Am 19. November 2026 hat Google in der Gemini Interactions API Tool Retrieval (Tool-Abruf) als Preview-Version eingeführt. Ein Agent sieht zunächst nur den Namen und die Kurzbeschreibung eines Tools; erst wenn er es tatsächlich aufrufen muss, wird das vollständige Parameter-Schema in den Kontext geladen. Es löst vor allem das Problem, dass bei immer mehr angebundenen Tools die Definitionen ungenutzter Tools den Kontext füllen. Am besten passt es zu Agenten mit vielen Tools, bei denen sich die Aufrufe auf wenige häufig genutzte Tools konzentrieren und zugleich viele Long-Tail-Tools vorhanden sind. Es ist kein Feature, das in jeder Anwendung durch bloßes standardmäßiges Aktivieren Kosten spart.
Was Sie in diesem Artikel erfahren
- was Tool Retrieval tatsächlich verändert und warum beides zugleich gilt: Entwickler müssen weiterhin vollständige Tool-Deklarationen einreichen, das Modell muss aber nicht vorab das vollständige Schema lesen
- die vollständige Ausführungskette von der Tool-Registrierung bis zum
function_callund die Aufteilung zwischen serverseitiger und clientseitiger Suche - die aktuell ausdrücklich unterstützten 4 Modell-IDs, den Standardpreis und die Bedeutung von „keine separate Funktionsgebühr, aber Tokens werden normal abgerechnet“
- zwei offizielle Beispielrechnungen mit gegensätzlicher Aussage: wann Sie sparen und wann es teurer wird
- welche Einschränkungen vor der Integration zu beachten sind und wie Sie beurteilen, ob sich der Einsatz für Ihren Agenten lohnt
Artikelstruktur: Im weiteren Verlauf verschaffen Ihnen zunächst eine Konzepttabelle und ein Kurzüberblick über die Auswirkungen schnell den nötigen Hintergrund. Der Abschnitt „Objektive Fakten“ erläutert der Reihe nach die Veröffentlichungsinformationen, die Funktionsweise, das hybride Laden und Remote-MCP, die unterstützten Modelle und Kosten sowie die Nutzungsbeschränkungen – stets auf Grundlage der offiziellen Google-Ankündigung und der Entwicklerdokumentation. Der Abschnitt „Analyse und Einschätzung“ enthält eine Bewertung der geeigneten Szenarien, eine Methode zur Baseline-Messung vor der Migration und einige häufige Fragen. Inhalte, die Einschätzungen oder Prognosen darstellen, werden gesondert gekennzeichnet.
Grundlegende Konzepte für Gemini API Tool Retrieval (To Know)
| Konzept | Kurze Erklärung |
|---|---|
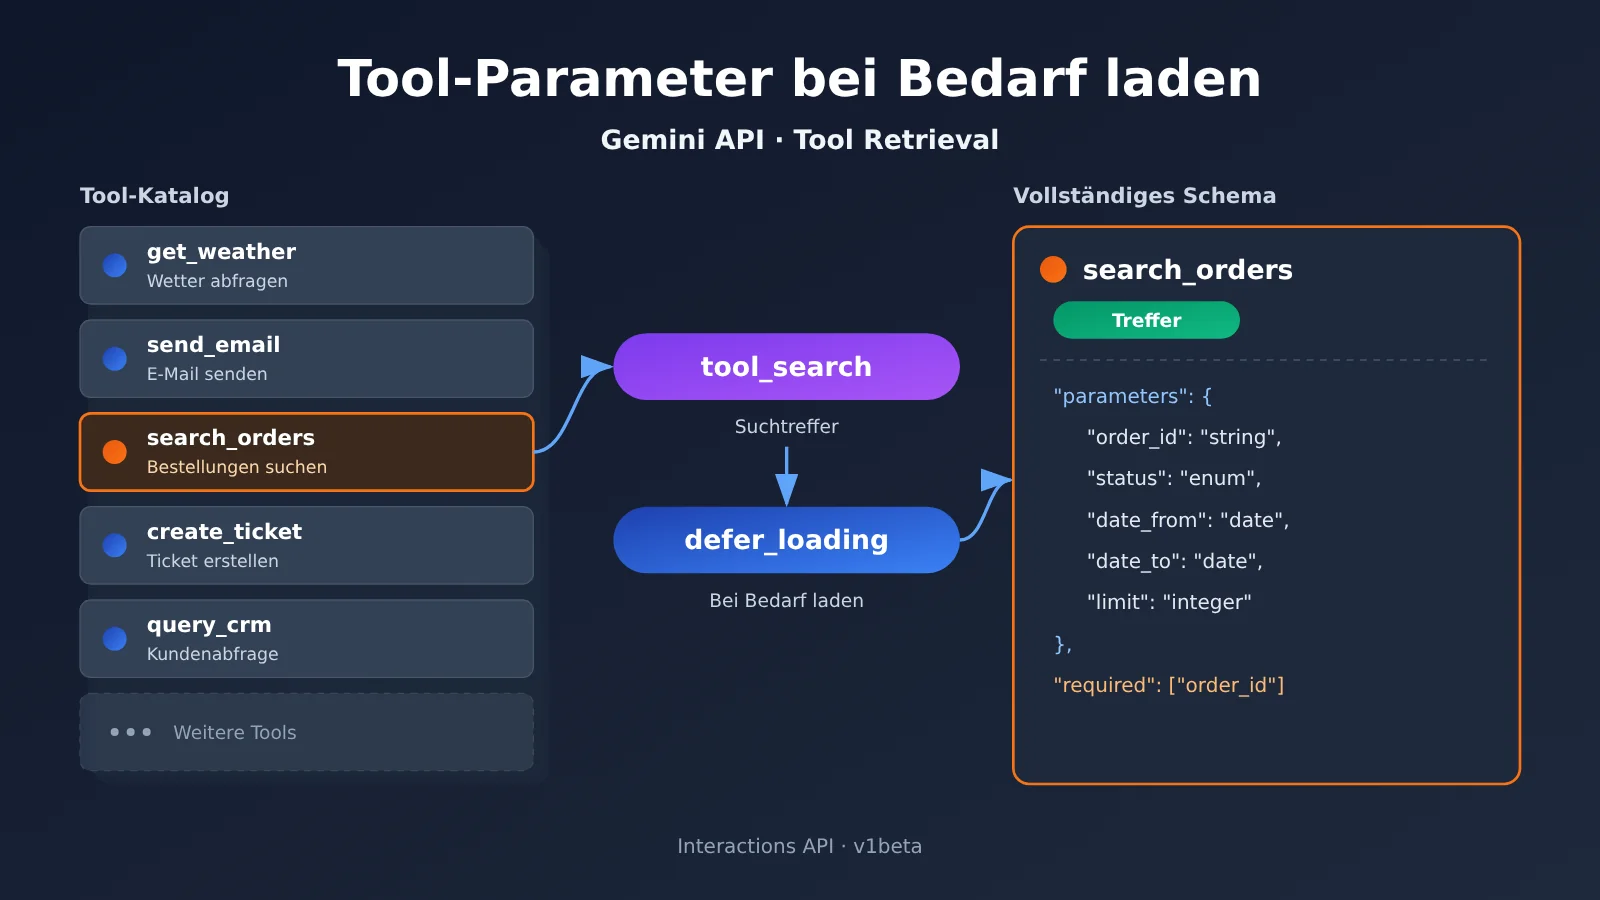
| Tool Retrieval | Zuerst werden die benötigten Tools gesucht; anschließend werden die vollständigen Parameterdefinitionen der gefundenen Tools in den Modellkontext aufgenommen. |
| Interactions API | Die Agent-Schnittstelle von Gemini. Sie verwaltet den Interaktionsverlauf, die Schritte der Tool-Ausführung und die Modellausgaben und ist seit Juni 2026 offiziell verfügbar. |
| Parameterschema | Beschreibt, welche Parameter eine Funktion akzeptiert, von welchem Typ sie sind und welche davon erforderlich sind – üblicherweise ausgedrückt als JSON Schema. |
| Function Calling | Das Modell erzeugt den Funktionsnamen und die Parameter, die Anwendung führt die Funktion aus und übergibt das Ergebnis anschließend zurück an das Modell. |
tool_search |
Ein Tool-Typ, der den Mechanismus für die Tool-Suche deklariert; über ihn sucht das Modell nach Tools und lädt deren Definitionen. |
defer_loading |
Eine Konfiguration im serverseitigen Modus, die das Laden der vollständigen Parameterdefinitionen eines Tools bis zum Treffer bei der Suche verzögert. |
short_description |
Eine kurze Beschreibung für verzögert geladene Tools, damit das Modell sie im anfänglichen Katalog erkennen kann. |
| Remote-MCP | Tools, die über das Model Context Protocol von Drittanbieterdiensten außerhalb der Anwendung bereitgestellt werden. |
| Implizites Caching | Die Plattform verwendet identische Kontextpräfixe automatisch wieder; für trefferhafte Teile wird der Eingabetarif für gecachte Inhalte berechnet. |
Gemini API Tool Retrieval – Auswirkungen im Überblick
- Entwickler, die einem Agent viele Business-Tools anbinden: Sie müssen keinen eigenen Tool-Retriever mehr bauen, sondern lassen das Modell bei Bedarf die Schemas von Dutzenden oder sogar Hunderten von Tools lesen. Allerdings muss weiterhin bei jeder Anfrage das komplette Tool-Array mitgeschickt werden, und Caching sowie Abrechnung sind neu zu bewerten. Vor der Migration sollten Sie mit dem bestehenden Function-Calling-Ablauf messen, wie viel die Tool-Definitionen tatsächlich belegen – über eine einheitliche Multi-Modell-Schnittstelle wie APIYI apiyi.com lässt sich schnell eine Vergleichsbaseline erstellen.
- Verantwortliche für Produkt und Kosten: Es gibt keine separate Funktionsgebühr, aber jede serverseitige Suche löst zusätzliche Modellinferenz aus. Ob es Geld spart, hängt von der Tool-Anzahl, der Kontextlänge und der Suchhäufigkeit ab. Das muss man anhand der Abrechnungsfelder prüfen und darf sich nicht allein auf die Richtung der Marketingaussagen verlassen.
- Anwendungen mit wenigen Tools und stabilen Aufrufen: Offizielle Rechenbeispiele zeigen, dass bei einem kleinen Tool-Set plus langem Kontext die Token-Gesamtzahl sogar ansteigt. Weiterhin direkt zu laden ist die stabilere Wahl.
- Teams, die ein Agent-Framework einsetzen: Das ist eine neue Fähigkeit auf der Modell-API-Ebene, die Frameworks nicht unbedingt sofort übernehmen. Beim progressiven Laden auf Framework-Ebene darf man nicht davon ausgehen, dass es bereits gelöst ist.
Objektive Fakten: Was Gemini API Tool Retrieval veröffentlicht hat
Veröffentlichungsinformationen und Hintergrund von Gemini API Tool Retrieval
Der offizielle Google-Blog veröffentlichte am 19. November 2026 den Beitrag „Introducing Tool Retrieval in the Gemini API“. Die Autorinnen sind Lucia Loher, Produktmanagerin für die Gemini API, und Nora Kassner, Forscherin bei Google DeepMind. Die Funktion befindet sich derzeit in der Preview-Phase, ist nur in der Interactions API verfügbar und erfordert die Version v1beta. Die ältere Methode generateContent wird nicht unterstützt.
Die Vorbereitung auf der Engineering-Seite begann vor der Ankündigung. Am 18. November veröffentlichte das offizielle Google Python SDK v3.6.0; in den Versionshinweisen steht, dass öffentliche Schemas für Tool Retrieval und Funktionsergebnisse hinzugefügt wurden. Am selben Tag enthielt auch das Go SDK v1.79.0 die entsprechenden Updates. Der Zeitlinie nach wurden auf der bereits GA-fähigen Interactions API die Möglichkeiten zur Werkzeugerkennung und zum Laden bei Bedarf ergänzt; es handelt sich nicht um ein neues API-Produkt.
Auch der Bedarf von Entwicklern ist dokumentiert. Am 18. März 2026 reichte ein Entwickler im Python-SDK-Repository Issue #2185 ein und bat um Unterstützung für defer_loading und tool_search. Als Begründung nannte er, dass bei Agents mit mehr als 30 angebundenen Tools das vollständige Schema den Kontext aufbläht. Google-Maintainer antworteten am 20. März und registrierten die Anfrage als Funktionswunsch. Das ist Bedarfsfeedback, kein Leistungstest.
Mit einem Satz zusammengefasst: Tools können zuerst entdeckt werden; die konkreten Parameter werden erst gelesen, wenn ein Aufruf nötig ist.
Wie Tool Retrieval die Art der Tool-Schema-Ladung verändert
Beim klassischen statischen Laden landen selbst dann, wenn der Nutzer nur eine einzige Rückerstattung erledigen möchte, die Parameterdeklarationen von Dutzenden Tools – Bestellungen, Logistik, Lagerbestand, CRM und so weiter – bei jeder Inferenz mit im Kontext. Die Google-Dokumentation erwähnt, dass allein mehrere Dutzend Funktionsdeklarationen Zehntausende Token belegen können. Das verdrängt den Platz für den Gesprächsverlauf, und bei vielen ähnlichen Tools kann es das Modell zusätzlich dabei stören, das richtige Tool auszuwählen.
Der Kern von Tool Retrieval liegt darin, drei Ebenen zu unterscheiden:
- API-Anfrageebene: Entwickler reichen wie gewohnt die vollständige Tool-Definition ein, inklusive Parameter-Schema.
- Anfangskontext des Modells: Tools, die mit
defer_loading: truemarkiert sind, erscheinen nur in Form von Name plusshort_description. Ist keine Kurzbeschreibung konfiguriert, wird der erste Satz der vollständigendescriptionverwendet. - Phase des Tool-Aufrufs: Erst wenn ein Tool durch die Suche getroffen wird, gelangt das vollständige Schema in den Kontext, und das Modell erzeugt darauf basierend den parametrisierten Aufruf.
Die Aussage „nicht mehr jedes Mal alle Tool-Parameter laden“ im Titel bedeutet also genau genommen: Das Modell liest nicht mehr in jeder Runde vorab alle vollständigen Parameter – und nicht, dass Entwickler keine vollständigen Deklarationen mehr senden müssten. Im Servermodus verlangt die offizielle Vorgabe, dass bei jeder Anfrage das vollständige tools-Array erneut übermittelt wird, auch wenn previous_interaction_id verwendet wird.
Die Ausführungskette von Tool Retrieval am Beispiel des offiziellen Rückerstattungsfalls
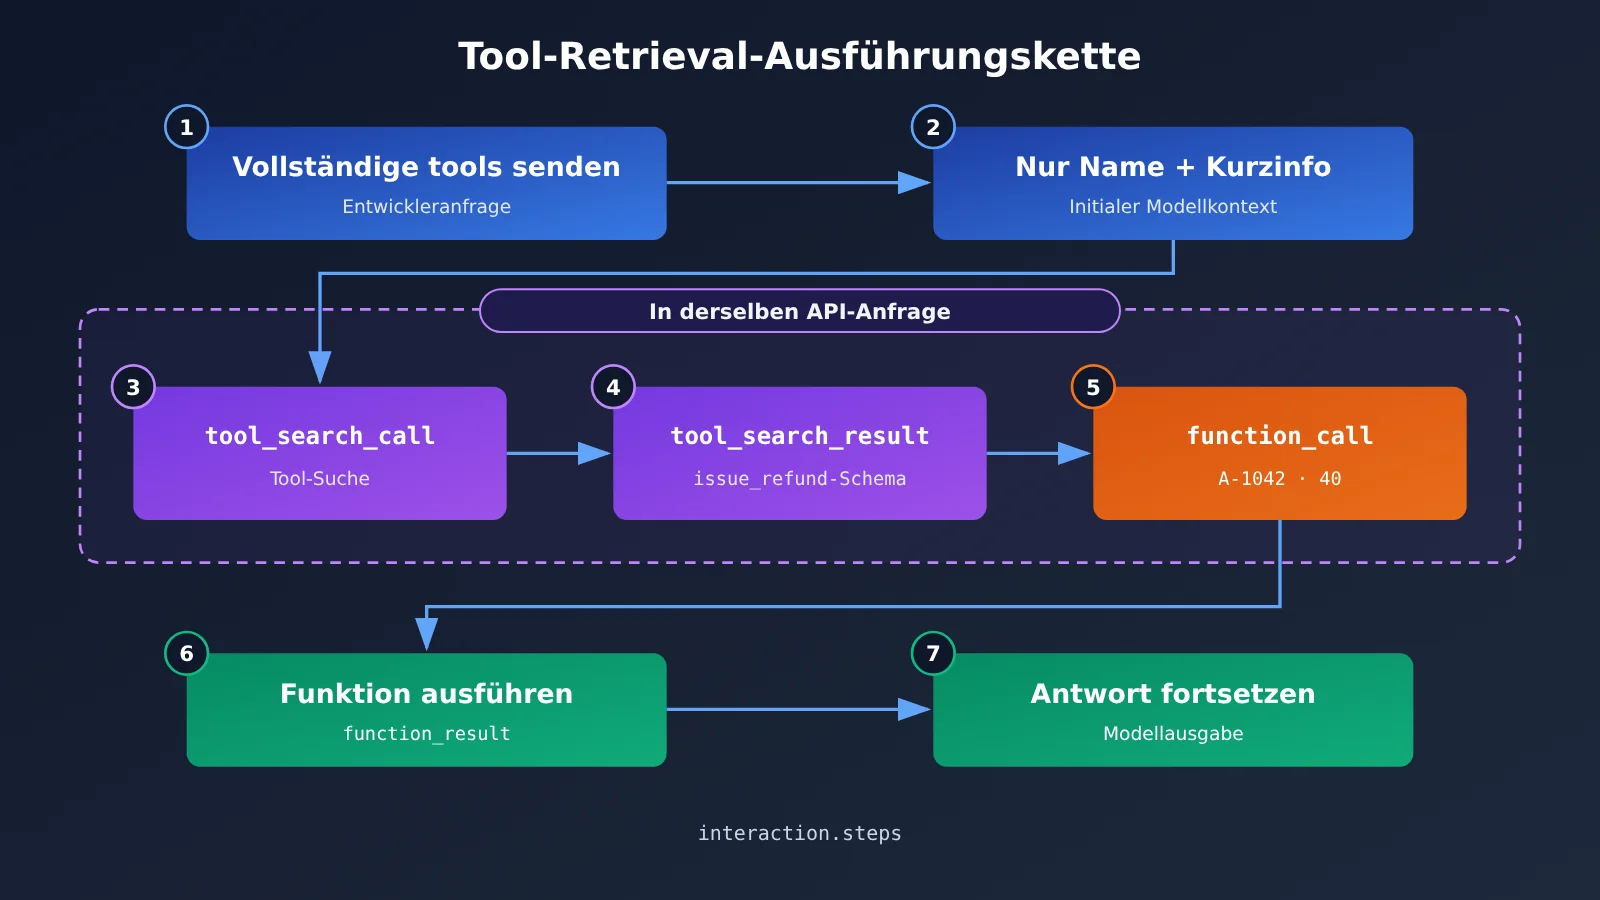
In der Google-Ankündigung wird ein Szenario zur Bestellrückerstattung verwendet: Bei der Bestellung A-1042 kam die Ware beschädigt an, der Nutzer verlangt eine Rückerstattung von 40 USD, und das dafür benötigte Tool ist issue_refund. Der vollständige Ablauf der serverseitigen Suche sieht so aus:
- In der Anfrage wird
{"type": "tool_search"}deklariert, und für selten genutzte Tools wieissue_refundwirddefer_loading: truegesetzt. - Das Modell erkennt anhand der Aufgabe, dass eine Rückerstattungsfunktion benötigt wird, und startet einen
tool_search_call. - Die API gibt ein
tool_search_resultzurück, das das vollständige Parameterschema vonissue_refundenthält. - Das Modell liest die Parameterdefinitionen und erzeugt einen
function_callmit den Parameternorder_id: "A-1042"undamount: 40. - Die Anwendung führt die Funktion aus und schickt ein
function_resultzurück, auf dessen Grundlage das Modell die Aufgabe weiter bearbeitet.
Suchen, Laden und Erzeugen des Funktionsaufrufs können innerhalb derselben externen API-Anfrage abgeschlossen werden, und alle Schritte sind in interaction.steps einsehbar. Beachten Sie jedoch: Eine einzelne Anfrage bedeutet nicht, dass intern nur einmal inferiert wird. Jede serverseitige Suche löst zusätzliche, kostenpflichtige Modellaufrufe aus. Außerdem handelt es sich um einen Demonstrationsfall, der keine Aussage über Erfolgsquoten von Rückerstattungen trifft.
Unten steht ein Beispielcode, der nach der offiziellen Dokumentation zusammengestellt wurde und direkt den Google-Endpunkt anspricht – er dient ausschließlich dazu, die Struktur der Anfrage zu zeigen:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Die ursprüngliche Aufgabenteilung von Function Calling bleibt unverändert. Bei benutzerdefinierten Funktionen gibt die API nur einen function_call zurück; das Ausführen der Rückerstattung, der Datenbankzugriff und die Rechteverwaltung sind weiterhin Aufgabe der Anwendung. Nur beim Anbinden eines entfernten MCP-Servers übernimmt die API den Remote-Aufruf und gibt dabei mcp_server_tool_call und mcp_server_tool_result zurück.
Hybrides Laden bei Tool Retrieval, Remote-MCP und die beiden Retrieval-Modi
Google empfiehlt eine hybride Vorgehensweise: Häufig genutzte Tools werden direkt geladen, seltene und spezialisierte Long-Tail-Tools dagegen verzögert. So muss bei einfachen Aufgaben nicht erst eine Suche durchgeführt werden, und Long-Tail-Fähigkeiten belegen nicht dauerhaft Kontext. Remote-MCP-Server lassen sich ebenfalls insgesamt auf verzögertes Laden setzen: Hängt man an eine Konfiguration vom Typ type: "mcp_server" das Feld defer_loading: true an, werden die von diesem Server bereitgestellten Tools bei Bedarf geladen, ohne sie einzeln deklarieren zu müssen.
Neben dem serverseitigen Modus, bei dem Gemini die Suche übernimmt, gibt es offiziell auch einen clientseitigen Modus: Entwickler deklarieren einen tool_search mit execution: "client", die eigene Anwendung fragt die Tool-Registry ab und legt die passenden vollständigen Tool-Deklarationen in function_result.result ab, um sie an das Modell zurückzugeben. Die Unterschiede sind:
| Vergleichskriterium | Serverseitige Suche | Clientseitige Suche |
|---|---|---|
| Ausführungsort | Gemini-API-Server (Standard: server) |
Entwickleranwendung (client) |
| Eigener Retriever erforderlich | Nein | Ja |
| Tool-Bibliothek vorab deklarieren | Ja | Nein, neue Tools können in der Sitzung eingebracht werden |
defer_loading |
Anwendbar | Nicht anwendbar |
| Zusätzliche Netzwerk-Roundtrips | Keine zusätzlichen Client-Roundtrips | Ein zusätzlicher Roundtrip pro Suche |
| Berechtigungskontrolle | Wird durch das im Request deklarierte Toolset bestimmt | Kann mit selbst gebauter benutzerspezifischer Berechtigungsfilterung kombiniert werden |
| Typische Szenarien | Große, relativ feste Toolsammlungen | Dynamische Tool-Bibliotheken, Multi-Tenant, unternehmenseigene private Registries |
Im Client-Modus sollten die zurückgegebenen Funktionsdeklarationen strukturierte Objekte sein und dürfen nicht in JSON-Strings umgewandelt werden. Innerhalb derselben Anfrage dürfen die beiden Modi nicht gemischt werden, und es darf höchstens ein tool_search deklariert werden.
Welche Modelle unterstützt Gemini API Tool Retrieval und wie ist die Preisgestaltung?
Googles Ankündigung ist relativ allgemein gehalten: Gemini 3.6 und neuere Modelle sollen unterstützt werden, einschließlich aller Gemini 4-Modelle. In der Entwicklerdokumentation sind jedoch mit Stand 20. November ausdrücklich nur vier Modell-IDs aufgeführt. In der Praxis sollte man sich an der Entwicklerdokumentation orientieren. Wenn man defer_loading für ein nicht unterstütztes Modell setzt, wird HTTP 400 zurückgegeben.
| Modell-ID | Standard-Eingabepreis (USD pro Million Tokens) | Standard-Ausgabepreis (inkl. Thinking) | Hinweise |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Mit Free Tier gekennzeichnet |
gemini-4-argon |
$2.00 (ab 1. Dezember $4.00) | $10.00 (ab 1. Dezember $20.00) | Kein Free Tier |
gemini-3.8-flash |
$0.75 (ab 1. Januar 2027 $1.50) | $3.75 (ab 1. Januar 2027 $7.50) | Mit Free Tier gekennzeichnet |
gemini-3.6-flash |
$0.75 (ab 1. Januar 2027 $1.50) | $3.75 (ab 1. Januar 2027 $7.50) | Mit Free Tier gekennzeichnet |
Die Preise stammen aus der Standard-Stufe der Preisseite der Google Gemini Developer API. Die tatsächlichen Kontingente und Ratenlimits des Free Tier müssen projektbezogen bestätigt werden.
Bei der Abrechnung stellt Google ausdrücklich klar, dass Tool Retrieval keine eigenständige Funktionsgebühr hat. Das bedeutet aber nicht, dass die Suche kostenlos ist. Die kurze Beschreibungsliste der verzögerten Tools, die festen Suchanweisungen, die nach Aktivierung von tool_search hinzukommen, die zusätzliche Inferenz bei jeder serverseitigen Suche, das geladene vollständige Schema sowie dessen Beibehaltung in nachfolgenden Runden werden alle als Tokens zum Tarif des gewählten Modells abgerechnet. Bei der Kostenbeobachtung sollte man besonders auf das Feld total_tool_use_tokens achten; es erfasst die zusätzlichen Modelleingaben, die durch die serverseitige Suche ausgelöst werden. Wer nur den Rückgang der Eingabe-Tokens beim ersten Aufruf betrachtet, überschätzt die Einsparungen leicht.
Offizielles Token-Rechenbeispiel für Tool Retrieval
Frühe offizielle Tests zeigen, dass jedes Lazy-Tool im anfänglichen Katalog im Durchschnitt etwa 26 Tokens belegt. Das ist ein Näherungswert, kein fixer Overhead. Die Dokumentation führt außerdem zwei hypothetische Rechenbeispiele auf, die in entgegengesetzte Richtungen weisen:
| Szenario (offizielle Annahme) | Statisches Laden aller Tools | Tool Retrieval | Veränderung |
|---|---|---|---|
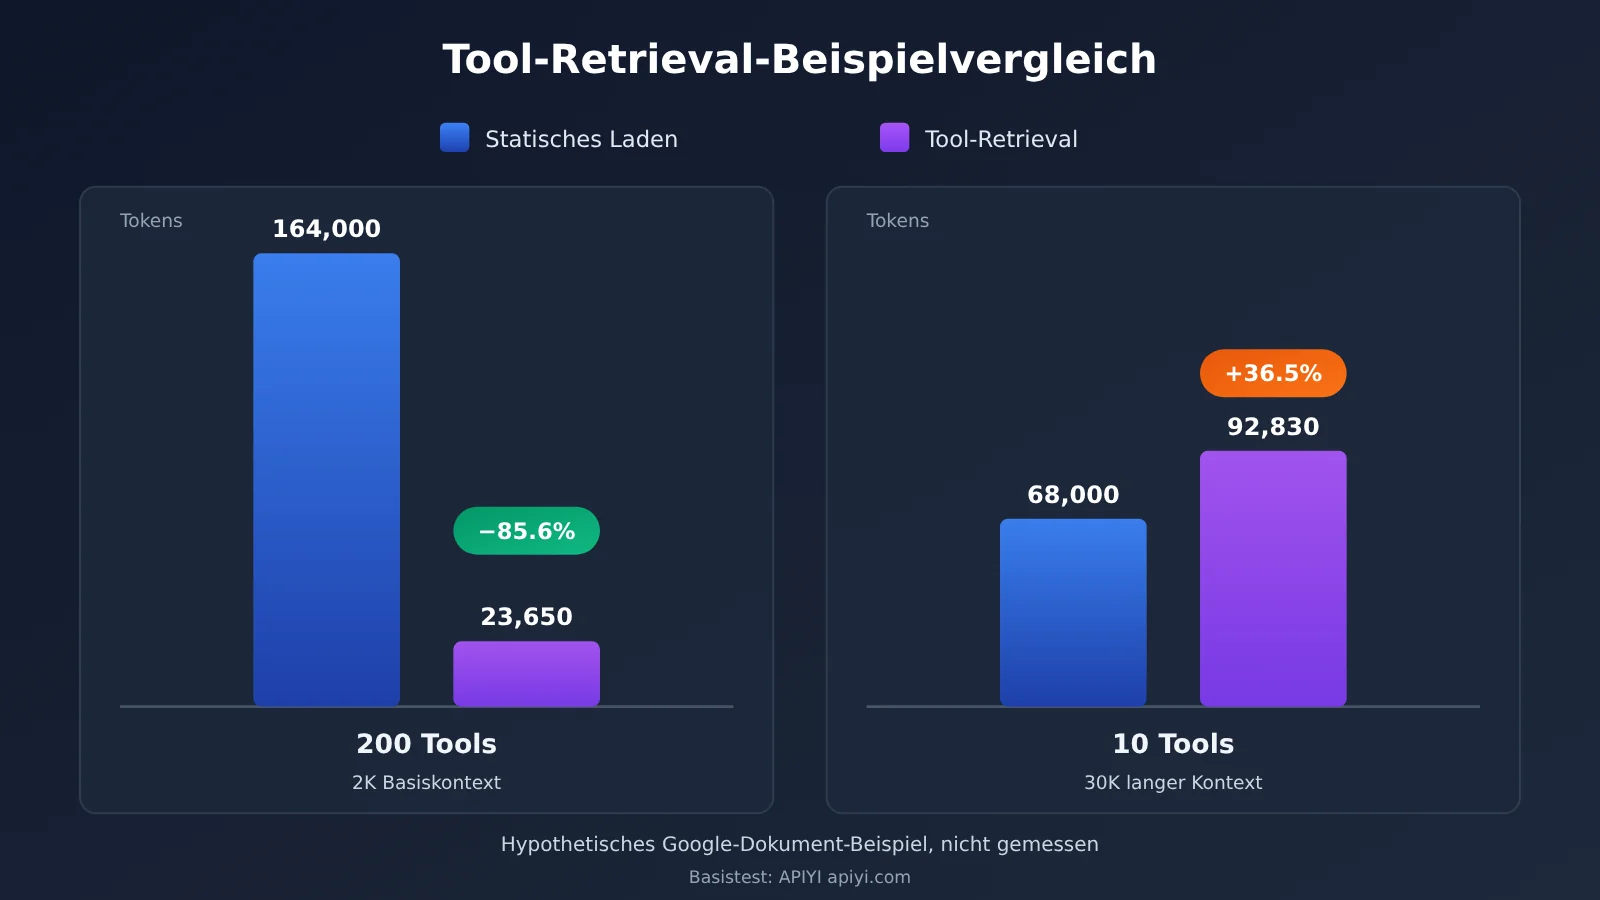
| 200 Tools, je 400 Tokens, Basiskontext 2.000, 2 verwendete Tools, insgesamt 2 Anfragen | 164.000 | ca. 23.650 | Reduktion um ca. 85,6 % (laut Rechenbeispiel) |
| 10 Tools, je 400 Tokens, Basiskontext 30.000, 2 verwendete Tools, insgesamt 2 Anfragen | 68.000 | 92.830 | Anstieg um ca. 36,5 % (laut Rechenbeispiel) |
Der Grund, warum das zweite Rechenbeispiel teurer wird: Die serverseitige Suche erfordert eine zusätzliche Inferenz und verarbeitet den ohnehin schon langen Kontext erneut. Die 10 Tools selbst belegen nicht viel, sodass das eingesparte Schema die Suchkosten nicht aufwiegt. Bei beiden Zahlen handelt es sich um von Google ausdrücklich als hypothetisch gekennzeichnete Beispiele, die weder Ausgabe-Tokens noch Cache-Gewinne berücksichtigen — es ist kein Production-Benchmark. Bis zum Datum der Materialprüfung hat Google weder das tatsächlich gemessene Token-Einsparverhältnis noch Latenzverbesserungen oder eine höhere Trefferquote bei der Tool-Auswahl für dieses Feature veröffentlicht.
Zum Caching: Google gibt an, dass Tool Retrieval implizites Caching unterstützt: Das vollständige Schema erscheint nicht im anfänglichen Präfix, und Präfixe wie Systemanweisungen und Tool-Katalog lassen sich leichter stabil halten. Die Dokumentation weist jedoch auch darauf hin, dass Lazy Loading die anfängliche Eingabeaufforderung verkürzt — Anfragen, die ursprünglich auf eine große Menge an Schema angewiesen waren, um die Mindestschwelle für das Caching zu erreichen, könnten dadurch unter diese Schwelle fallen.
Aktuelle Einschränkungen bei der Nutzung von Tool Retrieval
Die folgenden Punkte stammen aus der offiziellen Dokumentation und sind die häufigsten Stolperfallen in der Entwicklung:
- Bereits geladene Tools lassen sich nicht wieder entladen: Sobald ein Schema abgerufen wurde, bleibt es für die aktuelle Sitzung erhalten. Werden in sehr langen Sitzungen ständig neue Tools nachgeladen, wächst der Kontext weiter an.
- Bei jeder Anfrage wird das komplette Tool-Array erneut übermittelt: einschließlich
tool_search, aller verzögerten und nicht verzögerten Tools sowie der zugehörigen MCP-Konfiguration. Es reicht nicht, nurnameundshort_descriptionzu senden undparameterswegzulassen. - Tools, die in den Systemanweisungen direkt genannt werden, sollten nicht verzögert werden: Das Modell könnte die Suche umgehen und sie direkt aufrufen, was aufgrund des fehlenden Ladekontexts zu Fehlern führt.
- Bei zustandslosen Sitzungen müssen die Retrieval-Schritte vollständig erhalten bleiben: Wenn Sie den Verlauf mit
store=falseselbst verwalten, dürfentool_search_call,tool_search_resultund derensignaturenicht gelöscht oder verändert werden – sonst kann HTTP 400 zurückgegeben werden. - Beim Debuggen auf die steps achten: Selbst wenn
interaction.statusnichtrequires_actionist, kann das Ergebnis einen noch ausstehendenfunction_callenthalten. - Bei fehlendem Treffer kann Text zurückgegeben werden: Findet die serverseitige Suche kein passendes Tool, wird nicht zwangsläufig ein strukturierter Fehler zurückgegeben.
Analyse: Was Gemini API Tool Retrieval für die Agent-Entwicklung bedeutet
Wann Tool Retrieval sinnvoll ist
Der eigentliche Wert dieses Updates liegt darin, „eine vollständige Tool-Liste pflegen“ und „diese Liste bei jeder Inferenzrunde komplett durchlesen“ in zwei getrennte Dinge zu zerlegen. Die Tool-Bibliothek kann weiter wachsen, während im Modellkontext dauerhaft nur ein sehr schlanker Katalog bleibt. Für Teams, die laufend neue Geschäftssysteme anbinden, verringert das den Aufwand, das Tool-Set vorab zurechtzuschneiden. Außerdem sinkt die Zahl der Fälle, in denen auf Anwendungsseite in jeder Runde dynamisch Tools gefiltert werden, um Tokens zu sparen – und dadurch der Cache-Präfix zerstört wird.
Allerdings zeigen die offiziellen Rechenbeispiele bereits, dass der Nutzen an Bedingungen geknüpft ist. In Anlehnung an die offiziellen Engineering-Empfehlungen lässt sich anhand der folgenden Tabelle eine erste Einschätzung treffen (das sind Empfehlungen für die Wahl der Umsetzung, keine starren zahlenmäßigen Schwellen):
| Agent-Typ | Tool-Merkmale | Empfehlung |
|---|---|---|
| Kundenservice, Geschäftsprozess-Assistent | einige Dutzend Tools, wenige Abfrage-Tools mit hoher Frequenz; Rückerstattung, Genehmigung, Verträge usw. mit geringer Frequenz | häufig genutzte direkt laden, Long Tail über serverseitige Suche |
| Entwicklungs-/Betriebs-Agent mit mehreren MCP-Servern | viele Tools pro Server, pro Aufgabe wird nur ein kleiner Teil genutzt | defer_loading für den gesamten MCP-Server setzen |
| Multi-Tenant-Plattform, die Tools nach Berechtigungen freigibt | Tool-Set variiert je nach Nutzer und Workspace | Client-seitige Suche, kombiniert mit eigener Registry und Berechtigungsfilter |
| Kleiner Assistent | weniger als etwa 20 stabile Tools, die meisten werden in jeder Runde genutzt | weiterhin statisch laden |
| Langer Kontext + häufige Suche | sehr lange Konversation, oft mehrere Suchen pro Runde nötig | erst messen, dann entscheiden; Risiko steigender Nettokosten |
Unsere Einschätzung: Je „long-tailiger“ die Verteilung der Tool-Aufrufe, desto eher lohnt sich Tool Retrieval. Umgekehrt gilt: Wenn die meisten Tools in jeder Runde benötigt werden, bringt verzögertes Laden lediglich eine zusätzliche Such-Inferenz.
Vor der Migration zu Tool Retrieval zuerst den tatsächlichen Overhead des Tool-Schemas messen
Die zuverlässigste Grundlage für die Entscheidung, ob migriert werden soll, sind die eigenen Geschäftsdaten. Vor der Migration können Sie mit dem bestehenden OpenAI-kompatiblen Function-Calling-Ablauf die Differenz der Eingabe-Token zwischen zwei Anfragen messen – einmal mit „allen Tools“ und einmal mit „nur den tatsächlich verwendeten Tools“. So erhalten Sie den realen Overhead des Tool-Schemas. Das folgende Skript führt genau diese Basislinienmessung durch und ist nicht Tool Retrieval selbst:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle zur Messung der statischen Lade-Basislinie
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
Vollständiges Basislinien-Messskript anzeigen (Stapelvergleich nach Tool-Anzahl)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Über die einheitliche APIYI-Schnittstelle den Tool-Schema-Overhead verschiedener Modelle messen
)

def load_tools(path: str) -> list:
    """Liest die Tool-Definitionen im OpenAI-Format aus der Business-Tool-Registry (JSON-Datei)"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 Technischer Hinweis: Bevor Sie Tool Retrieval bewerten, können Sie über APIYI apiyi.com mit einem einzigen API-Schlüssel auf mehreren gängigen Modellen eine statische Lade-Basislinie durchlaufen lassen und so genau sehen, wie viele Token das Tool-Schema in Ihrer Anfrage tatsächlich belegt. Sobald Sie diese Basislinie haben, aktivieren Sie im Gemini Interactions API
tool_searchals Vergleich und vergleichen die Summe austotal_input_tokensundtotal_tool_use_tokens.
Anzumerken ist, dass Tool Retrieval von der v1beta-Schnittstelle der Interactions API und speziellen Feldern abhängt; die oben beschriebenen OpenAI-kompatiblen Aufrufe dienen lediglich dazu, den Aufwand des statischen Ladens zu messen. Bei Vergleichstests empfiehlt es sich, Modell, Werkzeugbibliothek, Aufgabensatz, Kontextlänge und Cache-Bedingungen konstant zu halten und erst dann die gesamten Abrechnungskosten, die End-to-End-Dauer, die Quote der korrekt ausgewählten Werkzeuge und die durchschnittliche Anzahl an Suchvorgängen zu vergleichen – nur so lassen sich die Unterschiede auf die Retrieval-Strategie zurückführen. Wenn Sie in ein und demselben Skript die Baseline-Unterschiede verschiedener Modelle nebeneinander betrachten möchten, spart die einheitliche Schnittstelle von APIYI apiyi.com die Arbeit, jeden Anbieter einzeln anzubinden.
Entwicklungen, die es weiter zu beobachten gilt (prognostische Einschätzung)
Das Folgende sind Einschätzungen, keine bereits bestätigten Fakten.
Erstens weichen die Ankündigung und die Entwicklerdokumentation beim Umfang der unterstützten Modelle voneinander ab; ob Modelle wie Gemini 4 Carbon oder Gemini 4 Neon in die Kompatibilitätsliste aufgenommen werden, lässt sich nur klären, indem man die Dokumentations-Updates im Auge behält. Zweitens ist „bereits geladene Schemata lassen sich nicht entladen“ eine deutliche Schwäche von Agents mit langen Sitzungen; ob die finale Version einen Mechanismus zum Entladen oder Ausmustern bietet, wirkt sich direkt darauf aus, wie sie sich bei langen Aufgaben schlägt. Drittens haben Nutzer des Google ADK bereits in Issue #7241 Probleme mit progressivem Laden und Cache-Invalidierung gemeldet. Dass die Modell-API eine neue Fähigkeit unterstützt, heißt nicht, dass das Framework sie automatisch übernimmt – das Tempo der Anpassung auf Framework-Ebene ist es wert, weiterverfolgt zu werden.
Die Idee, Werkzeugdefinitionen bei Bedarf zu laden, hat in der Branche bereits Vorläufer; Google ergänzt sie nun in der Agent-Schnittstelle von Gemini. Da sich Schnittstellen in der Preview-Phase ändern können, empfiehlt es sich, bei der Anbindung von Produktivsystemen einen Schalter zum Zurückfallen auf statisches Laden vorzusehen.
Einige häufige Fragen zu Gemini API Tool Retrieval
F1: Wird der Request-Body kleiner, wenn Tool Retrieval aktiviert ist?
Nein. Im Servermodus muss bei jeder Anfrage weiterhin das komplette Tool-Array übermittelt werden; kleiner wird nur der Tool-Anteil im initialen Kontext des Modells. Wenn Sie zunächst das Volumen der Tool-Definitionen in bestehenden Anfragen berechnen möchten, können Sie das obige Skript über APIYI apiyi.com verwenden, um eine Baseline zu messen.
F2: Sagt Google offiziell, dass man 85 % sparen kann?
Eine solche empirische Schlussfolgerung gibt es nicht. Die 85,6 % sind aus einem hypothetischen Rechenbeispiel mit 200 Tools abgeleitet; dasselbe Dokument liefert auch ein Gegenbeispiel, bei dem bei kleinen Tool-Sets die Tokens um etwa 36,5 % zunehmen.
F3: Ist Tool Retrieval kostenpflichtig?
Es gibt keine separate Funktionsgebühr, aber Suchanweisungen, zusätzliche Inferenz und geladene Schemas werden alle nach Modelltarif als Tokens abgerechnet. Budgetsensible Teams können zunächst über APIYI apiyi.com nutzungsbasiert kleinere Tests der Function-Calling-Kosten verschiedener Modelle durchführen und dann die Modellauswahl für den Agenten entscheiden.
F4: Muss man die Funktionen nicht mehr selbst ausführen, wenn man Tool Retrieval verwendet?
Nein. Benutzerdefinierte Funktionen werden weiterhin von der Anwendung ausgeführt und die Ergebnisse zurückgegeben; Tool Retrieval ist nur dafür zuständig, Tool-Definitionen zu finden und zu laden. Nur entfernte MCP-Tools werden von der API im Auftrag aufgerufen.
Die Tool-Bibliothek wird immer größer, aber in jeder Runde braucht man oft nur einige wenige davon. Tool Retrieval trennt „Tools bereithalten“ und „jederzeit abrufen“ – richtig eingesetzt macht es große Agenten leichter, falsch eingesetzt kann es auch eine zusätzliche Inferenzrunde kosten. Wie es im „Analekten · Weiling Gong“ heißt: „Will man seine Arbeit gut machen, muss man zuerst seine Werkzeuge schärfen.“ Erst wenn man das Gewicht jedes „Werkzeugs“ in der Hand kennt, entscheidet man, wie man sie anordnet.
📚 Referenzmaterialien
-
Offizielle Google-Ankündigung: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Inhalt: Veröffentlichungsinformationen, Designziele, die zwei Retrieval-Modi und Preisgestaltungsprinzipien
- Link:
-
Google Tool Retrieval Entwicklerdokumentation: Konfiguration, Limits, Abrechnung und Beispielrechnungen
- Link:
aistudio.google.com/docs/tool-retrieval - Inhalt: Liste der unterstützten Modelle, Usage-Felder, Best Practices und häufige Fehler
- Link:
-
Gemini Developer API Preisgestaltung: Standardmodellpreise und Caching-Raten
- Link:
aistudio.google.com/docs/pricing - Inhalt: Input-/Output-Einzelpreise der einzelnen Modelle sowie deren Gültigkeitsdatum
- Link:
-
Interactions API Dokumentation: Schnittstellenpositionierung und Ausführungsschritte
- Link:
aistudio.google.com/docs/interactions-overview - Inhalt: Zustandsbehaftete Konversationen, steps-Struktur und der Unterschied zu generateContent
- Link:
-
Google Python SDK v3.6.0 und Issue #2185: Technische Belege und dokumentierter Entwicklerbedarf
- Link:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - Link:
github.com/googleapis/python-genai/issues/2185 - Inhalt: Aktualisierung des öffentlichen SDK-Schemas und frühe Bedürfnisse der Community
- Link:
Autor: APIYI Technik-Team
Technischer Austausch: Sie erreichen uns gerne über die Startseite von APIYI apiyi.com – weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com