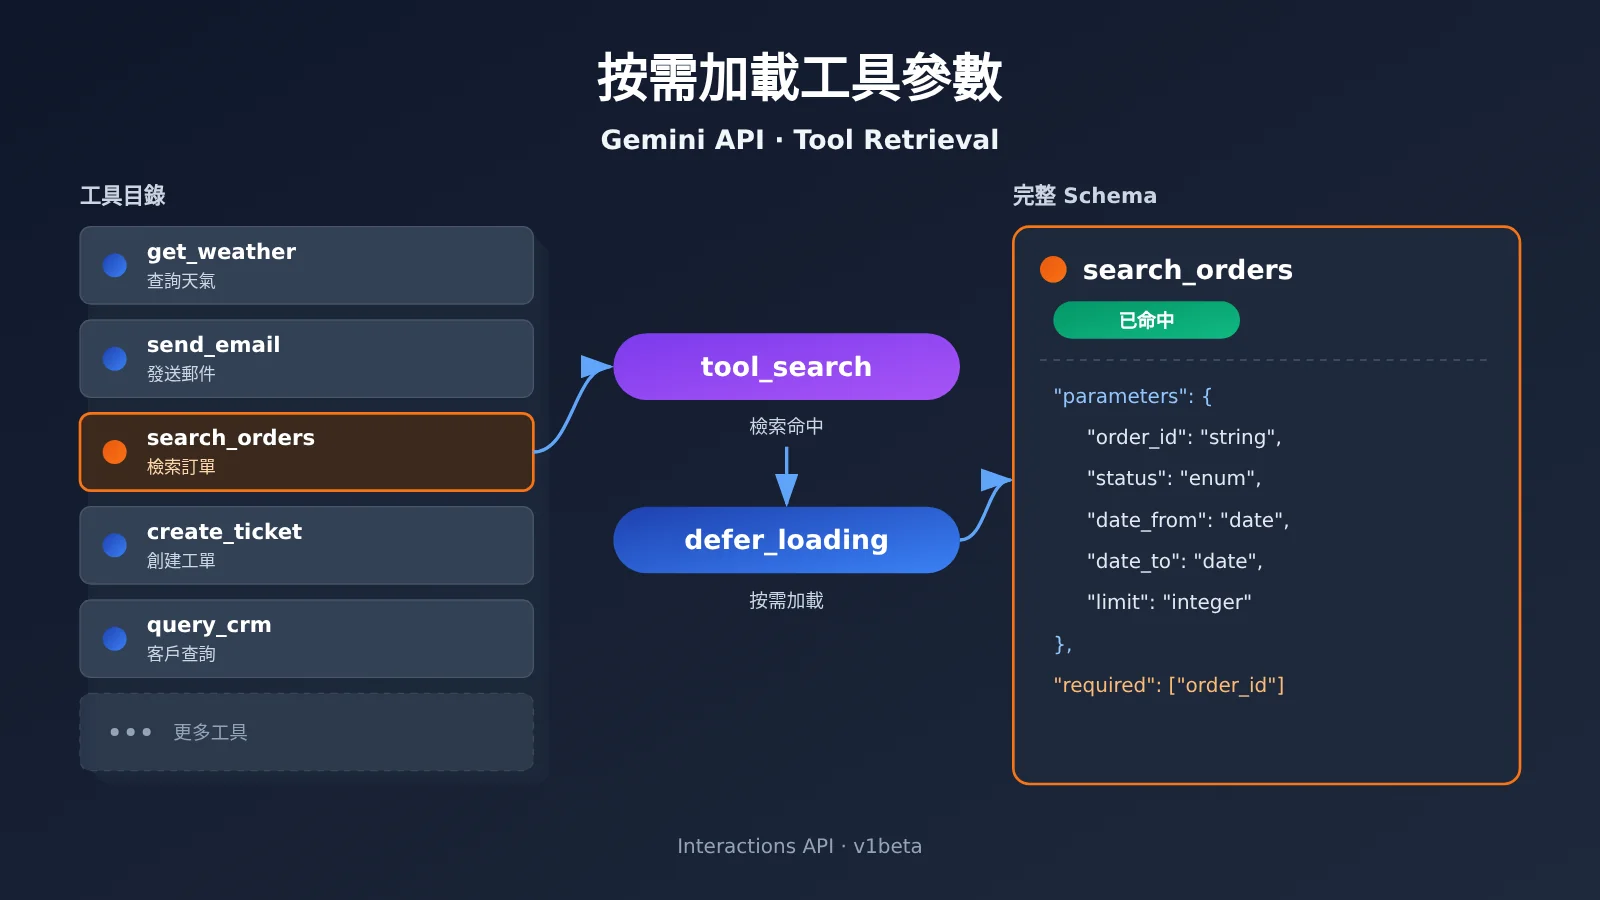
2026 年 11 月 19 日,Google 在 Gemini Interactions API 中以 Preview 形式推出 Tool Retrieval(工具檢索)。Agent 可以先只看到工具的名稱和簡述,等真正需要調用時再把完整參數 Schema 載入上下文。它主要解決的是“工具越接越多、上下文被閒置工具定義佔滿”的問題。它最適合工具數量多、調用集中在少數高頻工具、同時存在大量長尾工具的 Agent,並不是所有應用默認開啓就能省錢。
您讀完此文能瞭解到什麼?
- Tool Retrieval 改變的到底是什麼,以及“開發者仍要提交完整工具聲明”和“模型不必提前讀完整 Schema”爲何同時成立
- 從工具註冊到
function_call的完整執行鏈,以及服務端檢索與客戶端檢索的分工 - 當前明確支持的 4 個模型 ID、標準價格,以及“沒有單獨功能費,但 Token 照常計費”的含義
- 官方兩組方向相反的示意算例:什麼時候能省,什麼時候反而更貴
- 接入前需要注意的限制,以及如何判斷自己的 Agent 是否值得采用
索引:後文先用一張概念表和影響速覽幫你快速對齊背景。“客觀事實”部分依次說明發布信息、工作機制、混合加載與遠程 MCP、支持模型與成本、使用限制,全部以 Google 官方公告和開發文檔爲準。“分析判斷”部分給出適用場景判斷、遷移前的基線測量方法和幾個常見疑問,其中帶有判斷或預測性質的內容會單獨標明。
Gemini API Tool Retrieval 需要先知道的概念(To Know)
| 概念 | 簡要解釋 |
|---|---|
| Tool Retrieval | 先檢索需要的工具,再把命中工具的完整參數定義加入模型上下文 |
| Interactions API | Gemini 面向 Agent 的接口,管理交互歷史、工具執行步驟和模型輸出,2026 年 6 月已正式可用 |
| 參數 Schema | 描述函數接受哪些參數、類型是什麼、哪些必填的結構,通常用 JSON Schema 表達 |
| Function Calling | 模型生成函數名和參數,由應用執行函數,再把結果交回模型 |
tool_search |
聲明工具檢索機制的工具類型,模型通過它查找並載入工具定義 |
defer_loading |
服務端模式下的配置,把工具完整參數定義延遲到檢索命中時再加載 |
short_description |
延遲工具的簡短說明,供模型在初始目錄中識別工具 |
| 遠程 MCP | 通過 Model Context Protocol 連接應用外部、由第三方服務提供的工具 |
| 隱式緩存 | 平臺自動複用相同的上下文前綴,命中部分按緩存輸入費率計費 |
Gemini API Tool Retrieval 影響速覽
- 正在給 Agent 接大量業務工具的開發者:可以不再自建工具檢索器,就讓模型按需讀取幾十甚至上百個工具的 Schema。不過仍需每次請求提交完整工具數組,並重新評估緩存與計費。遷移前建議先用現有 Function Calling 流程測出工具定義的實際佔用,可藉助 API易 apiyi.com 這類多模型統一接口快速跑出對照基線。
- 產品與成本負責人:沒有單獨的功能費,但每次服務端搜索會觸發額外的模型推理。省不省錢取決於工具規模、上下文長度和搜索頻次,需要用賬單字段驗證,不能只看宣傳方向。
- 工具很少、調用穩定的應用:官方算例顯示,小工具集疊加長上下文時,Token 總量反而會上升,繼續直接加載是更穩的選擇。
- 使用 Agent 框架的團隊:這是模型 API 層的新能力,框架不一定立即適配。在框架層面的漸進加載問題上,不能默認已經被解決。
客觀事實:Gemini API Tool Retrieval 發佈了什麼
Gemini API Tool Retrieval 的發佈信息與背景
Google 官方博客於 2026 年 11 月 19 日發佈了《Introducing Tool Retrieval in the Gemini API》,作者是 Gemini API 產品經理 Lucia Loher 和 Google DeepMind 研究科學家 Nora Kassner。功能目前處於 Preview 階段,只能在 Interactions API 中使用,需要 v1beta 版本。舊的 generateContent 方法不支持。
工程側的準備早於公告。11 月 18 日,Google 官方 Python SDK 發佈 v3.6.0,更新記錄寫明加入了 Tool Retrieval 與函數結果相關的公共 Schema。同日,Go SDK v1.79.0 也包含相應更新。從時間線看,這次是在已經 GA 的 Interactions API 上補齊工具發現與按需裝載能力,並不是推出一個新的 API 產品。
開發者的需求也有記錄可查。2026 年 3 月 18 日,有開發者在 Python SDK 倉庫提交 Issue #2185,請求支持 defer_loading 和 tool_search,理由是 Agent 接入 30 個以上工具後,完整 Schema 會造成上下文膨脹。Google 維護人員在 3 月 20 日回應,將其登記爲功能請求。這些是需求反饋,不是性能測試。
用一句話概括 Tool Retrieval:工具可以先被發現,具體參數等到需要調用時再讀取。
Tool Retrieval 如何改變工具 Schema 的加載方式
在傳統靜態加載下,即使用戶只想辦一筆退款,訂單、物流、庫存、CRM 等幾十個工具的參數聲明也會隨每次推理一起進入上下文。Google 文檔提到,幾十個函數聲明就可能佔用數萬個 Token。這會擠佔對話歷史的空間,相似工具一多,還可能干擾模型選對工具。
Tool Retrieval 的關鍵在於區分三個層面:
- API 請求層:開發者照常提交完整工具定義,包括參數 Schema。
- 模型初始上下文:標記爲
defer_loading: true的工具只以名稱加short_description的形式出現。如果沒有配置簡述,就取完整description的第一句。 - 工具調用階段:工具被檢索命中後,完整 Schema 才進入上下文,模型據此生成參數化的調用。
所以標題裏“不再每次加載全部工具參數”,準確的含義是模型不再每輪提前讀取所有完整參數,而不是開發者不用再發送完整聲明。服務端模式下,官方要求每次請求都重新提交完整的 tools 數組,即使使用了 previous_interaction_id 也不例外。
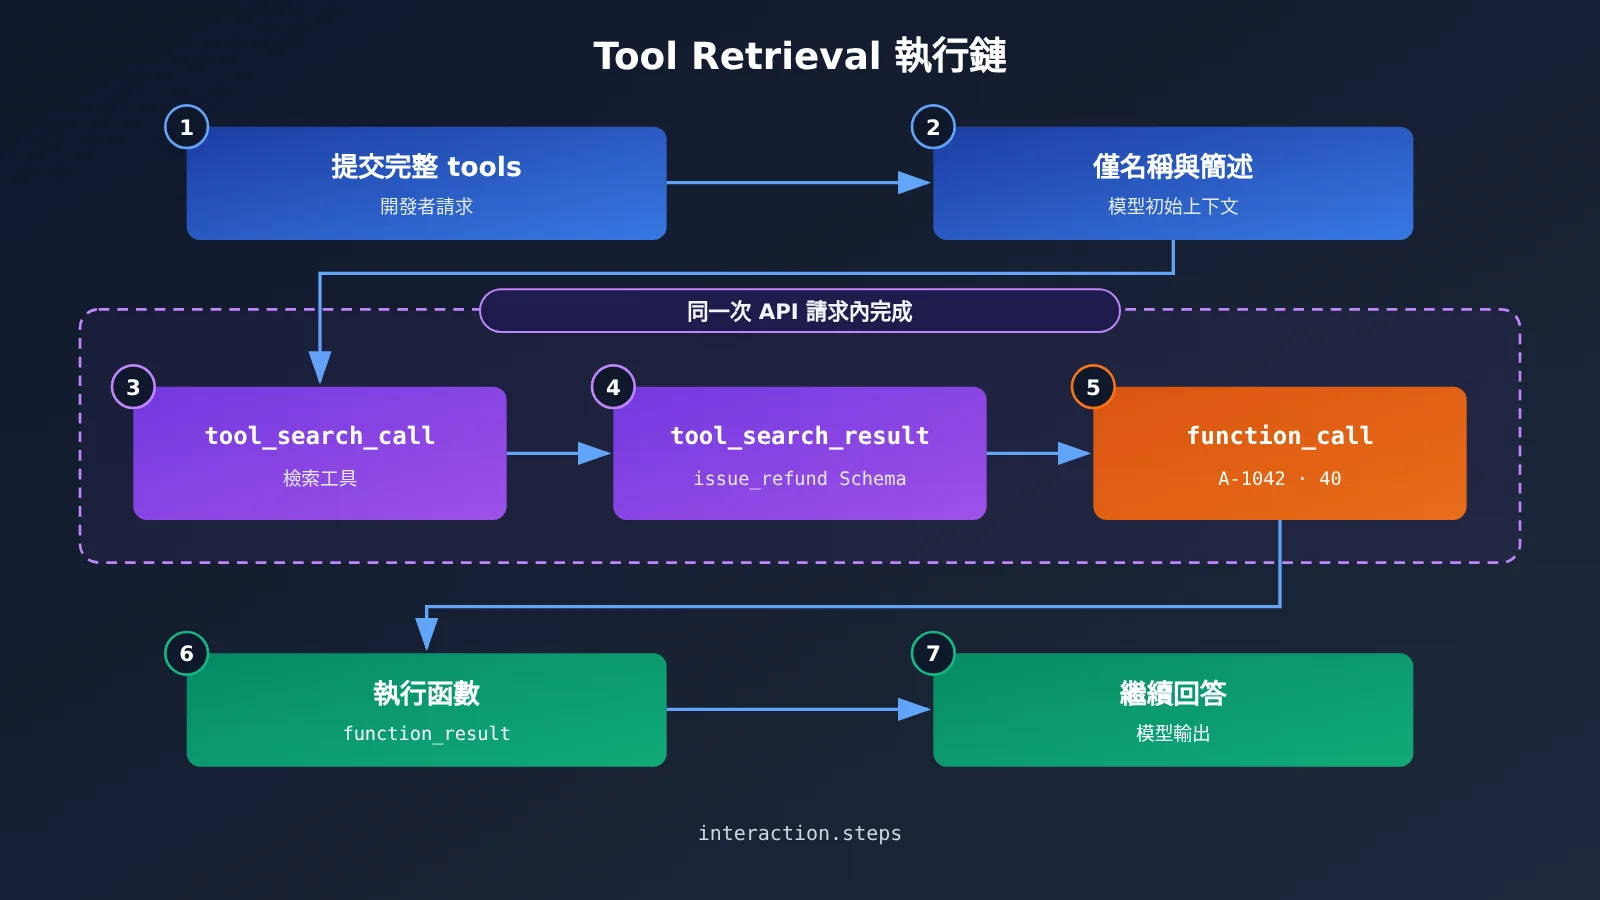
Tool Retrieval 的執行鏈:以官方退款案例爲例
Google 公告用了一個訂單退款場景:訂單 A-1042 的商品到貨時已損壞,用戶要求退款 40 美元,需要用到的工具是 issue_refund。服務端檢索的完整過程如下:
- 請求中聲明
{"type": "tool_search"},並對issue_refund等低頻工具設置defer_loading: true。 - 模型根據任務判斷需要退款能力,發起
tool_search_call。 - API 返回
tool_search_result,其中包含issue_refund的完整參數 Schema。 - 模型讀取參數定義,生成
function_call,參數爲order_id: "A-1042"和amount: 40。 - 應用執行函數並回傳
function_result,模型據此繼續完成任務。
搜索、載入和生成函數調用可以在同一次外部 API 請求內完成,所有步驟都能在 interaction.steps 中查看。但要注意,同一次請求不等於內部只推理一次,每次服務端搜索都會引發額外的、需要計費的模型調用。另外,這是演示案例,不代表任何退款成功率統計。
下面是依據官方文檔整理的示意代碼,直連 Google 端點,僅用於展示請求結構:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Function Calling 原有的職責分工沒有變化。對於自定義函數,API 只返回 function_call,執行退款、訪問數據庫、處理權限仍是應用的工作。只有連接遠程 MCP 服務器時,API 纔會代爲發起遠程調用,並返回 mcp_server_tool_call 和 mcp_server_tool_result。
Tool Retrieval 的混合加載、遠程 MCP 與兩種檢索模式
Google 推薦混合使用:高頻工具直接加載,低頻、專業化的長尾工具延遲加載。這樣簡單任務不必先搜索一輪,長尾能力也不會長期佔用上下文。遠程 MCP 服務器也可以整體設置延遲加載,例如對一個 type: "mcp_server" 的配置加上 defer_loading: true,該服務器暴露的工具就會按需載入,不必逐個聲明。
除了由 Gemini 完成檢索的服務端模式,官方還提供客戶端模式:開發者聲明一個 execution: "client" 的 tool_search,由自己的應用查詢工具註冊表,再把匹配的完整工具聲明放進 function_result.result 返回給模型。兩者的區別如下:
| 比較維度 | 服務端檢索 | 客戶端檢索 |
|---|---|---|
| 執行位置 | Gemini API 服務端(默認 server) |
開發者應用(client) |
| 是否需要自建檢索器 | 不需要 | 需要 |
| 是否需要提前聲明工具庫 | 需要 | 不需要,會話中可引入新工具 |
defer_loading |
適用 | 不適用 |
| 額外網絡往返 | 無需額外客戶端往返 | 每次搜索多一次往返 |
| 權限控制 | 由請求聲明的工具集決定 | 可結合自建的用戶級權限過濾 |
| 典型場景 | 大型、相對固定的工具集合 | 動態工具庫、多租戶、企業私有註冊表 |
客戶端模式返回的函數聲明應當是結構化對象,不能轉成 JSON 字符串。同一請求內不能混用兩種模式,且最多隻能聲明一個 tool_search。
Gemini API Tool Retrieval 支持哪些模型、價格如何
Google 公告的表述比較寬泛,稱 Gemini 3.6 及更新的模型均支持,包括所有 Gemini 4 模型。但開發文檔截至 11 月 20 日明確列出的只有 4 個模型 ID。落地時應以開發文檔爲準,對不支持的模型設置 defer_loading 會返回 HTTP 400。
| 模型 ID | 標準輸入價(美元/百萬 Tokens) | 標準輸出價(含 Thinking) | 備註 |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | 標有 Free Tier |
gemini-4-argon |
$2.00(12 月 1 日起 $4.00) | $10.00(12 月 1 日起 $20.00) | 無 Free Tier |
gemini-3.8-flash |
$0.75(2027 年 1 月 1 日起 $1.50) | $3.75(2027 年 1 月 1 日起 $7.50) | 標有 Free Tier |
gemini-3.6-flash |
$0.75(2027 年 1 月 1 日起 $1.50) | $3.75(2027 年 1 月 1 日起 $7.50) | 標有 Free Tier |
價格來自 Google Gemini Developer API 定價頁的 Standard 檔。Free Tier 的實際額度和速率限制需要按項目確認。
計費上,Google 明確表示 Tool Retrieval 沒有獨立的功能費,但這不等於搜索免費。延遲工具的簡述列表、開啓 tool_search 後增加的固定搜索指令、每次服務端檢索的額外推理、載入的完整 Schema 以及它在後續輪次中的保留,都會按所選模型的費率計 Token。觀察成本時要特別關注 total_tool_use_tokens 字段,它記錄了服務端搜索引發的額外模型調用輸入。只看首次輸入 Token 下降,很容易高估節省效果。
Tool Retrieval 的官方 Token 示意算例
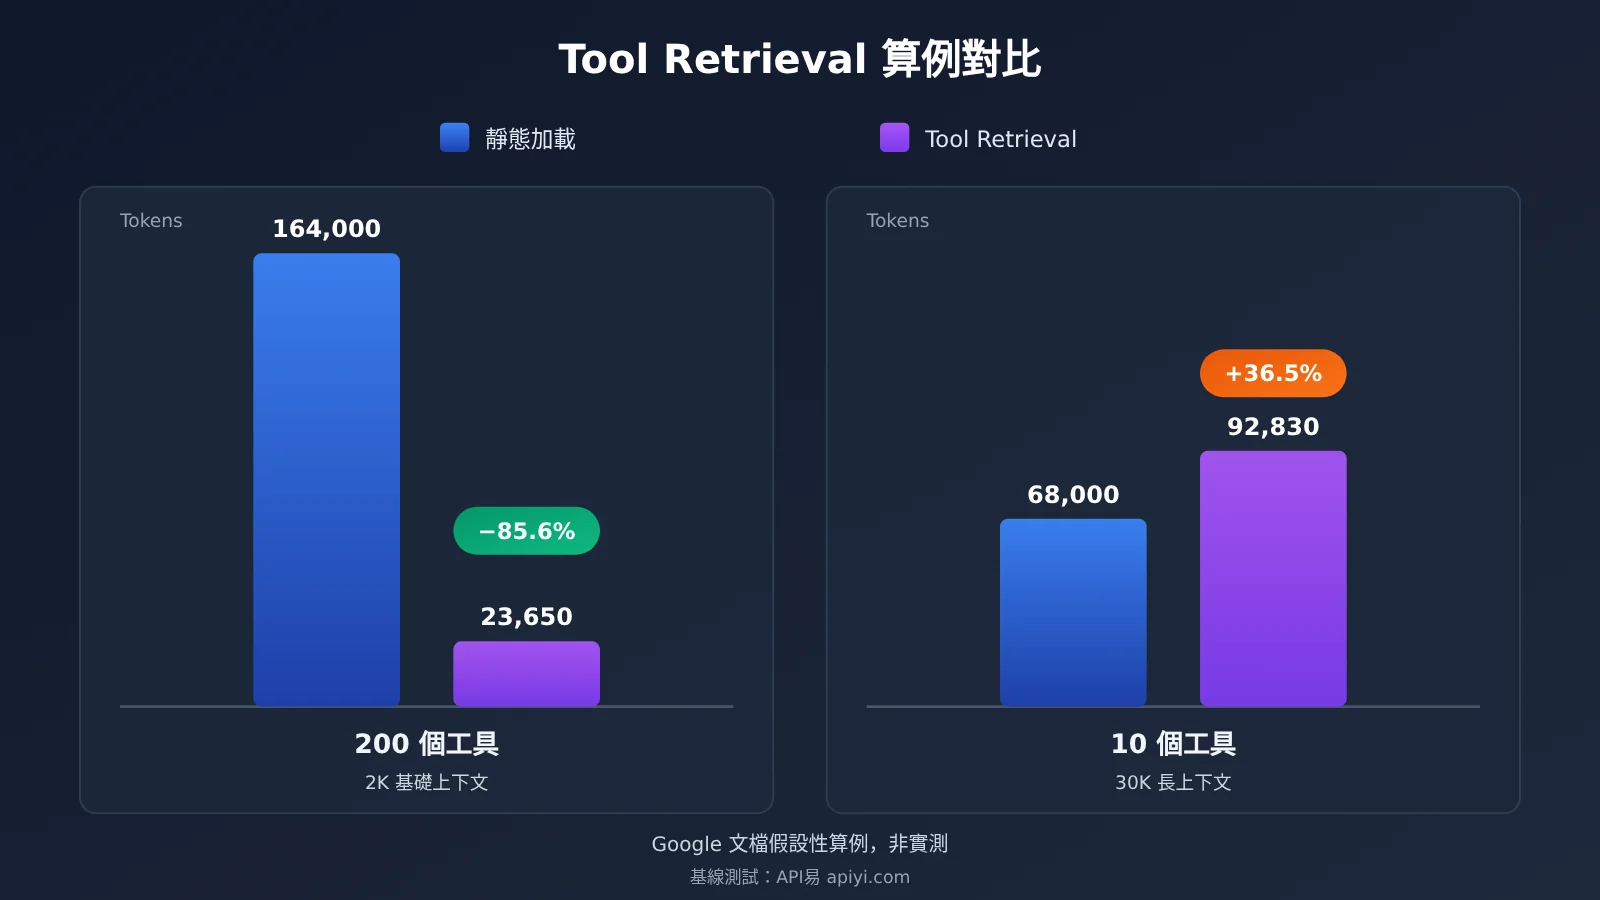
官方早期測試顯示,每個延遲工具在初始目錄中平均約佔 26 Tokens。這是近似值,不是固定開銷。文檔還給出了兩組假設性算例,結論方向相反:
| 場景(官方假設) | 靜態加載全部工具 | Tool Retrieval | 變化 |
|---|---|---|---|
| 200 個工具,每個 400 Tokens,基礎上下文 2,000,用到 2 個工具,共 2 次請求 | 164,000 | 約 23,650 | 減少約 85.6%(按算例推算) |
| 10 個工具,每個 400 Tokens,基礎上下文 30,000,用到 2 個工具,共 2 次請求 | 68,000 | 92,830 | 增加約 36.5%(按算例推算) |
第二組算例變貴的原因是服務端搜索要額外推理一次,並重新處理已經很長的上下文,而 10 個工具本身佔用不大,省下的 Schema 抵不過搜索開銷。兩組數字都是 Google 標明的假設性示例,沒有計入輸出 Token 和緩存收益,不是生產環境 Benchmark。截至資料覈查日,Google 沒有公佈這項功能實測的 Token 節省比例、延遲改善或工具選擇準確率提升。
緩存方面,Google 表示 Tool Retrieval 支持隱式緩存:完整 Schema 不出現在初始前綴中,系統指令和工具目錄等前綴更容易保持穩定。但文檔也提醒,延遲加載會讓初始提示詞變短,原本依賴大量 Schema 才能達到緩存最低門檻的請求,可能因此低於門檻。
Tool Retrieval 當前的使用限制
以下幾點來自官方文檔,在開發中最容易踩坑:
- 已加載工具無法卸載:Schema 一旦被檢索,就會在當前會話中一直保留。在很長的會話裏不斷檢索新工具,上下文仍會持續增長。
- 每次請求重新提交完整工具數組:包括
tool_search、全部延遲和非延遲工具、相關 MCP 配置。不能只交name和short_description而省略parameters。 - 系統指令直接點名的工具不要延遲:模型可能繞過搜索直接調用,導致缺少加載上下文而出錯。
- 無狀態會話要完整保留檢索步驟:使用
store=false自行管理歷史時,tool_search_call、tool_search_result及其signature不能刪改,否則可能返回 HTTP 400。 - 調試要看 steps:即使
interaction.status不是requires_action,結果中也可能含有待執行的function_call。 - 未命中時可能返回文本:服務端搜索找不到匹配工具時,不一定返回結構化錯誤。
分析判斷:Gemini API Tool Retrieval 對 Agent 開發意味着什麼
Tool Retrieval 的適用場景判斷
這次更新的實際價值,是把“維護一份完整工具清單”和“每輪推理都要讀完這份清單”拆成兩件事。工具庫可以繼續擴張,模型上下文裏常駐的只是一份很薄的目錄。對於持續接入新業務系統的團隊,這能減輕預先裁剪工具集的負擔,也減少爲了控制 Token 而在應用側每輪動態篩選工具、進而破壞緩存前綴的情況。
不過,官方算例已經說明收益是有條件的。結合官方工程建議,可以按下表初步判斷(這是工程選擇建議,不是硬性數量門檻):
| Agent 類型 | 工具特徵 | 建議 |
|---|---|---|
| 客服、業務流程助手 | 幾十個工具,少數查詢類高頻,退款、審批、合同等低頻 | 高頻直接加載,長尾用服務端檢索 |
| 多 MCP 服務器的研發/運維 Agent | 每個服務器工具多,單次任務只用一小部分 | 對 MCP 服務器整體設置 defer_loading |
| 多租戶、按權限開放工具的平臺 | 工具集合因用戶和工作區而變 | 客戶端檢索,結合自建註冊表和權限過濾 |
| 小型助手 | 少於約 20 個穩定工具,多數每輪都會用到 | 繼續靜態加載 |
| 長上下文 + 頻繁搜索 | 對話很長,每輪常需多次檢索 | 先測再決定,存在淨成本上升風險 |
我們的判斷是:工具調用分佈越“長尾”,Tool Retrieval 越值得用。反過來,如果大部分工具每輪都要用,延遲加載只會多出一次搜索推理。
遷移到 Tool Retrieval 前,先測出工具 Schema 的真實佔用
是否遷移,最可靠的依據是自己業務的數據。遷移前可以先用現有的 OpenAI 兼容 Function Calling 流程,測量“全量工具”和“只帶實際用到的工具”兩種請求的輸入 Token 差,得到工具 Schema 的真實佔用。下面的腳本做的是這種基線測量,並不是 Tool Retrieval 本身:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口,用於測量靜態加載基線
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查詢訂單 A-1042 的狀態"}]

for label, tools in [("全量 50 個工具", all_tools), ("僅 1 個工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
查看完整的基線測量腳本(按工具數量批量對比)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通過 API易 統一接口測量不同模型的工具 Schema 開銷
)

def load_tools(path: str) -> list:
    """從業務工具註冊表(JSON 文件)讀取 OpenAI 格式的工具定義"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"無工具基礎輸入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 個工具: {used} tokens, Schema 約佔 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查詢訂單 A-1042 的狀態")
🎯 技術建議:在評估 Tool Retrieval 之前,可以先通過 API易 apiyi.com 用一個 API Key 在多個主流模型上跑靜態加載基線,看清工具 Schema 在你的請求裏到底佔了多少 Token。拿到基線後,再到 Gemini Interactions API 中開啓
tool_search做對照,比較total_input_tokens與total_tool_use_tokens之和。
需要說明的是,Tool Retrieval 依賴 Interactions API 的 v1beta 接口和專用字段,上面的 OpenAI 兼容調用只用於測量靜態加載的開銷。對照測試時,建議保持模型、工具庫、任務集、上下文長度和緩存條件一致,再比較總計費成本、端到端耗時、正確工具選擇率和平均搜索次數,這樣才能把差異歸因到檢索策略上。如果想在同一套腳本里橫向看不同模型的基線差異,API易 apiyi.com 的統一接口能省去逐家接入的工作。
值得關注的後續發展(預測性判斷)
以下屬於判斷,不是已確認的事實。
第一,公告與開發文檔在支持模型範圍上存在差異,Gemini 4 Carbon、Gemini 4 Neon 等型號是否會進入兼容名單,需要關注文檔更新。第二,“已加載 Schema 無法卸載”是長會話 Agent 的明顯短板,正式版是否提供卸載或淘汰機制,會直接影響它在長任務裏的表現。第三,Google ADK 的用戶此前在 Issue #7241 中反饋過漸進式加載與緩存失效的問題,模型 API 支持了新能力,不代表框架會自動採用,框架層的適配節奏值得跟進。
按需加載工具定義的思路在業內此前已有先例,Google 這次屬於把它補進 Gemini 的 Agent 接口。由於 Preview 階段接口可能變動,生產系統接入時建議保留回退到靜態加載的開關。
關於 Gemini API Tool Retrieval 的幾個常見疑問
Q1:開了 Tool Retrieval,請求體會變小嗎?
不會。服務端模式下每次請求仍要提交完整工具數組,變小的是模型初始上下文裏的工具佔用。如果想先算清現有請求中工具定義的體量,可以用上文腳本通過 API易 apiyi.com 測出基線。
Q2:Google 官方說能省 85% 嗎?
沒有這樣的實測結論。85.6% 是按 200 工具的假設性算例推算出來的,同一份文檔還給出了小工具集下 Token 增加約 36.5% 的反例。
Q3:Tool Retrieval 收費嗎?
沒有單獨的功能費,但搜索指令、額外推理和載入的 Schema 都按模型費率計 Token。預算敏感的團隊可以先通過 API易 apiyi.com 按量計費地小規模測試不同模型的 Function Calling 開銷,再決定 Agent 的模型選型。
Q4:用了 Tool Retrieval,是不是不用自己執行函數了?
不是。自定義函數仍由應用執行並回傳結果,Tool Retrieval 只負責找到並載入工具定義。只有遠程 MCP 工具會由 API 代爲調用。
工具庫會越來越大,但每一輪真正需要的往往只是其中幾件。Tool Retrieval 把“備齊工具”和“隨時取用”分開處理,用得好能讓大型 Agent 更輕,用得不對也可能多付一輪推理的代價。正如《論語·衛靈公》所言:“工欲善其事,必先利其器。”先量清手裏每件“器”的分量,再決定怎麼擺放。
📚 參考資料
-
Google 官方公告:Introducing Tool Retrieval in the Gemini API(2026-11-19)
- 鏈接:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - 說明:發佈信息、設計目標、兩種檢索模式與定價原則
- 鏈接:
-
Google Tool Retrieval 開發文檔:配置、限制、計費與示意算例
- 鏈接:
aistudio.google.com/docs/tool-retrieval - 說明:支持模型列表、Usage 字段、最佳實踐與常見錯誤
- 鏈接:
-
Gemini Developer API 定價:模型標準價格與緩存費率
- 鏈接:
aistudio.google.com/docs/pricing - 說明:各模型輸入輸出單價及生效日期
- 鏈接:
-
Interactions API 文檔:接口定位與執行步驟
- 鏈接:
aistudio.google.com/docs/interactions-overview - 說明:有狀態對話、steps 結構及與 generateContent 的區別
- 鏈接:
-
Google Python SDK v3.6.0 與 Issue #2185:工程佐證與開發者需求記錄
- 鏈接:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - 鏈接:
github.com/googleapis/python-genai/issues/2185 - 說明:SDK 公共 Schema 更新與早期社區需求
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心