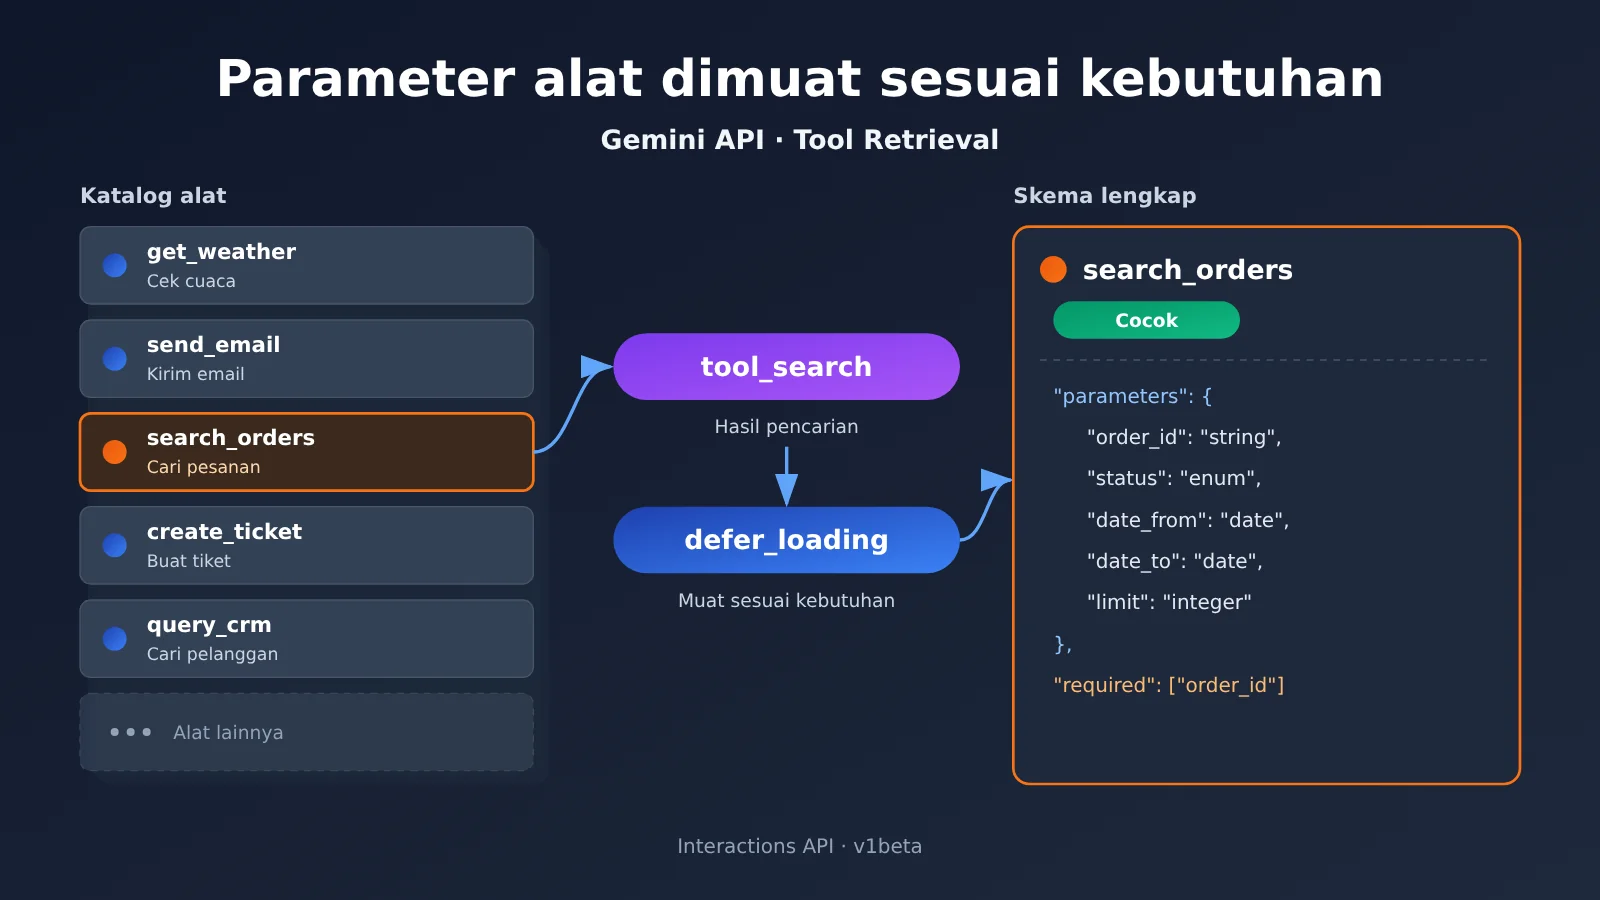
Pada 19 November 2026, Google merilis Tool Retrieval (pencarian tool) dalam bentuk Preview di Gemini Interactions API. Agent kini bisa melihat hanya nama dan deskripsi singkat tool terlebih dahulu, lalu memuat Schema parameter lengkap ke dalam konteks saat benar-benar perlu memanggilnya. Fitur ini terutama mengatasi masalah “tool yang diintegrasikan makin banyak, sementara konteks penuh oleh definisi tool yang menganggur”. Tool Retrieval paling cocok untuk Agent dengan jumlah tool banyak, pemanggilan terpusat pada sedikit tool frekuensi tinggi, dan sekaligus punya banyak tool long-tail. Bukan berarti semua aplikasi otomatis hemat hanya dengan mengaktifkannya.
Apa yang bisa Anda pelajari dari artikel ini?
- Apa sebenarnya yang diubah Tool Retrieval, dan mengapa “developer tetap harus mengirim deklarasi tool lengkap” serta “model tidak perlu membaca Schema lengkap lebih dulu” bisa berlaku bersamaan
- Rantai eksekusi lengkap dari registrasi tool hingga
function_call, serta pembagian kerja antara retrieval sisi server dan retrieval sisi klien - 4 ID model yang saat ini didukung secara eksplisit, harga standar, dan arti “tidak ada biaya fitur terpisah, tetapi Token tetap dihitung seperti biasa”
- Dua contoh perhitungan resmi dengan arah berlawanan: kapan bisa menghemat, kapan justru lebih mahal
- Batasan yang perlu diperhatikan sebelum integrasi, dan cara menilai apakah Agent Anda layak memakainya
Indeks: Bagian berikutnya dimulai dengan tabel konsep dan ringkasan dampak supaya Anda cepat selaras dengan latar belakang. Bagian “Fakta objektif” menjelaskan berturut-turut informasi rilis, mekanisme kerja, pemuatan hibrida dan MCP jarak jauh, model yang didukung beserta biayanya, dan batasan penggunaan — semuanya mengacu pada pengumuman resmi Google dan dokumentasi developer. Bagian “Analisis dan penilaian” memberikan penilaian skenario yang cocok, metode pengukuran baseline sebelum migrasi, dan beberapa pertanyaan umum; konten yang bersifat penilaian atau prediksi akan ditandai secara terpisah.
Konsep yang Perlu Diketahui (To Know) tentang Gemini API Tool Retrieval
| Konsep | Penjelasan Singkat |
|---|---|
| Tool Retrieval | Mencari tool yang diperlukan terlebih dahulu, lalu menambahkan definisi parameter lengkap tool yang cocok ke dalam konteks model |
| Interactions API | Antarmuka Gemini yang berorientasi Agent, mengelola riwayat interaksi, langkah eksekusi tool, dan output model. Sudah tersedia secara resmi pada Juni 2026 |
| Parameter Schema | Struktur yang mendeskripsikan parameter apa saja yang diterima fungsi, tipe datanya, serta mana yang wajib diisi, biasanya diekspresikan dengan JSON Schema |
| Function Calling | Model menghasilkan nama fungsi dan parameter, aplikasi mengeksekusi fungsi tersebut, kemudian mengembalikan hasilnya ke model |
tool_search |
Tipe tool yang mendeklarasikan mekanisme tool retrieval, melalui tool ini model mencari dan memuat definisi tool |
defer_loading |
Konfigurasi dalam mode sisi server yang menunda pemuatan definisi parameter lengkap tool hingga tool tersebut ditemukan lewat retrieval |
short_description |
Deskripsi singkat tool yang ditunda, digunakan model untuk mengenali tool dalam katalog awal |
| Remote MCP | Tool yang dihubungkan melalui Model Context Protocol ke luar aplikasi, disediakan oleh layanan pihak ketiga |
| Implicit caching | Platform secara otomatis menggunakan kembali prefix konteks yang sama, bagian yang cocok ditagih dengan tarif input cache |
Ringkasan Dampak Gemini API Tool Retrieval
- Developer yang sedang menghubungkan banyak tool bisnis ke Agent: Kini tidak perlu membangun tool retriever sendiri, biarkan model membaca Schema dari puluhan bahkan ratusan tool sesuai kebutuhan. Namun tetap perlu mengirimkan array tool lengkap pada setiap request, sekaligus mengevaluasi ulang caching dan penagihan. Sebelum migrasi, disarankan mengukur dulu berapa banyak tool definition yang sebenarnya terpakai menggunakan alur Function Calling yang ada, dan bisa memanfaatkan antarmuka multi-model terpadu seperti APIYI apiyi.com untuk cepat membuat baseline pembanding.
- Penanggung jawab produk dan biaya: Tidak ada biaya fitur terpisah, tetapi setiap pencarian sisi server memicu inferensi model tambahan. Apakah menghemat biaya bergantung pada skala tool, panjang konteks, dan frekuensi pencarian. Perlu diverifikasi melalui kolom tagihan, tidak bisa hanya melihat arah promosi.
- Aplikasi dengan sedikit tool dan pemanggilan yang stabil: Contoh perhitungan resmi menunjukkan bahwa pada toolset kecil yang ditambah konteks panjang, total Token justru meningkat, sehingga tetap memuat langsung adalah pilihan yang lebih aman.
- Tim yang menggunakan framework Agent: Ini adalah kemampuan baru di level model API, dan framework belum tentu langsung beradaptasi. Untuk masalah pemuatan bertahap di level framework, jangan menganggapnya sudah teratasi secara default.
Fakta Objektif: Apa yang Dirilis Gemini API Tool Retrieval
Informasi dan Latar Belakang Rilis Gemini API Tool Retrieval
Blog resmi Google merilis “Introducing Tool Retrieval in the Gemini API” pada 19 November 2026. Penulisnya adalah Lucia Loher, Product Manager Gemini API, dan Nora Kassner, Research Scientist Google DeepMind. Fitur ini saat ini berada di tahap Preview, hanya bisa digunakan di Interactions API, dan membutuhkan versi v1beta. Metode lama generateContent tidak mendukungnya.
Persiapan dari sisi engineering sudah dilakukan sebelum pengumuman. Pada 18 November, SDK Python resmi Google merilis v3.6.0, dan changelog-nya menyebutkan penambahan Skema publik terkait Tool Retrieval dan hasil fungsi. Di hari yang sama, SDK Go v1.79.0 juga memuat pembaruan serupa. Dari lini masa ini terlihat bahwa yang dilakukan adalah melengkapi kemampuan penemuan tool dan pemuatan sesuai kebutuhan pada Interactions API yang sudah GA, bukan meluncurkan produk API baru.
Kebutuhan developer juga tercatat. Pada 18 Maret 2026, seorang developer membuka Issue #2185 di repositori Python SDK, meminta dukungan defer_loading dan tool_search. Alasannya, setelah Agent terhubung ke lebih dari 30 tool, Skema lengkap membuat konteks membengkak. Maintainer Google merespons pada 20 Maret dan mencatatnya sebagai permintaan fitur. Ini adalah masukan kebutuhan, bukan pengujian performa.
Dalam satu kalimat, Tool Retrieval bisa dijelaskan begini: tool dapat ditemukan lebih dulu, lalu parameter spesifiknya dibaca saat benar-benar perlu dipanggil.
Bagaimana Tool Retrieval Mengubah Cara Memuat Skema Tool
Dalam pemuatan statis tradisional, meskipun pengguna hanya ingin memproses satu pengembalian dana, deklarasi parameter untuk puluhan tool seperti pesanan, logistik, inventaris, CRM, dan lainnya tetap masuk ke konteks pada setiap inferensi. Dokumentasi Google menyebutkan bahwa puluhan deklarasi fungsi dapat memakan puluhan ribu Token. Hal ini akan menggeser ruang riwayat percakapan; semakin banyak tool yang serupa, semakin besar kemungkinan mengganggu model dalam memilih tool yang tepat.
Kunci Tool Retrieval terletak pada membedakan tiga lapisan:
- Lapisan permintaan API: Pengembang tetap mengirimkan definisi tool lengkap seperti biasa, termasuk skema parameter.
- Konteks awal model: Tool yang ditandai dengan
defer_loading: truehanya muncul dalam bentuk nama ditambahshort_description. Jika ringkasan singkat tidak dikonfigurasi, maka yang dipakai adalah kalimat pertama daridescriptionlengkap. - Tahap pemanggilan tool: Setelah tool ditemukan oleh pencarian, skema lengkap baru masuk ke konteks, dan model menghasilkan pemanggilan berparameter berdasarkan skema tersebut.
Jadi, frasa “tidak lagi memuat semua parameter tool setiap kali” dalam judul secara akurat berarti model tidak lagi membaca semua parameter lengkap terlebih dahulu di setiap putaran, bukan berarti pengembang tidak perlu lagi mengirim deklarasi lengkap. Dalam mode sisi server, dokumentasi resmi mewajibkan setiap permintaan mengirim ulang array tools lengkap, bahkan saat menggunakan previous_interaction_id pun tidak ada pengecualian.
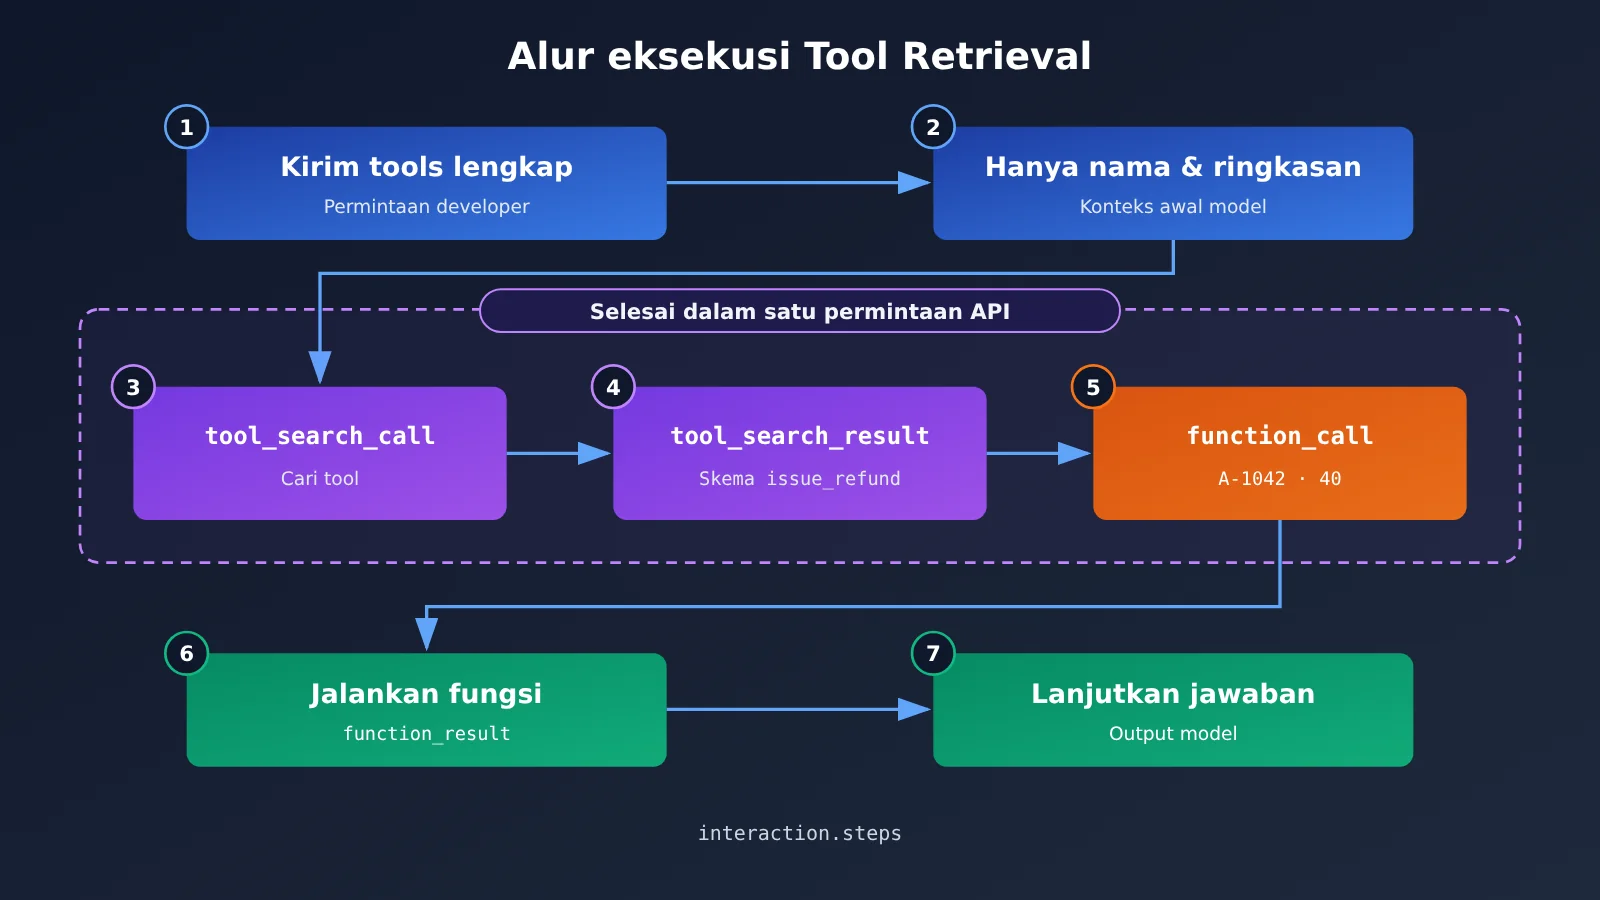
Rantai eksekusi Tool Retrieval: contoh resmi kasus pengembalian dana
Pengumuman Google menggunakan skenario pengembalian dana pesanan: barang pada pesanan A-1042 tiba dalam kondisi rusak, pengguna meminta pengembalian dana sebesar 40 dolar AS, dan tool yang perlu digunakan adalah issue_refund. Proses lengkap pencarian di sisi server adalah sebagai berikut:
- Dalam permintaan, deklarasikan
{"type": "tool_search"}, dan seteldefer_loading: trueuntuk tool frekuensi rendah sepertiissue_refund. - Model menilai berdasarkan tugas bahwa kemampuan pengembalian dana diperlukan, lalu memulai
tool_search_call. - API mengembalikan
tool_search_result, yang berisi skema parameter lengkap untukissue_refund. - Model membaca definisi parameter, menghasilkan
function_call, dengan parameterorder_id: "A-1042"danamount: 40. - Aplikasi mengeksekusi fungsi dan mengirim kembali
function_result, lalu model melanjutkan penyelesaian tugas berdasarkan hasil tersebut.
Pencarian, pemuatan, dan pembuatan pemanggilan fungsi dapat diselesaikan dalam satu permintaan API eksternal yang sama, dan semua langkah dapat dilihat di interaction.steps. Namun perlu diperhatikan, satu permintaan yang sama bukan berarti hanya ada satu inferensi internal; setiap pencarian di sisi server akan memicu pemanggilan model tambahan yang dikenai biaya. Selain itu, ini adalah kasus demonstrasi dan tidak mewakili statistik tingkat keberhasilan pengembalian dana apa pun.
Berikut adalah kode ilustratif yang disusun berdasarkan dokumentasi resmi, terhubung langsung ke endpoint Google, dan hanya digunakan untuk menunjukkan struktur permintaan:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Pembagian tanggung jawab yang sudah ada pada Function Calling tidak berubah. Untuk fungsi kustom, API hanya mengembalikan function_call; mengeksekusi pengembalian dana, mengakses database, dan menangani izin tetap menjadi tugas aplikasi. Hanya saat terhubung ke server MCP jarak jauh, API akan melakukan pemanggilan jarak jauh atas nama aplikasi dan mengembalikan mcp_server_tool_call serta mcp_server_tool_result.
Pemuatan campuran Tool Retrieval, MCP jarak jauh, dan dua mode retrieval
Google merekomendasikan pendekatan campuran: alat yang sering digunakan dimuat langsung, sedangkan alat long-tail yang jarang dipakai dan sangat terspesialisasi dimuat secara tertunda. Dengan begitu, tugas sederhana tidak perlu melewati satu putaran pencarian terlebih dahulu, dan kemampuan long-tail juga tidak akan menempati jendela konteks dalam waktu lama. Server MCP jarak jauh pun bisa diatur agar dimuat tertunda secara keseluruhan—misalnya dengan menambahkan defer_loading: true pada konfigurasi type: "mcp_server", maka alat yang diekspos server tersebut akan dimuat sesuai kebutuhan, tanpa perlu dideklarasikan satu per satu.
Selain mode sisi server di mana Gemini yang menjalankan retrieval, pihak resmi juga menyediakan mode klien: developer mendeklarasikan tool_search dengan execution: "client", lalu aplikasi miliknya sendiri yang menanyakan registri alat, kemudian menempatkan deklarasi alat lengkap yang cocok ke dalam function_result.result untuk dikembalikan ke model. Perbedaan keduanya adalah sebagai berikut:
| Dimensi perbandingan | Retrieval sisi server | Retrieval sisi klien |
|---|---|---|
| Lokasi eksekusi | Sisi server Gemini API (default server) |
Aplikasi developer (client) |
| Perlu membangun retriever sendiri | Tidak perlu | Perlu |
| Perlu mendeklarasikan pustaka alat terlebih dahulu | Perlu | Tidak perlu, alat baru bisa dimasukkan dalam sesi |
defer_loading |
Berlaku | Tidak berlaku |
| Perjalanan bolak-balik jaringan tambahan | Tidak perlu perjalanan bolak-balik klien tambahan | Setiap pencarian menambah satu perjalanan bolak-balik |
| Kontrol izin | Ditentukan oleh kumpulan alat yang dideklarasikan dalam permintaan | Dapat digabungkan dengan filter izin tingkat pengguna yang dibangun sendiri |
| Skenario umum | Kumpulan alat besar dan relatif tetap | Pustaka alat dinamis, multi-tenant, registri privat perusahaan |
Deklarasi fungsi yang dikembalikan oleh mode klien harus berupa objek terstruktur dan tidak boleh diubah menjadi string JSON. Dalam satu permintaan, kedua mode tidak boleh dicampur, dan paling banyak hanya satu tool_search yang dapat dideklarasikan.
Model apa saja yang didukung Tool Retrieval di Gemini API, dan bagaimana harganya?
Pengumuman Google cukup luas, menyebut Gemini 3.6 dan model yang lebih baru semuanya mendukung, termasuk semua model Gemini 4. Namun, hingga 20 November, dokumentasi developer hanya secara eksplisit mencantumkan 4 ID model. Saat implementasi, patokan yang sebaiknya dipakai adalah dokumentasi developer: jika defer_loading diatur pada model yang tidak didukung, API akan mengembalikan HTTP 400.
| ID Model | Harga input standar (USD per juta Token) | Harga output standar (termasuk Thinking) | Catatan |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Ditandai Free Tier |
gemini-4-argon |
$2.00 (mulai 1 Desember $4.00) | $10.00 (mulai 1 Desember $20.00) | Tidak ada Free Tier |
gemini-3.8-flash |
$0.75 (mulai 1 Januari 2027 $1.50) | $3.75 (mulai 1 Januari 2027 $7.50) | Ditandai Free Tier |
gemini-3.6-flash |
$0.75 (mulai 1 Januari 2027 $1.50) | $3.75 (mulai 1 Januari 2027 $7.50) | Ditandai Free Tier |
Harga di atas berasal dari tingkat Standard di halaman harga Google Gemini Developer API. Kuota dan batas laju aktual untuk Free Tier perlu dikonfirmasi per proyek.
Dalam hal penagihan, Google menegaskan bahwa Tool Retrieval tidak punya biaya fitur terpisah. Namun, itu bukan berarti pencariannya gratis. Daftar ringkas tool yang ditunda pemuatannya, instruksi pencarian tetap yang ditambahkan setelah tool_search diaktifkan, inferensi tambahan dari setiap pencarian di sisi server, Schema lengkap yang dimuat, serta retensinya pada giliran berikutnya, semuanya dihitung sebagai Token sesuai tarif model yang dipilih. Saat mengamati biaya, perhatikan khususnya field total_tool_use_tokens, yang mencatat input tambahan untuk pemanggilan model yang dipicu oleh pencarian di sisi server. Kalau hanya melihat penurunan Token input pertama, sangat mudah untuk melebih-lebihkan penghematan yang didapat.
Contoh Perhitungan Token Resmi Tool Retrieval
Pengujian awal resmi menunjukkan bahwa setiap tool yang dimuat tertunda (lazy-loaded) dalam katalog awal rata-rata menempati sekitar 26 Token. Ini adalah angka perkiraan, bukan biaya tetap. Dokumentasi juga memberikan dua contoh perhitungan hipotetis dengan kesimpulan yang saling berlawanan arah:
| Skenario (asumsi resmi) | Memuat semua tool secara statis | Tool Retrieval | Perubahan |
|---|---|---|---|
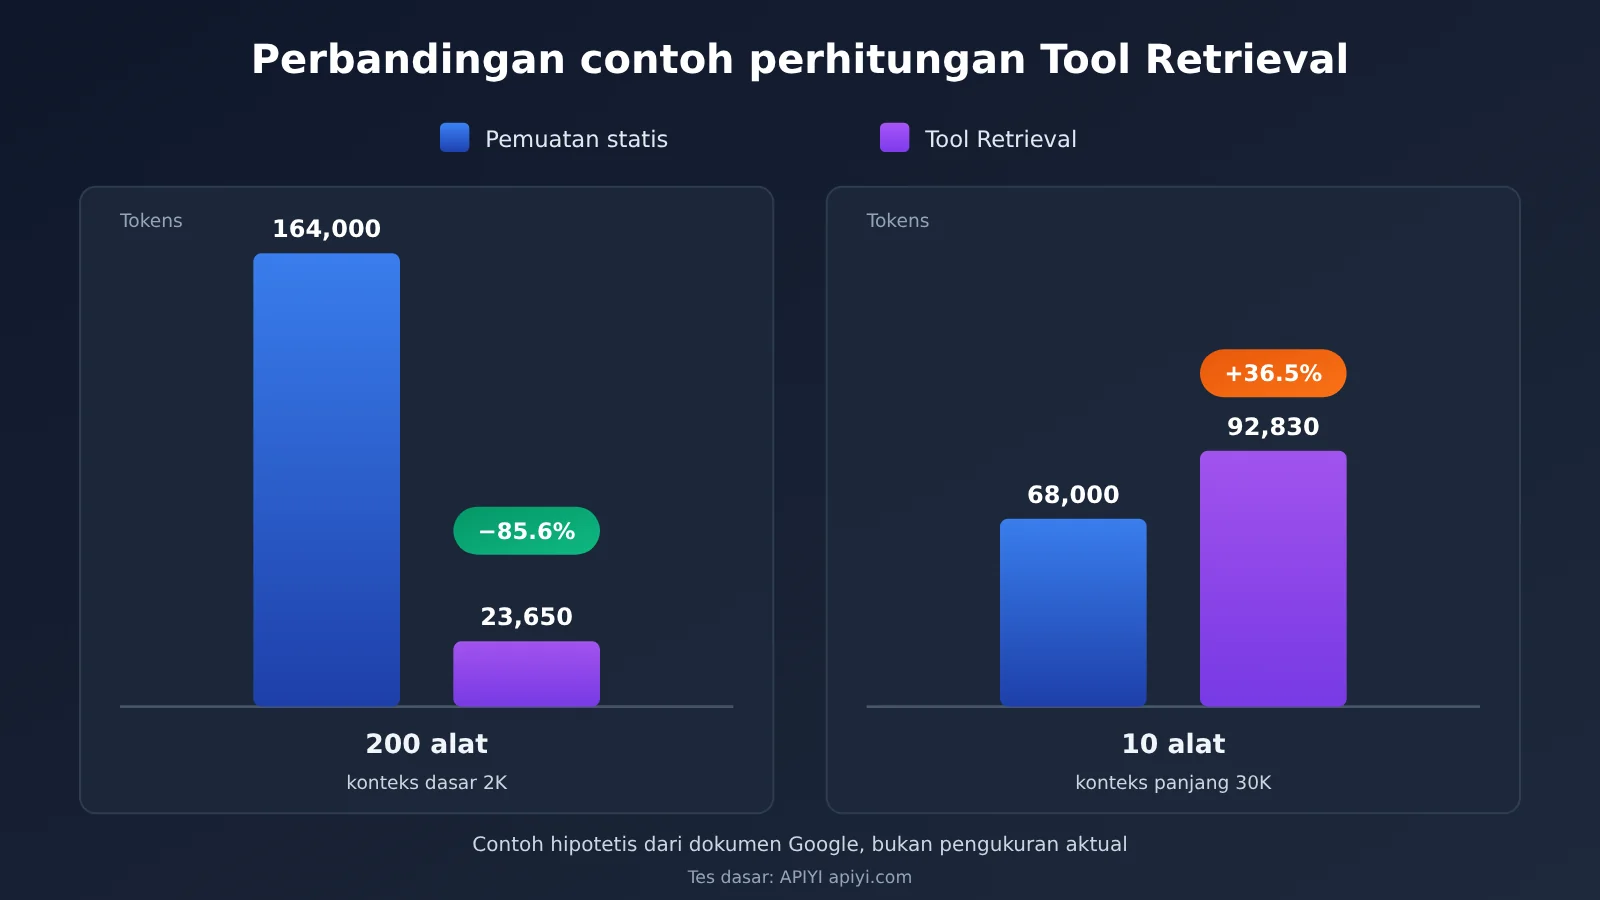
| 200 tool, masing-masing 400 Token, konteks dasar 2,000, memakai 2 tool, total 2 permintaan | 164,000 | sekitar 23,650 | berkurang sekitar 85.6% (berdasarkan perhitungan contoh) |
| 10 tool, masing-masing 400 Token, konteks dasar 30,000, memakai 2 tool, total 2 permintaan | 68,000 | 92,830 | bertambah sekitar 36.5% (berdasarkan perhitungan contoh) |
Alasan kelompok contoh kedua menjadi lebih mahal adalah karena pencarian di sisi server perlu satu kali inferensi tambahan dan memproses ulang konteks yang sudah sangat panjang, sementara 10 tool itu sendiri tidak menempati banyak ruang, sehingga Schema yang dihemat tidak sebanding dengan biaya pencarian. Kedua angka tersebut adalah contoh hipotetis yang ditandai Google, tidak memperhitungkan Token output dan keuntungan caching, dan bukan Benchmark lingkungan produksi. Hingga tanggal verifikasi materi, Google belum mempublikasikan rasio penghematan Token, peningkatan latensi, atau peningkatan akurasi pemilihan tool dari pengujian nyata fitur ini.
Dari sisi caching, Google menyatakan Tool Retrieval mendukung caching implisit: Schema lengkap tidak muncul di prefix awal, sehingga prefix seperti instruksi sistem dan katalog tool lebih mudah dijaga stabil. Namun dokumentasi juga mengingatkan bahwa pemuatan tertunda membuat petunjuk awal menjadi lebih pendek, sehingga permintaan yang tadinya bergantung pada banyak Schema untuk mencapai ambang minimum cache bisa jadi turun di bawah ambang tersebut.
Batasan penggunaan Tool Retrieval saat ini
Beberapa poin berikut berasal dari dokumentasi resmi dan paling rawan menimbulkan masalah saat pengembangan:
- Alat yang sudah dimuat tidak dapat dilepas: Begitu Schema diambil melalui retrieval, ia akan tetap tersimpan selama sesi berlangsung. Dalam sesi yang sangat panjang, terus me-retrieval alat baru tetap membuat konteks terus bertambah.
- Setiap permintaan mengirim ulang seluruh array alat: termasuk
tool_search, semua alat yang di-defer dan tidak di-defer, serta konfigurasi MCP terkait. Tidak bisa hanya mengirimnamedanshort_descriptionlalu menghilangkanparameters. - Jangan menunda alat yang disebut langsung dalam instruksi sistem: Model dapat melewati pencarian dan memanggilnya langsung, sehingga terjadi error karena konteks pemuatan tidak lengkap.
- Sesi stateless harus mempertahankan langkah retrieval secara utuh: Saat menggunakan
store=falsedan mengelola riwayat sendiri,tool_search_call,tool_search_result, dansignature-nya tidak boleh dihapus atau diubah, jika tidak bisa mengembalikan HTTP 400. - Saat debugging, perhatikan steps: Meskipun
interaction.statusbukanrequires_action, hasilnya bisa tetap berisifunction_callyang menunggu dieksekusi. - Saat tidak ada kecocokan, hasilnya bisa berupa teks: Ketika pencarian di sisi server tidak menemukan alat yang cocok, responsnya belum tentu berupa error terstruktur.
Analisis: Apa Arti Gemini API Tool Retrieval bagi Pengembangan Agent
Penilaian Skenario Penggunaan Tool Retrieval
Nilai nyata dari pembaruan ini adalah memisahkan dua hal: “memelihara daftar alat yang lengkap” dan “membaca seluruh daftar itu di setiap putaran penalaran”. Pustaka alat bisa terus berkembang, sementara yang menetap di konteks model hanyalah katalog yang sangat tipis. Bagi tim yang terus mengintegrasikan sistem bisnis baru, ini meringankan beban pemangkasan kumpulan alat di awal, sekaligus mengurangi situasi di mana—demi mengendalikan Token—aplikasi menyaring alat secara dinamis di setiap putaran sehingga merusak prefiks cache.
Namun, contoh perhitungan resmi sudah menunjukkan bahwa manfaatnya bersifat kondisional. Dengan menggabungkan saran engineering resmi, kita bisa melakukan penilaian awal lewat tabel berikut (ini adalah saran pilihan engineering, bukan ambang jumlah yang mutlak):
| Jenis Agent | Karakteristik alat | Saran |
|---|---|---|
| Layanan pelanggan, asisten proses bisnis | Puluhan alat, sebagian kecil alat kueri berfrekuensi tinggi; refund, persetujuan, kontrak, dsb berfrekuensi rendah | Yang berfrekuensi tinggi dimuat langsung, ekor panjang pakai retrieval sisi server |
| Agent R&D/operasional dengan banyak server MCP | Tiap server punya banyak alat, satu tugas hanya memakai sebagian kecil | Setel defer_loading secara keseluruhan untuk server MCP |
| Platform multi-tenant yang membuka alat berdasarkan izin | Kumpulan alat berubah sesuai pengguna dan workspace | Retrieval sisi klien, dikombinasikan dengan registri buatan sendiri dan penyaringan izin |
| Asisten kecil | Kurang dari sekitar 20 alat stabil, sebagian besar dipakai di tiap putaran | Tetap muat statis |
| Konteks panjang + pencarian sering | Percakapan sangat panjang, tiap putaran sering butuh beberapa kali retrieval | Uji dulu baru putuskan, ada risiko kenaikan biaya bersih |
Penilaian kami: semakin “ekor panjang” distribusi pemanggilan alat, semakin layak Tool Retrieval digunakan. Sebaliknya, jika sebagian besar alat dipakai di setiap putaran, pemuatan tertunda hanya akan menambah satu putaran penalaran pencarian ekstra.
Sebelum Bermigrasi ke Tool Retrieval, Ukur Dulu Pemakaian Nyata Skema Tool
Apakah perlu bermigrasi atau tidak, patokan paling andal adalah data bisnis Anda sendiri. Sebelum bermigrasi, Anda bisa lebih dulu memakai alur Function Calling yang kompatibel dengan OpenAI yang sudah ada untuk mengukur selisih Token input antara dua jenis permintaan—”semua tool” dan “hanya tool yang benar-benar dipakai”—sehingga ketahuan pemakaian nyata Skema tool. Skrip di bawah ini melakukan pengukuran baseline semacam itu, bukan Tool Retrieval itu sendiri:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI, dipakai untuk mengukur baseline pemuatan statis
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
Lihat skrip pengukuran baseline lengkap (perbandingan batch berdasarkan jumlah tool)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mengukur biaya Skema tool dari berbagai model lewat antarmuka terpadu APIYI
)

def load_tools(path: str) -> list:
    """Membaca definisi tool berformat OpenAI dari registri tool bisnis (file JSON)"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 Saran teknis: Sebelum mengevaluasi Tool Retrieval, Anda bisa lebih dulu menjalankan baseline pemuatan statis di beberapa model populer lewat APIYI apiyi.com dengan satu kunci API, supaya jelas terlihat berapa Token yang sebenarnya dipakai Skema tool dalam permintaan Anda. Setelah baseline didapat, aktifkan
tool_searchdi Gemini Interactions API sebagai pembanding, lalu bandingkan jumlahtotal_input_tokensdantotal_tool_use_tokens.
Perlu dicatat, Tool Retrieval bergantung pada antarmuka v1beta dan field khusus dari Interactions API; pemanggilan yang kompatibel dengan OpenAI di atas hanya dipakai untuk mengukur biaya pemuatan statis. Saat uji pembanding, sebaiknya model, pustaka tool, set tugas, panjang konteks, dan kondisi cache dijaga tetap sama, lalu bandingkan total biaya penagihan, waktu proses end-to-end, tingkat ketepatan pemilihan tool, dan rata-rata jumlah pencarian—supaya perbedaan bisa diatribusikan ke strategi retrieval. Kalau ingin melihat perbedaan baseline antar model secara berdampingan dalam satu set skrip, antarmuka terpadu APIYI apiyi.com bisa menghemat pekerjaan integrasi satu per satu.
Perkembangan lanjutan yang perlu diperhatikan (penilaian prediktif)
Berikut ini adalah penilaian, bukan fakta yang sudah dikonfirmasi.
Pertama, ada perbedaan antara pengumuman dan dokumentasi pengembang soal cakupan model yang didukung; apakah model seperti Gemini 4 Carbon dan Gemini 4 Neon akan masuk daftar kompatibel masih perlu dipantau lewat pembaruan dokumentasi. Kedua, “Schema yang sudah dimuat tidak bisa dilepas” adalah kelemahan yang jelas pada Agent dengan sesi panjang; apakah versi resmi menyediakan mekanisme pelepasan atau penghapusan akan langsung memengaruhi performanya pada tugas-tugas panjang. Ketiga, pengguna Google ADK sebelumnya pernah melaporkan masalah pemuatan progresif dan invalidasi cache di Issue #7241; model API mendukung kemampuan baru bukan berarti framework akan otomatis memakainya, jadi ritme adaptasi di lapisan framework layak diikuti.
Ide memuat definisi tool sesuai kebutuhan sebenarnya sudah ada precedents di industri; Google kali ini pada dasarnya menambahkannya ke antarmuka Agent Gemini. Karena antarmuka pada tahap Preview bisa berubah, saat mengintegrasikan ke sistem produksi sebaiknya tetap sediakan sakelar untuk kembali ke pemuatan statis.
Beberapa pertanyaan umum tentang Gemini API Tool Retrieval
Q1:Kalau Tool Retrieval diaktifkan, apakah body request jadi lebih kecil?
Tidak. Dalam mode sisi server, setiap request tetap harus mengirimkan array tool secara lengkap; yang mengecil adalah ruang yang dipakai tool di konteks awal model. Jika ingin menghitung dulu besaran definisi tool dalam request yang ada sekarang, Anda bisa memakai skrip di atas lewat APIYI apiyi.com untuk mengukur baseline.
Q2:Apakah Google resmi bilang bisa menghemat 85%?
Tidak ada kesimpulan dari pengujian nyata seperti itu. Angka 85,6% dihitung dari contoh hipotetis dengan 200 tool, dan dokumen yang sama juga memberikan contoh sebaliknya di mana pada kumpulan tool kecil Token justru bertambah sekitar 36,5%.
Q3:Apakah Tool Retrieval berbayar?
Tidak ada biaya fitur terpisah, tetapi instruksi pencarian, inferensi tambahan, dan Schema yang dimuat semuanya dihitung sebagai Token sesuai tarif model. Tim yang sensitif terhadap anggaran bisa lebih dulu menguji biaya Function Calling berbagai model dalam skala kecil dengan penagihan per penggunaan lewat APIYI apiyi.com, lalu memutuskan pemilihan model untuk Agent.
Q4:Kalau memakai Tool Retrieval, apakah tidak perlu mengeksekusi fungsi sendiri lagi?
Bukan. Fungsi kustom tetap dieksekusi oleh aplikasi dan hasilnya dikirim balik; Tool Retrieval hanya bertugas menemukan dan memuat definisi tool. Hanya tool MCP jarak jauh yang dipanggil oleh API atas nama Anda.
Pustaka tool akan terus membesar, tetapi yang benar-benar dibutuhkan di setiap ronde biasanya hanya beberapa di antaranya. Tool Retrieval memisahkan “menyiapkan semua tool” dan “mengambil sesuai kebutuhan”; kalau dipakai dengan tepat, Agent besar bisa jadi lebih ringan, tapi kalau salah pakai, Anda bisa membayar harga satu ronde inferensi ekstra. Seperti yang dikatakan dalam 《论语·卫灵公》: “Ingin mengerjakan pekerjaan dengan baik, seseorang harus lebih dulu mengasah alatnya.” Ukur dulu berat tiap “alat” di tangan Anda, baru tentukan bagaimana menatanya.
📚 Referensi
-
Pengumuman resmi Google: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Tautan:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Keterangan: Informasi rilis, tujuan desain, dua mode pengambilan, dan prinsip penetapan harga
- Tautan:
-
Dokumentasi pengembang Google Tool Retrieval: Konfigurasi, batasan, penagihan, dan contoh perhitungan ilustratif
- Tautan:
aistudio.google.com/docs/tool-retrieval - Keterangan: Daftar model yang didukung, field Usage, praktik terbaik, dan kesalahan umum
- Tautan:
-
Harga Gemini Developer API: Harga standar model dan tarif cache
- Tautan:
aistudio.google.com/docs/pricing - Keterangan: Harga satuan input/output setiap model serta tanggal berlakunya
- Tautan:
-
Dokumentasi Interactions API: Posisi antarmuka dan langkah eksekusi
- Tautan:
aistudio.google.com/docs/interactions-overview - Keterangan: Percakapan stateful, struktur steps, dan perbedaannya dengan generateContent
- Tautan:
-
Google Python SDK v3.6.0 dan Issue #2185: Bukti rekayasa dan catatan kebutuhan pengembang
- Tautan:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - Tautan:
github.com/googleapis/python-genai/issues/2185 - Keterangan: Pembaruan Schema publik SDK dan kebutuhan komunitas pada masa awal
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama APIYI apiyi.com; untuk materi integrasi lainnya, kunjungi pusat dokumentasi docs.apiyi.com