Hinweis des Autors: Der Einführungspreis für Gemini 4 Carbon läuft am 30. November aus. Dieser Artikel hilft dir, vor Ablauf die Rechnung noch einmal neu aufzustellen und die Integrationsschicht so umzubauen, dass beim Modellwechsel nur ID und Endpunkt geändert werden müssen.
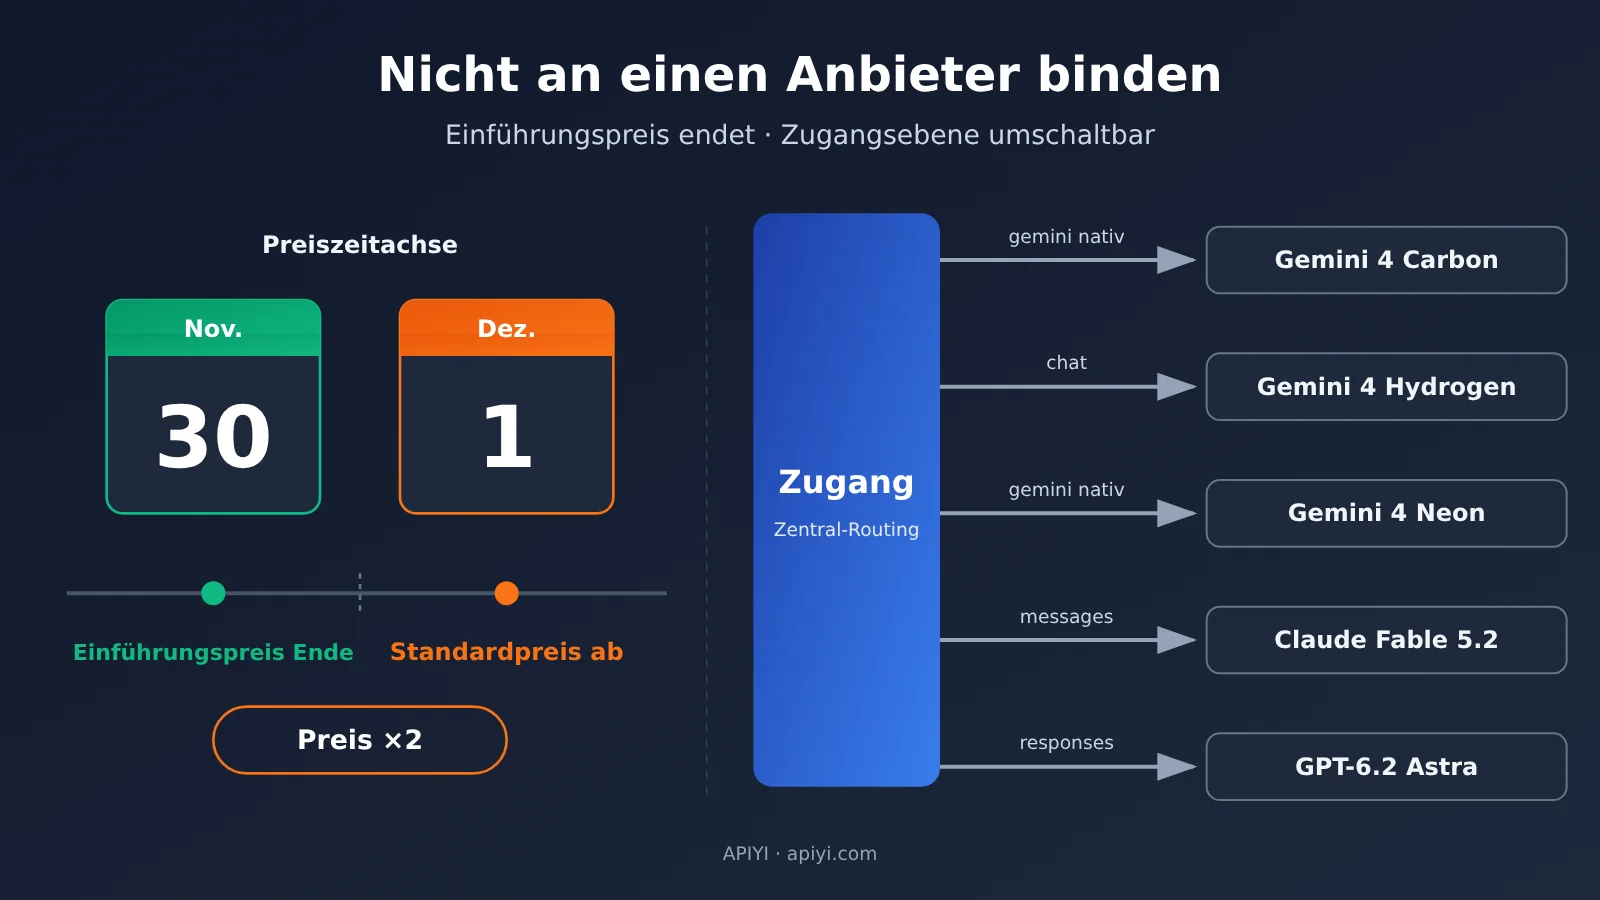
Wenn deine Anwendung bereits mit Gemini 4 Carbon integriert ist, solltest du die nächsten 10 Tage ernst nehmen. Auf der Google-Entwicklerseite steht ausdrücklich: Der Einführungspreis für Gemini 4 Carbon gilt bis 2026-11-30; ab 2026-12-01 wird auf den Standardpreis umgestellt. Die Preise für Eingabe und Ausgabe verdoppeln sich jeweils. Stand heute ist 2026-11-20, der Einführungspreis gilt also noch. Wenn du jetzt damit beginnst, dein Kostenmodell und den Integrationscode anzupassen, reicht die Zeit.
Dies ist kein Artikel, der dich dazu drängt, sofort das Modell zu wechseln. Ein Wechsel ist nicht zwangsläufig billiger, und die Ergebnisse sind auch nicht unbedingt gleichwertig. Dieser Artikel kümmert sich um zwei praktischere Dinge: erstens, wie du nach Ablauf die Rechnung neu aufstellst; zweitens, wie du die Aufrufschicht so umbaust, dass du jederzeit wechseln kannst – wenn sich das nächste Mal Preise oder Kontextfenster ändern, änderst du nur die Modell-ID und den Endpunkt und musst nicht den gesamten Aufruf neu schreiben.
Der praktische Nutzen: Nach dem Lesen dieses Artikels hast du das konkrete Ablaufdatum sowie zwei Zahlensätze – Einführungspreis und Standardpreis – und die Endpunkte, die du beim Wechsel zu Hydrogen, Neon, Fable oder Astra jeweils verwenden solltest.
Gemini 4 Carbon: Einführungspreis läuft aus – die Kernpunkte
Hier zuerst die wichtigsten Fakten kompakt. Die Zahlen in der Tabelle stammen von der Google-Entwicklerseite sowie aus Preisinformationen, die APIYI am 2026-11-20 geprüft hat. Die Einheit ist US-Dollar pro Million Token.
| Punkt | Erläuterung | Auswirkung auf dich |
|---|---|---|
| Stichtag für den Einführungspreis | Gilt bis 2026-11-30 |
Die November-Rechnung wird zum Einführungspreis berechnet |
| Einführungspreis | Eingabe 2, Ausgabe 10, Cache-Lesen 0.10 |
Aktuelle Kostenbasis |
| Standardpreis (ab 1. Dezember) | Eingabe 4, Ausgabe 20, Cache-Lesen 0.20 |
Bei gleichem Verbrauch etwa doppelte Kosten |
| Aktueller APIYI-Katalogpreis | gemini-4-carbon: Eingabe 2, Cache-Lesen 0.1, Ausgabe 10 |
Entspricht dem Einführungspreis; nach Ablauf gilt die dann aktuelle Modellliste der Plattform |
| Austauschbare Modelle | Hydrogen, Neon, Fable, Astra | Unterschiedliche Endpunkte, kein gemeinsamer Request-Body |
Wie sind die zwei Preisschemata von Gemini 4 Carbon zu verstehen
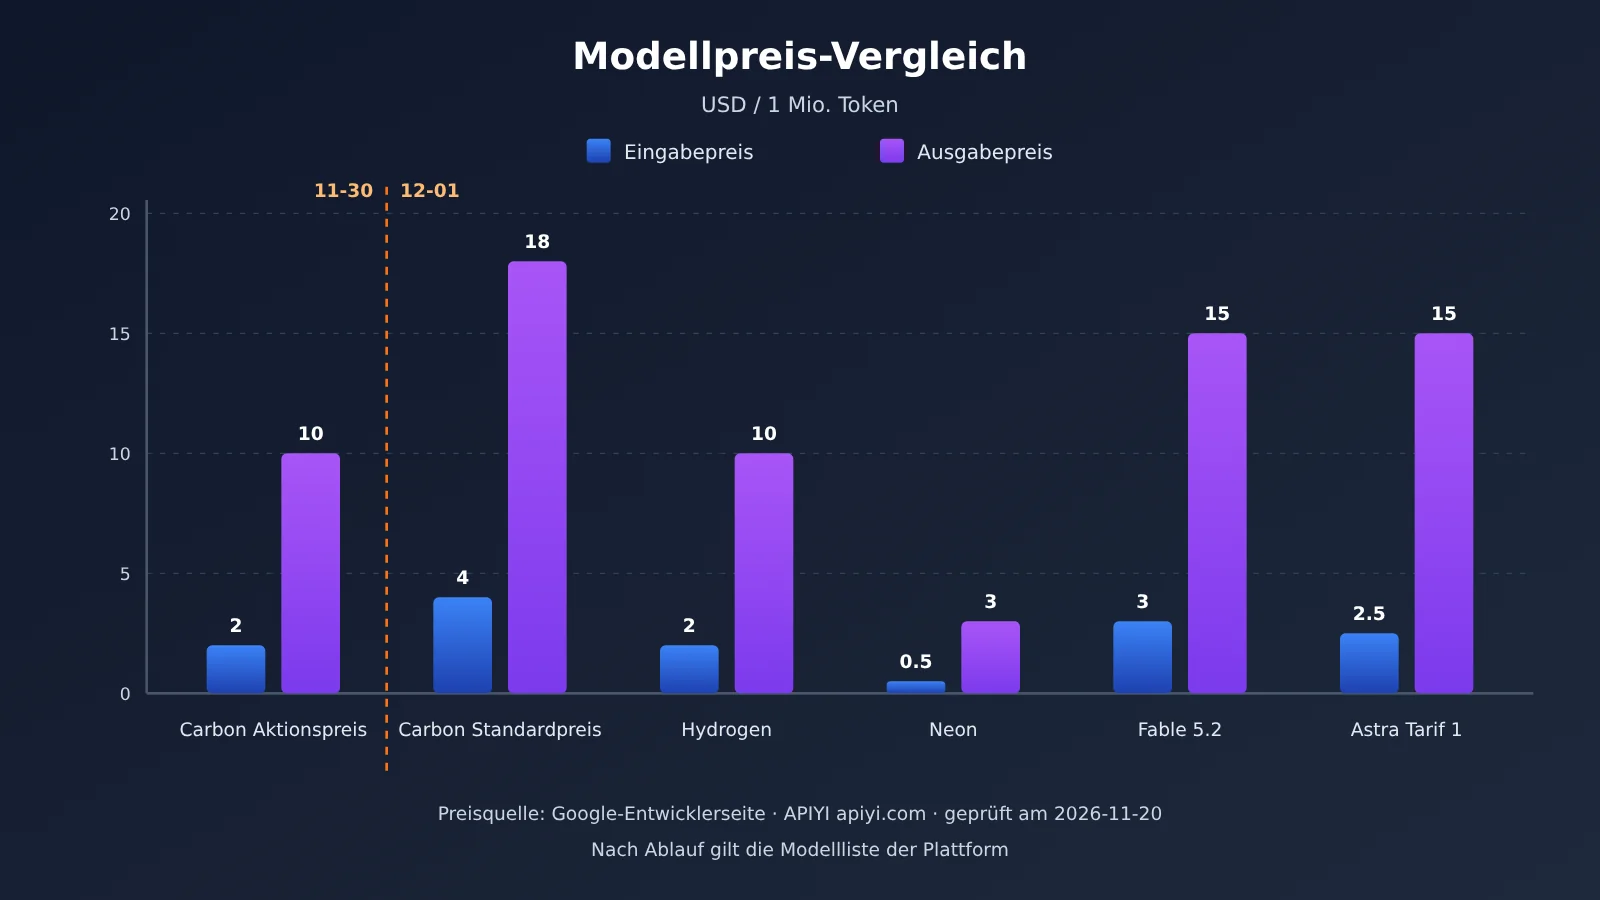
Der Unterschied zwischen Einführungspreis und Standardpreis ist ganz direkt: Eingabe steigt von 2 auf 4, Ausgabe von 10 auf 20, Cache-Lesen von 0.10 auf 0.20 – alle drei Werte verdoppeln sich. Ab Dezember liegen die Kosten also praktisch bei „Novemberverbrauch mal 2“. Wenn deine Eingabeaufforderungen viele wiederverwendbare Präfixe enthalten und die Cache-Trefferquote hoch ist, fällt der absolute Zuwachs beim Cache-Lesen kleiner aus, aber auch dieser Anteil verdoppelt sich im Verhältnis.
Besonders zu unterscheiden ist der Katalogpreis von APIYI apiyi.com. Nach der Prüfung am 2026-11-20 ist gemini-4-carbon dort mit Eingabe 2, Cache-Lesen 0.1 und Ausgabe 10 ausgezeichnet. Das entspricht dem Google-Einführungspreis, nicht dem Standardpreis ab dem 1. Dezember. Wie die Plattform nach Ablauf anpasst, richtet sich nach der dann aktuellen Modellliste der Plattform. Betrachte den heute sichtbaren Katalogpreis nicht als Garantie für die Zeit nach Dezember.
Warum du dich nicht an einen einzigen Modellanbieter binden solltest
Wenn du nur einen Modellanbieter einbindest, kommen die Risiken vor allem aus drei Richtungen. Erstens Preisanpassungen: Das Ende der Einführungsphase oder geänderte Aktionen verändern direkt die Stückkosten. Zweitens Modellabschaltung oder Umbenennung: Eine bisherige ID ist plötzlich nicht mehr verfügbar, und Aufrufe schlagen großflächig fehl. Drittens unterscheiden sich Reasoning-Stufen und Kontextfenster desselben Modells je nach Zugang; Parameter, die du an einem Zugang eingestellt hast, wirken am anderen möglicherweise nicht.
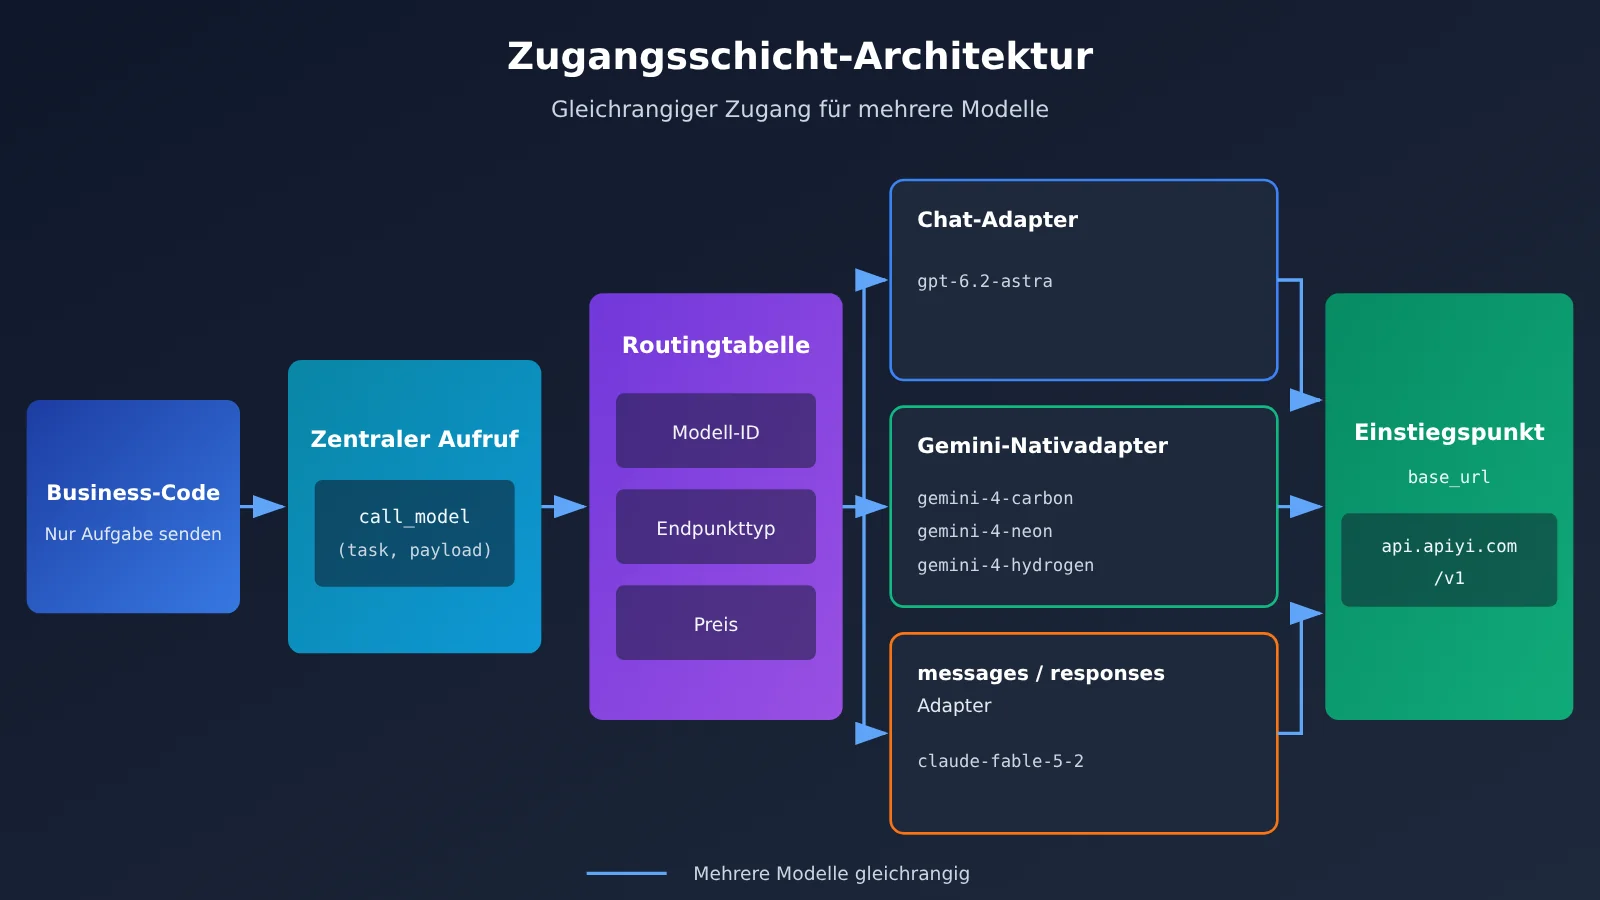
Diese drei Arten von Änderungen kannst du nicht kontrollieren. Kontrollieren kannst du aber, wie groß der Änderungsumfang ausfällt, wenn sie eintreten. Wenn Modell-ID, Endpunkttyp und Preisparameter fest im Geschäftscode verdrahtet sind, musst du bei jeder Änderung Code anpassen, neu testen und erneut ausrollen. Wenn all das in der Konfiguration der Zugriffsschicht gebündelt ist, bleibt die Änderung eine einzige Konfigurationszeile.
Kosten nach Ablauf von Gemini 4 Carbon neu berechnen
Beide Preismodelle mit dem eigenen Verbrauch durchrechnen
Für die Neuberechnung brauchen Sie eigentlich nur drei Zahlen: monatliche Eingabe-Token, monatliche Ausgabe-Token und monatliche Cache-Lese-Token. Multiplizieren Sie jede davon mit dem entsprechenden Stückpreis und addieren Sie die Ergebnisse – schon haben Sie die monatlichen Kosten. Im Folgenden zeigen wir das anhand eines angenommenen Verbrauchs: monatlich 100M Eingabe-Token und 20M Ausgabe-Token, Cache bleibt vorerst unberücksichtigt. Dieser Verbrauch dient nur als Beispiel – ersetzen Sie ihn durch die tatsächlichen Werte aus Ihrer eigenen Abrechnung.
| Tarif | Eingabepreis | Ausgabepreis | Monatliche Kosten beim Beispielverbrauch |
|---|---|---|---|
| Carbon-Einführungspreis (bis 30.11.) | 2 |
10 |
100×2 + 20×10 = 400 USD |
| Carbon-Standardpreis (ab 01.12.) | 4 |
20 |
100×4 + 20×20 = 800 USD |
gemini-4-hydrogen |
1.5 |
7.5 |
100×1.5 + 20×7.5 = 300 USD |
gemini-4-neon |
3 |
15 |
100×3 + 20×15 = 600 USD |
claude-fable-5-2 |
8 |
40 |
100×8 + 20×40 = 1600 USD |
gpt-6.2-astra (erste Stufe) |
8 |
40 |
100×8 + 20×40 = 1600 USD |
Diese Tabelle berücksichtigt nur die Stückpreise, nicht die Ergebnisqualität. Hydrogen hat den niedrigsten Preis, aber ob es Carbon ersetzen kann, hängt davon ab, welche Anforderungen Ihre Aufgabe an die Inferenzqualität und die Formatstabilität stellt. Fable und Astra sind teurer und eignen sich für die Stellen, an denen Qualität gefragt ist und man bereit ist, für bessere Ergebnisse zu zahlen – nicht als Maßnahme zur Kostensenkung. Anders gesagt: Die Neuberechnung soll Ihnen zeigen, was jeder Weg kostet – nicht, dass ein Wechsel automatisch günstiger ist.
Wo Sie die Preisdaten abgleichen können
Für die Preise bei APIYI gibt es zwei Quellen zum Abgleichen. Zum einen die Modellübersicht: Die am 20.11.2026 geprüfte Fassung wurde am 19.11.2026 um 10:59 Uhr (UTC+8) aktualisiert. Zum anderen die Preisschnittstelle api.apiyi.com/api/pricing in der Version shell-api-modelmak-v1. Dort entspricht model_ratio von 1 einem Eingabepreis von 2 US-Dollar pro Million Token; Ausgabe und Cache werden über completion_ratio bzw. cache_ratio umgerechnet.
Am Beispiel gemini-4-neon: In der Übersicht dieser Fassung fehlt diese Zeile, in der Preisschnittstelle ist sie jedoch vorhanden – model_ratio beträgt 1.5, completion_ratio 5 und cache_ratio 0.05. Daraus ergeben sich Eingabe 3, Ausgabe 15 und Cache-Lesen 0.15, was mit Googles Listenpreis übereinstimmt. Für die Budgetplanung sollten Sie sich an der Preisschnittstelle orientieren und die Übersicht nur ergänzend heranziehen.
gpt-6.2-astra hat Staffelpreise, daher müssen Sie beide Stellen prüfen. In der Übersicht ist die erste Stufe mit Eingabe 8, Cache-Lesen 0.4 und Ausgabe 40 angegeben; ab mehr als 272000 Token steigt die Eingabe auf 16. Die Preisschnittstelle zeigt dagegen, dass ab mehr als 272000 Token die Ausgabe mit 60 und das Cache-Lesen mit 0.8 berechnet wird. Wenn bei Ihren einzelnen Anfragen häufig sehr lange Kontexte vorkommen, wirkt sich diese Staffelung stark auf die Kosten aus und muss separat geschätzt werden.
💰 Tipp zur Kostenprüfung: Rufen Sie jeweils vor und nach Ablauf einmal die Preisschnittstelle und die Modellliste von APIYI apiyi.com ab und schreiben Sie die Stückpreise in Ihre Routing-Konfiguration – nicht fest verdrahtet in Code-Kommentare. So müssen Sie beim monatlichen Abgleich nur prüfen, ob Konfiguration und Plattformdaten übereinstimmen.
Endpunkt-Vergleich für Ersatzmodelle von Gemini 4 Carbon
Beim Modellwechsel zuerst die Endpunkte prüfen – nicht davon ausgehen, dass der Request-Body universell ist
Das ist der Schritt, bei dem man am leichtesten auf die Nase fällt. Viele Teams glauben: „Es läuft ja alles über die OpenAI-kompatible Schnittstelle, also reicht es, das Feld model auszutauschen.“ Doch bei manchen Modellen ist der empfohlene Endpunkt grundlegend anders, und auch die Felder im Request-Body unterscheiden sich. Die folgende Tabelle fasst die empfohlenen Endpunkt-Typen der austauschbaren Modelle zusammen; alle Aufrufe laufen einheitlich über die Basisadresse https://api.apiyi.com/v1.
| Modell-ID | Empfohlener Endpunkt | Eingabe / Cache-Lesen / Ausgabe (Stückpreis) | Hinweis beim Wechsel |
|---|---|---|---|
gemini-4-carbon |
chat oder Gemini-nativ | 2 / 0.1 / 10 (aktuell im Angebot) |
nach Ablauf gilt die Modellliste |
gemini-4-hydrogen |
chat oder Gemini-nativ | 1.5 / 0.075 / 7.5 |
Endpunkte identisch mit Carbon, minimale Änderung |
gemini-4-neon |
chat oder Gemini-nativ | 3 / 0.15 / 15 |
Preis gemäß der Preis-Schnittstelle |
claude-fable-5-2 |
chat oder messages | 8 / 0.2 / 40 |
native Funktionen über messages vollständiger |
claude-fable-5-2-thinking |
chat oder messages | 8 / 0.2 / 40 |
die Thinking-Stufe ist eine eigene ID |
gpt-6.2-astra |
empfohlen: responses | erste Stufe 8 / 0.4 / 40 |
über 272000 token gestufte Abrechnung |
Außerdem ist gemini-4-argon ebenfalls in der Übersichtstabelle aufgeführt, mit einer Bepreisung von Eingabe 2, Cache-Lesen 0.1 und Ausgabe 10 – gleich dem aktuellen Angebotspreis von Carbon. Seine Endpunkt-Informationen deckt das Referenzmaterial dieses Artikels nicht ab; wenn Sie es in Betracht ziehen, prüfen Sie bitte zuerst in der Plattformdokumentation den empfohlenen Endpunkt, bevor Sie es anbinden.
Worin unterscheiden sich die drei Endpoint-Typen?
Der chat-Endpoint ist das OpenAI-kompatible Format für Chat-Completions. Der Kern des Request-Bodys besteht aus dem Feld model und dem Array messages – die meisten SDKs nutzen standardmäßig diesen Typ. Der native gemini-Endpoint verwendet die eigene Request-Struktur von Gemini und passt zu Szenarien, die native Parameter brauchen (etwa eine spezielle Thinking-Konfiguration). Der messages-Endpoint ist das native Format von Claude: Wie die System-Eingabeaufforderung platziert wird und wie die Inhaltsblöcke aufgebaut sind, unterscheidet sich deutlich vom chat-Endpoint. Der responses-Endpoint ist die neuere Schnittstellenform von OpenAI – für gpt-6.2-astra ist genau dieser Weg empfohlen.
Eine solide Integrationsschicht sollte deshalb für jeden Endpoint-Typ einen eigenen Adapter bereitstellen. Der Business-Code übergibt dann nur noch „Aufgabentyp + Inhalt“, und der Adapter setzt daraus das passende Format zusammen. Die konkreten Endpoint-Pfade und Felder entnehmen Sie bitte der Dokumentation im APIYI-Dokumentationscenter.
🎯 Technischer Tipp: Bevor Sie die Routing-Konfiguration umstellen, senden Sie mit demselben API-Schlüssel von APIYI apiyi.com einige echte Geschäftsanfragen an den jeweils empfohlenen Endpoint der Kandidatenmodelle. Prüfen Sie dabei, ob Rückgabestruktur, Verhalten der Thinking-Stufen und Kontextlänge den Erwartungen entsprechen – erst dann stellen Sie um.
Schnellstart: austauschbare Zugriffsschicht für Gemini 4 Carbon
Minimalbeispiel: einheitlicher Client
Dieser Abschnitt enthält keinen großen Codeblock, sondern nur die wichtigsten Konfigurationen. Beim Initialisieren des Clients mit dem OpenAI-kompatiblen SDK sind nur zwei Parameter nötig: client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Beim anschließenden Aufruf des Chat-Endpunkts schreiben Sie client.chat.completions.create(model="gemini-4-carbon", messages=msgs). Wenn Sie zu Hydrogen wechseln möchten, ändern Sie einfach model in gemini-4-hydrogen, denn beide nutzen denselben Chat-Endpunkt, und der Request-Body bleibt unverändert.
Beim Wechsel zu gpt-6.2-astra sieht es anders aus. Die empfohlene Schreibweise ist client.responses.create(model="gpt-6.2-astra", input=msgs). Der Parametername ändert sich von messages zu input, und auch die Rückgabestruktur ist anders. Genau deshalb muss die Zugriffsschicht die Adapter nach Endpunkten trennen und nicht einfach nur den Modellnamen austauschen.
Vollständige Schritte für den Umbau
Um einen Aufruf eines einzelnen Modells in eine umschaltbare Struktur umzubauen, gehst du am besten in dieser Reihenfolge vor:
- Routing-Konfiguration herausziehen: Lege eine Konfigurationstabelle an. Jede Zeile enthält Aufgabenname, Modell-ID, Endpunkttyp, Eingabepreis, Ausgabepreis und Preis für Cache-Lesen. Der Anwendungscode kennt nur den Aufgabennamen.
- Adapter pro Endpunkt implementieren: Implementiere vier Adapter für chat, natives Gemini, messages und responses. Jeder Adapter wandelt die einheitliche Eingabe in den passenden Request-Body um und das Ergebnis in ein einheitliches Format.
- Basis-URL und Schlüssel vereinheitlichen: Alle Adapter teilen dieselbe
base_urlund denselben API-Schlüssel. Beim Modellwechsel ist keine zusätzliche Schlüsselverwaltung nötig. - Fallback-Kette ergänzen: Konfiguriere für kritische Aufgaben ein Hauptmodell und ein Ersatzmodell, zum Beispiel
gemini-4-carbonals Hauptmodell undgemini-4-hydrogenals Ersatz. Wenn das Hauptmodell einen Fehler meldet oder abgeschaltet wird, wird automatisch auf das Ersatzmodell ausgewichen. - Kosten-Tracking: Protokolliere bei jedem Aufruf Modell-ID und Token-Verbrauch. Schätze die Kosten laufend anhand der Preise in der Konfigurationstabelle und gleiche sie am Monatsende mit der Abrechnung ab.
Beispielhafte Felder der Routing-Konfiguration anzeigen
Eine typische Routing-Konfiguration kann diese Felder enthalten: `task: „summary“`, `model: „gemini-4-carbon“`, `endpoint: „chat“`, `price_in: 2`, `price_out: 10`, `price_cache: 0.1`, `fallback: „gemini-4-hydrogen“`. Ab dem 1. Dezember musst du nur noch anhand der Modellliste der Plattform `price_in` und `price_out` aktualisieren oder `model` und `endpoint` austauschen. Der Anwendungscode bleibt völlig unverändert.
Für Modelle mit Preisstaffelung wie `gpt-6.2-astra` empfiehlt es sich, zusätzlich `tier_threshold: 272000` und die entsprechenden Preisfelder für die höhere Stufe anzugeben. Das Kosten-Tracking-Modul entscheidet dann anhand der Token-Anzahl pro Anfrage, in welche Preisstufe der Aufruf fällt.
🚀 Schnellstart: Wenn du noch keinen einheitlichen Einstiegspunkt hast, kannst du dich zuerst bei APIYI apiyi.com registrieren, einen API-Schlüssel und ein kostenloses Testkontingent erhalten und mit einem Schlüssel Carbon, Hydrogen, Neon, Fable und Astra einmal komplett durchtesten. Danach entscheidest du, wie du das Routing konfigurierst.
Checkliste vor Ablauf
| Prüfpunkt | Empfohlene Frist | Erläuterung |
|---|---|---|
| November-Verbrauch exportieren | bis 11-25 | die tatsächlichen Token-Zahlen für Input, Output und Cache-Read ermitteln |
| Beide Preismodelle durchrechnen | bis 11-26 | Monatskosten jeweils mit Einführungspreis und Standardpreis berechnen |
| Kandidatenmodelle testen | bis 11-28 | über die empfohlenen Endpunkte jeweils eine Charge echter Anfragen senden |
| Routing-Konfiguration live schalten | bis 11-30 | Haupt- und Backup-Modell sowie Stückpreise in die Konfiguration aufnehmen |
| Plattformpreise erneut prüfen | nach 12-01 | Stückpreise anhand der Modellliste der Plattform aktualisieren |
Häufige Fragen (FAQ)
F1: Bis wann genau gilt der Einführungspreis für Gemini 4 Carbon?
Laut der Google-Entwicklerseite gilt der Einführungspreis bis 2026-11-30. In diesem Zeitraum kostet die Eingabe `2`, die Ausgabe `10` und das Cache-Lesen `0.10` US-Dollar pro Million Token. Ab 2026-12-01 gilt der Standardpreis: Eingabe `4`, Ausgabe `20`, Cache-Lesen `0.20`.
F2: Wie hoch ist der Carbon-Preis bei APIYI nach Dezember?
Derzeit steht `gemini-4-carbon` im APIYI-Sortiment bei Eingabe `2`, Cache-Lesen `0.1` und Ausgabe `10` – das entspricht dem Einführungspreis. Für Preise nach dem 1. Dezember gilt die Modellliste der Plattform; dieser Artikel gibt keine Zusicherung für spätere Regalpreise ab. Am besten nach Ablauf direkt bei APIYI auf apiyi.com nachprüfen.
F3: Wie viel Code muss ich ändern, um von Carbon auf Hydrogen umzusteigen?
So gut wie nichts. Beide empfehlen denselben Endpoint, nämlich chat oder Gemini-nativ. Wenn du bereits den chat-Endpoint nutzt, musst du nur das Feld `model` von `gemini-4-carbon` auf `gemini-4-hydrogen` ändern. Trotzdem solltest du zuerst mit echten Requests testen – ein niedrigerer Stückpreis bedeutet nicht automatisch gleiche Aufgabenqualität.
F4: Warum kann ich beim Wechsel zu Claude Fable oder GPT Astra nicht einfach den Modellnamen ändern?
Weil die empfohlenen Endpoints unterschiedlich sind. `claude-fable-5-2` läuft über chat oder messages, wobei die nativen Fähigkeiten über messages vollständiger sind. `gpt-6.2-astra` empfiehlt responses – Anforderungsparameter und Antwortstruktur unterscheiden sich von chat. Wer einfach den Modellnamen austauscht, bekommt häufig unbekannte Felder oder Parsing-Fehler.
F5: Welcher Preis gilt für Gemini 4 Neon?
In der Modellübersicht von 2026-11-19 fehlt die Zeile für Neon, in der Pricing-Schnittstelle ist es aber enthalten: umgerechnet Eingabe `3`, Ausgabe `15`, Cache-Lesen `0.15` – identisch mit der Google-Preisangabe. Für die Budgetplanung reicht die Pricing-Schnittstelle; der Endpoint ist ebenfalls chat oder Gemini-nativ.
F6: Wie vergleiche ich mehrere Kandidatenmodelle schnell mit einem Key?
Am besten über eine API-Aggregationsplattform, um einheitlich zu testen:
1. Bei APIYI auf apiyi.com registrieren und API-Schlüssel sowie kostenloses Testkontingent holen
2. Die `base_url` des Clients auf die einheitliche Adresse setzen und je nach Modell den empfohlenen Endpoint aufrufen
3. Token-Verbrauch und Ausgabequalität jedes Modells notieren und anschließend in die Neuberechnungstabelle dieses Artikels einsetzen
F7: Welche Grenzen hat diese austauschbare Zugriffsschicht?
Die Zugriffsschicht senkt nur die Wechselkosten, nicht die Leistungsunterschiede. Verschiedene Modelle verstehen dieselbe Eingabeaufforderung unterschiedlich, halten Formate anders ein und verhalten sich bei den Thinking-Stufen anders – nach dem Wechsel sind Regressionstests Pflicht. Außerdem müssen Modelle mit gestaffelter Preisberechnung (etwa Astra ab mehr als `272000` Token) separat geschätzt werden; die einheitliche Kostenformel unterschätzt Anfragen mit langem Kontextfenster.
Wichtige Erkenntnisse zum Auslaufen des Einführungspreises von Gemini 4 Carbon
- Klares Ablaufdatum: Der Einführungspreis gilt bis 2026-11-30; ab dem 1. Dezember 2026 gilt der Standardpreis.
- Kosten etwa verdoppelt: Die Standardpreise für Input, Output und Cache-Lesen sind jeweils doppelt so hoch wie der Einführungspreis.
- Listenpreis ist keine Garantie: Der aktuelle Carbon-Preis bei APIYI entspricht dem Einführungspreis; nach Ablauf ist die Modellliste maßgeblich.
- Unterschiedliche Endpunkte: Hydrogen und Neon laufen über chat oder gemini, Fable über chat oder messages; für Astra wird responses empfohlen.
- Ein Wechsel spart nicht automatisch: Hydrogen hat einen niedrigen Stückpreis, Fable und Astra sind teurer – die Entscheidung sollte auch die Ergebnisqualität berücksichtigen.
- Konfiguration ist entscheidend: Modell-ID, Endpunkt und Stückpreis gehören in die Routing-Konfiguration; der Anwendungscode kennt nur den Aufgabennamen.
- Einheitlicher Zugang erleichtert die Validierung: Mit einem API-Schlüssel bei APIYI mehrere Kandidatenmodelle testen und erst dann das Routing festlegen.
Zusammenfassung
Beim Auslaufen des Einführungspreises von Gemini 4 Carbon sind drei Punkte zentral:
- Zuerst rechnen: Legen Sie Ihre tatsächliche Nutzung sowohl auf den Einführungspreis als auch auf den Standardpreis um. Ab Dezember kostet dieselbe Nutzung etwa doppelt so viel wie bisher.
- Dann die Endpunkte prüfen: Die empfohlenen Endpunkte der Ersatzmodelle unterscheiden sich. Bevor Sie das Modell wechseln, klären Sie die jeweiligen Anfrageformate von chat, gemini, messages und responses.
- Zuletzt konfigurieren: Fassen Sie Modell-ID, Endpunkttyp und Stückpreis in der Routing-Konfiguration zusammen. Wenn sich Preise oder Kontextfenster das nächste Mal ändern, ändern Sie nur die Konfiguration, nicht den Code.
Bis zum 30. November sind es noch 10 Tage. Das reicht, um die Nutzung zu exportieren, beide Preisvarianten neu zu berechnen und die Kandidatenmodelle testweise laufen zu lassen. Binden Sie Ihr Geschäft nicht an ein einziges Modell und einen einzigen Preis. Eine Integrationsschicht mit austauschbaren Schnittstellen ist die beste Vorbereitung auf die nächste Änderung.
Empfohlen ist der einheitliche Zugang über APIYI apiyi.com: Mit einem API-Schlüssel lassen sich mehrere Modelle und Endpunkte testen, Ergebnisse vergleichen und Kosten gegenüberstellen.
📚 Referenzen
-
Google-Entwicklerseite – Gemini-Preisgestaltung: Einführungspreis und Standardpreis für Gemini 4 Carbon
- Link:
ai.google.dev - Beschreibung: Stichtag für den Einführungspreis sowie der Standardpreis ab dem 1. Dezember
- Link:
-
APIYI-Modellübersicht: Einzelpreise für Eingabe, Ausgabe und Cache-Lesen je Modell
- Link:
docs.apiyi.com/models.md - Beschreibung: Abgeglichene Version vom 2026-11-20, aktualisiert am 2026-11-19 10:59 (UTC+8)
- Link:
-
APIYI-Preisschnittstelle: Echtzeitpreise, umgerechnet über den Multiplikator
- Link:
api.apiyi.com/api/pricing - Beschreibung: Version
shell-api-modelmak-v1, geeignet zum programmatischen Auslesen der Einzelpreise
- Link:
Autor: APIYI-Team
Fachlicher Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Die Endpunkte der einzelnen Modelle und die zugehörigen Parameterbeschreibungen finden Sie im Dokumentationszentrum.