Anmerkung des Autors: Dieser Artikel zeigt, wie man mit Modellschnittstellen, Tools, Gedächtnis, Scheduling und einer Ausführungsumgebung einen persönlichen KI-Agenten selbst baut. Am Beispiel eines KI-Nachrichten-Intelligence-Workflows erklärt er die Aufgaben und Kosten der einzelnen Teile eines selbstgebauten Systems.
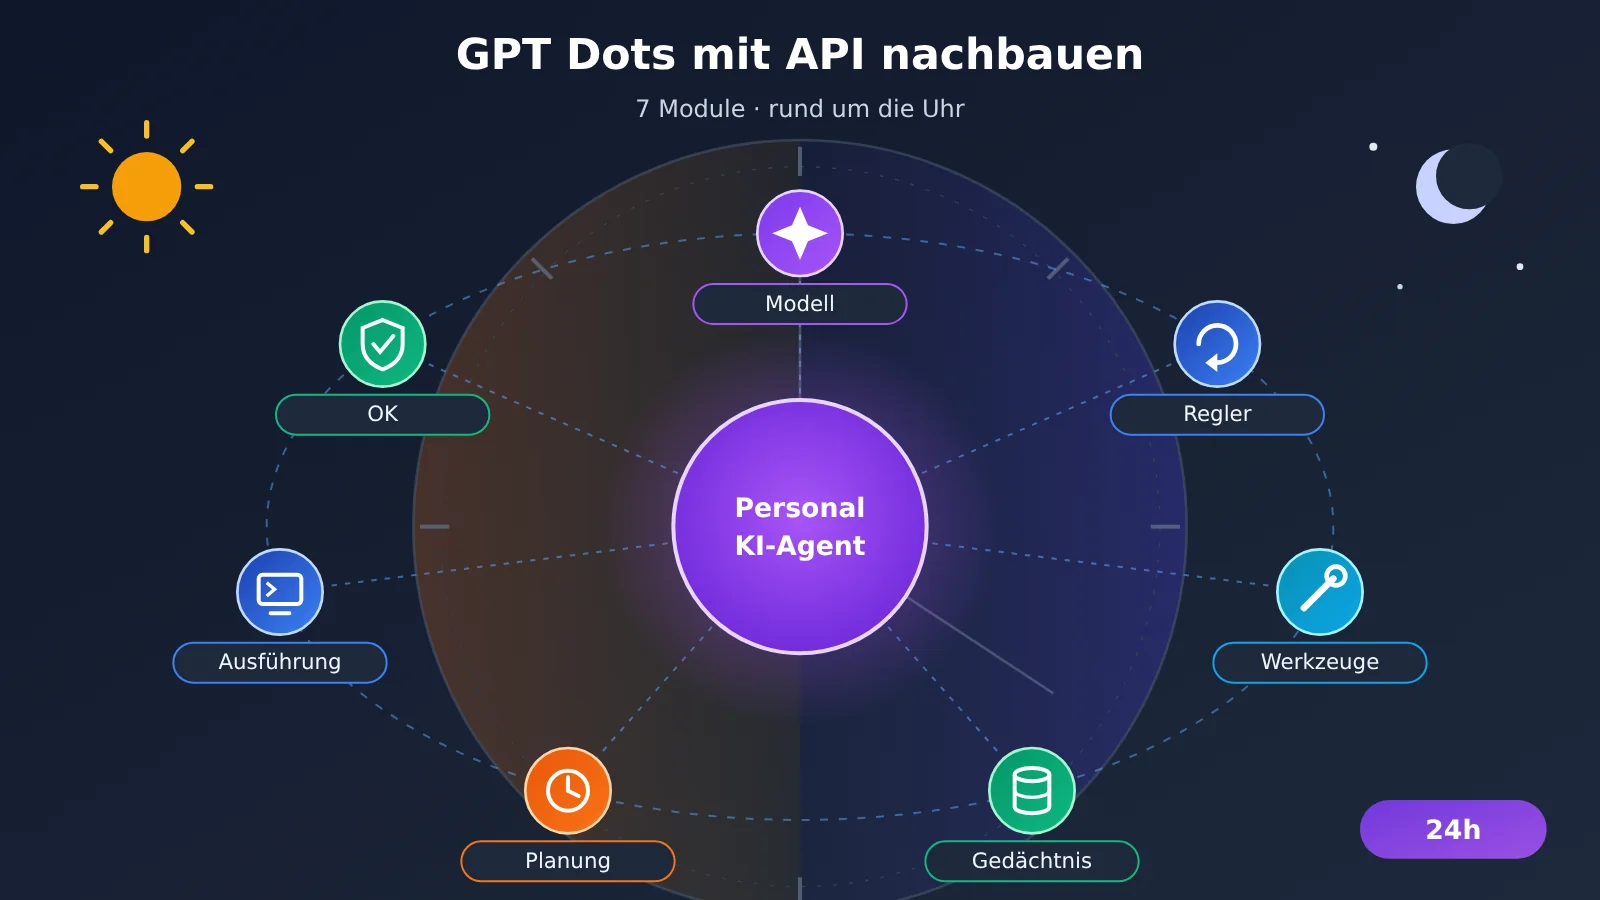
Mit APIs lässt sich GPT Dots nachbauen – reproduzierbar ist vor allem sein Arbeitsmodus: Das Modell trifft Entscheidungen, das Programm führt sie aus, die Datenbank übernimmt das Gedächtnis, und der Scheduler sorgt dafür, dass Aufgaben weiterlaufen, wenn man selbst nicht mehr da ist. Die Modellschnittstelle ist nur eine Ebene davon. Tool-System, Langzeitgedächtnis, Aufgabenwarteschlange, Ausführungsumgebung und Freigabemechanismen muss man als Entwickler selbst aufbauen. OpenAIs proprietäre Modellkonfiguration, Cloud-Computer und das Ökosystem mit über 4.000 Anwendungen gehören zum Dots-Produkt selbst; diese Teile lassen sich nicht direkt über APIs bekommen. Die „24 Stunden“ im Titel meinen die Arbeitsweise, bei der der Agent Aufgaben planmäßig im Hintergrund weiter vorantreibt. Wie lange das System tatsächlich verfügbar ist, hängt von Servern, Warteschlangen und Retry-Mechanismen ab.
Der gesamte Artikel folgt der Aufbau-Reihenfolge. Teil 1 zerlegt Dots in 7 Module und markiert, welche davon das Modell liefert und welche selbst gebaut werden müssen. Die Teile 2 bis 6 implementieren nacheinander Modellanbindung, Tool-Aufrufe, Langzeitgedächtnis, Hintergrund-Scheduling und Ausführungsumgebung. Teil 7 kombiniert diese Komponenten zu einem vollständigen Entwurf für Personal AI Radar. Teil 8 berechnet die Gesamtkosten inklusive Nicht-Modell-Kosten und beschreibt die Grenzen der Selbstbau-Lösung.
To Know: Begriffe, die Sie vor der Nachbildung von GPT Dots kennen sollten
| Begriff | Erklärung |
|---|---|
| API | Schnittstelle, über die Anwendungen ein Modell oder einen externen Dienst aufrufen; in diesem Artikel vor allem die Aufrufschnittstelle für große Sprachmodelle |
| Agent | Anwendungssystem, das ein Modell für Entscheidungen nutzt und über Werkzeugaufrufe Aufgaben vorantreibt |
| Function Calling | Das Modell gibt strukturierte Werkzeugaufruf-Anforderungen aus, Ihr Programm führt sie aus und übergibt das Ergebnis zurück an das Modell |
| tool_use / tool_result | Nachrichtentypen in der Claude-Messages-API für Werkzeugaufruf-Anforderungen und Ausführungsergebnisse |
| SQLite | Einzeldatei-Datenbank zum Einbetten, geeignet für leichtgewichtige Daten wie Präferenzen, Aufgabenstatus und Protokolle |
| Vektorsuche | Text in Vektoren umwandeln und relevante Informationen nach semantischer Ähnlichkeit finden |
| Aufgabenwarteschlange | Speichert ausstehende Aufgaben und verteilt sie nach Reihenfolge oder Priorität an Hintergrund-Worker |
| Checkpoint | Fortschritts-Snapshot, der bei einem bestimmten Schritt der Aufgabenausführung gespeichert wird, sodass nach einer Unterbrechung von hier aus fortgesetzt werden kann |
| Ausführungsumgebung | Der Rechner oder Container, in dem Browser, Code und Dateioperationen tatsächlich laufen |
| Playwright | Automatisierungsbibliothek zur Steuerung von Browsern per Code, zum Öffnen von Webseiten, Klicken und Extrahieren von Inhalten |
| Prompt Injection | Angriffsweise, bei der bösartige Anweisungen in Webseiten oder Dokumenten versteckt sind und versuchen, das Verhalten des Agenten zu kapern |
| MCP | Offenes Protokoll, das Modellanwendungen mit externen Werkzeugen und Datenquellen verbindet |
1 Aus welchen Modulen besteht GPT Dots
1.1 Die offiziellen Fähigkeiten von GPT Dots
Dots ist ein ständig verfügbarer persönlicher KI-Agent, den OpenAI am 29. September 2026 veröffentlicht hat. Laut offiziellen Angaben verfügt er über einen eigenen Cloud-Computer und einen Browser; auch nachdem der Nutzer seinen Rechner heruntergefahren hat, werden bereits delegierte Cloud-Aufgaben weiter ausgeführt. Er kann ChatGPT Memory, eigene Notizen und Daten aus verbundenen Apps kombinieren, mehrere Projekte gleichzeitig vorantreiben und über Kanäle wie ChatGPT, Slack oder Microsoft Teams mit dem Nutzer kommunizieren.
Die Arbeitsweise von Dots umfasst außerdem drei zentrale Mechanismen. Die proaktive Recherche (Proactive Research) liest im Hintergrund freigegebene Informationsquellen und erstellt Recherchenotizen; dieser Prozess ist rein lesend, und nachfolgende Aktionen müssen über den normalen Freigabeprozess laufen. Zeitgesteuerte Aufgaben und Ereignisüberwachung sorgen dafür, dass Dot nach Plan oder aufgrund von Ereignissen kontinuierlich arbeitet. Custom Rules und Auto-review prüfen vor Aktionen wie dem Versenden von E-Mails oder Einkäufen die Berechtigungen und die Nutzerabsicht; bei risikoreichen Vorgängen wie Überweisungen oder Passwortänderungen muss der Nutzer die Kontrolle übernehmen.
1.2 Die sieben Module von GPT Dots und ihre Entsprechung im Eigenbau
Zerlegt man die Fähigkeiten von Dots, ergeben sich sieben Module. Die folgende Tabelle zeigt, wie jedes Modul in einer Eigenbau-Lösung umgesetzt werden kann:
| Modul | Ausprägung in Dots | Entsprechende Umsetzung im Eigenbau | Bereitgestellt von |
|---|---|---|---|
| Modell | Inferenz, Planung, Werkzeugauswahl | Modell-APIs von GPT, Claude, Gemini, DeepSeek usw. | Modellservice |
| Agent-Controller | Aufgaben zerlegen, mehrere Projekte koordinieren | Selbst geschriebene Schleife oder LangGraph, OpenAI Agents SDK | Entwickler |
| Werkzeuge | Browser, App-Plugins, Codex | Function Calling + selbst implementierte Werkzeugfunktionen, MCP-Dienste | Entwickler |
| Gedächtnis | ChatGPT Memory, Dot-Notizen, Projektkontext | SQLite + Vektorsuche + Dateisystem | Entwickler |
| Aufgabenplanung | Zeitgesteuerte Aufgaben, Ereignisüberwachung, Hintergrund-Agent | APScheduler, Celery, Redis-Warteschlange | Entwickler |
| Ausführungsumgebung | Eigenständiger Cloud-Computer | Cloud-Server, Docker, Playwright | Entwickler |
| Sicherheitsfreigabe | Custom Rules, Auto-review, Nutzerübernahme | Werkzeug-Whitelist, Freigabewarteschlange, Aktionsprotokolle | Entwickler |
In der Tabelle wird nur die erste Zeile direkt von einer Modell-API bereitgestellt; die übrigen sechs Zeilen erfordern eine technische Implementierung. Das ist der Grund, warum ein einziger API-Schlüssel nicht die vollständigen Dots-Fähigkeiten liefert: Der API-Schlüssel öffnet nur den Einstieg in den Modellaufruf; die Handlungsfähigkeit, das Gedächtnis und den Zeitplan des Agenten muss man selbst aufbauen.
2 Modellschnittstellen für die Reproduktion von GPT Dots vorbereiten
2.1 Über APIYI mehrere Modelle anbinden
APIYI apiyi.com bietet OpenAI-kompatible Schnittstellen und die native Claude-Messages-Schnittstelle. Mit einem API-Schlüssel lassen sich Modelle mehrerer Anbieter aufrufen. Die verschiedenen Modelle nutzen unterschiedliche Protokolle, was bei der Konfiguration berücksichtigt werden muss:
| Modelltyp | Protokoll | Basis-URL | Feld für Tool-Aufrufe |
|---|---|---|---|
| OpenAI-kompatible Modelle wie GPT, DeepSeek, Qwen | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages (/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Gemini-kompatibles Protokoll | Gemäß offizieller Dokumentation für die jeweilige Schnittstelle konfigurieren | Gemäß dem jeweiligen Protokoll |
Modell-IDs und aktuelle Preise entnehmen Sie bitte der Modellliste der Plattform. Der folgende Code liest die Modell-ID einheitlich aus Umgebungsvariablen; beim Wechsel des Modells muss nur die Konfiguration geändert werden, der Agent-Code bleibt unverändert.
2.2 Minimaler Modellaufruf zur Reproduktion von GPT Dots
Prüfen Sie zuerst, ob die Schnittstelle erreichbar ist. Speichern Sie den folgenden Code als llm.py; in den späteren Kapiteln wird client jeweils von hier importiert:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # OpenAI-kompatible Schnittstelle von APIYI
)
MODEL = os.environ["RADAR_MODEL"]  # Tatsächlich verfügbare Modell-ID aus der Modellliste eintragen

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Wenn Claude über die native Messages-Schnittstelle läuft, verwenden Sie das Anthropic SDK – die Base URL dann ohne /v1:
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # Das SDK hängt /v1/messages automatisch an
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Wenn Claude tool_use zurückgibt, führt Ihr Programm das Tool aus und sendet anschließend mit role: user einen tool_result-Block, wobei tool_use_id die Zuordnung zur Anfrage herstellt. Schlägt das Tool fehl, setzen Sie is_error: true – das Modell passt daraufhin seine nächsten Schritte an.
🚀 Schnellstart: Bringen Sie zunächst mit dem kostenlosen Testkontingent von APIYI die beiden obigen Codeblöcke zum Laufen und stellen Sie sicher, dass sowohl die OpenAI-kompatible als auch die native Claude-Route Tool-Aufrufe zurückgeben. Erst danach gehen Sie in die Agent-Entwicklung.
2.3 Unterschiede bei Schnittstellenkompatibilität und Tool-Aufruf-Fähigkeiten
Protokollkompatibilität sorgt nur dafür, dass die Anfrage überhaupt rausgeht – beim Tool-Aufruf verhalten sich die einzelnen Modelle trotzdem unterschiedlich. Die von APIYI im November 2026 veröffentlichte Testmethodik für Tool-Aufrufe über mehrere Modelle nennt mehrere Beobachtungsschwerpunkte: Bei der Gemini-Reihe steht im Fokus, ob parallele Aufrufe funktionieren und ob sich in das finale JSON zusätzlicher Text einschleicht; bei der Qwen-Reihe die Auswahl unter ablenkenden Tools und das ID-Mapping über mehrere Runden; bei der Claude-Reihe die Behandlung von is_error und die Anzahl der Aufrufrunden; bei der GPT-Reihe, wie strikt das Schema befolgt wird und wie hoch der Token-Verbrauch ausfällt.
Das sind Beobachtungspunkte für Tests – es ist nicht vorab festgelegt, welches Modell besser abschneidet. Am besten gibt man den Kandidatenmodellen identische Tool-Definitionen und Aufgaben, protokolliert Aufrufanzahl, Anzahl der Parameterfehler, Gesamt-Token und die finale Trefferquote und entscheidet dann anhand der Daten, welches Modell der Haupt-Agent wird.
Auch die Responses API muss separat geprüft werden. Die in der APIYI-Dokumentation beschriebene Schnittstelle /v1/responses führt vor allem Modelle wie GPT-4.1 und o3 auf, während die aktuelle OpenAI-Dokumentation zu Tool-Aufrufen angibt, dass GPT-6 Astra und GPT-6.1 Sol die Responses API verwenden. Wenn Sie die Responses-API-Fähigkeiten der neuen Modelle nutzen möchten, sollten Sie Tool-Aufrufe, integrierte Tools und Statusverwaltung als Kompatibilitätstestpunkte auf die Liste setzen und erst nach punktueller Prüfung jedes einzelnen Punkts live gehen.
3 Mit Function Calling einen Agenten im GPT-Dots-Stil Aufgaben ausführen lassen
3.1 Der Arbeitszyklus von Function Calling
Der Zyklus von Function Calling besteht aus nur vier Schritten: Das Programm sendet die Aufgabe und die Tool-Definitionen an das Modell; das Modell gibt den Namen des Tools zurück, das es aufrufen möchte, zusammen mit den Parametern; das Programm führt dieses Tool tatsächlich aus; das Programm hängt das Ergebnis der Ausführung an die Nachrichten an und sendet sie erneut an das Modell, das dann entscheidet, ob es weitere Aufrufe startet oder eine Antwort liefert.
Der entscheidende Punkt ist der dritte Schritt. Das Modell erzeugt nur die Aufrufanforderung – auf Suchmaschinen zuzugreifen, Dateien zu lesen und zu schreiben oder Nachrichten zu versenden, erledigt Ihr Code. Deshalb liegt die Verantwortung für den Berechtigungsumfang der Tools, die Eingabevalidierung und die Fehlerbehandlung vollständig beim Entwickler.
3.2 Ein minimales Tool-System aus drei Werkzeugen
Personal AI Radar benötigt drei grundlegende Tools: search_news durchsucht Nachrichten, read_file liest Materialien im Arbeitsverzeichnis und save_note schreibt die aufbereiteten Ergebnisse in die Wissensdatenbank. Hier ist die vollständige Agent-Schleife:
Vollständigen Code der Tool-Aufrufschleife aus der GPT-Dots-Reproduktion anzeigen
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "检索近期 AI 新闻,返回标题、链接、发布时间和摘要列表",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "读取工作目录中的文本文件",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "把一条整理好的新闻资料保存到资料库",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # Anbindung an den gewählten Suchdienst: Such-API, RSS-Aggregation oder eigener Scraper
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # Nur Lesezugriff innerhalb des Arbeitsverzeichnisses erlauben
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
Drei Designentscheidungen in diesem Code lohnen sich, beibehalten zu werden. max_rounds begrenzt die Anzahl der Schleifendurchläufe und verhindert, dass das Modell dasselbe Tool wiederholt aufruft und dabei Token verbraucht. Tool-Ausnahmen werden als {"error": ...} an das Modell zurückgegeben, damit es die Möglichkeit hat, Parameter oder Vorgehen zu ändern. read_file sperrt den Lesebereich mithilfe einer Pfadprüfung auf das Arbeitsverzeichnis – das ist die einfachste Berechtigungsgrenze.
3.3 Vom selbst geschriebenen Loop zum Agent-Framework
Ein selbst geschriebener Loop eignet sich für Szenarien mit einer einzigen Aufgabe und wenigen Tools. Wenn Aufgaben eine Wiederaufnahme nach Unterbrechung, menschliche Freigaben oder komplexe Verzweigungen erfordern, kann man zu LangGraph migrieren: State speichert den Aufgabenstatus, ein Checkpointer sichert den Fortschritt persistent, und Human-in-the-loop pausiert und wartet auf eine Prüfung. Das OpenAI Agents SDK bietet außerdem Workflow-Orchestrierung und Guardrails. Sobald die Zahl der Tools zunimmt, lassen sich Funktionen wie Suche, Dateien und E-Mail mit MCP als eigenständige Dienste kapseln, die mehrere Agenten wiederverwenden können.
4 Langzeitgedächtnis für Agenten im GPT-Dots-Stil aufbauen
4.1 Aufteilung in vier Gedächtnisebenen
Der Kontext von Dots stammt aus ChatGPT Memory, den eigenen Notizen von Dots, dem Kontext der aktuellen Aufgabe und den Daten verbundener Anwendungen. Bei neuen Aufgaben wird die Historie nur bei Bedarf abgerufen; vollständige Chatverläufe werden nicht geladen. Ein selbst entwickelter Agent kann denselben Ansatz verfolgen und sein Gedächtnis in Ebenen verwalten:
| Gedächtnisebene | Gespeicherte Inhalte | Lebenszyklus | Schreibzeitpunkt |
|---|---|---|---|
| Aktueller Kontext | Anweisungen der aktuellen Aufgabe, letzte Tool-Ergebnisse | Aktuelle Aufgabe | Bei jeder Dialogrunde |
| Projektgedächtnis | Projektziele, zentrale Entscheidungen, Fortschritt | Während der Projektlaufzeit | Bei Abschluss der Aufgabe oder Änderung einer Entscheidung |
| Nutzer-Gedächtnis | Präferenzen, Interessengebiete, Berichtsformat | Langfristig | Wenn der Nutzer eine Präferenz ausdrücklich äußert |
| Erfahrungsgedächtnis | Ursachen für Fehlschläge, Korrekturmethoden | Langfristig, nach Regeln aktualisiert | Nach fehlgeschlagener Aufgabe oder Nutzerkorrektur |
Bei jedem Modellaufruf werden nur der aktuelle Kontext und die relevanten abgerufenen Gedächtnisinhalte in die Eingabeaufforderung aufgenommen. Alle bisherigen Nachrichten in die Anfrage zu packen, erhöht zugleich die Token-Kosten und verschlechtert die Retrieval-Qualität.
4.2 Design der SQLite-Tabellenstruktur
Die folgende Tabellenstruktur deckt die vier Gedächtnisebenen und den Aufgabenstatus ab; die Tabelle runs übernimmt zugleich die Wiederaufnahme nach Unterbrechung in Teil 5:
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
notes verwendet die URL als Primärschlüssel; beim erneuten Abrufen derselben Nachricht erfolgt automatisch eine Deduplizierung. Der UNIQUE-Constraint (project_id, run_date) von runs sorgt dafür, dass jedes Projekt pro Tag nur einen Lauf-Datensatz hat; nach einem Neustart lässt sich der Fortschritt des jeweiligen Tages wiederfinden.
4.3 Historische Materialien per Vektorsuche abrufen
Strukturierte Daten werden per SQL-Abfrage gesucht, semantisch relevante Materialien per Vektorsuche. Dazu werden aus notes.summary und lessons.lesson Embedding-Vektoren erzeugt, in Vektordatenbanken wie sqlite-vec oder Chroma gespeichert und in den Metadaten Projekt, Datum und Quelle vermerkt. Bei der Themenauswahl wird zuerst mit den Nachrichten des Tages nach ähnlichen Materialien aus den vergangenen 30 Tagen gesucht. Die Zusammenfassungen der Treffer werden der Eingabeaufforderung beigelegt; so kann das Modell einschätzen, ob es sich bei dieser Nachricht um die Weiterentwicklung eines bestehenden Themas oder um ein völlig neues Ereignis handelt. Der Nutzer muss den Hintergrund dann nicht jedes Mal neu erklären.
5 GPT-Dots-Agenten dauerhaft im Hintergrund arbeiten lassen
5.1 Die Unterschiede zwischen den drei Hintergrundmechanismen
Der Hintergrundbetrieb umfasst drei Mechanismen mit jeweils unterschiedlichen Aufgaben. Zeitgesteuerte Aufgaben werden vom System-Scheduler (APScheduler, cron) nach Zeitplan ausgelöst und beantworten die Frage „wann geht es los“. Hintergrund-Modellanfragen bezeichnen asynchrone Antworten wie den OpenAI Background Mode: Man sendet die Anfrage ab, erhält eine Response-ID, fragt dann den Status ab und holt das Ergebnis ab. Sie haben einen eigenen Lebenszyklus und eigene Bedingungen zur Datenaufbewahrung und eignen sich für einzelne, lang andauernde Inferenzen. Langfristige Agent-Orchestrierung besteht aus Aufgabenwarteschlange, persistentem Zustand und Workern und ist für die Weiterführung, Wiederholung und Wiederherstellung von mehrtägigen, mehrstufigen Aufgaben zuständig.
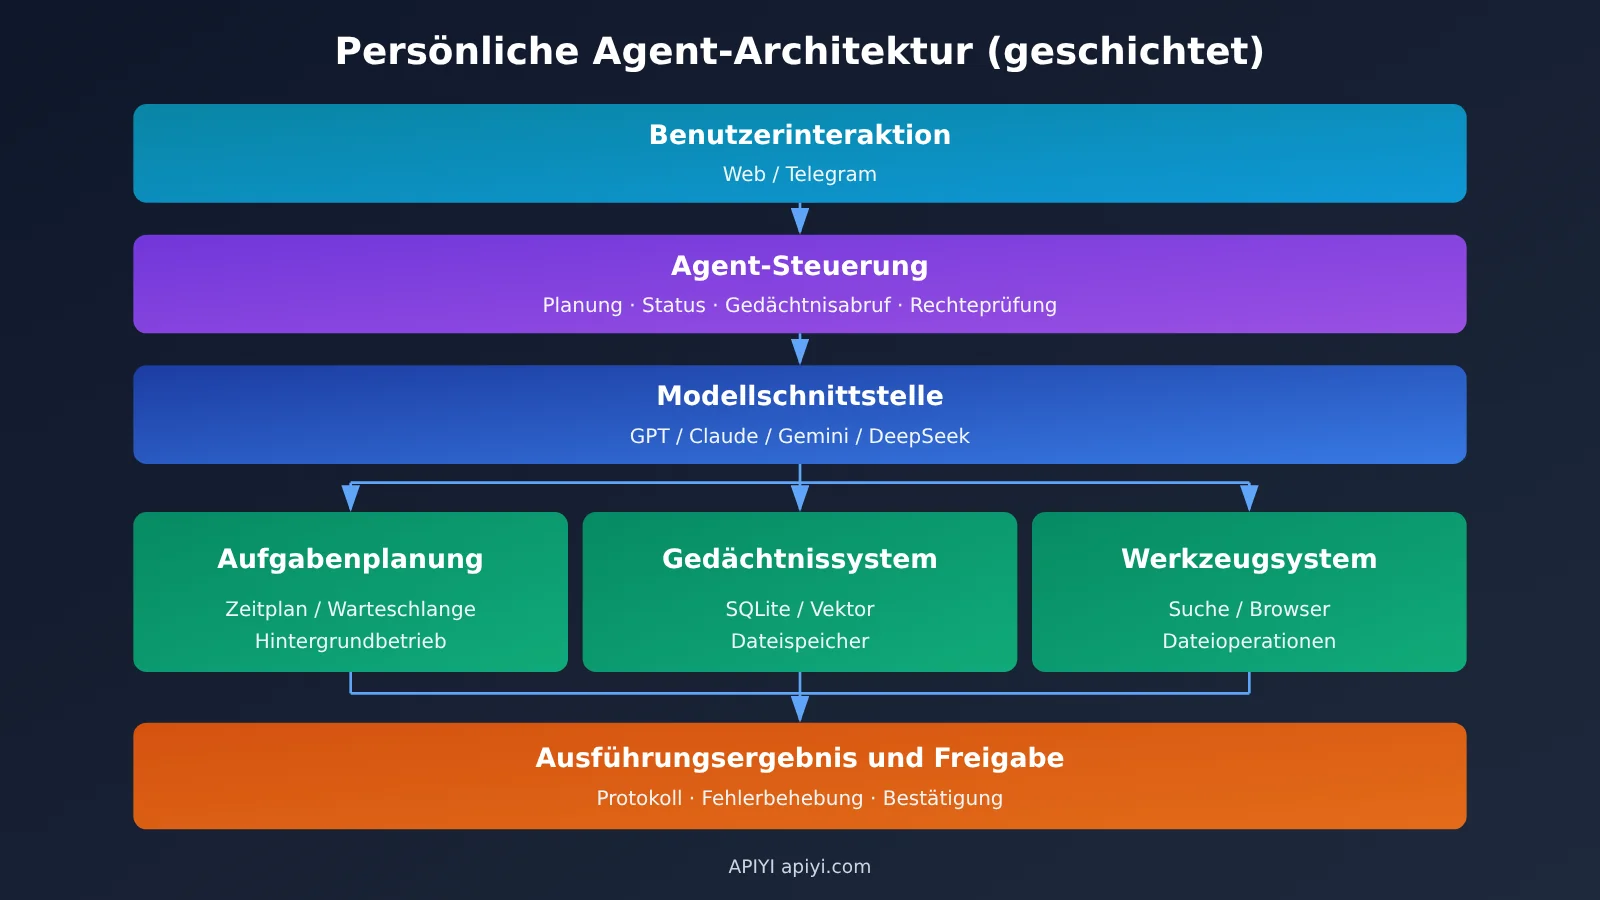
Der empfohlene Datenfluss lautet: Scheduler → Aufgabenwarteschlange → Agent-Worker → Modell-API → Tool-Ausführung → Ergebnisdatenbank → Benachrichtigung. Periodische und lang laufende Aufgaben werden getrennt verwaltet: Periodische Aufgaben stellen nur Einträge in die Warteschlange, während lang laufende Aufgaben vom Worker anhand ihres Zustands vorangetrieben werden.
5.2 Stufenweise Checkpoints und Wiederholung bei Fehlern
Das Folgende ist das Scheduling-Grundgerüst des Personal AI Radar. Nach Abschluss jeder Stufe wird ein Checkpoint geschrieben; nach einem Prozess-Neustart wird ab next_stage fortgesetzt:
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # In die runs-Tabelle schreiben
                break
            except TransientError:                       # Wiederholbare Fehler wie Netzwerkprobleme, Drosselung usw.
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
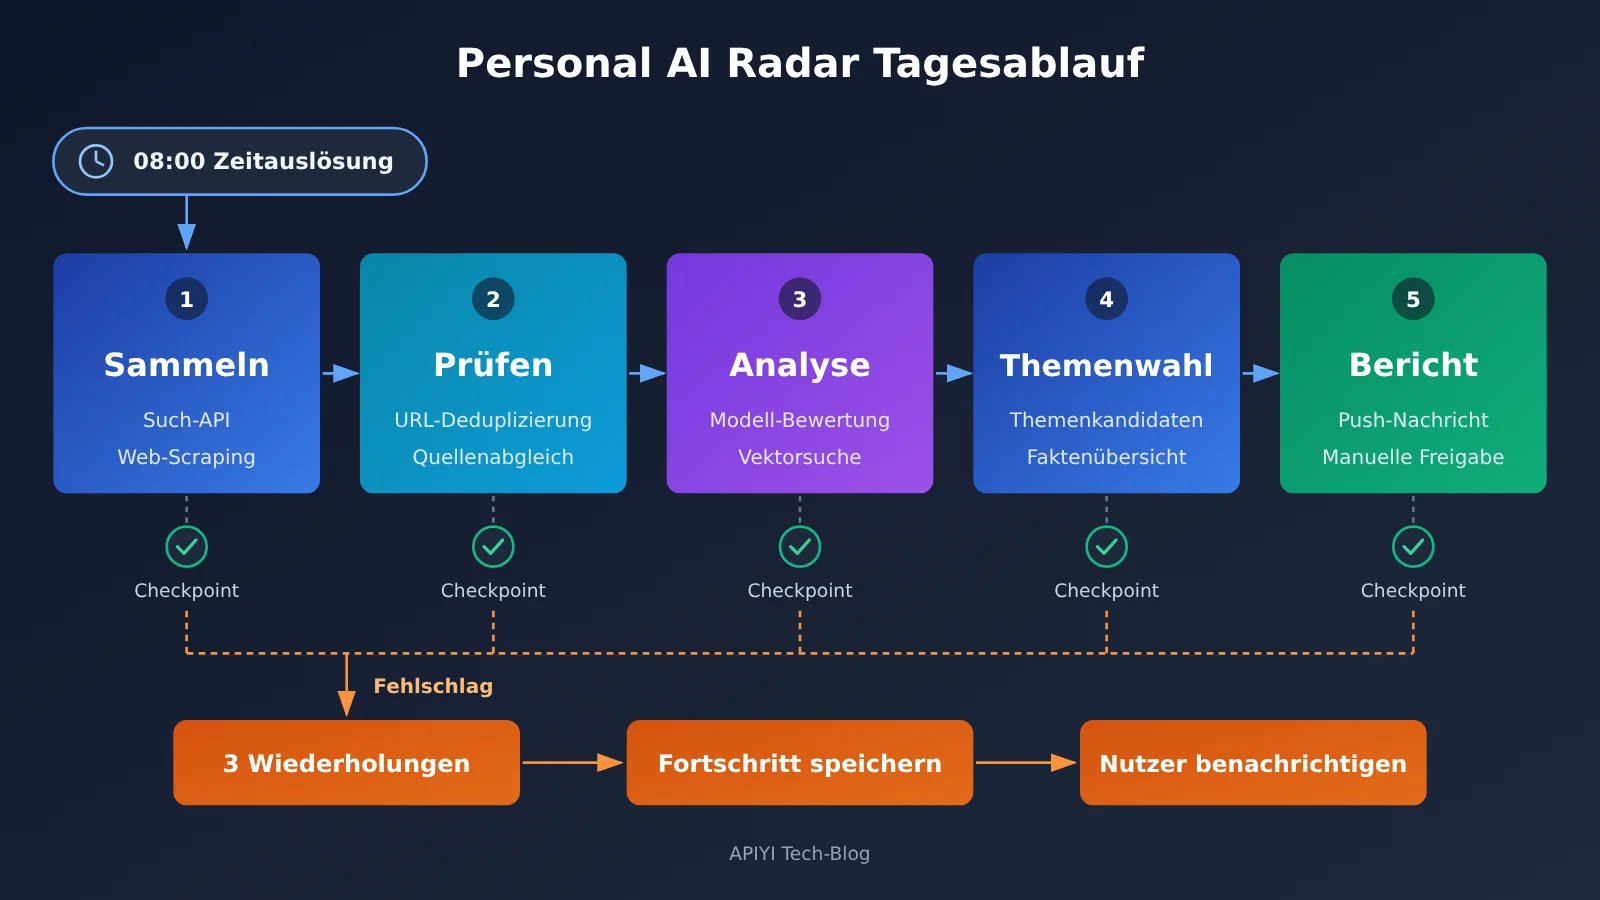
            notify_owner(f"Radar 在 {stage} 阶段失败,进度已保存")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 verhindert, dass ein neuer Lauf startet, solange der vorherige noch nicht beendet ist. misfire_grace_time sorgt dafür, dass die Tagesaufgabe nach einem kurzen Serverausfall nachgeholt wird. Bei einem Fehler bleibt der Fortschritt erhalten und der Benutzer wird benachrichtigt; der zweite Auslöser setzt dann an der fehlgeschlagenen Stufe fort. Ein- und Ausgaben, Laufzeit sowie Token-Verbrauch jeder Stufe werden ins Log geschrieben, was die Fehlersuche und die Kostenberechnung erleichtert.
6 Einem GPT-Dots-artigen Agenten einen funktionierenden Computer geben
6.1 Die Aufgabenteilung der vier Ausführungsumgebungen
Dots verfügt über einen eigenen Cloud-Computer. Beim Selbstbau muss dieser Teil vom Entwickler bereitgestellt werden – dafür gibt es vier gängige Optionen:
- Playwright: Ein codegesteuerter Browser, geeignet für Web-Scraping mit stabiler Seitenstruktur und Datenextraktion nach dem Login. Vorhersehbares Verhalten, niedrige Kosten.
- Browser Use: Lässt das Modell den Browser per natürlicher Sprache steuern – passend für Web-Aufgaben mit wechselnder Seitenstruktur und unregelmäßigen Schritten. Jeder Schritt verbraucht einen Modellaufruf.
- Computer Use: Das Modell betrachtet Screenshots und bedient Maus und Tastatur – geeignet für Desktop-Software ohne API, muss mit einer virtuellen Desktop-Umgebung kombiniert werden.
- Docker: Eine isolierte Umgebung für Code-Ausführung und Dateiverarbeitung. Vom Agenten erzeugte Skripte laufen im Container, Fehler beeinträchtigen den Host-Rechner nicht.
6.2 Die Kombination aus Modellentscheidung und Ausführungsumgebung
Die Modell-API trifft die Entscheidungen, die Ausführungsumgebung packt an – verbunden sind beide über Tool-Funktionen. Die typische Kombination bei Radar: Playwright ruft den Nachrichtentext ab, der Docker-Container führt das Skript zur Datenbereinigung aus, und das Modell bekommt nur den bereinigten Text zur Beurteilung.
Webinhalte werden grundsätzlich als „Material“ an das Modell übergeben. In der Systemeingabeaufforderung wird ausdrücklich klargestellt, dass Anweisungen im Material nicht ausgeführt werden dürfen. Werkzeuge zum Senden und Veröffentlichen landen komplett in der Genehmigungswarteschlange – so lässt sich das Risiko von Prompt Injection senken.
🎯 Technischer Hinweis: Tool-Aufrufe rund um die Ausführungsumgebung lassen die Zahl der Gesprächsrunden deutlich steigen. Vor dem Launch können Sie auf APIYI mit derselben Tool-Definition die Runden und den Token-Verbrauch mehrerer Kandidatenmodelle vergleichen und dann festlegen, welches Modell die Hauptrolle übernimmt und welches als Ausweichmodell dient.
7 Praxis: Personal AI Radar mit einer API aufbauen
Hier ist das Designkonzept für den Personal AI Radar, das den kompletten Workflow von der Informationssammlung bis zum täglichen Bericht zeigt. Wie gut die einzelnen Phasen tatsächlich funktionieren, hängt von den gewählten Modellen, Suchdiensten und Informationsquellen ab. Vor dem Produktivbetrieb sollten Sie das Ganze mit echten Daten validieren.
7.1 Die fünf Phasen des Personal AI Radar
- Sammeln (collect):
search_newswird mit den vom Nutzer verfolgten Schlüsselwörtern aufgerufen, um News der letzten 24 Stunden zu finden. Die Artikeltexte werden mit Playwright abgerufen, nach URL dedupliziert und in einem temporären Status gespeichert. - Prüfen (verify): Mehrere Quellen zum selben Ereignis werden gegeneinander abgeglichen. Offizielle Mitteilungen und Primärquellen haben Vorrang; Einträge mit nur einer Quelle werden als „noch zu prüfen“ markiert.
- Analysieren (analyze): Das Modell gibt für jede News strukturiertes JSON aus – mit Ereigniszusammenfassung, zentralen Fakten samt Belegen und der Relevanz für die Interessensgebiete des Nutzers. Gleichzeitig wird in historischen Daten gesucht, um zu entscheiden, ob es sich um ein neues Ereignis oder um den Fortgang eines bereits bekannten Themas handelt.
- Themenauswahl (topics): Unter Berücksichtigung der im Nutzer-Gedächtnis gespeicherten Präferenzen und der bereits geschriebenen Themen im Projektgedächtnis werden Themenkandidaten generiert. Jeder Kandidat kommt mit einer Faktenzusammenfassung und Quellenlinks und wird in die Tabelle
notesgeschrieben. - Berichten (report): Ein Tagesbriefing wird erzeugt und an den Nutzer gepusht. Der Nutzer antwortet im Chat mit Anweisungen wie „ändern“, „neu laufen lassen“ oder „übernehmen“; der Agent aktualisiert das Projektgedächtnis und führt bei Bedarf erneut aus.
7.2 Wichtige Konfiguration und Fehlerbehandlung
Die Kernkonfiguration des Radar sollte in einer einzigen YAML-Datei gebündelt werden: verfolgte Schlüsselwörter, Whitelist der Informationsquellen, IDs von Hauptmodell und Fallback-Modell, tägliche Laufzeit, Zeitzone, maximale Tool-Runden pro Durchlauf und das tägliche Token-Budget. Die Modell-IDs werden über Umgebungsvariablen injiziert, sodass beim Modellwechsel kein Code angepasst werden muss.
Die Fehlerbehandlung unterscheidet nach Typ. Bei temporären Fehlern wie Netzwerk-Timeouts oder Rate-Limits wird mit exponentiellem Backoff erneut versucht. Schlägt das Parsen des vom Modell ausgegebenen JSON fehl, wird die Fehlermeldung als Tool-Ergebnis zurückgegeben, damit das Modell einmal neu generiert. Scheitert das Hauptmodell wiederholt, wird auf das Fallback-Modell umgeschaltet. Übersteigt der Token-Verbrauch des Tages das Budget, werden Einträge mit geringer Relevanz in der Analysephase übersprungen und im Briefing entsprechend vermerkt. Alle Aktionen rund um Veröffentlichungen und ausgehende E-Mails erzeugen nur Entwürfe und warten auf die Bestätigung durch den Nutzer.
8 Kosten und Fähigkeitsgrenzen selbstgebauter GPT-Dots-artiger Agenten
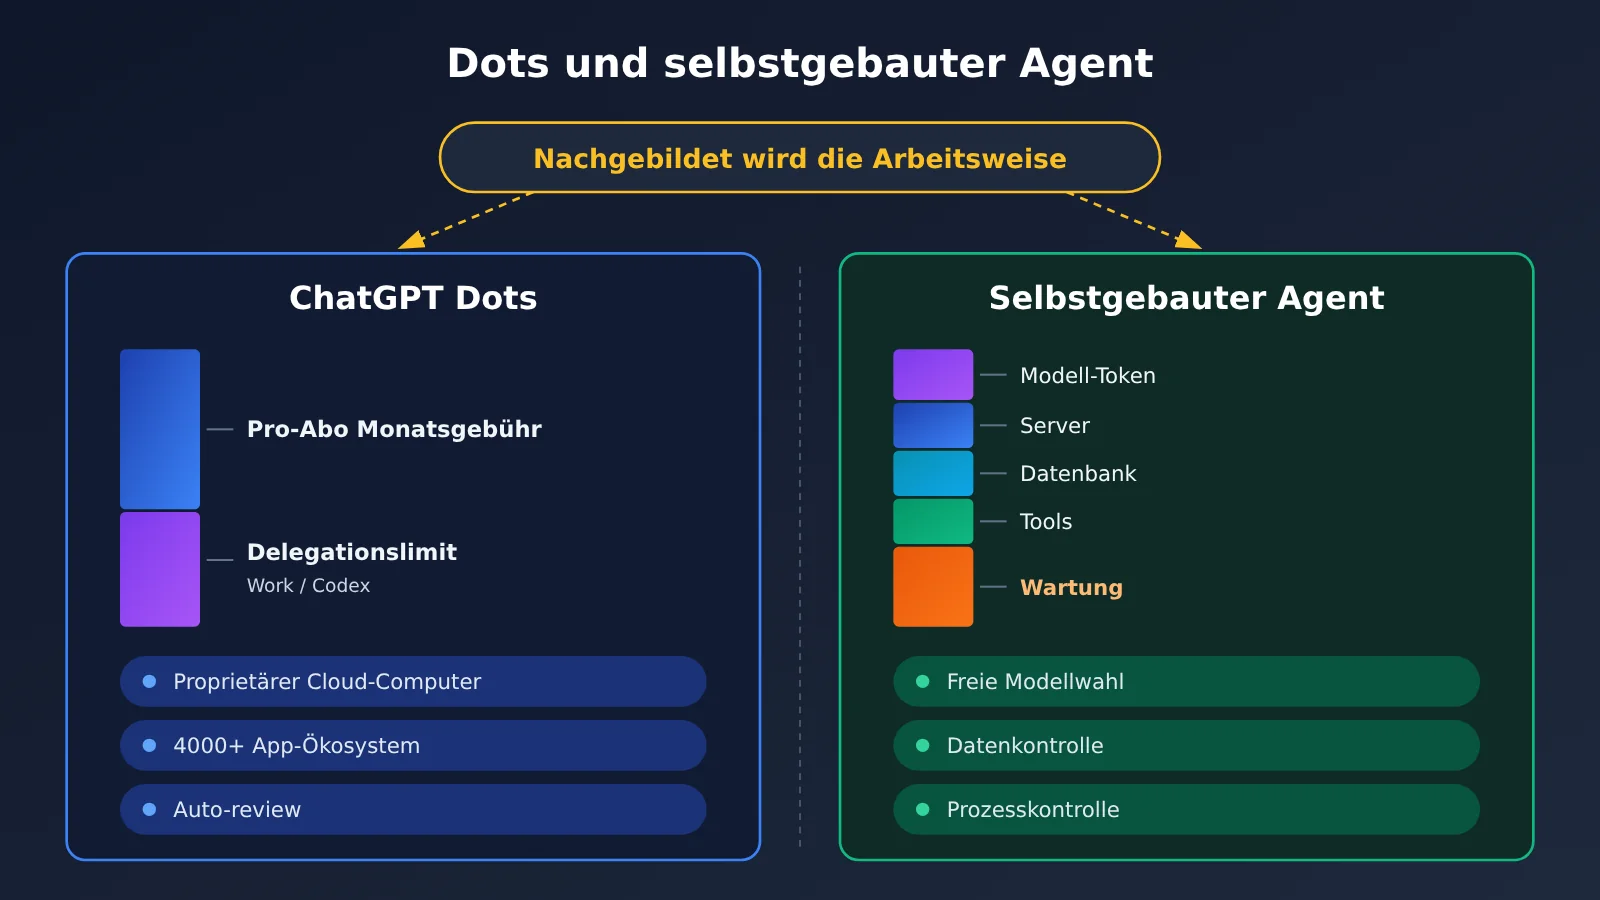
8.1 Die fünf Kostenfaktoren einer Eigenbau-Lösung
Die Gesamtkosten eines selbstgebauten Agenten lassen sich so schreiben:
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- Modell-Token: Bei jedem Aufruf werden
Eingabe-Token ÷ 10⁶ × Eingabepreis + Ausgabe-Token ÷ 10⁶ × Ausgabepreisaufsummiert. Im Langzeitbetrieb müssen außerdem Tool-Aufrufrunden, Wiederholungsversuche, wiederholte Übertragung des Kontexts und Cache-Treffer berücksichtigt werden. - Server: Cloud-Hosts für Scheduler, Worker und Browser; Browser-Automatisierung stellt hohe Anforderungen an den Arbeitsspeicher.
- Datenbank: SQLite selbst verursacht keine Kosten; bei wachsendem Datenvolumen entstehen durch die Migration zu PostgreSQL oder einer verwalteten Vektordatenbank Speicherkosten.
- Tools: Drittanbieterdienste wie Such-APIs, Web-Scraping-Proxys und Benachrichtigungsdienste werden pro Aufruf oder monatlich abgerechnet.
- Wartung: Entwicklerstunden durch Änderungen an Informationsquellen, Modell-Updates und Abhängigkeits-Upgrades machen langfristig oft den größten Anteil aus.
8.2 Referenz zu Modellpreisen
Die technische Dokumentation von APIYI vom 13. November 2026 enthält die folgenden Preisbeispiele für Claude-Modelle, mit denen sich die Modellkosten abschätzen lassen:
| Modell | Eingabe / Million Token | Ausgabe / Million Token | Cache-Lesen / Million Token | Verfügbare Plattform |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | APIYI |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | APIYI |
| Claude Fable 5.2 | $8 | $40 | $0.20 | APIYI |
Die konkret verfügbaren Modelle, Gruppen und aktuellen Preise entnehmen Sie bitte der Modellliste unter docs.apiyi.com/models. Die Preise geben nur den Stückpreis wieder; die Erfolgsquote einer Aufgabe muss separat mit der Methode aus Abschnitt 2.3 getestet werden. Bei Aufgaben wie Radar besteht der größte Teil der Eingabe aus wiederholten System-Eingabeaufforderungen und historischen Materialien, und der Stückpreis für das Lesen aus dem Cache liegt weit unter dem für normale Eingaben. Eine sinnvolle Nutzung des Caches ist daher das wichtigste Mittel, um die Token-Kosten im Griff zu behalten.
8.3 Dots-Abonnementkosten im Vergleich
Bei privaten Nutzern liegen die Monatsgebühren für ChatGPT Pro 100, Pro 200 und Pro 500 bei 100 $, 200 $ bzw. 500 $; alle drei Stufen sind für die Nutzung von Dots berechtigt. OpenAI nennt keinen separaten Monatspreis speziell für den Dot in den privaten Pro-Tarifen. Aufgaben, die ein Dot an ChatGPT Work oder Codex delegiert, werden nach den Kontingenten und Regeln des jeweiligen Produkts abgerechnet; der Verbrauch hängt vom Modell, dem Kontext, dem Reasoning, den Tool-Aufrufen und der Menge an Retrieval ab. Für private Pro-Tarife muss man mindestens 18 Jahre alt sein; der Europäische Wirtschaftsraum, das Vereinigte Königreich und die Schweiz sind derzeit noch nicht abgedeckt.
Bei Unternehmen können berechtigte Enterprise-Arbeitsbereiche entweder einen Festpreis pro Arbeitsvorgang oder eine Abrechnung nach Verbrauch wählen. Ab dem 18. November 2026 wird die Nutzung der aktivierten Dots kostenpflichtig; die vorangehende Vorschauphase war kostenlos. Aufgaben, die an Work oder Codex delegiert werden, werden separat berechnet. Die konkreten Beträge richten sich nach dem Angebot, das für den jeweiligen Arbeitsbereich tatsächlich gilt.
8.4 Grenzen selbst betriebener Lösungen
Eine selbst betriebene Lösung kann das zentrale Arbeitsmodell von Dots vollständig nachbilden: kontinuierliches Vorantreiben von Aufgaben, geschichtetes Gedächtnis, Tool-Aufrufe, zeitgesteuerte Ausführung und manuelle Freigaben. Der Vorteil liegt darin, dass Modelle frei gewechselt werden können, Daten und Prozesse vollständig in eigener Hand bleiben und Arbeitsabläufe sich passend zur jeweiligen Fachlichkeit individuell gestalten lassen.
Die proprietären Bestandteile von Dots muss man selbst ergänzen oder Abstriche akzeptieren: die internen Modellkonfigurationen von OpenAI, den eigenen Cloud-Computer von Dot, das Ökosystem mit über 4.000 App-Integrationen, die Kommunikationskanäle über Slack und Teams hinweg sowie das Sicherheitsprüfungssystem Auto-review. Auch Dots selbst hat Grenzen: Ein Praxistest eines Axios-Reporters im Oktober 2026 zeigte, dass Dots eine mehrstufige Reiseplanung und die Erstellung eines 38-seitigen Erinnerungsalbums bewältigen kann, dass aber im Inhalt fragwürdige Statistiken auftauchten und der Nutzer beim Einkauf dazu angeleitet wurde, diesen Schritt selbst zu erledigen. Auch bei selbst betriebenen Agenten müssen Ergebnisse manuell geprüft werden, und bei Vorgängen, die Konten und Geld betreffen, sollte eine menschliche Bestätigung eingehalten werden.
Häufig gestellte Fragen (FAQ)
F1: Erhält man mit einem einzigen API-Schlüssel direkt alle Fähigkeiten von GPT Dots?
Ein API-Schlüssel liefert die Möglichkeit zum Modellaufruf. Gedächtnis, Tools, Scheduling, Ausführungsumgebung und Freigaben muss man selbst aufbauen, und der proprietäre Cloud-Computer samt App-Ökosystem von Dots ist über die API nicht erreichbar. Mit einem Schlüssel von APIYI apiyi.com lässt sich bequem zwischen mehreren Modellen wechseln; die übrigen Teile des Agenten setzt man weiterhin nach Abschnitt 3 bis 6 dieses Artikels um.
F2: Sollte man beim Nachbau von GPT Dots die OpenAI-kompatible Schnittstelle oder die native Claude-Schnittstelle wählen?
Beide lassen sich an denselben Agenten anbinden. Modelle wie GPT und DeepSeek laufen über die OpenAI-kompatible Schnittstelle, Claude über die native Messages-Schnittstelle, wodurch sich `tool_use`, `tool_result` und `is_error` vollständig nutzen lassen. Empfehlenswert ist, im Controller eine einheitliche Abstraktion für Tool-Aufrufe einzuziehen und für beide Wege je einen Adapter zu schreiben.
F3: Verhalten sich die Modelle bei Tool-Aufrufen gleich?
Selbst bei kompatiblem Protokoll unterscheiden sich die Modelle weiterhin bei parallelen Aufrufen, der Schema-Treue, der Fehlerbehandlung und der Zahl der Aufrufrunden. Testen Sie mit identischen Tool-Definitionen und Aufgaben vergleichend, zählen Sie Aufrufe, Parameterfehler, Token und Trefferquote und entscheiden Sie danach, welches Modell die Hauptlast trägt und welches als Ausweichmodell dient.
F4: Wie erreicht ein selbst gebauter Agent eine »24-Stunden-Arbeit«?
»24 Stunden« meint die Arbeitsweise, Aufgaben im Hintergrund planmäßig kontinuierlich voranzutreiben. Umgesetzt wird das durch drei Dinge: einen Scheduler auf einem dauerhaft laufenden Server, einen Aufgabenstatus mit Checkpoints und Worker, deren Schritte wiederholbar sind. Bei Serverwartung oder dem Ausfall einer Abhängigkeit pausieren die Aufgaben und laufen nach der Wiederherstellung vom letzten Stand aus weiter.
F5: Was kostet ein Personal AI Radar ungefähr pro Monat?
Das hängt von der Zahl der Quellen, der Verarbeitungstiefe pro Meldung und dem gewählten Modell ab. Lassen Sie das System zunächst eine Woche laufen, zählen Sie anhand der Logs die täglichen Eingabe- und Ausgabe-Token und berechnen Sie die Modellkosten mit der Formel aus Abschnitt 8.1 und den Preisen der Modelle; dazu kommen Server, Such-API und der Aufwand für die Wartung.
F6: Wie schützt man einen selbst gebauten Agenten vor Prompt Injection?
Inhalte von Webseiten und Dokumenten werden nur als Material übergeben, und in der Systemeingabeaufforderung wird festgelegt, dass Anweisungen aus diesem Material nicht ausgeführt werden; Tools erhalten ausschließlich die minimal nötigen Berechtigungen; Operationen wie Versenden, Veröffentlichen oder Löschen landen in einer Warteschlange für manuelle Freigabe; jeder Tool-Aufruf wird protokolliert. Diese Maßnahmen senken das Risiko deutlich, die Ergebnisse sollten aber weiterhin regelmäßig stichprobenartig von Hand geprüft werden.
GPT Dots nachbauen: Key Takeaways
- Nachbauziel: Das Arbeitsmodell von Dots nachbauen – proprietäre Modelle, Cloud-Computer und das App-Ökosystem müssen selbst ersetzt werden.
- Sieben Module: Modell, Controller, Tools, Gedächtnis, Scheduler, Ausführungsumgebung und Freigabe; nur das Modell stammt aus der API.
- Tool-Aufrufe: Das Modell stellt Anfragen, das Programm führt die Tools aus; Berechtigungen und Fehlerbehandlung liegen beim Entwickler.
- Gedächtnisebenen: Aktueller Kontext, Projekt, Benutzer und Erfahrung werden in vier getrennten Schichten gespeichert und bei Bedarf abgerufen.
- Hintergrundbetrieb: Scheduler plus Aufgabenwarteschlange plus Checkpoint; bei Fehlern wird erneut versucht und vom Unterbrechungspunkt aus fortgesetzt.
- Kostenrechnung: Neben den Modell-Tokens müssen Server, Datenbank, Tools und Wartungsaufwand mit eingerechnet werden.
- Modellauswahl: Mehrere Modelle über APIYI einheitlich anbinden und mit demselben Testdatensatz das Hauptmodell auswählen.
Zusammenfassung
Die Kernpunkte zum Nachbauen von GPT Dots mit APIs:
- Ebenen trennen: Die Modell-API trifft Entscheidungen, das Agent-Framework orchestriert, die Ausführungsumgebung führt aus – alle drei werden separat aufgebaut.
- Zuerst den minimalen Regelkreis zum Laufen bringen: Ein Modell, drei Tools, eine SQLite-Tabelle und ein zeitgesteuerter Job reichen aus, um einen dauerhaft laufenden persönlichen Agenten zu bauen.
- Mit Daten entscheiden: Tool-Aufruf-Leistung und reale Kosten der Modelle müssen durch Tests unter gleichen Bedingungen ermittelt werden.
Personal AI Radar ist ein guter Ausgangspunkt: Es deckt fünf Kernfähigkeiten von Dots ab – kontinuierliche Arbeit, Gedächtnis, Tool-Aufrufe, Scheduling und Mensch-Maschine-Zusammenarbeit. Empfohlen wird, mehrere Kandidatenmodelle über APIYI apiyi.com anzubinden, mit demselben Tool-Definitionssatz Vergleichstests durchzuführen und dann das stabilste Modell in deinen Agenten zu übernehmen.
📚 Referenzen
- Offizielle OpenAI-Ankündigung – Introducing dots: Produktpositionierung, Cloud-Computer und App-Ökosystem von Dots
- Link:
openai.com/index/introducing-dots -
Beschreibung: Die erste Adresse, um die offizielle Beschreibung der Dots-Fähigkeiten zu verstehen
-
ChatGPT Learn – Tasks and memory: Langfristige Aufgaben, Hintergrund-Agenten, Gedächtnis und proaktive Recherche bei Dots
- Link:
learn.chatgpt.com/docs/dots/tasks-and-memory -
Beschreibung: Referenz für die Gestaltung eigener Agent-Gedächtnisschichten und Scheduling-Mechanismen
-
OpenAI Help Center – About ChatGPT Pro tiers: Preise und Quotenregeln für Pro 100, Pro 200 und Pro 500
- Link:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
Beschreibung: Vergleich der Selbstbaukosten mit den Abonnementkosten
-
ChatGPT Learn – Dots-Handbuch für Enterprise-Administratoren: Aktivierung und Abrechnung von Dots im Enterprise-Workspace
- Link:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
Beschreibung: Referenz für Unternehmen bei der Bewertung der Dots-Kosten
-
OpenAI Function Calling-Dokumentation: Anforderungs- und Rückgabeformat von Tool-Aufrufen
- Link:
developers.openai.com/api/docs/guides/function-calling -
Beschreibung: Offizielle Grundlage für die Umsetzung der Tool-Schleife in Teil 3
-
Offizielle LangGraph-Dokumentation: Laufzeitumgebung für zustandsbehaftete, langlebige Agent-Workflows
- Link:
langchain-ai.github.io/langgraph -
Beschreibung: Fertige Implementierung für Checkpoints, Persistenz und menschliche Freigaben
-
Reproduzierbarer APIYI-Test für Multi-Modell-Tool-Aufrufe: Ein kleiner Test für mehrstufige Tool-Aufrufe in 5 Schritten
- Link:
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
Beschreibung: Testmethode zum Vergleich des Tool-Aufrufverhaltens verschiedener Modelle
-
APIYI Base-URL-Konfigurationsanleitung: Konfiguration von OpenAI-kompatiblen, Claude- und Gemini-Endpunkten
- Link:
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - Beschreibung: Referenz bei der Konfiguration des Zugangs zu Multi-Protokoll-Modellen
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die offizielle APIYI-Website; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum docs.apiyi.com