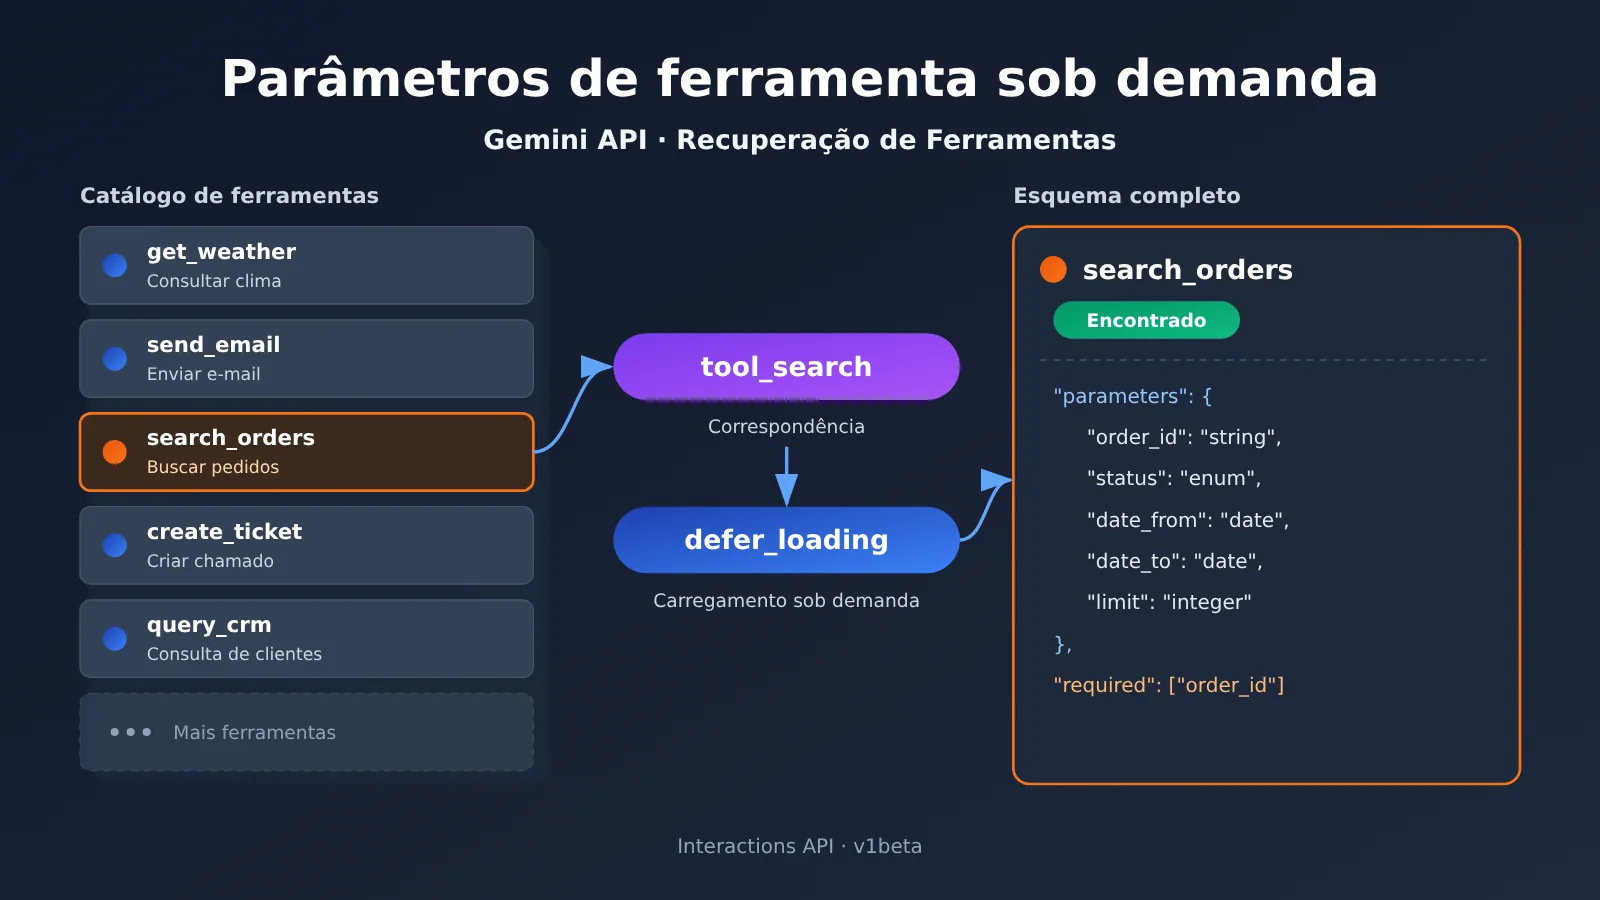
Em 19 de novembro de 2026, o Google lançou, em formato Preview na Gemini Interactions API, o Tool Retrieval (Recuperação de Ferramentas). O agente pode primeiro ver apenas o nome e uma breve descrição da ferramenta e, quando realmente precisar chamá-la, carregar o Schema completo de parâmetros no contexto. O problema que isso resolve é principalmente o de “quanto mais ferramentas são conectadas, mais o contexto fica ocupado por definições de ferramentas ociosas”. Ele é mais adequado para agentes com muitas ferramentas, cujas chamadas se concentram em poucas ferramentas de alta frequência e que também têm muitas ferramentas de cauda longa. Não é algo que todo aplicativo vá economizar só por ativá-lo por padrão.
O que você vai aprender lendo este artigo?
- O que exatamente o Tool Retrieval muda, e por que “o desenvolvedor ainda precisa enviar a declaração completa das ferramentas” e “o modelo não precisa ler o Schema completo antecipadamente” são verdadeiros ao mesmo tempo
- A cadeia de execução completa, do registro de ferramentas até
function_call, e a divisão de trabalho entre recuperação no servidor e recuperação no cliente - Os 4 IDs de modelo atualmente com suporte explícito, o preço padrão e o significado de “não há taxa separada por funcionalidade, mas os Tokens são cobrados normalmente”
- Os dois exemplos ilustrativos oficiais que apontam em direções opostas: quando é possível economizar e quando, ao contrário, fica mais caro
- As restrições que você precisa observar antes de integrar e como avaliar se seu agente vale a pena adotar isso
Índice: a seguir, uma tabela conceitual e um resumo rápido dos impactos ajudam você a alinhar o contexto rapidamente. A seção “Fatos objetivos” explica, em ordem, as informações de lançamento, o mecanismo de funcionamento, o carregamento híbrido e o MCP remoto, os modelos suportados e os custos, e as restrições de uso — tudo com base nos anúncios oficiais e na documentação para desenvolvedores do Google. A seção “Análise e julgamento” traz uma avaliação de cenários de aplicação, o método de medição de linha de base antes da migração e algumas dúvidas comuns; os conteúdos de natureza opinativa ou preditiva serão marcados separadamente.
Conceitos que você precisa conhecer antes do Gemini API Tool Retrieval (To Know)
| Conceito | Explicação breve |
|---|---|
| Tool Retrieval | Primeiro recuperar as ferramentas necessárias, depois adicionar ao contexto do modelo a definição completa dos parâmetros das ferramentas encontradas |
| Interactions API | Interface do Gemini voltada para Agentes, que gerencia histórico de interações, etapas de execução de ferramentas e saídas do modelo; já disponível oficialmente em junho de 2026 |
| Schema de parâmetros | Estrutura que descreve quais parâmetros uma função aceita, quais tipos, quais são obrigatórios, normalmente expressa em JSON Schema |
| Function Calling | O modelo gera o nome da função e os parâmetros, a aplicação executa a função e devolve o resultado ao modelo |
tool_search |
Tipo de ferramenta que declara o mecanismo de recuperação de ferramentas, por meio da qual o modelo busca e carrega as definições das ferramentas |
defer_loading |
Configuração no modo de servidor que adia o carregamento da definição completa dos parâmetros da ferramenta até que a recuperação a encontre |
short_description |
Descrição curta de ferramentas adiadas, para que o modelo identifique a ferramenta no catálogo inicial |
| MCP remoto | Ferramentas fornecidas por serviços de terceiros, conectadas externamente à aplicação via Model Context Protocol |
| Cache implícito | A plataforma reutiliza automaticamente prefixos de contexto idênticos, e a parte correspondente é cobrada pela tarifa de entrada em cache |
Visão rápida dos impactos do Gemini API Tool Retrieval
- Desenvolvedores que estão conectando muitas ferramentas de negócio a Agentes: agora não precisam mais construir seu próprio recuperador de ferramentas — basta deixar o modelo ler sob demanda os Schemas de dezenas ou até centenas de ferramentas. Ainda assim, é necessário enviar o array completo de ferramentas a cada requisição e reavaliar cache e cobrança. Antes da migração, vale medir com o fluxo atual de Function Calling quanto a definição das ferramentas realmente ocupa; dá para usar interfaces unificadas multi-modelo como o APIYI (apiyi.com) para montar rapidamente uma linha de base comparativa.
- Responsáveis por produto e custos: não existe uma taxa de funcionalidade separada, mas cada busca do lado do servidor dispara inferência adicional do modelo. Se economiza ou não depende da escala das ferramentas, do comprimento do contexto e da frequência das buscas — é preciso verificar pelos campos da fatura, não apenas pela direção do marketing.
- Aplicações com poucas ferramentas e chamadas estáveis: os exemplos oficiais mostram que, com um conjunto pequeno de ferramentas sobre um contexto longo, o total de Tokens pode até aumentar; continuar carregando diretamente é a opção mais segura.
- Equipes que usam frameworks de Agente: essa é uma nova capacidade na camada de API do modelo, e os frameworks não necessariamente se adaptam de imediato. Na questão do carregamento progressivo no nível do framework, não dá para assumir que já está resolvida.
Fatos objetivos: o que o Gemini API Tool Retrieval lançou
Informações de lançamento e contexto do Gemini API Tool Retrieval
O blog oficial do Google publicou em 19 de novembro de 2026 o artigo “Introducing Tool Retrieval in the Gemini API”, assinado por Lucia Loher, gerente de produto do Gemini API, e Nora Kassner, pesquisadora do Google DeepMind. O recurso está atualmente em fase Preview e só pode ser usado na Interactions API, exigindo a versão v1beta. O método antigo generateContent não tem suporte.
A preparação do lado da engenharia veio antes do anúncio. Em 18 de novembro, o SDK oficial de Python do Google lançou a versão v3.6.0, e as notas de atualização indicam a inclusão de Schemas públicos relacionados a Tool Retrieval e resultados de funções. No mesmo dia, o SDK de Go v1.79.0 também trouxe as atualizações correspondentes. Olhando para a linha do tempo, o que houve foi o preenchimento de capacidades de descoberta e carregamento sob demanda de ferramentas sobre a Interactions API, que já estava em GA — e não o lançamento de um novo produto de API.
A demanda dos desenvolvedores também tem registro público. Em 18 de março de 2026, um desenvolvedor abriu a Issue #2185 no repositório do SDK de Python pedindo suporte a defer_loading e tool_search, com a justificativa de que, quando um agente se conecta a mais de 30 ferramentas, o Schema completo faz o contexto crescer demais. Os mantenedores do Google responderam em 20 de março, registrando o pedido como solicitação de funcionalidade. Isso é feedback de demanda, não teste de desempenho.
Resumindo o Tool Retrieval em uma frase: as ferramentas podem ser descobertas primeiro; os parâmetros específicos só são lidos quando é hora de chamá-las.
Como o Tool Retrieval muda o carregamento do schema de ferramentas
No carregamento estático tradicional, mesmo que o usuário só queira fazer um reembolso, as declarações de parâmetros de dezenas de ferramentas — pedidos, logística, estoque, CRM e por aí vai — entram no contexto a cada inferência. A documentação do Google menciona que algumas dezenas de declarações de funções já podem consumir dezenas de milhares de tokens. Isso espreme o espaço do histórico da conversa e, quando há muitas ferramentas parecidas, ainda pode atrapalhar o modelo na hora de escolher a ferramenta certa.
O ponto central do Tool Retrieval está em separar três camadas:
- Camada de requisição da API: o desenvolvedor continua enviando a definição completa da ferramenta, incluindo o schema de parâmetros, como sempre fez.
- Contexto inicial do modelo: as ferramentas marcadas com
defer_loading: trueaparecem apenas como nome +short_description. Se não houver uma descrição curta configurada, o sistema usa a primeira frase dadescriptioncompleta. - Fase de invocação da ferramenta: só depois que a ferramenta é encontrada na busca o schema completo entra no contexto, e o modelo gera a chamada com parâmetros a partir dele.
Então o “não carrega todos os parâmetros das ferramentas a cada vez” do título significa, com precisão, que o modelo não lê mais todos os parâmetros completos antecipadamente a cada rodada — e não que o desenvolvedor possa deixar de enviar a declaração completa. No modo servidor, a documentação oficial exige o reenvio do array tools completo em cada requisição, mesmo quando se usa previous_interaction_id.
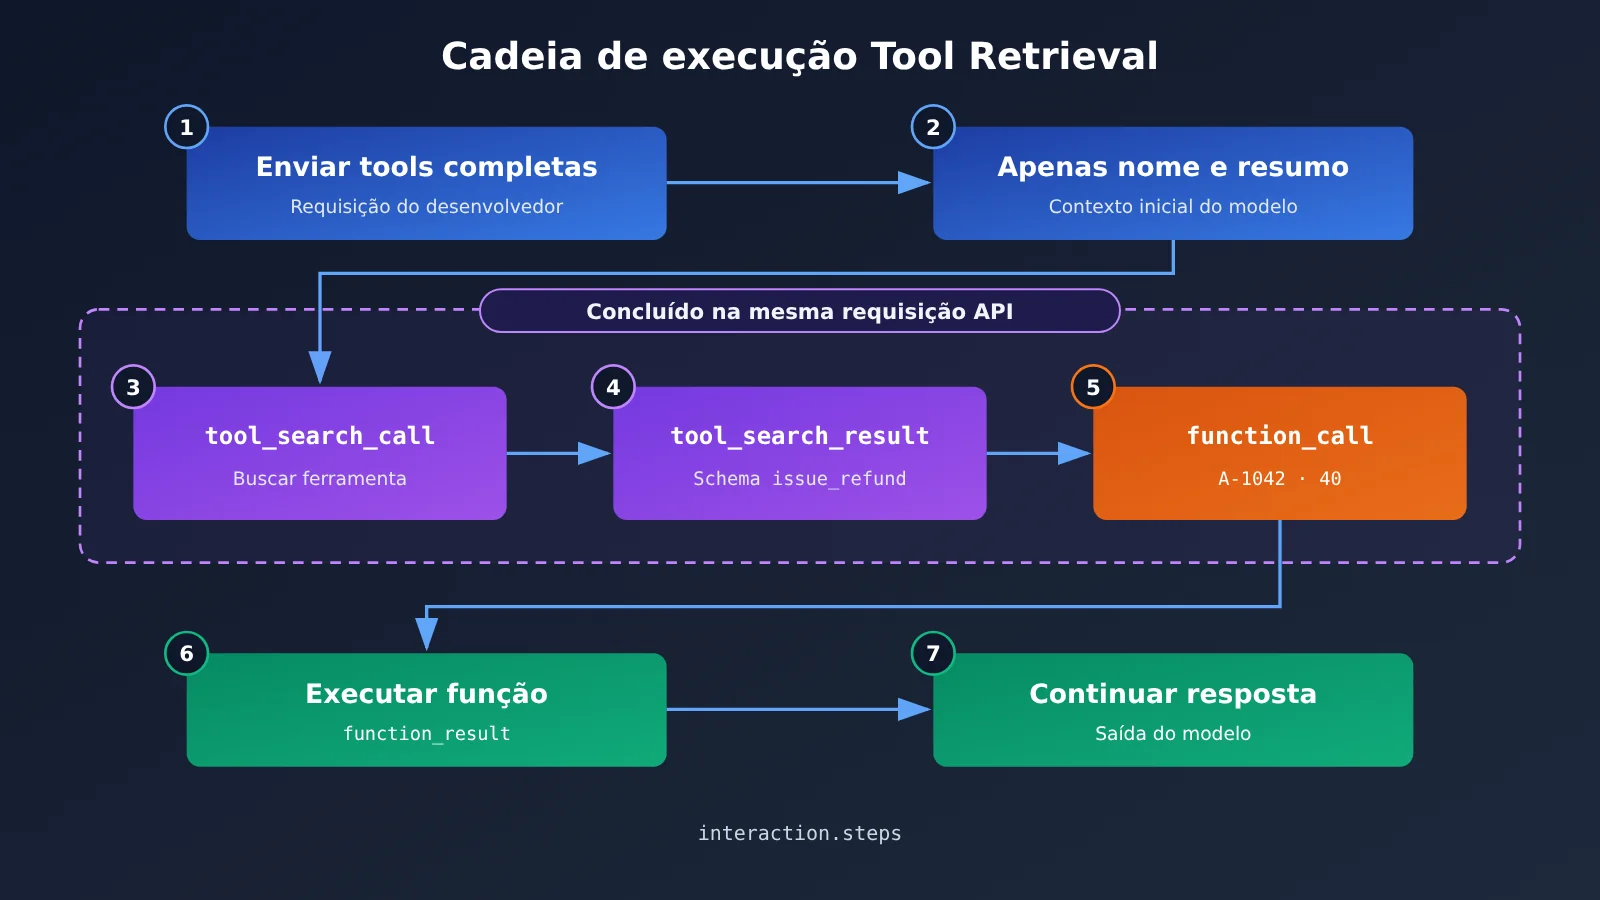
A cadeia de execução do Tool Retrieval: o caso oficial de reembolso como exemplo
O anúncio do Google usa um cenário de reembolso de pedido: o produto do pedido A-1042 chegou danificado e o usuário pede o reembolso de 40 dólares, sendo que a ferramenta necessária é issue_refund. O processo completo de recuperação no lado do servidor é este:
- A requisição declara
{"type": "tool_search"}e definedefer_loading: truepara ferramentas de baixa frequência, comoissue_refund. - O modelo avalia a tarefa, conclui que precisa da capacidade de reembolso e dispara um
tool_search_call. - A API retorna um
tool_search_result, contendo o Schema completo de parâmetros doissue_refund. - O modelo lê a definição dos parâmetros e gera um
function_callcom os parâmetrosorder_id: "A-1042"eamount: 40. - A aplicação executa a função e devolve o
function_result; com base nisso, o modelo segue até concluir a tarefa.
A busca, o carregamento e a geração da chamada de função podem acontecer dentro de uma mesma requisição externa à API, e todas as etapas ficam visíveis em interaction.steps. Vale um alerta: a mesma requisição não significa um único raciocínio interno — cada busca no lado do servidor provoca uma invocação adicional do modelo, que é cobrada. Além disso, trata-se de um caso de demonstração e não representa qualquer estatística de taxa de sucesso de reembolso.
Abaixo está um código ilustrativo, montado a partir da documentação oficial, que se conecta diretamente ao endpoint do Google e serve apenas para mostrar a estrutura da requisição:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
A divisão de responsabilidades do Function Calling continua a mesma. Para funções personalizadas, a API apenas devolve o function_call; executar o reembolso, acessar o banco de dados e lidar com permissões segue sendo trabalho da aplicação. Somente ao conectar um servidor MCP remoto é que a API faz a chamada remota em seu lugar e retorna mcp_server_tool_call e mcp_server_tool_result.
Carregamento híbrido do Tool Retrieval, MCP remoto e dois modos de recuperação
O Google recomenda o uso híbrido: carregar diretamente as ferramentas de alta frequência e deixar o carregamento sob demanda para as ferramentas de cauda longa, especializadas e de baixa frequência. Assim, tarefas simples não precisam passar primeiro por uma rodada de busca, e as capacidades de cauda longa também não ocupam contexto por muito tempo. Servidores MCP remotos também podem ser configurados para carregamento sob demanda como um todo; por exemplo, ao adicionar defer_loading: true a uma configuração com type: "mcp_server", as ferramentas expostas por esse servidor serão carregadas sob demanda, sem precisar declará-las uma a uma.
Além do modo servidor, em que o Gemini realiza a recuperação, a documentação oficial também oferece o modo cliente: o desenvolvedor declara um tool_search com execution: "client", e seu próprio aplicativo consulta o registro de ferramentas, depois coloca as declarações completas das ferramentas correspondentes em function_result.result e as retorna ao modelo. As diferenças entre os dois são as seguintes:
| Dimensão de comparação | Recuperação no servidor | Recuperação no cliente |
|---|---|---|
| Local de execução | Servidor da API Gemini (padrão server) |
Aplicativo do desenvolvedor (client) |
| Precisa construir seu próprio recuperador | Não | Sim |
| Precisa declarar a biblioteca de ferramentas antecipadamente | Sim | Não; novas ferramentas podem ser introduzidas na sessão |
defer_loading |
Aplicável | Não aplicável |
| Ida e volta extra de rede | Sem ida e volta extra do cliente | Uma ida e volta adicional por busca |
| Controle de permissões | Determinado pelo conjunto de ferramentas declarado na requisição | Pode combinar com filtragem de permissões por usuário construída internamente |
| Cenários típicos | Conjuntos de ferramentas grandes e relativamente fixos | Biblioteca dinâmica de ferramentas, multilocatário, registro privado corporativo |
As declarações de função retornadas pelo modo cliente devem ser objetos estruturados e não podem ser convertidas em strings JSON. Em uma mesma requisição, não é possível misturar os dois modos, e no máximo pode-se declarar um tool_search.
Quais modelos o Gemini API Tool Retrieval suporta e como funciona o preço
O anúncio do Google é bastante amplo, afirmando que o Gemini 3.6 e modelos mais recentes são compatíveis, incluindo todos os modelos Gemini 4. No entanto, a documentação para desenvolvedores, até 20 de novembro, lista explicitamente apenas 4 IDs de modelo. Na prática, o ideal é seguir a documentação para desenvolvedores: definir defer_loading em um modelo sem suporte retorna HTTP 400.
| ID do modelo | Preço padrão de entrada (USD / milhão de Tokens) | Preço padrão de saída (incluindo Thinking) | Observações |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Marcado com Free Tier |
gemini-4-argon |
$2.00 ($4.00 a partir de 1º de dezembro) | $10.00 ($20.00 a partir de 1º de dezembro) | Sem Free Tier |
gemini-3.8-flash |
$0.75 ($1.50 a partir de 1º de janeiro de 2027) | $3.75 ($7.50 a partir de 1º de janeiro de 2027) | Marcado com Free Tier |
gemini-3.6-flash |
$0.75 ($1.50 a partir de 1º de janeiro de 2027) | $3.75 ($7.50 a partir de 1º de janeiro de 2027) | Marcado com Free Tier |
Os preços vêm da faixa Standard da página de preços do Google Gemini Developer API. A cota real e os limites de taxa do Free Tier precisam ser confirmados por projeto.
Em relação à cobrança, o Google afirma claramente que o Tool Retrieval não tem uma taxa de funcionalidade independente, mas isso não significa que a busca seja gratuita. A lista de descrições curtas das ferramentas adiadas, as instruções de busca fixas adicionadas ao ativar tool_search, a inferência extra a cada busca no servidor, o Schema completo carregado e sua retenção nas rodadas seguintes — tudo isso é contado em Tokens conforme a tarifa do modelo escolhido. Ao observar custos, preste atenção especial ao campo total_tool_use_tokens, que registra a entrada extra de invocação do modelo provocada pela busca no servidor. Olhar apenas para a queda dos Tokens de entrada iniciais faz com que seja muito fácil superestimar a economia.
Exemplos ilustrativos oficiais de Tokens do Tool Retrieval
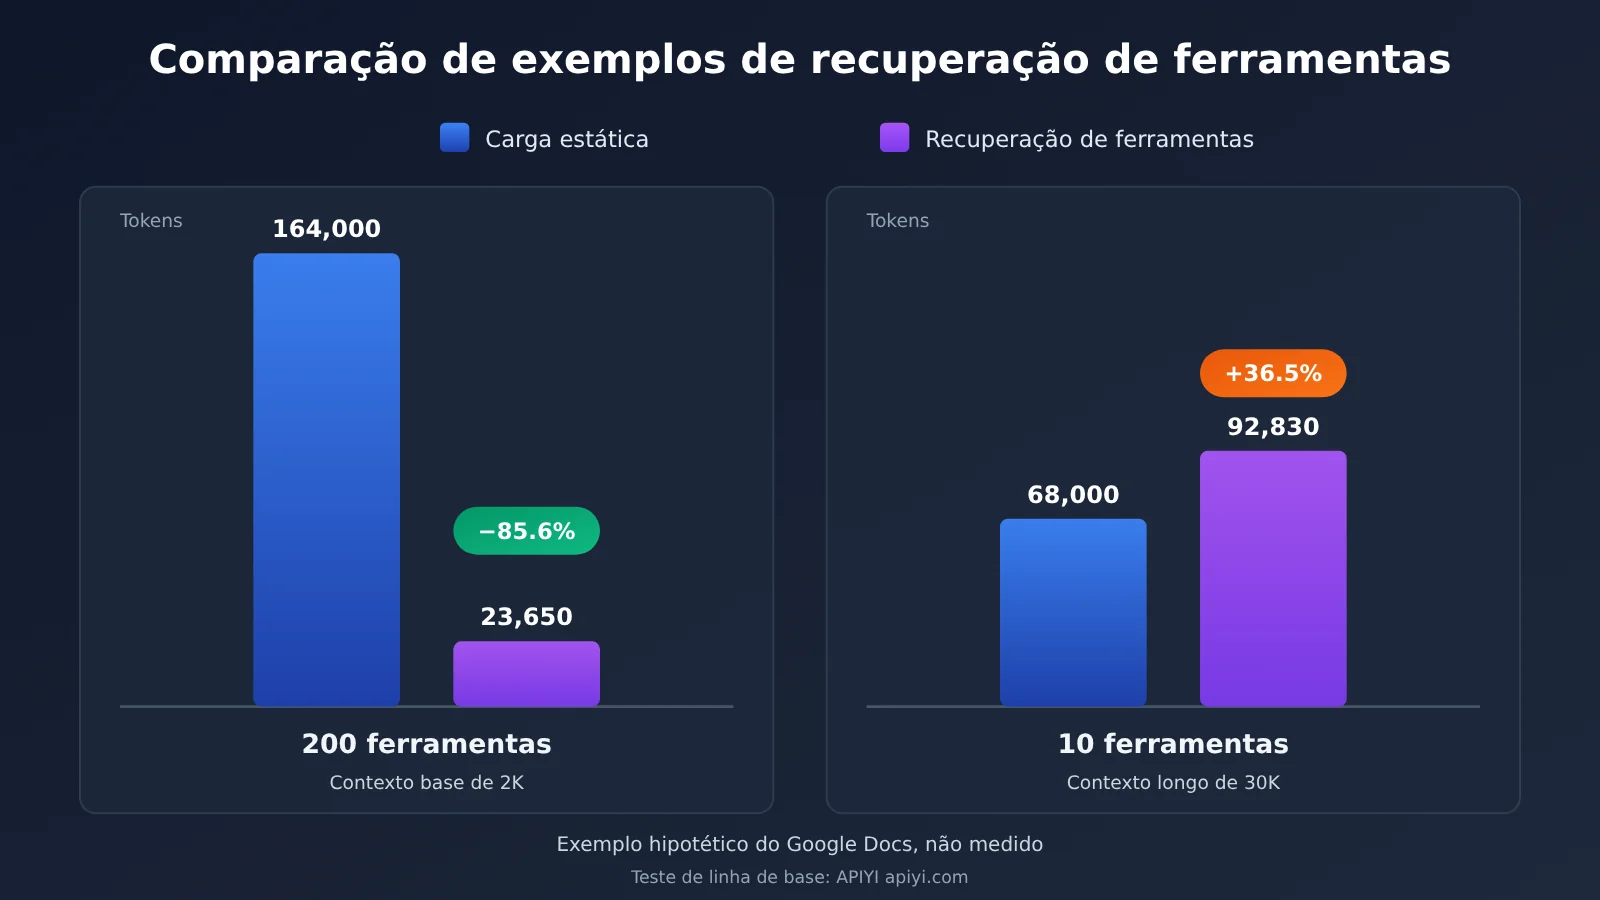
Testes iniciais oficiais mostram que cada ferramenta adiada ocupa, em média, cerca de 26 Tokens no catálogo inicial. É um valor aproximado, não um custo fixo. A documentação também traz dois exemplos hipotéticos de cálculo, com conclusões em direções opostas:
| Cenário (hipótese oficial) | Carregamento estático de todas as ferramentas | Tool Retrieval | Variação |
|---|---|---|---|
| 200 ferramentas, 400 Tokens cada, contexto base de 2.000, 2 ferramentas utilizadas, 2 requisições no total | 164.000 | cerca de 23.650 | redução de cerca de 85,6% (conforme o exemplo calculado) |
| 10 ferramentas, 400 Tokens cada, contexto base de 30.000, 2 ferramentas utilizadas, 2 requisições no total | 68.000 | 92.830 | aumento de cerca de 36,5% (conforme o exemplo calculado) |
A razão pela qual o segundo conjunto de cálculos fica mais caro é que a busca no lado do servidor precisa de uma inferência extra e reprocessa um contexto que já está longo; além disso, as 10 ferramentas em si ocupam pouco espaço, e a economia de Schema não compensa o custo da busca. Os dois conjuntos de números são exemplos hipotéticos explicitamente identificados pelo Google, não contabilizam Tokens de saída nem os ganhos de cache, e não são benchmarks de ambiente de produção. Até a data de verificação do material, o Google não divulgou a proporção de economia de Tokens medida na prática, a melhoria de latência nem o aumento da precisão na seleção de ferramentas.
No que diz respeito a cache, o Google afirma que o Tool Retrieval oferece suporte a cache implícito: o Schema completo não aparece no prefixo inicial, e prefixos como as instruções do sistema e o catálogo de ferramentas tendem a permanecer mais estáveis. Mas a documentação também alerta que o carregamento adiado encurta o prompt inicial, e requisições que antes dependiam de muitos Schemas para atingir o limite mínimo de cache podem, por isso, ficar abaixo desse limite.
Limitações de uso atuais do Tool Retrieval
Os pontos abaixo vêm da documentação oficial e são os que mais costumam dar dor de cabeça no desenvolvimento:
- Ferramentas já carregadas não podem ser descarregadas: assim que um Schema é recuperado, ele permanece na sessão atual. Em sessões muito longas, continuar recuperando novas ferramentas faz o contexto crescer sem parar.
- A cada requisição, é preciso reenviar o array completo de ferramentas: incluindo
tool_search, todas as ferramentas diferidas e não diferidas, e as configurações MCP relevantes. Não basta enviar apenasnameeshort_descriptione omitirparameters. - Não atrase ferramentas citadas explicitamente nas instruções do sistema: o modelo pode ignorar a busca e chamar a ferramenta diretamente, causando erro por falta do contexto de carregamento.
- Em sessões sem estado, preserve integralmente as etapas de recuperação: ao usar
store=falsee gerenciar o histórico por conta própria,tool_search_call,tool_search_resulte seussignaturenão podem ser excluídos nem modificados; caso contrário, a API pode retornar HTTP 400. - Para depurar, observe os steps: mesmo que
interaction.statusnão sejarequires_action, o resultado ainda pode conter umfunction_callaguardando execução. - Quando não há correspondência, a resposta pode vir em texto: se a busca do lado do servidor não encontrar uma ferramenta compatível, ela nem sempre retorna um erro estruturado.
Análise: o que o Tool Retrieval da API Gemini significa para o desenvolvimento de agentes
Quando o Tool Retrieval é adequado
O valor prático desta atualização é separar duas coisas: “manter uma lista completa de ferramentas” e “ler essa lista inteira a cada rodada de raciocínio”. O acervo de ferramentas pode continuar crescendo, enquanto o contexto do modelo mantém apenas um catálogo bem enxuto. Para equipes que integram novos sistemas de negócio continuamente, isso reduz a necessidade de recortar previamente o conjunto de ferramentas e também evita o problema de filtrar ferramentas dinamicamente no lado da aplicação a cada rodada para controlar tokens, o que acaba quebrando o prefixo de cache.
No entanto, os exemplos oficiais já mostram que o ganho tem condições. Combinando com as recomendações de engenharia oficiais, dá para fazer uma avaliação inicial com a tabela abaixo (é uma recomendação de escolha de engenharia, não um limite rígido de quantidade):
| Tipo de agente | Características das ferramentas | Recomendação |
|---|---|---|
| Atendimento ao cliente, assistente de processos de negócio | Dezenas de ferramentas; poucas de consulta têm alta frequência; reembolso, aprovação, contratos etc. têm baixa frequência | Carregar diretamente as de alta frequência; usar recuperação no servidor para a cauda longa |
| Agente de P&D/operações com vários servidores MCP | Muitas ferramentas por servidor, mas cada tarefa usa apenas uma pequena parte | Definir defer_loading para o servidor MCP como um todo |
| Plataformas multiusuário que expõem ferramentas conforme permissões | O conjunto de ferramentas varia conforme usuário e workspace | Recuperação no cliente, combinada com registro próprio e filtragem de permissões |
| Assistentes pequenos | Menos de cerca de 20 ferramentas estáveis, a maioria usada a cada rodada | Continuar com carregamento estático |
| Contexto longo + buscas frequentes | Conversas muito longas, muitas vezes com várias recuperações por rodada | Testar antes de decidir; há risco de aumento do custo líquido |
Nossa avaliação é: quanto mais “cauda longa” for a distribuição de chamadas de ferramentas, mais vale a pena usar o Tool Retrieval. Por outro lado, se a maioria das ferramentas é usada a cada rodada, o carregamento diferido só acrescenta uma inferência de busca extra.
Antes de migrar para Tool Retrieval, meça o consumo real do Schema de ferramentas
A decisão de migrar deve se basear nos dados do seu próprio negócio. Antes de migrar, você pode usar o fluxo atual de Function Calling compatível com OpenAI para medir a diferença de tokens de entrada entre duas requisições: “todas as ferramentas” e “apenas as ferramentas realmente usadas”. Assim, você obtém o consumo real do Schema de ferramentas. O script abaixo faz essa medição de linha de base, e não é o Tool Retrieval em si:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI, usada para medir a linha de base de carregamento estático
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
Ver o script completo de medição de linha de base (comparação em lote por quantidade de ferramentas)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mede o custo de Schema de ferramentas de diferentes modelos pela interface unificada da APIYI
)

def load_tools(path: str) -> list:
    """Lê definições de ferramentas no formato OpenAI a partir do registro de ferramentas do negócio (arquivo JSON)"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 Dica técnica: antes de avaliar o Tool Retrieval, você pode rodar a linha de base de carregamento estático em vários modelos mainstream com uma única chave API pela APIYI apiyi.com, para entender quanto o Schema de ferramentas realmente ocupa na sua requisição. Depois de obter a linha de base, ative
tool_searchna Gemini Interactions API para fazer uma comparação e comparar a soma detotal_input_tokensetotal_tool_use_tokens.
Vale explicar que o Tool Retrieval depende da interface v1beta da Interactions API e de campos dedicados; as chamadas compatíveis com OpenAI acima servem apenas para medir o custo do carregamento estático. No teste comparativo, recomenda-se manter consistentes o modelo, a biblioteca de ferramentas, o conjunto de tarefas, o comprimento do contexto e as condições de cache; depois compare custo total cobrado, tempo ponta a ponta, taxa de escolha correta de ferramentas e número médio de buscas. Assim você consegue atribuir as diferenças à estratégia de recuperação. Se quiser comparar horizontalmente as diferenças de linha de base entre modelos no mesmo conjunto de scripts, a interface unificada da APIYI apiyi.com elimina o trabalho de integração individual com cada fornecedor.
Próximos desenvolvimentos que vale a pena acompanhar (julgamento preditivo)
Os pontos a seguir são julgamentos, não fatos confirmados.
Primeiro: o anúncio e a documentação de desenvolvimento divergem quanto ao escopo de modelos suportados. Vale acompanhar as atualizações da documentação para saber se modelos como Gemini 4 Carbon e Gemini 4 Neon entrarão na lista de compatibilidade. Segundo, “um Schema já carregado não pode ser descarregado” é uma limitação clara de Agents em sessões longas. Se a versão final oferecer um mecanismo de descarregamento ou descarte, isso afetará diretamente o desempenho em tarefas longas. Terceiro, usuários do Google ADK já relataram na Issue #7241 problemas com carregamento progressivo e invalidação de cache. O fato de a API do modelo oferecer suporte a um novo recurso não significa que o framework vá adotá-lo automaticamente; vale acompanhar o ritmo de adaptação na camada do framework.
A ideia de carregar definições de ferramentas sob demanda já tinha precedentes no setor; desta vez, o Google está basicamente adicionando esse recurso à interface de Agent do Gemini. Como a interface pode mudar na fase Preview, ao integrar em sistemas de produção é recomendável manter uma opção de fallback para o carregamento estático.
Algumas dúvidas comuns sobre o Gemini API Tool Retrieval
Q1: Com o Tool Retrieval ativado, o corpo da requisição fica menor?
Não. No modo do lado do servidor, cada requisição ainda precisa enviar o array completo de ferramentas; o que diminui é o espaço ocupado pelas ferramentas no contexto inicial do modelo. Se quiser primeiro calcular o volume das definições de ferramentas nas requisições atuais, você pode usar o script acima para medir uma linha de base via APIYI apiyi.com.
Q2: O Google diz oficialmente que é possível economizar 85%?
Não existe uma conclusão assim baseada em testes reais. Os 85.6% foram estimados a partir de um exemplo hipotético com 200 ferramentas; o mesmo documento também apresenta um contraexemplo em que, com um conjunto pequeno de ferramentas, os Tokens aumentam cerca de 36.5%.
Q3: O Tool Retrieval é cobrado?
Não há uma taxa separada pelo recurso, mas instruções de busca, inferência extra e Schemas carregados são contados em Tokens de acordo com a tarifa do modelo. Equipes que precisam controlar o orçamento podem primeiro testar em pequena escala, com cobrança por uso via APIYI apiyi.com, os custos de Function Calling de diferentes modelos e só então decidir qual modelo usar no Agent.
Q4: Com o Tool Retrieval, não preciso mais executar as funções por conta própria?
Não. Funções personalizadas continuam sendo executadas pela aplicação, que devolve os resultados; o Tool Retrieval só encontra e carrega as definições de ferramentas. Apenas ferramentas MCP remotas são chamadas pela API em seu nome.
As bibliotecas de ferramentas vão crescer cada vez mais, mas a cada rodada normalmente só precisamos de algumas delas. O Tool Retrieval separa “deixar as ferramentas prontas” de “usar quando quiser”; se usado bem, deixa Agents grandes mais leves, mas se usado do jeito errado também pode custar uma rodada extra de inferência. Como dizem os Analectos (Lunyu), no capítulo Wei Ling Gong: “Para fazer bem o seu trabalho, é preciso primeiro afiar as ferramentas.” Primeiro meça bem o peso de cada “ferramenta” que você tem em mãos e só então decida como organizá-las.
📚 Materiais de referência
-
Anúncio oficial do Google: Apresentando o Tool Retrieval na API Gemini (2026-11-19)
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Descrição: informações do lançamento, objetivos de design, os dois modos de recuperação e os princípios de precificação
- Link:
-
Documentação de desenvolvimento do Google Tool Retrieval: configuração, limitações, cobrança e exemplos ilustrativos de cálculo
- Link:
aistudio.google.com/docs/tool-retrieval - Descrição: lista de modelos suportados, campos de Usage, práticas recomendadas e erros comuns
- Link:
-
Preços da Gemini Developer API: preços padrão dos modelos e tarifas de cache
- Link:
aistudio.google.com/docs/pricing - Descrição: preço unitário de entrada e saída de cada modelo e data de vigência
- Link:
-
Documentação da Interactions API: posicionamento da interface e etapas de execução
- Link:
aistudio.google.com/docs/interactions-overview - Descrição: conversa com estado, estrutura de
stepse diferenças em relação aogenerateContent
- Link:
-
Google Python SDK v3.6.0 e Issue #2185: evidências de engenharia e registro das necessidades dos desenvolvedores
- Link:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - Link:
github.com/googleapis/python-genai/issues/2185 - Descrição: atualização do Schema público do SDK e demandas iniciais da comunidade
- Link:
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para falar com a gente pela página inicial da APIYI apiyi.com; há mais materiais de integração disponíveis no centro de documentação docs.apiyi.com