Anmerkung des Autors: Mit einem einzigen Schlüssel, einem festen Satz von Skripten und einer gezielt injizierten Fehlersituation vergleichen wir mehrere Modelle in ihren Fähigkeiten bei mehrrundigen Tool-Aufrufen – für reproduzierbare und nachprüfbare Ergebnisse.
Bei der Auswahl eines Modells für einen Agenten erleben viele Teams dasselbe Problem. Bei Single-Turn-Fragen unterscheiden sich die Modelle kaum; sobald es jedoch in die mehrrundige Schleife geht – „Tool aufrufen → Ergebnis erhalten → erneut aufrufen → Fehler behandeln → strukturierte Antwort liefern“ –, treten die Unterschiede hervor. Dieser Artikel stellt einen kleinen Test für mehrrundige Tool-Aufrufe mit einem Schlüssel für mehrere Modelle vor und hilft dir, diese Unterschiede mit sehr geringem Aufwand in Daten zu verwandeln, die sich aufzeichnen und später nachprüfen lassen.
Das ist keine Modell-Rangliste. Dieser Artikel liefert keine ungeprüften Benchmark-Werte, sondern zeigt nur, wie du einen Test entwirfst, mit dem du in deinem eigenen Geschäftsszenario zu Schlussfolgerungen kommst. Der entscheidende Punkt beim Testen ist die Kontrolle der Variablen: derselbe Schlüssel, dieselben Tool-Definitionen, dieselben Mock-Daten – nur der Modellname ändert sich. Über eine Aggregationsplattform wie APIYI apiyi.com kannst du mit einem Schlüssel mehrere Modelle wie DeepSeek, Gemini, Qwen, Claude und GPT aufrufen. Das spart beim Quervergleich eine Menge Wechselaufwand.
Der Kernnutzen: Nach dem Lesen kannst du einen reproduzierbaren 5-Schritte-Test für mehrrundige Tool-Aufrufe aufbauen. Er deckt die fünf entscheidenden Punkte ab: Tool-Auswahl, Parameterprüfung, Rückgabe der Aufruf-ID, Wiederholungsversuch nach Fehlern und abschließende JSON-Validierung.
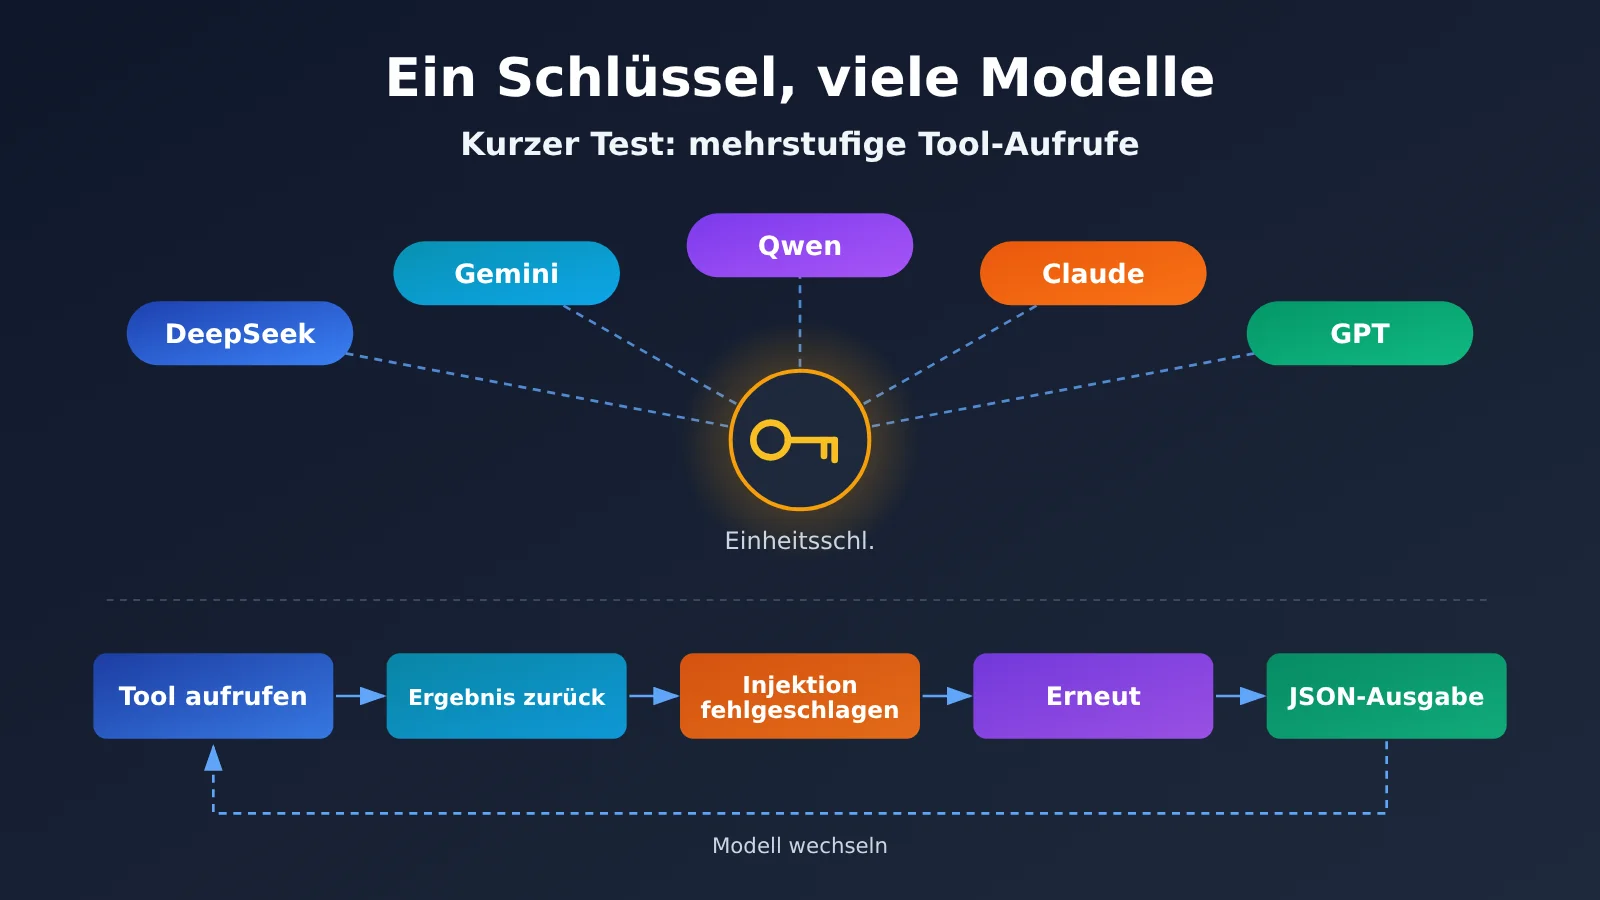
Kernpunkte des kleinen Tests für Mehrrunden-Tool-Aufrufe
Bevor du einen Test für Mehrrunden-Tool-Aufrufe entwirfst, solltest du klären, was „reproduzierbar“ bedeutet. Dieselbe Eingabe sollte zu unterschiedlichen Zeiten und von unterschiedlichen Personen ausgeführt zu vergleichbaren Ergebnissen derselben Art führen. Eine einzelne schön formatierte Ausgabe taugt nicht als Schlussfolgerung. Die folgende Tabelle zeigt das Grundgerüst des gesamten Tests.
| Kernpunkt | Beschreibung | Nutzen |
|---|---|---|
| Ein Schlüssel, mehrere Modelle | Alle Modelle laufen über denselben API-Eingang; nur das Feld model wird geändert |
Schließt Störungen durch Netzwerk, Authentifizierung und SDK-Version aus |
| Feste Mock-Tools | Tool-Rückgabewerte sind fest verdrahtet, keine Verbindung zu echten Datenbanken oder externen Diensten | Jeder Lauf sieht exakt dieselben Tool-Ergebnisse |
| Eine Fehlersituation gezielt einbauen | Ein Tool gibt beim ersten Aufruf fest einen Fehler zurück, der einen erneuten Versuch zulässt | Beobachten, ob das Modell korrekt erneut versucht und ob es Daten erfindet |
| Strukturierter Endpunkt | Die endgültige Antwort muss JSON sein, das dem Schema entspricht | Bestehen oder Scheitern lässt sich programmatisch automatisch feststellen |
| Vollständige Nachvollziehbarkeit | Anfrageparameter, Rohantwort, usage und Laufzeit speichern |
Schlussfolgerungen sind überprüfbar, und nach einem Wechsel der Modellversion sind Regressionstests möglich |
Warum Tests für Mehrrunden-Tool-Aufrufe „klein“ sein sollten
Tests sollten klein sein, weil große Tests schwer zu reproduzieren sind. Eine echte Tool-Kette in der Praxis kann aus einem Dutzend Tools bestehen und von externen Systemen abhängen. Jede Schwankung an irgendeiner Stelle wird dann schnell fälschlich dem Modell zugeschrieben. Ein guter kleiner Test braucht nur zwei bis drei schreibgeschützte Tools und einen künstlich injizierten Fehler, um die fehleranfälligsten Stellen der Mehrrunden-Schleife abzudecken.
Der Test muss außerdem „vollständig“ sein. Er muss die gesamte Schleife durchlaufen; es reicht nicht, nur zu prüfen, ob das Modell in der ersten Runde einen Tool-Aufruf auslöst. Viele Modelle zeigen in der ersten Runde gute Leistung; die Probleme treten in der zweiten oder dritten Runde auf: Sie übergeben nicht die richtige Aufruf-ID, geben nach einem Fehler sofort auf oder erfinden ohne Daten eine Sendungsnummer. Diese Probleme werden erst sichtbar, wenn die Schleife bis zur letzten Runde läuft.
Designprinzipien für das Testen mehrerer Modelle mit einem Schlüssel
Kontrollierte Variablen sind die Voraussetzung für Vergleichstests. Wenn Modell A das offizielle SDK verwendet, Modell B ein SDK eines Drittanbieters und Modell C zusätzlich eine andere Proxy-Adresse, lässt sich am Ende nicht unterscheiden, ob die Unterschiede vom Modell oder von der Kette stammen. Nach der Vereinheitlichung des Eingangs bleiben Authentifizierung, Wiederholungsstrategie, Timeout-Einstellungen und Logformat konsistent; die einzige Variable ist das Modell selbst.
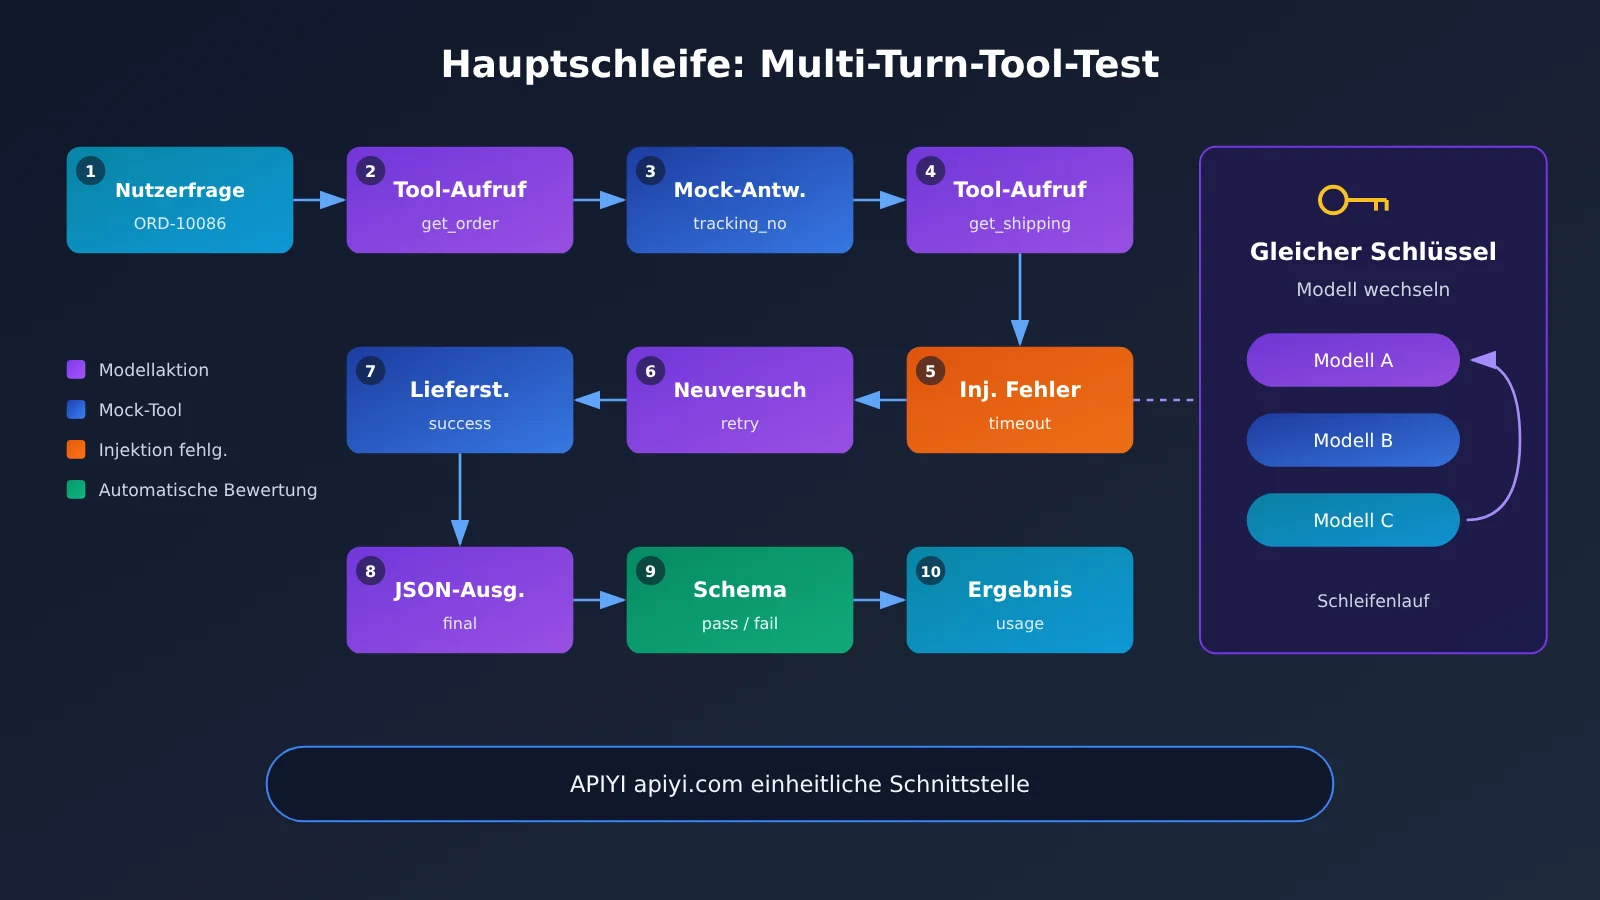
Schnellstart: Kleiner Test für Multi-Turn-Tool-Aufrufe
Dieser Abschnitt enthält keinen Code. Er listet nur Parameter, Tool-Definitionen und Ausführungsschritte auf. Du kannst ihn in jeder Sprache umsetzen, die dir vertraut ist – Python, Node.js oder auch ein Shell-Skript. Wichtig ist, dass jede Einstellung in einer festen Konfigurationsdatei festgehalten und zusammen mit den Testergebnissen gespeichert wird.
Schritt 1: Einheitliche Schnittstelle und Ausführungsparameter
Lege zuerst den API-Endpunkt und die Sampling-Parameter fest. APIYI ist sowohl mit dem OpenAI- als auch mit dem Anthropic-Schnittstellenformat kompatibel. Derselbe API-Schlüssel lässt sich sowohl für Aufrufe im Chat-Completions-Stil als auch im Messages-Stil verwenden. Die folgende Tabelle listet die Einstellungen auf, die du fest vorgeben solltest.
| Konfigurationselement | Empfohlener Wert | Beschreibung |
|---|---|---|
| base_url (OpenAI-Format) | https://api.apiyi.com/v1 |
Aufruf über den einheitlichen APIYI-Einstiegspunkt; die genaue Adresse richtet sich nach der Dokumentation auf docs.apiyi.com |
| base_url (Anthropic-Format) | Siehe Anthropic-kompatible Adresse in der APIYI-Dokumentation | Für Tests des tool_use-/tool_result-Protokolls |
| api_key | Derselbe API-Schlüssel | Wird von allen Modellen gemeinsam genutzt, um Unterschiede bei der Authentifizierung auszuschließen |
| temperature | 0 oder möglichst niedrig | Verringert die Zufälligkeit; falls einige Reasoning-Modelle dies nicht unterstützen, den tatsächlichen Wert protokollieren |
| max_tokens | Fester Wert | Verhindert Fehlurteile durch abgeschnittene Ausgaben |
| tool_choice | auto | Beobachtet die eigenständige Entscheidung des Modells, ohne einen Aufruf zu erzwingen |
| Maximale Anzahl Schleifenrunden | Festes Limit, z. B. 6 Runden | Verhindert, dass das Modell in eine endlose Wiederholungsschleife gerät |
| Anzahl der Läufe pro Modell | Feste Anzahl, z. B. 5 Läufe | Stabilität anhand mehrerer Ergebnisse beurteilen, nicht anhand eines einzelnen Laufs |
🚀 Schnellstart-Tipp: Du kannst dich zuerst bei APIYI auf apiyi.com registrieren und einen API-Schlüssel abrufen. Rufe dann die Kandidatenmodelle nacheinander mit demselben API-Schlüssel auf. Prüfe, ob jedes Modell eine ordnungsgemäße Tool-Aufruf-Antwort zurückgibt, bevor du mit dem eigentlichen Test beginnst. Hinweise zur Anbindung findest du unter docs.apiyi.com.
Schritt 2: Zwei bis drei schreibgeschützte Tools definieren
Für das Tool-Design gelten zwei Anforderungen: schreibgeschützt und deterministisch. Schreibgeschützt verhindert, dass während des Tests versehentlich Schreibvorgänge ausgelöst werden; deterministisch stellt sicher, dass jeder Aufruf denselben Rückgabewert liefert. Empfohlen wird ein fiktives Bestellabfrage-Szenario mit zwei Tools:
- get_order: Parameter ist
order_id(String, festes Format „ORD-“ plus Ziffern). Gibt immer Bestellstatus, Produktname und Sendungsnummertracking_nozurück. - get_shipping: Parameter ist
tracking_no(String). Der erste Aufruf liefert immer einen Fehler, dessen Inhalterror=timeoutundretryable=trueenthält; ab dem zweiten Aufruf werden ein fester Sendungsstatus und ein voraussichtliches Lieferdatum zurückgegeben. - Optionales Ablenkungstool
get_coupon: steht in keinem Zusammenhang mit der Frage und dient dazu zu beobachten, ob das Modell es unnötig aufruft.
Das Parameter-Schema muss streng formuliert sein: Feldtypen, Pflichtfelder und Regex-Format müssen eindeutig angegeben werden. Die vom Modell erzeugten Parameter werden zuerst gegen das Schema validiert und erst danach an die Mock-Funktion übergeben. Bei fehlgeschlagener Validierung wird ein „Parameterfehler“ protokolliert; keine stillschweigende Korrektur.
Schritt 3: Feste Eingabeaufforderung und Nutzerfrage schreiben
Die System-Eingabeaufforderung enthält nur Regeln, keine Antworten. Darin kann das Modell angewiesen werden, ausschließlich anhand der von den Tools zurückgegebenen Daten zu antworten, bei einem wiederholbaren Tool-Fehler höchstens zweimal erneut zu versuchen und am Ende nur ein JSON-Objekt mit den Feldern order_status, shipping_status, eta und data_source auszugeben. Die Nutzerfrage ist fest und besteht aus einem Satz, zum Beispiel: „Kannst du mir sagen, wo die Bestellung ORD-10086 gerade ist?“
Sobald die Eingabeaufforderung festgelegt ist, wird sie nicht mehr geändert. Wenn im Test ein Modell wegen einer mehrdeutigen Eingabeaufforderung scheitert, ist der richtige Weg, eine neue Versionsnummer anzulegen und alle Modelle mit der neuen Version erneut zu testen, statt die Eingabeaufforderung nur für dieses eine Modell zu ändern.
Schritt 4: Ausführungsschleife durchführen und Fehler injizieren
Die Ausführungslogik läuft in dieser Reihenfolge ab:
- System- und User-Nachrichten sowie die Tool-Definitionen senden.
- Enthält die Antwort Tool-Aufrufe, werden die Parameter der Reihe nach validiert, die passende Mock-Funktion ausgeführt und das Ergebnis protokollkonform zurückgegeben.
- Beim ersten Aufruf von
get_shippingwird fest ein wiederholbarer Fehler zurückgegeben. - Schritt 2 so lange wiederholen, bis das Modell eine finale Antwort ohne Tool-Aufrufe liefert oder die maximale Rundenzahl erreicht ist.
- Die finale Antwort mit JSON Schema validieren und alle Nachrichten, die Rohantwort sowie die
usagejeder Runde speichern.
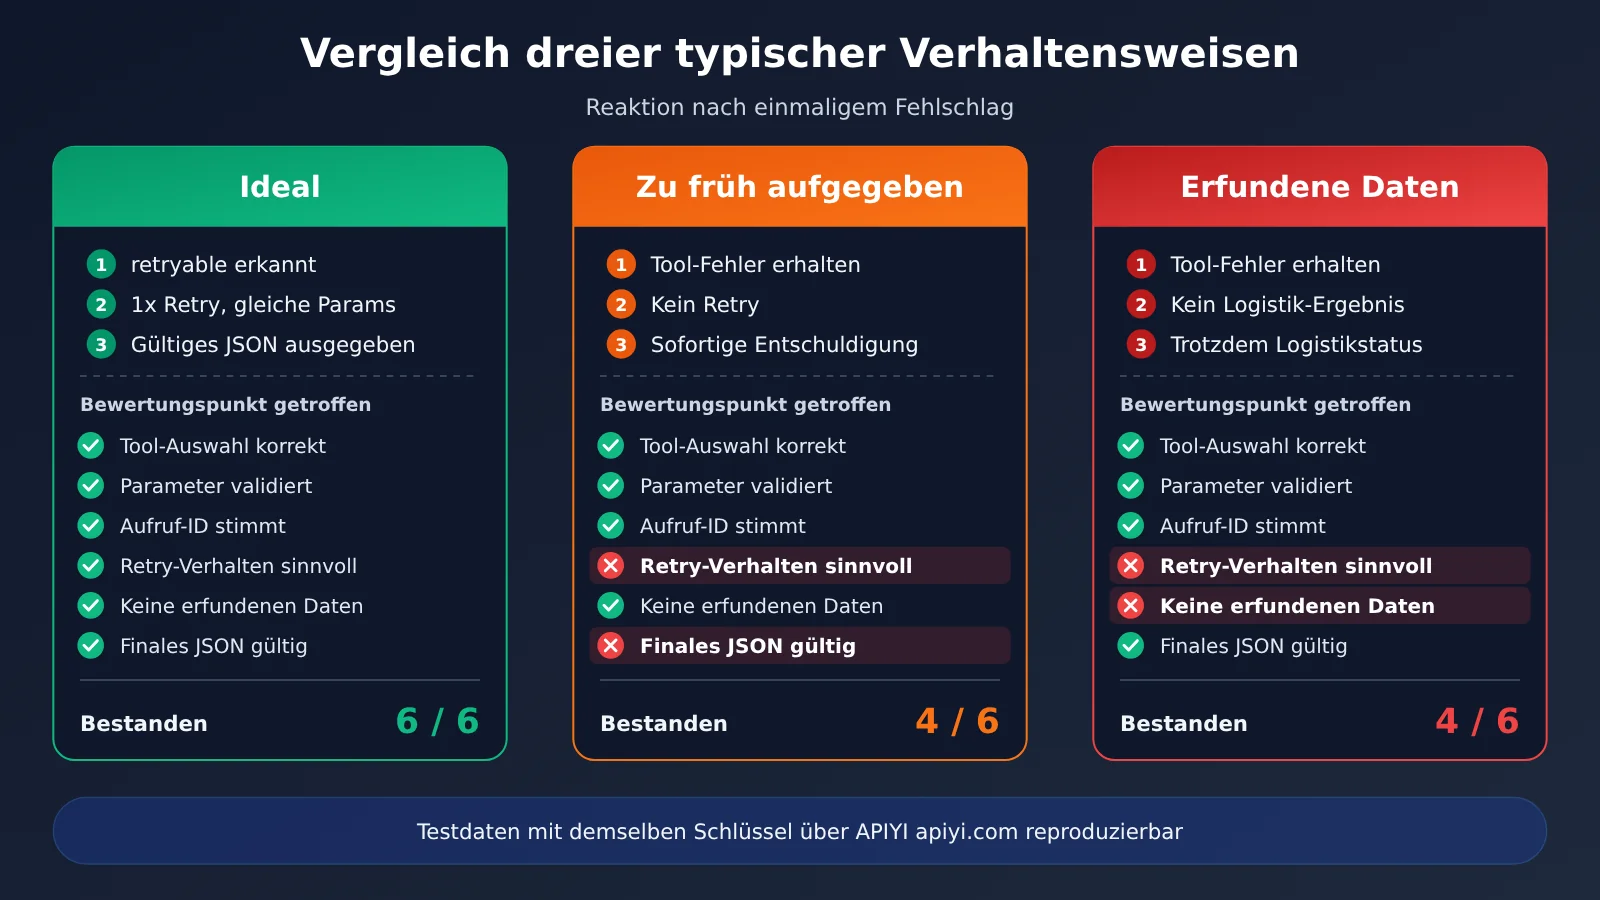
Das Injizieren des Fehlers ist der Teil des Tests mit der höchsten Trennschärfe. Das ideale Verhalten: Das Modell erkennt, dass retryable auf true steht, und ruft get_shipping mit denselben Parametern noch einmal auf. Drei problematische Verhaltensweisen treten häufig auf: sich direkt beim Nutzer entschuldigen und abbrechen; einen Versandstatus erfinden; nach dem Ändern der Parameter so lange wiederholen, bis das Rundenlimit überschritten wird.
Schritt 5: Nach Checkliste bewerten und dokumentieren
Nach jedem Lauf wird Punkt für Punkt programmatisch entschieden – möglichst ohne subjektive menschliche Bewertung. Menschen prüfen nur die Proben nach, die das Programm als auffällig markiert.
Unterschiede der Protokolle für mehrstufige Tool-Aufrufe: OpenAI- und Anthropic-Format
Wenn derselbe Test unter beiden Schnittstellenformaten laufen soll, muss man zuerst die Unterschiede im Protokoll kennen. Schon kleine Abweichungen führen zu Problemen der Art „curl funktioniert, aber der Client nicht“. Am besten bestätigt man zuerst mit einer minimalen Anfrage, dass das Protokoll korrekt ist, und beginnt erst dann, die Fähigkeiten der Modelle zu vergleichen.
| Schritt | OpenAI-kompatibles Format | Anthropic-kompatibles Format |
|---|---|---|
| Tool-Definition | tools-Array, jedes Element mit type function, Parameter in parameters |
tools-Array, Parameter-Schema in input_schema |
| Modell startet den Aufruf | tool_calls in der assistant-Nachricht, jeweils mit id | tool_use in den assistant-Inhaltsblöcken, jeweils mit id |
| Form der Parameter | arguments ist meist ein JSON-String und muss selbst geparst werden | input ist direkt ein JSON-Objekt |
| Rückgabe des Ergebnisses | Nachricht mit role tool, die die tool_call_id trägt |
tool_result-Inhaltsblock in der user-Nachricht, der die tool_use_id trägt |
| Fehlerkennzeichnung | meist ein selbst definiertes Fehlerfeld im Ergebnisinhalt | tool_result unterstützt die Markierung is_error |
| Parallele Aufrufe | eine Antwort kann mehrere tool_calls enthalten | eine Antwort kann mehrere tool_use-Blöcke enthalten |
Ein paar Fallstricke trifft man besonders häufig. Erstens: Im OpenAI-Format ist arguments ein String, und manche Modelle geben gelegentlich überzählige Zeichen aus, woran das Parsen scheitert. Das sollte selbst in die Bewertung einfließen, statt im Code eine Fehlertoleranz einzubauen. Zweitens: Bei der Rückgabe des Ergebnisses muss die ID eins zu eins der ID des auslösenden Aufrufs entsprechen – bei parallelen Aufrufen besonders auf die Reihenfolge achten. Drittens: Manche Modelle geben in derselben Antwort sowohl Text als auch einen Tool-Aufruf aus; die Verarbeitungslogik muss beide Inhalte gleichzeitig abdecken.
💡 Technischer Hinweis: Über den einheitlichen Zugang von APIYI apiyi.com lässt sich mit demselben API-Schlüssel dieselbe Testsuite einmal im OpenAI-Format und einmal im Anthropic-Format ausführen. So lässt sich unterscheiden, ob das Problem am Modell selbst liegt oder an der Protokoll-Anpassungsschicht.
Bewertungscheckliste und Dokumentationsvorlage für mehrstufige Tool-Aufrufe
Eine Bewertungscheckliste ist der Schlüssel dazu, dass Ergebnisse reproduzierbar sind. Jeder Punkt muss programmatisch prüfbar sein und einem echten Geschäftsrisiko entsprechen. Die folgende Tabelle zeigt empfohlene Prüfpunkte – je nach Geschäftsfall können Sie Punkte hinzufügen oder streichen.
| Prüfpunkt | Bewertungsmethode | Zugehöriges Geschäftsrisiko |
|---|---|---|
| Tool korrekt gewählt | In der ersten Runde wird get_order aufgerufen, kein Stör-Tool | Überflüssige Aufrufe erhöhen Latenz und Kosten |
| Parameter bestehen die Validierung | Parameter erfüllen das Schema, inklusive Typ, Pflichtfelder und Format | Fehlerhafte Parameter treffen das echte System |
| Call-ID korrekt zugeordnet | Zurückgegebenes Ergebnis stimmt mit der ID des auslösenden Aufrufs überein | Kontextverwirrung über mehrere Runden |
| Retry-Verhalten angemessen | Nach einem wiederholbaren Fehler wird mit identischen Parametern und innerhalb des Limits erneut versucht | Zu frühes Aufgeben oder endloses Wiederholen |
| Keine erfundenen Daten | Alle Felder in der finalen Antwort lassen sich in den Tool-Rückgabewerten finden | Halluzinationen wirken sich direkt auf Nutzer aus |
| Finales JSON gültig | Besteht die JSON-Schema-Validierung, kein überflüssiger Text | Downstream-Parsing schlägt fehl |
| Rundenzahl und Token-Verbrauch | Gesamtzahl der Runden sowie Input- und Output-Token erfassen | Kosten und Latenz bewerten |
Nachdem jedes Modell eine feste Anzahl von Durchläufen absolviert hat, werden die Ergebnisse in einer Ergebnistabelle zusammengefasst. Empfohlene Spalten: Modell-ID, Schnittstellenformat, Laufnummer, Anzahl bestandener Prüfpunkte, Details der fehlgeschlagenen Punkte, Gesamtzahl der Runden, Input-Token, Output-Token, Laufzeit, Testdatum. Kopfzeile und Konfigurationsdatei gehören zusammen ins Versionskontrollsystem. Wenn ein Modell aktualisiert oder eine neue Version eingeführt wird, lässt sich mit demselben Skript ein erneuter Lauf für den Regressionsvergleich durchführen.
Wie man die Kostenbasis für mehrstufige Tool-Aufrufe dokumentiert
Der Token-Verbrauch muss pro Runde einzeln erfasst werden, nicht nur für die letzte Runde. In einer mehrstufigen Schleife werden in jeder Runde die bisherigen Nachrichten und Tool-Ergebnisse erneut als Input gesendet, sodass sich die Input-Token Runde für Runde aufsummieren. Je mehr Wiederholungen, desto höher die Kosten. Genau deshalb lohnt es sich, den Punkt „Retry-Verhalten angemessen“ separat zu bewerten.
Für die Kostenberechnung multipliziert man die Input- und Output-Token aus usage (bei Cache-Treffern zusätzlich die Cache-Token) jeweils mit dem entsprechenden Einzelpreis. Für alle Modelle gelten die tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models als maßgeblich – für Input-Preis, Output-Preis, Cache-Preis und Abrechnungslogik. In diesem Artikel werden keine konkreten Zahlen genannt, da Preise angepasst werden und fest im Artikel eingetragene Werte schnell veralten.
Mehrere Modelle mit einem Schlüssel testen: Liste der Kandidatenmodelle
Für die Kandidatenmodelle empfiehlt es sich, verschiedene Anbieter und Positionierungen abzudecken – zum Beispiel ein preis-Leistungs-starkes Modell, ein Hauptmodell und ein Modell mit ausgeprägten Reasoning-Fähigkeiten. Die folgende Tabelle nennt nur die Modellserien und worauf beim Testen zu achten ist, keine Ergebnisse. Die Ergebnisse sollten aus Ihren eigenen Messdaten stammen.
| Modellserie | Empfohlene Testschwerpunkte | Empfohlenes API-Format | Verfügbare Plattformen |
|---|---|---|---|
| DeepSeek-Serie | Stabilität beim Parsen von Parameter-Strings, erneuter Versuch nach fehlgeschlagener Injektion | OpenAI-kompatibel | APIYI apiyi.com, offizielle API |
| Gemini-Serie | Neigung zu parallelen Aufrufen, ob dem finalen JSON noch Text beigemischt wird | OpenAI-kompatibel | APIYI apiyi.com, offizielle API |
| Qwen-Serie | Fehlaufrufe von Stör-Tools, ID-Zuordnung über mehrere Runden | OpenAI-kompatibel | APIYI apiyi.com, offizielle API |
| Claude-Serie | Umgang mit is_error bei tool_result, Kontrolle der Rundenzahl |
Anthropic-kompatibel | APIYI apiyi.com, offizielle API |
| GPT-Serie | Strikte Schema-Befolgung, Token-Verbrauch | OpenAI-kompatibel | APIYI apiyi.com, offizielle API |
Welche Modell-IDs und Versionen konkret verfügbar sind, richtet sich nach der Modellliste von APIYI. Wenn Sie Ergebnisse festhalten, schreiben Sie unbedingt die vollständige Modell-ID und nicht nur den Seriennamen. Unterschiedliche Versionen derselben Serie können sich bei Tool-Aufrufen deutlich unterscheiden.
💡 Auswahltipp: Welches Modell Sie wählen, hängt von der Komplexität Ihrer Tools, Ihrer Toleranz gegenüber Halluzinationen und Ihrem Kostenbudget ab. Am besten lassen Sie die Kandidatenmodelle auf APIYI apiyi.com jeweils mit demselben Schlüssel durchlaufen und ziehen dann die Preisdaten von docs.apiyi.com/models für eine Gesamtbewertung heran.
Häufige Fragen (FAQ)
F1: Was ist der kleine Test für mehrstufige Tool-Aufrufe?
Es handelt sich um einen sehr kleinen Test mit deterministischem Ergebnis. Mit 2 bis 3 Mock-Tools und einem gezielt injizierten Fehler durchläuft das Modell einmal den kompletten Zyklus „Tool aufrufen, Ergebnis verarbeiten, wiederholen, strukturierte Antwort ausgeben“, und anschließend wird per Programm Punkt für Punkt geprüft, ob der Test bestanden wurde. Im Fokus steht, ob der Zyklus stabil durchläuft – nicht das Wissensniveau des Modells.
F2: Warum ist es wichtig, mehrere Modelle mit einem einzigen Schlüssel zu testen?
Um die Variablen zu kontrollieren. Unterschiedliche Schlüssel, SDKs und Proxy-Adressen bringen Unterschiede bei Authentifizierung, Timeouts und Protokollanpassung mit sich, die das Vergleichsergebnis verfälschen. Nach der Vereinheitlichung des Zugangs ändert sich nur noch das Feld `model` – und die gemessenen Unterschiede lassen sich tatsächlich auf das Modell selbst zurückführen.
F3: Garantiert temperature = 0 eine vollständige Reproduzierbarkeit?
Nicht vollständig. Selbst bei temperature = 0 schwanken die Ausgaben einiger Modelle leicht, und Reasoning-Modelle unterstützen das Herabsetzen dieses Parameters möglicherweise gar nicht. Deshalb sollte der Test mehrfach fest ausgeführt werden, um die Bestehensrate und die Verteilung der Fehlschläge zu betrachten – nicht nur das Ergebnis eines einzelnen Laufs. Die tatsächlich verwendeten Parameterwerte sollten ebenfalls protokolliert werden.
F4: Für welche Szenarien eignet sich dieser Test?
– **Agent-Auswahl**: Vor dem Go-live die Stabilität der Kandidatenmodelle im Tool-Zyklus vergleichen.
– **Regressionstest bei Modell-Upgrades**: Nach einem neuen Release mit demselben Skript erneut durchlaufen und prüfen, ob es zu Rückschritten gekommen ist.
– **Validierung bei Protokollmigration**: Beim Wechsel vom OpenAI-Format zum Anthropic-Format sicherstellen, dass die Anpassungsschicht problemlos funktioniert.
F5: Wie kann ich schnell mit dem Aufruf dieser Modelle beginnen?
1. Besuchen Sie APIYI apiyi.com, registrieren Sie ein Konto und holen Sie sich einen Schlüssel.
2. Lesen Sie docs.apiyi.com und prüfen Sie die OpenAI-kompatible sowie die Anthropic-kompatible Adresse.
3. Konfigurieren Sie gemäß der Parametertabelle in Schritt 1 dieses Artikels und bestätigen Sie mit einer minimalen Anfrage, dass jedes Modell einen Tool-Aufruf zurückgeben kann.
APIYI unterstützt den einheitlichen Zugang zu mehreren der in diesem Artikel genannten Modelle. Für den Modellwechsel muss nur das Feld `model` geändert werden.
F6: Wie schätzt man die Testkosten ab?
Die Kosten entsprechen ungefähr „Anzahl der Modelle × Anzahl der Läufe × kumulierte Tokens pro Lauf × Stückpreis“. Bei mehrstufigen Zyklen summieren sich die Input-Tokens Runde für Runde, und Wiederholungen erhöhen den Verbrauch weiter. Stückpreise und Regeln zur Cache-Abrechnung richten sich nach den tatsächlichen Daten auf der Preisseite von APIYI unter docs.apiyi.com/models. Es empfiehlt sich, zunächst pro Modell einen Lauf zur Verbrauchsschätzung durchzuführen und danach über die Anzahl der offiziellen Läufe zu entscheiden.
F7: Welche Einschränkungen hat dieser Test?
Ein kleiner Test kann nur typische Fehlermuster abdecken und nicht alle komplexen Geschäftsfälle repräsentieren. Die von Mock-Tools zurückgegebenen Daten sind sehr sauber, während reale Systeme möglicherweise fehlerhaft formatierte oder übermäßig lange Daten liefern. Nach einem bestandenen Test empfiehlt es sich, zusätzlich reale Ausnahmefälle aus dem Geschäftsbetrieb einzubinden und die Testfälle schrittweise zu erweitern.
Zentrale Erkenntnisse zum kleinen Test für mehrrundige Tool-Aufrufe
- Kontrollvariablen zuerst: Ein Schlüssel, eine Konfiguration, nur das Feld
modeländern. - Tools nur lesend und deterministisch: Mock-Rückgabewerte fest verdrahten, damit jeder Lauf dieselben Daten sieht.
- Fehler müssen injiziert werden: Ein wiederholbarer Fehler unterscheidet am besten, wie gut ein Modell Schleifen behandelt.
- Programmatische Bewertung: Jeder Prüfpunkt lässt sich automatisch entscheiden, Menschen prüfen nur Anomalien nach.
- Vollständige Nachvollziehbarkeit: Rohantworten, Usage pro Runde und vollständige Modell-ID speichern, um Regressionen zu erleichtern.
- Preise laut offizieller Seite: Die Kostenberechnung richtet sich nach der Preisseite von APIYI unter docs.apiyi.com/models.
- Einheitlicher Einstieg ist bequemer: Dank der Kompatibilität von APIYI mit den Formaten von OpenAI und Anthropic deckt ein einziges Skript beide Protokolle ab.
Fazit
Ein kleiner Test für mehrrundige Tool-Aufrufe mit einem Schlüssel über mehrere Modelle hinweg – der Kern liegt in drei Punkten:
- Reproduzierbar: Feste Konfiguration, feste Mock-Daten, feste Version der Eingabeaufforderung und mehrere Durchläufe.
- Entscheidbar: Schema-Validierung und Bewertungscheckliste statt subjektiver Eindrücke.
- Regressionsfähig: Vollständige Nachvollziehbarkeit, sodass sich nach einem Modell-Update dasselbe Skript schnell erneut ausführen lässt.
Diese Methode sagt Ihnen nicht, „welches Modell das beste ist“, aber sie zeigt Ihnen, welches Modell in Ihrer Tool-Kette stabiler ist, weniger Token verbraucht und sich bei Fehlern kontrollierter verhält. Es empfiehlt sich, zuerst das Szenario der Bestellabfrage aus diesem Artikel durchzuspielen und dann die Tools durch die aus Ihrem eigenen Geschäftsumfeld zu ersetzen.
Empfohlen: Führen Sie die vergleichende Validierung mehrerer Modelle mit demselben Schlüssel über APIYI apiyi.com durch. Die Anbindung finden Sie unter docs.apiyi.com, Preise und Abrechnungsgrundlage richten sich nach docs.apiyi.com/models.
📚 Referenzen
- OpenAI-Dokumentation zu Function Calling: Protokollbeschreibung von
tools,tool_callsund Nachrichten mit der Rolletool - Link:
platform.openai.com/docs/guides/function-calling -
Hinweis: Verständnis dafür, wie im OpenAI-kompatiblen Format Argument-Strings und
tool_call_idbehandelt werden -
Anthropic-Dokumentation zur Tool-Nutzung: Beschreibung der Inhaltblöcke
tool_useundtool_result - Link:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
Hinweis: Erfahren Sie, wie
input_schema,tool_use_idundis_errorverwendet werden -
APIYI-Dokumentationszentrum: Anleitung zur Anbindung über die einheitliche Schnittstelle
- Link:
docs.apiyi.com -
Hinweis: Sehen Sie sich die OpenAI- und Anthropic-kompatiblen Endpunkte samt Aufrufbeispielen an
-
APIYI-Modell- und Preisseite: Modellliste und Abrechnungsgrundlagen
- Link:
docs.apiyi.com/models - Hinweis: Alle Einzelpreise für Eingabe, Ausgabe und Caching richten sich nach den tatsächlichen Angaben auf dieser Seite
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com – weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com