Le 19 novembre 2026, Google a introduit Tool Retrieval (récupération d’outils) dans la Gemini Interactions API, en Preview. Un agent peut d’abord ne voir que le nom et une brève description des outils, puis charger le schéma complet des paramètres dans le contexte au moment où il doit réellement les appeler. L’objectif principal est de résoudre le problème des « outils de plus en plus nombreux, avec un contexte saturé par les définitions d’outils inutilisés ». Cette approche convient surtout aux agents qui disposent d’un grand nombre d’outils, dont les appels se concentrent sur quelques outils fréquents tout en comportant une longue traîne d’outils rarement utilisés. Elle n’est pas une option à activer par défaut pour toutes les applications en pensant économiser automatiquement.
Qu’apprendrez-vous en lisant cet article ?
- Ce que Tool Retrieval change réellement, et pourquoi « le développeur doit toujours soumettre la déclaration complète des outils » et « le modèle n’a pas besoin de lire le schéma complet à l’avance » peuvent être vrais en même temps
- La chaîne d’exécution complète, de l’enregistrement des outils jusqu’à
function_call, ainsi que la répartition entre recherche côté serveur et recherche côté client - Les 4 ID de modèle explicitement pris en charge aujourd’hui, le tarif standard, et ce que signifie « pas de frais de fonctionnalité séparés, mais les tokens sont facturés comme d’habitude »
- Les deux exemples de calcul indicatifs officiels, dans des directions opposées : quand on économise, et quand cela revient plus cher
- Les limites à connaître avant l’intégration, et comment déterminer si votre agent a intérêt à adopter cette approche
Sommaire : la suite commence par un tableau conceptuel et un aperçu des impacts pour vous aider à aligner rapidement le contexte. La partie « Faits objectifs » présente successivement les informations de lancement, le mécanisme de fonctionnement, le chargement hybride et le MCP distant, les modèles pris en charge et les coûts, puis les limites d’utilisation, en se fondant exclusivement sur les annonces officielles et la documentation développeur de Google. La partie « Analyse et évaluation » donne des critères pour déterminer les cas d’usage, une méthode de mesure de référence avant migration et quelques questions fréquentes ; les éléments à caractère subjectif ou prédictif y sont signalés séparément.
Récupération d’outils avec l’API Gemini : les concepts à connaître d’abord
| Concept | Brève explication |
|---|---|
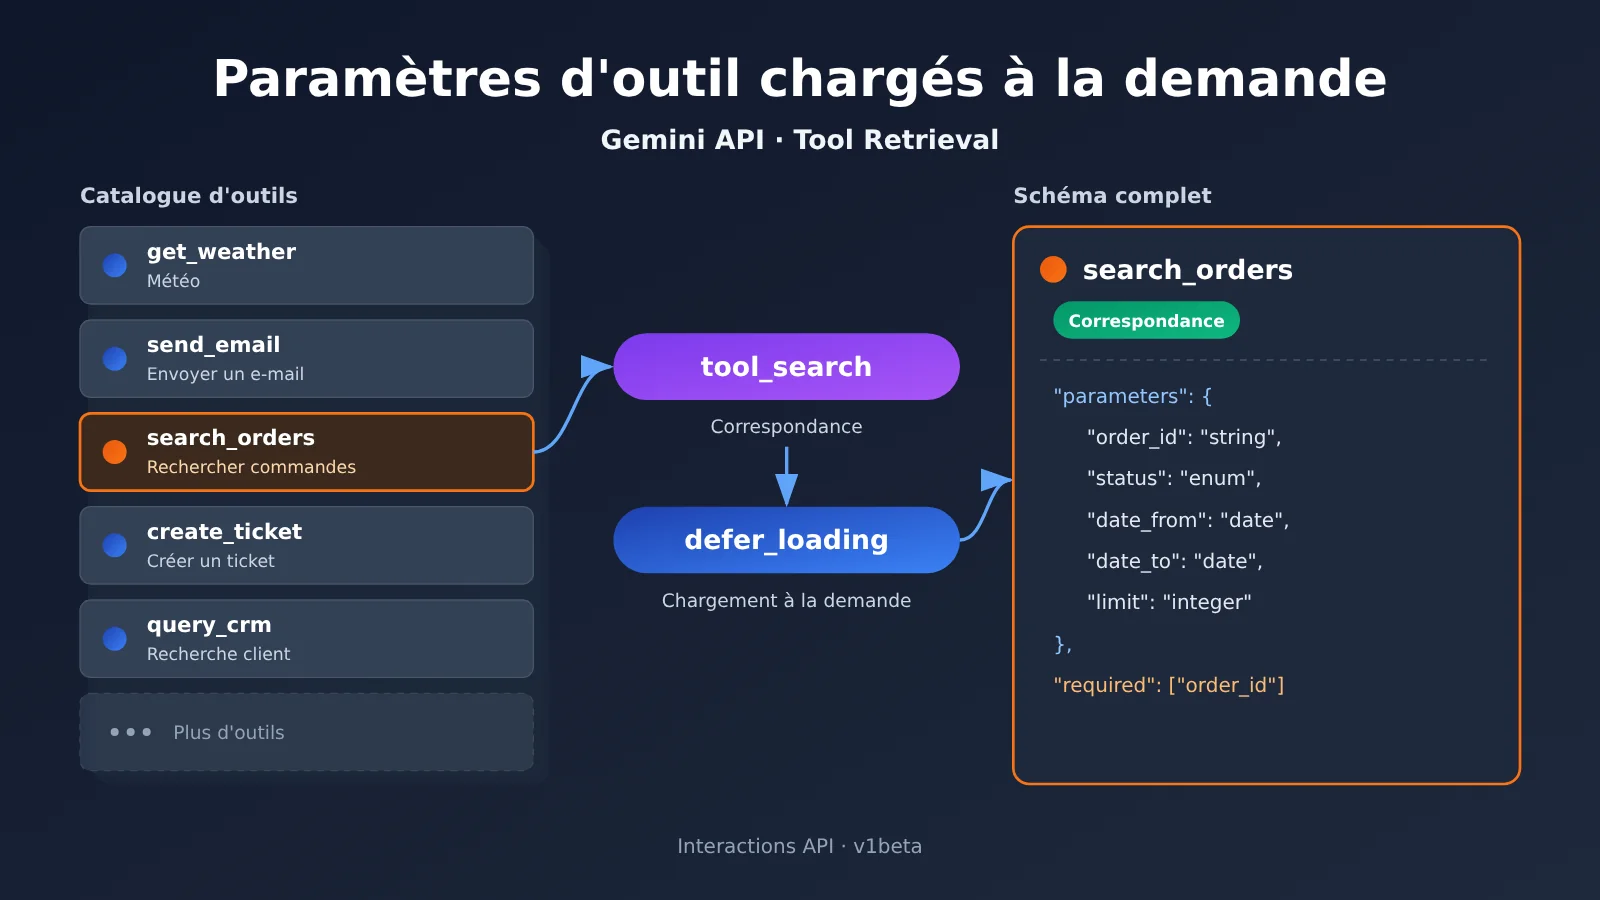
| Tool Retrieval | On commence par récupérer les outils nécessaires, puis on ajoute au contexte du modèle la définition complète des paramètres des outils trouvés |
| Interactions API | Interface de Gemini destinée aux agents, qui gère l’historique des interactions, les étapes d’exécution des outils et la sortie du modèle ; officiellement disponible depuis juin 2026 |
| Schéma des paramètres | Structure décrivant quels paramètres une fonction accepte, leurs types et lesquels sont obligatoires, généralement exprimée en JSON Schema |
| Function Calling | Le modèle génère le nom de la fonction et ses paramètres, l’application exécute la fonction, puis renvoie le résultat au modèle |
tool_search |
Type d’outil qui déclare le mécanisme de récupération d’outils ; le modèle s’en sert pour trouver et charger les définitions d’outils |
defer_loading |
Configuration en mode côté serveur qui reporte le chargement de la définition complète des paramètres d’un outil jusqu’à ce que la récupération le trouve |
short_description |
Brève description d’un outil différé, destinée au modèle pour l’identifier dans le catalogue initial |
| MCP distant | Outils fournis par des services tiers, externes à l’application, connectés via le Model Context Protocol |
| Cache implicite | La plateforme réutilise automatiquement les mêmes préfixes de contexte ; la partie qui touche le cache est facturée au tarif des entrées mises en cache |
Récupération d’outils avec l’API Gemini : aperçu des impacts
- Développeurs qui connectent un agent à un grand nombre d’outils métier : plus besoin de construire votre propre récupérateur d’outils ; le modèle peut lire à la demande les schémas de dizaines, voire de centaines d’outils. Il faut toutefois envoyer le tableau complet des outils à chaque requête et réévaluer le cache et la facturation. Avant de migrer, je vous conseille de mesurer l’occupation réelle des définitions d’outils avec votre flux Function Calling actuel ; vous pouvez obtenir rapidement une base de comparaison via une interface multi-modèles unifiée comme APIYI apiyi.com.
- Responsables produit et coûts : pas de frais de fonctionnalité séparés, mais chaque recherche côté serveur déclenche une inférence de modèle supplémentaire. Les économies dépendent de la taille du catalogue d’outils, de la longueur du contexte et de la fréquence des recherches ; il faut le vérifier dans les champs de facturation, pas seulement dans les arguments marketing.
- Applications avec peu d’outils et des appels stables : les exemples officiels montrent que, avec un petit ensemble d’outils et un contexte long, le nombre total de tokens augmente au contraire ; continuer à charger directement reste donc le choix le plus sûr.
- Équipes qui utilisent un framework d’agent : il s’agit d’une nouvelle capacité au niveau de l’API du modèle, et les frameworks ne l’adapteront pas forcément immédiatement. Sur le chargement progressif au niveau du framework, il ne faut pas considérer que le problème est déjà réglé.
Faits objectifs : ce qu’annonce réellement Gemini API Tool Retrieval
Informations de publication et contexte de Gemini API Tool Retrieval
Le blog officiel de Google a publié le 19 novembre 2026 l’article « Introducing Tool Retrieval in the Gemini API », signé par Lucia Loher, chef de produit Gemini API, et Nora Kassner, chercheuse chez Google DeepMind. La fonctionnalité est actuellement en phase Preview et ne peut être utilisée que dans l’API Interactions, avec la version v1beta. L’ancienne méthode generateContent n’est pas prise en charge.
Côté ingénierie, la préparation a précédé l’annonce. Le 18 novembre, le SDK Python officiel de Google est passé en v3.6.0, et les notes de version précisent l’ajout de schémas publics liés à Tool Retrieval et aux résultats de fonction. Le même jour, le SDK Go v1.79.0 intégrait lui aussi les mises à jour correspondantes. À regarder la chronologie, il s’agit ici de compléter l’API Interactions déjà en GA avec la découverte d’outils et le chargement à la demande, et non de lancer un nouveau produit API.
La demande des développeurs est également documentée. Le 18 mars 2026, un développeur a ouvert l’Issue #2185 dans le dépôt du SDK Python pour demander la prise en charge de defer_loading et tool_search, au motif qu’au-delà d’une trentaine d’outils branchés sur un Agent, le schéma complet alourdit le contexte. Un mainteneur de Google a répondu le 20 mars en l’enregistrant comme demande de fonctionnalité. Ce sont des retours d’usage, pas des tests de performance.
En une phrase, Tool Retrieval, c’est : un outil peut d’abord être découvert, et ses paramètres précis ne sont lus qu’au moment où il faut l’appeler.
Comment Tool Retrieval change la façon dont les schémas d’outils sont chargés
Dans le chargement statique classique, même si l’utilisateur ne veut faire qu’un seul remboursement, les déclarations de paramètres de dizaines d’outils — commandes, logistique, stocks, CRM, etc. — entrent dans le contexte à chaque inférence. La documentation de Google indique que quelques dizaines de déclarations de fonctions peuvent occuper des dizaines de milliers de tokens. Cela grignote la place disponible pour l’historique de conversation et, quand les outils similaires se multiplient, peut brouiller le choix du bon outil par le modèle.
Le point clé de Tool Retrieval, c’est qu’il distingue trois niveaux :
- Niveau requête API : le développeur soumet comme d’habitude la définition complète de l’outil, y compris le schéma des paramètres.
- Contexte initial du modèle : les outils marqués
defer_loading: truen’apparaissent que sous la forme d’un nom accompagné d’uneshort_description. Si aucune description courte n’est configurée, on prend la première phrase de ladescriptioncomplète. - Phase d’appel d’outil : une fois qu’un outil est retrouvé par la recherche, son schéma complet entre dans le contexte, et le modèle génère à partir de là un appel paramétré.
Donc quand le titre dit « on ne charge plus tous les paramètres d’outils à chaque fois », il faut comprendre : le modèle ne précharge plus l’intégralité des paramètres à chaque tour, et non pas que le développeur n’a plus besoin d’envoyer les déclarations complètes. En mode serveur, la documentation officielle exige de resoumettre le tableau tools complet à chaque requête, y compris lorsqu’on utilise previous_interaction_id.
La chaîne d’exécution de Tool Retrieval : l’exemple officiel du remboursement
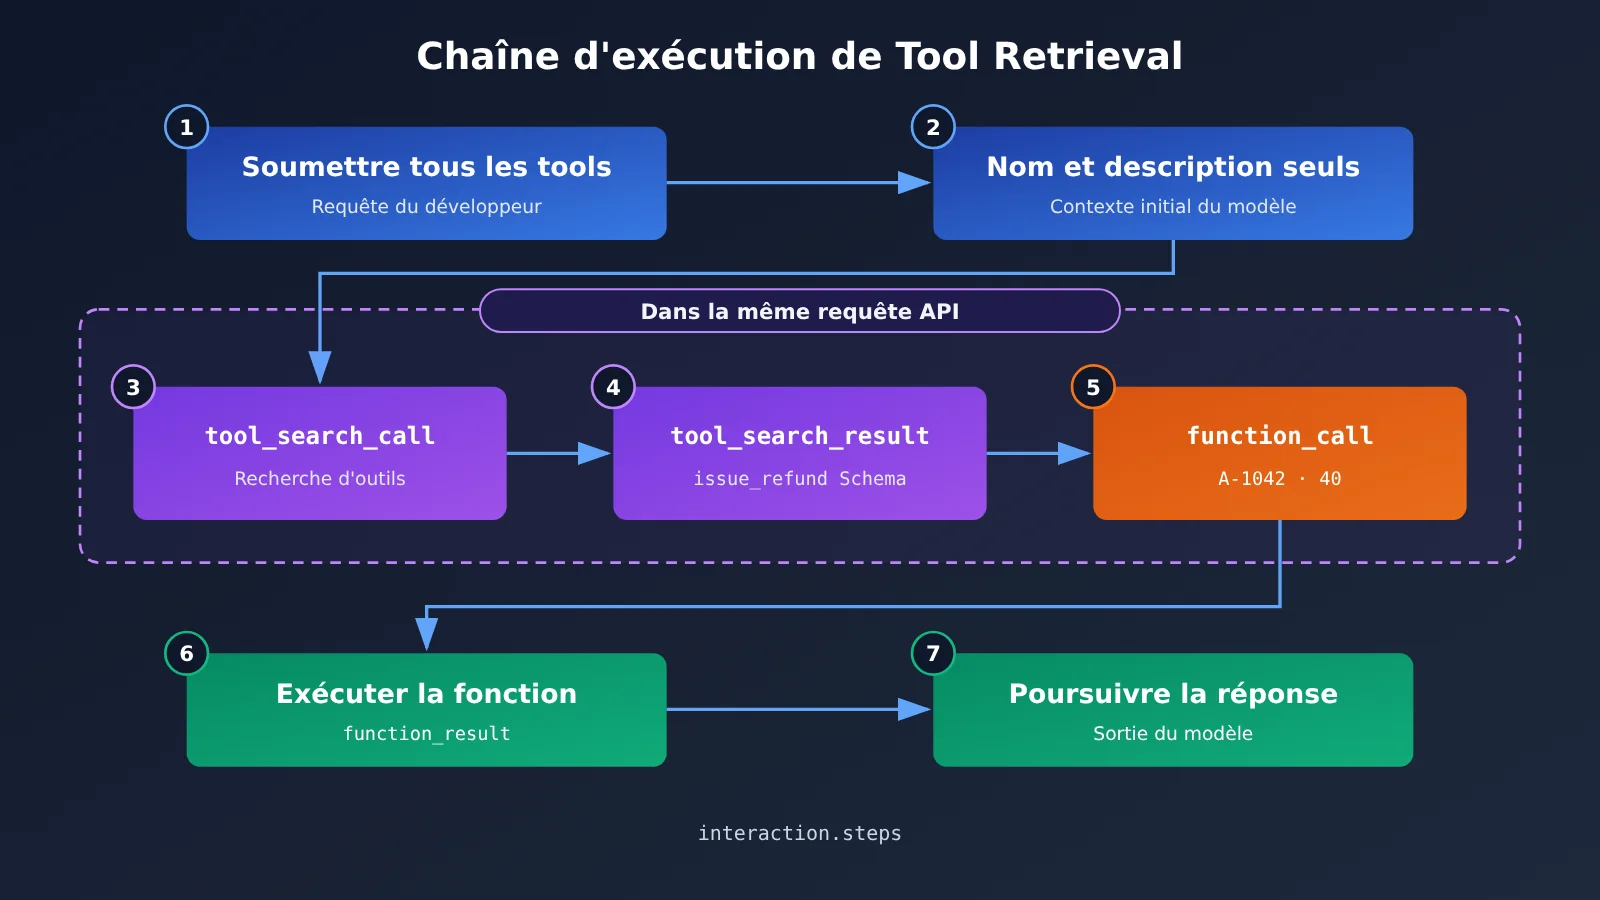
L’annonce de Google s’appuie sur un scénario de remboursement de commande : l’article de la commande A-1042 est arrivé endommagé, le client demande un remboursement de 40 dollars, et l’outil à utiliser est issue_refund. Voici le déroulement complet de la recherche côté serveur :
- La requête déclare
{"type": "tool_search"}et activedefer_loading: truepour les outils peu fréquents commeissue_refund. - Le modèle déduit de la tâche qu’il a besoin de la capacité de remboursement et lance un
tool_search_call. - L’API renvoie un
tool_search_result, qui contient le schéma complet des paramètres deissue_refund. - Le modèle lit la définition des paramètres et génère un
function_call, avec pour paramètresorder_id: "A-1042"etamount: 40. - L’application exécute la fonction et renvoie un
function_result, sur lequel le modèle s’appuie pour poursuivre la tâche.
La recherche, le chargement et la génération de l’appel de fonction peuvent se faire au sein d’une même requête API externe, et toutes les étapes sont consultables dans interaction.steps. Attention toutefois : une même requête ne signifie pas qu’il n’y a qu’une seule inférence interne ; chaque recherche côté serveur déclenche des appels au modèle supplémentaires, qui sont facturés. Par ailleurs, il s’agit d’un cas de démonstration, qui ne représente aucune statistique de taux de réussite des remboursements.
Voici un exemple de code inspiré de la documentation officielle, connecté directement au point de terminaison Google, uniquement destiné à illustrer la structure de la requête :
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
La répartition des responsabilités propre à Function Calling n’a pas changé. Pour les fonctions personnalisées, l’API renvoie uniquement un function_call ; exécuter le remboursement, accéder à la base de données ou gérer les permissions reste du ressort de l’application. Ce n’est que lors d’une connexion à un serveur MCP distant que l’API lance elle-même l’appel à distance et renvoie mcp_server_tool_call et mcp_server_tool_result.
Chargement hybride dans Tool Retrieval, MCP distant et deux modes de recherche
Google recommande une approche hybride : charger directement les outils fréquemment utilisés, et charger à la demande les outils spécialisés de longue traîne, moins souvent sollicités. Ainsi, les tâches simples n’ont pas besoin de passer par une recherche préalable, et les capacités de longue traîne n’occupent pas durablement la fenêtre de contexte. Un serveur MCP distant peut également être configuré entièrement en chargement différé : par exemple, en ajoutant defer_loading: true à une configuration type: "mcp_server", les outils exposés par ce serveur sont chargés à la demande, sans avoir à les déclarer un par un.
Outre le mode côté serveur où Gemini effectue la recherche, l’offre officielle propose aussi un mode côté client : le développeur déclare un tool_search avec execution: "client", son application interroge le registre d’outils, puis renvoie au modèle les déclarations complètes des outils correspondants dans function_result.result. Voici les différences entre les deux :
| Critère de comparaison | Recherche côté serveur | Recherche côté client |
|---|---|---|
| Emplacement d’exécution | Côté serveur de l’API Gemini (server par défaut) |
Application du développeur (client) |
| Faut-il construire son propre moteur de recherche ? | Non | Oui |
| Faut-il déclarer la bibliothèque d’outils à l’avance ? | Oui | Non ; de nouveaux outils peuvent être introduits en cours de session |
defer_loading |
Applicable | Non applicable |
| Aller-retour réseau supplémentaire | Aucun aller-retour client supplémentaire | Un aller-retour de plus à chaque recherche |
| Contrôle des permissions | Déterminé par l’ensemble d’outils déclaré dans la requête | Peut être combiné à un filtrage personnalisé des permissions par utilisateur |
| Cas d’usage typiques | Grand ensemble d’outils relativement stable | Bibliothèque d’outils dynamique, multi-tenant, registre privé d’entreprise |
En mode client, les déclarations de fonctions renvoyées doivent être des objets structurés, et non des chaînes JSON. Il n’est pas possible de mélanger les deux modes dans une même requête, et un seul tool_search peut être déclaré au maximum.
Quels modèles Gemini API Tool Retrieval prend-il en charge, et à quel prix ?
L’annonce de Google est assez vague : elle affirme que les modèles Gemini 3.6 et plus récents sont pris en charge, y compris tous les modèles Gemini 4. Mais dans la documentation développeur, à la date du 20 novembre, seuls 4 identifiants de modèles sont explicitement listés. En production, c’est la documentation développeur qui fait foi : définir defer_loading sur un modèle non pris en charge renvoie une erreur HTTP 400.
| ID du modèle | Prix d’entrée standard (USD / million de tokens) | Prix de sortie standard (Thinking inclus) | Remarques |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Marqué Free Tier |
gemini-4-argon |
$2.00 (à partir du 1er décembre : $4.00) | $10.00 (à partir du 1er décembre : $20.00) | Pas de Free Tier |
gemini-3.8-flash |
$0.75 (à partir du 1er janvier 2027 : $1.50) | $3.75 (à partir du 1er janvier 2027 : $7.50) | Marqué Free Tier |
gemini-3.6-flash |
$0.75 (à partir du 1er janvier 2027 : $1.50) | $3.75 (à partir du 1er janvier 2027 : $7.50) | Marqué Free Tier |
Les prix proviennent du niveau Standard de la page de tarification de Google Gemini Developer API. Les quotas et limites de débit réels du Free Tier doivent être vérifiés projet par projet.
Côté facturation, Google indique clairement que Tool Retrieval n’entraîne pas de frais de fonctionnalité distincts, mais cela ne signifie pas pour autant que la recherche est gratuite. La liste résumée des outils différés, l’instruction de recherche fixe ajoutée lorsqu’on active tool_search, le raisonnement supplémentaire à chaque recherche côté serveur, le schéma complet chargé ainsi que sa conservation lors des tours suivants : tout cela est facturé en tokens au tarif du modèle choisi. Pour suivre les coûts, il faut particulièrement surveiller le champ total_tool_use_tokens, qui enregistre l’entrée supplémentaire de modèle déclenchée par la recherche côté serveur. Se contenter de constater la baisse des tokens d’entrée initiaux conduit facilement à surestimer les économies réalisées.
Exemples officiels de calcul de Tokens pour Tool Retrieval
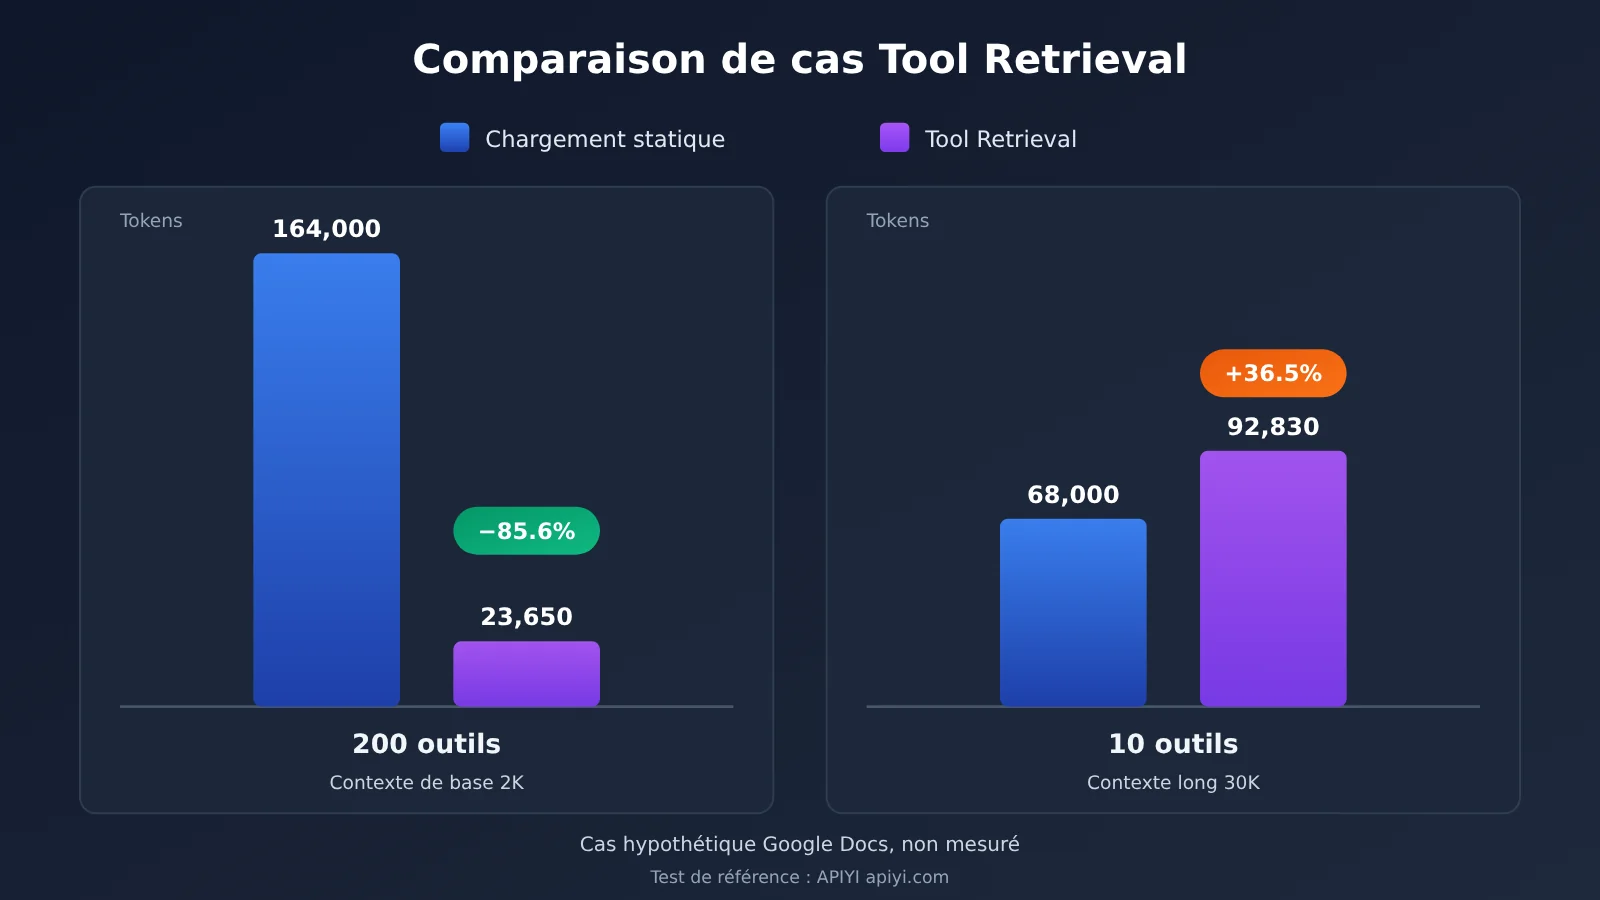
Les premiers tests officiels montrent que chaque outil chargé à la demande représente en moyenne environ 26 Tokens dans le catalogue initial. C’est une valeur approximative, pas un coût fixe. La documentation fournit également deux exemples de calcul hypothétiques, dont les conclusions vont dans des directions opposées :
| Scénario (hypothèse officielle) | Chargement statique de tous les outils | Tool Retrieval | Variation |
|---|---|---|---|
| 200 outils, 400 Tokens chacun, contexte de base de 2 000, 2 outils utilisés, 2 requêtes au total | 164 000 | environ 23 650 | environ -85,6 % (d’après le calcul de l’exemple) |
| 10 outils, 400 Tokens chacun, contexte de base de 30 000, 2 outils utilisés, 2 requêtes au total | 68 000 | 92 830 | environ +36,5 % (d’après le calcul de l’exemple) |
Le second exemple coûte plus cher parce que la recherche côté serveur nécessite une inférence supplémentaire et retraite un contexte déjà très long, tandis que 10 outils eux-mêmes n’occupent pas beaucoup de place : les Tokens de schéma économisés ne compensent pas le coût de la recherche. Ces deux jeux de chiffres sont des exemples hypothétiques explicitement indiqués par Google ; ils ne tiennent pas compte des Tokens de sortie ni des gains de cache, et ne constituent pas un benchmark en environnement de production. À la date de vérification des sources, Google n’a pas publié de taux d’économie de Tokens, d’amélioration de la latence ni de gain de précision dans la sélection des outils mesurés sur cette fonctionnalité.
Côté cache, Google indique que Tool Retrieval prend en charge le cache implicite : le schéma complet n’apparaît pas dans le préfixe initial, ce qui permet aux préfixes comme les instructions système et le catalogue d’outils de rester plus stables. Mais la documentation prévient aussi que le chargement différé raccourcit l’invite initiale : les requêtes qui dépendaient auparavant de nombreux schémas pour atteindre le seuil minimal de cache peuvent ainsi passer sous ce seuil.
Limitations actuelles de Tool Retrieval
Les points suivants proviennent de la documentation officielle ; ce sont ceux sur lesquels on trébuche le plus souvent en développement :
- Impossible de décharger un outil déjà chargé : une fois qu’un schéma a été récupéré, il reste présent pour toute la session en cours. Dans les sessions très longues où l’on ne cesse de récupérer de nouveaux outils, le contexte continue donc de grossir.
- Le tableau complet d’outils est renvoyé à chaque requête : y compris
tool_search, tous les outils différés et non différés, ainsi que la configuration MCP associée. On ne peut pas se contenter de transmettrenameetshort_descriptionen omettantparameters. - Les outils nommés explicitement dans les instructions système ne doivent pas être différés : le modèle pourrait contourner la recherche et les appeler directement, ce qui provoquerait une erreur faute de contexte chargé.
- En session sans état, il faut conserver intégralement les étapes de récupération : si vous gérez vous-même l’historique avec
store=false,tool_search_call,tool_search_resultet leursignaturene doivent ni être supprimés ni modifiés, sous peine de recevoir une erreur HTTP 400. - Pour déboguer, consultez les steps : même si
interaction.statusn’est pasrequires_action, le résultat peut contenir unfunction_callen attente d’exécution. - En cas d’absence de correspondance, du texte peut être renvoyé : lorsque la recherche côté serveur ne trouve aucun outil correspondant, il n’y a pas forcément d’erreur structurée en retour.
Analyse : ce que signifie Tool Retrieval de l’API Gemini pour le développement d’Agents
Dans quels cas utiliser Tool Retrieval
La valeur concrète de cette mise à jour consiste à séparer deux choses : « maintenir une liste complète d’outils » et « lire cette liste en entier à chaque tour de raisonnement ». La bibliothèque d’outils peut continuer à s’étendre, tandis que le contexte du modèle ne contient en permanence qu’un catalogue très léger. Pour les équipes qui intègrent sans cesse de nouveaux systèmes métier, cela allège la charge de pré-sélection des outils et réduit les situations où l’application filtre dynamiquement les outils à chaque tour pour maîtriser les tokens, ce qui casse le préfixe de cache.
Cela dit, les exemples officiels montrent déjà que le gain est conditionnel. En combinant avec les recommandations d’ingénierie officielles, le tableau ci-dessous permet une première évaluation (il s’agit de conseils de choix d’ingénierie, pas de seuils chiffrés rigides) :
| Type d’agent | Caractéristiques des outils | Recommandation |
|---|---|---|
| Assistants clientèle, assistants de processus métier | Quelques dizaines d’outils, dont une minorité de requêtes à haute fréquence ; remboursements, validations, contrats, etc. à basse fréquence | Charger directement les outils à haute fréquence ; utiliser la recherche côté serveur pour la longue traîne |
| Agents de développement/exploitation avec plusieurs serveurs MCP | Chaque serveur expose de nombreux outils, mais une tâche donnée n’en utilise qu’une petite partie | Définir defer_loading pour l’ensemble du serveur MCP |
| Plateformes multi-tenant exposant des outils selon les permissions | L’ensemble d’outils varie selon l’utilisateur et l’espace de travail | Recherche côté client, avec un registre interne et un filtrage par permissions |
| Petits assistants | Moins d’environ 20 outils stables, dont la plupart sont utilisés à chaque tour | Continuer à charger statiquement |
| Contexte long + recherches fréquentes | Conversations très longues, nécessitant souvent plusieurs recherches par tour | Tester avant de décider ; risque d’augmentation du coût net |
Notre avis : plus la distribution des appels d’outils est « longue traîne », plus Tool Retrieval mérite d’être utilisé. À l’inverse, si la plupart des outils sont utilisés à chaque tour, le chargement différé ne fait qu’ajouter une inférence de recherche.
Avant de migrer vers Tool Retrieval, mesurez l’empreinte réelle du schéma des outils
La décision de migrer ou non doit avant tout s’appuyer sur les données de votre propre activité. Avant la migration, vous pouvez mesurer l’écart de tokens d’entrée entre une requête avec « tous les outils » et une requête avec « uniquement les outils réellement utilisés », en utilisant le flux Function Calling compatible OpenAI existant. Vous obtenez ainsi l’empreinte réelle du schéma des outils. Le script ci-dessous réalise cette mesure de référence ; il ne s’agit pas de Tool Retrieval en soi :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI, pour mesurer la référence de chargement statique
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
Voir le script complet de mesure de référence (comparaison par lot selon le nombre d’outils)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mesurer le coût du schéma d'outils selon les modèles via l'interface unifiée APIYI
)

def load_tools(path: str) -> list:
    """Lit les définitions d'outils au format OpenAI depuis le registre d'outils métier (fichier JSON)"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 Conseil technique : avant d’évaluer Tool Retrieval, vous pouvez d’abord exécuter une mesure de référence du chargement statique sur plusieurs modèles courants avec une seule clé API via APIYI apiyi.com, pour voir combien de tokens le schéma des outils occupe réellement dans votre requête. Une fois la référence obtenue, activez
tool_searchdans Gemini Interactions API pour faire une comparaison, et comparez la somme detotal_input_tokenset detotal_tool_use_tokens.
Il faut le préciser : Tool Retrieval dépend de l’interface v1beta d’Interactions API et de champs dédiés. Les appels compatibles OpenAI ci-dessus servent uniquement à mesurer le coût du chargement statique. Pour les tests comparatifs, mieux vaut garder identiques le modèle, la bibliothèque d’outils, le jeu de tâches, la longueur de contexte et les conditions de cache, puis comparer le coût total facturé, le temps de bout en bout, le taux de sélection correcte des outils et le nombre moyen de recherches. C’est à ce prix que vous pourrez attribuer les écarts à la stratégie de récupération. Si vous voulez comparer les écarts de référence entre modèles dans un même script, l’interface unifiée APIYI apiyi.com vous évite de brancher chaque fournisseur séparément.
Développements à suivre (estimations prospectives)
Les points ci-dessous relèvent d’une appréciation, pas de faits confirmés.
Premièrement, l’annonce et la documentation pour développeurs ne s’accordent pas sur le périmètre des modèles pris en charge : la question de savoir si des modèles comme Gemini 4 Carbon, Gemini 4 Neon et d’autres figureront dans la liste des modèles compatibles mérite un suivi des mises à jour de la documentation. Deuxièmement, l’impossibilité de décharger un schéma déjà chargé est un point faible évident pour les agents en session longue ; le fait que la version finale propose ou non un mécanisme de déchargement ou d’éviction aura un impact direct sur leurs performances dans les tâches longues. Troisièmement, des utilisateurs de Google ADK ont signalé par le passé, dans l’Issue #7241, des problèmes de chargement progressif et d’invalidation du cache ; le fait que l’API du modèle prenne en charge une nouvelle capacité ne signifie pas que le framework l’adoptera automatiquement, et le rythme d’adaptation au niveau du framework mérite d’être suivi.
L’approche consistant à charger les définitions d’outils à la demande a déjà des précédents dans l’industrie ; cette fois, Google l’ajoute à l’interface agent de Gemini. Comme l’interface peut encore évoluer pendant la phase Preview, il est recommandé, lors de l’intégration en production, de conserver une option permettant de revenir au chargement statique.
Quelques questions fréquentes sur Gemini API Tool Retrieval
Q1 : Si j’active Tool Retrieval, le corps de la requête devient-il plus petit ?
Non. En mode côté serveur, chaque requête doit toujours envoyer le tableau d’outils complet ; ce qui diminue, c’est la place occupée par les outils dans le contexte initial du modèle. Si vous voulez d’abord mesurer le volume des définitions d’outils dans vos requêtes actuelles, vous pouvez utiliser le script ci-dessus pour établir une base de référence via APIYI apiyi.com.
Q2 : Google affirme-t-il officiellement que cela permet d’économiser 85 % ?
Il n’existe pas de conclusion de ce type fondée sur des mesures réelles. Les 85,6 % sont extrapolés à partir d’un exemple hypothétique avec 200 outils ; le même document donne aussi le contre-exemple d’une augmentation d’environ 36,5 % des tokens avec un ensemble restreint d’outils.
Q3 : Tool Retrieval est-il facturé ?
Il n’y a pas de frais de fonctionnalité séparés, mais les instructions de recherche, l’inférence supplémentaire et les schémas chargés sont facturés en tokens selon le tarif du modèle. Les équipes sensibles au budget peuvent d’abord tester à petite échelle, via APIYI apiyi.com et en facturation à l’usage, le coût du Function Calling de différents modèles, avant de choisir le modèle de leur agent.
Q4 : Avec Tool Retrieval, est-on dispensé d’exécuter les fonctions soi-même ?
Non. Les fonctions personnalisées sont toujours exécutées par l’application, qui renvoie ensuite le résultat ; Tool Retrieval se contente de trouver et de charger les définitions d’outils. Seuls les outils MCP distants sont appelés par l’API à votre place.
La bibliothèque d’outils va continuer de grossir, mais à chaque tour, seuls quelques-uns sont réellement nécessaires. Tool Retrieval sépare la préparation de l’ensemble des outils de leur disponibilité à la demande : bien utilisé, il peut alléger un agent de grande taille ; mal utilisé, il peut aussi entraîner le coût d’une inférence supplémentaire. Comme le dit le Livre XV des Entretiens de Confucius (Wei Ling Gong) : « Pour bien faire son ouvrage, il faut d’abord affûter ses outils. » Mesurez d’abord le poids de chaque « outil » dont vous disposez, puis décidez comment l’agencer.
📚 Références
-
Annonce officielle de Google : Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Description : informations de publication, objectifs de conception, deux modes de récupération d’outils et principes de tarification
- Lien :
-
Documentation développeur Google Tool Retrieval : configuration, limites, facturation et exemples de calcul
- Lien :
aistudio.google.com/docs/tool-retrieval - Description : liste des modèles pris en charge, champ Usage, bonnes pratiques et erreurs courantes
- Lien :
-
Tarification de la Gemini Developer API : prix standard des modèles et tarifs de mise en cache
- Lien :
aistudio.google.com/docs/pricing - Description : prix unitaires d’entrée et de sortie pour chaque modèle, ainsi que dates d’entrée en vigueur
- Lien :
-
Documentation de l’API Interactions : positionnement de l’interface et étapes d’exécution
- Lien :
aistudio.google.com/docs/interactions-overview - Description : conversations avec état, structure des steps et différences avec generateContent
- Lien :
-
Google Python SDK v3.6.0 et Issue #2185 : preuves d’ingénierie et suivi des besoins des développeurs
- Lien :
github.com/googleapis/python-genai/releases/tag/v3.6.0 - Lien :
github.com/googleapis/python-genai/issues/2185 - Description : mise à jour du schéma public du SDK et demandes initiales de la communauté
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com.