Anmerkung des Autors: Ausgehend von öffentlich dokumentierten Praxistests mit drei persönlichen Agenten zerlegen wir die Schnittstellenprobleme hinter den Ausführungsschwächen von Agenten und liefern eine Checkliste zur Behebung – für Tool-Aufrufe, Fehlertoleranz mit Wiederholungsversuchen, Formatkompatibilität und Kostenkontrolle.
36Kr veröffentlichte am 4. November 2026 den Artikel „Persönliche Agenten treten an – wer zeigt zuerst Schwäche?“ und stellte drei persönliche Agenten im selben Praxistest an einen Tisch. Solche Vergleichstests kommen in der Regel zu einem sehr einheitlichen Fazit: Agenten mangelt es nicht am „Reden“, sondern am „Zu-Ende-Bringen“. Die Kernfrage dieses Artikels ist: Die Ausführungsschwächen von Agenten liegen größtenteils auf der Schnittstellenebene – und nicht allein im Modell selbst.
Dies ist kein weiterer Ranking-Artikel darüber, welcher Agent schlauer ist. Wir wiederholen nicht die konkreten Bewertungen des Originalartikels, sondern fassen die bei solchen Praxistests häufigen Ausführungsfehler in fünf Kategorien zusammen und ordnen sie anschließend nacheinander den Stellen zu, an denen sich das Design der Agent-Schnittstelle ändern lässt.
Kernnutzen: Nach der Lektüre wissen Sie, welche Schnittstellenparameter Sie beim Aufbau eines eigenen Agenten zuerst prüfen sollten, wie Sie mit Fehlern umgehen und wie Sie reibungslos zwischen den beiden Schnittstellenformaten von OpenAI und Anthropic wechseln.
Kernpunkte: Ausführungsschwächen von Agent-Schnittstellen
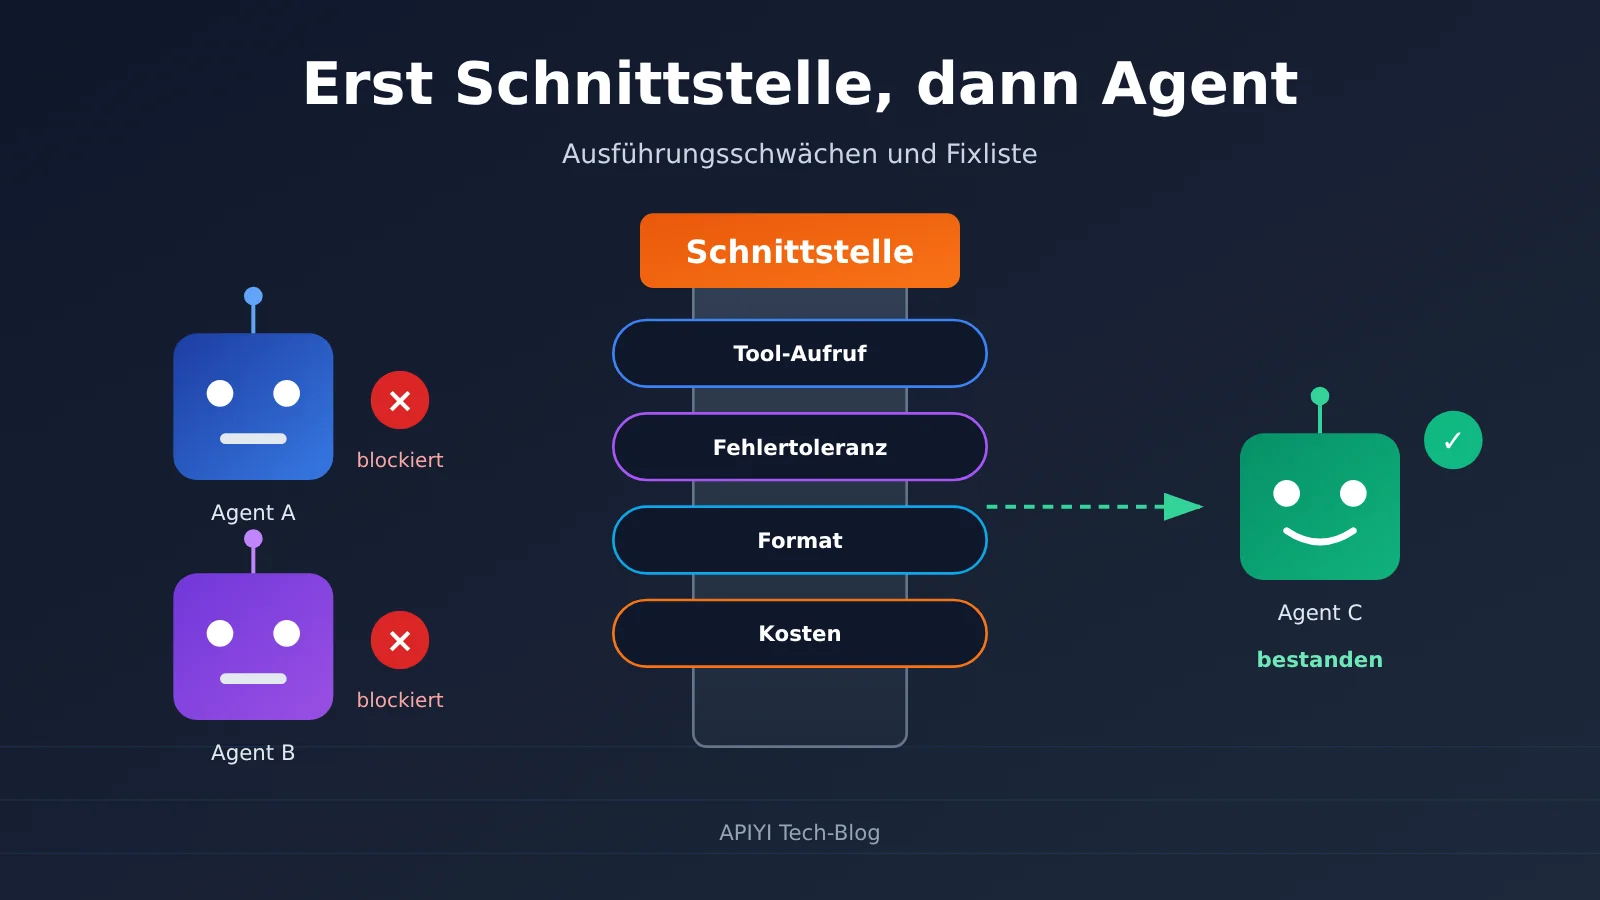
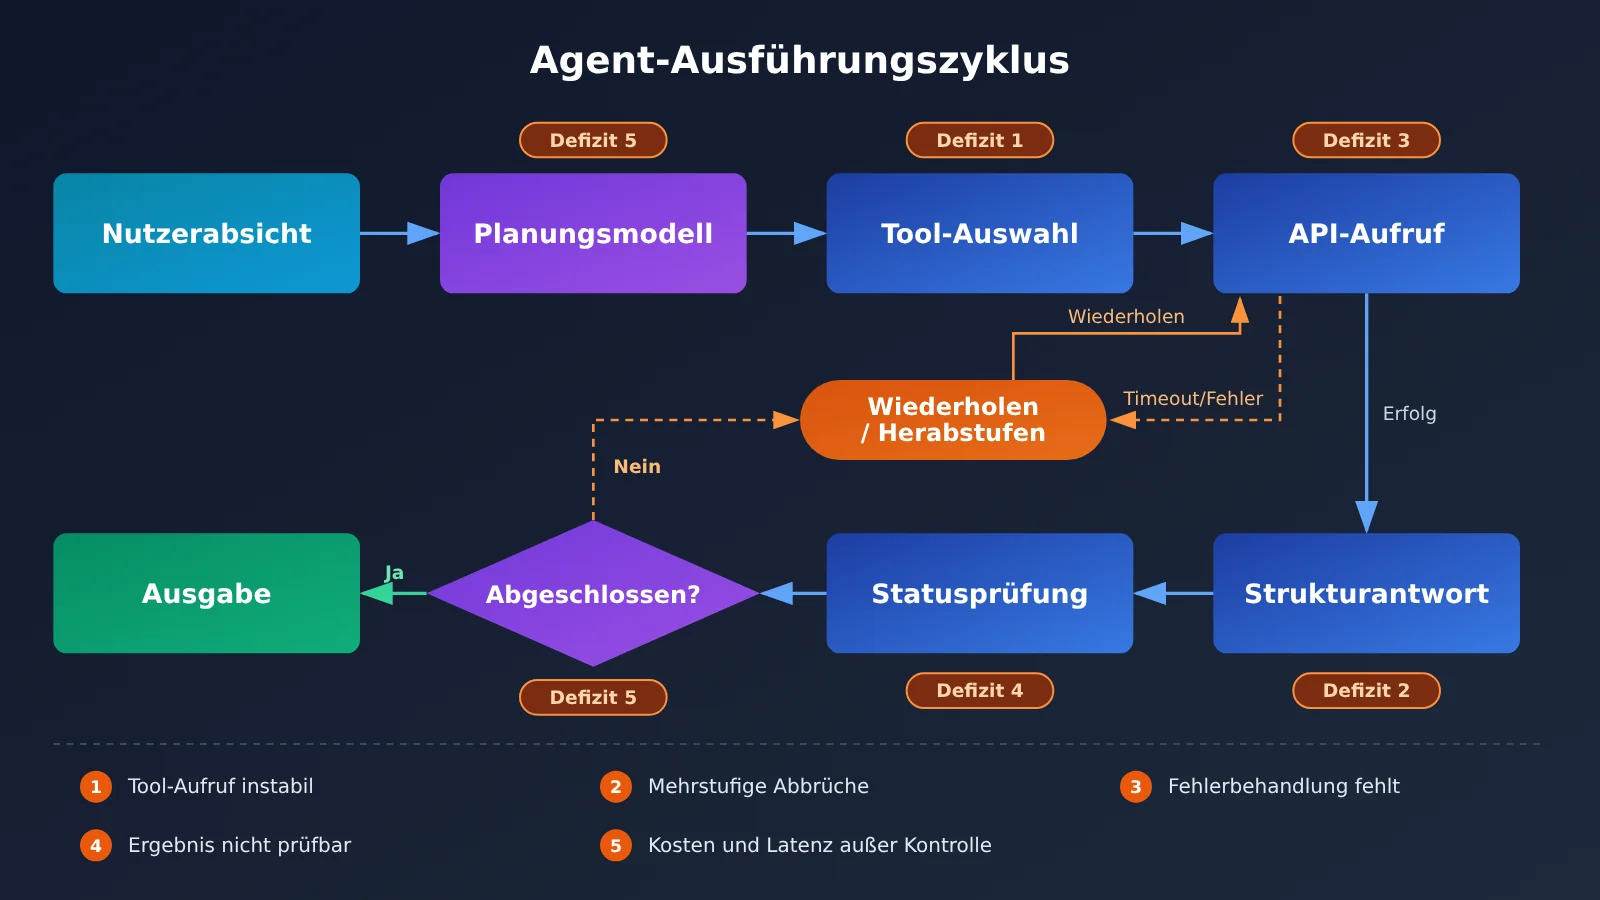
Das Ziel eines persönlichen Agenten ist es, die gesamte Aufgabe für den Nutzer zu erledigen – zum Beispiel Tickets buchen, E-Mails sortieren, Informationen zusammenfassen oder Webseiten bedienen. Sobald ein Zwischenschritt fehlschlägt, erlebt der Nutzer es als „Es ist nicht fertig geworden“. Verfolgt man die in Praxistests häufigen Fehlerbilder zurück, lassen sie sich fast immer auf die folgenden 5 Arten von Schnittstellenproblemen zurückführen.
| Ausführungsschwäche | Typisches Symptom | Ursache auf Schnittstellenebene | Lösungsrichtung |
|---|---|---|---|
| Unzuverlässige Tool-Aufrufe | falsches Tool ausgewählt, Parameterfelder fehlen, Format ungültig | Tool-Beschreibung vage, Schema ohne Einschränkungen | Tool-Set straffen, strenges Parameter-Schema schreiben |
| Mehrstufige Aufgaben brechen ab | nach dem dritten oder vierten Schritt ist das Ziel vergessen | grobe Kontextverwaltung, Tool-Ergebnisse nicht korrekt zurückgeliefert | Nachrichtenhistorie standardisieren, Zwischenergebnisse komprimieren |
| Externe Fehler ohne Auffangnetz | bei Rate-Limit oder Timeout sofort aufgeben oder Fertigstellung vortäuschen | Fehlertypen werden nicht unterschieden, es gibt keine Retry-Strategie | Retries nach Statuscode abstufen, Timeouts und Fallbacks ergänzen |
| Ergebnisse nicht verifizierbar | Antwort „erledigt“, tatsächlich wurde nichts getan | fehlende Ausführungsrückmeldung und Statusprüfung | für jeden Schritt eine strukturierte Rückmeldung verlangen |
| Kosten und Latenz geraten außer Kontrolle | Schleifenaufrufe, eine Aufgabe verbraucht viele Token | kein Schrittanlimit, kein Caching | maximale Rundenzahl festlegen, Modelle gestaffelt einsetzen, Caching nutzen |
Die wichtigsten Schnittstellenschwächen des Agenten im Detail
Die ersten beiden Schwächen wirken wie Probleme der Modellfähigkeit, lassen sich aber mit Engineering-Mitteln zum großen Teil beheben. Unzuverlässige Tool-Aufrufe entstehen am häufigsten dadurch, dass dem Modell auf einmal Dutzende Tools vorgesetzt werden und sich die Beschreibungen überschneiden – dann wählt das Modell natürlich falsch. Reduziert man die Tools auf den Umfang, den die aktuelle Aufgabe wirklich braucht, und gibt für jeden Parameter Typ, erlaubte Enum-Werte und Pflichtfeld-Status klar an, sinkt die Fehlerrate in der Regel deutlich. Abbrüche bei mehrstufigen Aufgaben liegen dagegen oft an der Rückgabe der Tool-Ergebnisse: Wenn das Ergebnis nicht gemäß Protokoll an die zugehörige Call-ID gebunden wird, kann das Modell nicht feststellen, ob der vorherige Schritt tatsächlich erfolgreich war.
Die letzten drei Schwächen sind reine Engineering-Probleme. Ein gut funktionierender Agent muss klar wissen, „was bei einem Fehler zu tun ist“ und „wie man belegt, dass die Aufgabe erledigt ist“. In der Praxis enttäuscht die Nutzer weniger der Fehler selbst als die vorgetäuschte Fertigstellung danach. Deshalb sind ein Rückmeldemechanismus auf Schnittstellenebene und eine Fehlerklassifizierung nützlicher, als ein größeres Modell einzusetzen.
Agent-Schnittstelle schnell starten: 5-Schritte-Checkliste
Die folgenden Schritte hängen von keinem bestimmten Framework ab. Sie gelten sowohl, wenn Sie die Agent-Schleife selbst schreiben, als auch bei der Verwendung eines fertigen Agent-Frameworks. Entsprechend den Vorgaben dieses Artikels gibt es hier keinen Code; alle wichtigen Einstellungen werden in Tabellen erläutert.
Schritt 1: Einheitlicher Einstiegspunkt für die Agent-Schnittstelle
Agents benötigen häufig eine Kombination aus „starkem Modell für die Planung und schnellem Modell für die Ausführung“. Wenn jedes Modell einzeln an einen eigenen Anbieter angebunden wird, unterscheiden sich Authentifizierung, Fehlerformate und Abrechnungslogik – das macht die Fehlersuche aufwendig. Einfacher ist ein einheitlicher Einstiegspunkt, der sowohl mit dem OpenAI- als auch dem Anthropic-API-Format kompatibel ist. Dann reicht es, base_url, api_key und model zu ändern, um das Modell zu wechseln.
| Konfiguration | Zweck | Empfohlener Wert |
|---|---|---|
base_url |
API-Adresse | Laut Anbieterdokumentation, z. B. die in der APIYI-Dokumentation unter docs.apiyi.com angegebene Adresse |
api_key |
Authentifizierungsnachweis | In einer Umgebungsvariable ablegen, nicht in die Eingabeaufforderung oder Logs schreiben |
model |
Modellname | Planung und Ausführung getrennt konfigurieren, damit sie einzeln ausgetauscht werden können |
timeout |
Timeout pro Anfrage | Je nach Aufgabentyp festlegen; bei Aufgaben mit langen Ausgaben großzügiger bemessen |
max_retries |
Anzahl automatischer SDK-Wiederholungen | Klein halten; die Anwendungsebene übernimmt abgestufte Wiederholungen selbst |
🚀 Schnellstart: APIYI bietet API-Aufrufe für die in diesem Artikel behandelten gängigen großen Sprachmodelle und ist sowohl mit dem OpenAI- als auch dem Anthropic-API-Format kompatibel. Bei bestehenden SDKs reicht eine Änderung von
base_urlzur Anbindung. Hinweise zur Anbindung finden Sie im APIYI-Dokumentationszentrum: docs.apiyi.com.
Schritt 2: Tool-Calling-Parameter für den Agenten strikt definieren
Der Tool-Aufruf ist die erste Hürde bei der Ausführungsstärke eines Agenten. Je strenger die Parameter definiert sind, desto kleiner wird der Spielraum für „freie Interpretation“ durch das Modell – und desto niedriger die Fehlerquote.
| Parameter | Bedeutung | Praktische Empfehlung |
|---|---|---|
tools |
Liste der aufrufbaren Tools | Pro Runde nur die Tools freigeben, die in der aktuellen Phase gebraucht werden; in der Beschreibung klar festhalten, „wann man es nutzt und wann nicht“ |
tool_choice |
Strategie der Tool-Auswahl | Wenn eine bestimmte Aktion erzwungen werden soll, das Tool explizit angeben; bei offenen Fragen auf automatisch setzen |
| Parameter-Schema | Struktur der Tool-Eingabeparameter | Pflichtfelder in required eintragen; wo eine Enumeration möglich ist, keinen Freitext verwenden |
response_format |
Strukturierte Ausgabe | Für die abschließende Rückmeldung eine JSON-Struktur verlangen, damit sie programmatisch geprüft werden kann |
max_tokens |
Obergrenze der Ausgabe | Im Anthropic-Format ein Pflichtfeld, je nach Aufgabe vorab kalkulieren |
temperature |
Zufälligkeit | Bei ausführenden Schritten niedriger setzen, damit dieselbe Eingabe nicht zu unterschiedlichen Aktionen führt |
Schritt 3: Formatunterschiede zwischen OpenAI und Anthropic behandeln
Viele Agenten werden nach einem Modellwechsel scheinbar „plötzlich dumm“. Die Ursache liegt nicht im Modell, sondern darin, dass die Tool-Protokolle der beiden Formate unterschiedlich sind und die Ergebnisse deshalb an der falschen Stelle zurückkommen. Die folgende Tabelle zeigt die Stellen, an denen man am ehesten stolpert.
| Vergleichspunkt | OpenAI Chat Completions-Format | Anthropic Messages-Format |
|---|---|---|
| Position des System-Prompts | Liegt in messages mit der Rolle system |
Wird über den Top-Level-Parameter system gesetzt |
| Tool-Definition | type: function plus ein Function-Objekt |
name, description, input_schema |
| Aufruf durch das Modell | tool_calls in der Assistant-Nachricht |
Content-Block vom Typ tool_use |
| Rückgabe des Tool-Ergebnisses | Nachricht mit der Rolle tool, inklusive tool_call_id |
tool_result-Content-Block in einer User-Nachricht, verknüpft über tool_use_id |
| Obergrenze der Ausgabe | max_tokens optional |
max_tokens Pflichtfeld |
Keines der beiden Formate ist besser als das andere. Entscheidend ist, im Agenten nur eine einzige interne Repräsentation zu pflegen und sie erst beim Request in das passende Format zu übersetzen. Wenn Sie einen Endpunkt nutzen, der beide Formate unterstützt – etwa APIYI –, können Sie die Claude-Reihe im nativen Anthropic-Format laufen lassen und alle anderen Modelle im OpenAI-Format; so bleibt jeweils die vollständige Tool-Calling-Fähigkeit erhalten.
Schritt 4: Fallbacks für fehlgeschlagene Agent-Schnittstellen entwerfen
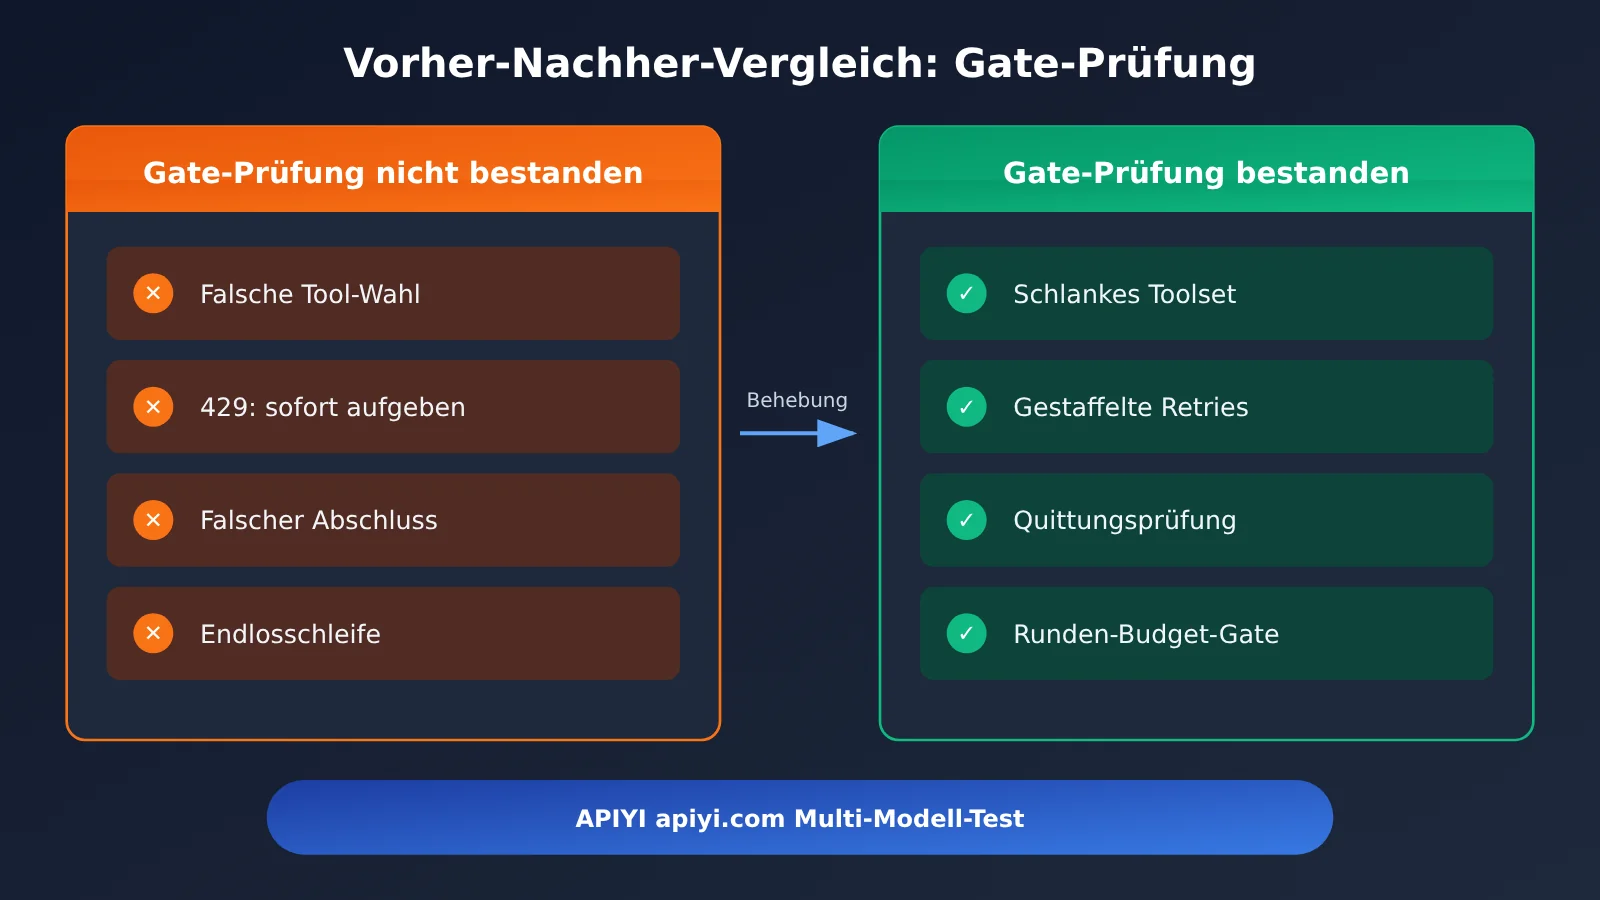
„Bei einem Fehler einfach aufgeben“ und „bei einem Fehler Erfolg vortäuschen“ sind die beiden Verhaltensweisen, die in der Praxis die Nutzererfahrung am stärksten beschädigen. Der richtige Ansatz ist, zunächst nach Fehlertyp zu klassifizieren und dann zu entscheiden, ob ein erneuter Versuch, eine Degradierung oder eine ehrliche Information an den Nutzer angebracht ist.
| Fehlertyp | Häufige Ursache | Strategie des Agenten |
|---|---|---|
| 400 Parameterfehler | Ungültige Tool-Parameter, falsch ausgerichtetes Nachrichtenformat | Nicht blind wiederholen, sondern die Fehlermeldung an das Modell zurückgeben, damit es einmal korrigiert |
| 401 / 403 Authentifizierung | Schlüssel ungültig oder Berechtigungen unzureichend | Sofort abbrechen und den Nutzer auf die Prüfung der Konfiguration hinweisen |
| 429 Ratenlimit | Zu hohe Parallelität oder Kontingent erschöpft | Exponentielles Backoff mit Wiederholung, bei Bedarf auf ein Ausweichmodell wechseln |
| 5xx Serverfehler | Schwankungen des Upstream-Dienstes | Begrenzte Wiederholungen, oberhalb der Obergrenze degradieren |
| Timeout | Lange Ausgabe oder Netzwerk-Jitter | Auf Streaming-Ausgabe umstellen oder die Aufgabe in kleinere Teile zerlegen und erneut versuchen |
Ein weiteres leicht übersehenes Detail: Tools mit Nebenwirkungen müssen idempotent sein. Bei Operationen wie E-Mails versenden, Bestellungen aufgeben oder in die Datenbank schreiben, muss vor einem erneuten Versuch geprüft werden, ob der vorherige bereits wirksam geworden ist – sonst erledigt der Agent dieselbe Sache zweimal.
Schritt 5: Rückmeldungen und Kostenschranken für den Agenten
Jede Tool-Ausführung sollte eine strukturierte Rückmeldung zurückgeben, die mindestens drei Felder enthält: „erfolgreich oder nicht“, „was wurde getan“ und „Kennung des zentralen Ergebnisses“. Bevor der Agent eine Aufgabe als abgeschlossen meldet, muss ein Programm – nicht das Modell – die Rückmeldung prüfen. So wird ein fälschlich behauptetes „Erledigt“ schon durch den Mechanismus ausgeschlossen.
Bei den Kosten empfiehlt es sich, drei Kostenschranken einzubauen: maximale Schleifenrunden, ein Token-Budget pro Aufgabe und die Erkennung wiederholter Aufrufe. Planung, Ausführung und Klassifizierung können auf Modelle unterschiedlicher Leistungsstufen verteilt werden. Lange Systemanweisungen und Tool-Definitionen sollten möglichst stabil bleiben, um den Prompt-Cache zu nutzen. Konkrete Preise pro Einheit für Eingabe, Ausgabe und Cache sowie die Abrechnungsmodalitäten entnehmen Sie bitte den tatsächlichen Daten auf der APIYI-Preisseite https://docs.apiyi.com/models. Dieser Artikel nennt keine ungeprüften Preisangaben.
💡 Empfehlung: In der Aufbauphase zunächst mit kleinem Traffic den gesamten Kreislauf durchlaufen lassen und erst dann schrittweise Tools ergänzen. Über APIYI apiyi.com können Sie mit demselben Key schnell vergleichen, wie stabil verschiedene Modelle bei Tool-Aufrufen sind – für einen Wechsel muss nur das Feld
modelgeändert werden.
Referenz zur Auswahl der Agent-API-Schichten
Leistungsstarke Agents setzen selten nur auf ein einziges Modell. Eine Schichtung nach Zuständigkeiten erhöht die Stabilität und erleichtert die Kostenkontrolle.
| Zuständigkeitsschicht | Fähigkeitsanforderungen | Auswahlansatz | Verfügbare Plattformen | Preisreferenz |
|---|---|---|---|---|
| Planungsschicht | Langes Kontextfenster, komplexes Reasoning, Aufgabenzerlegung | Ein Flaggschiffmodell mit starker Reasoning-Fähigkeit wählen | APIYI apiyi.com, offizielle API | Gemäß Preisseite von APIYI |
| Ausführungsschicht | Stabiler Tool-Aufruf, schnelle Antwort | Ein Mittelklassemodell mit stabilem Tool-Calling wählen | APIYI apiyi.com, offizielle API | Gemäß Preisseite von APIYI |
| Leichtgewichtsschicht | Absichtsklassifikation, Formatvalidierung, Zusammenfassung/Komprimierung | Ein kleines Modell mit geringer Latenz und niedrigen Kosten wählen | APIYI apiyi.com, offizielle API | Gemäß Preisseite von APIYI |
Welche Modelle konkret verfügbar sind und wie die aktuellen Modellnamen lauten, entnehmen Sie bitte der APIYI-Dokumentation unter docs.apiyi.com. Es empfiehlt sich, mit den eigenen realen Aufgaben jeweils eine Stichprobe laufen zu lassen und Erfolgsquote der Tool-Aufrufe, durchschnittliche Anzahl der Runden und Verbrauch pro Aufgabe zu erfassen, bevor Sie festlegen, welches Modell in welcher Schicht eingesetzt wird. Verlassen Sie sich dabei nicht nur auf öffentliche Ranglisten.
Häufig gestellte Fragen (FAQ)
Q1: Was ist die „Schnittstellen-Hürde“ eines Agenten?
Gemeint ist die Engineering-Schicht, die zwischen „durchdacht“ und „erledigt“ liegt: Tool-Definitionen, Aufrufprotokolle, Fehlerbehandlung, Ergebnisquittungen und Kostenkontrolle. Das Modell trifft die Entscheidungen, die Schnittstellenschicht sorgt dafür, dass diese Entscheidungen zuverlässig in die Tat umgesetzt werden. Wer diese Hürde nicht nimmt, erlebt selbst bei einem starken Modell eine schwache Ausführungsqualität.
Q2: Liegt schwache Ausführung am Modell oder an der Schnittstelle?
An beidem, aber Schnittstellenprobleme werden leichter unterschätzt. Falsch gewähltes Tool, fehlerhaftes Parameterformat, abgerissene Aufrufketten, die Behauptung „fertig“, obwohl der Aufruf fehlgeschlagen ist – ein guter Teil davon lässt sich durch strengere Schemata, standardisierte Ergebnisrückgabe und zusätzliche Quittungsprüfungen entschärfen. Erst die Schnittstellenschicht solide aufbauen, dann beurteilen, ob wirklich ein Modellwechsel nötig ist.
Q3: Was zeigt der Praxistest mit drei persönlichen Agenten?
Der Testbericht von 36Kr vom November 2026 zeigt, dass persönliche Agenten in die Phase eingetreten sind, in der es darum geht, wer Aufgaben wirklich zu Ende bringt – der Schwerpunkt hat sich von der Dialogqualität auf den geschlossenen Ausführungskreislauf verschoben. Die konkreten Ergebnisse der einzelnen Produkte stehen im Original; dieser Artikel zieht nur die allgemeinen Engineering-Lehren daraus.
Q4: OpenAI-Format oder Anthropic-Format – was sollte man wählen?
Nach Modell entscheiden. Claude-Modelle nutzen das native Anthropic-Format und können Tool-Aufrufe und Caching voll ausschöpfen; die meisten anderen Modelle sind mit dem OpenAI-Format universeller unterwegs. APIYI unterstützt beide Formate gleichzeitig, sodass du im Agenten eine einheitliche Zwischendarstellung pflegen und erst beim Request pro Modell konvertieren kannst.
Q5: Wie binde ich schnell mehrere Modelle in meinen Agenten ein?
1. Bei APIYI apiyi.com registrieren und API-Schlüssel besorgen;
2. `base_url` nach der Dokumentation unter docs.apiyi.com konfigurieren;
3. In Planungs- und Ausführungsschicht jeweils `model` eintragen und mit derselben Aufgabenliste vergleichend testen.
Am SDK muss dabei nichts geändert werden, nur die Konfiguration.
Q6: Wie schätze ich die Agent-Kosten, und wo sehe ich die Preise?
Zuerst die durchschnittliche Rundenzahl, die Input-Tokens und die Output-Tokens pro Aufgabe ermitteln, dann mit dem Stückpreis des jeweiligen Modells multiplizieren. Input-, Output- und Cache-Preise sowie die Abrechnungsregeln gelten einheitlich nach den tatsächlichen Daten der APIYI-Preisseite https://docs.apiyi.com/models; die Unterschiede zwischen den Modellen sind groß, also immer anhand der realen Seite kalkulieren.
Q7: Mit mehr Tools wird der Agent immer instabiler – was tun?
Tools je nach Aufgabenphase dynamisch bereitstellen, pro Runde nur wenige relevante Tools. Man kann auch zuerst ein leichtes Modell die Routing-Klassifizierung machen lassen und dann dem Ausführungsmodell die passende Tool-Teilmenge übergeben. Klar formulierte Einsatzgrenzen in der Tool-Beschreibung wirken besser, als immer mehr Beispiele anzuhäufen.
Q8: Welche Grenzen bleiben, wenn die Schnittstellenschicht solide ist?
Die Schnittstellenschicht erhöht die Stabilität deutlich, löst aber nicht die Reasoning-Obergrenze des Modells und auch nicht Änderungen bei Websites oder Diensten von Drittanbietern. Bei langen Aufrufketten sollten weiterhin manuelle Bestätigungspunkte bleiben, besonders bei irreversiblen Aktionen wie Zahlungen, Löschungen oder dem Versand nach außen.
Key Takeaways zur Ausführungsfähigkeit von Agent-Schnittstellen
- Schwächen bei der Ausführung liegen meist auf der Schnittstellenebene: Falsche Werkzeugwahl, abgebrochene Ketten, vorgetäuschte Erledigung – dafür gibt es in den meisten Fällen eine technische Lösung
- Lieber wenige Werkzeuge als zu viele: Werkzeuge schrittweise freigeben, und je strenger das Parameter-Schema, desto stabiler läuft es
- Formatunterschiede isolieren: intern eine einheitliche Darstellung, erst beim Request in das OpenAI- oder Anthropic-Format umwandeln
- Fehler müssen klassifiziert werden: 400 korrigieren, 429 mit Backoff begegnen, 5xx degradieren; Operationen mit Nebenwirkungen müssen idempotent sein
- Der Abschluss wird vom Programm festgestellt: strukturierte Rückmeldung plus Statusprüfung, damit „Scheinerledigung“ gar nicht erst durchkommt
- Kostenschranken setzen: Obergrenze für Runden, Token-Budget, gestaffelter Modelleinsatz; Preise laut APIYI-Preisseite
- Einstiegspfad: über den einheitlichen Zugang von APIYI mehrere Modelle anbinden – einfach
base_urlundmodeländern, schon lässt sich vergleichen
Fazit
Der Praxistest mit drei persönlichen Agents ist eine Mahnung an Entwickler: Der Wettbewerb bei Agents verschiebt sich gerade vom „kann plaudern“ zum „kann zu Ende bringen“. Um die Ausführungsfähigkeit nachzuziehen, lohnt sich die Investition zuerst an der Schnittstellenhürde am meisten:
- Tool-Aufrufe: Werkzeuge straffen, Schema verschärfen, Ergebnisrückgabe standardisieren;
- Fehlertoleranz als Sicherheitsnetz: Fehlerklassifizierung, begrenzte Wiederholungen, Idempotenzschutz;
- Verifizierbar und kontrollierbar: strukturierte Rückmeldung, Prüfung durch das Programm, Kostenschranken.
Am besten zuerst eine echte Aufgabe einmal komplett durchlaufen lassen und die Fähigkeiten danach schrittweise ausbauen. Empfohlen wird der Zugang über APIYI apiyi.com – die Plattform ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel, was den Vergleich der Ausführungsstabilität verschiedener Modelle erleichtert. Die Dokumentation findet sich unter docs.apiyi.com, Preise laut https://docs.apiyi.com/models.
📚 Referenzen
- 36Kr: Persönliche Agenten treten auf den Plan – wer zeigt als Erster Nerven? Ein Praxistest mit drei persönlichen Agenten
- Link:
36kr.com/p/4055385191224452 -
Hinweis: Quelle für das Thema dieses Artikels; konkrete Produkte und Testergebnisse finden Sie im Originalbeitrag
-
APIYI Dokumentationszentrum: Hinweise zu Integrationskonfiguration und verfügbaren Modellen
- Link:
docs.apiyi.com -
Hinweis:
base_url-Konfiguration, Anbindung im OpenAI- und Anthropic-Format -
APIYI Modell-Preisseite: Modellpreise und Abrechnungsgrundlagen
- Link:
docs.apiyi.com/models - Hinweis: Alle Preisangaben in diesem Artikel richten sich nach den tatsächlichen Daten auf dieser Seite
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die offizielle APIYI-Website apiyi.com. Weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com