Hinweis des Autors: Die drei Bereiche Coding, Diagramme und Langkontext von Gemini 4 Neon und GPT-6.2 Sol werden getrennt gegenübergestellt; außerdem werden Kosten pro Aufgabe, Laufzeit, offizielle Stückpreise und APIYI-Katalogpreise geprüft. Jede Zahl ist mit ihrer Quelle versehen.
Viele Teams sehen GPT-6.2 Sol als die günstigere Option. Gemini 4 Neon wurde am 2026-11-18 veröffentlicht; die Modellseite von Artificial Analysis weist einen Intelligenzscore von 61 aus, Sol liegt bei 57. Wo genau diese 4 Punkte auf Aufgabenebene liegen, entscheidet darüber, wie viel sie für deine Arbeitslast wert sind. Dieser Artikel betrachtet Coding, Diagramme und Langkontext getrennt und führt anschließend zwei getrennte Rechnungen: eine für die Kosten pro Aufgabe und eine für die Stückpreise.
Jede Zahl im Text trägt eine Quellenkennzeichnung: offizielle Selbstauskunft, Modellkarte, Artificial-Analysis-Modellseite, Artificial-Analysis-Artikel, APIYI-Übersichtstabelle, Preis-API. Zahlen, bei denen die beiden Messgrundlagen nicht übereinstimmen, bleiben nebeneinander stehen – ohne Mittelwert und ohne neue zusammengesetzte Zahl.
Kernaussage: Nach dem Lesen kannst du klar sagen, in welchen Bereichen die zusätzlichen Punkte von Neon auftauchen, in welcher Disziplin Sol sogar besser abschneidet, wie groß der Unterschied zwischen beiden bei Kosten pro Aufgabe und Laufzeit ist und wie du das bereits gelistete gpt-6.2-sol über APIYI aufrufst.
Gemini 4 Neon und GPT-6.2 Sol: die Kernunterschiede auf einen Blick
Hier zuerst die sieben wichtigsten Zeilen zusammengestellt. Achtet auf die Stufen: Auf der Artificial Analysis-Modellseite stammen Neons 61 Punkte aus der xhigh-Stufe, Sols 57 Punkte aus der max-Stufe. Beide sind die jeweils höchste Stufe auf ihrer Seite, doch die Stufenbezeichnungen und ihre Bedeutung unterscheiden sich.
| Vergleichsdimension | Gemini 4 Neon | GPT-6.2 Sol | Quelle |
|---|---|---|---|
| Gesamtintelligenz-Score | 61 (xhigh) | 57 (max) | Artificial Analysis-Modellseite |
| Coding: Terminal-bench 4.1 (Genauigkeit nach Cheating-Korrektur) | 65.2% | 61.5% | Model Card |
| Diagramme: Chartography | 73.5% | 75.1% | Model Card |
| Langkontext: GraphWalks (256k bis 1M, F1 bei BFS) | 95.2% | 80.1% | Model Card |
| Kosten pro Aufgabe | 6.44 USD | 1.01 USD | Artificial Analysis-Modellseite |
| Zeit pro Aufgabe | 21.5 Minuten | 8.5 Minuten | Artificial Analysis-Modellseite |
| Listenpreis (Eingabe/Ausgabe, pro Million Token) | 3 / 15 USD | 2 / 10 USD | Offizielle Eigenangabe / Artificial Analysis-Modellseite |
Drei Hinweise zur Einordnung, bevor Sie die Vergleichstabelle von Gemini 4 Neon und GPT-6.2 Sol lesen
Der erste Punkt betrifft die Art der Model Card. Die Vergleichstabelle in der Model Card von DeepMind hat nur drei Spalten: Gemini 4 Neon, Claude Opus 5.5 und GPT-6.2 Sol. Das begleitende Evaluations-PDF legt fest, dass Ergebnisse für Nicht-Gemini-Modelle standardmäßig aus den Eigenangaben der jeweiligen Anbieter stammen. Die Sol-Spalte in der Model Card enthält also von Google zusammengefasste offizielle Zahlen und keine Wiederholungsmessung durch dasselbe Labor am selben Tag.
Der zweite Punkt betrifft die Konsistenz des Intelligenzwerts. Die Zahl 61 stimmt an allen drei Stellen überein: im Google-Blog (offizielle Eigenangabe), in der Model Card (die Zeile für AA Index v5.0.1 nennt 61 / 59 / 57) und auf der Artificial Analysis-Modellseite. Sols 57 stimmt in der Model Card und auf der Artificial Analysis-Modellseite ebenfalls überein. Bei den Coding-Indizes ist es nicht so einheitlich; ich gehe unten getrennt darauf ein.
Der dritte Punkt betrifft die Kostenbasis. Die Kosten pro Aufgabe bei Artificial Analysis sind der Betrag, der nach dem Durchlaufen der gesamten Index-Suite auf jede Aufgabe entfällt. Sie hängen sowohl vom Stückpreis als auch von der Anzahl der Ausgabe-Token ab. Diese Zahl und der tokenbasierte Preis pro einzelnem Aufruf auf der Plattform sind zwei verschiedene Rechnungen und können einander nicht ersetzen.
Vergleich der Codierungsfähigkeiten von Gemini 4 Neon und GPT-6.2 Sol
Im Bereich Codierung liegt Neon bei allen fünf Unterkategorien der Modellkarte, für die Daten vorliegen, über Sol – allerdings sind die Abstände sehr ungleichmäßig. Die folgende Tabelle stammt vollständig aus der Modellkarte; die Zahlen für Sol sind laut den Evaluierungsdetails von OpenAI selbst gemeldet.
| Codierungs-Unterkategorie (Modellkarte) | Gemini 4 Neon | GPT-6.2 Sol | Abstand |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | Keine Daten | Nicht vergleichbar |
| Terminal-bench 4.1 (nach Betrugsbereinigung) | 65.2% | 61.5% | 3.7 Prozentpunkte |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4 Prozentpunkte |
| SWE-sweep (Anbieter-Harness) | 39.0% | 8.3% | 30.7 Prozentpunkte |
| SWE-sweep (mini-SWE-Harness) | 12.8% | 11.6% | 1.2 Prozentpunkte |
Die beiden Harnesses von SWE-sweep müssen getrennt gelesen werden
SWE-sweep ist die Zeile, die am leichtesten missverstanden wird. Neons 39.0% stammen vom Anbieter-Harness Google Antigravity; mit dem einheitlichen mini-SWE-Harness sind es 12.8%. Der Google-Blog (offizielle Selbstauskunft) beschreibt den Sprung von 12.8 auf 39.0 als Freischaltung durch das Harness – diese Zahlen zeigen also den kombinierten Effekt von „Modell plus Toolchain“.
Unter ein und demselben mini-SWE-Harness stehen Neon 12.8% gegen Sol 11.6% – nur 1.2 Prozentpunkte Unterschied. Sol erreicht im eigenen Anbieter-Harness 8.3%, was sogar unter seinem mini-SWE-Ergebnis liegt. Wenn Ihr Coding-Agent nicht in Antigravity läuft, kommt die mini-SWE-Zeile den Bedingungen, die Sie reproduzieren können, näher.
Die beiden Zahlen des Coding Agent Index
Der Google-Blog (offizielle Selbstauskunft) nennt für Neon einen Artificial Analysis Coding Agent Index von 58.6 und bezeichnet ihn als Gesamtplatz 1. Der Artikel von Artificial Analysis nennt 59 für Neon xhigh auf der Antigravity CLI. Die beiden Zahlen stammen aus unterschiedlichen Quellen; dieser Beitrag behält beide bei und führt sie nicht zusammen. In den Referenzmaterialien gibt es keine Punktzahl für Sol in diesem Index, daher lässt sich dieser Punkt nicht zwischen beiden vergleichen. Zudem wurde die 46.2% bei FrontierCode 2.0 laut offizieller Selbstauskunft in der Standardstufe „high“ gemessen.
Vergleich der Diagrammfähigkeiten von Gemini 4 Neon und GPT-6.2 Sol
Bei den Diagrammen liegt Sol als einziges der drei Felder vorn. In der Chartography-Zeile der Modellkarte steht Neon bei 73,5 %, Sol bei 75,1 % – Sol liegt um 1,6 Prozentpunkte höher. Der Google-Blog (offizielle Selbstauskunft) nennt für Neon ebenfalls 73,5 %, beide Quellen stimmen überein.
Beim ebenfalls zum multimodalen Verständnis gehörenden LVBench nennt die Modellkarte Neon 89,0 % und Sol 87,6 %; hier liegt Neon um 1,4 Prozentpunkte vorn. Die beiden Werte laufen in entgegengesetzte Richtungen und die Abstände sind beide klein. Ob „Diagramm- oder visuelle Aufgaben“ besser gemeistert werden, lässt sich daher kaum in einem Satz sagen – es hängt davon ab, ob Ihre Aufgabe eher dem Lesen von Diagrammen oder dem Ansehen langer Videos ähnelt.
Zu den Eingabemodalitäten schreibt die Modellkarte, dass Neon Text, Bilder, Audio und Video akzeptiert. Die Referenzunterlagen enthalten keine Liste der Eingabemodalitäten für Sol. Wenn Ihre Pipeline auf Audio- oder Videoeingaben angewiesen ist, sollten Sie zunächst in der offiziellen OpenAI-Dokumentation prüfen, ob Sol diese unterstützt.
Vergleich des Langkontexts von Gemini 4 Neon und GPT-6.2 Sol
Für den Langkontext verwendet dieser Artikel ausschließlich die GraphWalks-Daten der Modellkarte. Bei einer BFS-Traversierung im Bereich von 256k bis 1M Token erreicht Neon einen F1-Score von 95,2 %, Sol 80,1 % – eine Differenz von 15,1 Prozentpunkten und damit der größte Abstand unter den drei Feldern.
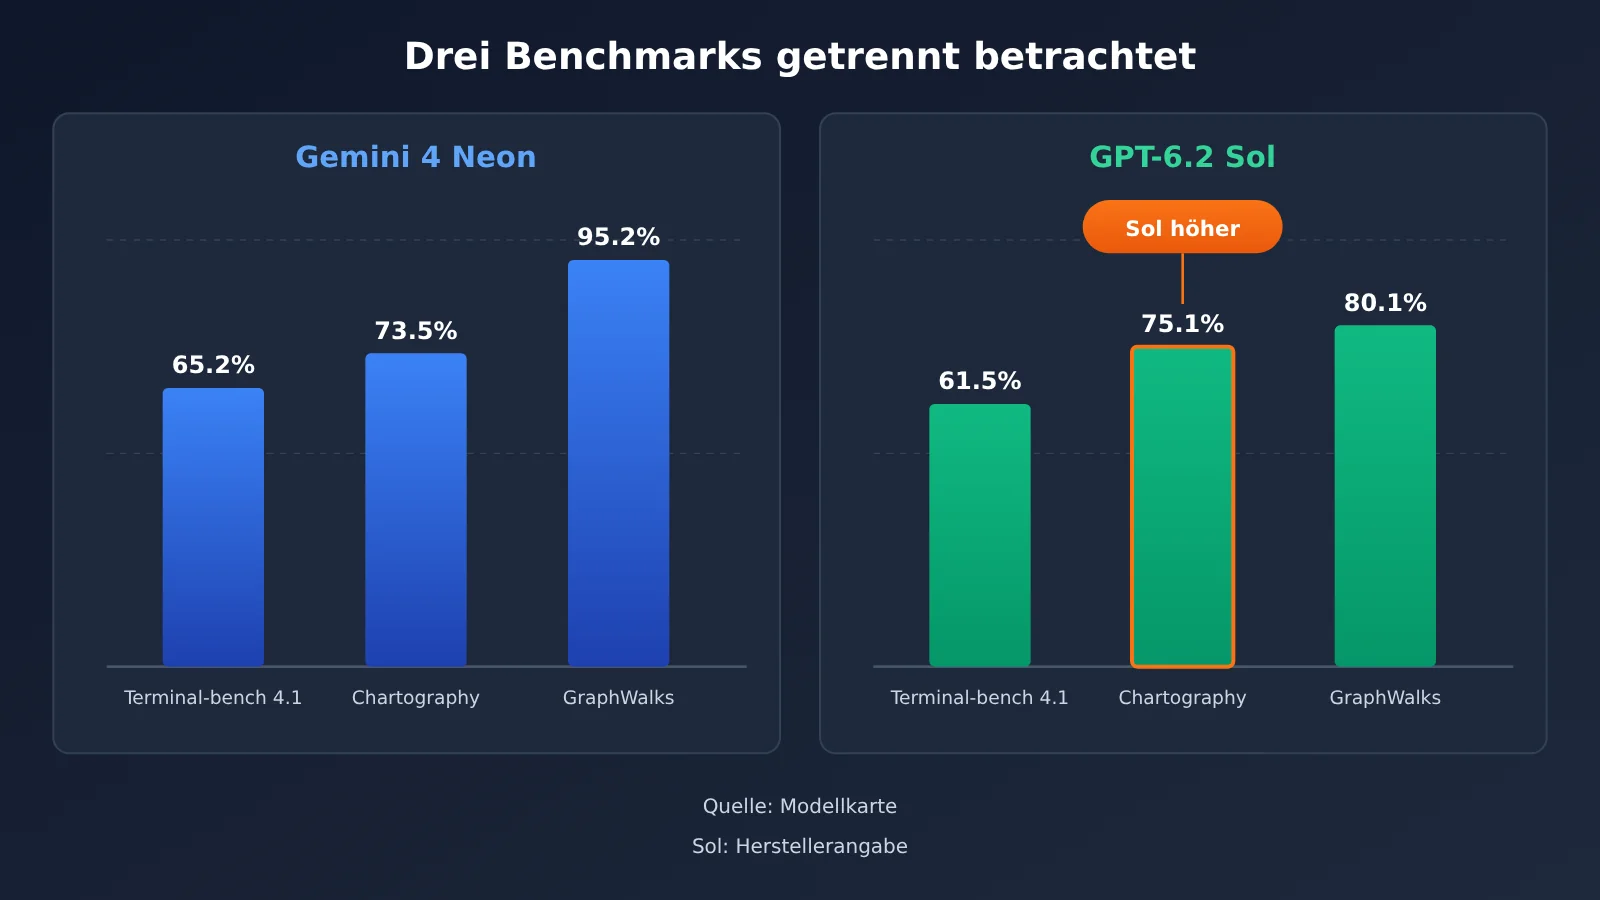
📊 Hinweis zum Diagramm: Alle Zahlen im obigen Diagramm stammen aus der Modellkarte; die Sol-Spalte gehört laut Bewertungshinweis zur Anbieter-Selbstauskunft. Wenn Sie die Leistung von Sol an Ihren eigenen langen Dokumenten überprüfen möchten, können Sie über APIYI apiyi.com mit demselben API-Schlüssel direkt eine
gpt-6.2-sol-Anfrage starten.
Langkontext-Parameter von Gemini 4 Neon
Für Neon ist die Fensterspezifikation vollständig dokumentiert. Die Modellkarte gibt ein gemeinsames Fenster von maximal 1 Million Token an, standardmäßig bis zu 64.000 Token synchroner Ausgabe und bis zu 1 Million Token für die lange Dekodierung im Hintergrund. Der Google-Cloud-Entwicklerleitfaden nennt exakte Werte: Obergrenze 1048576 Token, die Eingabe und Ausgabe gemeinsam umfasst, wobei die Ausgabe wiederum Reasoning, Funktionsaufrufe und die endgültige Antwort enthält; pro Segment standardmäßig maximal 65536, bei langer Dekodierung bis zu 1048576 minus Eingabe.
Zum Caching schreibt der Entwicklerleitfaden, dass Neon explizites Kontext-Caching nicht unterstützt. Implizites Caching greift automatisch für gemeinsame Präfixe ab 4096 Token; persistentes Caching ist standardmäßig aktiviert. Für Szenarien, in denen wiederholt Fragen zu langen Dokumenten gestellt werden, bedeutet das: Sie müssen das gemeinsame Präfix stabil halten, um den auf der Preisseite von AI Studio genannten Cache-Preis von 0,15 US-Dollar zu nutzen.
Langkontext-Informationen zu GPT-6.2 Sol
Die Referenzunterlagen geben kein oberes Limit für das Kontextfenster von Sol an; dieser Artikel vergleicht die Fenstergröße daher nicht. Bestätigen lässt sich die Abrechnung: Die APIYI-Übersichtstabelle zeigt, dass gpt-6.2-sol bei einer Eingabe über 272000 Token in eine höhere Preisstufe wechselt; der Abschnitt zu den Preisen weiter unten geht darauf ein. Bei Langkontext-Aufgaben wirkt sich diese Schwelle direkt auf die Struktur Ihrer Abrechnung aus.
Gemini 4 Neon vs. GPT-6.2 Sol: Kosten und Laufzeit im Vergleich
Der Unterschied bei den Kosten pro Aufgabe ist deutlich größer als der bei den Stückpreisen. Auf der Modellseite von Artificial Analysis kostet eine Aufgabe mit Neon xhigh 6,44 US-Dollar, mit Sol max 1,01 US-Dollar – also etwa 6,4-mal so viel. Die Listenpreise unterscheiden sich dagegen nur um den Faktor 1,5: 3 zu 2 bei der Eingabe und 15 zu 10 bei der Ausgabe.
Der zusätzliche Anteil kommt von der Ausgabemenge. Auf derselben Seite hat Neon xhigh im Index-Lauf 283 Millionen Token ausgegeben, Sol max 60,9 Millionen Token – rund 4,6-mal so viel. Erst der um die Hälfte höhere Stückpreis plus die um ein Mehrfaches größere Ausgabemenge ergeben zusammen die 6,44 gegenüber 1,01 US-Dollar.
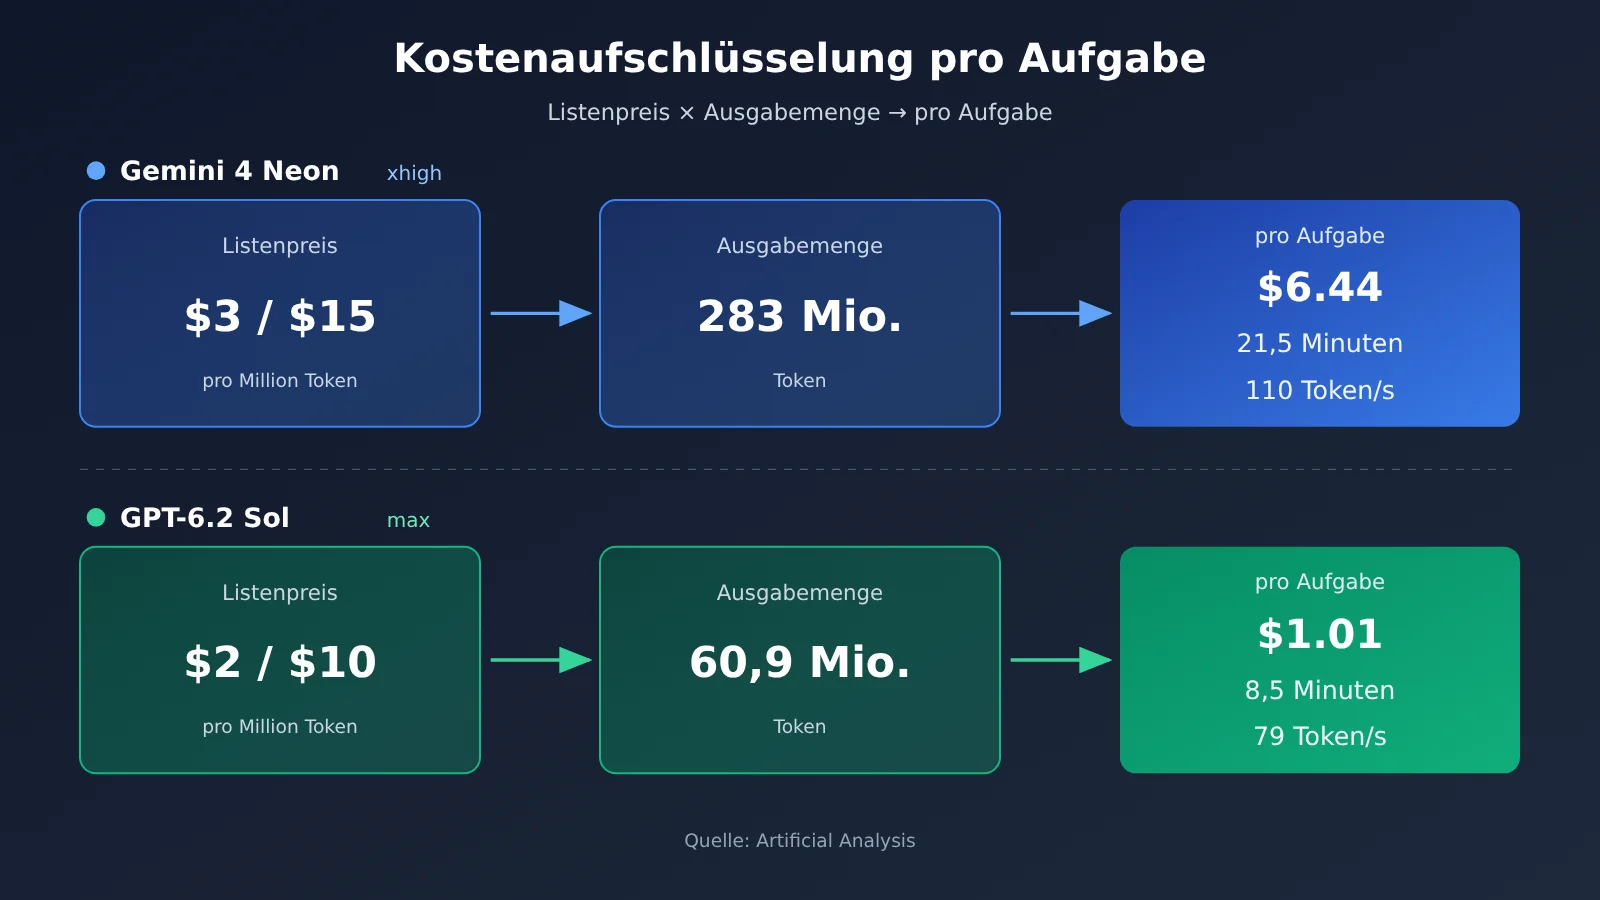
Bei der Laufzeit verhält es sich ähnlich. Neon xhigh gibt mit etwa 110 Token/s schneller aus als Sol max mit 79 Token/s, produziert aber mehr Output; die Zeit pro Aufgabe liegt bei 21,5 Minuten gegenüber 8,5 Minuten. Die Zeit bis zum ersten Antwort-Token beträgt bei Neon xhigh 56,51 Sekunden und bei Sol max 75,06 Sekunden – hier ist Neon schneller.
Intelligenz-Scores und Zeit pro Aufgabe nach Stufe
Beide Modelle bieten mehrere Reasoning-Stufen; die folgende Tabelle stammt von der Modellseite von Artificial Analysis. Die Kosten pro Aufgabe sind nur für die höchste Stufe angegeben; bei den übrigen Stufen nennt die Seite Score, Zeit und Geschwindigkeit.
| Stufe | Neon Intelligenz-Score | Neon Zeit/Aufgabe | Neon Ausgabegeschwindigkeit | Sol Intelligenz-Score | Sol Zeit/Aufgabe | Sol Ausgabegeschwindigkeit |
|---|---|---|---|---|---|---|
| max | Nicht verfügbar | — | — | 57 | 8,5 Minuten | 79 Token/s |
| xhigh | 61 | 21,5 Minuten | 110 Token/s | 56 | 5,3 Minuten | 76 Token/s |
| high | 60 | 14,8 Minuten | 101 Token/s | 55 | 4,6 Minuten | 73 Token/s |
| medium | 55 | 8,3 Minuten | 101 Token/s | 53 | 3,2 Minuten | 70 Token/s |
| low | 44 | 3,7 Minuten | 97 Token/s | 41 | 1,5 Minuten | 65 Token/s |
Diese Tabelle lässt sich auf zwei Arten lesen. Vergleicht man die gleichnamigen Stufen, steht Neon auf high bei 60 Punkten gegenüber 55 Punkten bei Sol, bei einer Zeit von 14,8 Minuten gegenüber 4,6 Minuten. Vergleicht man die Zeiten, liegen Neon medium mit 8,3 Minuten und Sol max mit 8,5 Minuten nahe beieinander; die Scores lauten 55 zu 57. Die Standardstufe von Neon ist high (so steht es sowohl im Entwicklerhandbuch als auch auf der aktuellen Modellseite in AI Studio) – und auf diese Zeile dürften auch viele Integrationen standardmäßig fallen. Für die letzten drei Neon-Stufen sind die Zeiten bis zum ersten Token zusätzlich in den FAQ der Modellseite vermerkt: high 40,64 Sekunden, medium 20,14 Sekunden, low 13,93 Sekunden. Diese Werte stehen nicht in derselben Spalte wie die Übersichtstabelle.
Gemini 4 Neon vs. GPT-6.2 Sol im Preisvergleich: offizielle Stückpreise und die APIYI-Regale
Bei den Stückpreisen gibt es zwei Ebenen: die Listenpreise auf den Seiten des Modellanbieters oder Dritter und den Regalpreis bei APIYI (apiyi.com).
| Position | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| Eingabepreis (pro Million Token) | 3,00 USD (offizielle Angabe / Preisseite von AI Studio) | 2,00 USD (Modellseite von Artificial Analysis) |
| Ausgabepreis (pro Million Token) | 15,00 USD, inkl. Thinking-Token | 10,00 USD |
| Caching | 0,15 USD, nur implizites Caching | 95 % Cache-Rabatt (Modellseite von Artificial Analysis) |
| Kostenlose Stufe | keine (Preisseite von AI Studio) | in den Quellen nicht erwähnt |
| APIYI-Modell-ID | derzeit nicht gelistet | gpt-6.2-sol |
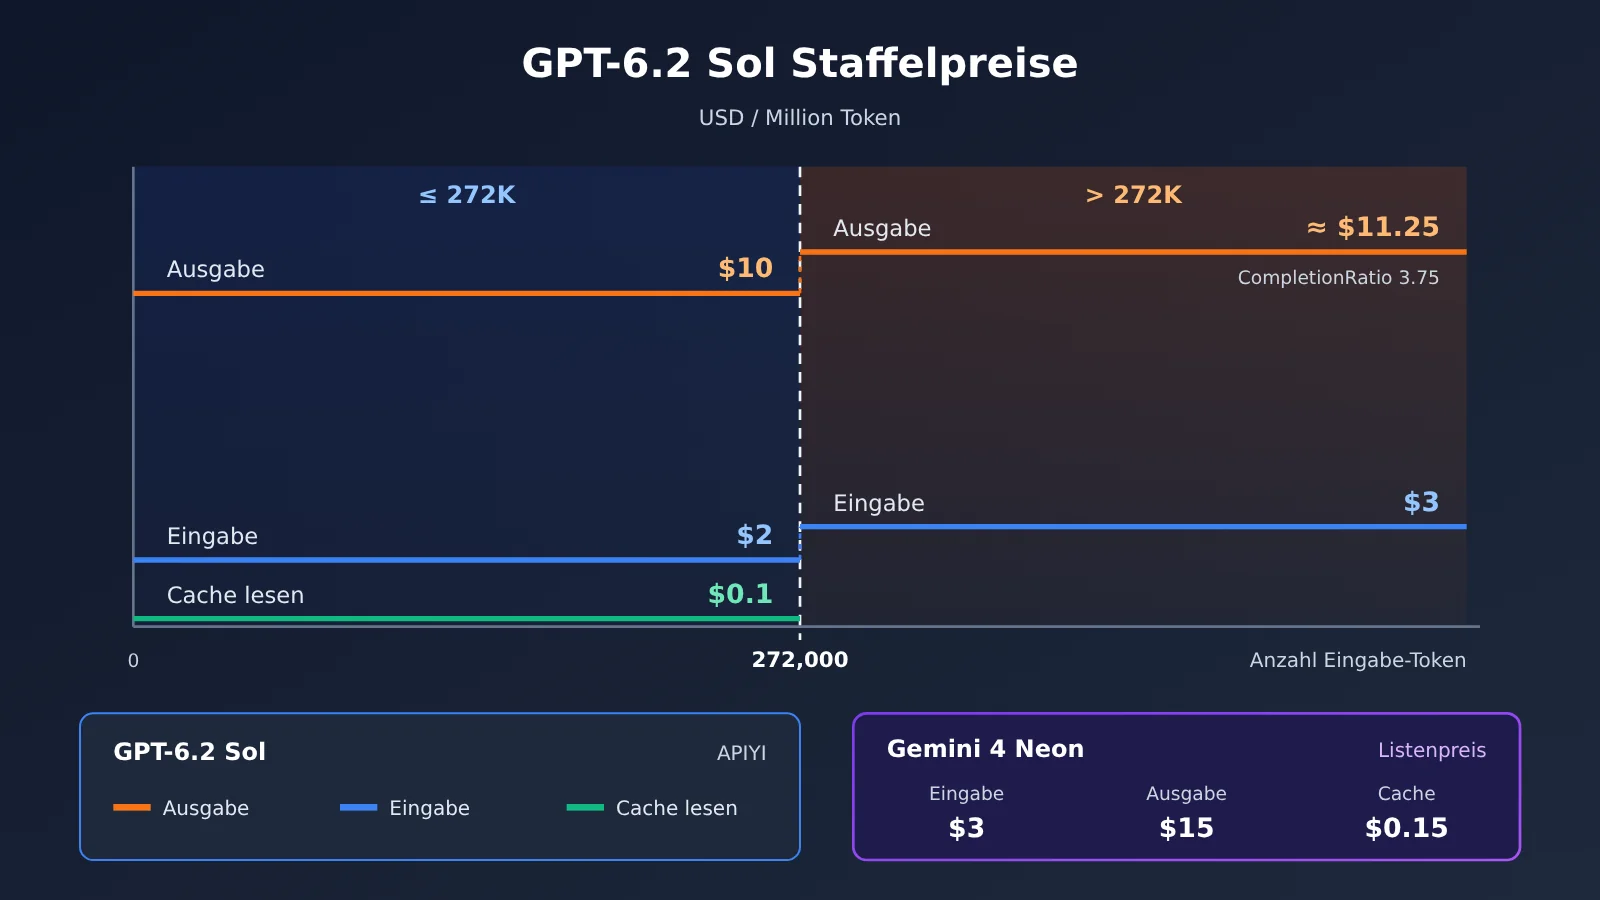
| APIYI, erste Stufe (0 bis 272.000 Eingabe-Token) | — | Eingabe 2 / Cache-Read 0,1 / Ausgabe 10 USD |
| APIYI, höhere Stufe (über 272.000 Eingabe-Token) | — | Eingabe 3 USD; Ausgabe laut Preisschnittstelle ca. 11,25 USD |
| APIYI-Endpunkt | — | responses (empfohlen), chat |
| Verfügbare Plattformen | offizielle Kanäle wie die Gemini API in Google AI Studio | APIYI apiyi.com u. a. |
gemini-4-neon ist weder in der APIYI-Übersichtstabelle noch in der Preisschnittstelle enthalten und derzeit nicht gelistet. Wir nehmen das Modell so schnell wie möglich auf; maßgeblich sind die Modellbezeichnungen und Preise in der Modellliste der Plattform.
Die Stufenwechsel bei gpt-6.2-sol auf APIYI im Detail
In der APIYI-Übersichtstabelle (laut Seitenangabe aktualisiert am 2026-11-16 um 09:39, UTC+8) stehen für gpt-6.2-sol in der ersten Stufe: Eingabe 2 USD, Cache-Read 0,1 USD, Ausgabe 10 USD – passend zu den Listenpreisen 2/10 auf der Modellseite von Artificial Analysis. Für Eingaben über 272.000 Token nennt der Text der Übersichtstabelle nur, dass die Eingabe von 2 auf 3 USD springt.
Die am 2026-11-19 abgefragte Preisschnittstelle (Version shell-api-modelmak-v1, insgesamt 285 Modelle) liefert vollständigere Angaben. Ein model_ratio von 1 entspricht dort 2 USD pro Million Eingabe-Token, ein completion_ratio von 5 bedeutet, dass die Ausgabe das Fünffache der Eingabe kostet. Oberhalb von 272.000 Token wechselt die CompletionRatio von 5 auf 3,75 – bei 3 USD für die Eingabe ergibt das rund 11,25 USD pro Million Ausgabe-Token, nicht weiter 10 USD.
Die Gruppennamen sind an beiden Stellen leicht unterschiedlich geschrieben: In der Übersichtstabelle stehen CodexResponses, Codex_Reverse, Default und SVIP, in der Preisschnittstelle CodexResponses, CodexReverse, default und svip. Und noch einmal betont: Die 1,01 USD bei Artificial Analysis sind die auf eine Aufgabe umgelegten Kosten des Benchmark-Laufs – nicht dasselbe wie die Token-Kosten, die ein einzelner Aufruf auf der Plattform tatsächlich verursacht.
Szenario-Vergleich: Gemini 4 Neon und GPT-6.2 Sol
Im Folgenden finden Sie die jeweils relevantesten Zahlen nach Aufgabentyp sortiert – damit lässt sich die Evaluierung mit der eigenen Workload abgleichen. Welches Modell besser passt, hängt von Ihrer Aufgabenverteilung und Ihrem Budget ab; hier geht es nur um den Vergleich, nicht um ein abschließendes Urteil.
Zahlen rund um Coding-Agenten
- Betrieb in Google Antigravity: Schauen Sie auf die Zeile SWE-sweep (Hersteller-Harness): Neon 39,0 %, Sol 8,3 % – und beachten Sie dabei, dass Google selbst diesen Unterschied dem Harness zuschreibt.
- Betrieb in einem generischen Harness: Zeile mini-SWE: 12,8 % gegenüber 11,6 %, dazu Terminal-bench 4.1 mit 65,2 % gegenüber 61,5 %.
- Häufige kleine Änderungen: Hier zählt die Zeit pro Aufgabe stärker; vergleichen Sie die Laufzeiten im gleichen Punktbereich in der Stufentabelle.
Zahlen rund um Diagramme und lange Dokumente
- Fragen zu Finanzbericht-Diagrammen und Dashboard-Screenshots: Bei Chartography liegt Sol bei 75,1 %, Neon bei 73,5 % – dieser Punkt läuft dem Gesamtergebnis entgegen.
- Graphstruktur- oder Dokument-Traversierung im Bereich von Hunderttausenden Token: GraphWalks: Neon 95,2 %, Sol 80,1 % – und rechnen Sie den Tarifsprung mit ein, den Sol bei APIYI oberhalb von 272000 Token macht.
- Langvideo-Verständnis: LVBench: Neon 89,0 %, Sol 87,6 %, und in der Model Card steht ausdrücklich, dass Neon Videoeingaben unterstützt.
Gemini 4 Neon und GPT-6.2 Sol: Entscheidungsempfehlung – erst prüfen, dann auswählen
Vor der Auswahl sollten Sie Ihre eigene Situation in der folgenden Reihenfolge prüfen, statt direkt mit 61 zu 57 die Entscheidung zu treffen.
- Zählen Sie, welchen Anteil Coding, Diagramme und langer Kontext in Ihren Aufgaben jeweils ausmachen, und gleichen Sie das dann mit den drei Aufschlüsselungstabellen oben ab.
- Schätzen Sie die durchschnittliche Ausgabemenge pro Aufgabe. Die Daten von Artificial Analysis zeigen: Der Kostenunterschied pro Aufgabe zwischen beiden Modellen resultiert hauptsächlich aus der Ausgabemenge – je länger Ihre Ausgaben, desto deutlicher wird dieser Unterschied.
- Prüfen Sie, ob die Eingabelänge 272000 Token überschreitet. Danach ändern sich bei
gpt-6.2-solin APIYI sowohl der Input- als auch der Output-Preis. - Bestätigen Sie die Denkstufe. Neon unterstützt nur die vier Stufen low, medium, high und xhigh; die Übergabe von
thinking_budgetoderMINIMALliefert HTTP400(Entwicklerhandbuch). - Führen Sie auf Ihrem eigenen Sample-Set einen kleinen Vergleichslauf durch und protokollieren Sie Punktzahl, Laufzeit und Token-Verbrauch.
💡 Auswahlhinweis: Die beiden Modelle schneiden in den einzelnen Kategorien unterschiedlich ab; letztlich hängt alles von Ihrer Aufgabenverteilung und Ihrem Budget ab. Empfehlung: Nehmen Sie zuerst über APIYI apiyi.com das bereits verfügbare
gpt-6.2-solin Betrieb und protokollieren Sie Token-Verbrauch und Laufzeit auf Ihren eigenen Samples. Sobald Neon verfügbar ist, führen Sie mit demselben Skript den Vergleichslauf durch.
So rufen Sie GPT-6.2 Sol schnell über APIYI auf
APIYI empfiehlt für gpt-6.2-sol den Endpunkt responses; die OpenAI-kompatible base_url ist https://api.apiyi.com/v1. Die gesamte Anbindung umfasst nur vier Schritte:
- Schlüssel vorbereiten: Erzeugen Sie in der Plattformkonsole einen API-Schlüssel, hinterlegen Sie ihn in der Umgebungsvariable
APIYI_API_KEY, und lesen Sie ihn im Code ausschließlich aus der Umgebungsvariable – niemals im Klartext. - Anfrageadresse festlegen: Der Responses-Endpunkt ist
POST https://api.apiyi.com/v1/responses; die Anfrage-Header enthaltenAuthorization: Bearer $APIYI_API_KEYundContent-Type: application/json. - Anfrage-Body zusammenstellen: Der minimale Anfrage-Body lautet
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}. - Mit dem OpenAI SDK aufrufen: Initialisieren Sie
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"])und rufen Sie dannclient.responses.create(model="gpt-6.2-sol", input=...)auf; das Ergebnis lesen Sie ausoutput_textdes zurückgegebenen Objekts.
Wenn Ihr bestehender Code auf Chat Completions basiert, können Sie dieselbe Modell-ID auch an den chat-Endpunkt senden; der Pfad lautet /v1/chat/completions. Das native Gemini-Protokoll läuft über https://api.apiyi.com mit der Version v1beta und eignet sich für die Gemini-Modelle, die auf der Plattform bereits gelistet sind.
Bei Tests mit langem Kontext empfiehlt es sich, in den Logs auch die Anzahl der Eingabe-Tokens jeder Anfrage zu protokollieren, damit Sie leichter erkennen, ob die Schwelle von 272000 überschritten wird. Die konkreten Werte für den Parameter der Denkstufe entnehmen Sie der offiziellen OpenAI-Dokumentation und der Modellseite der Plattform.
🚀 Schnellstart: Neue Nutzer können auf APIYI (apiyi.com) ein kostenloses Testguthaben erhalten und mit einem einzigen Schlüssel gleichzeitig OpenAI-, Claude-, Gemini- und andere bereits gelistete Modelle aufrufen. Bringen Sie zuerst die Responses-Anbindung für
gpt-6.2-solzum Laufen; für einen späteren Modellwechsel müssen Sie nur das Feldmodeländern.
Häufig gestellte Fragen (FAQ)
F1: Wie sind Gemini 4 Neon und GPT-6.2 Sol jeweils positioniert?
Neon ist eine Weiterentwicklung von Gemini 4 Carbon (siehe Modellkarte). Googles Entwicklerleitfaden ordnet es zwischen Hydrogen (schneller Alltagszyklus) und Carbon (komplexe Langstreckenaufgaben) ein. GPT-6.2 Sol ist auf der Modellseite von Artificial Analysis mit 2/10 USD bepreist; die höchste Stufe max erreicht einen Intelligenzwert von 57.
F2: Wo zeigen sich die 4 Punkte, die Neon gegenüber Sol voraus hat?
Betrachtet man die Einzelwerte der Modellkarte, ist der Abstand beim langen Kontext in GraphWalks am größten (95,2 % gegenüber 80,1 %) sowie bei SWE-sweep unter dem herstellereigenen Harness (39,0 % gegenüber 8,3 %). Beim Diagramm-Benchmark Chartography liegt dagegen Sol vorn (75,1 % gegenüber 73,5 %).
F3: Wann erscheint Gemini 4 Neon und über welche Kanäle ist es verfügbar?
Laut Google-Blog ist der Veröffentlichungstermin der 2026-11-18. Dem Beitrag von Sundar Pichai zufolge startet es am selben Tag in der Gemini API von Google AI Studio, in Gemini for business, in Google Antigravity für die kostenpflichtigen Varianten Google AI Pro und Ultra sowie in der Gemini App für Pro und Ultra. Die Modell-ID lautet `gemini-4-neon`.
F4: Kann man die 1,01 US-Dollar pro Aufgabe bei Sol als Aufrufbudget ansetzen?
Diese Zahl sind die Kosten pro Aufgabe, die entstehen, wenn Artificial Analysis den kompletten Index durchläuft und auf jede Aufgabe umlegt. Sol max hat in diesem Test 60,9 Millionen Token ausgegeben. Deine tatsächlichen Kosten hängen von der Anzahl deiner Eingabe- und Ausgabe-Token und der Abrechnungsstufe ab. Am besten schätzt du sie selbst anhand der ersten Tarifstufe in der APIYI-Übersichtstabelle (2 / 0,1 / 10 USD) und beachtest den Stufenwechsel oberhalb von 272.000 Token.
F5: Wie rufe ich die beiden Modelle schnell über die API auf?
`gpt-6.2-sol` ist bereits bei APIYI gelistet. Registriere dich auf apiyi.com, hole dir dein Testguthaben, setze die base_url auf `https://api.apiyi.com/v1` und rufe den `responses`-Endpunkt auf. `gemini-4-neon` ist derzeit weder in der Übersichtstabelle noch in der Preis-API vorhanden und damit noch nicht gelistet. Wir bringen das Modell so bald wie möglich online; Modellbezeichnung und Preise richten sich nach der Modellliste der Plattform.
F6: Welche Einschränkungen haben diese Vergleichsdaten?
Im Wesentlichen gibt es drei Punkte:
– **Messgrundlage**: Die Sol-Werte in der Modellkarte sind laut Evaluierungsdokumentation vom Hersteller selbst gemeldet und stammen nicht aus einer Nachmessung am selben Tag.
– **Stufe**: Bei Artificial Analysis ist die höchste Stufe von Neon xhigh, bei Sol dagegen max – die Stufen sind also nicht vollständig vergleichbar.
– **Uneinheitliche Zahlen**: Der Coding Agent Index liegt im Google-Blog bei 58,6, im Artikel von Artificial Analysis bei 59; WebExploitBench v1.2 wird im Blog mit 51,26 % und in der Modellkarte mit 51,3 % angegeben. Hier wurden die Werte jeweils unverändert übernommen.
Gemini 4 Neon und GPT-6.2 Sol: Die wichtigsten Erkenntnisse
- Gesamtpunktzahl: Auf der Modellseite von Artificial Analysis erreicht Neon xhigh 61 Punkte, Sol max 57 Punkte.
- Coding: Auf der Modellkarte erzielt Terminal-bench 4.1 65,2 % gegenüber 61,5 %. Der Unterschied bei SWE-sweep muss je nach Harness betrachtet werden.
- Diagramme: Bei Chartography liegt Sol mit 75,1 % gegenüber 73,5 % vorn.
- Langkontext: Bei GraphWalks von 256k bis 1M liegt der F1 bei 95,2 % gegenüber 80,1 % – hier ist der Unterschied am größten.
- Kosten und Dauer: Pro Aufgabe 6,44 gegenüber 1,01 USD und 21,5 gegenüber 8,5 Minuten. Der Hauptgrund ist die um ein Mehrfaches höhere Ausgabemenge.
- Stückpreis: Neon 3/15 USD, Sol 2/10 USD. Bei APIYI springt
gpt-6.2-solnach mehr als 272.000 Eingabe-Tokens in die nächste Preisstufe.
Fazit
Die Unterschiede zwischen Gemini 4 Neon und GPT-6.2 Sol werden deutlich klarer, wenn man sie einzeln aufschlüsselt, statt nur die Gesamtpunktzahl zu betrachten:
- Coding: Neon liegt bei den Teilwerten, für die die Modellkarte Daten liefert, vorn. Unter demselben mini-SWE-Harness beträgt der Unterschied aber nur 1,2 Prozentpunkte.
- Diagramme: Bei Chartography liegt Sol vorn, bei LVBench leicht Neon.
- Langkontext: Bei GraphWalks liegt Neon um 15,1 Prozentpunkte vorn – das ist der deutlichste Unterschied der drei Punkte.
- Kosten: Der Stückpreis unterscheidet sich um den Faktor 1,5, die Kosten pro Aufgabe um etwa den Faktor 6,4. Die Vergrößerung dazwischen entsteht durch die Anzahl der Ausgabe-Tokens.
Welches Modell Sie wählen, hängt von der Verteilung Ihrer Aufgaben und der Ausgabelänge ab. Empfehlung: Binden Sie zuerst gpt-6.2-sol über APIYI apiyi.com ein, erfassen Sie an echten Stichproben Verbrauch und Dauer und ergänzen Sie den Vergleich mit Neon nach der Veröffentlichung über denselben Workflow.
📚 Referenzen
-
Google-Blog „Introducing Gemini 4 Neon“: offizielle Ankündigung und selbst berichtete Benchmarks
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Beschreibung: Gesamtleistung, Coding, Wissenschaft und Preispositionierung sind offiziell selbst angegeben
- Link:
-
DeepMind Gemini 4 Neon Modellkarte: Quelle der dreispaltigen Vergleichstabelle
- Link:
deepmind.google/models/model-cards/gemini-4-neon - Beschreibung: Einzeldaten zu Chartography, GraphWalks, SWE-sweep und weiteren Punkten
- Link:
-
Google Cloud Gemini 4 Neon Entwicklerleitfaden: Kontextfenster, Denkstufen und Cache-Regeln
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Beschreibung: einheitliches Limit von 1048576 Token, HTTP-400-Regel, Erläuterungen zum impliziten Caching
- Link:
-
Google AI Studio Preisseite: offizielle Stückpreise für Neon
- Link:
aistudio.google.com/docs/pricing - Beschreibung: Eingabe 3, Ausgabe 15, Cache 0.15 USD pro Million Token
- Link:
-
Artificial Analysis Modellseite: Daten zu Neon und Sol nach Preisstufen
- Link:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - Beschreibung: Intelligenz-Score, Kosten pro Aufgabe, Zeit, Ausgabegeschwindigkeit
- Link:
-
Artificial Analysis Artikel: Interpretation der Messungen durch Dritte zu Neon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Beschreibung: Daten wie der Coding Agent Index 59
- Link:
-
APIYI Übersichtstabelle und Preis-API: verfügbare Modelle und Staffelpreise
- Link:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Beschreibung: erste Stufe von
gpt-6.2-solund die Staffelregel beim Sprung auf 272000 Token
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Modelle und Integrationshinweise finden Sie im Dokumentationszentrum unter docs.apiyi.com