2026 年 11 月 19 日,Google 在 Gemini Interactions API 中以 Preview 形式推出 Tool Retrieval(工具检索)。Agent 可以先只看到工具的名称和简述,等真正需要调用时再把完整参数 Schema 载入上下文。它主要解决的是“工具越接越多、上下文被闲置工具定义占满”的问题。它最适合工具数量多、调用集中在少数高频工具、同时存在大量长尾工具的 Agent,并不是所有应用默认开启就能省钱。
您读完此文能了解到什么?
- Tool Retrieval 改变的到底是什么,以及“开发者仍要提交完整工具声明”和“模型不必提前读完整 Schema”为何同时成立
- 从工具注册到
function_call的完整执行链,以及服务端检索与客户端检索的分工 - 当前明确支持的 4 个模型 ID、标准价格,以及“没有单独功能费,但 Token 照常计费”的含义
- 官方两组方向相反的示意算例:什么时候能省,什么时候反而更贵
- 接入前需要注意的限制,以及如何判断自己的 Agent 是否值得采用
索引:后文先用一张概念表和影响速览帮你快速对齐背景。“客观事实”部分依次说明发布信息、工作机制、混合加载与远程 MCP、支持模型与成本、使用限制,全部以 Google 官方公告和开发文档为准。“分析判断”部分给出适用场景判断、迁移前的基线测量方法和几个常见疑问,其中带有判断或预测性质的内容会单独标明。
Gemini API Tool Retrieval 需要先知道的概念(To Know)
| 概念 | 简要解释 |
|---|---|
| Tool Retrieval | 先检索需要的工具,再把命中工具的完整参数定义加入模型上下文 |
| Interactions API | Gemini 面向 Agent 的接口,管理交互历史、工具执行步骤和模型输出,2026 年 6 月已正式可用 |
| 参数 Schema | 描述函数接受哪些参数、类型是什么、哪些必填的结构,通常用 JSON Schema 表达 |
| Function Calling | 模型生成函数名和参数,由应用执行函数,再把结果交回模型 |
tool_search |
声明工具检索机制的工具类型,模型通过它查找并载入工具定义 |
defer_loading |
服务端模式下的配置,把工具完整参数定义延迟到检索命中时再加载 |
short_description |
延迟工具的简短说明,供模型在初始目录中识别工具 |
| 远程 MCP | 通过 Model Context Protocol 连接应用外部、由第三方服务提供的工具 |
| 隐式缓存 | 平台自动复用相同的上下文前缀,命中部分按缓存输入费率计费 |
Gemini API Tool Retrieval 影响速览
- 正在给 Agent 接大量业务工具的开发者:可以不再自建工具检索器,就让模型按需读取几十甚至上百个工具的 Schema。不过仍需每次请求提交完整工具数组,并重新评估缓存与计费。迁移前建议先用现有 Function Calling 流程测出工具定义的实际占用,可借助 API易 apiyi.com 这类多模型统一接口快速跑出对照基线。
- 产品与成本负责人:没有单独的功能费,但每次服务端搜索会触发额外的模型推理。省不省钱取决于工具规模、上下文长度和搜索频次,需要用账单字段验证,不能只看宣传方向。
- 工具很少、调用稳定的应用:官方算例显示,小工具集叠加长上下文时,Token 总量反而会上升,继续直接加载是更稳的选择。
- 使用 Agent 框架的团队:这是模型 API 层的新能力,框架不一定立即适配。在框架层面的渐进加载问题上,不能默认已经被解决。
客观事实:Gemini API Tool Retrieval 发布了什么
Gemini API Tool Retrieval 的发布信息与背景
Google 官方博客于 2026 年 11 月 19 日发布了《Introducing Tool Retrieval in the Gemini API》,作者是 Gemini API 产品经理 Lucia Loher 和 Google DeepMind 研究科学家 Nora Kassner。功能目前处于 Preview 阶段,只能在 Interactions API 中使用,需要 v1beta 版本。旧的 generateContent 方法不支持。
工程侧的准备早于公告。11 月 18 日,Google 官方 Python SDK 发布 v3.6.0,更新记录写明加入了 Tool Retrieval 与函数结果相关的公共 Schema。同日,Go SDK v1.79.0 也包含相应更新。从时间线看,这次是在已经 GA 的 Interactions API 上补齐工具发现与按需装载能力,并不是推出一个新的 API 产品。
开发者的需求也有记录可查。2026 年 3 月 18 日,有开发者在 Python SDK 仓库提交 Issue #2185,请求支持 defer_loading 和 tool_search,理由是 Agent 接入 30 个以上工具后,完整 Schema 会造成上下文膨胀。Google 维护人员在 3 月 20 日回应,将其登记为功能请求。这些是需求反馈,不是性能测试。
用一句话概括 Tool Retrieval:工具可以先被发现,具体参数等到需要调用时再读取。
Tool Retrieval 如何改变工具 Schema 的加载方式
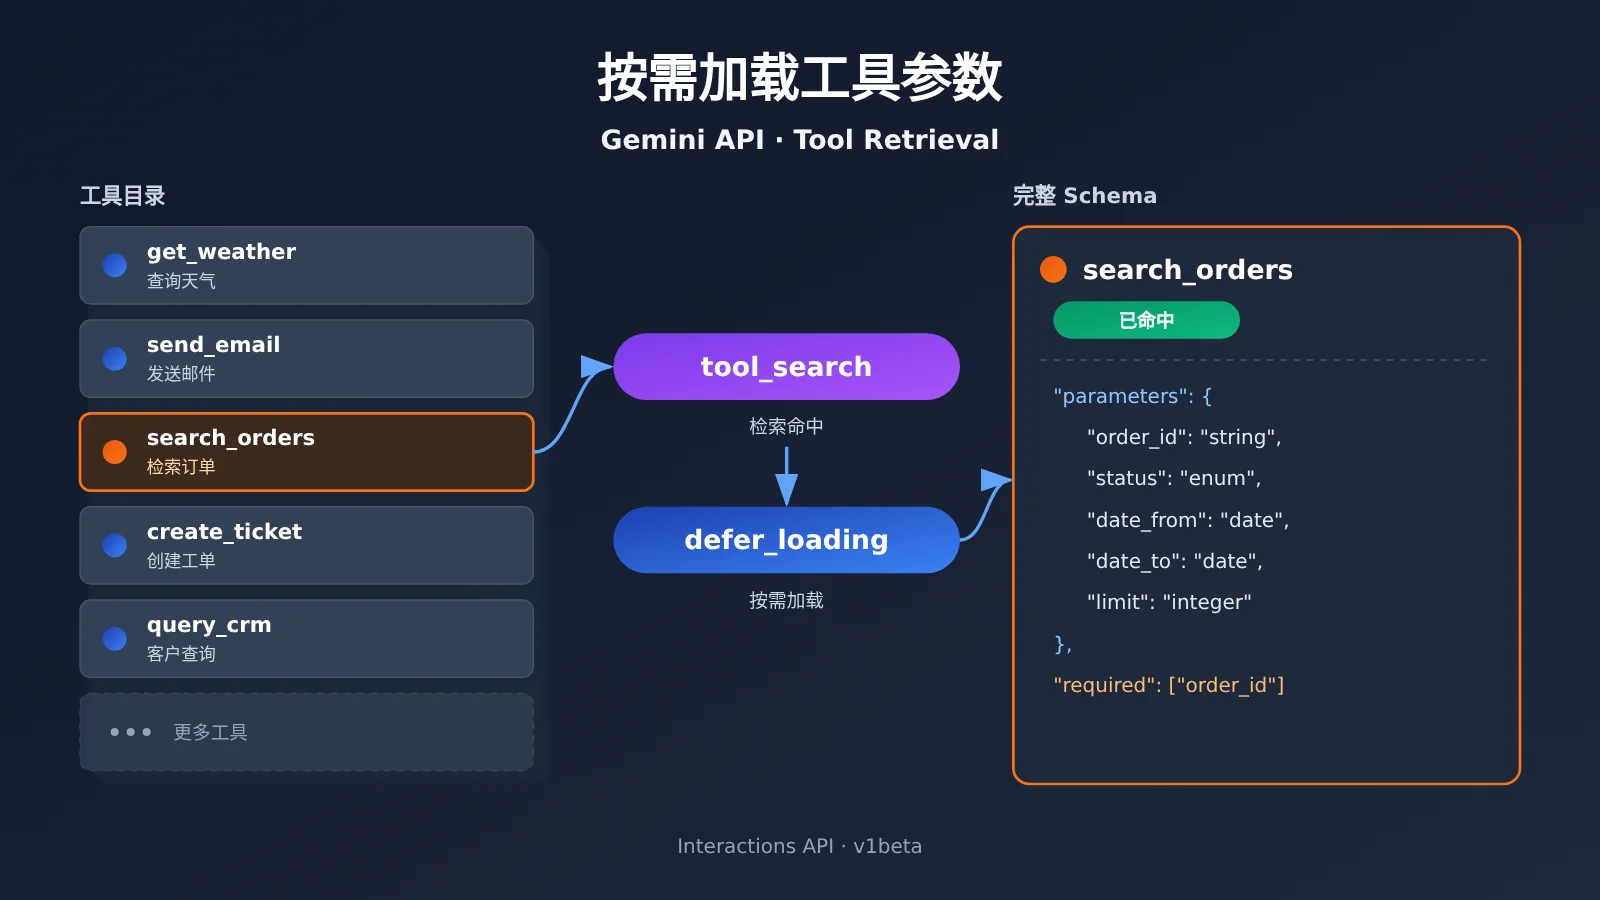
在传统静态加载下,即使用户只想办一笔退款,订单、物流、库存、CRM 等几十个工具的参数声明也会随每次推理一起进入上下文。Google 文档提到,几十个函数声明就可能占用数万个 Token。这会挤占对话历史的空间,相似工具一多,还可能干扰模型选对工具。
Tool Retrieval 的关键在于区分三个层面:
- API 请求层:开发者照常提交完整工具定义,包括参数 Schema。
- 模型初始上下文:标记为
defer_loading: true的工具只以名称加short_description的形式出现。如果没有配置简述,就取完整description的第一句。 - 工具调用阶段:工具被检索命中后,完整 Schema 才进入上下文,模型据此生成参数化的调用。
所以标题里“不再每次加载全部工具参数”,准确的含义是模型不再每轮提前读取所有完整参数,而不是开发者不用再发送完整声明。服务端模式下,官方要求每次请求都重新提交完整的 tools 数组,即使使用了 previous_interaction_id 也不例外。
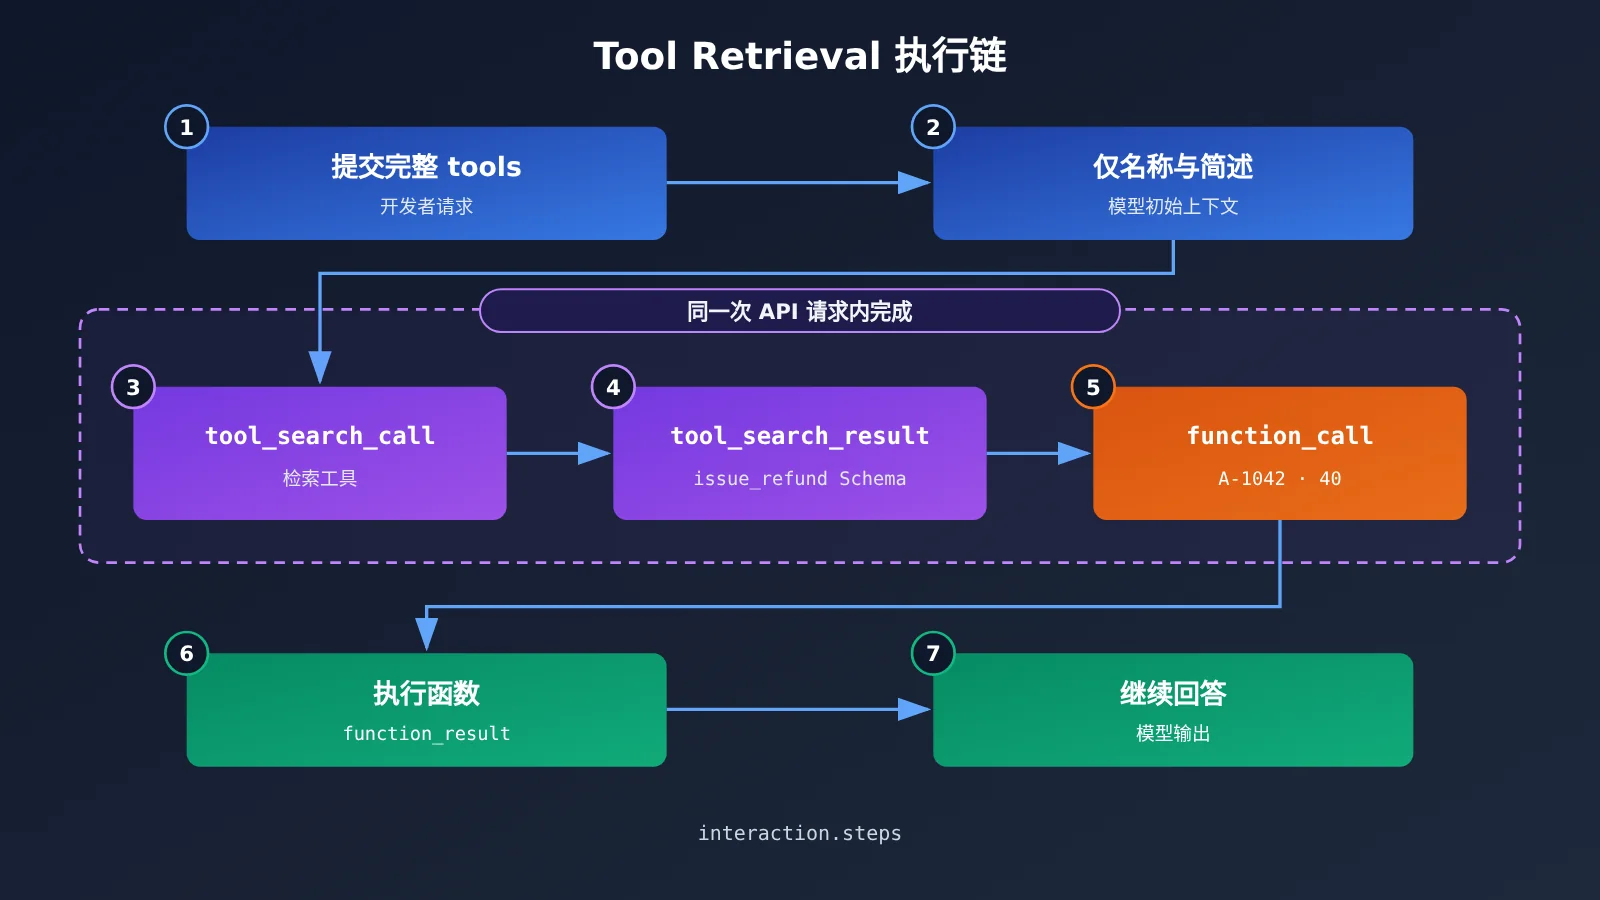
Tool Retrieval 的执行链:以官方退款案例为例
Google 公告用了一个订单退款场景:订单 A-1042 的商品到货时已损坏,用户要求退款 40 美元,需要用到的工具是 issue_refund。服务端检索的完整过程如下:
- 请求中声明
{"type": "tool_search"},并对issue_refund等低频工具设置defer_loading: true。 - 模型根据任务判断需要退款能力,发起
tool_search_call。 - API 返回
tool_search_result,其中包含issue_refund的完整参数 Schema。 - 模型读取参数定义,生成
function_call,参数为order_id: "A-1042"和amount: 40。 - 应用执行函数并回传
function_result,模型据此继续完成任务。
搜索、载入和生成函数调用可以在同一次外部 API 请求内完成,所有步骤都能在 interaction.steps 中查看。但要注意,同一次请求不等于内部只推理一次,每次服务端搜索都会引发额外的、需要计费的模型调用。另外,这是演示案例,不代表任何退款成功率统计。
下面是依据官方文档整理的示意代码,直连 Google 端点,仅用于展示请求结构:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
Function Calling 原有的职责分工没有变化。对于自定义函数,API 只返回 function_call,执行退款、访问数据库、处理权限仍是应用的工作。只有连接远程 MCP 服务器时,API 才会代为发起远程调用,并返回 mcp_server_tool_call 和 mcp_server_tool_result。
Tool Retrieval 的混合加载、远程 MCP 与两种检索模式
Google 推荐混合使用:高频工具直接加载,低频、专业化的长尾工具延迟加载。这样简单任务不必先搜索一轮,长尾能力也不会长期占用上下文。远程 MCP 服务器也可以整体设置延迟加载,例如对一个 type: "mcp_server" 的配置加上 defer_loading: true,该服务器暴露的工具就会按需载入,不必逐个声明。
除了由 Gemini 完成检索的服务端模式,官方还提供客户端模式:开发者声明一个 execution: "client" 的 tool_search,由自己的应用查询工具注册表,再把匹配的完整工具声明放进 function_result.result 返回给模型。两者的区别如下:
| 比较维度 | 服务端检索 | 客户端检索 |
|---|---|---|
| 执行位置 | Gemini API 服务端(默认 server) |
开发者应用(client) |
| 是否需要自建检索器 | 不需要 | 需要 |
| 是否需要提前声明工具库 | 需要 | 不需要,会话中可引入新工具 |
defer_loading |
适用 | 不适用 |
| 额外网络往返 | 无需额外客户端往返 | 每次搜索多一次往返 |
| 权限控制 | 由请求声明的工具集决定 | 可结合自建的用户级权限过滤 |
| 典型场景 | 大型、相对固定的工具集合 | 动态工具库、多租户、企业私有注册表 |
客户端模式返回的函数声明应当是结构化对象,不能转成 JSON 字符串。同一请求内不能混用两种模式,且最多只能声明一个 tool_search。
Gemini API Tool Retrieval 支持哪些模型、价格如何
Google 公告的表述比较宽泛,称 Gemini 3.6 及更新的模型均支持,包括所有 Gemini 4 模型。但开发文档截至 11 月 20 日明确列出的只有 4 个模型 ID。落地时应以开发文档为准,对不支持的模型设置 defer_loading 会返回 HTTP 400。
| 模型 ID | 标准输入价(美元/百万 Tokens) | 标准输出价(含 Thinking) | 备注 |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | 标有 Free Tier |
gemini-4-argon |
$2.00(12 月 1 日起 $4.00) | $10.00(12 月 1 日起 $20.00) | 无 Free Tier |
gemini-3.8-flash |
$0.75(2027 年 1 月 1 日起 $1.50) | $3.75(2027 年 1 月 1 日起 $7.50) | 标有 Free Tier |
gemini-3.6-flash |
$0.75(2027 年 1 月 1 日起 $1.50) | $3.75(2027 年 1 月 1 日起 $7.50) | 标有 Free Tier |
价格来自 Google Gemini Developer API 定价页的 Standard 档。Free Tier 的实际额度和速率限制需要按项目确认。
计费上,Google 明确表示 Tool Retrieval 没有独立的功能费,但这不等于搜索免费。延迟工具的简述列表、开启 tool_search 后增加的固定搜索指令、每次服务端检索的额外推理、载入的完整 Schema 以及它在后续轮次中的保留,都会按所选模型的费率计 Token。观察成本时要特别关注 total_tool_use_tokens 字段,它记录了服务端搜索引发的额外模型调用输入。只看首次输入 Token 下降,很容易高估节省效果。
Tool Retrieval 的官方 Token 示意算例
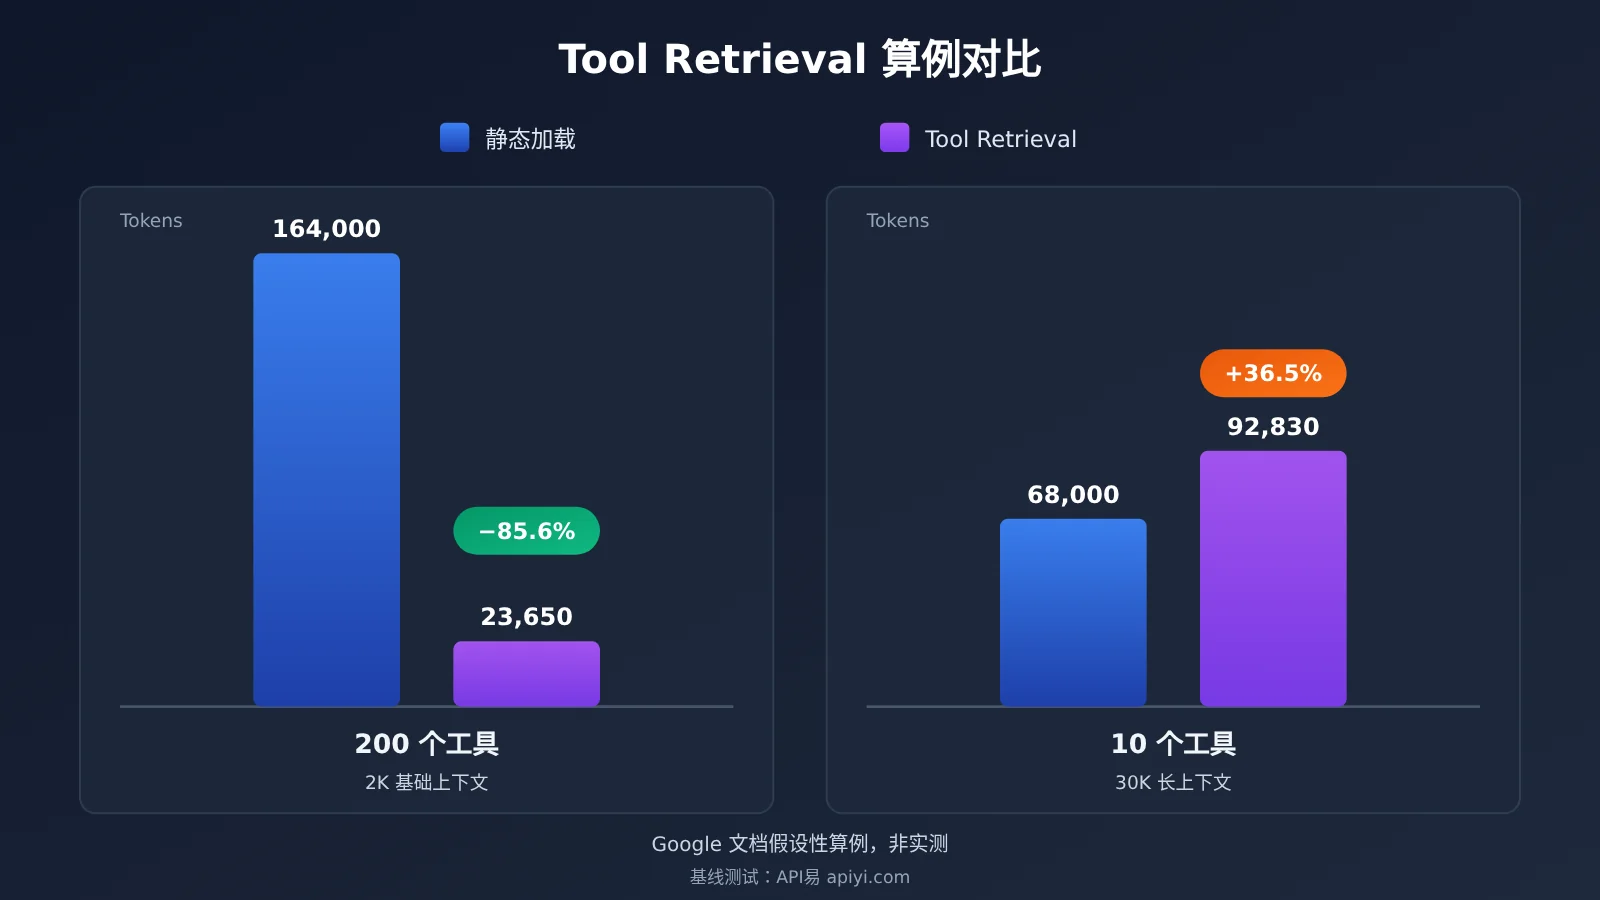
官方早期测试显示,每个延迟工具在初始目录中平均约占 26 Tokens。这是近似值,不是固定开销。文档还给出了两组假设性算例,结论方向相反:
| 场景(官方假设) | 静态加载全部工具 | Tool Retrieval | 变化 |
|---|---|---|---|
| 200 个工具,每个 400 Tokens,基础上下文 2,000,用到 2 个工具,共 2 次请求 | 164,000 | 约 23,650 | 减少约 85.6%(按算例推算) |
| 10 个工具,每个 400 Tokens,基础上下文 30,000,用到 2 个工具,共 2 次请求 | 68,000 | 92,830 | 增加约 36.5%(按算例推算) |
第二组算例变贵的原因是服务端搜索要额外推理一次,并重新处理已经很长的上下文,而 10 个工具本身占用不大,省下的 Schema 抵不过搜索开销。两组数字都是 Google 标明的假设性示例,没有计入输出 Token 和缓存收益,不是生产环境 Benchmark。截至资料核查日,Google 没有公布这项功能实测的 Token 节省比例、延迟改善或工具选择准确率提升。
缓存方面,Google 表示 Tool Retrieval 支持隐式缓存:完整 Schema 不出现在初始前缀中,系统指令和工具目录等前缀更容易保持稳定。但文档也提醒,延迟加载会让初始提示词变短,原本依赖大量 Schema 才能达到缓存最低门槛的请求,可能因此低于门槛。
Tool Retrieval 当前的使用限制
以下几点来自官方文档,在开发中最容易踩坑:
- 已加载工具无法卸载:Schema 一旦被检索,就会在当前会话中一直保留。在很长的会话里不断检索新工具,上下文仍会持续增长。
- 每次请求重新提交完整工具数组:包括
tool_search、全部延迟和非延迟工具、相关 MCP 配置。不能只交name和short_description而省略parameters。 - 系统指令直接点名的工具不要延迟:模型可能绕过搜索直接调用,导致缺少加载上下文而出错。
- 无状态会话要完整保留检索步骤:使用
store=false自行管理历史时,tool_search_call、tool_search_result及其signature不能删改,否则可能返回 HTTP 400。 - 调试要看 steps:即使
interaction.status不是requires_action,结果中也可能含有待执行的function_call。 - 未命中时可能返回文本:服务端搜索找不到匹配工具时,不一定返回结构化错误。
分析判断:Gemini API Tool Retrieval 对 Agent 开发意味着什么
Tool Retrieval 的适用场景判断
这次更新的实际价值,是把“维护一份完整工具清单”和“每轮推理都要读完这份清单”拆成两件事。工具库可以继续扩张,模型上下文里常驻的只是一份很薄的目录。对于持续接入新业务系统的团队,这能减轻预先裁剪工具集的负担,也减少为了控制 Token 而在应用侧每轮动态筛选工具、进而破坏缓存前缀的情况。
不过,官方算例已经说明收益是有条件的。结合官方工程建议,可以按下表初步判断(这是工程选择建议,不是硬性数量门槛):
| Agent 类型 | 工具特征 | 建议 |
|---|---|---|
| 客服、业务流程助手 | 几十个工具,少数查询类高频,退款、审批、合同等低频 | 高频直接加载,长尾用服务端检索 |
| 多 MCP 服务器的研发/运维 Agent | 每个服务器工具多,单次任务只用一小部分 | 对 MCP 服务器整体设置 defer_loading |
| 多租户、按权限开放工具的平台 | 工具集合因用户和工作区而变 | 客户端检索,结合自建注册表和权限过滤 |
| 小型助手 | 少于约 20 个稳定工具,多数每轮都会用到 | 继续静态加载 |
| 长上下文 + 频繁搜索 | 对话很长,每轮常需多次检索 | 先测再决定,存在净成本上升风险 |
我们的判断是:工具调用分布越“长尾”,Tool Retrieval 越值得用。反过来,如果大部分工具每轮都要用,延迟加载只会多出一次搜索推理。
迁移到 Tool Retrieval 前,先测出工具 Schema 的真实占用
是否迁移,最可靠的依据是自己业务的数据。迁移前可以先用现有的 OpenAI 兼容 Function Calling 流程,测量“全量工具”和“只带实际用到的工具”两种请求的输入 Token 差,得到工具 Schema 的真实占用。下面的脚本做的是这种基线测量,并不是 Tool Retrieval 本身:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口,用于测量静态加载基线
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
查看完整的基线测量脚本(按工具数量批量对比)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 API易 统一接口测量不同模型的工具 Schema 开销
)

def load_tools(path: str) -> list:
    """从业务工具注册表(JSON 文件)读取 OpenAI 格式的工具定义"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 技术建议:在评估 Tool Retrieval 之前,可以先通过 API易 apiyi.com 用一个 API Key 在多个主流模型上跑静态加载基线,看清工具 Schema 在你的请求里到底占了多少 Token。拿到基线后,再到 Gemini Interactions API 中开启
tool_search做对照,比较total_input_tokens与total_tool_use_tokens之和。
需要说明的是,Tool Retrieval 依赖 Interactions API 的 v1beta 接口和专用字段,上面的 OpenAI 兼容调用只用于测量静态加载的开销。对照测试时,建议保持模型、工具库、任务集、上下文长度和缓存条件一致,再比较总计费成本、端到端耗时、正确工具选择率和平均搜索次数,这样才能把差异归因到检索策略上。如果想在同一套脚本里横向看不同模型的基线差异,API易 apiyi.com 的统一接口能省去逐家接入的工作。
值得关注的后续发展(预测性判断)
以下属于判断,不是已确认的事实。
第一,公告与开发文档在支持模型范围上存在差异,Gemini 4 Carbon、Gemini 4 Neon 等型号是否会进入兼容名单,需要关注文档更新。第二,“已加载 Schema 无法卸载”是长会话 Agent 的明显短板,正式版是否提供卸载或淘汰机制,会直接影响它在长任务里的表现。第三,Google ADK 的用户此前在 Issue #7241 中反馈过渐进式加载与缓存失效的问题,模型 API 支持了新能力,不代表框架会自动采用,框架层的适配节奏值得跟进。
按需加载工具定义的思路在业内此前已有先例,Google 这次属于把它补进 Gemini 的 Agent 接口。由于 Preview 阶段接口可能变动,生产系统接入时建议保留回退到静态加载的开关。
关于 Gemini API Tool Retrieval 的几个常见疑问
Q1:开了 Tool Retrieval,请求体会变小吗?
不会。服务端模式下每次请求仍要提交完整工具数组,变小的是模型初始上下文里的工具占用。如果想先算清现有请求中工具定义的体量,可以用上文脚本通过 API易 apiyi.com 测出基线。
Q2:Google 官方说能省 85% 吗?
没有这样的实测结论。85.6% 是按 200 工具的假设性算例推算出来的,同一份文档还给出了小工具集下 Token 增加约 36.5% 的反例。
Q3:Tool Retrieval 收费吗?
没有单独的功能费,但搜索指令、额外推理和载入的 Schema 都按模型费率计 Token。预算敏感的团队可以先通过 API易 apiyi.com 按量计费地小规模测试不同模型的 Function Calling 开销,再决定 Agent 的模型选型。
Q4:用了 Tool Retrieval,是不是不用自己执行函数了?
不是。自定义函数仍由应用执行并回传结果,Tool Retrieval 只负责找到并载入工具定义。只有远程 MCP 工具会由 API 代为调用。
工具库会越来越大,但每一轮真正需要的往往只是其中几件。Tool Retrieval 把“备齐工具”和“随时取用”分开处理,用得好能让大型 Agent 更轻,用得不对也可能多付一轮推理的代价。正如《论语·卫灵公》所言:“工欲善其事,必先利其器。”先量清手里每件“器”的分量,再决定怎么摆放。
📚 参考资料
-
Google 官方公告:Introducing Tool Retrieval in the Gemini API(2026-11-19)
- 链接:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - 说明:发布信息、设计目标、两种检索模式与定价原则
- 链接:
-
Google Tool Retrieval 开发文档:配置、限制、计费与示意算例
- 链接:
aistudio.google.com/docs/tool-retrieval - 说明:支持模型列表、Usage 字段、最佳实践与常见错误
- 链接:
-
Gemini Developer API 定价:模型标准价格与缓存费率
- 链接:
aistudio.google.com/docs/pricing - 说明:各模型输入输出单价及生效日期
- 链接:
-
Interactions API 文档:接口定位与执行步骤
- 链接:
aistudio.google.com/docs/interactions-overview - 说明:有状态对话、steps 结构及与 generateContent 的区别
- 链接:
-
Google Python SDK v3.6.0 与 Issue #2185:工程佐证与开发者需求记录
- 链接:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - 链接:
github.com/googleapis/python-genai/issues/2185 - 说明:SDK 公共 Schema 更新与早期社区需求
- 链接:
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心