ملاحظة الكاتب: تقديرًا للحد الأدنى من متطلبات الأجهزة، والتكلفة الشهرية، وتكلفة كل وحدة من الرموز، ونقطة التعادل لنشر Kimi K3.1 Pro محليًا، استنادًا إلى بيانات اختبارات Kimi K3 المتاحة، لمساعدتك على تحديد متى تستأجر الأجهزة، ومتى تشتريها، ومتى تستخدم API مباشرة.
الخلاصة أولًا: من المتوقع أن يُنشر Kimi K3.1 Pro مفتوح المصدر قريبًا، لكن نشره محليًا ليس خيارًا مناسبًا للأفراد. أفادت الجهة المطوّرة بأن الأوزان الكاملة ستُنشر قبل 4 نوفمبر، وأن النموذج سيكون من فئة النماذج مفتوحة الأوزان ذات 3 تريليونات. وحتى 26 أكتوبر 2026، لم تُنشر أوزان K3.1 Pro بعد. جميع أرقام الأجهزة والذاكرة المستخدمة في هذا المقال مبنية على نتائج الاختبارات الفعلية لـ Kimi K3 المتاح؛ لذا يجب التحقق منها مجددًا بعد نشر الأوزان.
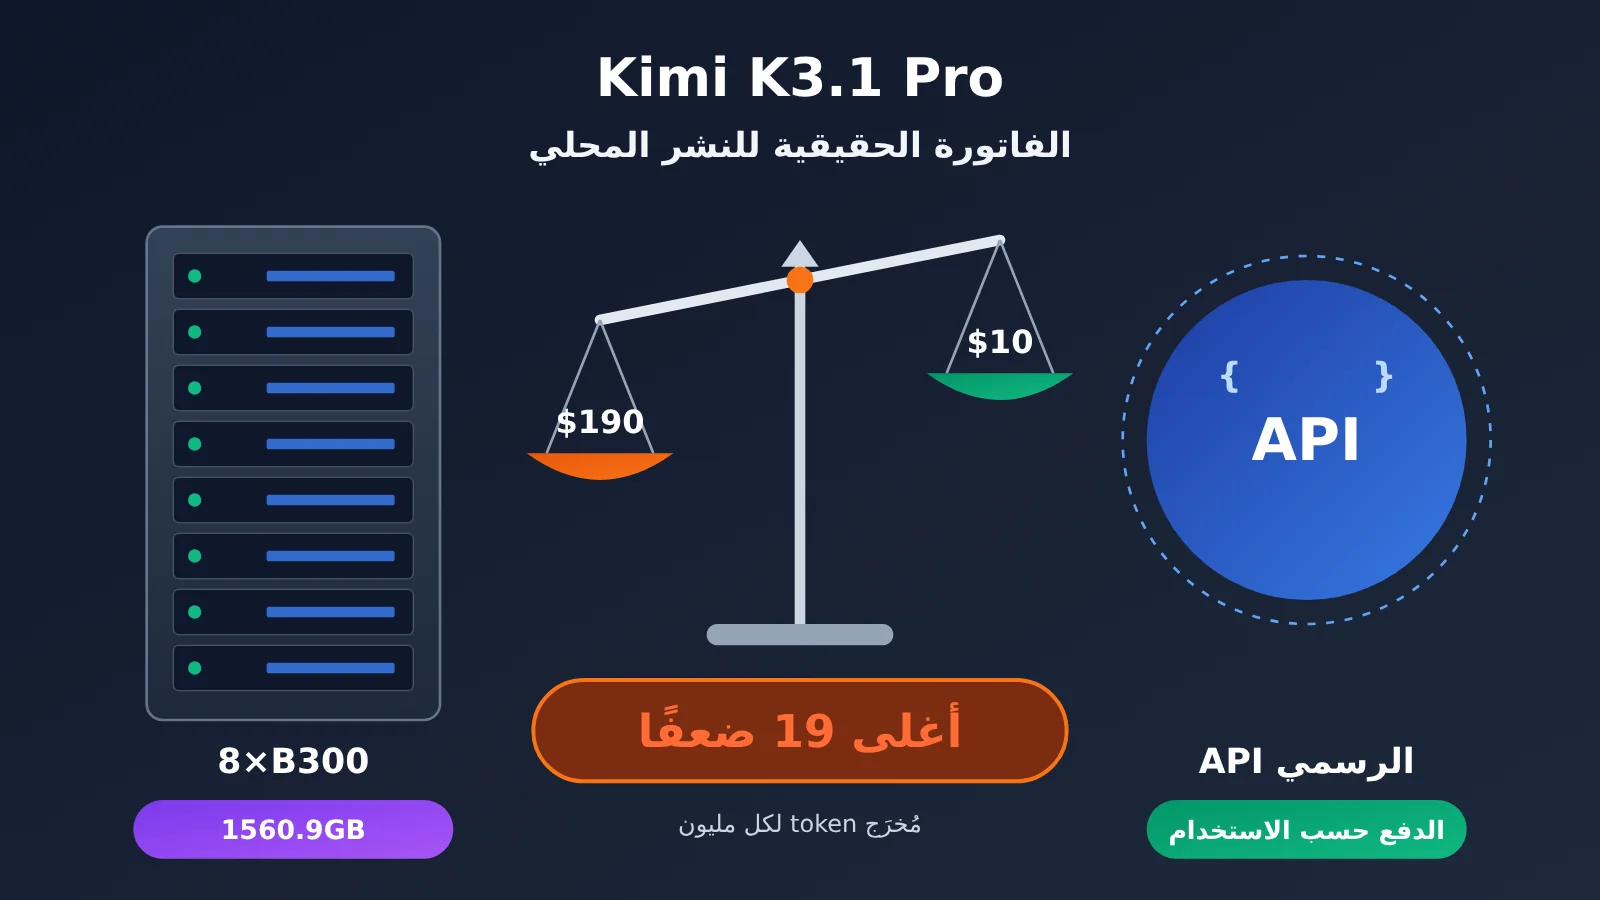
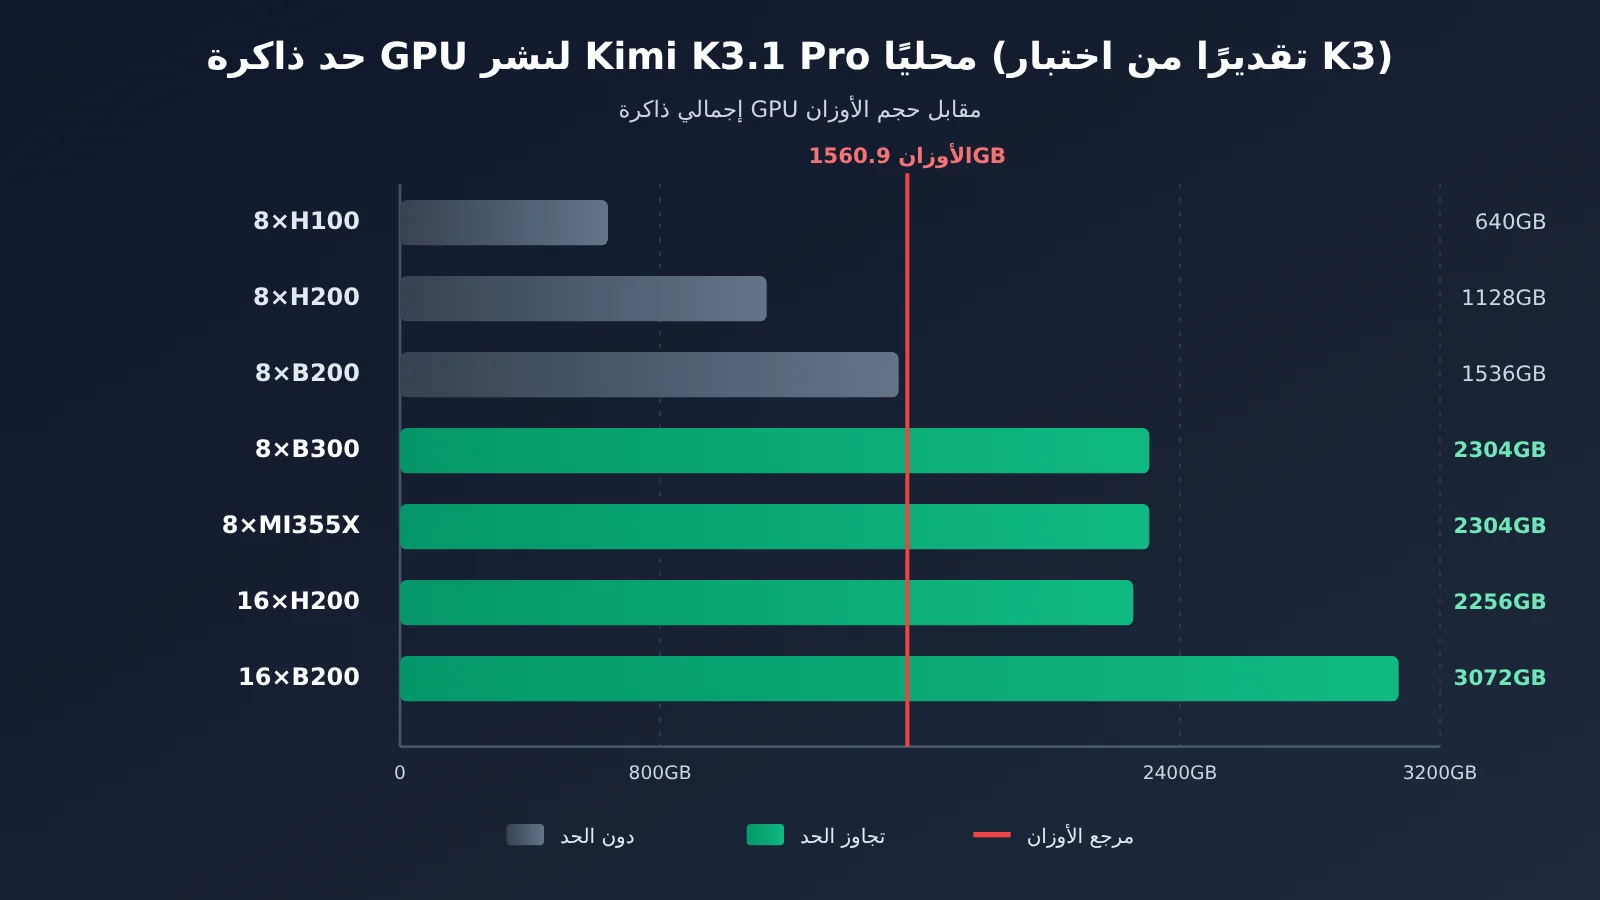
بحسب اختبارات K3، يبلغ حجم الأوزان وحدها 1560.9GB. وتتسع لها 8 بطاقات B300 بالكاد، بينما ينقص 8 بطاقات H200 نحو 400GB. وإذا خصصت خادمًا يضم 8 بطاقات B300 لاستخدامك وحدك، فستبلغ التكلفة نحو 190.00 دولارًا لكل مليون رمز مُخرَج، أي 19 ضعفًا تكلفة API الرسمية البالغة 10.00 دولارات.
هذا المقال ليس محاولة لثنيك عن الفكرة، بل هو دليل لاتخاذ قرار بشأن «إنشاء بنية ذاتية». وقد وُضّح بجانب كل رقم ما إذا كان مستندًا إلى مصدر رسمي، أو اختبار فعلي من جهة خارجية، أو تقدير وارد في هذا المقال، حتى تتمكن من تطبيق الحسابات مباشرة على حجم أعمالك.
الفائدة الأساسية: بعد قراءة المقال، ستتمكن من حساب التكلفة الفعلية لنشر Kimi K3.1 Pro بنفسك، واستخدام قائمة التحقق لتحديد ما إذا كان الأنسب لك استئجار الأجهزة أو شراؤها أو استدعاء API مباشرة.
النقاط الأساسية لنشر Kimi K3.1 Pro محليًا
| النقطة | الخلاصة | مستوى موثوقية المعلومة |
|---|---|---|
| حالة الأوزان | لم تُنشر بعد، وأفادت الشركة رسميًا بأنها ستُنشر قبل 4 نوفمبر | النص الرسمي |
| حجم الأوزان | تبلغ أوزان K3 حجم 1560.9GB، ويستمر K3.1 Pro في استخدام البنية نفسها | قياسات مستقلة فعلية (K3) |
| الحد الأدنى لجهاز واحد | 8×B300 / 8×GB300 / 8×MI355X | إعدادات أطر الاستدلال + قياسات فعلية |
| تكلفة الاستخدام الذاتي للوحدة | نحو $190.00 لكل مليون رمز مُخرَج | فاتورة قياس فعلية من جهة خارجية |
| شرط مجاراة واجهة API | إخراج مستقر يتجاوز 1,500 رمز/ثانية على المدى الطويل | تقديرات هذه المقالة |
توضيح مستويات موثوقية المعلومات حول النشر المحلي لـ Kimi K3.1 Pro
نقسم المعلومات في هذه المقالة إلى ثلاثة مستويات، لذا يُرجى التمييز بينها أثناء القراءة. تشير عبارة النص الرسمي إلى ما ورد على مدونة Moonshot في kimi.ai، ووثائق platform.kimi.ai، وبطاقة النموذج على Hugging Face. أما القياسات المستقلة الفعلية فتشير إلى بيانات الاختبارات المنشورة من مستخدمين مثل AWS وGPUStack وOpenZeka وModal؛ وسنذكر المصدر والتاريخ في المقالة. وتشير تقديرات هذه المقالة إلى النتائج التي حسبناها استنادًا إلى الأسعار ومعدلات الإخراج المنشورة، مع توضيح المعادلات والافتراضات؛ وهي لا تمثل بيانات رسمية.
وتستند التقديرات أيضًا إلى معلومات رسمية: فـ Kimi K3.1 Pro هو إصدار من Kimi K3 خضع للتدريب اللاحق (post-trained version of Kimi K3)، ويستمر في استخدام البنية نفسها، مع زيادة القدرة الحاسوبية المخصصة للتدريب اللاحق بالتعلم المعزز. لذلك يمكن الاستناد إلى عدد معلمات K3 وتنسيقات التكميم وحجم أوزانه بوصفها مراجع معقولة للحد الأدنى لمتطلبات نشر Kimi K3.1 Pro.
الحد الأدنى لمتطلبات العتاد لنشر Kimi K3.1 Pro محليًا: لماذا تحتاج إلى 8 بطاقات B300 على الأقل؟
【المعلومات الرسمية】تُظهر بطاقة نموذج K3 أن إجمالي عدد المعلمات يبلغ 2.8 تريليون، بينما يبلغ عدد المعلمات النشطة 104 مليارات، ويتألف النموذج من 93 طبقة. ويضم 896 خبيرًا موجّهًا، يختار النموذج منها 16 لكل رمز، إلى جانب خبيرين مشتركين. أما نافذة السياق فتبلغ 1,048,576 رمزًا. تستخدم الأوزان تنسيق MXFP4، وتستخدم التنشيطات MXFP8، وقد خضع النموذج للتدريب مع مراعاة التكميم منذ مرحلة SFT.
【قياسات مستقلة】أحصى أحدهم ملفات مستودع Hugging Face واحدًا تلو الآخر: بلغ الحجم الإجمالي لشرائح safetensors الـ96 نحو 1,560,936,091,448 بايت، أي قرابة 1560.9GB. ويتجاوز الحجم الفعلي القيمة النظرية «2.8T × 0.5 بايت = 1400GB»، لأن بعض المكونات الواردة في القائمة البيضاء ضمن config، مثل طبقات الانتباه والخبراء المشتركين وlm_head وبرج الرؤية، احتُفظ بها بدقة أعلى. ويقدّر إعداد vLLM الحد الأدنى للذاكرة المطلوبة بـ1680GB، وينص على ضرورة استخدام 8×GB300 على الأقل. أما تشغيل أحمال إنتاجية فعلية فيتطلب عدة عقد.
| التهيئة | إجمالي الذاكرة | هل يمكن تشغيل النموذج؟ | ملاحظات |
|---|---|---|---|
| 8×H100 80GB | 640GB | لا | حجم الأوزان يعادل 2.4 ضعف سعة الذاكرة |
| 32×H100 | 2.56TB | بصعوبة | يتوفر إعداد في SGLang، لكن معمارية Hopper لا تدعم MXFP4 أصليًا، لذا يلزم فك التكميم أثناء التشغيل |
| 8×H200 141GB | 1.13TB | لا | ينقصها نحو 400GB، وهي الفئة الأكثر إحباطًا |
| 16×H200 (جهازان) | 2.26TB | نعم | يلزم فك التكميم أيضًا |
| 8×B200 180GB | 1.44TB | لا | ينقصها نحو 120GB |
| 16×B200 / GB200 | 2.88TB | نعم | التهيئة المرجعية لمعمارية Blackwell |
| 8×B300 / GB300 | 2.30TB | نعم | المسار الافتراضي الرسمي؛ تتسع لها محطة واحدة بالكاد |
| 8×MI355X | 2.30TB | نعم | تحقق AMD في اليوم الأول |
| بطاقة واحدة / RTX 4090 / جهاز Mac بذاكرة 512GB | — | لا | تحتاج إلى 75 بطاقة RTX 4090 لتتسع للأوزان |
في المقابل، لا تشكّل ذاكرة KV cache عنق الزجاجة. ففي K3، تستخدم 24 طبقة فقط بنية Gated MLA، وتحتاج إلى نحو 27 KiB لكل رمز، بينما لا تحتاج طبقات KDA الـ69 المتبقية إلا إلى حالة ثابتة لكل تسلسل. وتشير حسابات مستقلة إلى أن ذاكرة KV لمستخدم واحد عند سياق بطول مليون رمز تبلغ نحو 29.5GB، وتنخفض إلى نحو 0.7GB عند سياق بطول 8K. ما يقيّدك فعليًا هو الأوزان نفسها، التي يبلغ حجمها 1.56TB.
إذا كنت لا تزال ترغب في النشر، فإليك المتطلبات الصارمة على مستوى الأطر، استنادًا إلى إعداد vLLM ودليل SGLang الخاص بـK3:
- صورة vLLM:
vllm/vllm-openai:kimi-k3، متاحة بإصدار CUDA 13 فقط، وتتطلب برنامج تشغيل r580 أو أحدث، وvLLM بإصدار 0.27.0 أو أحدث - استراتيجية التوازي: الحد الأدنى 8 بطاقات لـ TP / TEP، و16 بطاقة لـ DEP؛ ذاكرة KV المؤقتة الموزعة غير مدعومة على جميع الأجهزة المذكورة
- تخطيط عُقد SGLang: عقدة واحدة تضم 8 بطاقات لـ B300، وعقدتان تضم كل منهما 8 بطاقات لكل من B200 وH200
- وفقًا لما نقلته جهة خارجية عن إرشادات Moonshot في أغسطس 2026: يُنصح باستخدام عقدة فائقة تضم أكثر من 64 مُسرّعًا في بيئات الإنتاج
الفاتورة الفعلية لنشر Kimi K3.1 Pro محليًا: التكلفة الشهرية لأربعة خيارات
فيما يلي تقدير للتكلفة الشهرية لتشغيل خادم واحد مزوّد بـ 8 بطاقات B300 على مدار الساعة. اعتمدنا سعر صرف موحّدًا قدره 1 دولار = 7.25 يوان. تستند الأسعار إلى ثلاثة مصادر: عروض الدفع حسب الاستخدام التي جمعتها ComputeUnion في 24–25 أكتوبر 2026، وفاتورة فعلية لمستخدم Modal، ومحضر «دراسة قطاع تأجير القدرة الحاسوبية» الذي نقلته صحيفة سينا المالية في 20 مايو 2026.
⚠️ أسعار استئجار الخوادم الكاملة وشرائها داخل الصين (مثل نحو 80 ألف يوان شهريًا لخادم H200، و160–190 ألف يوان شهريًا لخادم B300 بعقد مدته خمس سنوات، و6.8–7 ملايين يوان لخادم B300 متاح فورًا) مستمدة من دراسة للقطاع، وليست عروض أسعار منشورة من الشركات المصنّعة؛ لذا تُستخدم للاسترشاد بالنطاق التقريبي فقط. تعتمد الخيارات الشائعة على خوادم كاملة بثماني بطاقات، وأقصر مدة للتعاقد سنة واحدة.
| الخيار | أساس الحساب | التكلفة الشهرية | ملاحظات |
|---|---|---|---|
| الاستئجار بالدفع حسب الاستخدام خارج الصين (على مدار الساعة) | 342–464 يوانًا في الساعة لخادم B300 كاملًا × 730 ساعة | نحو 249,800–338,700 يوان (34,500–46,700 دولار) | عرض سعر من جهة خارجية + تقدير هذه المقالة |
| فاتورة Modal الفعلية (على مدار الساعة) | 56.79 دولارًا في الساعة × 730 ساعة | 41,457.00 دولارًا، أي نحو 300,600 يوان | فاتورة فعلية لمستخدم لدى جهة خارجية |
| استئجار خادم كامل في الصين بعقد لخمس سنوات | وفقًا لدراسة القطاع | 160,000–190,000 يوان | سعر غير معلن؛ الحد الأدنى للعقد سنة واحدة |
| الشراء مع احتساب الكهرباء | استهلاك 6.8–7 ملايين يوان موزعًا على 3 سنوات، إضافة إلى نحو 8,800 يوان للكهرباء | نحو 198,000–203,000 يوان | لا يشمل أجور فريق التشغيل والصيانة أو قطع الغيار أو مساحة مركز البيانات أو النطاق الترددي |
| التشغيل 4 ساعات يوميًا ثم إيقاف الخادم | الدفع حسب الاستخدام خارج الصين | نحو 26,000–30,000 يوان | تستغرق إعادة التشغيل والتهيئة الباردة نحو 27 دقيقة في كل مرة |
تقدير فاتورة الكهرباء في هذه المقالة مبني على الافتراضات التالية: حمل قدره 13.2 كيلوواط، ومعامل كفاءة استخدام الطاقة (PUE) يساوي 1.3، وسعر كهرباء يبلغ 0.7 يوان لكل كيلوواط ساعة. وتبلغ التكلفة نحو 12 يوانًا في الساعة. يبدو خيار الشراء الأرخص، لكن الجدول لا يحتسب تكلفة مهندسي التشغيل والصيانة، وهي بالضبط أكبر النفقات الخفية على الفرق الصغيرة.
قد يبدو إيقاف الخادم بعد تشغيله 4 ساعات يوميًا وسيلة لتوفير المال، لكن تطبيق ذلك صعب عمليًا. ففي اختبار Modal، استغرقت التهيئة الباردة نحو 27 دقيقة، مع تحميل أوزان بحجم 1.56 تيرابايت، وتنفيذ الترجمة الفورية (JIT)، والتقاط 51 رسمًا بيانيًا لـ CUDA. وعند بدء المهام القصيرة، قد يفوق وقت الانتظار وقت الاستدلال نفسه.
التكلفة لكل وحدة في Kimi K3.1 Pro: معدل الإنتاجية يحدد كم مرة ستكون أغلى من API
الاشتراك الشهري ليس سوى الفاتورة الظاهرة؛ أما ما يحدد فعليًا إن كان الخيار مجديًا، فهو تكلفة كل مليون token. تقدير المقال يعتمد المعادلة التالية: تكلفة كل مليون token مُخرَج = تكلفة الجهاز في الساعة ÷ عدد token المُخرَجة في الساعة (بالملايين). وقد ثُبّتت قيمة البسط عند 56.79 دولارًا في الساعة، وفق قياسات Modal.
【قياسات مستقلة】فيما يلي بعض بيانات الإنتاجية على إعداد 8×B300:
- جهاز Modal واحد (TP8، بتنسيق MXFP4 الأصلي): معدل ثابت يبلغ 92 token/s، وزمن TTFT يتراوح بين 0.92 و1.02 ثانية
- OpenZeka (DGX B300، TP8، وvLLM): إنتاجية 105.7 token/s عند تزامن 1، و32.45 token/s لكل مستخدم عند تزامن 64. وتشير التقديرات إلى إمكانية دعم 150 مستخدمًا للدردشة أو 50 مستخدمًا لوكلاء الذكاء الاصطناعي
- عينة AWS الرسمية (29 يوليو 2026، p6-b300.48xlarge): 516 token/s عند تزامن 8، وإجمالي إنتاجية يبلغ 4,634 token/s عند التزامن العالي
- GPUStack (30 يوليو 2026): عند إدخال 64K وتزامن 10، استغرق التنفيذ من بدايته إلى نهايته 100.5 ثانية باستخدام vLLM؛ وبلغت إنتاجية المعالجة المسبقة المجمّعة نحو 19K–23K token/s
| إنتاجية الإخراج المستقرة | الإخراج في الساعة | تكلفة كل مليون token مُخرَج | المقارنة مع سعر API الرسمي البالغ 10.00 دولارات |
|---|---|---|---|
| 92 token/s (أقصى سرعة لطلب واحد) | 0.33M | 171.50 دولارًا (وفق حساب المؤلف الأصلي: 190.00 دولارًا) | أغلى بنحو 17–19 مرة |
| 500 token/s | 1.80M | 31.50 دولارًا | أغلى بنحو 3 مرات |
| 1,000 token/s | 3.60M | 15.80 دولارًا | أغلى بنحو 1.6 مرة |
| 1,500 token/s | 5.40M | 10.50 دولارات | متقاربة جدًا |
| 3,000 token/s | 10.80M | 5.30 دولارات | نحو نصف السعر |
| 4,634 token/s (ذروة قياس AWS) | 16.68M | 3.40 دولارات | نحو ثلث السعر |
إذا كنت مستخدمًا واحدًا أو مجموعة صغيرة، فستكون تكلفتك الفعلية أقرب إلى الصف الأول. فعندما لا يرتفع التزامن، يظل الجهاز معطّلًا معظم الوقت، وتبلغ تكلفة كل مليون token مُخرَج نحو 190 دولارًا. ومن هنا جاءت عبارة «أغلى 19 مرة» في العنوان. ولا تنخفض تكلفة الاستضافة الذاتية لتساوي تكلفة API إلا إذا استطاعت الخدمة الحفاظ على إنتاجية تتجاوز 1,500 token/s.
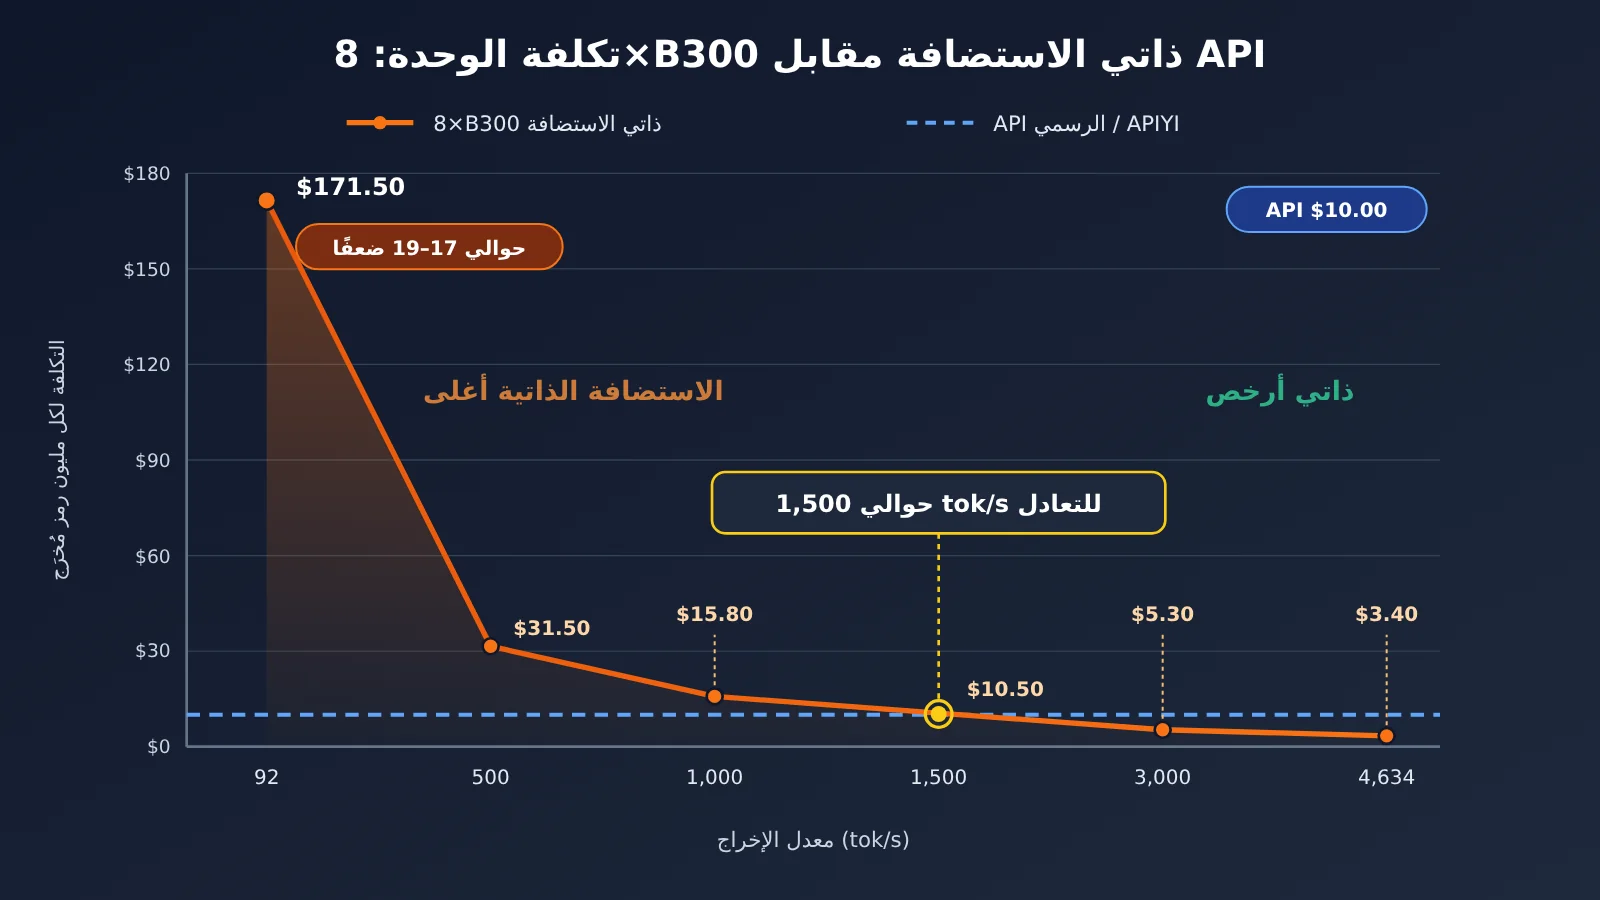
💡 ملاحظة للمقارنة: يعتمد الخط المرجعي لـ API في الرسم أعلاه على السعر الرسمي البالغ 10.00 دولارات لكل مليون token مُخرَج. وسعر الإخراج لنموذج kimi-k3.1-pro على APIYI apiyi.com مطابق للسعر الرسمي، لذا يمكن استخدامه للمقارنة مباشرةً.
نقطة التعادل لنشر Kimi K3.1 Pro محليًا: كم رمزًا تحتاج شهريًا؟
لننظر إلى الأمر من زاوية مختلفة: كم رمزًا تحتاج إلى استخدامه شهريًا حتى تتساوى كلفة الاستضافة الذاتية مع كلفة API؟ تستند تقديرات هذه المقالة إلى الافتراضات التالية: مقارنةً بسعر API الرسمي، البالغ 2.00 دولار للإدخال و10.00 دولارات للإخراج لكل مليون رمز، وبنسبة إدخال إلى إخراج قدرها 5:1، وهي نسبة شائعة في سيناريوهات الوكلاء، ومن دون احتساب إصابات التخزين المؤقت.
| مسار الاستضافة الذاتية | التكلفة الشهرية | رموز الإدخال المطلوبة شهريًا | رموز الإخراج المطلوبة شهريًا |
|---|---|---|---|
| استئجار حسب الاستخدام خارج البلاد على مدار الساعة | 41,457.00 دولارًا | نحو 10.4 مليارات | نحو 2.07 مليار |
| استئجار جهاز كامل داخل البلاد لمدة خمس سنوات | 190 ألف يوان | نحو 6.55 مليارات | نحو 1.31 مليار |
| شراء الجهاز (الاستهلاك + الكهرباء) | 203 آلاف يوان | نحو 6.98 مليارات | نحو 1.4 مليار |
ما حجم استهلاك أكثر من مليار رمز إخراج شهريًا؟ تقدّر OpenZeka أن جهازًا واحدًا مزودًا بـ 8×B300 قادر على دعم 50 مستخدمًا متزامنًا لوكلاء الذكاء الاصطناعي. أما فريق صغير لا يتجاوز عشرة أشخاص، فسيكون استهلاكه أقل بكثير من هذا المستوى.
وثمة عامل يسهل إغفاله: التخزين المؤقت. فسعر إصابة التخزين المؤقت الرسمي لا يتجاوز 0.20 دولار لكل مليون رمز، كما أن معدل إصابة التخزين المؤقت يكون عادةً مرتفعًا في سيناريوهات الوكلاء والمستندات الطويلة. وكلما ارتفعت نسبة الرموز التي تُستفاد فيها من التخزين المؤقت، انخفضت كلفة API، وارتفعت نقطة التعادل للاستضافة الذاتية أكثر.
متى يكون الاستضافة الذاتية لـ Kimi K3.1 Pro خيارًا مناسبًا؟
الاستضافة الذاتية ليست مستحيلة، لكنها تحتاج إلى مبرر واضح. في الحالات التالية، تكون خيارًا منطقيًا:
- إذا كان الامتثال أو التشغيل دون اتصال شرطًا أساسيًا: عندما لا يمكن إخراج البيانات من الشبكة الداخلية، أو يلزم عزلها ماديًا، فلن يكون استخدام API ممكنًا مهما انخفضت تكلفته. لكن API الرسمي يدعم الآن الاحتفاظ بالبيانات لمدة صفرية (ZDR)، لذا يُنصح أولًا بالتأكد مما إذا كان ذلك يفي بمتطلبات الامتثال لديك.
- إذا كنت تريد إجراء الضبط الدقيق والتقطير: عندما تريد إجراء تدريب لاحق متخصص على K3.1 Pro، أو تقطيره إلى نموذج صغير يتراوح حجمه بين 30B و120B، فستحتاج إلى الأوزان الكاملة.
- إذا كانت لديك بطاقات رسومية غير مستخدمة وفريق مختص بالتشغيل والصيانة: تكون التكلفة الإضافية منخفضة فقط إذا كانت لديك بالفعل بطاقات 8×B300 أو 8×MI355X أو جهازان H200 غير مستخدمين، إلى جانب مهندس متمرس في vLLM أو SGLang يتولى التشغيل والصيانة.
- إذا كان حجم أعمالك يبرر ذلك فعلًا: أي إذا كان بإمكانك الحفاظ على معدل يتجاوز 1,500 tok/s على المدى الطويل، وبلغ حجم الإخراج الشهري مستوى مليار رمز أو أكثر.
ينبغي أيضًا مراجعة الترخيص مسبقًا. يستخدم K3 ترخيص Kimi K3 License، وتشير ملخصات جهات خارجية إلى أن تقديم خدمات النموذج للغير بإيرادات سنوية تتجاوز 20 مليون دولار أمريكي يتطلب ترخيصًا منفصلًا. أما ترخيص K3.1 Pro، فينبغي الرجوع فيه إلى ملف LICENSE في مستودع Hugging Face بعد نشر الأوزان؛ ولا يمكن حاليًا الجزم به نيابةً عن الجهة الرسمية.
متى يجب ألّا تشغّل Kimi K3.1 Pro بنفسك؟
في الحالات التالية، من المرجح أن يكلّفك التشغيل الذاتي أكثر مما يوفره:
- إذا كان هدفك توفير المال: ما لم يتجاوز معدل المعالجة 1,500 tok/s باستمرار، فستكون تكلفة الوحدة أعلى من استخدام API. وفي الاستخدام الشخصي، قد تصل إلى نحو 19 ضعفًا.
- إذا أردت تشغيل مهام طويلة مع إيقاف التشغيل وتشغيله عند الحاجة: يستغرق بدء التشغيل البارد نحو 27 دقيقة، ما يجعل خطط التشغيل والإيقاف عند الحاجة غير عملية إلى حد كبير.
- إذا كنت ستستخدمه وحدك أو ضمن فريق صغير: لن تتمكن من استغلال التوازي المتاح بالكامل؛ أي أنك ستدفع 56.79 دولارًا في الساعة مقابل سرعة تبلغ 92 tok/s.
- إذا كنت تعوّل على التكميم لتشغيله على جهاز واحد: لا تصلح الحلول المتاحة من المجتمع للاستخدام الإنتاجي. فنسخة Unsloth ببت واحد (UD-IQ1_S، بحجم 594GB) تحقق نحو 9 tok/s على 8 بطاقات A100، ما يعادل 620.00 دولارًا لكل مليون رمز مُخرَج، أي 3.3 أضعاف تكلفة تشغيل النموذج كاملًا. كما تبلغ نسبة التطابق في اختيار النتيجة الأولى (top-1) بين نسخة 1-bit والنموذج الكامل نحو 79%. أما
kimi-k3-in-cفيشغّل الأوزان الكاملة باستخدام 8.24GB من الذاكرة، لكن سرعته لا تتجاوز 10–32 ثانية لكل رمز، لذا لا يعدو كونه عرضًا تقنيًا.
الشكل المحلي الذي يستحق الانتظار هو نسخة مُقطّرة يطرحها المجتمع لاحقًا. وحتى ذلك الحين، يظل استخدام API الخيار الأسهل للأفراد والفرق الصغيرة.
بدء سريع مع Kimi K3.1 Pro: اختبر سير العمل عبر API أولًا
قبل اتخاذ قرار الاستضافة الذاتية، ننصح بشدة باستخدام API لتشغيل أعمال حقيقية لمدة شهر، وقياس النسب الفعلية للمدخلات والمخرجات ومرات إصابة ذاكرة التخزين المؤقت، ثم العودة إلى جدول التعادل أعلاه وحساب التكاليف. أضافت APIYI apiyi.com نموذج kimi-k3.1-pro، وبالسعر الرسمي نفسه: $2.00 للإدخال / $10.00 للإخراج / $0.20 لقراءة البيانات المخزّنة مؤقتًا (بالدولار لكل مليون رمز). يُرجى الرجوع إلى قائمة النماذج في المنصة للتحقق من المعرّفات والأسعار.
نقاط مهمة للربط (واجهة متوافقة مع OpenAI):
- سجّل في APIYI apiyi.com وأنشئ مفتاح API؛ يحصل المستخدمون الجدد على رصيد مجاني للاختبار.
- اضبط
base_urlفي SDK علىhttps://api.apiyi.com/v1. - أدخل
kimi-k3.1-proمعرّفًا للنموذج؛ وإذا كانت السرعة أولوية، يمكنك استخدامkimi-k3.1-pro-highspeedبدلًا منه ($4.00 للإدخال / $20.00 للإخراج). - معامل قوة الاستدلال: يقبل
reasoning_effortالقيمlow/high/max، والقيمة الافتراضية لدى Kimi هيmax. أما إعدادات التقييم الرسمية فهيtemperature = 1.0وtop_p = 0.95. - في المحادثات متعددة الجولات وعند استدعاء الأدوات، أعد تمرير رسائل assistant التي تتضمن
reasoning_contentكما هي تمامًا، وإلا فقد يحدث خلل في السياق. - أعدّ سكربتًا للإحصاءات يسجّل يوميًا
prompt_tokensوcompletion_tokensوعدد مرات إصابة ذاكرة التخزين المؤقت، لتستند إليها عند اتخاذ قرار الاستضافة الذاتية مستقبلًا.
| النموذج | الإدخال | الإخراج | قراءة البيانات المخزّنة مؤقتًا | المنصات المتاحة |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | APIYI apiyi.com، وواجهة Kimi الرسمية |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | APIYI، وواجهة Kimi الرسمية |
| kimi-k3 | $3.00 | $15.00 | $0.30 | APIYI |
🚀 بدء سريع: إذا كان مشروعك لا يزال في مرحلة التحقق، فننصحك باستخدام APIYI apiyi.com لاختبار kimi-k3.1-pro وغيره من النماذج الرائدة بالمفتاح نفسه. تأكد أولًا من أن K3.1 Pro هو الخيار الأفضل لمهمتك، ثم ناقش ما إذا كانت الاستضافة الذاتية مناسبة.
الأسئلة الشائعة حول النشر المحلي لـ Kimi K3.1 Pro
س1: هل يمكن تنزيل أوزان Kimi K3.1 Pro الآن؟
ليس بعد. ورد في الإعلان الرسمي: «سيتم إصدار أوزان النموذج كاملة بحلول 4 نوفمبر»، أي قبل 4 نوفمبر 2026. جميع أرقام الأجهزة في هذا المقال تقديرية، وقد استُنتجت من K3 مفتوح المصدر. بعد إصدار الأوزان، يُرجى التحقق منها مجددًا بالاستناد إلى الحجم الفعلي للملفات.
س2: لماذا لا تكفي 8 بطاقات H200 لتشغيل Kimi K3.1 Pro؟
تبلغ ذاكرة الفيديو الإجمالية لـ 8 بطاقات H200 نحو 1.13 تيرابايت، بينما يبلغ الحجم الفعلي لأوزان K3 نحو 1560.9 غيغابايت، أي إن الفارق يقارب 400 غيغابايت. إضافة إلى ذلك، لا يدعم معمار Hopper تنسيق MXFP4 دعمًا أصليًا؛ وحتى عند استخدام جهازين، في كل منهما 16 بطاقة H200، ستظل هناك حاجة إلى إزالة التكميم أثناء التشغيل، ما يحدّ من السرعة.
س3: كيف حُسبت تكلفة «أعلى بـ19 مرة»؟
يستند هذا الرقم إلى قياس أجرته جهة خارجية: تبلغ تكلفة 8 بطاقات B300 على Modal نحو 56.79 دولارًا في الساعة، ويصل معدل التوليد المستقر لكل طلب إلى نحو 92 رمزًا في الثانية. وهذا يعادل نحو 190.00 دولارًا لكل مليون رمز إخراج. وبقسمة هذا الرقم على سعر الإخراج في واجهة API الرسمية، البالغ 10.00 دولارات، تكون التكلفة أعلى بـ19 مرة. وبالحساب الدقيق وفق معدل 92 رمزًا في الثانية، تبلغ التكلفة 171.50 دولارًا؛ لكن تقدير الكاتب الأصلي يشمل أيضًا فاقد الأداء أثناء التشغيل الفعلي.
س4: هل توجد طريقة لتوفير التكلفة على الفرق الصغيرة التي تريد استضافة Kimi K3.1 Pro بنفسها؟
في الغالب لا. فمسار شراء الأجهزة يتكلف نحو 200 ألف يوان شهريًا، من دون احتساب تكلفة الموظفين. كما أن ضغط النموذج ليتسع على جهاز واحد يزيد التكلفة ويقلل الجودة. الخيار العملي أكثر للفرق الصغيرة هو استخدام واجهة API بالدفع حسب الاستخدام، مثل استدعاء kimi-k3.1-pro عبر APIYI apiyi.com؛ فتدفع مقابل ما تستخدمه فقط، ولا تتجاوز تكلفة الرموز التي يُطابقها التخزين المؤقت 0.20 دولار لكل مليون رمز.
س5: كيف يمكن استدعاء Kimi K3.1 Pro بسرعة عبر API؟
سجّل في APIYI apiyi.com للحصول على مفتاح API، واضبط `base_url` على `https://api.apiyi.com/v1`، وحدد اسم النموذج `kimi-k3.1-pro`. لن تحتاج غالبًا إلى إجراء تغييرات تُذكر على الشفرة الحالية التي تستخدم حزمة OpenAI SDK. انتبه إلى ضرورة إعادة تمرير `reasoning_content` في المحادثات متعددة الجولات.
س6: ما القيود المعروفة للنشر المحلي لـ Kimi K3.1 Pro؟
هناك ثلاثة قيود رئيسية. أولًا، يستغرق بدء التشغيل البارد نحو 27 دقيقة، لذا فهو غير مناسب للتوسّع أو التقليص المرن. ثانيًا، تتوفر صورة vLLM بإصدار CUDA 13 فقط، ما يتطلب برنامج تشغيل بالإصدار r580 أو أحدث؛ لذلك تحتاج المجموعات الأقدم إلى الترقية أولًا. ثالثًا، لا يدعم أي من الأجهزة المذكورة ذاكرة KV المخبئية الموزعة، ما يحدّ من التوسّع عبر عدة أجهزة.
س7: متى يصبح النشر المحلي خيارًا عمليًا؟
سيصبح ذلك ممكنًا للأفراد والفرق الصغيرة عندما يطرح المجتمع نسخًا مقطّرة بحجم يتراوح بين 30 و120 مليار معلمة. أما النماذج الكاملة بحجم 3 تريليونات معلمة، فستظل في المستقبل القريب عبئًا يتطلب مستوى مراكز البيانات.
أهم النقاط حول النشر المحلي لـ Kimi K3.1 Pro
- الأوزان لم تُنشر بعد: تعهّد الفريق الرسمي بنشرها قبل 4 نوفمبر، أما الأرقام المتاحة حاليًا فجميعها تقديرات مبنية على K3.
- الحد الأدنى للأجهزة: يبلغ حجم الأوزان 1560.9GB، وتحتاج إلى 8 وحدات على الأقل من B300 أو GB300 أو MI355X على جهاز واحد.
- التكلفة الشهرية: تشغيل جهاز واحد على مدار الساعة طوال أيام الأسبوع يكلف نحو 160–340 ألف يوان شهريًا، بحسب الخيار.
- تكلفة الوحدة: تبلغ تكلفة الاستخدام الذاتي نحو 190.00 دولارًا لكل مليون رمز مُخرَج، أي 19 ضعف تكلفة واجهة API الرسمية.
- شروط الوصول إلى نقطة التعادل: تحقيق معدل نقل مستدام يتجاوز 1,500 رمز/ثانية، مع إخراج شهري يبلغ مستوى مليار رمز.
- طريقة البدء: استخدم APIYI على apiyi.com لاستدعاء kimi-k3.1-pro وتشغيل أعمال فعلية أولًا، ثم قرر بناءً على البيانات ما إذا كان النشر الذاتي مناسبًا.
قائمة تحقق لتحديد طريقة نشر Kimi K3.1 Pro
أجب عن الأسئلة الخمسة التالية لتعرف إن كان الأنسب لك استئجار الأجهزة أو شراؤها أو استخدام API:
- هل تمنع متطلبات الامتثال البيانات من مغادرة الشبكة الداخلية، ولا يفي ZDR الرسمي بالغرض؟ — لا، استخدم API مباشرة.
- هل تحتاج إلى استخدام الأوزان لإجراء الضبط الدقيق أو التقطير؟ — نعم، فكّر في استئجار الأجهزة لفترة قصيرة بحسب الاستخدام، ثم أوقفها بعد الانتهاء.
- هل يتجاوز عدد رموز الخرج شهريًا مليارًا و300 مليون باستمرار؟ — لا، سيكون النشر الذاتي أغلى من استخدام API حتمًا.
- هل لديك بالفعل أجهزة غير مستغلة من فئة 8×B300 أو MI355X، إلى جانب فريق متخصص للتشغيل والصيانة؟ — نعم، يمكنك التفكير في النشر الذاتي؛ وإلا فلا تشترِ أجهزة خصيصًا لهذا الغرض.
- هل يحتاج العمل إلى إيقاف الخدمة وتشغيلها وتوسيع نطاقها أو تقليصه عند الحاجة؟ — نعم، لن يصمد أمامك زمن بدء التشغيل البارد في النشر الذاتي، البالغ 27 دقيقة؛ اختر API.
الخلاصة
أهم ما ينبغي معرفته عن نشر Kimi K3.1 Pro محليًا:
- يتطلب تجهيزات ضخمة: يُقدَّر حجم الأوزان بنحو 1.56 تيرابايت استنادًا إلى K3، ولا تكفي إلا بالكاد 8 وحدات B300.
- مكلف للاستخدام الشخصي: تبلغ التكلفة على جهاز واحد نحو 190.00 دولارًا لكل مليون رمز إخراج، أي 19 ضعف تكلفة واجهة API.
- يصبح مجديًا عند التوسع فقط: لا يكون النشر الذاتي خيارًا مناسبًا إلا إذا تجاوزت الإنتاجية 1,500 رمز في الثانية باستمرار، وبلغ حجم الإخراج الشهري مليار رمز تقريبًا.
بالنسبة إلى معظم المطورين والفرق الصغيرة في الصين، الأفضل البدء باستخدام واجهة API لتشغيل الخدمة وجمع بيانات الاستخدام، ثم تقييم جدوى النشر الذاتي. نوصي باستدعاء kimi-k3.1-pro عبر APIYI apiyi.com؛ فالأسعار مطابقة للأسعار الرسمية، ويحصل المستخدمون الجدد على رصيد مجاني، كما يتيح مفتاح واحد مقارنة النموذج بسهولة مع نماذج رائدة أخرى.
📚 المراجع
- مدونة الإطلاق الرسمية لـ Kimi K3.1 Pro: موعد إتاحة الأوزان وموقع النموذج
- الرابط:
kimi.ai/blog/kimi-k3-1-pro -
ملاحظة: المقال الرسمي يؤكد أن الأوزان ستُتاح قبل 4 نوفمبر.
-
قائمة أسعار واجهة API الرسمية لـ Kimi: أسعار الإدخال والإخراج والتخزين المؤقت لـ K3.1 Pro
- الرابط:
platform.kimi.ai/docs/pricing/chat -
ملاحظة: مصدر الأسعار المرجعية لواجهة API في هذا المقال.
-
بطاقة نموذج Kimi K3: البنية والكمّ والترخيص
- الرابط:
huggingface.co/moonshotai/Kimi-K3 -
ملاحظة: 2.8 تريليون معلمة إجمالًا، وكمّ MXFP4، وترخيص Kimi K3.
-
وصفة vLLM لنموذج Kimi K3: الحد الأدنى لذاكرة GPU ومتطلبات النشر
- الرابط:
recipes.vllm.ai/moonshotai/Kimi-K3 -
ملاحظة: يتطلب النموذج 8 وحدات GB300 على الأقل، وبحد أدنى لذاكرة GPU يبلغ 1,680 غيغابايت.
-
اختبارات استدلال AWS على 8 وحدات B300: بيانات الإنتاجية
- الرابط:
github.com/aws-samples/sample-llm-inference-on-eks -
ملاحظة: بلغت الإنتاجية الإجمالية 4,634 رمزًا في الثانية عند التزامن العالي.
-
اختبارات GPUStack على 8 وحدات B300: مقارنة vLLM وSGLang مع سياقات طويلة
- الرابط:
cnblogs.com/gpustack/p/22073008 - ملاحظة: أزمنة التنفيذ من البداية إلى النهاية مع إدخال بطول 64K و200K.
الكاتب: فريق APIYI التقني
للتواصل التقني: نرحب بتواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI. ويمكنكم الاطلاع على مزيد من المعلومات حول ربط النماذج في مركز التوثيق docs.apiyi.com.