
ملخص: نقارن التوليفات المتاحة داخل الصين على ثلاثة مستويات: النماذج، ووكلاء البرمجة، وقنوات API. ثم نختار بأنفسنا خطة إعادة إنتاج مناسبة عبر مهام برمجة حقيقية، والتكلفة، والتوافق.
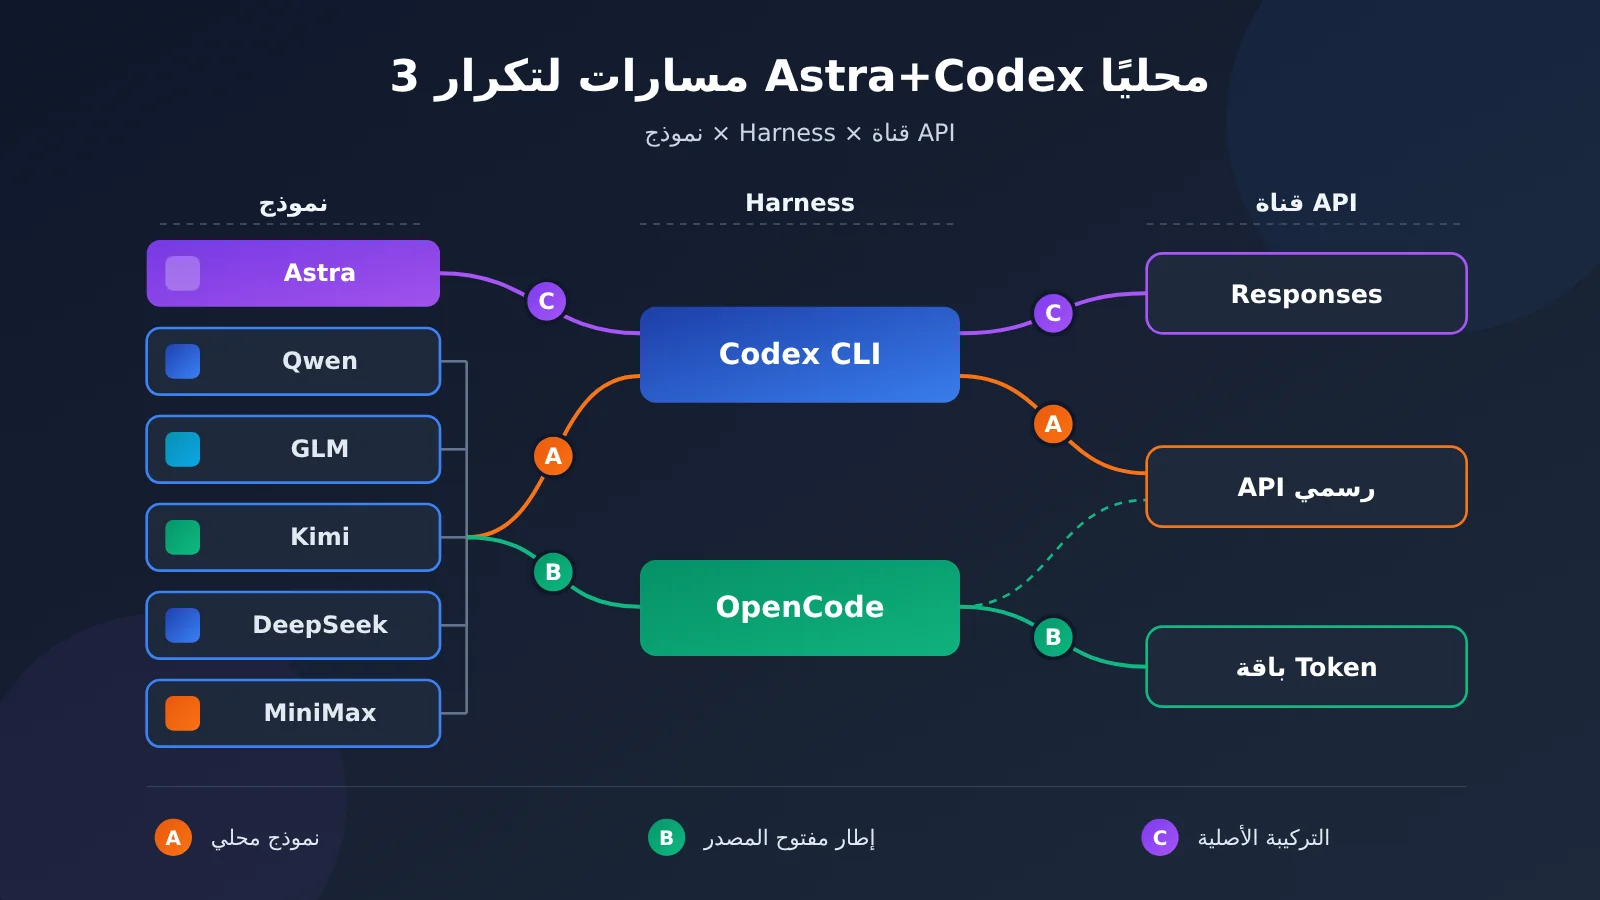
هناك ثلاثة مسارات جديرة بالاختبار لإعادة إنتاج Astra + Codex داخل الصين إلى أقصى حد ممكن. المسار A: الإبقاء على Codex CLI الأصلي، والاتصال بنماذج رائدة محلية عبر واجهة متوافقة مع Responses من Alibaba Cloud Bailian أو Tencent Cloud TokenHub، وهذا المسار يحافظ على تجربة التنفيذ في Codex. المسار B: التحول إلى OpenCode أو أدوات Harness مفتوحة أخرى للاتصال بعدة نماذج محلية، وهذا المسار يمنح أكبر حرية في اختيار النموذج. المسار C: ضمن حدود القانون والامتثال وتوفر الخدمة فعليًا، الإبقاء على نموذج GPT-6 Astra والاتصال بـ Codex الأصلي عبر قناة API تدعم بروتوكول Responses بالكامل، وهذا المسار يحقق أعلى درجة تطابق مع التوليفة الأصلية.
إذا كان المطلوب أن تكون النماذج محلية، فإن المسار A هو نقطة البداية، لكن Qwen4-Max-Preview متاح فقط حتى الساعة 24:00 من 25 نوفمبر 2026، لذا يصلح للتقييم ولا يصلح ليكون الاعتماد الوحيد طويل الأمد. وإذا كان المطلوب فقط الاستخدام داخل بيئة الشبكة في الصين دون اشتراط نماذج محلية، فإن المسار C هو الأقرب إلى النسخة الأصلية من حيث قدرات النموذج. أما الاختيار النهائي بين المسارات الثلاثة فيجب أن يحسمه معدل نجاح نفس المجموعة من مهام البرمجة الحقيقية، والوقت المستغرق، والتكلفة، وتوافق الأدوات، لا لوحات الصدارة ولا سعر الـ Token.
فيما يلي نفصل أولاً Astra + Codex إلى خمسة مكونات قدرات، لنوضح ما الذي نعيد إنتاجه فعلاً عند الحديث عن «إعادة الإنتاج». ثم نعرض إعدادَي التكامل الرسميين والمقارنة بين الباقات في المسار A، وأدوات Harness الأربع في المسار B، والنماذج المحلية التي تستحق الاختبار أولاً. بعد ذلك نجمع مفاضلات المسارات الثلاثة في جدول شامل. وأخيرًا نقدم منهجية قابلة للتكرار لاختبار خمس فئات من المهام، مع جعل «تكلفة المهمة الناجحة الواحدة» المؤشر الأساسي عند اختيار الحل.
معرفة أساسية: مصطلحات تمهيدية
| المصطلح | الشرح |
|---|---|
| GPT-6 Astra | نموذج الاستدلال الرائد من OpenAI، مخصّص لمهام الاستدلال المعقدة وهندسة البرمجيات ومهام الوكيل طويلة المدى، ومعرّف النموذج هو gpt-6-astra. |
| Codex | وكيل برمجة من OpenAI، يستطيع قراءة المشروع وتعديل الشيفرة وتنفيذ الأوامر والتحقق من النتائج. |
| Harness | إطار تنفيذ يربط قرارات النموذج بأدوات حقيقية، ويتولّى حلقة الأدوات والسياق والصلاحيات والتعافي من الأخطاء. |
| Responses API | بروتوكول واجهة من OpenAI يدعم مخرجات النموذج والاستدلال واستدعاء الأدوات، ويعتمد عليه الإصدار الجديد من Codex في التشغيل. |
| Chat Completions | بروتوكول واجهة محادثة أقدم من OpenAI، يستخدمه الإصدار القديم من Codex. |
| Provider | مزوّد يقدّم خدمة النموذج لأدوات الوكيل، ويظهر في ملف التكوين كمجموعة من معاملات الاتصال. |
| Base URL | عنوان الوصول الأساسي لواجهة خدمة النموذج، وهو ما يتم تغييره أساسًا عند تبديل القنوات. |
| Token Plan | خطة تسعير شهرية تقدّمها مزوّدات السحابة، تُتيح حصة من استدعاءات النموذج. |
| Credits / النقاط | وحدة قياس داخل الحزمة تُخصم منها حصة الاستدعاء، ولا يمكن تبادلها مباشرة بين مزوّدين مختلفين. |
| نافذة السياق | الحد الأقصى لما يمكن أن يعالجه النموذج في طلب واحد، محسوبًا بالـ Token. |
| مستوى الاستدلال | معامل يتحكم في عمق تفكير النموذج، ويوفّر Astra خمسة مستويات من low إلى max. |
| إصابة الذاكرة المؤقتة | إعادة استخدام الخادم للمدخلات المتكررة، فتُحاسب بسعر أقل. |
| MCP | بروتوكول مفتوح يربط تطبيقات النموذج بالأدوات ومصادر البيانات الخارجية. |
| Function Calling | آلية يُخرج فيها النموذج طلب استدعاء مُهيكلًا، فينفّذ التطبيق الدالة ويُعيد النتيجة. |
| تسعير الذروة والخارج عن الذروة | تسعير يختلف حسب الفترة الزمنية، إذ تستهلك ساعات الذروة حصة أكبر. |
المحتوى
1 أين تتجلى قوة Astra + Codex تحديدًا؟
1.1 ما الذي تقدمه Astra؟
GPT-6 Astra هو نموذج الاستدلال الرائد من OpenAI، وتغطي صفته الرسمية الاستدلال المعقد، وهندسة البرمجيات، وتعديلات الشيفرة متعددة الخطوات، وتشغيل المتصفح والحاسوب، والتحليل البحثي، وإنتاج الوثائق المهنية. وما يقدمه إلى Codex هو «قدرة التقدير»: فهم قاعدة شيفرة غير مألوفة، وتصميم خطة للتعديل، وفهم رسائل الأخطاء وتعديل الاستراتيجية.
مواصفات النموذج الرسمية (تاريخ التحقق من البيانات: 2026-11-13) هي:
- نافذة السياق: 1,050,000 توكن؛ أقصى إخراج: 128,000 توكن.
- مستويات الاستدلال: low، medium، high، xhigh، max.
- السعر القياسي (دولار / مليون توكن): الإدخال $10، الإخراج $50، الإدخال المخزن مؤقتًا $1، كتابة التخزين المؤقت لمدة 30 دقيقة $12.50؛ وعندما يتجاوز الإدخال 272K توكن، تُطبق أسعار أعلى للسياق الطويل.
- أدوات Responses API: Web Search، File Search، Hosted Shell، Apply Patch، Computer Use، MCP، وغيرها.
يحتاج البند الأخير إلى فهم منفصل: هذه الأدوات قدرات توفرها منصة OpenAI، وما إذا كان عميل معين أو بوابة طرف ثالث يستطيع استخدامها يتوقف على الأدوات التي دمجها فعليًا.
1.2 ما المهام التي يتولاها Codex؟
في مقال Codex Harness الذي نشرته OpenAI في أغسطس 2026، وُصِف جوهر Codex بأنه يتكون من حلقة الوكيل (Agent loop)، وفهم قاعدة الشيفرة والتعامل مع الملفات، وتنفيذ الأوامر، واستدعاء الأدوات وإرجاع النتائج، وإدارة السياق متعدد الجولات، وموافقة المستخدم، وحدود الأمان في البيئة المعزولة، ومراقبة عملية التنفيذ والتعافي من الفشل.
تقسيم الأدوار واضح: النموذج مسؤول عن التقدير والتوليد، بينما تتولى منظومة التشغيل (Harness) تطبيق قرارات النموذج فعليًا على نظام الملفات والطرفية الحقيقيين. ولا يمكن لنموذج محادثة قوي أن ينجز مهمة برمجية كاملة — «قراءة المشروع → تعديل الشيفرة → تشغيل الاختبارات → إصلاح الفشل → إعادة التحقق» — إلا إذا اقترن بنظام التنفيذ هذا.
1.3 هل نعيد إنتاج النموذج أم الوكيل بالكامل؟
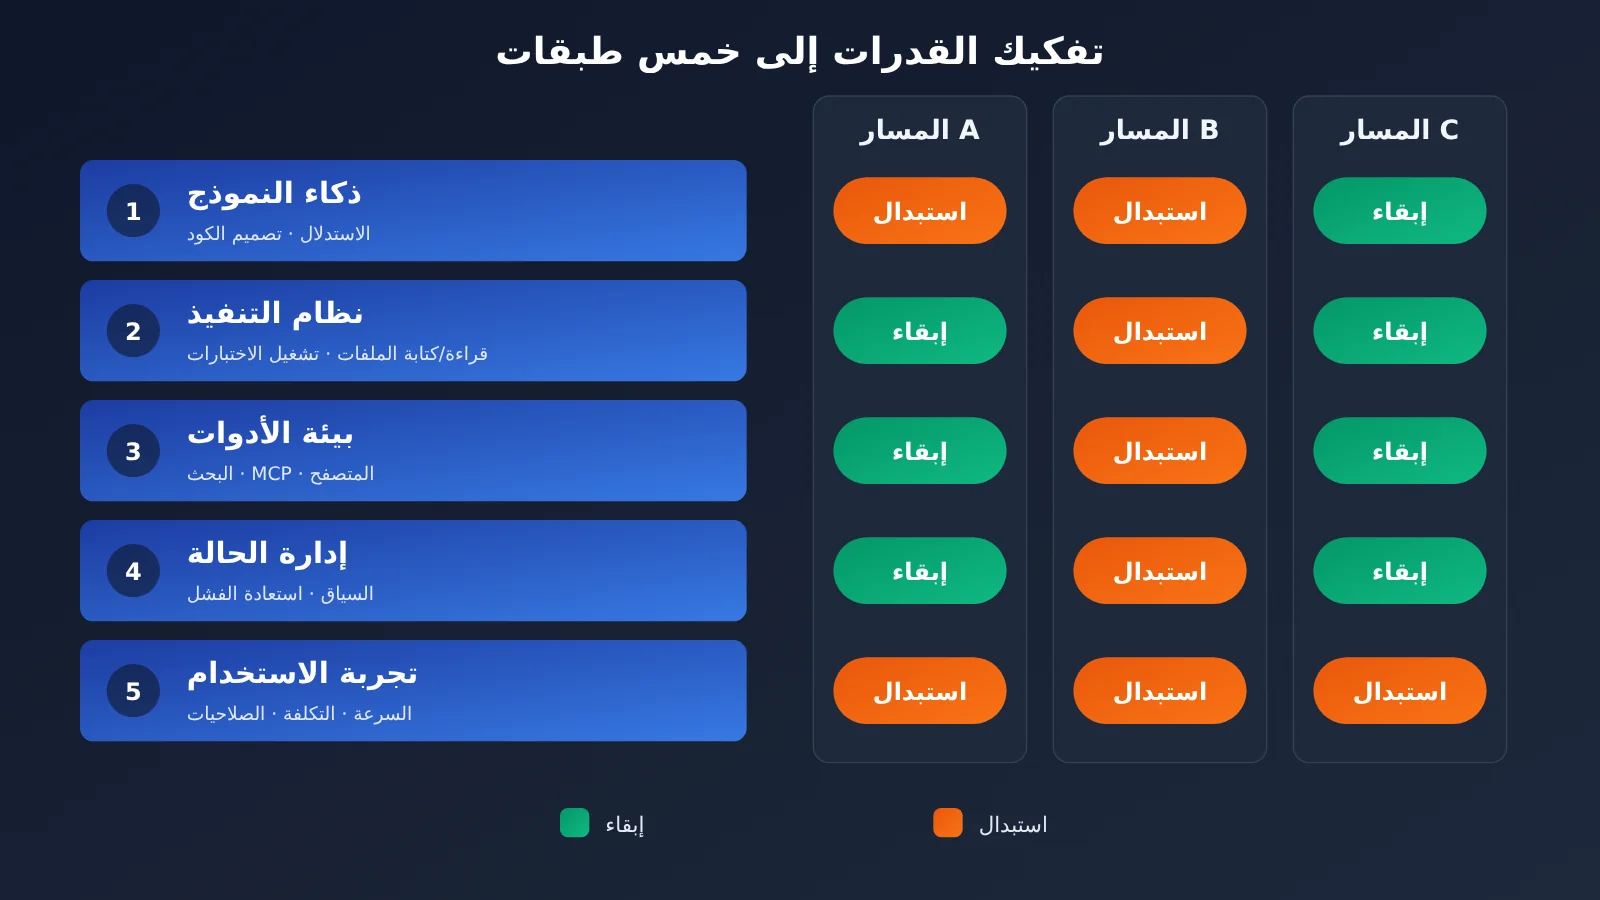
إذا فككنا التجربة الأصلية، نحصل على خمسة مكونات:
- ذكاء النموذج: فهم المهام المعقدة، وتصميم الشيفرة، والاستدلال والتصحيح.
- نظام التنفيذ: قراءة المشروع، وتحرير الملفات، وتنفيذ الأوامر، وتشغيل الاختبارات.
- منظومة الأدوات: البحث عبر الإنترنت، وقراءة صفحات الويب، وMCP، ومعالجة الملفات، وتشغيل المتصفح.
- إدارة الحالة: سياق المهام الطويلة، وحلقة استدعاء الأدوات، والتعافي من الفشل.
- تجربة الاستخدام: سرعة الاستجابة، والاستقرار، والتكلفة، والتحكم في الصلاحيات، وسهولة التشغيل.
استبدال النموذج يغيّر البند الأول بشكل أساسي، لكن ما يشعر به المستخدم في النهاية هو مجموع البنود الخمسة. وهذا أيضًا ما يفصل بين المسارات الثلاثة: المسار A يستبدل البند الأول ويحافظ على البندين الثاني والرابع؛ والمسار B يستبدل البنود الأول والثاني والرابع معًا؛ والمسار C يحافظ على البنود الأول والثاني والرابع قدر الإمكان، مع تركيز الاختلاف في البند الخامس وتفاصيل البروتوكول الناتجة عن قناة API.
2 الاحتفاظ بـ Codex وربطه بنموذج محلي الصنع (المسار A)
2.1 Alibaba Cloud Bailian Token Plan + Codex
نشرت Alibaba Cloud وثائق رسمية لربط Codex، ويقدّم Token Plan واجهة متوافقة مع Responses تتيح الاتصال مباشرة بالإصدار الجديد من Codex. اكتب ما يلي في ~/.codex/config.toml (في Windows يكون عادةً C:\Users\<اسم المستخدم>\.codex\config.toml):
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
يجب وضع مفتاح API الخاص بحزمة Token Plan في متغير البيئة الذي يشير إليه env_key. وهناك بعض التفاصيل التقنية الحساسة التي قد تُوقعك في أخطاء أثناء الإعداد:
- إصدار البروتوكول: يتطلب Codex اعتبارًا من الإصدار 0.94.0 واجهة Responses API. تستخدم Coding Plan القديمة من Alibaba Cloud واجهة Chat Completions، وتتطلب الوثائق الرسمية اقترانها بـ Codex 0.93.0 أو إصدار أقدم؛ أما البيئات التي تحتاج إلى صيانة طويلة الأمد فينبغي أن تختار Token Plan.
- عزل المفاتيح: تستخدم Token Plan وCoding Plan والفوترة حسب الاستخدام ثلاث مجموعات مختلفة من مفاتيح API.
- المنطقة: يدعم Token Plan حاليًا منطقة شمال الصين 2 (بكين) فقط.
- بيانات النموذج الوصفية: يحتاج النموذج الجديد إلى إعداد معرّف النموذج وبياناته الوصفية بشكل صحيح للحصول على دعم كامل في واجهة اختيار النموذج في Codex.
أبرز ما يستحق الانتباه في Bailian حاليًا هو Qwen4-Max-Preview الذي أُطلق في 11 نوفمبر 2026 (معرّف النموذج qwen4-max-preview). تؤكد الوثائق الرسمية أنه نموذج متعدد الوسائط رائد من الجيل الجديد، يدعم تطوير الكود ومهام الوكلاء الذكيين المعقدة وفهم الصور والفيديو، ويدعم التفكير العميق (مُفعّل افتراضيًا) واستدعاء الأدوات والبحث عبر الإنترنت والمخرجات المنظمة، ويتوافق مع ثلاثة بروتوكولات: OpenAI Chat Completions وResponses وAnthropic Messages. طول نافذة السياق 1M Token، وأقصى ميزانية إخراج 393,216 Token، ويشترك التفكير والرد النهائي في هذه الميزانية.
شروط استخدامه واضحة بدورها: متوفر حاليًا في Token Plan فقط، ولا يدعم الفوترة حسب الاستخدام؛ فترة المعاينة من 10:00 بتوقيت بكين في 11 نوفمبر 2026 حتى 24:00 يوم 25 نوفمبر، وبعدها يُسحب من الخدمة. واعتبارًا من تاريخ هذا المقال، يتبقى أقل من أسبوعين للاختبار، لذا يُنصح بالإسراع في التقييم، مع تجهيز نموذج بديل للبيئة الإنتاجية في الوقت نفسه.
2.2 Tencent Cloud TokenHub + Codex
وفّر Tencent Cloud برنامجًا تعليميًا رسميًا مخصصًا لربط Codex CLI، وطريقة كتابة ملف الإعداد نفسه كما يلي:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
يجب استبدال $model_id بمعرّف النموذج الدقيق الذي تدعمه الباقة حاليًا. تشمل مكتبة نماذج TokenHub كلاً من GLM-5.3 وKimi K3 وسلسلة DeepSeek V4 وMiniMax M3 وسلسلة Hy من Tencent Hunyuan، إضافةً إلى بعض النماذج الخفيفة ونماذج التوجيه التلقائي، وتدعم الباقة نفسها أيضًا أدوات مثل Claude Code وCline وOpenClaw.
تكمن ميزة TokenHub في «إعداد Codex واحد، ونماذج صينية متعددة»: يكفي تغيير سطر model واحد ليجعل نفس Harness يشغّل GLM ثم Kimi ثم DeepSeek ثم MiniMax بالتتابع، وهو أمر مثالي للمقارنات الأفقية. تتغير مخزونات النماذج وإصداراتها وسياسات الحصص باستمرار، لذا ينبغي قبل كل اختبار الاعتماد على معرّفات النماذج المدرجة في لوحة التحكم.
2.3 ما الفرق بين الباقتين
كلتا الشركتين تسمّي باقتها Token Plan، لكن وحدة القياس مختلفة: تستخدم Bailian من Alibaba Cloud Credits، بينما يستخدم TokenHub نقاطًا، ولا يمكن التحويل بينهما مباشرةً. بيانات الجدول التالي حتى 2026-11-13، وجميع الأسعار باليوان/شهر:
| بُعد المقارنة | خطة Token Plan من Alibaba Cloud Bailian (النسخة الشخصية) | خطة Token Plan العام من Tencent Cloud TokenHub (النسخة الشخصية) |
|---|---|---|
| الفئة والرسوم الشهرية | Lite ¥39، Essential ¥79، Standard ¥139، Pro ¥312 | Lite ¥39، Standard ¥99، Pro ¥299، Max ¥599 |
| الحصة الشهرية | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 نقطة |
| عدد الوكلاء المتزامنين الموصى به | 1—2 / 2—3 / 3—4 / 6—8 | لا توفر الوثائق مؤشرًا مماثلاً |
| الخصومات والمزايا | Lite وEssential: الشراء الأول للمستخدمين الجدد بـ ¥19.5 و¥39.5 (حتى 2026-11-30)؛ Standard وPro مع مزايا AgentStudio Harness | معدلات استهلاك مخفّضة لفترة محدودة لبعض النماذج؛ مرجع شراء النقاط ¥1 = 20 نقطة |
| بروتوكول ربط Codex | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| النماذج البارزة | سلسلة Qwen، بما فيها Qwen4-Max-Preview الحصري لـ Token Plan | GLM-5.3، Kimi K3، DeepSeek V4، MiniMax M3، Hunyuan Hy |
| طريقة القياس | تُخصم Credits حسب النموذج | خصم بالنقاط اعتبارًا من 2026-08-31، بمعدلات مختلفة بين النماذج |
| قيود الاستخدام | شمال الصين 2 (بكين) فقط؛ لا ينبغي استخدام باقة البرمجة التفاعلية مباشرةً في أتمتة الواجهات الخلفية التجارية العامة | قد تتغير مكتبة النماذج والعروض الترويجية |
عند مقارنة هاتين الباقتين، فإن ترتيب السعر الشهري ليس ذا أهمية كبيرة؛ المهم هو «النموذج الذي أريد استخدامه، وكم حصة يستهلك في هذه الباقة عند إتمام كل مهمة». تتركز قيمة Bailian في منظومة Qwen وQwen4-Max-Preview المحصورة حاليًا بها؛ بينما تتركز قيمة TokenHub في أن عدة نماذج صينية تتشارك حصة واحدة.
أعلن TokenHub عن معدلات خصم النقاط لكل نموذج بشكل علني. فيما يلي بعض معدلات الخصم لفترة محدودة التي تم الاستعلام عنها في 2026-11-13، بعد تحويلها إلى يوان لكل مليون Token وفقًا لـ ¥1 = 20 نقطة:
| النموذج | الإدخال العادي | الإخراج | الإدخال عند إصابة الذاكرة المؤقتة | ملاحظات |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | يعود إلى سعر القائمة بعد انتهاء الخصم |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | سيناريوهات حساسة للسرعة والتكلفة |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | يعود إلى سعر القائمة بعد انتهاء الخصم |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | نموذج مخصص للكود |
| DeepSeek V4.1 Flash (خارج الذروة) | ¥0.40 | ¥1.60 | ¥0.008 | فوترة الذروة وخارج الذروة |
| DeepSeek V4.1 Flash (الذروة) | ¥0.80 | ¥3.20 | ¥0.016 | أيام العمل 09:00—12:00 و14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | سعر الإدخال عند ≤ 512K توكن |
يجب قراءة هذا الجدول مع نقطتين أساسيتين. أولاً، الاشتراك الشهري يُحصّل حسب رسوم الباقة الشهرية، والمبالغ في الجدول هي القيمة المرجعية للنقاط، وتُستخدم لمقارنة معدل الاستهلاك بين النماذج. ثانياً، بدأت فوترة الذروة وخارج الذروة في DeepSeek اعتباراً من 30 أكتوبر 2026، ويبلغ الاستهلاك في أوقات الذروة نحو ضعف الاستهلاك خارجها؛ وتشغيل المهام غير المتزامنة ليلاً مثل فحص الكود بالجملة وتحليل الاختبارات يمكن أن يوفّر من الحصة بشكل ملحوظ.
لنجري عملية حسابية باستخدام GLM-5.3: مهمة برمجية كبيرة تستهلك في المجموع 100,000 توكن إدخال عادي، و300,000 توكن إصابة ذاكرة مؤقتة، و30,000 توكن إخراج، وهو ما يقابل 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232 كقيمة مرجعية بالنقاط. إصابات الذاكرة المؤقتة تستحوذ على الجزء الأكبر من الإدخال، وهذا هو الشكل النموذجي لمهام الوكيل (Agent)، ويوضح أيضاً أن سعر الذاكرة المؤقتة يؤثر بشكل كبير في التكلفة الإجمالية لسيناريوهات البرمجة.
3 هل يقرّبنا تغيير Harness أكثر إلى Astra + Codex؟ (المسار B)
3.1 OpenCode: التركيز على حرية استخدام نماذج متعددة
OpenCode هو وكيل برمجة بالذكاء الاصطناعي مفتوح المصدر، ويدعم عددًا كبيرًا من مزوّدي LLM: أضف المزوّد عبر /connect، وبدّل النموذج عبر /models، كما يدعم Base URL المخصص والنماذج المحلية. يمكن استخدامه في الطرفية وسطح المكتب وبعض بيئات التطوير، ويوفّر إمكانات البحث في الملفات وتعديلها وتنفيذ الأوامر وسير عمل الوكلاء. وقد وفّرت Alibaba Cloud تعليمات اتصال رسمية؛ ما عليك سوى اختيار Alibaba Token Plan (China) لاستخدام باقة Bailian.
تجدر الإشارة الجدية إلى ملاحظات الأمان الرسمية لـ OpenCode: فالوكيل المحلي الافتراضي لا يوفّر عزلاً أمنيًا على مستوى النظام، ولا يمكن لموافقات الأذونات أن تعوّض الحاوية أو الجهاز الافتراضي. وعند تشغيل تعليمات برمجية غير موثوقة أو مهام أتمتة عالية الصلاحيات، ينبغي تنفيذها داخل Docker أو جهاز افتراضي.
3.2 Qwen Code وKimi Code وDeepSeek Harness
تخدم كل أداة Harness أصلية من هذه الأدوات الثلاث النظام البيئي للنموذج المقابل لها:
- Qwen Code: توفّر Alibaba Cloud ثلاث واجهات: CLI وسطح المكتب وIDE. يكفي تسجيل الدخول إلى Bailian واختيار المنطقة وإدخال مفتاح API للاتصال، مع إمكانات البحث في قاعدة التعليمات البرمجية وتحرير الملفات وتنفيذ الأوامر. تفضّلها الفرق التي تعتمد أساسًا على نماذج Qwen وتسعى إلى تقليل أعمال تكييف البروتوكولات.
- Kimi Code CLI: أداة برمجة طرفية تدعمها Moonshot AI، وتتيح قراءة التعليمات البرمجية وتعديلها، واستدعاء Shell، وجلب محتوى الويب، واستعادة الجلسات، وأوضاع التخطيط والموافقة، والتكامل مع المحرر، كما يمكنها إعداد نماذج متوافقة من جهات خارجية. على Windows، تُثبّت عبر سكربت PowerShell الرسمي، وتعتمد على Git Bash من Git for Windows؛ توقّف دعم الإصدار القديم من Kimi CLI في سبتمبر 2026، لذا يستخدم المستخدمون الجدد Kimi Code CLI مباشرة.
- DeepSeek Harness: إطار عمل مفتوح المصدر للوكلاء يوفّر Web UI وCLI معًا، ويدعم إعداد المزوّد والأدوات بشكل مخصص، ويمكن ربطه بمخططات الفوترة المختلفة في Bailian. شغّله عبر
npx @deepseek-ai/dsh web، والعنوان الافتراضي هوhttp://127.0.0.1:3080. عند اختياره، ركّز على استقرار تنفيذ الأدوات، والتحكم في الأذونات، وتوافق بروتوكول النموذج المستهدف.
3.3 لماذا يؤثر Harness في أداء النموذج
قد يبدو الفرق كبيرًا في النتائج عند وضع النموذج نفسه داخل Harness مختلف؛ والسبب أن Harness يحدد ما «يراه» النموذج، وما «يستطيع فعله»، وكيف «يتعامل مع الخطأ»:
- استراتيجية قراءة التعليمات البرمجية: عدد الملفات التي تُقرأ دفعة واحدة، وترتيب البحث، يحددان ما إذا كان فهم النموذج للمشروع كاملًا.
- تصميم حلقة الأدوات: كيفية إرجاع نتائج الأدوات، وما إذا كانت إعادة المحاولة التلقائية تحدث بعد الفشل، يحددان ما إذا كان يمكن إكمال المهام الطويلة.
- ضغط السياق: أي سجل يُحتفظ به في الجلسات الطويلة وأي تفاصيل تُحذف، يؤثر مباشرة في احتمال أن «ينسى» النموذج الهدف.
- التعديلات والاختبارات: هل يتم استبدال الملف بالكامل أم استخدام patch من نوع diff، وهل تُشغّل الاختبارات افتراضيًا بعد التعديل؟ يحدد ذلك دقة التغييرات ومخاطر الانحدار.
لذا فإن النتيجة التي يقيسها المسار B هي نتيجة مركّبة لـ «النموذج + Harness نفسه». وعند مقارنتها بالمسار A، ينبغي أن نتذكّر أن استراتيجيات التنفيذ لدى الجانبين مختلفة أصلًا.
4 ما النماذج المحلية التي تستحق الاختبار؟
4.1 Qwen4-Max-Preview
من المواصفات المعلنة، نافذة سياق بحجم 1M، وميزانية مشتركة للتفكير والإخراج تبلغ 393,216 Token، واستدعاء الأدوات والإخراج المنظم، تجعله مناسبًا لاختبار البرمجة المعقدة وتحليل السياق الطويل وسير عمل Agent متعدد الجولات. وهو متوافق مع Responses وAnthropic Messages في الوقت نفسه، ويمكن ربطه بـ Codex وكذلك بأدوات من نوع Claude Code.
نافذة الوقت هي القيد الأول عند اختياره: تنتهي النسخة التجريبية في 2026-11-25 الساعة 24:00 وتُسحب من الخدمة. الطريقة الموصى بها هي استخدامه خلال هذه الفترة لتشغيل مجموعة الاختبارات الكاملة، واتخاذ النتائج مرجعًا لنماذج Qwen الرسمية اللاحقة، مع إعداد نموذج بديل متاح على المدى الطويل في بيئة الإنتاج في الوقت نفسه.
4.2 GLM-5.3 وKimi K3 وDeepSeek V4 وMiniMax M3
كل هذه السلاسل ضمن باقة واحدة في TokenHub، وتوزيعها حسب نوع المهمة هو الخيار الأسهل:
- المنطق المعقد وتعديل ملفات متعددة: GLM-5.3 وKimi K3 وDeepSeek V4-Pro كمجموعة عالية القدرة للمقارنة. سعر إخراج Kimi K3 هو الأعلى في الجدول، لذا يناسب وضعه على أصعب المهام لاختبار الحد الأعلى.
- المهام الموجهة إلى الكود: Kimi K2.7 Code مخصص للمقارنة في سيناريوهات تعديل الكود، ويمكن أيضًا استخدامه مع Kimi Code CLI لاختبار التجربة الأصلية.
- المهام عالية التكرار ومنخفضة التكلفة: GLM-5.3-Flash وDeepSeek V4-Flash لفحص الكود وإعادة الهيكلة بالجملة وغيرها من السيناريوهات الحساسة للتكلفة والسرعة.
- استقرار السياق الطويل ودقة استدعاء الأدوات: يُدرج MiniMax M3 ضمن المرشحين، مع الانتباه إلى ارتفاع السعر فوق عتبة الإدخال 512K.
4.3 كيف نحدد أي نموذج أقرب إلى Astra
لا يمكن الاعتماد على طول السياق أو عدد المعلمات أو التموضع التسويقي أو سعر Token الواحد لإعطاء ترتيب موثوق للنماذج، كما تفتقر نتائج الأداء الترويجية الواردة من مصادر مختلفة إلى قابلية المقارنة. الطريقة الموثوقة الوحيدة لتحديد “أي نموذج أقرب إلى Astra + Codex” هي استخدام Harness واحد ومجموعة المهام نفسها، مع تسجيل موحد لمعدل نجاح المهام ووقت التنفيذ وتكلفة Token وتوافق الأدوات وعدد التدخلات اليدوية؛ والتفاصيل في القسم 6.
5 ثلاث مسارات لإعادة الإنتاج، كيف تختار بينها فعليًا؟
5.1 إذا أردت تجربة تشغيل Codex الأصلية: اختر المسار A
أبقِ Codex Harness كما هو، واتصل بخدمة محلية تدعم بروتوكول Responses دعمًا رسميًا. إذا كان Qwen هو نموذجك الأساسي فاختر Bailian، وإذا كنت تريد التنقل بين عدة نماذج محلية فاختر TokenHub. الميزة أن تكلفة التعلّم والانتقال منخفضة، وأن عمليات الملفات ومنظومة تنفيذ الوكيل (Agent) كلها نسخة أصلية. أما المقايضة فهي أن ذكاء النموذج يختلف عن Astra، وأن درجة تنفيذ الواجهة المتوافقة تؤثر على تجربة استدعاء الأدوات، كما أن نافذة السياق ومعاملات الاستدلال تختلف من نموذج لآخر وتحتاج إلى ضبط منفصل لكل واحد منها.
5.2 إذا أردت النماذج المحلية وحرية تعدد النماذج: اختر المسار B
OpenCode مع واجهات API لنماذج محلية متعددة، وإذا لزم الأمر أضف Qwen Code أو Kimi Code أو DeepSeek Harness. هذا المسار هو الأنسب للمطورين الذين يستخدمون عدة نماذج على المدى الطويل ولا يرغبون في الارتباط بمزوّد واحد، وهو أيضًا الأسهل للمقارنة الأفقيّة بين أداء نماذج مختلفة على المهمة نفسها. الثمن أن استراتيجية التنفيذ مختلفة عن Codex، وأن ربط عدة Providers يجلب عملًا إضافيًا في الضبط والصيانة.
5.3 إذا أردت الحفاظ على قدرات Astra إلى أقصى حد: اختر المسار C
تركيبة المسار C هي «Codex CLI الأصلي + GPT-6 Astra + خدمة وصول API متاحة». وبمجرد أن تقدّم القناة فعليًا نسخة GPT-6 Astra الأصلية وتدعم بشكل كامل Responses API والتدفّق الحدثي واستدعاء الأدوات وإدارة السياق التي يحتاجها Codex، يمكنك الحفاظ على المكوّنين الأساسيين معًا: النموذج و Harness. هذا المسار يعالج مسألة توفّر الشبكة، وهو أمر منفصل عن استبدال النموذج بنموذج محلي.
لنأخذ APIYI مثالًا، فطريقة الربط متطابقة تمامًا مع المسار A، وكل ما تحتاجه هو تغيير مجموعة إعدادات Provider:
model_provider = "APIYI"
model = "gpt-6-astra"            # اعتمد على معرّف النموذج المدرج فعليًا في لوحة تحكم APIYI
model_reasoning_effort = "high"  # اضبطه بين low و max حسب صعوبة المهمة

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
قبل الربط يُنصح بتشغيل سكربت قصير للتأكد من أن القناة تدعم فعليًا بروتوكول Responses واستدعاء الأدوات، لا أن تعيد نصًا عاديًا فقط:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # استبدله بمعرّف النموذج المتاح في لوحة التحكم
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# في الحالة الطبيعية يجب أن يعيد عنصر إخراج من النوع function_call مع معاملات مُهيكلة
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # تحقّق مما إذا كانت رموز الإدخال والإخراج والتخزين المؤقت والاستدلال محسوبة كلٌّ على حدة
يغطي هذا الاختبار الاستكشافي ثلاثة أمور يعتمد عليها Codex أكثر من غيرها: بروتوكول Responses، وإرجاع Function Calling، وإحصاءات الاستخدام المفصّلة. بعد نجاح السكربت، ادمج Codex ثم شغّل مهمة كاملة تشمل «تعديل الشيفرة + تشغيل الاختبارات» للتأكد من أن أحداث البث وحلقة الأدوات متعددة الجولات تعمل بشكل طبيعي.
حتى لو كان النموذج نفسه، فإن تجربة المسار C تظل متأثرة بتوجيه النموذج الفعلي، ومستوى الاستدلال، وزمن استجابة API وإنتاجية الإخراج، وإصابة التخزين المؤقت، وتوافق بروتوكول البوابة، وتكاليف المزوّد. تعتمد نسخة Codex لسطح المكتب والمهام السحابية والميزات المخصصة لحساب ChatGPT على نظام التفويض الخاص بـ OpenAI؛ أما الاستخدام عبر مفتاح API فيعتمد على مزيج Codex CLI مع API النموذج، لذلك ينبغي استبعاد هذه الميزات عند التخطيط.
🚀 نصيحة للبدء السريع: إذا أردت مقارنة المسار A بالمسار C، يمكنك التسجيل في APIYI عبر apiyi.com والحصول على رصيد اختبار مجاني، ثم تشغيل نماذج صينية محلية ونماذج GPT في بيئة Codex نفسها كلٌّ على حدة. أما قائمة النماذج المتاحة فعليًا لدى APIYI ودعم البروتوكولات، فيُرجع فيها إلى لوحة التحكم ووثائق docs.apiyi.com.
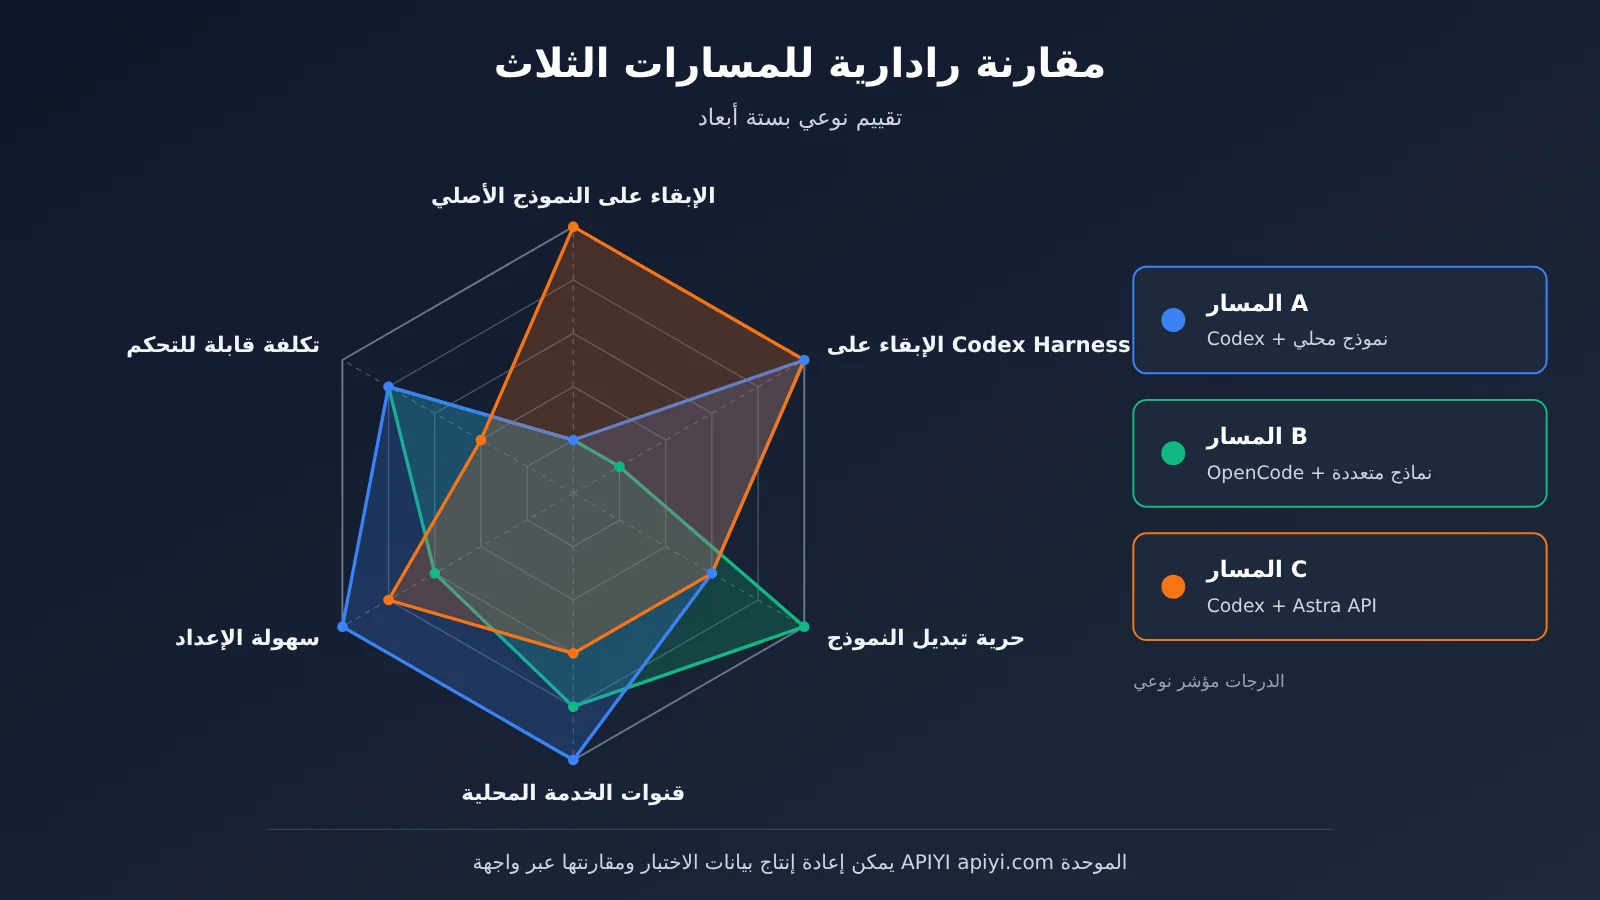
فيما يلي ملخص المقايضات بين المسارات الثلاثة:
| بعد المقارنة | المسار A: Codex + نموذج صيني محلي | المسار B: OpenCode وغيره + نماذج محلية متعددة | المسار C: Codex + Astra API |
|---|---|---|---|
| الاحتفاظ بالنموذج الأصلي | لا، يُستبدل بـ Qwen / GLM / Kimi وغيرها | لا | نعم (بشرط أن يتحقق المزوّد من ذلك) |
| الاحتفاظ بـ Codex Harness | نعم | لا، يُستبدل بإطار Harness مفتوح | نعم |
| تبديل النموذج | تغيير معرّف النموذج داخل المنصة نفسها | تبديل حر بين مزوّدين متعددين | التبديل بين النماذج التي يدعمها المزوّد |
| قنوات الخدمة المحلية | Alibaba Cloud Bailian وTencent Cloud TokenHub | Bailian وTokenHub وخدمات متوافقة أخرى | قنوات طرف ثالث تدعم Responses، مثل APIYI apiyi.com |
| تعقيد الإعداد | منخفض، إعدادات جاهزة رسميًا | متوسط، يتطلب صيانة عدة مزوّدين | منخفض، بشرط التحقق من البروتوكول أولًا |
| شكل التكلفة | باقة شهرية (Credits / نقاط) | باقة أو حسب الاستخدام، بحسب المزوّد | فوترة حسب الاستخدام، وسعر Astra أعلى من معظم النماذج الصينية المحلية |
| مناسب لـ | تجربة Codex الأصلية + استخدام نموذج محلي | سير عمل طويل الأمد متعدد النماذج | الحفاظ على القدرات الأصلية إلى أقصى حد |
5.4 الحدود الشبكية والأمنية للاستخدام المحلي
عندما يستخدم API النموذج عنوانًا يمكن الوصول إليه داخل الصين، فإن ذلك يحل فقط جزءًا من سلسلة استدعاء النموذج. أثناء عمل الوكيل، سيصل أيضًا إلى مصادر برمجية مثل GitHub وnpm وPyPI، وإلى الوثائق الرسمية الخارجية، وخدمات MCP التابعة لجهات خارجية، والبحث في الويب؛ وتحتاج إمكانية الوصول إلى هذه المسارات إلى تأكيد منفصل. البحث عبر الإنترنت أيضًا قدرة مستقلة: فالبحث المدمج لدى مزودي السحابة، وأدوات الاتصال بالشبكة المضمنة في Harness، وواجهات Search API / MCP المبنية ذاتيًا، لكل منها قيود مختلفة في الوصول والفواتير والاستدعاء.
من ناحية الأمان، يستطيع وكيل البرمجة تعديل الملفات وتشغيل Shell وقراءة متغيرات البيئة، لذا يُنصح بما يلي:
- تخزين مفتاح API في متغيرات البيئة أو في أداة إدارة بيانات الاعتماد، وعدم كتابته أبدًا في الشفرة المصدرية أو مستودعات Git.
- إجراء التعديلات المعقدة على فرع Git مستقل، مع الاحتفاظ بالتحكم في الإصدارات ونسخة احتياطية قابلة للاستعادة للمشروع.
- تقييد وصول الوكيل إلى الملفات الحساسة خارج دليل العمل، ووضع الشفرة غير الموثوقة داخل حاوية أو جهاز افتراضي.
- الاحتفاظ بموافقة بشرية للعمليات عالية المخاطر مثل الحذف والنشر والدفع.
6 اختبار المهام الواقعية أكثر قيمة من لوحات تصنيف النماذج
6.1 إعداد خمس فئات من مهام الاختبار
استخدم مشروعًا واقعيًا يضم الواجهة الأمامية والخلفية والاختبارات وإعدادات التبعيات، وصمّم خمس فئات من المهام لفحص قدرات النموذج وقدرات Harness كلٌّ على حدة:
- فهم المشروع: اطلب شرح البنية والعلاقات بين الوحدات الرئيسية، وراقب تحديد موقع الملفات وفهم التبعيات بين الملفات، وما إذا كان النموذج يستطيع تقديم إشارات مسارات قابلة للتحقق.
- تطوير عبر ملفات متعددة: أضف ميزة جديدة تتطلب تعديل مواضع متعددة، وراقب دقة التعديلات واكتمال الوظيفة وما إذا كانت ستُدخل أخطاء انحدارية.
- إصلاح الأخطاء: قدّم مشروعًا يحتوي على اختبار فاشل قابل لإعادة الإنتاج، وراقب ما إذا كان النموذج يحدد السبب الجذري ويصحح الموضع الصحيح ويشغّل الاختبارات بنفسه دون الإضرار بالحالات الأخرى.
- سير عمل Agent طويل المدى: أكمل السلسلة المتصلة «فهم المتطلبات ← تعديل الشيفرة ← تشغيل الاختبارات ← اكتشاف الفشل ← الإصلاح ← إعادة التحقق»، وراقب ما إذا كان يحافظ على الهدف ويستطيع تعديل استراتيجيته بناءً على رسائل الخطأ.
- الاطلاع على الوثائق عبر الإنترنت: بعد قراءة أحدث وثائق SDK، رحّل جزءًا من شيفرة API قديمة، وراقب ما إذا كان يستطيع فعلًا جلب النص الأساسي عبر الإنترنت، وما إذا كان يطبق API الجديد في الشيفرة، وما إذا كان يميز بين «عدم توفر الأداة» و«نتائج البحث فارغة».
6.2 تسجيل معدل النجاح والزمن والتكلفة
يخضع كل تركيب من «النموذج + Harness» لنفس مجموعة المهام، مع تكرارها ثلاث مرات على الأقل وأخذ المتوسط، مع تسجيل المؤشرات التالية بشكل موحد:
| المؤشر | طريقة الحساب أو القياس |
|---|---|
| معدل نجاح المهام | عدد المهام المكتملة بنجاح / إجمالي عدد المهام |
| معدل النجاح من المحاولة الأولى | نسبة النجاح من محاولة واحدة دون تصحيح يدوي |
| إجمالي زمن المهمة | من إرسال المهمة حتى نجاح التحقق النهائي |
| عدد استدعاءات النموذج | عدد طلبات API المتراكمة لكل مهمة |
| عدد استدعاءات الأدوات | عدد استدعاءات القراءة والتحرير وShell والبحث وغيرها |
| استخدام الـ Token | تفصيل استهلاك المدخلات والمخرجات وإصابات الذاكرة المؤقتة والاستدلال |
| التكلفة الفعلية للمهمة | التكلفة الحقيقية لإكمال مهمة ناجحة واحدة |
| عدد التدخلات اليدوية | عدد مرات الضبط والإصلاح اليدوي من المستخدم |
لجعل التجربة قابلة للتكرار، ثبّت المتغيرات التالية: نفس لقطة مستودع الشيفرة، ونفس إصدار Harness، ونفس مستوى الاستدلال أو إعدادات التفكير، ونفس الفترة الزمنية (وهو أمر مهم خصوصًا للنماذج ذات التسعير حسب فترات الذروة والانخفاض مثل DeepSeek). قبل بدء كل مهمة، أعد ضبط المستودع إلى اللقطة، لتجنب تأثير تعديلات الجولة السابقة على الجولة التالية.
6.3 اعتبار تكلفة المهمة الناجحة الواحدة مؤشر الشراء الأساسي
طريقة الحساب الموصى بها هي: تكلفة المهمة الناجحة الواحدة = إجمالي تكلفة جميع المحاولات ÷ عدد المهام الناجحة. يجب تضمين تكلفة المحاولات الفاشلة، لأنها تستهلك أيضًا من الرصيد.
ليس بالضرورة أن يكون النموذج ذو السعر المنخفض أرخص. فإذا كان النموذج يحتاج إلى جولات استدلال أكثر، وإعادة تعديل وتجربة مرارًا، أو تدخل بشري متكرر، فقد يتجاوز إجمالي استهلاكه لإنجاز مهمة ما تكلفة نموذج أعلى سعرًا ينجح من المحاولة الأولى. وبالمقابل، في المهام البسيطة والمتكررة، غالبًا ما يحقق انخفاض سعر نماذج فئة Flash وسرعتها وفرًا حقيقيًا. وعند حساب التكلفة «لكل مهمة ناجحة»، يمكن وضع النوعين من النماذج على المقياس نفسه للمقارنة.
💰 اقتراح لتقييم التكلفة: القنوات ذات الفوترة حسب الاستخدام هي الأنسب لهذا النوع من التجارب، لأن بنود Token وتكلفة كل طلب يمكن التحقق منها طلبًا بطلب. ومن خلال APIYI apiyi.com، يمكن استدعاء عدة نماذج بمفتاح واحد، وجمع فواتير النماذج المختلفة في لوحة خلفية واحدة لحساب تكلفة المهمة الناجحة الواحدة.
7 سيناريو APIYI: جعل النموذج مكوّنًا قابلًا للاستبدال
تشير التحليلات السابقة إلى الاستنتاج نفسه: بيئة برمجة بالذكاء الاصطناعي مستقرة ينبغي أن تثبت Harness، وتتعامل مع النموذج كمكوّن قابل للاستبدال. يتولى Codex أو OpenCode التنفيذ وإدارة الحالة، وتتولى قناة API توفير النموذج، ويتم تبديل النموذج بمرونة وفق صعوبة المهمة والميزانية.
يؤدي APIYI apiyi.com في هذه البنية دور طبقة الوصول الموحدة: مفتاح API واحد لاستدعاء النماذج الشائعة مثل OpenAI وClaude وGemini، وواجهة متوافقة مع بروتوكول OpenAI، وفوترة حسب الاستخدام. وبالنسبة لمستخدمي البرمجة، قبل اختيار أي قناة API (بما فيها APIYI)، يُنصح بالتحقق بندًا بندًا من المحتوى التالي:
- هل تدعم Responses API وأحداث البث التي يتطلبها إصدار Codex الحالي.
- معرّفات النماذج الفعلية المدرجة في لوحة التحكم، وما إذا كان النموذج المستهدف متاحًا.
- هل يمكن أن تكتمل دورة الذهاب والعودة في استدعاء الأدوات وFunction Calling بالكامل.
- هل يلبي زمن الاستجابة وسرعة الإخراج المستمرة احتياجات المهام الطويلة.
- هل يتم التعرف على استخدام ذاكرة التخزين المؤقت بشكل صحيح وفوترة بنوده بشكل منفصل.
هذه المعلومات تُعتمد على لوحة تحكم الخدمة والوثائق التقنية، ويمكن استخدام سكربت الفحص من القسم 5.3 مباشرة للتحقق. عند التنفيذ الفعلي، من الشائع استخدام باقة الاشتراك الشهري في المسار A للمهام اليومية المتكررة، واستخدام القناة حسب الاستخدام للمسائل الأصعب التي تحتاج إلى نماذج أقوى واختبارات المقارنة، مع كتابة المزوّدين معًا في ملف config.toml نفسه، والتبديل عبر --profile أو تعديل model_provider.
8 الأسئلة الشائعة
س1: عند إعادة إنتاج Astra + Codex داخل الصين، أي مسار يوفّر أعلى درجة محاكاة؟
أعلى درجة محاكاة تأتي من المسار C: واجهة Codex CLI الأصلية مع API حقيقي وقابل للاستخدام لـ GPT-6 Astra، بحيث يبقى المكوّنان الأساسيان — النموذج وHarness — محفوظين. الشرط الأساسي أن تكون القناة موثّقة بأنها توفّر النموذج الأصلي وتدعم بروتوكول Responses واستدعاء الأدوات بشكل كامل. أما إذا كان المطلوب تعريب النموذج (استخدام نموذج محلي)، فإن المسار A هو الخيار الأفضل لمحاكاة تجربة تنفيذ Codex.
س2: هل يصلح Qwen4-Max-Preview للاستخدام طويل الأمد داخل Codex؟
يصلح للتجربة الحالية. هذا النموذج متاح فقط ضمن Token Plan في منصة بايليان، وسيُوقف بعد انتهاء فترة المعاينة في 25 نوفمبر 2026 الساعة 24:00. يُنصح باستغلال فترة المعاينة لإتمام مهام الاختبار، مع تجهيز نموذج بديل متاح على المدى الطويل لبيئة الإنتاج.
س3: لماذا لا يتصل إصدار Codex الجديد بإصدار Coding Plan القديم في Alibaba Cloud؟
منذ الإصدار 0.94.0 أصبح Codex يتطلب Responses API، بينما يعتمد إصدار Coding Plan القديم على بروتوكول Chat Completions، ويشترط الدليل الرسمي استخدام Codex 0.93.0 أو إصدار أقدم. وللاتصال بإصدار Codex الجديد، انتقل إلى Token Plan واضبط `wire_api = “responses”`، مع ملاحظة أن Token Plan يستخدم مفتاح API مستقلًا.
س4: هل يمكن مقارنة Credits في بايليان بنقاط TokenHub مقارنة مباشرة؟
لا يمكن المقارنة المباشرة. فكل منهما وحدة قياس خاصة بمنصته، كما يختلف معدل الخصم من نموذج لآخر. الطريقة الأكثر موثوقية هي تنفيذ المهمة نفسها على المنصتين، ثم مقارنة «نسبة حصة الباقة التي تستهلكها مهمة ناجحة واحدة من الاشتراك الشهري».
س5: كيف أتحقق بسرعة من قدرة قناة طرف ثالث على تشغيل Codex؟
ابدأ بإرسال طلب Responses واحد يتضمن أداة function باستخدام سكربت Python الوارد في القسم 5.3، وتأكد من عودة عنصر الإخراج `function_call` ومن أن إحصاءات الاستخدام مفصّلة بشكل طبيعي، ثم اربط Codex ونفّذ مهمة كاملة تتضمن اختبارات. بعد التسجيل في APIYI على apiyi.com يمكنك الحصول على حصة اختبار مجانية لإتمام هذه الخطوة، والنماذج المتاحة فعليًا تُحدد وفق لوحة التحكم.
س6: هل من الطبيعي أن يختلف أداء النموذج نفسه بين OpenCode وCodex؟
نعم، طبيعي. فـ Harness هو ما يحدد استراتيجية قراءة الشيفرة وحلقة الأدوات وضغط السياق وعادات الاختبار، وكلها تغيّر الأداء الفعلي للنموذج. عند المقارنة ينبغي تثبيت Harness واختبار النموذج، أو تثبيت النموذج واختبار Harness، لتجنّب تغيّر متغيّرين في الوقت ذاته.
س7: عند استخدام Codex عبر مفتاح API، هل أحصل على ميزات Codex الموجودة في اشتراك ChatGPT؟
طريقة مفتاح API توفّر مزيجًا من Codex CLI مع API النموذج فقط. أما مهام Codex السحابية وإصدار سطح المكتب والميزات الحصرية لحساب ChatGPT فتعتمد على تفويض الحساب من OpenAI، ولا تستطيع قنوات API الخارجية توفير هذه المزايا.
س8: عند التبديل بين عدة نماذج، كيف تتحكم في التكلفة الإجمالية؟
قسّم المهام إلى طبقات: المهام الصعبة تُسند إلى نموذج عالي القدرة، والفحوصات بالجملة وإعادة الهيكلة البسيطة تُوكل إلى نموذج بمستوى Flash، والنماذج التي تدعم التسعير حسب وقت الذروة والانخفاض يُنقل عملها غير المتزامن إلى الليل. استخدم مقياس «تكلفة المهمة الناجحة الواحدة» بشكل موحد، والقنوات القائمة على الاستخدام مثل APIYI apiyi.com تسهّل التحقق من الاستهلاك الفعلي لكل نموذج سطرًا بسطر.
9 الخلاصة: النقاط الأساسية
- ثلاثة مسارات وثلاثة تركيزات: المسار A يحافظ على تجربة Codex، والمسار B يحافظ على حرية اختيار النموذج، والمسار C يحافظ على النموذج الأصلي.
- Astra + Codex تركيبة من خمس طبقات: النموذج ونظام التنفيذ وبيئة الأدوات وإدارة الحالة وتجربة الاستخدام تحدد النتيجة معًا.
- المسار A له إعداد جاهز: يوفر كل من بايليان وTokenHub إعداد Codex الرسمي، والجوهر هو
wire_api = "responses". - Qwen4-Max-Preview له موعد نهائي: مقتصر على Token Plan، وينتهي العرض الترويجي ويُسحب في 2026-11-25 24:00.
- وحدات الباقات لا تُقارن مختلطة: Credits والنقاط وToken واليوان الصيني تنتمي إلى أنظمة قياس مختلفة، ولا يمكن المقارنة إلا بالقياس الفعلي حسب المهمة.
- دع المهام تتحدث: خمسة أنواع من المهام الحقيقية وثمانية مؤشرات، مع اتخاذ تكلفة المهمة الناجحة الواحدة أساسًا للشراء.
- اجعل النموذج مكوّنًا قابلًا للاستبدال: ثبّت Harness، ووحّد قنوات الوصول، وبدّل النماذج حسب المهمة، عندها تصبح البيئة مستقرة وقابلة للتحكم.
الطريقة العملية الأكثر واقعية للبدء هي إعداد مزوّدين (Provider) اثنين داخل بيئة Codex نفسها: أحدهما باقة سحابية محلية تتولى المهام اليومية، والآخر قناة قائمة على الاستخدام تتولى اختبارات المقارنة والمهام عالية الصعوبة، ثم تشغيل دورة باستخدام طريقة القسم 6، وبعدها تحديد التركيبة طويلة الأمد. يُنصح ببناء مجموعة المقارنة بسرعة عبر APIYI apiyi.com، واستخدام واجهة موحدة لوضع النماذج المحلية وسلسلة GPT على المجموعة نفسها من المهام للتحقق.
📚 المراجع
- الوثائق الرسمية لنموذج GPT-6 Astra: مواصفات النموذج ومستويات الاستدلال والتسعير
- الرابط:
developers.openai.com/api/docs/models/gpt-6-astra -
الوصف: نافذة السياق، والحد الأقصى للإخراج، ودعم الأدوات، وأسعار السياق الطويل
-
OpenAI Codex Harness: تصميم إطار تنفيذ Codex
- الرابط:
developers.openai.com/blog/codex-as-a-platform -
الوصف: شرح رسمي لحلقة الوكيل، وإرجاع نتائج الأدوات، وإدارة السياق، وبيئة العزل (sandbox)
-
تكامل Codex مع Alibaba Cloud Model Studio: طريقة إعداد Token Plan
- الرابط:
help.aliyun.com/zh/model-studio/codex -
الوصف: حقول config.toml، وبروتوكول Responses، ومتطلبات الإصدار
-
Token Plan الإصدار الشخصي من Alibaba Cloud: أسعار الباقات وCredits
- الرابط:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
الوصف: الفئات والحدود وعروض الشراء الأول بعد تعديل 2026-11-09
-
الوثائق الرسمية لـ Qwen4-Max-Preview: مواصفات النموذج وفترة المعاينة
- الرابط:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
الوصف: سياق 1M، والتوافق مع البروتوكول، وموعد الإيقاف
-
إعداد Codex CLI على Tencent Cloud TokenHub: دليل تكامل رسمي
- الرابط:
cloud.tencent.cn/document/product/1823/130071 -
الوصف: إعداد Provider وطريقة استبدال معرّف النموذج
-
باقات Tencent Cloud TokenHub ومعدلات النقاط: قواعد الفوترة
- الرابط:
cloud.tencent.cn/document/product/1823/130060 - الرابط:
cloud.tencent.com/document/product/1823/133811 -
الوصف: فئات الباقات، ومعدلات نقاط النماذج، والتسعير حسب أوقات الذروة وخارجها
-
مستودع OpenCode الرسمي: وكيل برمجة مفتوح المصدر
- الرابط:
github.com/anomalyco/opencode -
الوصف: إعداد Provider وملاحظات الأمان
-
Qwen Code وKimi Code CLI وDeepSeek Harness: أطر تشغيل أصلية
- الرابط:
help.aliyun.com/zh/model-studio/qwen-code - الرابط:
github.com/MoonshotAI/kimi-code - الرابط:
help.aliyun.com/zh/model-studio/deepseek-harness - الوصف: التثبيت والتكامل ونطاق الإمكانات
المؤلف: فريق APIYI التقني
التواصل التقني: نرحب بتواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد التكامل يمكنكم زيارة مركز وثائق docs.apiyi.com


