
Resumo: comparamos em três camadas — modelo, agente de programação e canal de API — as combinações disponíveis no mercado chinês e, em seguida, usamos tarefas reais de programação, custo e compatibilidade para escolher a solução de reprodução que faz mais sentido para você.
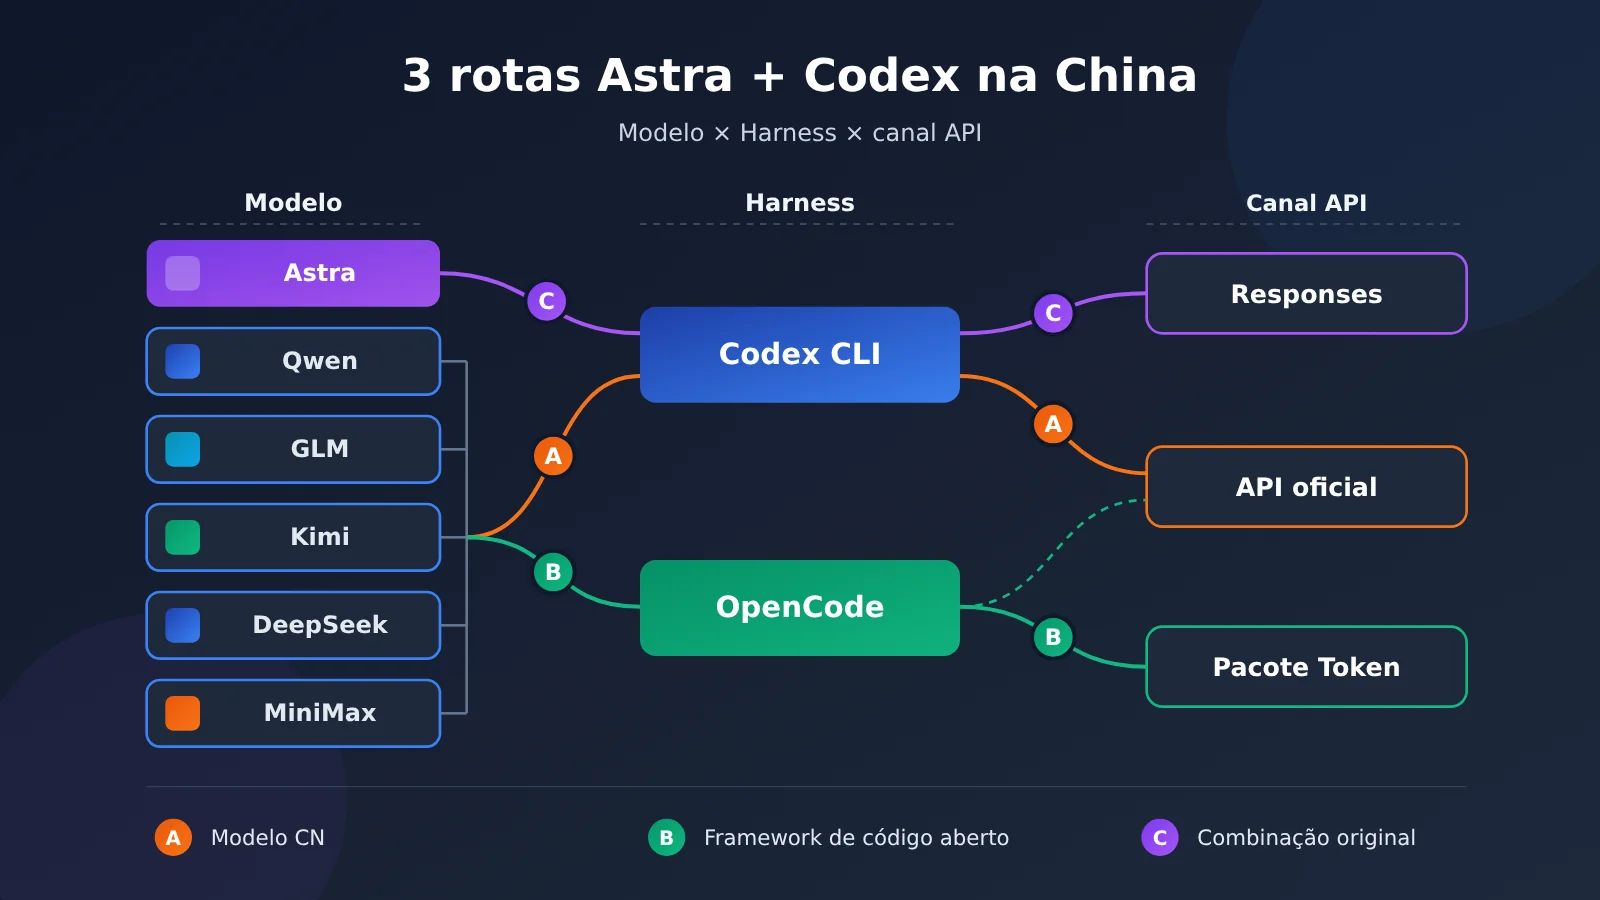
Para reproduzir o Astra + Codex ao máximo dentro da China, há três rotas que vale a pena testar. Rota A: manter o Codex CLI original e conectar modelos nacionais de ponta por meio das interfaces compatíveis com Responses do Alibaba Cloud Bailian ou do Tencent Cloud TokenHub — essa rota preserva a experiência de execução do Codex. Rota B: trocar para um Harness aberto, como o OpenCode, e conectar vários modelos nacionais — essa rota entrega a maior liberdade de escolha de modelo. Rota C: desde que dentro da legalidade e da conformidade e com o serviço realmente disponível, manter o modelo GPT-6 Astra e conectar o Codex original por um canal de API com suporte completo ao protocolo Responses — essa rota tem o maior grau de fidelidade à combinação original.
Se a exigência é usar modelos nacionais, a rota A é o ponto de partida — mas atenção: o Qwen4-Max-Preview só fica disponível até 25 de novembro de 2026, às 24h, então serve para avaliação, não como dependência única de longo prazo. Se a única exigência é funcionar na rede doméstica, sem exigir modelos nacionais, a rota C é a mais próxima do original em inteligência de modelo. A decisão final entre as três rotas deve ser tomada com base na taxa de sucesso, no tempo gasto, no custo e na compatibilidade de ferramentas de um mesmo lote de tarefas reais de programação — e não por rankings ou pelo preço unitário de token.
A seguir, primeiro decompomos o Astra + Codex em cinco componentes de capacidade para deixar claro o que “reproduzir” significa de fato; depois apresentamos as duas configurações oficiais de acesso da rota A, com comparação de planos, os quatro Harness da rota B e os modelos nacionais que merecem ser testados primeiro; em seguida, uma tabela geral reúne o trade-off das três rotas; e, por fim, apresentamos um método de teste reproduzível com cinco tipos de tarefa, usando o “custo por tarefa concluída com sucesso” como métrica central na escolha.
Para saber: noções básicas de terminologia
| Termo | Explicação |
|---|---|
| GPT-6 Astra | Modelo de raciocínio principal da OpenAI, voltado a raciocínio complexo, engenharia de software e tarefas de Agent de longo prazo. O ID do modelo é gpt-6-astra. |
| Codex | Agente de programação da OpenAI que consegue ler projetos, alterar código, executar comandos e validar resultados. |
| Harness | Estrutura de execução que conecta as decisões do modelo às ferramentas reais, responsável pelo loop de ferramentas, contexto, permissões e recuperação de falhas. |
| Responses API | Protocolo de interface da OpenAI que suporta a saída do modelo, o raciocínio e a chamada de ferramentas. A versão nova do Codex depende dele para funcionar. |
| Chat Completions | Protocolo de conversa anterior da OpenAI; a versão antiga do Codex o utiliza. |
| Provider | Provedor que oferece serviços de modelo às ferramentas Agent; no arquivo de configuração, aparece como um conjunto de parâmetros de acesso. |
| Base URL | Endereço base de acesso da API do serviço de modelo; ao trocar de canal, é principalmente ele que se altera. |
| Token Plan | Esquema de cobrança em que provedores de nuvem oferecem cotas mensais de invocação do modelo. |
| Credits / pontos | Unidade de medida usada no pacote para deduzir a cota de invocação; as unidades de fornecedores diferentes não são diretamente conversíveis. |
| Janela de contexto | Limite de conteúdo que o modelo consegue processar em uma única requisição, medido em tokens. |
| Nível de raciocínio | Parâmetro que controla a profundidade de pensamento do modelo; Astra oferece cinco níveis, de low a max. |
| Acerto de cache | Entradas enviadas repetidamente são reutilizadas pelo servidor e cobradas a uma tarifa menor. |
| MCP | Protocolo aberto que conecta aplicações de modelo a ferramentas externas e fontes de dados. |
| Function Calling | Mecanismo pelo qual o modelo emite uma solicitação de chamada estruturada, o aplicativo executa a função e devolve o resultado. |
| Cobrança por horário de pico e fora de pico | Preços variam conforme o período; horários de pico consomem mais cota. |
Conteúdo principal
1 Onde exatamente está a força do Astra + Codex?
1.1 O que o Astra oferece
O GPT-6 Astra é o modelo de raciocínio carro-chefe da OpenAI, e seu posicionamento oficial abrange raciocínio complexo, engenharia de software, modificação de código em múltiplas etapas, operação de navegador e computador, análise de pesquisa e produção de documentos profissionais. O que ele entrega ao Codex é “capacidade de julgamento”: entender bases de código desconhecidas, planejar mudanças, interpretar mensagens de erro e ajustar a estratégia.
As especificações oficiais do modelo (data de verificação das informações: 2026-11-13) são as seguintes:
- Janela de contexto: 1.050.000 tokens; saída máxima: 128.000 tokens.
- Níveis de raciocínio: low, medium, high, xhigh, max.
- Preço padrão (USD / milhão de tokens): entrada $10, saída $50, entrada em cache $1, gravação de cache de 30 minutos $12.50; quando a entrada ultrapassa 272K tokens, aplica-se uma tarifa mais alta de contexto longo.
- Ferramentas da Responses API: Web Search, File Search, Hosted Shell, Apply Patch, Computer Use, MCP, entre outras.
O último item merece uma explicação à parte: essas ferramentas são capacidades oferecidas pela plataforma da OpenAI, e se um cliente ou gateway de terceiros consegue usá-las depende de quais ferramentas ele de fato integra.
1.2 Quais tarefas o Codex executa
No artigo sobre o Codex Harness publicado pela OpenAI em agosto de 2026, o núcleo do Codex é resumido como: loop do agente, compreensão da base de código e operação de arquivos, execução de comandos, chamada de ferramentas e retorno de resultados, gerenciamento de contexto em múltiplas rodadas, aprovação do usuário, limites de segurança do sandbox, além de observação do processo de execução e recuperação de falhas.
A divisão de trabalho é bem clara: o modelo cuida do julgamento e da geração, e o Harness cuida de levar as decisões do modelo até o sistema de arquivos e o terminal reais. Um modelo de chat muito potente só consegue cumprir a tarefa completa de programação — “ler o projeto → alterar o código → rodar os testes → corrigir as falhas → validar de novo” — quando equipado com esse sistema de execução.
1.3 O que se quer reproduzir: o modelo ou o agente inteiro?
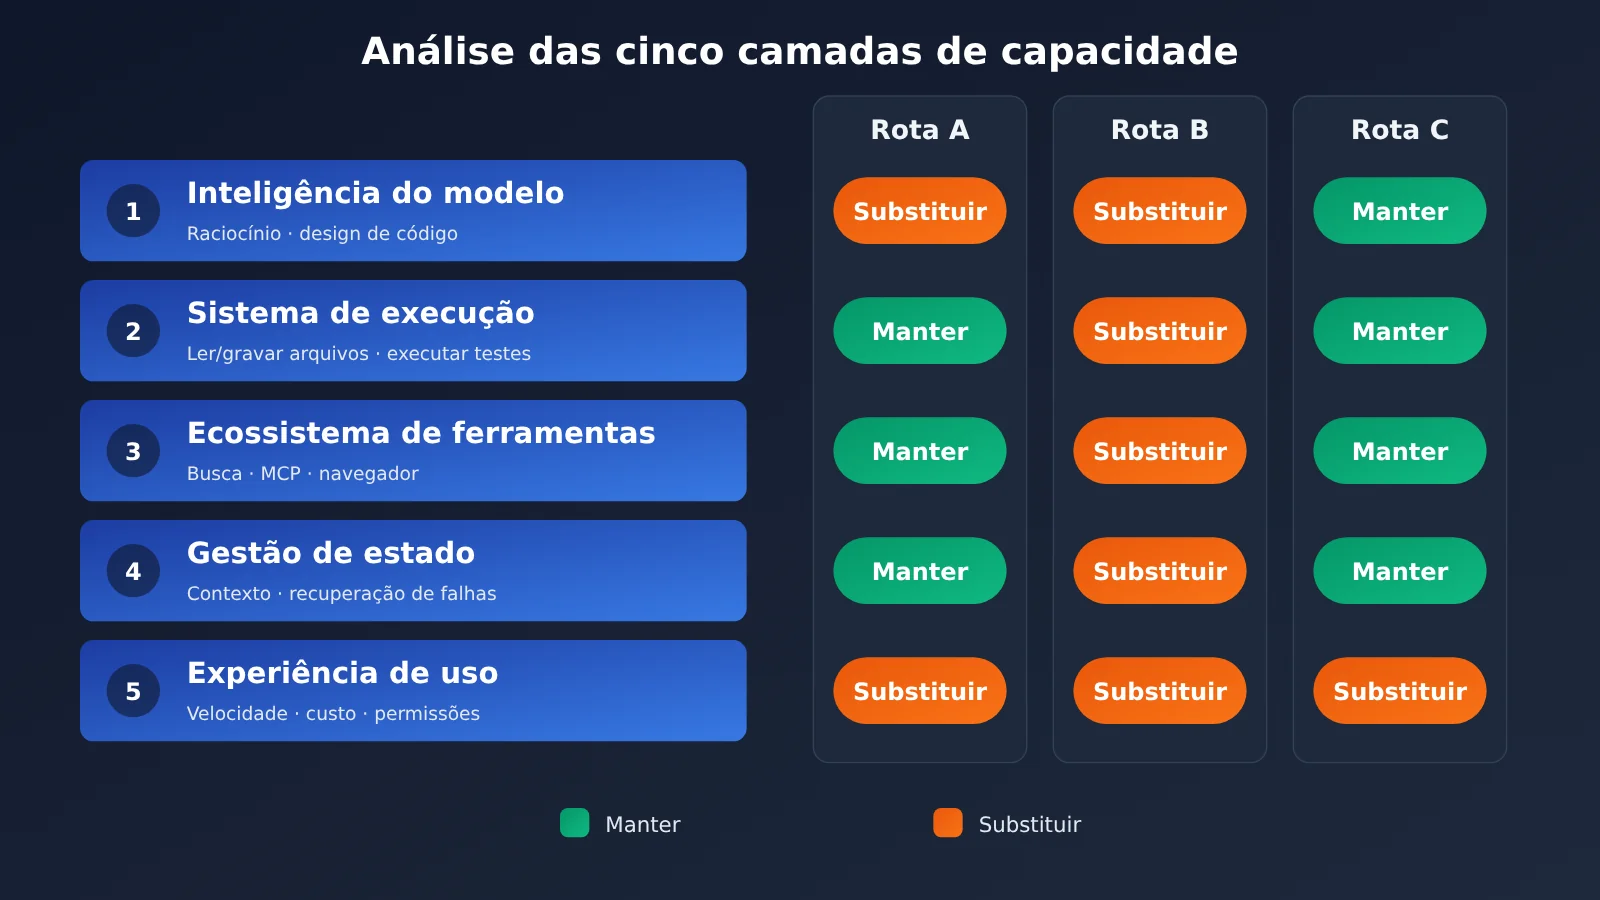
Se decompormos a experiência original, chegamos a cinco componentes:
- Inteligência do modelo: compreensão de tarefas complexas, design de código, raciocínio e depuração.
- Sistema de execução: ler o projeto, editar arquivos, executar comandos, rodar testes.
- Ecossistema de ferramentas: busca na web, leitura de páginas, MCP, processamento de arquivos, operação de navegador.
- Gerenciamento de estado: contexto de tarefas longas, loop de chamada de ferramentas, recuperação de falhas.
- Experiência de uso: velocidade de resposta, estabilidade, custo, controle de permissões e conveniência operacional.
Trocar o modelo altera principalmente o item 1, mas o que o usuário sente no final é a soma dos cinco itens. É justamente aí que ficam as fronteiras entre as três rotas: a rota A substitui o item 1 e mantém os itens 2 e 4; a rota B troca os itens 1, 2 e 4 ao mesmo tempo; a rota C preserva ao máximo os itens 1, 2 e 4, com as diferenças concentradas no item 5 e nos detalhes de protocolo trazidos pelo canal de API.
2 Manter o Codex e integrar modelos nacionais (Rota A)
2.1 Alibaba Cloud Bailian Token Plan + Codex
A Alibaba Cloud já publicou a documentação oficial de integração do Codex. O Token Plan oferece uma interface compatível com Responses, que permite conectar diretamente a nova versão do Codex. No arquivo ~/.codex/config.toml (no Windows, normalmente C:\Users\<nome de usuário>\.codex\config.toml), escreva:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
A variável de ambiente apontada por env_key deve conter a chave API exclusiva do plano Token Plan. Na configuração, há alguns detalhes técnicos que costumam causar dor de cabeça:
- Versão do protocolo: o Codex exige a API Responses a partir da versão 0.94.0. O antigo Coding Plan da Alibaba Cloud usa Chat Completions e, segundo a documentação oficial, deve ser combinado com o Codex 0.93.0 ou anterior; ambientes de manutenção de longo prazo devem escolher o Token Plan.
- Isolamento de chaves: Token Plan, Coding Plan e cobrança por consumo usam três conjuntos diferentes de chaves API.
- Região: o Token Plan atualmente só oferece suporte à região Norte da China 2 (Pequim).
- Metadados do modelo: modelos novos precisam do ID e dos metadados configurados corretamente para terem suporte completo na interface de seleção de modelos do Codex.
O que mais merece atenção no Bailian hoje é o Qwen4-Max-Preview, disponibilizado em 11 de novembro de 2026 (ID do modelo qwen4-max-preview). A documentação oficial confirma que se trata de um modelo multimodal de nova geração da linha de topo, com suporte a desenvolvimento de código, tarefas complexas de agentes, compreensão de imagens e vídeos, raciocínio profundo (ativado por padrão), chamada de ferramentas, pesquisa na web e saída estruturada, além de compatibilidade com os três protocolos OpenAI Chat Completions, Responses e Anthropic Messages. A janela de contexto é de 1M Token e o orçamento máximo de saída é de 393.216 Token, com o raciocínio e a resposta final compartilhando esse mesmo orçamento.
As condições de uso também são bem claras: no momento, ele só está disponível no Token Plan, sem cobrança por consumo; o período de pré-visualização vai de 11 de novembro de 2026, 10:00 (horário de Pequim), até 25 de novembro, 24:00, quando será descontinuado. Na data deste artigo, restam menos de duas semanas de testes, um bom momento para fazer avaliações; ambientes de produção devem preparar também modelos substitutos.
2.2 Tencent Cloud TokenHub + Codex
A Tencent Cloud disponibiliza um tutorial oficial específico para o Codex CLI. No mesmo arquivo de configuração, a sintaxe é:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id deve ser substituído pelo ID exato do modelo atualmente suportado pelo plano. O catálogo do TokenHub inclui GLM-5.3, Kimi K3, a série DeepSeek V4, MiniMax M3, a série Tencent Hunyuan Hy, além de alguns modelos leves e de roteamento automático; o mesmo plano também dá suporte a ferramentas como Claude Code, Cline e OpenClaw.
A vantagem do TokenHub é “uma configuração de Codex, vários modelos nacionais”: basta alterar uma linha de model para que o mesmo Harness rode GLM, Kimi, DeepSeek e MiniMax em sequência, o que é ótimo para comparações horizontais. O catálogo, as versões e as políticas de cota são ajustados dinamicamente; antes de cada teste, vale consultar o ID do modelo listado no console.
2.3 Quais são as diferenças entre os dois planos
Ambos se chamam Token Plan, mas usam unidades de medida diferentes: o Bailian usa Credits, enquanto o TokenHub usa pontos — não há conversão direta entre eles. Os dados da tabela abaixo são referentes a 2026-11-13, e todos os preços estão em RMB/mês:
| Dimensão de comparação | Token Plan do Alibaba Cloud Bailian (versão pessoal) | Token Plan geral do Tencent Cloud TokenHub (versão pessoal) |
|---|---|---|
| Níveis e mensalidade | Lite ¥39, Essential ¥79, Standard ¥139, Pro ¥312 | Lite ¥39, Standard ¥99, Pro ¥299, Max ¥599 |
| Cota mensal | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 pontos |
| Agentes simultâneos recomendados | 1—2 / 2—3 / 3—4 / 6—8 | A documentação não traz métricas equivalentes |
| Descontos e benefícios | Lite e Essential: primeira compra para novos usuários por ¥19.5 e ¥39.5 (até 2026-11-30); Standard e Pro incluem benefícios do AgentStudio Harness | Tarifas de dedução promocionais por tempo limitado para alguns modelos; referência para compra de pontos: ¥1 = 20 pontos |
| Protocolo de integração do Codex | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| Modelos representativos | Série Qwen, incluindo o Qwen4-Max-Preview, exclusivo do Token Plan | GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3 e Hunyuan Hy |
| Forma de cobrança | Credits debitados por modelo | A partir de 2026-08-31, dedução por pontos, com taxas diferentes entre modelos |
| Restrições de uso | Somente na região China North 2 (Pequim); o pacote de programação interativa não deve ser usado diretamente para automação de backend comercial de qualquer tipo | A biblioteca de modelos e as promoções podem sofrer ajustes |
Ao comparar esses dois planos, ordenar pelo valor mensal não diz muita coisa; o ponto principal é “quanta cota é debitada por tarefa concluída com o modelo que eu quero usar, dentro deste plano”. O valor do Bailian está concentrado no ecossistema Qwen e no Qwen4-Max-Preview, que no momento é exclusivo; o valor do TokenHub está em compartilhar uma mesma cota entre vários modelos chineses.
O TokenHub divulga as taxas de dedução de pontos de cada modelo. A seguir estão algumas tarifas promocionais por tempo limitado consultadas em 2026-11-13, já convertidas para RMB por milhão de tokens com base em ¥1 = 20 pontos:
| Modelo | Entrada normal | Saída | Entrada com cache hit | Observações |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | Ao fim da promoção, volta ao preço de tabela |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | Para cenários em que velocidade e custo são críticos |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | Ao fim da promoção, volta ao preço de tabela |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | Modelo voltado para código |
| DeepSeek V4.1 Flash (fora de pico) | ¥0.40 | ¥1.60 | ¥0.008 | Cobrança por pico/fora de pico |
| DeepSeek V4.1 Flash (pico) | ¥0.80 | ¥3.20 | ¥0.016 | Dias úteis, 09:00—12:00 e 14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | Preço para entrada ≤ 512K tokens |
É preciso ler esta tabela junto com dois pontos. Primeiro, a assinatura mensal é cobrada pelo valor mensal do plano; os valores na tabela são o valor de referência dos pontos, usados para comparar a taxa de consumo entre os modelos. Segundo, a cobrança por pico e fora de pico do DeepSeek entrou em vigor em 30 de outubro de 2026; o consumo em horário de pico é cerca de duas vezes o consumo fora de pico, e rodar à noite, em lote, tarefas assíncronas como verificação de código e análise de testes pode economizar bastante cota.
Vamos fazer uma conta com o GLM-5.3: uma tarefa grande de código que consome, no total, 100.000 tokens de entrada normal, 300.000 tokens de cache hit e 30.000 tokens de saída corresponde a 0,1 × ¥4,40 + 0,3 × ¥1,10 + 0,03 × ¥15,40 ≈ ¥1,232 em valor de referência de créditos. O cache hit responde pela maior parte da entrada — exatamente o formato típico de tarefas de agente — e mostra como a tarifa de cache pesa bastante no custo total de cenários de programação.
3 Trocando de Harness: dá para chegar mais perto de Astra + Codex? (Rota B)
3.1 OpenCode: o destaque é a liberdade para usar vários modelos
O OpenCode é um agente de programação com IA de código aberto que aceita uma grande variedade de provedores de LLM: use /connect para adicionar um provedor, /models para trocar de modelo, e ele aceita Base URL personalizada e modelos locais. Pode ser usado no terminal, no desktop e em alguns ambientes de desenvolvimento, com recursos de busca e edição de arquivos, execução de comandos e fluxos de trabalho de agente. A Alibaba Cloud já oferece instruções oficiais de integração; basta selecionar Alibaba Token Plan (China) para usar o plano Bailian.
O aviso de segurança oficial do OpenCode merece ser levado a sério: o agente local padrão não tem isolamento de segurança em nível de sistema, e a aprovação de permissões não substitui um contêiner ou uma máquina virtual. Ao rodar código não confiável ou tarefas de automação com privilégios elevados, execute dentro do Docker ou de uma máquina virtual.
3.2 Qwen Code, Kimi Code e DeepSeek Harness
Os três Harnesses nativos atendem, cada um, ao seu ecossistema de modelos:
- Qwen Code: a Alibaba Cloud oferece três formatos — CLI, desktop e IDE. Basta fazer login no Bailian, escolher a região e inserir a chave API para conectar; ele tem busca no repositório de código, edição de arquivos e execução de comandos. Equipes que usam principalmente os modelos Qwen e querem reduzir a adaptação de protocolo devem priorizá-lo.
- Kimi Code CLI: ferramenta de codificação no terminal mantida pela Moonshot AI, com suporte a leitura e edição de código, chamadas ao Shell, obtenção de conteúdo da web, restauração de sessão, modos de planejamento e aprovação, integração com editores, além de permitir configurar modelos compatíveis de terceiros. No Windows, a instalação é feita pelo script oficial do PowerShell e depende do Git Bash do Git for Windows; a versão antiga do Kimi CLI teve a manutenção encerrada em setembro de 2026, então novos usuários devem usar diretamente o Kimi Code CLI.
- DeepSeek Harness: estrutura de agente de código aberto que oferece tanto Web UI quanto CLI, com suporte a provedores personalizados e configuração de ferramentas, e pode se conectar a diferentes planos de cobrança do Bailian. Inicie com
npx @deepseek-ai/dsh web; o endereço padrão éhttp://127.0.0.1:3080. Ao escolhê-lo, avalie com atenção a estabilidade da execução de ferramentas, o controle de permissões e a adaptação ao protocolo do modelo alvo.
3.3 Por que o Harness afeta o desempenho do modelo
O mesmo modelo colocado em Harnesses diferentes pode apresentar resultados muito distintos. O motivo é que o Harness determina “o que o modelo vê, o que consegue fazer e o que acontece depois de errar”:
- Estratégia de leitura de código: quantos arquivos são lidos de uma vez e em que ordem a busca é feita determina se a compreensão do modelo sobre o projeto é completa.
- Design do ciclo de ferramentas: como os resultados das ferramentas são devolvidos e se há nova tentativa automática após falhas determina se tarefas longas conseguem terminar.
- Compactação de contexto: quais históricos são mantidos e quais detalhes são descartados em sessões longas afeta diretamente se o modelo “esquece o objetivo”.
- Patches e testes: usar sobrescrita do arquivo inteiro ou patch diff, e se os testes são executados por padrão após as alterações, determina a precisão das mudanças e o risco de regressão.
Portanto, o desempenho medido na Rota B é o desempenho da combinação “modelo + esse Harness”. Ao compará-lo com a Rota A, lembre-se de que as estratégias de execução dos dois lados já são diferentes por si só.
4 Quais modelos nacionais vale a pena testar?
4.1 Qwen4-Max-Preview
Pelas especificações públicas, janela de contexto de 1M, budget compartilhado de 393.216 Tokens entre raciocínio e saída, chamada de ferramentas e saída estruturada fazem dele um bom candidato para testar codificação complexa, análise de contexto longo e fluxos de trabalho de Agent multi-turno. Ele é compatível tanto com Responses quanto com Anthropic Messages, então dá para conectá-lo ao Codex e também a ferramentas do tipo Claude Code.
A janela de tempo é a primeira restrição na hora de escolhê-lo: a prévia termina e sai do ar em 2026-11-25 às 24:00. A recomendação é usar esse período para rodar a bateria completa de tarefas de teste e guardar os resultados como referência para os modelos Qwen oficiais que vierem depois, configurando em paralelo um modelo alternativo de disponibilidade permanente para o ambiente de produção.
4.2 GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3
As quatro séries estão dentro de um único pacote do TokenHub, e distribuir por tipo de tarefa é o caminho mais simples:
- Lógica complexa e modificações em múltiplos arquivos: GLM-5.3, Kimi K3 e DeepSeek V4-Pro formam o grupo de alta capacidade para comparação. O Kimi K3 tem o maior preço unitário de saída da tabela, então vale colocá-lo nas tarefas mais difíceis para testar o limite superior.
- Tarefas direcionadas de código: o Kimi K2.7 Code serve especificamente para comparar cenários de modificação de código, e pode ser combinado com o Kimi Code CLI para testar a experiência nativa.
- Tarefas de alta frequência e baixo custo: GLM-5.3-Flash e DeepSeek V4-Flash entram em cenários sensíveis a custo e velocidade, como revisão de código e refatoração em lote.
- Estabilidade em contexto longo e precisão de chamada de ferramentas: o MiniMax M3 entra como candidato, mas atenção: acima do limiar de entrada de 512K o preço sobe.
4.3 Como saber qual está mais próximo do Astra
Comprimento de contexto, número de parâmetros, posicionamento de marketing e preço unitário por Token não permitem ranquear os modelos de forma confiável, e os benchmarks promocionais de fontes diferentes também não são comparáveis entre si. O único jeito confiável de julgar “quem está mais próximo do Astra + Codex” é usar o mesmo Harness e o mesmo lote de tarefas, registrando de forma padronizada a taxa de sucesso, o tempo de execução, o custo em Tokens, a compatibilidade de ferramentas e o número de intervenções humanas. O método detalhado está na seção 6.
5 Três caminhos de reprodução: como escolher na prática?
5.1 Para ter a experiência operacional do Codex original: escolha o caminho A
Mantenha o Codex Harness e conecte-se a serviços chineses com suporte oficial ao protocolo Responses. Para usar Qwen como modelo principal, escolha Bailian; para alternar entre vários modelos chineses, escolha TokenHub. A vantagem é o baixo custo de aprendizado e migração, já que as operações de arquivo e o sistema de execução de agentes continuam sendo os originais. A contrapartida é que a inteligência do modelo difere da do Astra, o nível de implementação da interface compatível afeta a experiência de chamada de ferramentas, e os parâmetros de contexto e de raciocínio de cada modelo precisam ser ajustados individualmente.
5.2 Para ter modelos chineses e liberdade multi-modelo: escolha o caminho B
OpenCode combinado com APIs de vários modelos chineses, complementando com Qwen Code, Kimi Code ou DeepSeek Harness quando necessário. É a opção mais adequada para desenvolvedores que usam vários modelos por longo prazo e não querem se prender a um único fornecedor; também é a mais conveniente para comparar lado a lado o desempenho de diferentes modelos em uma mesma tarefa. O custo é que a estratégia de execução é diferente da do Codex, e a integração com múltiplos provedores traz trabalho extra de configuração e manutenção.
5.3 Para preservar ao máximo as capacidades do Astra: escolha o caminho C
A combinação do caminho C é “Codex CLI original + GPT-6 Astra + um serviço de acesso à API disponível”. Desde que o canal realmente ofereça o GPT-6 Astra original e suporte de forma completa à Responses API, aos eventos de streaming, à chamada de ferramentas e ao gerenciamento de contexto exigidos pelo Codex, será possível manter ao mesmo tempo os dois componentes centrais: o modelo e o Harness. Esse caminho resolve a disponibilidade de rede; ele e a substituição por modelos nacionais são duas coisas diferentes.
Tomando o APIYI como exemplo, a forma de integração é exatamente a mesma do caminho A; basta trocar um conjunto de configurações de provedor:
model_provider = "APIYI"
model = "gpt-6-astra"            # use o ID de modelo realmente listado no console do APIYI
model_reasoning_effort = "high"  # ajuste na faixa low ~ max conforme a dificuldade da tarefa

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Antes de integrar, é recomendável usar um script para confirmar que o canal realmente suporta o protocolo Responses e a chamada de ferramentas, em vez de apenas retornar texto comum:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # substitua pelo ID de modelo disponível no console
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# Em condições normais, deve retornar um item de saída do tipo function_call, com parâmetros estruturados
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # confira se os tokens de entrada, saída, cache e raciocínio são contabilizados separadamente
Esse teste de sondagem cobre três coisas das quais o Codex mais depende: o protocolo Responses, o retorno de Function Calling e as estatísticas detalhadas de uso. Depois que o script passar, integre-o ao Codex e execute uma tarefa completa que inclua “alterar código + executar testes”, para confirmar que os eventos de streaming e o ciclo de ferramentas em várias rodadas funcionam corretamente.
Mesmo com o mesmo modelo, a experiência do caminho C ainda é afetada pelo roteamento real do modelo, pelo nível de raciocínio, pela latência da API e pela vazão de saída, pelo acerto de cache, pela compatibilidade de protocolo do gateway e pelos custos do canal. A versão desktop do Codex, as tarefas na nuvem e os recursos exclusivos da conta ChatGPT dependem do próprio sistema de autorização da OpenAI; o que se usa por meio de uma chave API é a combinação de Codex CLI com API de modelo. No planejamento, esses recursos devem ficar de fora.
🚀 Sugestão de início rápido: para comparar a Rota A com a Rota C, você pode se registrar no APIYI apiyi.com e resgatar créditos de teste gratuitos, usando o mesmo ambiente Codex para rodar, respectivamente, modelos nacionais e modelos da série GPT. A lista concreta de modelos disponíveis no APIYI e o suporte a protocolos devem ser verificados no console e na documentação em docs.apiyi.com.
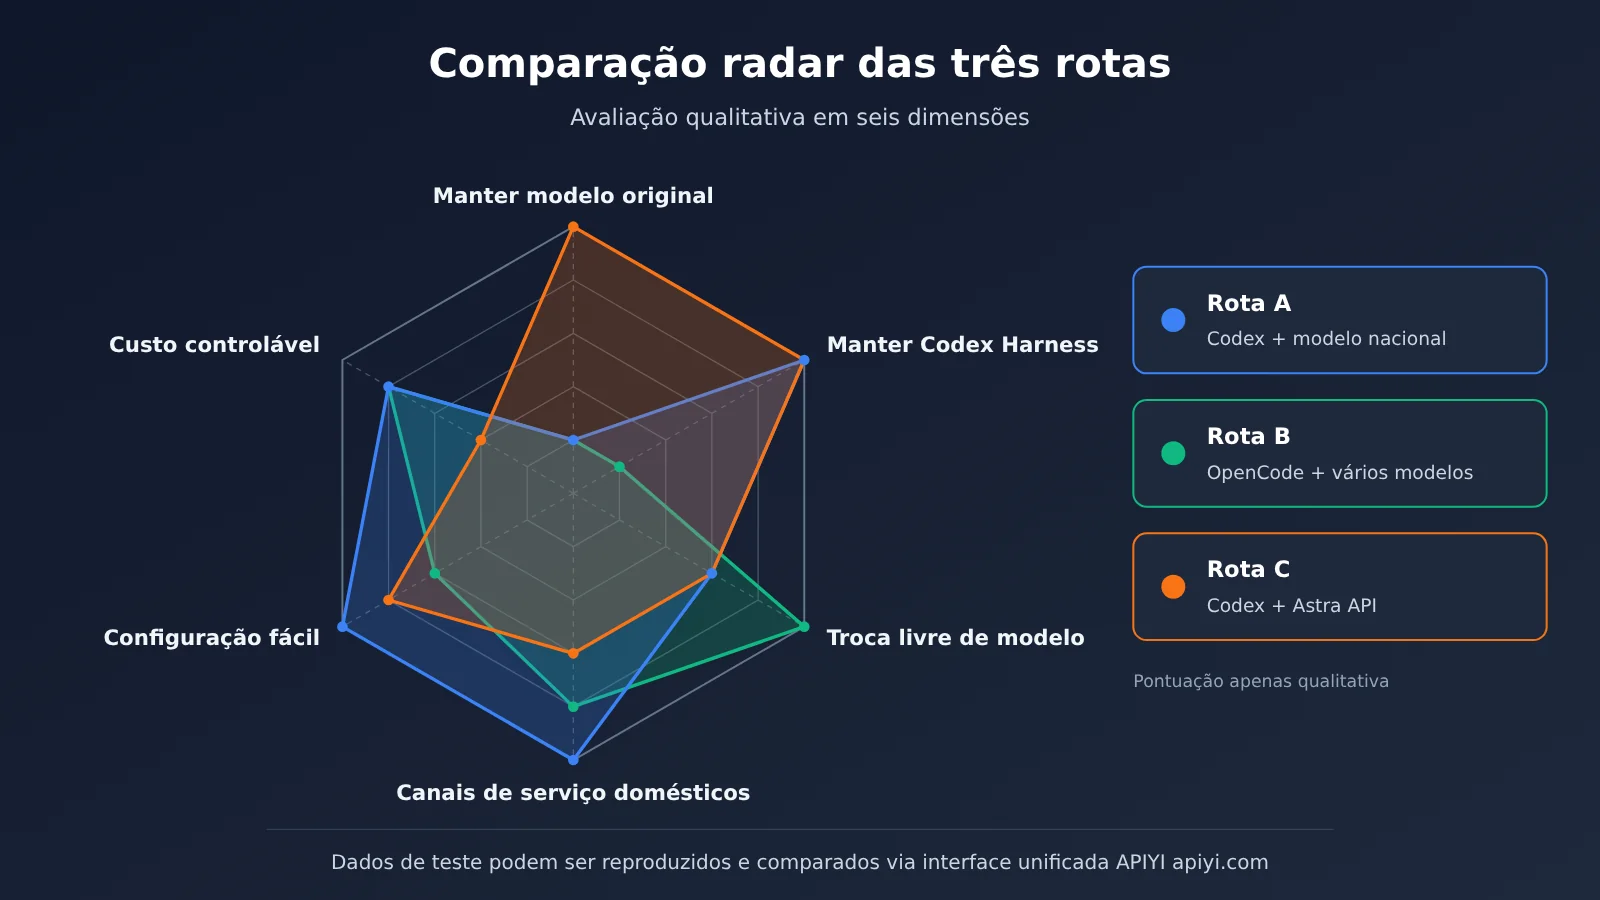
O resumo dos trade-offs das três rotas é o seguinte:
| Dimensão de comparação | Rota A: Codex + modelos nacionais | Rota B: OpenCode e similares + múltiplos modelos nacionais | Rota C: Codex + Astra API |
|---|---|---|---|
| Manter o modelo original | Não; substituído por Qwen / GLM / Kimi etc. | Não | Sim (desde que verificável pelo canal) |
| Manter o Codex Harness | Sim | Não; substituído por um Harness aberto | Sim |
| Troca de modelo | Alterar o ID do modelo na mesma plataforma | Troca livre entre vários Providers | Troca entre os modelos suportados pelo canal |
| Canais de serviço nacionais | Alibaba Cloud Bailian, Tencent Cloud TokenHub | Bailian, TokenHub e outros serviços compatíveis | Canais de terceiros com suporte a Responses, como APIYI apiyi.com |
| Complexidade de configuração | Baixa; a documentação oficial traz configs prontas | Média; é preciso manter várias configurações de Provider | Baixa, desde que o protocolo seja validado antes |
| Formato de custo | Pacote mensal (Credits / pontos) | Pacote ou pagamento por uso, conforme o Provider | Cobrança por uso; o preço unitário do Astra é maior que o da maioria dos modelos nacionais |
| Necessidade atendida | Experiência do Codex original + nacionalização do modelo | Fluxo de trabalho multimodelo de longo prazo | Preservar ao máximo as capacidades originais |
5.4 Limites de rede e segurança no uso local
Fazer a API do modelo passar por endereços acessíveis no país resolve apenas o trecho da invocação do modelo. Durante o trabalho, o Agent também acessa fontes de software como GitHub, npm e PyPI, documentação oficial externa, serviços MCP de terceiros e busca na web; a acessibilidade desses caminhos precisa ser verificada separadamente. A busca online também é uma capacidade independente: a busca integrada dos provedores de nuvem, a ferramenta de acesso à internet nativa do Harness e uma Search API / MCP própria têm, cada uma, as suas restrições de acesso, cobrança e invocação.
Em termos de segurança, um Agent de programação pode modificar arquivos, executar Shell e ler variáveis de ambiente; por isso, recomenda-se fazer o seguinte:
- Guarde a chave API em variáveis de ambiente ou em ferramentas de gerenciamento de credenciais; nunca a escreva no código-fonte nem no repositório Git.
- Faça modificações complexas em um branch Git separado; mantenha o projeto sob controle de versão e com backups restauráveis.
- Limite o acesso do Agent a arquivos sensíveis fora do diretório de trabalho; coloque código não confiável em containers ou máquinas virtuais.
- Mantenha aprovação humana para operações de alto risco, como exclusão, deploy e pagamentos.
6 Testes com tarefas reais valem mais do que os rankings de modelos
6.1 Configurando cinco tipos de tarefas de teste
Usando um projeto real que inclui frontend, backend, testes e configuração de dependências, foram desenhados cinco tipos de tarefas para avaliar, respectivamente, a capacidade do modelo e a capacidade do Harness:
- Compreensão do projeto: pedir para explicar a arquitetura e as relações entre os módulos principais, observando a localização de arquivos, a compreensão de dependências entre arquivos e se ele consegue fornecer referências de caminho verificáveis.
- Desenvolvimento entre arquivos: adicionar uma nova funcionalidade que exige alterações em vários pontos, observando a precisão das modificações, a completude funcional e se introduz regressões.
- Correção de bugs: entregar um projeto com um teste de falha reproduzível e observar se o modelo encontra a causa raiz, corrige o local certo, executa os testes por conta própria e não quebra os demais casos.
- Fluxo de trabalho de agente de longo prazo: completar a cadeia contínua “entendimento do requisito → alteração de código → execução de testes → descoberta de falhas → correção → revalidação”, observando se o objetivo é mantido e se a estratégia é ajustada conforme os erros.
- Consulta de documentação online: depois de ler a documentação mais recente do SDK, migrar um trecho de código que usa a API antiga, observando se ele consegue de fato acessar a internet e extrair o conteúdo, se aplica a nova API ao código e se sabe distinguir “ferramenta indisponível” de “resultado de busca vazio”.
6.2 Registrar taxa de sucesso, tempo e custo
Cada combinação “modelo + Harness” executa o mesmo conjunto de tarefas, com pelo menos três repetições para tirar a média, registrando de forma padronizada as seguintes métricas:
| Métrica | Forma de cálculo ou observação |
|---|---|
| Taxa de sucesso das tarefas | Tarefas concluídas com sucesso / total de tarefas |
| Taxa de acerto na primeira tentativa | Proporção de sucessos de primeira, sem correção manual |
| Tempo total da tarefa | Do envio da tarefa até a validação final bem-sucedida |
| Número de invocações do modelo | Total acumulado de requisições à API por tarefa |
| Número de chamadas de ferramentas | Leituras, edições, Shell, buscas e afins |
| Consumo de tokens | Entrada, saída, acertos de cache e uso de raciocínio, detalhados por item |
| Custo real da tarefa | Custo efetivo para concluir uma tarefa com sucesso |
| Número de intervenções humanas | Quantas vezes o usuário ajustou e corrigiu manualmente |
Para que o experimento seja reproduzível, fixe as seguintes variáveis: o mesmo snapshot do repositório de código, a mesma versão do Harness, o mesmo nível de raciocínio ou configuração de “thinking” e o mesmo período do dia (especialmente importante para modelos com cobrança por pico e fora de pico, como o DeepSeek). Antes de cada tarefa, restaure o repositório ao snapshot para evitar que as alterações da rodada anterior afetem a próxima.
6.3 Usar o custo de uma tarefa bem-sucedida como principal indicador de compra
A forma de cálculo recomendada é: custo por tarefa bem-sucedida = custo total de todas as tentativas ÷ número de tarefas bem-sucedidas. Os custos das tentativas malsucedidas precisam entrar na conta, porque também consumiram créditos.
Preço unitário baixo nem sempre significa modelo barato. Se um modelo precisa de mais rodadas de raciocínio, de alterações repetidas e novas tentativas, ou se exige intervenção humana com frequência, o consumo total para concluir uma tarefa pode superar o de um modelo com preço unitário mais alto que acerta de primeira. Por outro lado, em tarefas simples e de alta frequência, o preço unitário baixo e a velocidade dos modelos da linha Flash costumam gerar economia real. Ao levar o custo para a métrica de “custo por tarefa bem-sucedida”, os dois tipos de modelo passam a ser comparáveis na mesma escala.
💰 Sugestão de avaliação de custo: canais com cobrança por uso são os mais práticos para esse tipo de experimento, porque o detalhamento de tokens e o custo de cada requisição podem ser conferidos item a item. Chamando vários modelos com uma única chave API no APIYI apiyi.com, é possível reunir as faturas de diferentes modelos no mesmo painel e calcular o custo por tarefa bem-sucedida.
7 Cenário APIYI: tornando o modelo um componente substituível
As análises anteriores apontam para a mesma conclusão: um ambiente de programação com IA estável deve fixar o Harness e tratar o modelo como um componente substituível. O Codex ou o OpenCode cuida da execução e do gerenciamento de estado, o canal de API fornece o modelo, e o modelo é alternado com flexibilidade conforme a dificuldade da tarefa e o orçamento.
O APIYI apiyi.com assume, nessa arquitetura, o papel de camada de acesso unificada: uma única chave API para invocar modelos populares como OpenAI, Claude e Gemini, com interface compatível com o protocolo OpenAI e cobrança por uso. Para usuários de programação, antes de escolher qualquer canal de API (incluindo o APIYI), recomenda-se verificar item por item:
- Se há suporte à Responses API e aos eventos de streaming exigidos pela versão atual do Codex.
- Os IDs reais dos modelos listados no console e se o modelo desejado está disponível.
- Se a invocação de ferramentas e o Function Calling conseguem completar o ciclo de ida e volta.
- Se a latência e a velocidade de saída contínua atendem às necessidades de tarefas longas.
- Se o uso de cache é corretamente identificado e cobrado de forma discriminada.
Essas informações devem ser tomadas com base no console do serviço e na documentação técnica, e o script de sondagem da seção 5.3 pode ser usado diretamente para verificação. Na prática, a abordagem comum é usar o pacote mensal da rota A para tarefas diárias de alta frequência e o canal por consumo para problemas difíceis que exigem modelos mais fortes e para testes comparativos, gravando os dois Providers no mesmo config.toml e alternando com --profile ou alterando model_provider.
8 Perguntas frequentes
Q1: Para reproduzir Astra + Codex localmente, qual caminho oferece a maior fidelidade?
O caminho com maior fidelidade é a opção C: Codex CLI original combinado com uma API GPT-6 Astra real e disponível, mantendo os dois componentes centrais — o modelo e o Harness. O pré-requisito é que o canal seja verificável como provedor do modelo original e ofereça suporte completo ao protocolo Responses e à chamada de ferramentas. Se houver a exigência de usar um modelo nacional, o caminho A é a melhor escolha para reproduzir a experiência de execução do Codex.
Q2: O Qwen4-Max-Preview serve para uso prolongado no Codex?
Ele serve para esta avaliação. O modelo é oferecido apenas no Token Plan do Bailian e será descontinuado após o fim do período de prévia, em 25 de novembro de 2026, às 24h. A recomendação é aproveitar a prévia para concluir as tarefas de teste e, ao mesmo tempo, preparar um modelo alternativo de longo prazo para o ambiente de produção.
Q3: Por que o novo Codex não consegue se conectar ao Coding Plan antigo do Alibaba Cloud?
A partir da versão 0.94.0, o Codex exige a Responses API, enquanto o Coding Plan antigo usa o protocolo Chat Completions; a documentação oficial pede o Codex 0.93.0 ou anterior. Basta migrar para o Token Plan e definir `wire_api = “responses”` para conectar o Codex novo. Atenção: o Token Plan usa uma chave API própria.
Q4: Dá para comparar diretamente os Credits do Bailian com os pontos do TokenHub?
Não dá para comparar diretamente. São unidades de medida de plataformas diferentes, e a taxa de dedução varia entre modelos. O caminho mais confiável é rodar a mesma tarefa nas duas plataformas e comparar “a proporção do valor mensal consumida para concluir uma tarefa com sucesso”.
Q5: Como verificar rapidamente se um canal de terceiros consegue rodar o Codex?
Primeiro, use o script Python da seção 5.3 para enviar uma requisição Responses com uma ferramenta function e confirme que a saída traz um item `function_call` e que as estatísticas de uso por categoria estão normais. Depois, conecte o Codex e rode uma tarefa completa que inclua testes. Ao se registrar em APIYI apiyi.com, você pode receber cota gratuita de teste para concluir essa verificação; os modelos disponíveis são os mostrados no console.
Q6: É normal o mesmo modelo se comportar de forma diferente no OpenCode e no Codex?
Sim. O Harness define a estratégia de leitura de código, o loop de ferramentas, a compactação de contexto e os hábitos de teste, e tudo isso altera o desempenho real do modelo. Ao comparar, fixe o Harness para testar o modelo, ou fixe o modelo para testar o Harness, evitando mudar duas variáveis ao mesmo tempo.
Q7: Usando o Codex via chave API, tenho acesso às funcionalidades de Codex da assinatura ChatGPT?
O modo chave API oferece a combinação Codex CLI + API do modelo. Tarefas na nuvem do Codex, o app desktop e os recursos exclusivos da conta ChatGPT dependem da autorização de conta da OpenAI, e canais de API de terceiros não conseguem oferecer esses benefícios.
Q8: Como controlar o custo total ao alternar entre vários modelos?
Estratifique por tarefa: use modelos de alta capacidade para problemas difíceis, deixe verificações em lote e refatorações simples para modelos de nível Flash, e coloque tarefas assíncronas em modelos com cobrança por horário de pico/fora de pico no período noturno. Avalie sempre por “custo por tarefa concluída com sucesso”; canais por consumo, como APIYI apiyi.com, facilitam a conferência item a item do gasto real de cada modelo.
9 Resumo: Principais pontos
- Três caminhos, três focos: o caminho A preserva a experiência do Codex; o caminho B preserva a liberdade de escolha do modelo; o caminho C preserva o modelo original.
- Astra + Codex é uma combinação de cinco camadas: modelo, sistema de execução, ecossistema de ferramentas, gerenciamento de estado e experiência de uso determinam juntos o resultado.
- O caminho A já tem configuração pronta: Bailian e TokenHub oferecem configuração oficial do Codex, e o ponto central é
wire_api = "responses". - Qwen4-Max-Preview tem data limite: exclusivo do Token Plan; a prévia termina e é descontinuada em 2026-11-25 24:00.
- Unidades de planos não podem ser comparadas de forma misturada: Credits, pontos, Tokens e centavos de RMB pertencem a sistemas de medição diferentes; só dá para comparar com testes reais por tarefa.
- Deixe as tarefas falarem: cinco tipos de tarefas reais e oito métricas, usando o custo por tarefa bem-sucedida como base para a compra.
- Transforme o modelo em componente substituível: Harness fixo, canal de acesso unificado e troca de modelo conforme a tarefa; assim o ambiente fica estável e controlável.
A forma mais pragmática de começar é configurar dois Providers no mesmo ambiente Codex: um plano de nuvem nacional para tarefas do dia a dia e um canal sob demanda para testes comparativos e tarefas mais difíceis. Rode uma rodada com o método da seção 6 e depois decida a combinação de longo prazo. Recomenda-se montar rapidamente o grupo de controle via APIYI apiyi.com e validar, com uma interface unificada, modelos chineses e a série GPT no mesmo conjunto de tarefas.
📚 Referências
- Documentação oficial do modelo GPT-6 Astra: especificações do modelo, níveis de inferência e preços
- Link:
developers.openai.com/api/docs/models/gpt-6-astra -
Descrição: janela de contexto, saída máxima, suporte a ferramentas e tarifa de contexto longo
-
OpenAI Codex Harness: design do framework de execução do Codex
- Link:
developers.openai.com/blog/codex-as-a-platform -
Descrição: explicação oficial sobre o loop do Agent, retorno de ferramentas, gestão de contexto e sandbox
-
Integração do Codex ao Bailian (Model Studio) da Alibaba Cloud: método de configuração do Token Plan
- Link:
help.aliyun.com/zh/model-studio/codex -
Descrição: campos do config.toml, protocolo Responses e requisitos de versão
-
Token Plan versão pessoal da Alibaba Cloud: preços dos planos e Credits
- Link:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
Descrição: níveis, cotas e desconto de primeira compra após o ajuste de 2026-11-09
-
Documentação oficial do Qwen4-Max-Preview: especificações do modelo e período de pré-visualização
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
Descrição: contexto de 1M, compatibilidade de protocolo e data de descontinuação
-
Configuração do Codex CLI no TokenHub do Tencent Cloud: tutorial oficial de integração
- Link:
cloud.tencent.cn/document/product/1823/130071 -
Descrição: configuração de Provider e método de substituição do ID do modelo
-
Planos e taxas de pontos do TokenHub do Tencent Cloud: regras de cobrança
- Link:
cloud.tencent.cn/document/product/1823/130060 - Link:
cloud.tencent.com/document/product/1823/133811 -
Descrição: níveis de plano, taxa de pontos por modelo e cobrança por pico/vale
-
Repositório oficial do OpenCode: Coding Agent de código aberto
- Link:
github.com/anomalyco/opencode -
Descrição: configuração de Provider e notas de segurança
-
Qwen Code, Kimi Code CLI, DeepSeek Harness: Harness nativo
- Link:
help.aliyun.com/zh/model-studio/qwen-code - Link:
github.com/MoonshotAI/kimi-code - Link:
help.aliyun.com/zh/model-studio/deepseek-harness - Descrição: instalação, integração e escopo de capacidades
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para nos contatar pela página inicial do site oficial da APIYI; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com


