
Кратко: сравниваем доступные в Китае комбинации на трёх уровнях — модель, агент для программирования и API-канал, — а затем выбираем подходящий вариант воспроизведения по реальным задачам программирования, стоимости и совместимости.
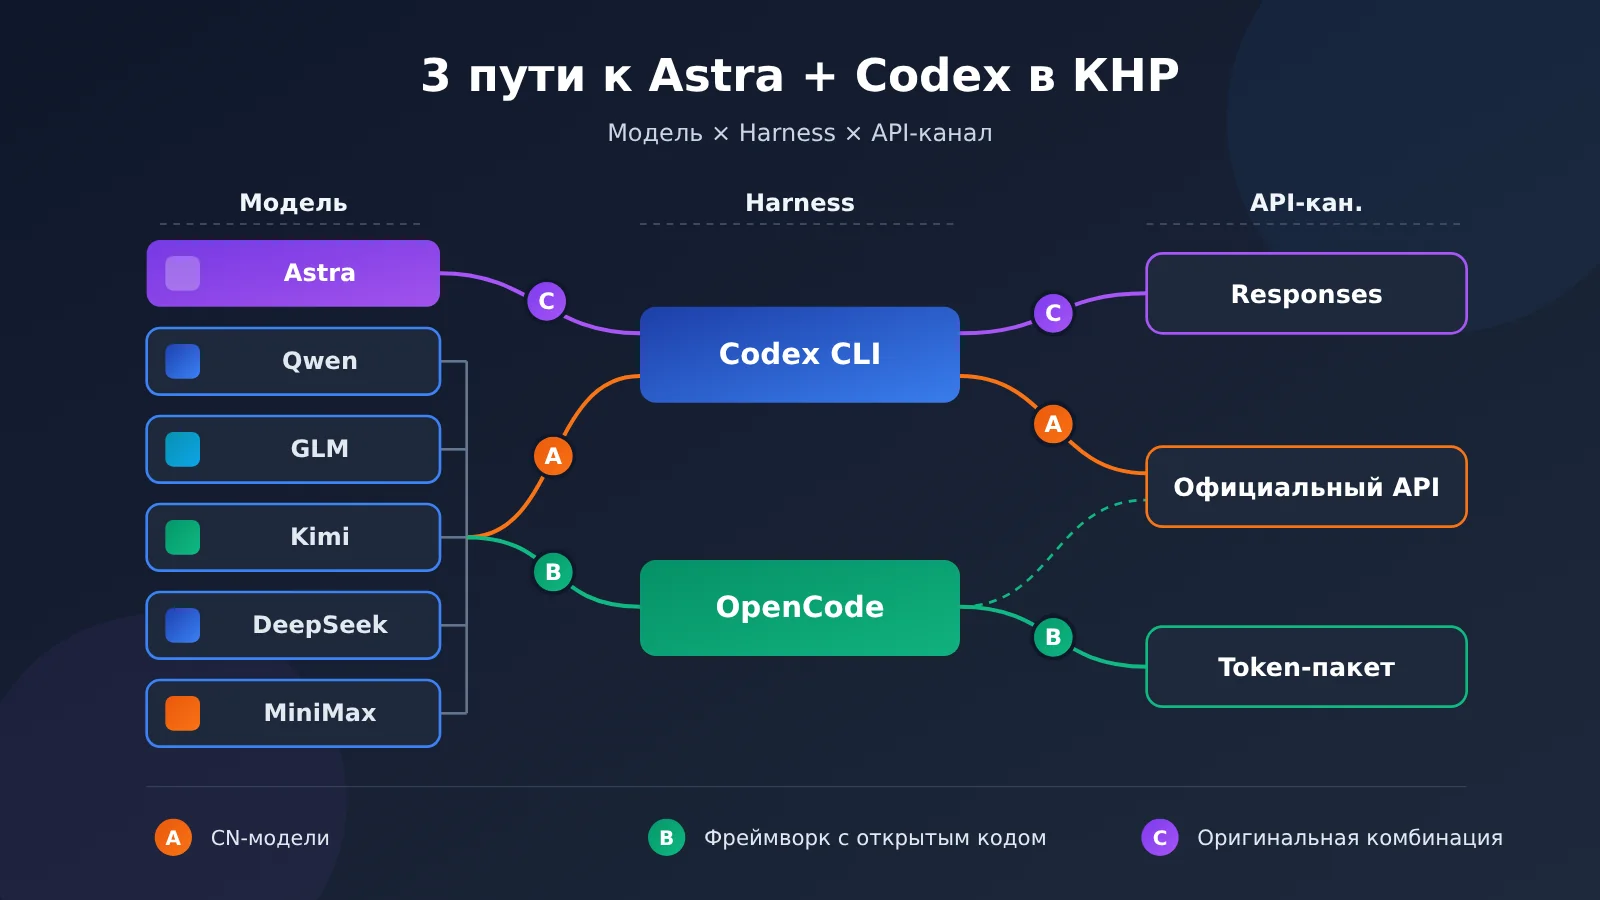
Чтобы максимально точно воспроизвести Astra + Codex в Китае, стоит проверить три маршрута. Маршрут A: сохранить оригинальный Codex CLI и подключить китайские флагманские модели через интерфейс, совместимый с Responses, от Alibaba Cloud Bailian или Tencent Cloud TokenHub — так вы сохраняете привычный процесс работы в Codex. Маршрут B: перейти на открытые Harness вроде OpenCode и подключить несколько китайских моделей — так вы получаете максимальную свободу выбора моделей. Маршрут C: при условии законности и реальной доступности сервиса сохранить модель GPT-6 Astra и подключить её к оригинальному Codex через API-канал с полной поддержкой протокола Responses — этот маршрут даёт максимальную точность воспроизведения исходной комбинации.
Если нужен переход на китайские модели, начните с маршрута A. Правда, Qwen4-Max-Preview доступна только до 24:00 25 ноября 2026 года, так что она подходит для тестов, но не как единственная долгосрочная зависимость. Если достаточно работать из китайской сети и не обязательно использовать китайскую модель, маршрут C по возможностям модели ближе всего к оригиналу. Окончательный выбор между тремя маршрутами должен опираться на успешность, время выполнения, стоимость и совместимость с инструментами на одном и том же наборе реальных задач программирования, а не на рейтинги или цену за токен.
Дальше сначала разложим Astra + Codex на пять функциональных компонентов и объясним, что именно мы воспроизводим. Затем приведём два официальных варианта подключения и сравнение тарифных планов для маршрута A, четыре Harness для маршрута B и китайские модели, которые стоит тестировать в первую очередь. После этого сведём выбор между тремя маршрутами в одну сводную таблицу. В конце дадим воспроизводимую методику тестирования на пяти типах задач, где стоимость одной успешно выполненной задачи будет ключевым показателем при выборе.
Для начала: базовые термины
| Термин | Пояснение |
|---|---|
| GPT-6 Astra | Флагманская модель рассуждений OpenAI, ориентирована на сложные логические задачи, разработку ПО и длительные агентские сценарии. ID модели — gpt-6-astra. |
| Codex | Программирующий агент OpenAI: умеет читать проект, вносить правки в код, выполнять команды и проверять результат. |
| Harness | Исполнительный каркас, который связывает решения модели с реальными инструментами. Отвечает за цикл вызовов инструментов, контекст, права доступа и восстановление после ошибок. |
| Responses API | Протокол интерфейса OpenAI для вывода модели, рассуждений и вызова инструментов. Новая версия Codex работает именно через него. |
| Chat Completions | Более ранний протокол диалогового интерфейса OpenAI; его использует старая версия Codex. |
| Провайдер | Поставщик модельных услуг для агентских инструментов; в конфигурационном файле выглядит как набор параметров подключения. |
| Base URL | Базовый адрес API сервиса модели. При смене канала в первую очередь меняют именно его. |
| Token Plan | Тарифный план облачного провайдера с помесячной квотой на вызовы модели. |
| Credits / баллы | Единица учёта внутри тарифа, которой списывается квота вызовов. Единицы разных провайдеров напрямую не конвертируются друг в друга. |
| Контекстное окно | Максимальный объём контента, который модель обрабатывает за один запрос, измеряется в токенах. |
| Уровень рассуждения | Параметр, задающий глубину размышлений модели. У Astra есть пять уровней — от low до max. |
| Попадание в кэш | Повторно отправленный ввод переиспользуется сервером и оплачивается по сниженному тарифу. |
| MCP | Открытый протокол, соединяющий приложения с моделью и внешние инструменты и источники данных. |
| Function Calling | Механизм, при котором модель выдаёт структурированный запрос на вызов, приложение выполняет функцию и возвращает ей результат. |
| Пиково-непиковая тарификация | Цена зависит от времени суток: в часы пик расходуется больше квоты. |
1. В чём, собственно, сила Astra + Codex?
1.1 Что даёт Astra
GPT-6 Astra — флагманская модель рассуждений OpenAI. Официально её позиционируют для сложных рассуждений, разработки ПО, многошагового изменения кода, работы с браузером и компьютером, исследовательского анализа и создания профессиональных документов. Codex она даёт «способность судить»: понимать незнакомую кодовую базу, проектировать изменения, разбираться в сообщениях об ошибках и корректировать стратегию.
Официальные характеристики модели (данные сверены 2026-11-13):
- Контекстное окно: 1,050,000 Token; максимальный вывод: 128,000 Token.
- Уровни рассуждения: low, medium, high, xhigh, max.
- Стандартная цена (доллары / миллион Token): ввод $10, вывод $50, ввод из кэша $1, запись в кэш на 30 минут $12.50; при вводе свыше 272K Token действует повышенный тариф за длинный контекст.
- Инструменты Responses API: Web Search, File Search, Hosted Shell, Apply Patch, Computer Use, MCP и другие.
Последний пункт стоит понять отдельно: это возможности, которые предоставляет платформа OpenAI, а какие из них окажутся доступны в конкретном клиенте или стороннем шлюзе — зависит от того, какие инструменты он реально интегрировал.
1.2 Какие задачи берёт на себя Codex
В статье OpenAI о Codex Harness, опубликованной в августе 2026 года, суть Codex сведена к циклу агента, пониманию кодовой базы и работе с файлами, выполнению команд, вызову инструментов и возврату результатов, управлению многораундовым контекстом, одобрению пользователем, границам безопасности песочницы, а также наблюдению за ходом выполнения и восстановлению после сбоев.
Разделение ролей понятное: модель отвечает за суждения и генерацию, Harness — за то, чтобы решения модели воплощались в реальной файловой системе и терминале. Даже очень сильная чат-модель только вместе с этой исполнительной системой способна пройти полный цикл «прочитать проект → изменить код → запустить тесты → починить падения → проверить ещё раз».
1.3 Что воспроизводить — модель или всего агента
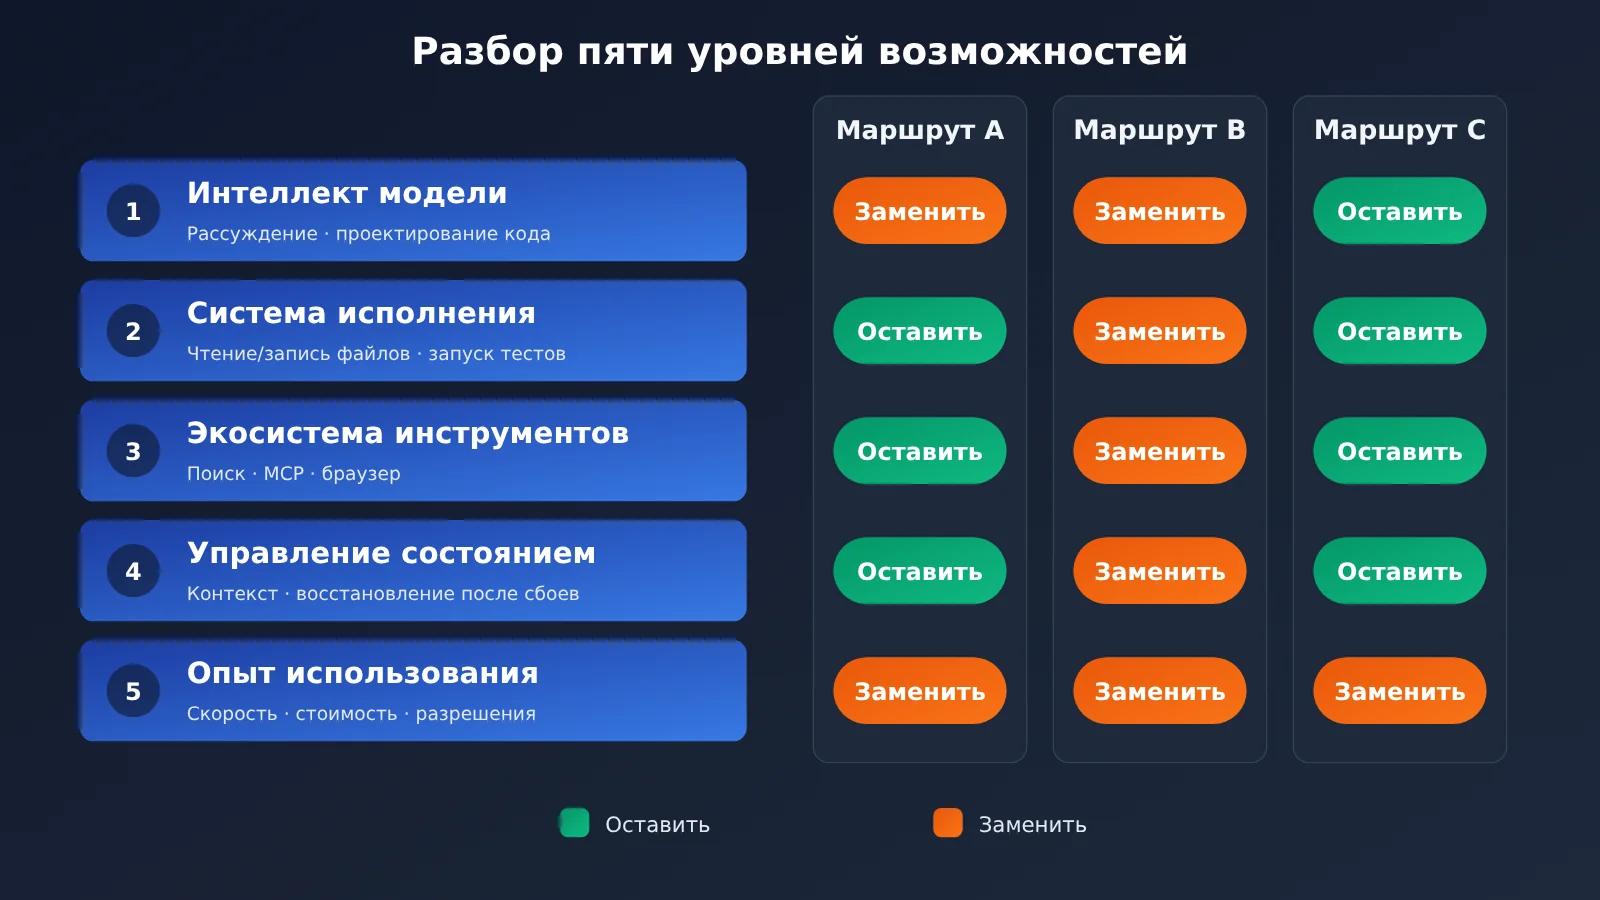
Если разобрать исходный опыт на части, получится пять компонентов:
- Интеллект модели: понимание сложных задач, проектирование кода, рассуждения и отладка.
- Исполнительная система: чтение проекта, редактирование файлов, выполнение команд, запуск тестов.
- Экосистема инструментов: поиск в интернете, чтение веб-страниц, MCP, работа с файлами, управление браузером.
- Управление состоянием: контекст долгих задач, цикл вызовов инструментов, восстановление после сбоев.
- Пользовательский опыт: скорость отклика, стабильность, стоимость, контроль прав доступа и удобство работы.
Замена модели меняет в основном пункт 1, но пользователь в итоге ощущает сумму всех пяти. Отсюда и границы трёх маршрутов: маршрут A заменяет пункт 1, сохраняя пункты 2 и 4; маршрут B меняет сразу пункты 1, 2 и 4; маршрут C по возможности сохраняет пункты 1, 2 и 4, а различия сосредоточены в пункте 5 и в деталях протокола, которые приносит канал API.
2 Оставляем Codex и подключаем китайские модели (вариант A)
2.1 Alibaba Cloud Bailian Token Plan + Codex
Alibaba Cloud уже опубликовала официальную документацию по подключению Codex: Token Plan предоставляет интерфейс, совместимый с Responses, и позволяет напрямую подключать новую версию Codex. В файл ~/.codex/config.toml (в Windows обычно C:\Users\<用户名>\.codex\config.toml) записываем:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
В переменной окружения, на которую указывает env_key, должен лежать API-ключ, выделенный под тариф Token Plan. При настройке есть несколько технических нюансов, на которых легко споткнуться:
- Версия протокола: начиная с 0.94.0 Codex требует Responses API. Старый Coding Plan от Alibaba Cloud работает через Chat Completions, и официально его нужно сочетать с Codex 0.93.0 или более ранней версии; если среду планируется поддерживать долго, стоит выбирать Token Plan.
- Изоляция ключей: Token Plan, Coding Plan и оплата по факту потребления используют три разных набора API-ключей.
- Регион: Token Plan сейчас доступен только в регионе Северный Китай 2 (Пекин).
- Метаданные модели: чтобы новая модель полноценно отображалась в интерфейсе выбора модели в Codex, нужно правильно указать её ID и метаданные.
Самое интересное в Bailian сейчас — Qwen4-Max-Preview (ID модели qwen4-max-preview), вышедшая 11 ноября 2026 года. Официальная документация подтверждает, что это новая флагманская мультимодальная модель: она поддерживает разработку кода, сложные агентские задачи, понимание изображений и видео, глубокое рассуждение (включено по умолчанию), вызов инструментов, поиск в интернете и структурированный вывод, а также совместима с тремя протоколами — OpenAI Chat Completions, Responses и Anthropic Messages. Длина контекста — 1M токенов, максимальный бюджет вывода — 393,216 токенов, причём рассуждение и финальный ответ делят этот бюджет между собой.
Условия использования тоже вполне конкретные: сейчас модель доступна только в Token Plan, оплата по факту потребления не поддерживается; период предварительного просмотра — с 10:00 11 ноября 2026 года до 24:00 25 ноября по пекинскому времени, после чего модель отключат. На момент публикации статьи на тестирование остаётся меньше двух недель — самое время поспешить с оценкой, а для продакшена заранее подготовить замену.
2.2 Tencent Cloud TokenHub + Codex
Tencent Cloud подготовила отдельное официальное руководство по подключению Codex CLI. В том же конфигурационном файле запись выглядит так:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
Вместо $model_id нужно подставить точный ID модели, который сейчас поддерживает тариф. Библиотека моделей TokenHub включает GLM-5.3, Kimi K3, серию DeepSeek V4, MiniMax M3, серию Tencent Hunyuan Hy, а также часть лёгких моделей и моделей с автоматической маршрутизацией; в рамках того же тарифа поддерживаются и такие инструменты, как Claude Code, Cline, OpenClaw.
Преимущество TokenHub — «одна конфигурация Codex, несколько китайских моделей»: достаточно изменить одну строку model, и один и тот же Harness по очереди прогонит GLM, Kimi, DeepSeek и MiniMax — очень удобно для сравнительного анализа. Набор моделей, версии и политика квот меняются динамически, поэтому перед каждым тестом ориентируйтесь на ID моделей, перечисленные в консоли.
2.3 Чем отличаются два тарифных плана
Оба называются Token Plan, но единицы измерения у них разные: в Bailian используются Credits, в TokenHub — баллы, и напрямую их не пересчитать. Данные в таблице ниже актуальны на 2026-11-13, цены указаны в юанях за месяц:
| Критерий сравнения | Alibaba Cloud Bailian Token Plan (личный) | Tencent Cloud TokenHub универсальный Token Plan (личный) |
|---|---|---|
| Уровень и месячная плата | Lite ¥39, Essential ¥79, Standard ¥139, Pro ¥312 | Lite ¥39, Standard ¥99, Pro ¥299, Max ¥599 |
| Месячная квота | 20 000 / 45 000 / 80 000 / 200 000 Credits | 780 / 1 980 / 5 980 / 11 980 баллов |
| Рекомендуемое число параллельных агентов | 1—2 / 2—3 / 3—4 / 6—8 | В документации аналогичные показатели не указаны |
| Скидки и преимущества | Lite, Essential — первая покупка для новых пользователей ¥19,5, ¥39,5 (до 2026-11-30); Standard, Pro — с преимуществами AgentStudio Harness | Для части моделей действуют временные льготные ставки списания; ориентир при покупке баллов — ¥1 = 20 баллов |
| Протокол подключения Codex | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| Характерные модели | Серия Qwen, включая доступную только в Token Plan Qwen4-Max-Preview | GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3, Hunyuan Hy |
| Способ учёта | Списание Credits по каждой модели | С 2026-08-31 — списание в баллах, ставки различаются по моделям |
| Ограничения использования | Только регион «Северный Китай 2» (Пекин); интерактивный тариф для программирования не стоит напрямую использовать для произвольной коммерческой серверной автоматизации | Состав моделей и акции могут меняться |
Сравнивать эти два тарифа по месячной плате смысла мало — главное, «сколько квоты списывается за выполнение одной задачи той моделью, которую я собираюсь использовать, именно в этом тарифе». Ценность Bailian сосредоточена в экосистеме Qwen и текущей монополии на Qwen4-Max-Preview; ценность TokenHub — в том, что одна общая квота покрывает несколько китайских моделей.
TokenHub публикует ставки списания баллов для каждой модели. Ниже — часть временных льготных ставок, полученных при запросе 2026-11-13, пересчитанных по курсу ¥1 = 20 баллов в юани за миллион токенов:
| Модель | Обычный ввод | Вывод | Ввод с попаданием в кэш | Примечание |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | После окончания акции — возврат к прайс-листовой цене |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | Сценарии, чувствительные к скорости и стоимости |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | После окончания акции — возврат к прайс-листовой цене |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | Специализированная модель для кода |
| DeepSeek V4.1 Flash (непиковое время) | ¥0.40 | ¥1.60 | ¥0.008 | Пиковое/непиковое тарифицирование |
| DeepSeek V4.1 Flash (пиковое время) | ¥0.80 | ¥3.20 | ¥0.016 | Рабочие дни 09:00—12:00, 14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | Цена при вводе ≤ 512K токенов |
Эту таблицу стоит читать с двумя оговорками. Во-первых, помесячная подписка оплачивается по месячной стоимости тарифа, а суммы в таблице — это справочная стоимость баллов, по которой удобно сравнивать интенсивность расхода разных моделей. Во-вторых, пиковое/непиковое тарифицирование DeepSeek действует с 30 октября 2026 года: в пиковые часы расход примерно вдвое выше, чем в непиковые. Поэтому ночные пакетные прогоны проверок кода, анализа тестов и других асинхронных задач заметно экономят квоту.
Посчитаем на примере GLM-5.3: одна крупная кодовая задача суммарно потребляет 100 000 токенов обычного ввода, 300 000 токенов с попаданием в кэш и 30 000 токенов вывода. Это соответствует 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232 справочной стоимости в баллах. Попадания в кэш составляют бо́льшую часть ввода — как раз типичная картина для агентных задач. Это же показывает, что тариф на кэш сильно влияет на общую стоимость в сценариях программирования.
3. Меняем Harness — можно ли приблизиться к Astra + Codex? (Маршрут B)
3.1 OpenCode: главное — свобода выбора моделей
OpenCode — это открытый AI Coding Agent с поддержкой большого числа LLM-провайдеров: добавить провайдера можно командой /connect, переключить модель — командой /models, поддерживаются собственный Base URL и локальные модели. Работает в терминале, на десктопе и в некоторых средах разработки, умеет искать и изменять файлы, выполнять команды и строить agent-воркфлоу. Alibaba Cloud уже опубликовала официальную инструкцию по подключению: выбираете Alibaba Token Plan (China) — и можно пользоваться тарифом Bailian.
К официальному предупреждению OpenCode о безопасности стоит относиться серьёзно: локальный Agent по умолчанию не имеет системной изоляции, и подтверждение разрешений не заменяет контейнер или виртуальную машину. Если запускаете недоверенный код или автоматизацию с высокими привилегиями, делайте это в Docker или в виртуалке.
3.2 Qwen Code, Kimi Code и DeepSeek Harness
Три нативных Harness — каждый под свою экосистему моделей:
- Qwen Code: Alibaba Cloud предлагает три формы — CLI, десктоп и IDE. Вход в Bailian, выбор региона, ввод API-ключа — и всё подключено; есть поиск по кодовой базе, редактирование файлов и выполнение команд. Тем, кто в основном работает с моделями Qwen и хочет меньше возиться с адаптацией протоколов, стоит смотреть в первую очередь.
- Kimi Code CLI: терминальный инструмент для кодинга, который поддерживает Moonshot AI. Умеет читать и править код, вызывать Shell, получать содержимое веб-страниц, восстанавливать сессию, работать в режимах планирования и подтверждений, интегрироваться с редакторами, а также подключать сторонние совместимые модели. На Windows ставится официальным PowerShell-скриптом и требует Git Bash из состава Git for Windows; поддержка старого Kimi CLI завершилась в сентябре 2026 года, так что новым пользователям — сразу Kimi Code CLI.
- DeepSeek Harness: открытый фреймворк Agent, который даёт и Web UI, и CLI; поддерживает собственных Provider’ов и настройку инструментов, умеет работать с разными тарифными схемами Bailian. Запуск — через
npx @deepseek-ai/dsh web, адрес по умолчанию —http://127.0.0.1:3080. При выборе смотрите в первую очередь на стабильность выполнения инструментов, контроль прав и совместимость с протоколом целевой модели.
3.3 Почему Harness влияет на то, как показывает себя модель
Одна и та же модель в разных Harness может давать очень разные результаты — потому что Harness определяет, «что модель видит, что она может сделать и что происходит после ошибки»:
- Стратегия чтения кода: сколько файлов читается за раз и в каком порядке идёт поиск — от этого зависит, насколько полно модель понимает проект.
- Устройство цикла инструментов: как возвращаются результаты инструментов и есть ли автоматический повтор при сбое — от этого зависит, доедет ли длинная задача до конца.
- Сжатие контекста: какие фрагменты истории сохраняются в длинной сессии, а какие детали выбрасываются, — напрямую влияет на то, «забудет ли модель цель».
- Патчи и тесты: перезапись файла целиком или diff-патч, запускаются ли тесты по умолчанию после правок — от этого зависит точность изменений и риск регрессий.
Поэтому результаты маршрута B — это результат связки «модель + конкретный Harness». Сравнивая их с маршрутом A, стоит помнить: стратегии выполнения у этих сторон изначально разные.
4 Какие китайские модели стоит тестировать?
4.1 Qwen4-Max-Preview
Судя по открытым спецификациям, контекст в 1M, общий бюджет в 393 216 токенов на рассуждение и вывод, вызов инструментов и структурированный вывод — всё это делает модель удобной для тестирования сложного кодинга, анализа длинного контекста и многораундовых агентных воркфлоу. Она совместима и с Responses, и с Anthropic Messages, подключается к Codex, а также к инструментам вроде Claude Code.
Главное ограничение при выборе — срок: превью заканчивается 2026-11-25 в 24:00, после чего модель отключают. Рекомендую за это время прогнать на ней весь набор тестовых задач, а результаты использовать как ориентир для последующих официальных версий Qwen. В продакшене параллельно настройте запасную модель с долгосрочным доступом.
4.2 GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3
Все четыре серии входят в один тариф TokenHub, поэтому проще всего распределить их по типам задач:
- Сложная логика и правки в нескольких файлах: GLM-5.3, Kimi K3, DeepSeek V4-Pro — как высокопроизводительная контрольная группа. У Kimi K3 самая высокая цена за выходные токены в таблице, её уместно ставить на самые трудные задачи, чтобы проверить верхний предел.
- Задачи, нацеленные на код: Kimi K2.7 Code — специально для сценариев правки кода; можно также совместить с Kimi Code CLI, чтобы оценить нативный опыт.
- Частые задачи с низкой стоимостью: GLM-5.3-Flash, DeepSeek V4-Flash — для проверки кода, массового рефакторинга и других сценариев, чувствительных к стоимости и скорости.
- Стабильность на длинном контексте и точность вызовов инструментов: MiniMax M3 стоит включить в кандидаты, но учтите: выше порога в 512K входных токенов цена растёт.
4.3 Как понять, кто ближе всех к Astra
Длина контекста, число параметров, рекламное позиционирование и цена за токен не дают надёжного рейтинга моделей, а рекламные бенчмарки из разных источников несопоставимы. Единственный надёжный способ понять, «кто ближе к Astra + Codex», — прогнать модели на одном и том же Harness и одном наборе задач, единообразно фиксируя долю успешных задач, время выполнения, стоимость в токенах, совместимость с инструментами и количество ручных вмешательств. Подробнее — в разделе 6.
5. Три варианта воспроизведения: как выбрать подходящий?
5.1. Нужен оригинальный опыт работы с Codex — выбираем вариант A
Сохраняем Codex Harness и подключаем китайский сервис, который официально поддерживает протокол Responses. Если основная модель — Qwen, берите Байлянь (Bailian); если хочется переключаться между несколькими китайскими моделями — TokenHub. Плюсы: низкие затраты на обучение и миграцию, работа с файлами и система выполнения Agent остаются оригинальными. Минусы: интеллект модели отличается от Astra, степень реализации совместимого интерфейса влияет на опыт tool calling, а контекст и параметры reasoning для каждой модели приходится настраивать отдельно.
5.2. Нужны китайские модели и свобода выбора среди нескольких — вариант B
OpenCode в связке с китайскими мультимодельными API, при необходимости дополняем Qwen Code, Kimi Code или DeepSeek Harness. Лучше всего подходит разработчикам, которые постоянно используют несколько моделей и не хотят привязываться к одному производителю; удобнее всего и для сравнения того, как разные модели справляются с одной и той же задачей. Цена — стратегия выполнения отличается от Codex, а подключение нескольких Provider’ов добавляет работы по настройке и поддержке.
5.3. Нужно максимально сохранить возможности Astra — вариант C
Вариант C — это комбинация «оригинальный Codex CLI + GPT-6 Astra + рабочий сервис доступа к API». Если канал действительно предоставляет оригинальную GPT-6 Astra и полностью поддерживает нужные Codex Responses API, потоковые события, вызов инструментов и управление контекстом, то удаётся сохранить оба ключевых компонента — и модель, и Harness. Этот вариант решает вопрос доступности по сети; это отдельная история от замены на китайские модели.
На примере APIYI: способ подключения точно такой же, как в варианте A, нужно только заменить набор настроек Provider:
model_provider = "APIYI"
model = "gpt-6-astra"            # ориентируйтесь на фактический ID модели в консоли APIYI
model_reasoning_effort = "high"  # корректируйте от low до max в зависимости от сложности задачи

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Перед подключением стоит скриптом проверить, что канал действительно поддерживает протокол Responses и вызов инструментов, а не только возвращает обычный текст:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # замените на доступный в консоли ID модели
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# В нормальном случае должен вернуться элемент вывода типа function_call со структурированными параметрами
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # проверьте, что входные, выходные, кешированные и reasoning-токены считаются отдельно
Этот проверочный скрипт охватывает три вещи, от которых Codex зависит больше всего: протокол Responses, возврат Function Calling и раздельный учёт расхода токенов. Когда скрипт пройдёт проверку, подключайте Codex и прогоните целую задачу «правка кода + запуск тестов», чтобы убедиться, что потоковые события и многораундовый цикл с инструментами работают нормально.
Даже при одинаковой модели впечатления от маршрута C зависят от фактической маршрутизации модели, профиля рассуждений, задержки API и пропускной способности вывода, попаданий в кэш, совместимости с протоколом шлюза и стоимости канала. Настольная версия Codex, облачные задачи и функции, привязанные к аккаунту ChatGPT, опираются на собственную систему авторизации OpenAI. При работе через API-ключ используется связка Codex CLI + API модели, поэтому при планировании эти функции нужно исключать.
🚀 Рекомендация для быстрого старта: если хотите сравнить маршруты A и C, зарегистрируйтесь на APIYI apiyi.com и получите бесплатный тестовый лимит, а затем в одном и том же окружении Codex прогоните по очереди отечественные модели и модели серии GPT. Конкретный список моделей и поддержку протоколов в APIYI уточняйте в консоли и документации docs.apiyi.com.
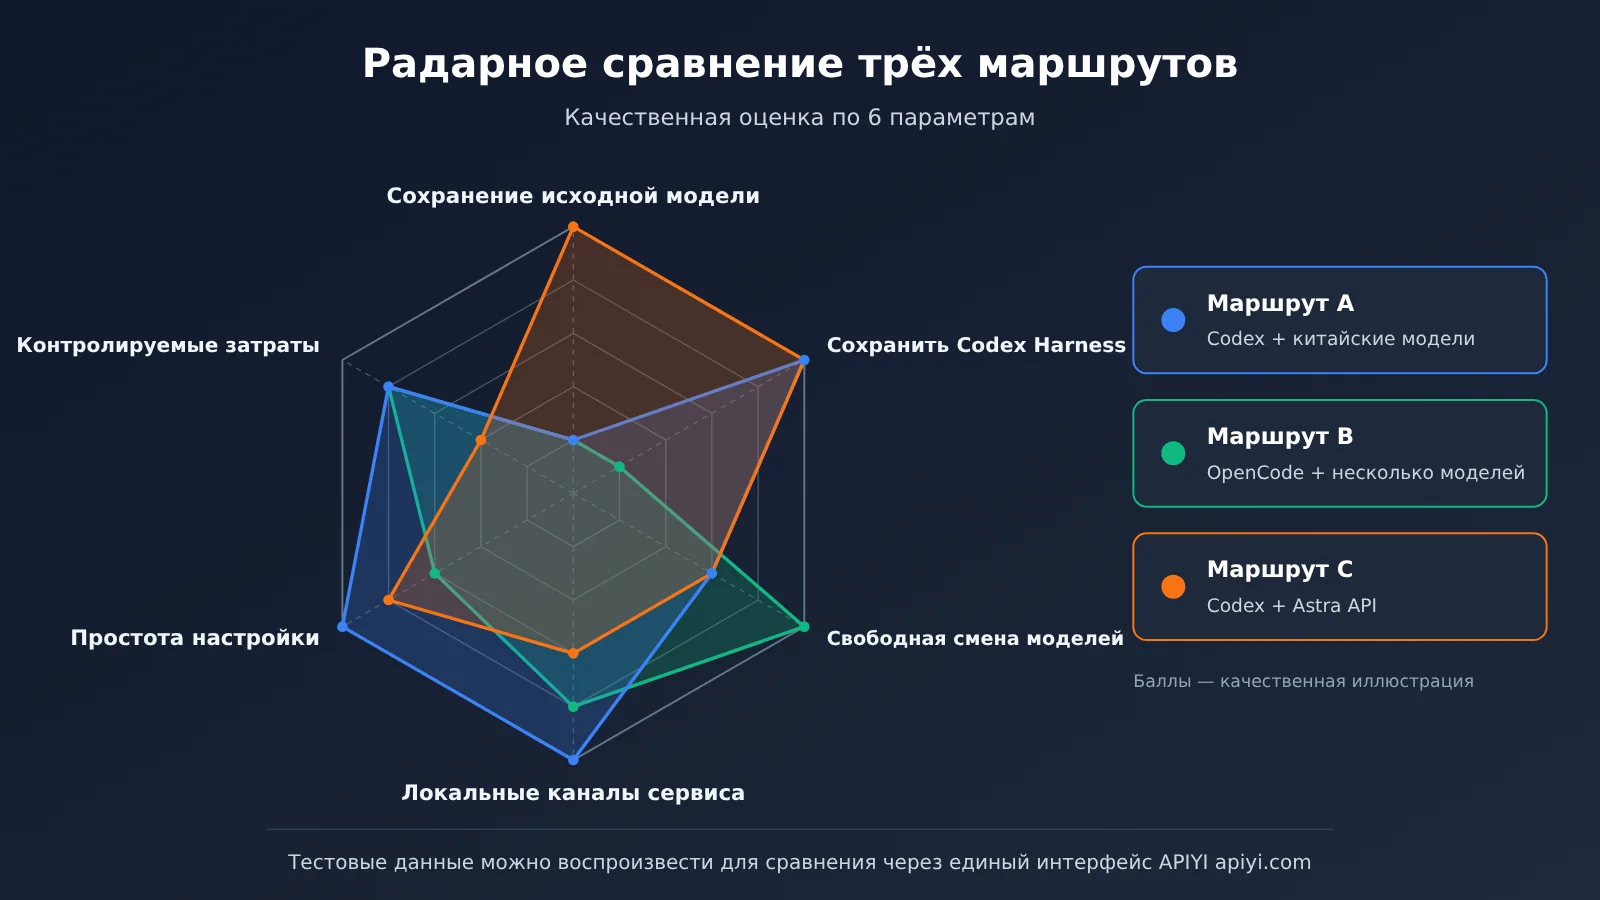
Сводка компромиссов по трём маршрутам:
| Критерий сравнения | Маршрут A: Codex + отечественные модели | Маршрут B: OpenCode и др. + несколько отечественных моделей | Маршрут C: Codex + Astra API |
|---|---|---|---|
| Сохранение исходной модели | Нет, меняется на Qwen / GLM / Kimi и др. | Нет | Да (при условии, что канал можно проверить) |
| Сохранение Codex Harness | Да | Нет, меняется на открытый Harness | Да |
| Переключение моделей | Смена model ID в пределах одной платформы | Свободное переключение между провайдерами | Переключение между моделями, которые поддерживает канал |
| Отечественный канал обслуживания | Alibaba Cloud Bailian, Tencent Cloud TokenHub | Bailian, TokenHub и другие совместимые сервисы | Сторонние каналы с поддержкой Responses, например APIYI apiyi.com |
| Сложность настройки | Низкая, есть готовые официальные конфиги | Средняя, нужно поддерживать несколько наборов Provider | Низкая при условии, что протокол проверен заранее |
| Структура затрат | Месячная подписка (Credits / баллы) | Подписка или оплата по факту — зависит от провайдера | Оплата по факту, цена Astra выше большинства отечественных моделей |
| Подходящие задачи | Оригинальный опыт Codex + локализация моделей | Долгосрочные рабочие процессы с несколькими моделями | Максимальное сохранение исходных возможностей |
5.4 Сетевые и защитные границы при использовании в Китае
То, что API модели доступен по адресу, открывающемуся из Китая, решает только участок вызова модели. В работе агент также обращается к GitHub, npm, PyPI и другим источникам ПО, к внешней официальной документации, сторонним MCP-сервисам и веб-поиску — доступность этих каналов нужно проверять отдельно. Веб-поиск тоже является самостоятельной возможностью: встроенный поиск облачного провайдера, встроенные инструменты выхода в сеть в Harness и собственный Search API / MCP имеют свои ограничения по доступу, тарификации и вызовам.
С точки зрения безопасности программирующий агент умеет изменять файлы, запускать Shell и читать переменные окружения. Рекомендуется сделать следующее:
- API-ключ храните в переменных окружения или в менеджере секретов — и никогда не записывайте в исходный код или Git-репозиторий.
- Сложные изменения делайте в отдельной ветке Git; проект должен оставаться под контролем версий, а резервные копии — восстанавливаемыми.
- Ограничьте доступ агента к конфиденциальным файлам за пределами рабочего каталога; недоверенный код запускайте в контейнере или виртуальной машине.
- Высокорисковые операции — удаление, развёртывание, платные действия — оставляйте на ручное подтверждение.
6. Тестирование на реальных задачах ценнее, чем рейтинги моделей
6.1. Ставим пять типов задач
Берём реальный проект с фронтендом, бэкендом, тестами и конфигурацией зависимостей и проектируем пять типов задач, которые проверяют и возможности модели, и возможности Harness:
- Понимание проекта: нужно объяснить архитектуру и связи ключевых модулей. Смотрим, как модель находит файлы, понимает ли межфайловые зависимости и даёт ли проверяемые ссылки на пути.
- Кросс-файловая разработка: добавляем новую функцию, для которой нужно изменить несколько мест. Смотрим на точность правок, полноту реализации и на то, не внесла ли она регрессий.
- Исправление багов: даём проект с воспроизводимо падающим тестом. Смотрим, находит ли модель корневую причину, исправляет ли нужное место, сама ли запускает тесты и не ломает ли другие кейсы.
- Длинный агентный рабочий процесс: непрерывная цепочка «понимание требований → правка кода → запуск тестов → обнаружение падения → исправление → повторная проверка». Смотрим, удерживает ли модель цель и умеет ли менять стратегию по тексту ошибок.
- Работа с документацией в интернете: прочитать свежую документацию SDK и мигрировать фрагмент старого кода API. Смотрим, действительно ли модель ходит в сеть и извлекает текст документа, применяет ли новый API в коде и различает ли «инструмент недоступен» и «результат поиска пуст».
6.2. Фиксируем успешность, время и стоимость
Каждая комбинация «модель + Harness» прогоняет один и тот же набор задач — минимум три раза с усреднением, — и мы единообразно записываем следующие метрики:
| Метрика | Как считаем или наблюдаем |
|---|---|
| Успешность задачи | число успешно выполненных задач / общее число задач |
| Доля успехов с первого раза | доля без ручных правок, успех с первой попытки |
| Общее время задачи | от постановки задачи до финальной успешной проверки |
| Число вызовов модели | суммарное число API-запросов на задачу |
| Число вызовов инструментов | число вызовов чтения, редактирования, Shell, поиска и т. п. |
| Расход токенов | отдельно входные, выходные, попадания в кэш и расход на рассуждение |
| Реальная стоимость задачи | фактические расходы на выполнение одной успешной задачи |
| Число ручных вмешательств | сколько раз пользователь вручную корректировал и исправлял |
Чтобы эксперимент был воспроизводимым, фиксируем следующие переменные: один и тот же снимок репозитория кода, одна и та же версия Harness, один и тот же уровень рассуждения или настройка thinking, один и тот же временной интервал (особенно важно для моделей с пиковым и непиковым тарифом вроде DeepSeek). Перед каждой задачей сбрасываем репозиторий к снимку, чтобы правки прошлого раунда не влияли на следующий.
6.3. Стоимость одного успешного задания как ключевой показатель закупки
Рекомендуемый расчёт: стоимость одного успешного задания = суммарные расходы всех попыток ÷ число успешных заданий. Расходы неудачных попыток обязательно计入 — они тоже消耗 квоту.
Модель с низкой ценой за единицу не обязательно дешевле. Если модели нужно больше раундов рассуждения, повторных правок и ретраев или частого вмешательства человека, суммарный расход на задачу может оказаться выше, чем у более дорогой модели, которая делает всё правильно с первого раза. С другой стороны, на простых и частых задачах низкая цена и высокая скорость Flash-моделей часто дают реальную экономию. Если считать стоимость «на каждое успешное задание», обе категории моделей можно сравнивать по одной линейке.
💰 Совет по оценке затрат: для таких экспериментов удобнее всего каналы с оплатой по факту использования — по каждому запросу можно построчно сверять разбивку по токенам и стоимость. С помощью APIYI apiyi.com можно вызывать несколько моделей одним ключом и сводить счета разных моделей в одной панели управления, чтобы считать стоимость одной успешной задачи.
7 Сценарий APIYI: модель как заменяемый компонент
Предыдущий анализ ведёт к одному выводу: стабильная среда для AI-программирования должна фиксировать Harness и относиться к модели как к заменяемому компоненту. Codex или OpenCode отвечают за выполнение и управление состоянием, API-каналы предоставляют модели, а сами модели гибко переключаются в зависимости от сложности задачи и бюджета.
APIYI apiyi.com в этой архитектуре выполняет роль единого слоя доступа: один API-ключ для вызова OpenAI, Claude, Gemini и других популярных моделей, интерфейс совместим с протоколом OpenAI, оплата по факту использования. Пользователям, работающим с кодом, перед выбором любого API-канала (включая APIYI) стоит проверить по пунктам следующее:
- Поддерживаются ли Responses API и потоковые события, которых требует текущая версия Codex.
- Какие реальные ID моделей указаны в консоли и есть ли нужная модель в наличии.
- Работают ли вызовы инструментов и Function Calling в полном цикле туда-обратно.
- Достаточны ли задержка и скорость непрерывного вывода для длительных задач.
- Правильно ли распознаётся использование кэша и тарифицируется ли оно отдельно.
Эти сведения стоит сверять с консолью сервиса и технической документацией; скрипт проверки из раздела 5.3 можно использовать для валидации напрямую. На практике обычно поступают так: месячный тариф из варианта A берут для повседневных частых задач, а канал с оплатой по факту использования — для сложных задач, где нужна более сильная модель, и для сравнительных тестов. Оба провайдера прописывают в одном config.toml и переключаются через --profile или изменение model_provider.
8 Часто задаваемые вопросы
Вопрос 1: при воспроизведении Astra + Codex в Китае какой маршрут обеспечивает наибольшую точность?
Наибольшую точность даёт маршрут C: оригинальный Codex CLI в связке с реально доступным API GPT-6 Astra — сохраняются оба ключевых компонента, модель и Harness. Условие — канал должен подтверждённо предоставлять оригинальную модель и полностью поддерживать протокол Responses и вызов инструментов. Если нужна модель китайского производства, маршрут A — лучший выбор для воспроизведения того, как реально работает Codex.
Вопрос 2: подходит ли Qwen4-Max-Preview для долгосрочного использования в Codex?
Для текущего тестирования — подходит. Модель доступна только в Token Plan от Bailian; превью-период заканчивается 25 ноября 2026 года в 24:00, после чего модель выведут из эксплуатации. Рекомендую успеть прогнать тестовые задачи в течение превью-периода и параллельно подготовить для продакшена долгосрочную альтернативную модель.
Вопрос 3: почему новый Codex не подключается к старой версии Coding Plan от Alibaba Cloud?
Начиная с версии 0.94.0 Codex требует Responses API, а старая версия Coding Plan использует протокол Chat Completions — официально её предписано использовать с Codex 0.93.0 или более ранней версией. Перейдите на Token Plan и установите `wire_api = «responses»` — так новый Codex подключится. Учтите: Token Plan использует отдельный API-ключ.
Вопрос 4: можно ли напрямую сравнивать Credits в Bailian и баллы в TokenHub?
Напрямую — нельзя. Это единицы измерения разных платформ, и скорость списания у разных моделей разная. Надёжнее прогнать одну и ту же задачу на обеих сторонах и сравнить «долю месячной стоимости тарифа, которую съедает выполнение одной успешной задачи».
Вопрос 5: как быстро проверить, потянет ли сторонний канал Codex?
Сначала отправьте запрос Responses с инструментом function через Python-скрипт из раздела 5.3, убедитесь, что в ответе есть элемент вывода `function_call` и статистика расхода по категориям в порядке, а затем подключите Codex и прогоните полную задачу с тестами. После регистрации на APIYI apiyi.com можно получить бесплатный тестовый лимит и пройти эту проверку; конкретные доступные модели смотрите в консоли.
Вопрос 6: одна и та же модель по-разному ведёт себя в OpenCode и Codex — это нормально?
Да, это нормально. Harness определяет стратегию чтения кода, цикл инструментов, сжатие контекста и подход к тестированию — всё это меняет фактическое поведение модели. При сравнении фиксируйте Harness, чтобы тестировать модель, или фиксируйте модель, чтобы тестировать Harness, — не меняйте обе переменные одновременно.
Вопрос 7: если использовать Codex через API-ключ, получу ли я функции Codex из подписки ChatGPT?
Способ с API-ключом — это комбинация Codex CLI и API модели. Облачные задачи Codex, десктопное приложение и функции, эксклюзивные для аккаунта ChatGPT, зависят от авторизации аккаунта OpenAI; сторонние API-каналы эти права предоставить не могут.
Вопрос 8: как контролировать общие затраты при переключении между моделями?
Разделяйте задачи по уровню: сложные — на мощные модели, массовые проверки и простой рефакторинг — моделям уровня Flash, а асинхронные задачи для моделей с тарификацией «пик/не пик» переносите на ночь. Оценивайте всё по «стоимости одной успешно выполненной задачи»: в каналах с оплатой по факту, таких как APIYI apiyi.com, удобно построчно сверять фактический расход по каждой модели.
9 Итоги: Key Takeaways
- Три маршрута — три акцента: маршрут A сохраняет опыт Codex, маршрут B — свободу выбора модели, маршрут C — оригинальную модель.
- Astra + Codex — это пятиуровневая комбинация: модель, система исполнения, экосистема инструментов, управление состоянием и пользовательский опыт вместе определяют результат.
- Для маршрута A есть готовые конфигурации: и Bailian, и TokenHub предоставляют официальные конфигурации Codex, ключевое здесь —
wire_api = "responses". - У Qwen4-Max-Preview есть дедлайн: только в рамках Token Plan, 2026-11-25 24:00预览 завершается, и модель выводят из эксплуатации.
- Единицы тарифов нельзя сравнивать напрямую: Credits, баллы, Token и юани относятся к разным системам измерения — сравнивать можно только по реальным замерам на задачах.
- Пусть решают задачи: пять типов реальных задач, восемь метрик, а основание для закупки — стоимость одной успешно выполненной задачи.
- Модель как сменный компонент: фиксированный Harness, единый канал доступа, переключение моделей под задачу — только так среда остаётся стабильной и управляемой.
Самый практичный способ начать — настроить в одном окружении Codex два Provider: один облачный тариф для повседневных задач, второй канал с оплатой по факту — для контрольных тестов и сложных задач. Прогоните один раунд по методике из раздела 6 и уже потом решайте, какая комбинация станет вашей долгосрочной. Рекомендую быстро собрать контрольную группу через APIYI apiyi.com и на едином интерфейсе проверить отечественные модели и серию GPT на одном и том же наборе задач.
📚 Справочные материалы
- Официальная документация модели GPT-6 Astra: спецификации модели, уровни рассуждения и ценообразование
- Ссылка:
developers.openai.com/api/docs/models/gpt-6-astra -
Описание: контекстное окно, максимальный объём вывода, поддержка инструментов и тарифы для длинного контекста
-
OpenAI Codex Harness: архитектура фреймворка исполнения Codex
- Ссылка:
developers.openai.com/blog/codex-as-a-platform -
Описание: официальное описание цикла Agent, возврата данных инструментами, управления контекстом и песочницы
-
Подключение Codex в Alibaba Cloud Model Studio: настройка Token Plan
- Ссылка:
help.aliyun.com/zh/model-studio/codex -
Описание: поля config.toml, протокол Responses и требования к версии
-
Персональная версия Token Plan в Alibaba Cloud: цены пакетов и Credits
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
Описание: тарифы после изменений от 2026-11-09, квоты и скидка на первую покупку
-
Официальная документация Qwen4-Max-Preview: спецификации модели и период предпросмотра
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
Описание: контекст 1M, совместимость протоколов и срок отключения
-
Настройка Codex CLI в Tencent Cloud TokenHub: официальное руководство по подключению
- Ссылка:
cloud.tencent.cn/document/product/1823/130071 -
Описание: настройка Provider и способ замены ID модели
-
Пакеты и тарифы кредитов Tencent Cloud TokenHub: правила биллинга
- Ссылка:
cloud.tencent.cn/document/product/1823/130060 - Ссылка:
cloud.tencent.com/document/product/1823/133811 -
Описание: уровни пакетов, ставки кредитов по моделям и биллинг по пиковым и непиковым часам
-
Официальный репозиторий OpenCode: открытый Coding Agent
- Ссылка:
github.com/anomalyco/opencode -
Описание: настройка Provider и примечания по безопасности
-
Qwen Code, Kimi Code CLI, DeepSeek Harness: нативные Harness
- Ссылка:
help.aliyun.com/zh/model-studio/qwen-code - Ссылка:
github.com/MoonshotAI/kimi-code - Ссылка:
help.aliyun.com/zh/model-studio/deepseek-harness - Описание: установка, подключение и охват возможностей
Автор: техническая команда APIYI
Техническое общение: свяжитесь с нами на главной странице официального сайта APIYI, больше материалов по подключению — в центре документации docs.apiyi.com


