ملخص: في مهام الفيديو المدفوعة بالكود ضمن VibeVideoBench، أصبح GPT-6 Astra في المستوى نفسه مع Claude Opus 5.5، بجودة إجمالية أعلى قليلًا وتكلفة أقل؛ كما أن تسليم Opus 5.5 أكثر استقرارًا. ولم يُطرح بعد الجيل التالي من نموذج OpenAI العام، وستحتاج قدراته على الفيديو إلى اختبار فعلي بعد الإطلاق.
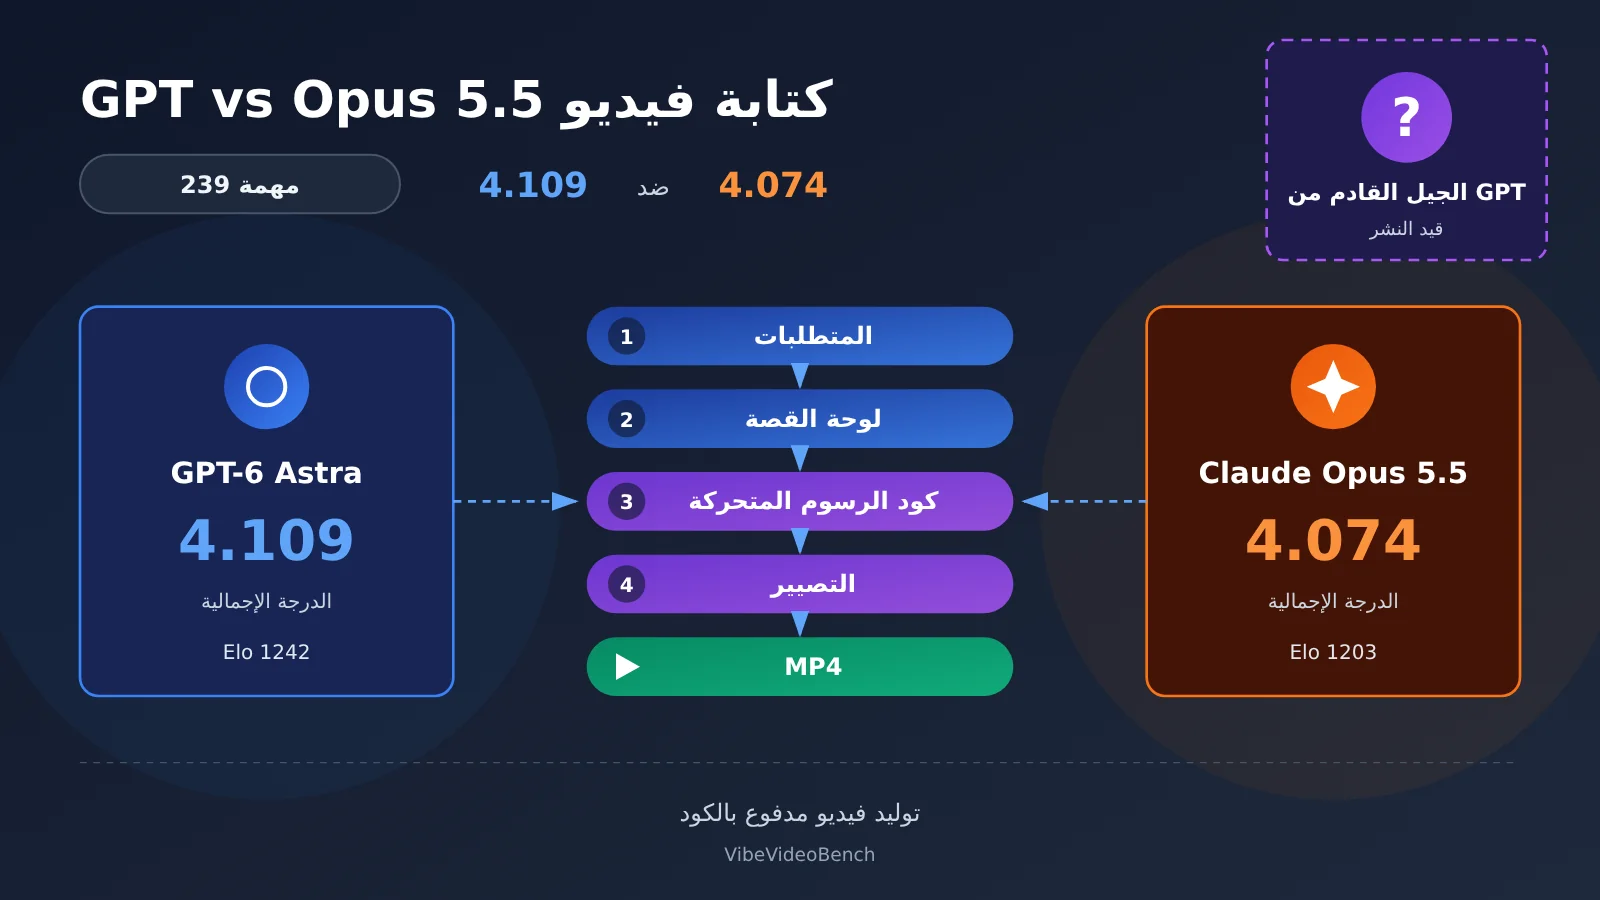
الخلاصة أولًا: حتى 15 نوفمبر 2026، وفي المسار الذي «يكتب فيه الوكيل الكود، ويستدعي أدوات التصيير، ويسلّم ملف MP4 كاملًا»، فإن GPT-6 Astra وClaude Opus 5.5 هما أقرب نظامين في VibeVideoBench. حصل Astra على درجة جودة إجمالية مقدارها 4.109، وحصل Opus 5.5 على 4.074؛ وفي اختبار بشري أعمى، كانت درجتا Elo 1242 و1203 على التوالي، ولا يمكن إحصائيًا التمييز بينهما. سلّمت Opus 5.5 جميع المهام الـ239، بمعدل نجاح صارم للمهام بلغ 76.3%، مقابل 74.5% لـAstra؛ وبلغ متوسط تكلفة API لكل مهمة لدى Astra نحو 8.19 دولارات، أي حوالي نصف تكلفة Opus 5.5. وقد نشرت OpenAI دليلين على أن نموذجين داخليين لديها يتفوقان بشكل ملحوظ على Astra، لكن لم يُعلن اسم الجيل التالي من GPT العام، ولا موعد إطلاقه، ولا نتائجه المتخصصة في الفيديو. لذا فإن الإجابة عن سؤال العنوان هي: الجيل الحالي من GPT قد وصل بالفعل إلى المستوى نفسه، أما قدرة الجيل التالي على خلق فارق واضح، فتتوقف على الاختبار الفعلي بعد الإطلاق.
استعراض المحتوى: نحدد في ما يلي أولًا نطاق التقييم، ثم نفكك النتائج الإجمالية لـVibeVideoBench، والنتائج حسب الفئات، والتفضيلات البشرية، وبيانات التكلفة، لنوضح من أين تأتي نقاط القوة لدى كل منهما؛ وبعد ذلك نراجع الإشارات العلنية الصادرة عن النماذج الداخلية لدى OpenAI وحالة إطلاق الجيل التالي، ونحلل العائق الحقيقي أمام وكيل الفيديو؛ وأخيرًا نقدم منهجية اختبار مقارنة قابلة لإعادة الاستخدام مباشرة بعد إطلاق النموذج الجديد، لمساعدتك في تحديد ما إذا كان يستحق استبدال الحل الحالي.
للعلم: مصطلحات يجب معرفتها قبل قراءة المقال
| المصطلح | الشرح |
|---|---|
| Code-driven Video Generation | توليد الفيديو الموجّه بالشيفرة: يكتب الذكاء الاصطناعي برامج الرسوم المتحركة والعرض، ثم يُخرج ملف MP4 في النهاية |
| Native Video Generation | التوليد الأصلي للفيديو: ينتج النموذج مشاهد الفيديو مباشرة من النص أو الصورة، ومن أبرز المنتجات Sora وVeo |
| VibeVideoBench | معيار تقييم متخصص لاختبار قدرة وكيل ذكاء اصطناعي على إنتاج فيديو كامل بشكل مستقل، صدر في 26 أكتوبر 2026 |
| Harness | بيئة تشغيل النموذج، توفر إمكانات تنفيذ الشيفرة والوصول إلى الملفات واستدعاء الأدوات، مثل Codex CLI وClaude Code |
| L1 / L2 / L3 | طبقات التقييم الثلاث: فحص تسليم البرنامج، وفحص متطلبات المهمة بندًا بندًا، وتقييم جودة الفيديو عبر مراجعة متعددة الوسائط |
| معدل نجاح المهام الصارم | نسبة المهام التي سُلّم فيها الفيديو بنجاح مع استيفاء جميع القيود، وهو أدق من «معدل التسليم» وحده |
| Bradley–Terry Elo | طريقة تقييم تعتمد على مقارنات بشرية ثنائية لحساب تفضيل نسبي بين النماذج |
| Multi-agent Orchestration | تنسيق متعدد الوكلاء: توزيع العمل بين عدة وكلاء ثم دمج النتائج |
| Render Pipeline | خط أنابيب عرض الفيديو: توليد المشاهد، ومعالجة الصوت، والترميز والدمج حتى الإخراج النهائي |
| Remotion / FFmpeg | الأول يكتب رسومًا متحركة للفيديو باستخدام شيفرة React، والثاني يتولى ترميز الصوت والفيديو ودمجهما |
| ffprobe | أداة فحص مرفقة مع FFmpeg، تُستخدم لقراءة دقة الفيديو ومعدل الإطارات والمدة والمسارات الصوتية وغيرها من المعلومات |
| Cache Hit | معدل إصابة الذاكرة المؤقتة: نسبة السياق المتكرر التي تُقرأ من الذاكرة المؤقتة، وتؤثر مباشرة في تكلفة API للمهام الطويلة |
| BenchCAD 2.0 | معيار هندسي لاختبار قدرة الذكاء الاصطناعي على إعادة بناء الأجزاء ثلاثية الأبعاد، وتصميم التجميعات الميكانيكية، والتعرف على توصيلات PCB |
1 الخلاصة أولاً: دخل GPT بالفعل نطاق المنافسة مع Opus 5.5 في إنشاء الفيديو
1.1 أي نوع من «كتابة الفيديو» يقارن هذا المقال؟
مسارات إنشاء الفيديو بالذكاء الاصطناعي مساراتان حالياً. المسار الأول هو توليد الفيديو الأصلي، حيث يُخرج النموذج إطارات متحركة متصلة مباشرة، ويبرع في الشخصيات والحركة الفيزيائية ولغة الكاميرا. أما المسار الثاني فهو توليد الفيديو المدفوع بالكود، حيث يعمل النموذج كمخرج ومبرمج في الوقت نفسه: يفهم المطلوب، ويكتب السيناريو ولوحة القصص، ويستخدم Remotion أو Three.js أو Cairo أو Blender لكتابة الرسوم المتحركة، ويولّد التعليق الصوتي عبر TTS، ثم يجمع الفيديو النهائي بواسطة FFmpeg ويراجعه.
يناقش هذا المقال المسار الثاني، أي القدرة على تسليم ملف MP4 كامل ومشروع قابل للتعديل عبر وكلاء مثل Codex CLI وClaude Code. يناسب هذا المسار تصور البيانات، وعروض المنتجات، والشرح المعرفي، والإنفوجرافيك المتحرك، والأفلام الإعلانية للعلامات التجارية. وهو أيضاً المجال الذي تتوفر فيه حالياً مقاييس مستقلة تسمح بمقارنة GPT مع Claude.
لقد تغيّر خط منتجات الفيديو الأصلي لدى OpenAI نفسه: توقف منتج Sora عن الخدمة في 26 أبريل 2026، وأُغلق نموذج Sora 2 وواجهة Videos API في 24 سبتمبر، مع إشعار الإيقاف الرسمي الذي ينص على عدم وجود API بديل بشكل فردي. أما GPT-Image-2.6، الذي صدر في 4 نوفمبر، فيدعم إخراج رسوم GIF المتحركة من 2 إلى 16 إطاراً، ويناسب الملصقات التعبيرية والحركات المتكررة ومعاينات لوحات القصص، وهو سير عمل مختلف عن إنتاج MP4 الكامل. لذلك تظهر قدرة سلسلة GPT على «كتابة الفيديو» حالياً بشكل أساسي في المسار المدفوع بالكود.
1.2 إجابة السؤال الوارد في العنوان بجملة واحدة
GPT-6 Astra قريب جداً من Opus 5.5 في VibeVideoBench؛ تقييمه الإجمالي أعلى قليلاً، واستقراره في التسليم أقل قليلاً. تحمل نماذج OpenAI من الجيل التالي إشارات تقنية على إمكانية التحسن أكثر، لكن النتائج المنشورة المتخصصة في الفيديو ما تزال تعتمد على Astra كمرجع.
2,239 مهمة فيديو حقيقية: أيّهما أقوى، GPT-6 Astra أم Opus 5.5؟
2.1 كيف يقيس VibeVideoBench قدرات الفيديو لدى GPT وOpus 5.5
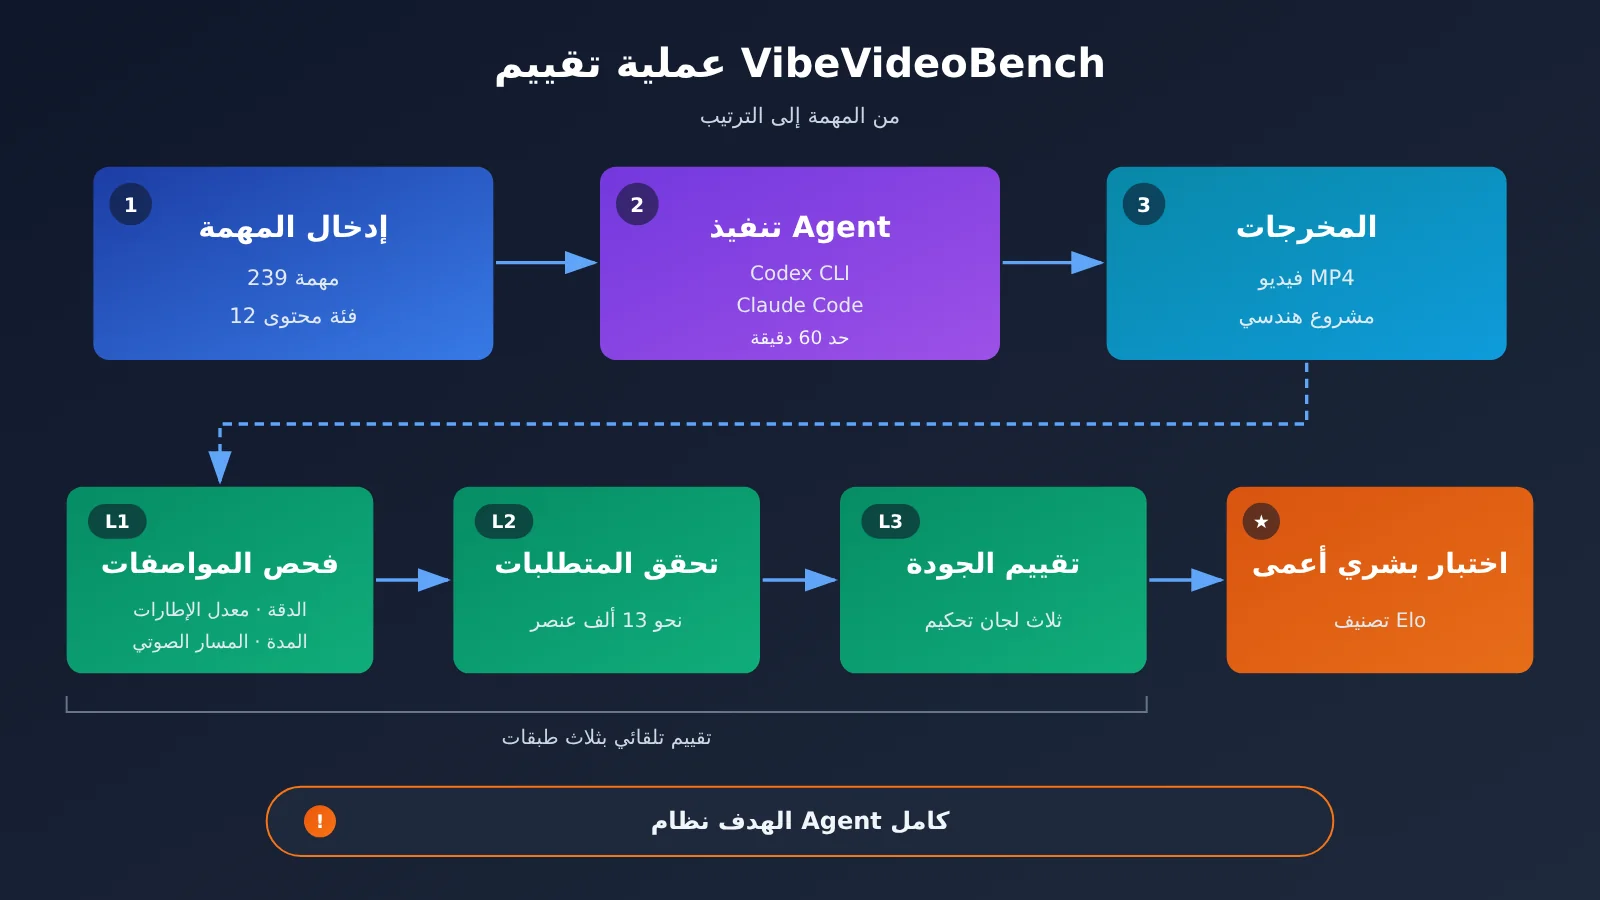
أعدّ VibeVideoBench قائمة من 239 مهمة إنتاج فيديو حقيقية، تغطي 12 فئة من المحتوى، واختبر 9 أنظمة Agent بإجمالي 2,151 تشغيلًا. كل مهمة تتطلب من الذكاء الاصطناعي إنجازها بنفسه داخل بيئة معزولة (sandbox)، وأن يسلّم ملف MP4 قابلًا للتشغيل، ومشروعًا هندسيًا يمكن إعادة توليد الفيديو منه، إضافة إلى تعليمات الإنتاج. لكل مهمة حدّ زمني أقصاه 60 دقيقة، وتستخدم جميع الأنظمة بيئة التطوير الأصلية الخاصة بها وبأقصى قوة استدلال متاحة، دون إضافة أي تعليمات بشرية في منتصف التنفيذ.
يعمل GPT-6 Astra داخل Codex CLI، ويعمل Claude Opus 5.5 داخل Claude Code. أما بقية الأنظمة المشاركة فتضم Claude Sonnet 5.5 وGemini 4 Argon وDeepSeek V4.1 Flash وKimi K3 وGLM-5.3 Flash وGPT-5.6 Sol وGemini 3.8 Flash. ويتم التقييم على ثلاث طبقات: الطبقة L1 تفحص هل تم تسليم ملف MP4، ومواصفاته مثل الدقة ومعدل الإطارات والمدة والمسار الصوتي؛ والطبقة L2 تتحقق بندًا ببند من نحو 13 ألف متطلب خاص بالمهمة؛ والطبقة L3 تتولى فيها ثلاثة أنظمة مراجعة متعددة الوسائط تقييم جودة الصورة وجماليتها ومنطق المحتوى وإيقاع الحركة وتزامن الصوت.
2.2 مقارنة النتائج الإجمالية بين GPT-6 Astra و Opus 5.5
| المؤشر | GPT-6 Astra | Claude Opus 5.5 | المتقدّم |
|---|---|---|---|
| الفيديوهات المسلّمة بنجاح | 238/239 | 239/239 | Opus |
| معدل تسليم الفيديو | 99.6% | 100% | Opus |
| معدل مطابقة المواصفات | 93.7% | 99.6% | Opus |
| معدل اجتياز متطلبات المهمة | 97.1% | 97.3% | Opus |
| جودة الفيديو | 4.08 | 3.99 | Astra |
| الجمال البصري | 4.30 | 4.19 | Astra |
| منطق المحتوى | 4.20 | 4.18 | Astra |
| الحركة والإيقاع | 3.95 | 3.95 | تعادل |
| جودة الصوت والمزامنة | 4.10 | 4.07 | Astra |
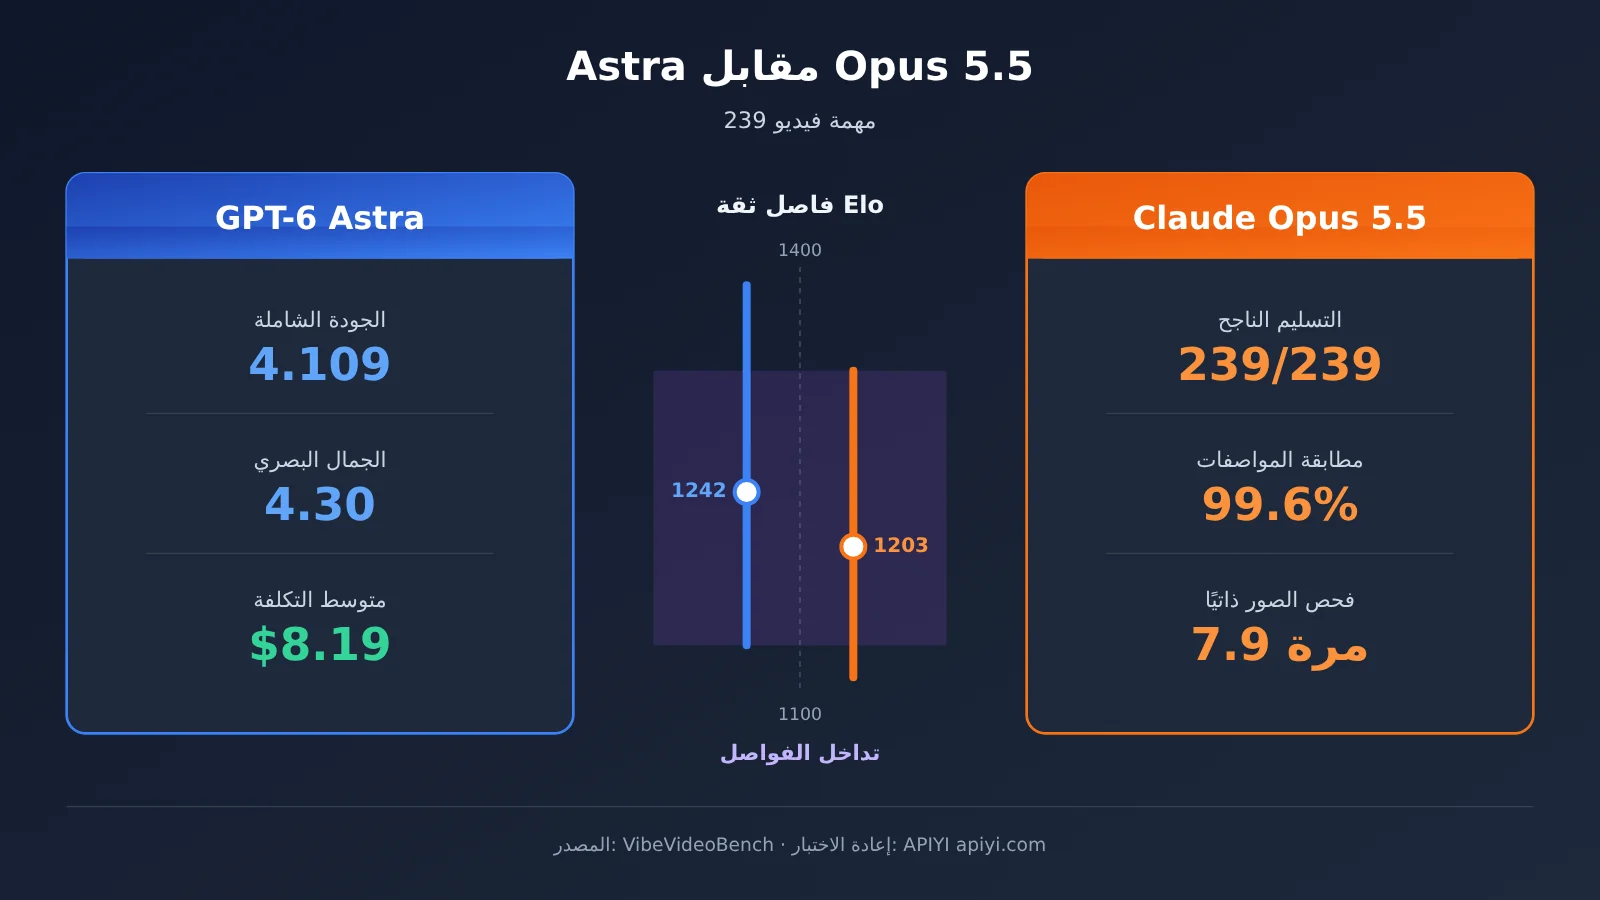
| درجة الجودة الإجمالية | 4.109 | 4.074 | Astra |
| معدل نجاح المهام الصارمة | 74.5% | 76.3% | Opus |
| Elo تفضيل البشر | 1242 | 1203 | لا يمكن التمييز إحصائيًا |
البيانات مأخوذة من متوسط نتائج ثلاث لجان تحكيم، ونطاق التقييم من 1 إلى 5. ويتقدّم النظامان على بقية الأنظمة المشاركة في الاختبار.
يُظهر هذا الجدول تقسيمًا واضحًا للأدوار: يتقدّم Astra قليلًا في “هل الفيديو الناتج يبدو جيدًا؟”، إذ يتقدّم بـ 0.035 نقطة في الجودة الإجمالية و0.11 نقطة في الجمال البصري؛ بينما Opus 5.5 أكثر موثوقية في “هل يمكنه التسليم وفق المواصفات؟”، إذ يزيد معدل مطابقة المواصفات بـ 5.9 نقطة مئوية، ومعدل نجاح المهام الصارمة بـ 1.8 نقطة مئوية. الفارق البالغ 0.035 نقطة صغير جدًا، ومع مراعاة فترة الثقة الخاصة بـ Elo، فإن النظامين يقعان في الفئة نفسها.
2.3 توزيع تفوق GPT وOpus 5.5 عبر أنواع الفيديو المختلفة
| فئة الفيديو | Astra | Opus 5.5 | المتفوق |
|---|---|---|---|
| العلامة التجارية والتسويق | 4.18 | 4.18 | تعادل |
| عرض المنتجات والميزات | 4.20 | 4.24 | Opus |
| الموسيقى والمحتوى المعتمد على الصوت | 3.83 | 3.92 | Opus |
| شرح الأوراق البحثية | 4.03 | 4.07 | Opus |
| شرح المفاهيم والعمليات | 4.19 | 4.15 | Astra |
| قصص البيانات والحقائق | 4.14 | 4.01 | Astra |
| الفنون البصرية | 3.94 | 3.91 | Astra |
| الألعاب والرياضة | 4.15 | 4.12 | Astra |
| الفعاليات والتعبير الشخصي | 4.03 | 3.93 | Astra |
| القصص والكوميديا البصرية | 4.00 | 3.88 | Astra |
| عمليات البناء والصناعة | 3.97 | 3.94 | Astra |
| التدريس في الصفوف | 4.47 | 4.45 | Astra |
البيانات مأخوذة من الملحق E.4 في الورقة البحثية، مع احتساب الفيديوهات غير المسلّمة بدرجة صفر.
تتفوق Astra في 8 فئات من أصل 12، وأكبر فرق لديها في قصص البيانات والحقائق (0.13) والقصص والكوميديا البصرية (0.12)؛ بينما يتفوق Opus 5.5 في عرض المنتجات، والمحتوى المعتمد على الموسيقى، وشرح الأوراق البحثية، ويبلغ الفرق في المحتوى المعتمد على الموسيقى 0.09. تتطلب مهام الموسيقى محاذاة عالية بين الصوت والصورة، كما يتطلب عرض المنتجات مواصفات وتفاصيل دقيقة، وهذا يتوافق مع اتجاه تفوق Opus في معدل مطابقة المواصفات. معظم الفروق بين الفئات ضمن 0.05 نقطة، وقد ظهر بالفعل اختلاف في اختيار النموذج بحسب نوع المهمة، لكن الفرق في فئة واحدة لا يزال يحتاج إلى اختبارات متكررة قبل الحكم عليه.
2.4 لماذا لا يزال Opus 5.5 قادرًا على المنافسة
يستخدم الاختبار البشري الأعمى نموذج Bradley–Terry لحساب تصنيف Elo. حصل Astra على 1242 (فاصل ثقة 95% بين 1134 و1387)، وحصل Opus على 1203 (1111–1327)، وفاصل الثقة في ترتيب كل منهما هو 1–3، واحتمال المقارنة الذي أورده البحث هو P=0.69، والاستنتاج هو أنه لا يمكن التمييز بينهما إحصائيًا. وتجدر الإشارة إلى أن الاختبار البشري يقيّم فقط الفيديوهات التي تم تسليمها بالفعل، ولا يستطيع قياس القدرة على التسليم في الموعد المحدد، والتسليم في الموعد هو بالضبط نقطة قوة Opus.
سلوك الفحص الذاتي يفسّر ذلك. فـ Opus يفحص الصور المُصيَّرة 7.9 مرات في المتوسط في كل تشغيل، ويستخدم ffprobe 3.9 مرات؛ أما Astra فـ 3.4 مرات و2.1 مرة على التوالي. يفحص Opus مخرجاته بوتيرة أعلى، ويكتشف المشكلات ثم يصلحها، فحصل مقابل ذلك على معدل تسليم 100% ومعدل مطابقة للمواصفات 99.6%. تصنّف Anthropic نموذج Opus 5.5 كنموذج Agentic Coding مخصص للتشغيل الطويل، وقد ذكر بعض المستخدمين في المجتمع أنه أنجز في نحو 30 دقيقة فيديو ترويجيًا لتطبيق iOS، وأنتج تلقائيًا فيديو إخباريًا قصيرًا عموديًا بدقة 1080×1920 مرفقًا بترجمة SRT. وهذه حالات فردية، ويمكن اعتبارها دليلًا غير مباشر على اكتمال سير العمل.
2.5 تكلفة مهام الفيديو: سعر GPT-6 Astra أعلى، لكن تكلفة المهمة الواحدة أقل
| المؤشر | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| سعر الإدخال القياسي (دولار/مليون توكن) | 10 | 4 |
| سعر الإخراج القياسي (دولار/مليون توكن) | 50 | 20 |
| متوسط تكلفة المهمة | $8.19 | $15.38 |
| تكلفة المهمة الوسيطة | $7.88 | $10.19 |
| تكلفة المهمة عند P90 | $11.88 | $31.22 |
| متوسط توكنات الإخراج | 61K | 130.7K |
| عدد استدعاءات API لكل مهمة | 46 | 51 |
| إصابة الذاكرة المؤقتة (Cache Hit) | 97% | 65% |
السعر القياسي لـ Astra يعادل 2.5 ضعف سعر Opus 5.5، لكن متوسط تكلفة المهمة أقل بنحو 46.7%. والسببان في ذلك هما: أن توكنات إخراج Astra أقل بنحو 53.3%؛ وأن معدل إصابة الذاكرة المؤقتة لدى Astra يبلغ 97%، في حين أن نحو 76% من تكلفة المهمة لدى Opus تأتي من كتابة الذاكرة المؤقتة (Cache Write). والفارق في التكلفة يظهر بوضوح أكبر عند P90، إذ تتقلب تكلفة Opus بشكل أكبر في المهام المعقدة. وتشير الورقة البحثية أيضًا إلى أن مجرد زيادة استهلاك التوكنات لم يُسفر عن تحسن مقابل في الجودة.
هذه المجموعة من التكاليف هي تكاليف مكافئة محسوبة وفق أسعار API المعلنة، ولا تشمل تكاليف العمالة والمواد لفيديو تجاري متكامل. ويوفر Batch API الرسمي لـ Opus 5.5 خصمًا بنصف السعر على الإدخال والإخراج، لذا يتغير هيكل التكلفة عند الإنتاج الدفعي دون اتصال.
💰 تحسين التكلفة: تتأثر تكلفة المهمة الواحدة لوكيل الفيديو بشدة بمعدل إصابة الذاكرة المؤقتة وطول الإخراج، والنظر إلى سعر الوحدة فقط قد يؤدي إلى تقدير خاطئ. نوصي بتشغيل المهمة نفسها على كلا النموذجين على APIYI apiyi.com، وحساب التكلفة على أساس «الاستهلاك الفعلي لكل فيديو نهائي»، بدلًا من المقارنة بالأسعار المعلنة.
3 إشارات على تحسّن قدرات الجيل القادم من GPT في OpenAI
3.1 بحث Navier–Stokes: النموذج الداخلي أقوى بكثير من GPT-6 Astra
في 8 سبتمبر 2026، نشرت OpenAI نتائج بحثها حول مسألة Navier–Stokes، إحدى مسائل جائزة الألفية. ويوضّح المقال الرسمي أن النموذج الداخلي المستخدم يتجاوز GPT-6 Astra بفارق واضح في القدرات، وأنه دُريب باستخدام التعلّم المعزّز على نطاق واسع، وكان التدريب لا يزال مستمرًا في وقت نشر الإعلان.
حجم التنفيذ في هذا البحث يمثّل في حد ذاته عرضًا مباشرًا لقدرات تعدد الوكلاء: شارك نحو 10,000 وكيل في الوقت نفسه، واستغرق البحث حوالي 88 ساعة، وأنتج 2.7 مليون رسالة ونحو 130 مليار رمز إخراج؛ وتوزّع الوكلاء على مجموعات تدرس نسخًا مختلفة من المسألة، وتبادلت المجموعات المعلومات فيما بينها، وتولّى Codex دمج النتائج الوسيطة، بينما ظل النظام يوجّه الموارد باستمرار نحو المسارات الأكثر جدوى. أما التحقق الشكلي بـ Lean فقد استغرق 17 ساعة إضافية، وأُجري باستخدام GPT-6 Astra.
بالنسبة لإنتاج الفيديو، فالأمر الأكثر صلة هنا هو جدولة المهام الطويلة والتعاون بين وكلاء متعددين، وليس القدرة الرياضية في حد ذاتها. فالفيديو المعقّد يحتاج أيضًا إلى معالجة النص والرسوم المتحركة والصوت على نحو متوازٍ، ثم إلى دمج وفحص وإعادة عمل.
3.2 BenchCAD 2.0: رفع القدرة الهندسية من 0.594 إلى 0.875
في 3 نوفمبر 2026، أعلنت OpenAI في مقالها «Accelerating engineering for the physical world» أن أحد النماذج الداخلية الأحدث حقّق متوسطًا قدره 0.875 في BenchCAD 2.0، بينما بلغ GPT-6 Astra عند أعلى مستوى استدلال 0.594، أي تحسّن نسبي بنحو 47.3%. وتشمل محتويات الاختبار إعادة بناء الأجزاء ثلاثية الأبعاد، وتصميم التجميعات الميكانيكية، والتعرّف على توصيلات PCB.
ينبغي النظر إلى هاتين الحجتين بشكل منفصل. فـ OpenAI لم توضّح ما إذا كان النموذج المستخدم في اختبار BenchCAD هو نفسه نموذج بحث Navier–Stokes، كما لم تُعلن الأسماء ولا مواعيد النشر. وBenchCAD هو اختبار هندسي أعلنت عنه OpenAI بنفسها، ويُعدّ إشارة إلى تقدّم في الفهم المكاني والمعرفة الهندسية المعقّدة، لكنه لا يقابل مهام توليد الفيديو بشكل مباشر.
3.3 متى تُصدر الجيل القادم من GPT: الحالة المعلنة حتى 15 نوفمبر
| التاريخ | التطورات المعلنة |
|---|---|
| 2 نوفمبر | وفقًا لصحيفة The National، صرّح Altman في ADIPEC بأن البحث الرياضي استخدم نموذج GPT يُصدر قريبًا، بمشاركة نحو 10,000 وكيل (Agent) على مدى نحو أربعة أيام؛ وقد أشار التقرير إلى أن هذا التصريح لم يُتحقّق منه بشكل مستقل |
| 3 نوفمبر | نشرت OpenAI بيانات النموذج الداخلي في BenchCAD 2.0 |
| 4 نوفمبر | نقلت The Information عن مصادر مطلعة أن OpenAI قد تطلق في موعد أقربه 6 نوفمبر جيلًا جديدًا من Astra وSol ونموذج الأمن السيبراني |
| 5 نوفمبر | أكّد OpenAI API Changelog إصدار GPT-6 Cyber، ولم يصدر جيلًا عامًا جديدًا من Astra أو Sol |
| 15 نوفمبر | لا يزال النموذج العام الرائد في كتالوج النماذج الرسمي هو GPT-6 Astra وGPT-6.1 Sol وGPT-6.1 Terra وGPT-6 Luna |
الأسماء المتداولة على الإنترنت مثل GPT-6.2 Astra وGPT-6.2 Sol لم تحصل حتى الآن على تأكيد رسمي من OpenAI. وينبغي الانتباه كذلك إلى أن VibeVideoBench يقيس GPT-6 Astra وGPT-5.6 Sol، ولا يمكن تطبيق نتائج Astra مباشرة على GPT-6.1 Sol أو Terra.
4 ما الذي يحتاجه الجيل القادم من GPT ليتجاوز Opus 5.5 في إنشاء الفيديو
4.1 العقبة الحقيقية أمام وكيل الفيديو: إدارة الوقت والتسليم
من إجمالي 2,151 عملية تشغيل في VibeVideoBench، لم تُسلِّم 224 عملية فيديو قابلًا للتشغيل. منها 169 حالة تعود إلى مشكلة في إدارة الوقت: بدء التصيير النهائي في وقت متأخر جدًا، أو تشغيل بطيء للغاية، أو عدم البدء إطلاقًا، وهو ما يمثل نحو 75% من إجمالي الإخفاقات. بيئة الاختبار عبارة عن حاوية Docker موحّدة بـ 8 أنوية CPU و32GB من الذاكرة ودون GPU، والتصيير وحده يستهلك وقتًا معتبرًا.
وهذا يعني أن تحسين قدرة النموذج على الاستنتاج يجب أن يترجم أيضًا إلى إيقاع التنفيذ. فمهما كتب النموذج رسومًا متحركة متقنة، فإن بدء التصيير في الدقيقة 55 يعني أن النتيجة ستظل صفرًا. لقد أصبح الفارق في الجودة بين Astra وOpus 5.5 بالكاد يُلمس، والمساحة المتاحة للجيل القادم من GPT ليصنع فارقًا حقيقيًا تكمن أساسًا في جانب التسليم.
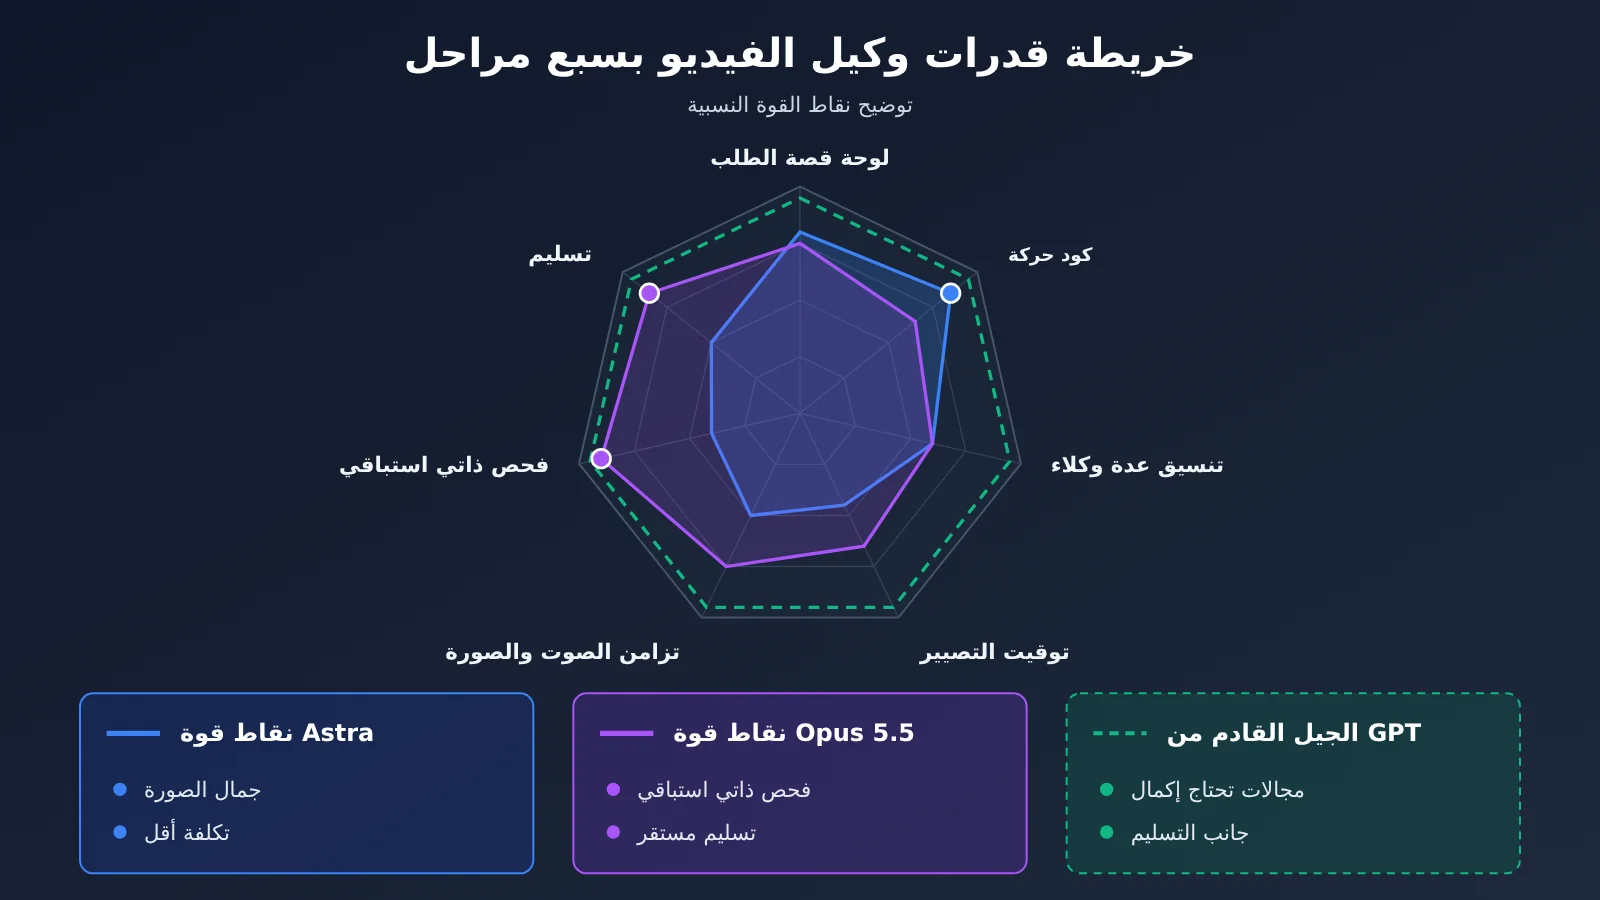
4.2 سبع نقاط يمكن للجيل القادم من GPT أن يطوّرها في سير عمل الفيديو
بالنظر إلى نقاط القوة والضعف الحالية لكل منهما، يحتاج الجيل القادم من النماذج إلى التقدم في العناصر التالية في الوقت نفسه ليتجاوز Opus 5.5 بوضوح:
- فهم المتطلبات ولوحة القصص: الفهم الدقيق للموضوع والجمهور والأسلوب، وتقسيم المتطلبات إلى ترتيب لقطات وخط زمني.
- شيفرة الرسوم المتحركة المعقدة: كتابة رسوم Remotion وThree.js وPython بشكل صحيح من المحاولة الأولى، لتقليل إعادة التصيير.
- تنسيق الوكلاء المتعددين: موازاة السيناريو والرسوم المتحركة والصوت، مع نقل قدرة التنسيق التي أظهرها النموذج الداخلي في البحث الرياضي إلى هذا النوع من المهام الهندسية.
- توقيت التصيير: حجز وقت كافٍ للتصيير، لتجنّب مشكلات إدارة الوقت التي تشكل نحو ثلاثة أرباع إجمالي الإخفاقات.
- تزامن الصوت والصورة: محاذاة التعليق الصوتي والمؤثرات الصوتية مع إيقاع الصورة، وهو الاتجاه الذي يتقدم فيه Opus في المهام المدفوعة بالموسيقى.
- الفحص الذاتي النشط: يفحص Opus الصورة 7.9 مرة في المتوسط مقابل 3.4 مرة لـ Astra، ويرتبط تكرار الفحص الذاتي ارتباطًا مباشرًا بنسبة مطابقة المواصفات.
- تسليم مستقر: ملف MP4 كامل مع مشروع قابل للتعديل، وتحقيق المواصفات من المحاولة الأولى.
5 بعد إصدار الجيل القادم من GPT، كيف تتحقق مما إذا كان يتجاوز Opus 5.5 فعلاً
5.1 طريقة اختبار مقارنة من سبع خطوات
لوحات التصنيف العامة تُشغَّل مرة واحدة فقط، وبحدٍّ زمني يبلغ 60 دقيقة، وتغلب عليها المهام الإنجليزية (209 من أصل 239 مهمة إنجليزية)، أما سيناريوهات الأعمال باللغة الصينية فتحتاج إلى إعادة اختبار بنفسك. ويمكن إعادة استخدام الطريقة التالية مباشرة في يوم إصدار النموذج الجديد:
| الخطوة | الإجراء | المؤشرات المرصودة |
|---|---|---|
| 1 تثبيت مجموعة المهام | اختيار 10—20 متطلب فيديو حقيقياً من الأعمال، تغطي كتابة السكربت والرسوم المتحركة وتصوّر البيانات وعرض المنتج | تغطية المهام |
| 2 تثبيت البيئة | توحيد سلسلة الأدوات (إصدارات Remotion/FFmpeg) وإعدادات الأجهزة والحدود الزمنية؛ مع تسجيل فروق Harness بشكل منفصل | قابلية المقارنة |
| 3 اختبار حسب المرحلة | أولاً اختبار لوحة القصة وكود الرسوم المتحركة عبر API بشكل منفصل، ثم تشغيل العملية الكاملة في بيئة الوكيل | درجة كل مرحلة |
| 4 تسجيل الاستهلاك | زمن كل تشغيل، ورموز الإدخال والإخراج (Token)، وإصابات الذاكرة المؤقتة | تكلفة الفيديو الواحد |
| 5 فحص التسليم | استخدام ffprobe للتحقق من الدقة ومعدل الإطارات والمدة والمسار الصوتي | معدل التسليم، معدل مطابقة المواصفات |
| 6 اختبار معمّى وتكرار | إخفاء أسماء النماذج وإجراء مقارنات ثنائية، وتشغيل كل مهمة 3 مرات على الأقل | معدل الفوز في التفضيل، التباين |
| 7 تقييم شامل | وزن مرجّح للجودة ومعدل النجاح وتكلفة التعديل وتكلفة الفيديو الواحد | استنتاج اختيار نهائي |
الخطوة 3 تفصل بين «قدرة النموذج» و«قدرة بيئة الوكيل (Agent)». فـ VibeVideoBench يقيس نظام وكيل متكاملاً، كما أن Codex CLI وClaude Code نفسهما يختلفان؛ وباستخدام نفس الواجهة المتوافقة مع OpenAI لاستدعاء النموذجين مباشرةً لتوليد لوحة القصة وكود الرسوم المتحركة، يمكن أولاً عزل تأثير Harness ورؤية الفرق بين النماذج نفسها بوضوح.
5.2 مثال برمجي للمقارنة على مستوى المراحل باستخدام واجهة موحدة
المثال المبسّط التالي يستدعي نموذجين عبر نفس base_url لإنتاج سكربت لقطات لنفس الطلب المتعلق بالفيديو. يُرجى اعتماد قائمة النماذج على منصة النماذج كمرجع لأسماء النماذج.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة: مفتاح واحد لاستدعاء GPT وClaude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
عرض سكربت المقارنة الكامل متعدد الدورات (مع تسجيل الزمن وToken)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # استدعاء موحد عبر APIYI، يسهّل التبديل والمقارنة
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # اعتمد قائمة النماذج على المنصة؛ أضف النماذج الجديدة مباشرة بعد إصدارها
RUNS = 3  # عدد مرات تكرار التشغيل لكل مهمة

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# احفظ النتائج، ثم أخفِ أسماء النماذج وسلّمها للمراجعين لإجراء اختبار أعمى
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 بداية سريعة: تتطلب المقارنة على مستوى المراحل استدعاء GPT وClaude في الوقت نفسه. ومن خلال APIYI على apiyi.com، يمكنك التبديل بين النموذجين بمفتاح API واحد وواجهة متوافقة مع OpenAI، كما يحصل المستخدمون الجدد على حصة اختبار مجانية. وعند إطلاق الجيل التالي من GPT، يكفي إضافة اسم النموذج إلى قائمة
MODELSلإعادة تشغيل المجموعة نفسها من المهام.
5.3 اعتبارات اختبار المسار الكامل
بعد اجتياز اختبار المراحل، شغّل مهام الفيديو الكاملة في Codex CLI وClaude Code، وسجّل معدل التسليم ونتائج فحص ffprobe. الاختبار البشري الأعمى يقيّم الفيديوهات المسلّمة فقط، لذلك يجب إحصاء معدل التسليم بشكل منفصل، وإلا سنكرر النقطة العمياء ذاتها في الاختبار البشري لـ VibeVideoBench. كرر كل مهمة 3 مرات على الأقل، واحسب المتوسط والتباين، لتجنب اعتبار نتيجة تشغيل واحد أداءً مستقرًا.
6 توصيات لاتخاذ القرار: كيف تختار بين GPT وOpus 5.5 في سيناريوهات الفيديو
6.1 اختيار GPT-6 Astra أو Opus 5.5 حسب السيناريو
بناءً على الدرجات التصنيفية وبيانات التسليم في VibeVideoBench، يمكن التوزيع على النحو التالي في الوقت الحالي:
- تفضيل GPT-6 Astra: القصص المبنية على البيانات والحقائق، وشرح المفاهيم والعمليات، وفيديوهات القصص والألعاب؛ والإنتاج بالجملة والسيناريوهات الحساسة للتكلفة لكل وحدة، حيث يبلغ متوسط تكلفة المهمة 8.19 دولار، وتكلفة P90 أكثر قابلية للتحكم أيضًا.
- تفضيل Claude Opus 5.5: عروض المنتجات والميزات، والفيديوهات المعتمدة على الموسيقى، وشرح الأوراق البحثية؛ والتسليم التجاري الذي يفرض متطلبات صارمة على المواصفات والتسليم، مثل دقة ثابتة ومدة محددة ومواد إعلانية يجب أن تحتوي على مسار صوتي.
- التسويق بالعلامة التجارية: حصل الاثنان على الدرجة نفسها 4.18، ويُحدَّد الاختيار بحسب التكلفة وسلسلة الأدوات الموجودة لدى الفريق.
6.2 هل ننتظر الجيل التالي من GPT أم نطلق الآن؟
النموذجان الحاليان قادران بالفعل على إنتاج فيديوهات قابلة للاستخدام بشكل مستقر، ولا حاجة لأن تنتظر الأعمال الجيل التالي من النماذج. الطريقة الأكثر عملية هي اعتماد منهج القسم 5 لبناء مجموعة مهامك ونتائجك الأساسية، ثم إعادة التشغيل يوم إصدار النموذج الجديد، واتخاذ قرار التبديل بناءً على البيانات.
💡 توصية الاختيار: يتركّز الفرق بينهما في استقرار التسليم وهيكل التكلفة، أما الاختيار النهائي فيعتمد على نوع الفيديوهات ومتطلبات التسليم لديك. ننصح باختبار كل منهما عبر APIYI على apiyi.com باستخدام نفس الدفعة من المهام الحقيقية؛ فالواجهة الموحدة تسهّل المقارنة جنبًا إلى جنب والانتقال لاحقًا إلى النموذج الجديد.
7 الخلاصة النهائية: هدف المنافسة للجيل القادم من GPT لم يعد مجرد اللحاق بـ Opus 5.5
7.1 النقاط الأساسية في قدرات الفيديو لدى GPT و Opus 5.5
- الوضع الحالي: كل من GPT-6 Astra وClaude Opus 5.5 في الصف الأول ضمن مهام الفيديو المدفوعة بالشفرة في VibeVideoBench، بجودة إجمالية 4.109 مقابل 4.074.
- مزايا Astra: الجمال البصري، والدرجات في معظم فئات المحتوى، وتكلفة المهمة المتوسطة الأقل بنحو 46.7%.
- مزايا Opus 5.5: تسليم 239/239 بالكامل، ونسبة مطابقة للمواصفات 99.6%، وفحص ذاتي أكثر تكرارًا.
- تفضيل البشر: 1242 مقابل 1203، مع تداخل فترات الثقة، فلا يمكن التمييز إحصائيًا.
- إشارة الجيل القادم: النموذج الداخلي بلغ 0.875 في BenchCAD 2.0 (Astra 0.594)، وأظهر قدرة تعاون على مستوى عشرات الآلاف من الوكلاء؛ ولم يُعلن الاسم ولا موعد الإصدار ولا نتائج الفيديو.
- العائق الحقيقي: نحو 75% من حالات فشل التسليم سببها إدارة الوقت، ومحور المنافسة يتحول من جودة التوليد إلى التنفيذ والتسليم.
- طريقة التحقق: مهام ثابتة وبيئة ثابتة واختبارات عمياء متعددة الجولات وحساب التكلفة لكل وحدة فيديو، ويمكن إعادة اختبار كل مرحلة عبر واجهة موحدة على APIYI apiyi.com.
7.2 نقطة نهاية المنافسة هي إنتاجية العمل الكاملة
عودة إلى العنوان: لقد لحق GPT بـ Opus 5.5، والنسخة الحالية Astra تتفوق قليلًا في الجودة والتكلفة، بينما يحافظ Opus 5.5 على تقدمه في موثوقية التسليم. أظهر النموذج الداخلي لدى OpenAI قدرات عامة أقوى وإمكانات تنفيذ متعددة الوكلاء، ولدى الجيل القادم من GPT العام فرصة لتحسين قدرة إنتاج الفيديو أكثر، أما المقدار الدقيق فعلى المستخدم انتظار التقييمات المستقلة بعد الإصدار واختباراتك التجارية الخاصة للإجابة عنه.
ستتركّز المنافسة المقبلة على إنتاجية العمل الكاملة: من فهم الفكرة إلى إخراج فيديو موثوق ودقيق وقابل للتعديل، ومن يستطيع إنجاز مهام أكثر بتكلفة أقل. أنصحك بأن تبني الآن خط أساس لمهام الفيديو الخاصة بك على APIYI apiyi.com، حتى تتمكن من المقارنة المباشرة بمجرد إطلاق النموذج الجديد.
المراجع
- موقع التقييم الرسمي لـ VibeVideoBench: لوحة ترتيب وكلاء الفيديو ودرجات الجودة
- الرابط:
vibevideobench.github.io -
الوصف: نظرة عامة على اللوحة الإجمالية وتصميم التقييم
-
ورقة VibeVideoBench البحثية: المنهجية، الدرجات التصنيفية، التكلفة، التفضيلات البشرية وأسباب الفشل
- الرابط:
arxiv.org/abs/2610.35864 -
الوصف: المصدر الرئيسي لبيانات الجداول في هذا المقال، والدرجات التصنيفية موجودة في الملحق E.4
-
إعلان إصدار Anthropic Claude Opus 5.5: تموضع النموذج والحالات الرسمية
- الرابط:
anthropic.com/claude-opus-5-5 -
الوصف: الوصف الرسمي لقدرات Opus 5.5 والتغيرات في التكلفة
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: النماذج الداخلية والبحث متعدد الوكلاء
- الرابط:
openai.com/index/navier-stokes-solution -
الوصف: بيانات 10,000 وكيل متزامن، و88 ساعة من البحث وغيرها
-
OpenAI: Accelerating engineering for the physical world: نتائج النماذج الداخلية في BenchCAD 2.0
- الرابط:
openai.com/index/accelerating-engineering-for-the-physical-world -
الوصف: مقارنة بين النموذج الداخلي 0.875 و GPT-6 Astra 0.594
-
OpenAI API Changelog وكتالوج النماذج: التحقق من تقدم الإصدار
- الرابط:
developers.openai.com/api/docs/changelog،developers.openai.com/api/docs/models -
الوصف: سجل إصدار GPT-6 Cyber والنماذج الرائدة العامة الحالية
-
OpenAI API Deprecations: معلومات إيقاف Sora 2 و Videos API
- الرابط:
developers.openai.com/api/docs/deprecations - الوصف: الوضع الحالي لمسار توليد الفيديو الأصلي
المؤلف: فريق APIYI التقني
التواصل التقني: نرحب بتواصلكم معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com لتبادل الخبرات في اختبار وكلاء الفيديو، ولمزيد من مواد التكامل يمكنكم زيارة مركز الوثائق docs.apiyi.com