
Zusammenfassung:Aus drei Perspektiven – Modell, Programmier-Agent und API-Kanal – vergleichen wir die in China verfügbaren Kombinationen und wählen dann anhand echter Programmieraufgaben, Kosten und Kompatibilität die passende Reproduktionslösung aus.
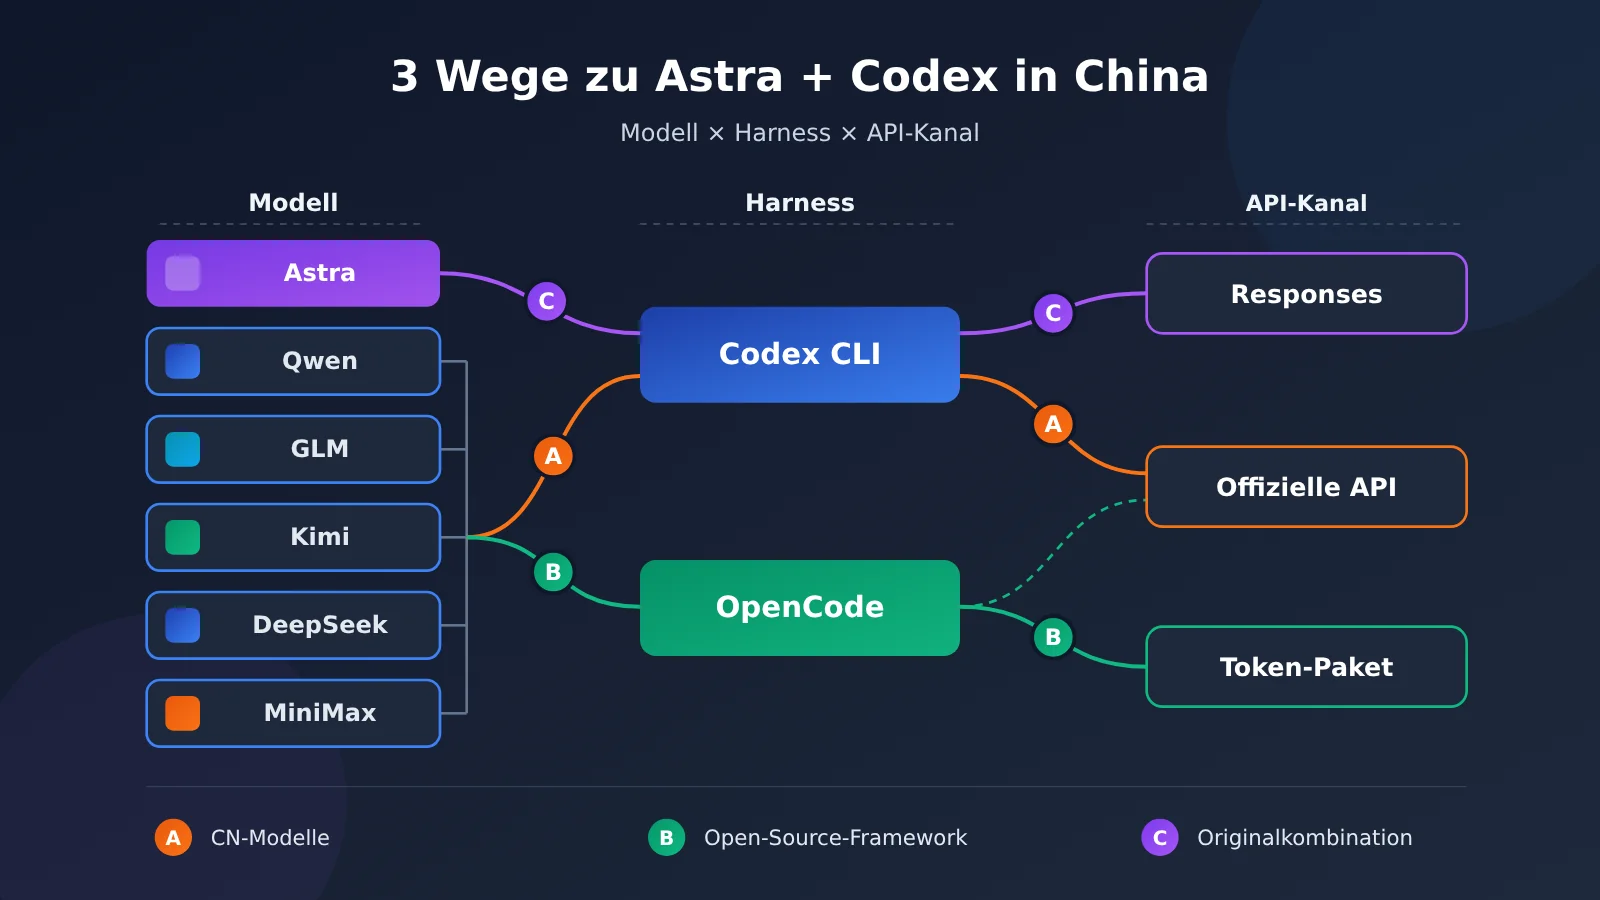
Astra + Codex in China so weit wie möglich zu reproduzieren, dafür gibt es drei testenswerte Wege. Route A: das Original-Codex-CLI beibehalten und über die Responses-kompatible Schnittstelle von Alibaba Cloud Bailian oder Tencent Cloud TokenHub die chinesischen Flaggschiffmodelle anbinden – diese Route bewahrt das Ausführungserlebnis von Codex. Route B: auf ein offenes Harness wie OpenCode wechseln und mehrere chinesische Modelle anbinden – diese Route bringt die größte Freiheit bei der Modellauswahl. Route C: unter der Voraussetzung von rechtlicher Konformität und tatsächlicher Dienstverfügbarkeit das Modell GPT-6 Astra beibehalten und das Original-Codex über einen API-Kanal anbinden, der das Responses-Protokoll vollständig unterstützt – diese Route hat die höchste Treue zur ursprünglichen Kombination.
Wenn eine Umstellung auf chinesische Modelle gefordert ist, ist Route A der Ausgangspunkt; dabei ist Qwen4-Max-Preview nur bis zum 25. November 2026, 24:00 Uhr geöffnet und eignet sich damit für Tests, aber nicht als einzige langfristige Abhängigkeit. Wenn nur die Nutzung im chinesischen Netzwerk gefordert ist, ohne Umstellung auf chinesische Modelle, kommt Route C in puncto Modellintelligenz dem Original am nächsten. Die endgültige Entscheidung zwischen den drei Routen sollte anhand der Erfolgsquote, der benötigten Zeit, der Kosten und der Tool-Kompatibilität bei derselben Charge echter Programmieraufgaben fallen – nicht anhand von Ranglisten oder Token-Stückpreisen.
Im Folgenden zerlegen wir Astra + Codex zunächst in fünf Fähigkeitskomponenten und erklären, was bei der „Reproduktion“ eigentlich reproduziert wird; dann stellen wir für Route A zwei offizielle Integrationskonfigurationen samt Tarifvergleich vor, für Route B vier Harnesses sowie die chinesischen Modelle, die vorrangig getestet werden sollten; anschließend fasst eine Übersichtstabelle die Abwägungen der drei Routen zusammen; und zum Schluss liefern wir eine reproduzierbare Testmethodik für fünf Aufgabentypen, die „Kosten pro erfolgreich erledigter Aufgabe“ als Kernkennzahl der Auswahl nimmt.
To Know: Fachbegriffe vorab
| Begriff | Erklärung |
|---|---|
| GPT-6 Astra | OpenAIs Flaggschiff-Reasoning-Modell, ausgelegt auf komplexes Reasoning, Software-Engineering und lang laufende Agent-Aufgaben. Die Modell-ID lautet gpt-6-astra. |
| Codex | OpenAIs Coding-Agent, der Projekte einlesen, Code ändern, Befehle ausführen und Ergebnisse verifizieren kann. |
| Harness | Ausführungsframework, das Modellentscheidungen mit echten Werkzeugen verbindet – zuständig für Tool-Schleifen, Kontext, Berechtigungen und Fehlerwiederherstellung. |
| Responses API | Schnittstellenprotokoll von OpenAI für Modellausgaben, Reasoning und Tool-Aufrufe; das neue Codex baut darauf auf. |
| Chat Completions | Älteres Dialog-Schnittstellenprotokoll von OpenAI; das alte Codex nutzt es. |
| Provider | Anbieter, der Agent-Tools Modell-Services bereitstellt; in der Konfigurationsdatei erscheint er als Satz von Zugangsparametern. |
| Base URL | Basisadresse der Modell-Service-API – sie ist es, die beim Wechsel des Kanals hauptsächlich geändert wird. |
| Token Plan | Abrechnungsmodell von Cloud-Anbietern, bei dem ein Monatspaket ein Kontingent für Modellaufrufe bereitstellt. |
| Credits / Punkte | Maßeinheit innerhalb eines Pakets, über die aufgerufenes Kontingent abgebucht wird; die Einheiten verschiedener Anbieter sind nicht direkt gegeneinander austauschbar. |
| Kontextfenster | Obergrenze für den Inhalt, den ein Modell in einer Anfrage verarbeiten kann, gemessen in Tokens. |
| Reasoning-Stufe | Parameter, der die Denktiefe des Modells steuert; Astra bietet fünf Stufen von low bis max. |
| Cache-Treffer | Wiederholt gesendete Eingaben werden vom Server wiederverwendet und zu einem niedrigeren Tarif abgerechnet. |
| MCP | Offenes Protokoll, das Modell-Anwendungen mit externen Werkzeugen und Datenquellen verbindet. |
| Function Calling | Mechanismus, bei dem das Modell eine strukturierte Aufrufanforderung ausgibt, die Anwendung die Funktion ausführt und das Ergebnis zurückschickt. |
| Peak-/Off-Peak-Abrechnung | Zeitabhängige Preisgestaltung: In Spitzenzeiten wird mehr Kontingent verbraucht. |
Hauptteil
1. Wo liegt eigentlich die Stärke von Astra + Codex?
1.1 Was Astra bietet
GPT-6 Astra ist das Flaggschiff-Reasoning-Modell von OpenAI. Die offizielle Positionierung umfasst komplexes Reasoning, Softwareentwicklung, mehrstufige Codeänderungen, Browser- und Computerbedienung, Recherche und Analyse sowie die Erstellung professioneller Dokumente. Was es für Codex bereitstellt, ist „Urteilsvermögen“: unbekannte Codebasen verstehen, Änderungspläne entwerfen, Fehlermeldungen richtig lesen und die Strategie entsprechend anpassen.
Die offiziellen Modellspezifikationen (Stand der Angaben: 13.11.2026) lauten wie folgt:
- Kontextfenster: 1,050,000 Token; maximale Ausgabe: 128,000 Token.
- Reasoning-Stufen: low, medium, high, xhigh, max.
- Standardpreise (USD / eine Million Token): Eingabe $10, Ausgabe $50, gecachte Eingabe $1, 30-minütiges Cache-Schreiben $12.50; ab mehr als 272K Token Eingabe gilt ein höherer Langkontext-Tarif.
- Responses-API-Tools: Web Search, File Search, Hosted Shell, Apply Patch, Computer Use, MCP und weitere.
Der letzte Punkt verdient eine eigene Betrachtung: Diese Tools sind Funktionen, die die OpenAI-Plattform bereitstellt. Ob ein bestimmter Client oder ein Drittanbieter-Gateway sie nutzen kann, hängt davon ab, welche Tools er tatsächlich integriert hat.
1.2 Welche Aufgaben übernimmt Codex
In dem im August 2026 veröffentlichten Codex-Harness-Artikel fasst OpenAI den Kern von Codex so zusammen: Agent-Schleife, Verstehen der Codebasis und Dateioperationen, Befehlsausführung, Tool-Aufrufe mit Ergebnisrückgabe, mehrstufige Kontextverwaltung, Benutzerfreigaben, Sicherheitsgrenzen der Sandbox sowie Beobachtung des Ausführungsprozesses und Wiederherstellung nach Fehlern.
Die Aufteilung ist klar: Das Modell übernimmt Urteilen und Generieren, das Harness setzt die Entscheidungen des Modells auf dem echten Dateisystem und im Terminal um. Ein noch so starkes Chat-Modell kann die komplette Programmieraufgabe „Projekt lesen → Code ändern → Tests ausführen → Fehler beheben → erneut prüfen“ erst dann bewältigen, wenn es mit diesem Ausführungssystem ausgestattet ist.
1.3 Was will man eigentlich nachbilden – das Modell oder den ganzen Agenten?
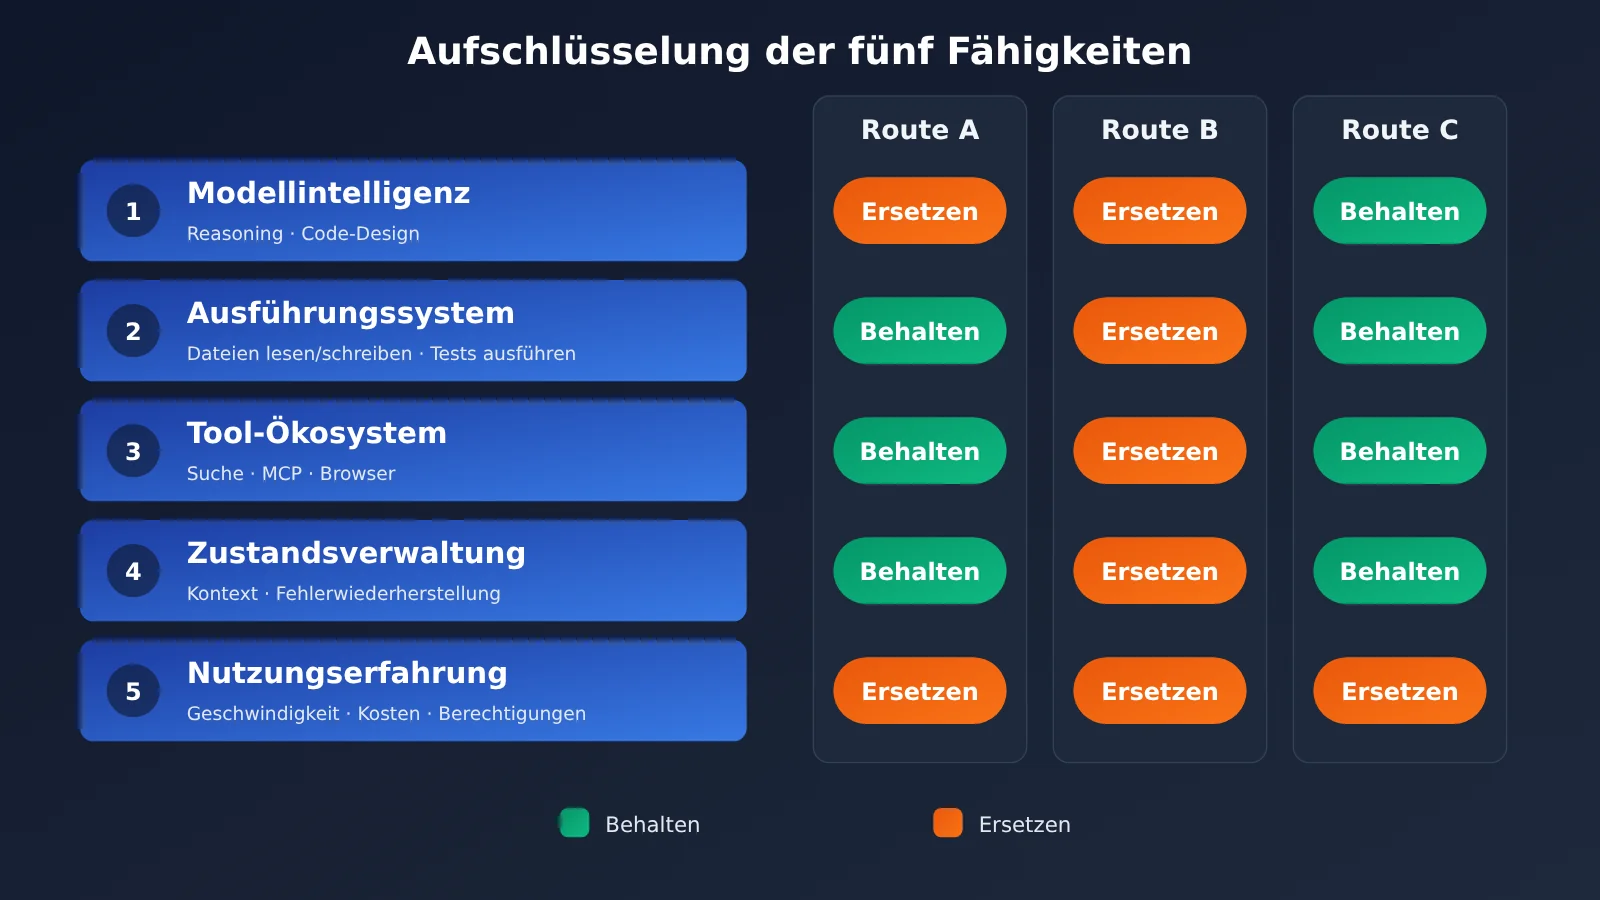
Zerlegt man das ursprüngliche Erlebnis, ergeben sich fünf Komponenten:
- Modellintelligenz: Verstehen komplexer Aufgaben, Code-Design, Reasoning und Debugging.
- Ausführungssystem: Projekt lesen, Dateien bearbeiten, Befehle ausführen, Tests laufen lassen.
- Tool-Ökosystem: Websuche, Webseiten lesen, MCP, Dateiverarbeitung, Browserbedienung.
- Zustandsverwaltung: Kontext für lange Aufgaben, Tool-Aufruf-Schleifen, Wiederherstellung nach Fehlern.
- Nutzererlebnis: Reaktionsgeschwindigkeit, Stabilität, Kosten, Rechteverwaltung und Bedienkomfort.
Ein Modellwechsel betrifft hauptsächlich Punkt 1 – doch der Nutzer erlebt am Ende die Summe aller fünf Punkte. Genau hier verläuft die Trennlinie zwischen den drei Routen: Route A tauscht Punkt 1 aus und behält Punkt 2 und 4; Route B ersetzt Punkt 1, 2 und 4 zugleich; Route C behält Punkt 1, 2 und 4 möglichst bei, und die Unterschiede konzentrieren sich auf Punkt 5 sowie auf Protokolldetails, die der API-Kanal mitbringt.
2 Codex beibehalten, chinesische Modelle anbinden (Route A)
2.1 Alibaba Cloud Bailian Token Plan + Codex
Alibaba Cloud hat eine offizielle Codex-Integrationsdokumentation veröffentlicht. Token Plan bietet eine Responses-kompatible Schnittstelle, mit der die neue Codex-Version direkt verbunden werden kann. Tragen Sie in ~/.codex/config.toml (unter Windows üblicherweise C:\Users\<用户名>\.codex\config.toml) Folgendes ein:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
In der Umgebungsvariable, auf die env_key verweist, muss der paketspezifische API-Schlüssel des Token Plan hinterlegt werden. Bei der Konfiguration gibt es einige technische Details, bei denen man leicht stolpert:
- Protokollversion: Codex verlangt ab Version 0.94.0 die Responses API. Der ältere Coding Plan von Alibaba Cloud verwendet Chat Completions und sollte laut offizieller Empfehlung mit Codex 0.93.0 oder einer älteren Version kombiniert werden. Für langfristig gepflegte Umgebungen sollte man den Token Plan wählen.
- Key-Isolation: Token Plan, Coding Plan und nutzungsbasierte Abrechnung verwenden drei unterschiedliche Sätze von API-Schlüsseln.
- Region: Token Plan unterstützt derzeit nur North China 2 (Peking).
- Modell-Metadaten: Neue Modelle benötigen eine korrekt konfigurierte Modell-ID und Metadaten, damit sie in der Modellauswahl von Codex vollständig unterstützt werden.
Derzeit ist bei Bailian vor allem Qwen4-Max-Preview (Modell-ID qwen4-max-preview) interessant, das am 11. November 2026 online ging. Laut offizieller Dokumentation handelt es sich um ein neues Flaggschiff-multimodales Modell, das Softwareentwicklung, komplexe Agenten-Aufgaben sowie Bild- und Videoverständnis unterstützt. Es bietet tiefes Nachdenken (standardmäßig aktiviert), Tool-Aufrufe, Websuche und strukturierte Ausgaben und ist mit den drei Protokollen OpenAI Chat Completions, Responses und Anthropic Messages kompatibel. Der Kontext umfasst 1 Mio. Token, das maximale Ausgabebudget beträgt 393.216 Token, wobei Nachdenken und endgültige Antwort sich dieses Budget teilen.
Auch die Nutzungsbedingungen sind eindeutig: Es wird derzeit nur im Token Plan angeboten, nutzungsbasierte Abrechnung wird nicht unterstützt; die Vorschauphase läuft von 11. November 2026, 10:00 Uhr Pekinger Zeit, bis 25. November 2026, 24:00 Uhr, danach wird es abgeschaltet. Bis zum Datum dieses Artikels bleiben weniger als zwei Wochen zum Testen – ideal, um schnell eine Bewertung durchzuführen. Für Produktionsumgebungen sollte gleichzeitig ein Alternativmodell bereitstehen.
2.2 Tencent Cloud TokenHub + Codex
Tencent Cloud bietet ein eigenes offizielles Integrations-Tutorial für die Codex CLI an. Die Schreibweise in derselben Konfigurationsdatei sieht so aus:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id muss durch die exakte Modell-ID ersetzt werden, die im Paket aktuell unterstützt wird. Die Modellbibliothek von TokenHub umfasst GLM-5.3, Kimi K3, die DeepSeek-V4-Serie, MiniMax M3, die Tencent Hunyuan Hy-Serie sowie einige leichtgewichtige und automatisch geroutete Modelle. Dasselbe Paket unterstützt außerdem Tools wie Claude Code, Cline und OpenClaw.
Der Vorteil von TokenHub liegt in „eine Codex-Konfiguration, mehrere chinesische Modelle“: Ändert man nur eine Zeile bei model, kann dasselbe Harness nacheinander GLM, Kimi, DeepSeek und MiniMax ausführen – ideal für Quervergleiche. Modellbestand, Versionen und Kontingentrichtlinien werden dynamisch angepasst. Vor jedem Test sollte man sich daher an der im Konsolen-Interface aufgelisteten Modell-ID orientieren.
2.3 Worin unterscheiden sich die beiden Pakete?
Beide heißen Token Plan, doch die Maßeinheiten sind unterschiedlich: Bailian rechnet in Credits, TokenHub in Punkten (积分). Eine direkte Umrechnung ist nicht möglich. Die Daten in der folgenden Tabelle haben den Stand 2026-11-13, alle Preise sind in RMB pro Monat angegeben:
| Vergleichsdimension | Alibaba Cloud Bailian Token Plan (Privatversion) | Tencent Cloud TokenHub Universal-Token-Plan (Privatversion) |
|---|---|---|
| Stufen und Monatsgebühr | Lite ¥39, Essential ¥79, Standard ¥139, Pro ¥312 | Lite ¥39, Standard ¥99, Pro ¥299, Max ¥599 |
| Monatliches Kontingent | 20.000 / 45.000 / 80.000 / 200.000 Credits | 780 / 1.980 / 5.980 / 11.980 Punkte |
| Empfohlene parallele Agents | 1—2 / 2—3 / 3—4 / 6—8 | In der Dokumentation gibt es keine vergleichbare Kennzahl |
| Rabatte und Vorteile | Lite, Essential: Erstkauf für neue Nutzer ¥19.5, ¥39.5 (bis 2026-11-30); Standard, Pro inklusive AgentStudio-Harness-Vorteil | Zeitlich begrenzte Rabatte auf die Abzugsraten einiger Modelle; beim Punktkauf gilt ¥1 = 20 Punkte |
| Codex-Anbindungsprotokoll | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| Repräsentative Modelle | Qwen-Serie, inklusive des nur im Token Plan erhältlichen Qwen4-Max-Preview | GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3, Hunyuan Hy |
| Abrechnungsweise | Credits werden je nach Modell abgezogen | Seit 2026-08-31 Abzug über Punkte, mit modellabhängigen Raten |
| Nutzungsbeschränkungen | Nur Region Nordchina 2 (Peking); interaktive Programmierpakete sollten nicht ohne Weiteres für beliebige kommerzielle Backend-Automatisierung eingesetzt werden | Modellbibliothek und Aktionsangebote können sich ändern |
Beim Vergleich dieser beiden Pakete sagt die Reihenfolge der Monatsgebühren wenig aus. Entscheidend ist die Frage: „Wie viel Kontingent wird für das Modell, das ich nutzen will, in diesem Paket pro erledigter Aufgabe abgezogen?“ Der Wert von Bailian liegt im Qwen-Ökosystem und im derzeit exklusiven Qwen4-Max-Preview; der Wert von TokenHub liegt darin, dass mehrere inländische Modelle ein gemeinsames Kontingent teilen.
TokenHub veröffentlicht die Punkte-Abzugsraten für die einzelnen Modelle. Die folgenden zeitlich begrenzten Aktionsraten wurden am 2026-11-13 abgefragt und nach ¥1 = 20 Punkten in RMB pro Million Token umgerechnet:
| Modell | Normaler Input | Output | Input mit Cache-Treffer | Anmerkung |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | Nach Ende der Aktion gilt wieder der Listenpreis |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | Für Szenarien mit Fokus auf Geschwindigkeit und Kosten |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | Nach Ende der Aktion gilt wieder der Listenpreis |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | Speziell auf Code ausgerichtetes Modell |
| DeepSeek V4.1 Flash (Nebenzeittarif) | ¥0.40 | ¥1.60 | ¥0.008 | Spitzen- und Nebenzeittarif |
| DeepSeek V4.1 Flash (Hauptzeit) | ¥0.80 | ¥3.20 | ¥0.016 | Werktags 09:00—12:00, 14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | Preis bei Input ≤ 512K Token |
Diese Tabelle sollte man zusammen mit zwei Punkten lesen. Erstens: Das Monatsabo wird über die Monatsgebühr des jeweiligen Pakets abgerechnet; die Beträge in der Tabelle sind der Referenzwert der Punkte und dienen dem Vergleich, wie schnell die einzelnen Modelle verbrauchen. Zweitens: Die Peak-/Off-Peak-Abrechnung von DeepSeek gilt ab dem 30. Oktober 2026 – der Verbrauch zu Spitzenzeiten liegt etwa doppelt so hoch wie zu Nebenzeiten. Asynchrone Aufgaben wie Code-Checks oder Testanalysen, die man nachts im Batch laufen lässt, sparen dadurch spürbar Kontingent.
Ein Rechenbeispiel mit GLM-5.3: Eine große Code-Aufgabe verbraucht insgesamt 100,000 Token normalen Input, 300,000 Token Cache-Treffer und 30,000 Token Output. Das ergibt einen Referenzpunktwert von 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232. Die Cache-Treffer machen den Großteil des Inputs aus – genau die typische Form einer Agent-Aufgabe. Das zeigt auch, dass die Cache-Rate die Gesamtkosten im Programmier-Szenario stark beeinflusst.
3 Bringt ein anderes Harness uns näher an Astra + Codex? (Route B)
3.1 OpenCode: Der Fokus liegt auf freier Modellwahl
OpenCode ist ein Open-Source-KI-Coding-Agent und unterstützt eine große Zahl von LLM-Providern: Mit /connect fügst du Anbieter hinzu, mit /models wechselst du das Modell. Eigene Base-URLs und lokale Modelle sind möglich, und der Agent läuft im Terminal, auf dem Desktop sowie in einigen Entwicklungsumgebungen. Er kann Dateien durchsuchen und ändern, Befehle ausführen und Agent-Workflows abwickeln. Alibaba Cloud stellt eine offizielle Integrationsanleitung bereit – wer dort „Alibaba Token Plan (China)“ auswählt, kann das Bailian-Paket nutzen.
Die offiziellen Sicherheitshinweise von OpenCode sollte man ernst nehmen: Der lokale Agent hat standardmäßig keine Isolation auf Systemebene, und eine Freigabe von Berechtigungen ersetzt weder Container noch virtuelle Maschine. Wer nicht vertrauenswürdigen Code ausführt oder Automatisierungsaufgaben mit hohen Rechten laufen lässt, sollte das in Docker oder einer VM tun.
3.2 Qwen Code, Kimi Code und DeepSeek Harness
Die drei nativen Harnesses bedienen jeweils das eigene Modell-Ökosystem:
- Qwen Code: Alibaba Cloud bietet drei Varianten – CLI, Desktop und IDE. In Bailian einloggen, Region auswählen, API-Schlüssel eingeben, schon ist die Anbindung fertig. Das Werkzeug durchsucht Codebasen, bearbeitet Dateien und führt Befehle aus. Teams, die überwiegend Qwen-Modelle einsetzen und den Aufwand für Protokollanpassungen klein halten wollen, sollten es zuerst in Betracht ziehen.
- Kimi Code CLI: Das von Moonshot AI gepflegte Terminal-Werkzeug fürs Programmieren. Es liest und ändert Code, ruft die Shell auf, holt Webinhalte, setzt Sitzungen fort, bietet Plan- und Freigabemodi sowie Editor-Integration und lässt sich auch mit kompatiblen Modellen von Drittanbietern konfigurieren. Unter Windows installiert man es über das offizielle PowerShell-Skript; es benötigt die Git Bash aus Git for Windows. Die alte Kimi CLI wurde im September 2026 eingestellt, neue Nutzer verwenden direkt die Kimi Code CLI.
- DeepSeek Harness: Ein Open-Source-Agent-Framework, das sowohl Web-UI als auch CLI anbietet. Eigene Provider und Tool-Konfigurationen werden unterstützt, und es lässt sich an verschiedene Abrechnungsmodelle von Bailian anbinden. Start über
npx @deepseek-ai/dsh web, die Standardadresse isthttp://127.0.0.1:3080. Bei der Auswahl sollte man vor allem auf die Stabilität der Tool-Ausführung, die Rechteverwaltung und die Anpassung an das Protokoll des Zielmodells achten.
3.3 Warum das Harness die Modellleistung beeinflusst
Dasselbe Modell in einem anderen Harness kann deutlich unterschiedliche Ergebnisse liefern. Der Grund: Das Harness entscheidet, was das Modell sieht, was es tun kann und was nach einem Fehler passiert:
- Strategie beim Code-Lesen: Wie viele Dateien auf einmal eingelesen werden und in welcher Reihenfolge gesucht wird, entscheidet, ob das Modell das Projekt vollständig versteht.
- Design der Tool-Schleife: Wie Tool-Ergebnisse zurückgegeben werden und ob nach einem Fehler automatisch ein neuer Versuch startet, entscheidet, ob lang laufende Aufgaben zu Ende gebracht werden.
- Kontextkomprimierung: Welche Teile des Verlaufs in langen Sitzungen erhalten bleiben und welche Details verworfen werden, wirkt sich direkt darauf aus, ob das Modell sein Ziel vergisst.
- Patches und Tests: Ob ganze Dateien überschrieben oder Diff-Patches verwendet werden und ob nach Änderungen standardmäßig Tests laufen, bestimmt die Trefferquote der Änderungen und das Regressionsrisiko.
Die Ergebnisse von Route B sind also immer die Kombinationsleistung aus „Modell + diesem Harness“. Beim Vergleich mit Route A sollte man im Hinterkopf behalten, dass die Ausführungsstrategien auf beiden Seiten grundsätzlich unterschiedlich sind.
4 Welche inländischen Modelle sind einen Test wert?
4.1 Qwen4-Max-Preview
Den öffentlich verfügbaren Spezifikationen zufolge machen das 1M-Kontextfenster, ein gemeinsames Budget von 393,216 Tokens für Denken und Ausgabe sowie Tool-Aufrufe und strukturierte Ausgaben das Modell geeignet für Tests mit komplexer Code-Erstellung, Langkontext-Analysen und mehrstufigen Agent-Workflows. Es ist gleichzeitig mit Responses und Anthropic Messages kompatibel und lässt sich sowohl in Codex als auch in Claude-Code-ähnliche Tools einbinden.
Die wichtigste Einschränkung bei der Auswahl ist das Zeitfenster: Die Preview endet am 2026-11-25 um 24:00 und wird dann abgeschaltet. Empfohlen ist, in diesem Zeitraum die komplette Testsuite damit laufen zu lassen und die Ergebnisse als Referenz für die späteren offiziellen Qwen-Modelle zu nutzen; in der Produktionsumgebung sollte parallel ein langfristig verfügbares Alternativmodell konfiguriert sein.
4.2 GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3
Alle vier Serien sind in einem TokenHub-Paket enthalten; die Zuordnung nach Aufgabentyp ist am wenigsten Aufwand:
- Komplexe Logik und Änderungen über mehrere Dateien: GLM-5.3, Kimi K3 und DeepSeek V4-Pro dienen als Vergleichsgruppe mit hoher Leistungsfähigkeit. Kimi K3 hat den höchsten Ausgabepreis in der Tabelle und eignet sich dafür, bei den schwierigsten Aufgaben die Obergrenze auszuloten.
- Code-spezifische Aufgaben: Kimi K2.7 Code dient speziell als Vergleich für Szenarien mit Code-Änderungen; zusammen mit der Kimi Code CLI lässt sich auch das native Erlebnis testen.
- Häufige Aufgaben mit niedrigen Kosten: GLM-5.3-Flash und DeepSeek V4-Flash für kosten- und geschwindigkeitskritische Szenarien wie Code-Prüfung und Massen-Refactoring.
- Langkontext-Stabilität und Genauigkeit der Tool-Aufrufe: MiniMax M3 kommt als Kandidat hinzu; beachten Sie, dass der Preis oberhalb der 512K-Eingabeschwelle steigt.
4.3 Wie lässt sich beurteilen, wer Astra am nächsten kommt?
Kontextlänge, Parameterzahl, Marketing-Positionierung und Token-Einzelpreis ergeben keine verlässliche Rangliste der Modelle, und die Werbe-Benchmarks aus verschiedenen Quellen sind kaum vergleichbar. Um zu beurteilen, „wer Astra + Codex am nächsten kommt“, gibt es nur einen verlässlichen Weg: im selben Harness und mit derselben Aufgabensammlung einheitlich Erfolgsquote, Ausführungszeit, Token-Kosten, Tool-Kompatibilität und Zahl der manuellen Eingriffe erfassen. Die genaue Methode steht in Abschnitt 6.
5 Drei Reproduktionswege – welchen sollte man konkret wählen?
5.1 Wenn Sie das Original-Codex-Bedienungserlebnis wollen: Weg A
Codex Harness beibehalten und einen inländischen Dienst anbinden, der das Responses-Protokoll offiziell unterstützt. Wer Qwen als Hauptmodell nutzt, wählt Bailian; wer zwischen mehreren chinesischen Modellen wechseln möchte, wählt TokenHub. Der Vorteil: geringe Lern- und Migrationskosten, Dateioperationen und das Agent-Ausführungssystem bleiben im Originalzustand. Der Kompromiss: Die Modellintelligenz unterscheidet sich von Astra, der Umsetzungsgrad der kompatiblen Schnittstelle beeinflusst das Tool-Calling-Erlebnis, und Kontext- sowie Reasoning-Parameter müssen für jedes Modell separat abgestimmt werden.
5.2 Wenn Sie chinesische Modelle und Modellfreiheit wollen: Weg B
OpenCode in Kombination mit einer inländischen Multi-Modell-API, bei Bedarf ergänzt durch Qwen Code, Kimi Code oder DeepSeek Harness. Das passt am besten zu Entwicklern, die langfristig mehrere Modelle nutzen und sich nicht an einen einzigen Anbieter binden wollen – und ist zugleich der bequemste Weg, verschiedene Modelle bei derselben Aufgabe direkt zu vergleichen. Der Preis dafür: Die Ausführungsstrategie unterscheidet sich von Codex, und die Anbindung mehrerer Provider bedeutet zusätzlichen Konfigurations- und Wartungsaufwand.
5.3 Wenn Sie die Astra-Fähigkeiten maximal erhalten wollen: Weg C
Weg C kombiniert „Original-Codex-CLI + GPT-6 Astra + nutzbarer API-Zugangsdienst“. Solange der Kanal tatsächlich das originale GPT-6 Astra bereitstellt und die von Codex benötigten Responses-API, Streaming-Events, Tool-Calls und Kontextverwaltung vollständig unterstützt, bleiben beide Kernkomponenten erhalten: Modell und Harness. Dieser Weg löst die Frage der Netzwerkverfügbarkeit – die Ablösung durch chinesische Modelle ist ein davon getrenntes Thema.
Am Beispiel von APIYI: Die Anbindung ist identisch mit Weg A, Sie tauschen lediglich die Provider-Konfiguration aus:
model_provider = "APIYI"
model = "gpt-6-astra"            # Maßgeblich ist die im APIYI-Konsolen tatsächlich aufgeführte Modell-ID
model_reasoning_effort = "high"  # Je nach Aufgabenschwierigkeit zwischen low ~ max anpassen

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Vor der Anbindung empfiehlt es sich, mit einem kurzen Skript zu prüfen, ob der Kanal das Responses-Protokoll und Tool-Calls wirklich unterstützt und nicht nur einfachen Text zurückgeben kann:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # ersetzen durch eine im Konsolen verfügbare Modell-ID
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# Im Normalfall sollte ein Ausgabeelement vom Typ function_call mit strukturierten Parametern zurückkommen
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # prüfen, ob Eingabe-, Ausgabe-, Cache- und Reasoning-Token getrennt ausgewiesen werden
Dieser Test deckt genau die drei Dinge ab, auf die Codex am meisten angewiesen ist: das Responses-Protokoll, die Function-Calling-Rückgabe und die separate Token-Abrechnung. Wenn das Skript durchläuft, binden Sie Codex an und führen eine vollständige Aufgabe aus, die „Code ändern + Tests ausführen“ umfasst, um zu bestätigen, dass Streaming-Events und mehrrundige Tool-Schleifen ordnungsgemäß funktionieren.
Selbst wenn das Modell identisch ist, hängt das Erlebnis von Route C weiterhin vom tatsächlichen Modell-Routing, der Inference-Stufe, der API-Latenz und dem Ausgabedurchsatz, den Cache-Treffern, der Gateway-Protokollkompatibilität und den Kosten des Kanals ab. Codex Desktop, Cloud-Aufgaben und die accountgebundenen Funktionen von ChatGPT stützen sich auf das eigene Autorisierungssystem von OpenAI. Über einen API-Schlüssel nutzt man die Kombination aus Codex CLI plus Modell-API – diese Funktionen sollte man bei der Planung bewusst ausklammern.
🚀 Tipp für den schnellen Einstieg: Wer Route A und Route C direkt vergleichen möchte, kann sich bei APIYI apiyi.com registrieren und ein kostenloses Testguthaben abholen, um im selben Codex-Umfeld einmal ein chinesisches Modell und einmal ein Modell der GPT-Reihe laufen zu lassen. Welche Modelle APIYI konkret anbietet und welche Protokolle unterstützt werden, entnehmen Sie bitte der Konsole und der Dokumentation unter docs.apiyi.com.
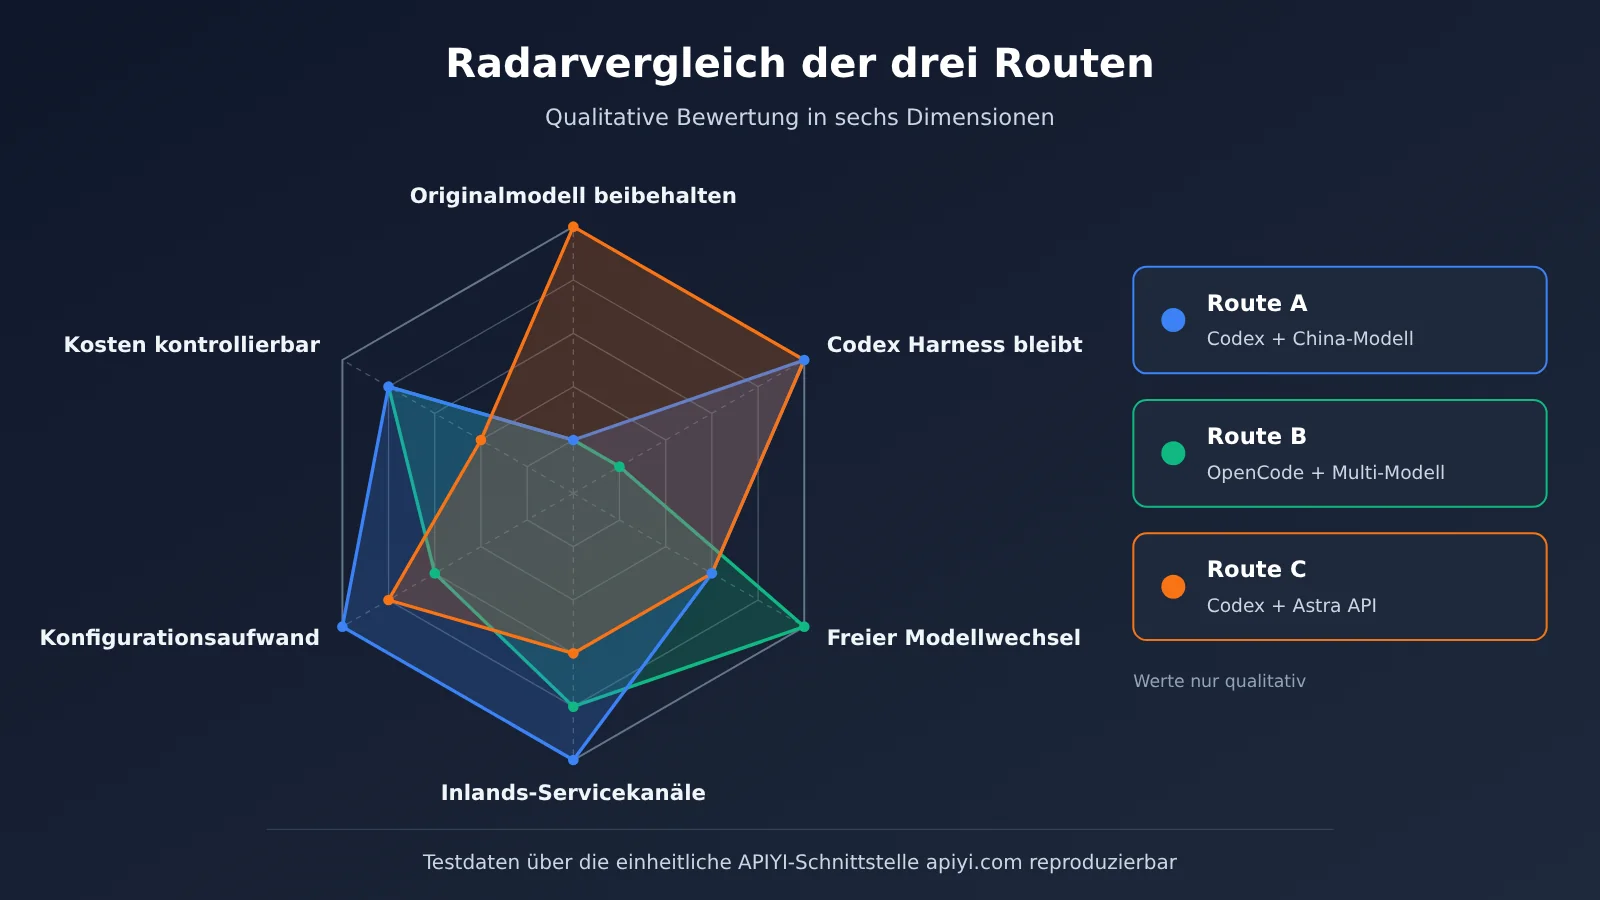
Die Vor- und Nachteile der drei Routen im Überblick:
| Vergleichsdimension | Route A: Codex + chinesisches Modell | Route B: OpenCode & Co. + mehrere chinesische Modelle | Route C: Codex + Astra API |
|---|---|---|---|
| Originalmodell beibehalten | Nein, ersetzt durch Qwen / GLM / Kimi usw. | Nein | Ja (sofern der Kanal dies verifizieren kann) |
| Codex-Harness beibehalten | Ja | Nein, ersetzt durch offenes Harness | Ja |
| Modellwechsel | Modell-ID innerhalb derselben Plattform ändern | freier Wechsel zwischen mehreren Providern | Wechsel zwischen den vom Kanal unterstützten Modellen |
| Lokale Servicekanäle | Alibaba Cloud Bailian, Tencent Cloud TokenHub | Bailian, TokenHub und weitere kompatible Dienste | Drittanbieter-Kanäle mit Responses-Unterstützung, z. B. APIYI apiyi.com |
| Konfigurationsaufwand | Gering, offizielle Fertigkonfiguration vorhanden | Mittel, mehrere Provider müssen gepflegt werden | Gering, sofern das Protokoll vorher verifiziert wird |
| Kostenmodell | Monatspaket (Credits / Punkte) | Paket oder verbrauchsabhängig, je nach Provider | Nutzungsbasierte Abrechnung, Astra-Preis pro Einheit höher als bei den meisten chinesischen Modellen |
| Passende Anforderungen | Originales Codex-Erlebnis + chinesische Modelle | Langfristiger Multi-Modell-Workflow | Maximale Bewahrung der Originalfähigkeiten |
5.4 Netzwerk- und Sicherheitsgrenzen bei der Nutzung in China
Eine Modell-API über eine in China erreichbare Adresse löst nur den Teil der Kette, der den Modellaufruf betrifft. Ein Agent greift im Betrieb außerdem auf Softwarequellen wie GitHub, npm und PyPI, auf externe offizielle Dokumentation, Drittanbieter-MCP-Dienste und die Websuche zu – die Erreichbarkeit dieser Wege muss separat geprüft werden. Auch die Internetsuche ist eine eigenständige Fähigkeit: die in Cloud-Plattformen integrierte Suche, die Netztools des Harness und eine selbst gebaute Search API / MCP haben jeweils eigene Zugriffs-, Abrechnungs- und Aufruflimits.
In puncto Sicherheit gilt: Ein Coding-Agent kann Dateien ändern, die Shell ausführen und Umgebungsvariablen lesen – daher empfehlen sich folgende Punkte:
- API-Schlüssel in Umgebungsvariablen oder einem Credential-Management-Tool speichern – niemals im Quellcode oder im Git-Repository ablegen.
- Komplexe Änderungen in einem separaten Git-Branch durchführen; das Projekt behält Versionskontrolle und wiederherstellbare Backups.
- Den Zugriff des Agenten auf sensible Dateien außerhalb des Arbeitsverzeichnisses beschränken; nicht vertrauenswürdigen Code in Containern oder virtuellen Maschinen ausführen.
- Für risikoreiche Vorgänge wie Löschen, Deployment und kostenpflichtige Aktionen bleibt eine manuelle Freigabe vorgesehen.
6 Tests mit realen Aufgaben sind wertvoller als Modell-Rankings
6.1 Fünf Aufgabentypen festlegen
Mit einem realen Projekt, das Frontend, Backend, Tests und Abhängigkeitskonfiguration umfasst, werden fünf Aufgabentypen entworfen, die jeweils die Modellfähigkeit und die Harness-Fähigkeit prüfen:
- Projektverständnis: Die Architektur und die Beziehungen der Schlüsselmodule erklären lassen. Dabei beobachten, wie Dateien lokalisiert werden, wie dateiübergreifende Abhängigkeiten verstanden werden und ob verifizierbare Pfadreferenzen geliefert werden.
- Dateiübergreifende Entwicklung: Eine neue Funktion hinzufügen, die Änderungen an mehreren Stellen erfordert. Dabei beobachten, wie genau die Änderungen sind, ob die Funktion vollständig ist und ob Regressionen eingeführt werden.
- Bug-Fixing: Ein Projekt mit einem reproduzierbar fehlschlagenden Test bereitstellen. Beobachten, ob die Grundursache gefunden, die richtige Stelle geändert, Tests aktiv ausgeführt und andere Testfälle nicht beschädigt werden.
- Langstreckiger Agent-Workflow: Die durchgehende Kette „Anforderungsverständnis → Codeänderung → Tests ausführen → Fehler entdecken → Reparieren → Erneut verifizieren“ abschließen. Beobachten, ob das Ziel beibehalten und die Strategie anhand von Fehlermeldungen angepasst wird.
- Online-Dokumentationsrecherche: Nach dem Lesen der neuesten SDK-Dokumentation einen Abschnitt alten API-Code migrieren. Beobachten, ob tatsächlich online der Haupttext abgerufen wird, ob die neue API im Code umgesetzt wird und ob „Tool nicht verfügbar“ und „Suchergebnis leer“ unterschieden werden können.
6.2 Erfolgsrate, Zeitaufwand und Kosten erfassen
Jede „Modell + Harness“-Kombination durchläuft denselben Aufgabensatz, mindestens dreimal wiederholt und gemittelt. Einheitlich werden dabei folgende Metriken erfasst:
| Metrik | Berechnung oder Beobachtungsmethode |
|---|---|
| Aufgaben-Erfolgsrate | Erfolgreich abgeschlossene Aufgaben / Gesamtaufgaben |
| Erst-Durchlauf-Rate | Anteil der Aufgaben, die ohne manuelle Korrektur beim ersten Versuch erfolgreich waren |
| Gesamtzeit pro Aufgabe | Von der Aufgabenausgabe bis zur finalen erfolgreichen Verifikation |
| Modellaufrufe | Kumulierte API-Anfragen pro Aufgabe |
| Tool-Aufrufe | Anzahl der Aufrufe von Lesen, Bearbeiten, Shell, Suche usw. |
| Token-Verbrauch | Input, Output, Cache-Treffer und Reasoning-Verbrauch aufgeschlüsselt |
| Tatsächliche Aufgabenkosten | Reale Kosten für eine erfolgreich abgeschlossene Aufgabe |
| Manuelle Eingriffe | Anzahl der manuellen Anpassungen und Korrekturen durch den Nutzer |
Um das Experiment reproduzierbar zu machen, werden folgende Variablen fixiert: derselbe Snapshot des Code-Repositorys, dieselbe Harness-Version, dieselbe Inferenzstufe bzw. dieselbe Denk-Einstellung, derselbe Zeitraum (besonders wichtig für Modelle mit Spitzen- und Nebenzeittarifierung wie DeepSeek). Vor jedem Aufgabenstart wird das Repository auf den Snapshot zurückgesetzt, damit die Änderungen der vorherigen Runde nicht die nächste beeinflussen.
6.3 Die Kosten einer erfolgreichen Aufgabe als zentrale Beschaffungsmetrik
Empfohlene Berechnung: Kosten pro erfolgreicher Aufgabe = Gesamtkosten aller Versuche ÷ Anzahl erfolgreicher Aufgaben. Die Kosten fehlgeschlagener Versuche müssen eingerechnet werden, denn auch sie verbrauchen Kontingent.
Ein Modell mit niedrigem Stückpreis ist nicht automatisch billig. Wenn ein Modell mehr Inferenzrunden, wiederholte Änderungen und erneute Versuche benötigt oder häufig manuelle Eingriffe erfordert, können die Gesamtkosten für eine Aufgabe die eines Modells mit höherem Stückpreis übersteigen, das beim ersten Mal richtig liegt. Umgekehrt können bei einfachen, häufig wiederkehrenden Aufgaben Modelle der Flash-Klasse mit niedrigem Stückpreis und hoher Geschwindigkeit echte Einsparungen bringen. Rechnet man die Kosten auf „pro erfolgreicher Aufgabe“ herunter, lassen sich beide Modelltypen auf derselben Skala vergleichen.
💰 Empfehlung zur Kostenbewertung: Kanäle mit pay-per-use-Abrechnung eignen sich am besten für solche Experimente, da sich Token-Aufschlüsselung und Kosten jeder Anfrage einzeln nachprüfen lassen. Über APIYI apiyi.com kann man mit einem Schlüssel mehrere Modelle aufrufen und die Abrechnungen der verschiedenen Modelle im selben Backend zusammenführen, um die Kosten pro erfolgreicher Aufgabe zu ermitteln.
7 APIYI-Szenario: Das Modell zu einer austauschbaren Komponente machen
Die bisherige Analyse führt zu einer einheitlichen Schlussfolgerung: Eine stabile KI-Programmierumgebung sollte das Harness festschreiben und das Modell als austauschbare Komponente behandeln. Codex oder OpenCode übernehmen die Ausführung und die Zustandsverwaltung, der API-Kanal stellt das Modell bereit, und das Modell wird je nach Aufgabenkomplexität und Budget flexibel gewechselt.
APIYI (apiyi.com) übernimmt in dieser Architektur die Rolle einer einheitlichen Zugriffsschicht: Ein API-Schlüssel ruft die gängigen Modelle wie OpenAI, Claude und Gemini auf, die Schnittstelle ist mit dem OpenAI-Protokoll kompatibel, und die Abrechnung erfolgt nach Verbrauch. Für Programmierer empfiehlt es sich, vor der Wahl eines beliebigen API-Kanals (einschließlich APIYI) die folgenden Punkte einzeln zu prüfen:
- Ob die für die aktuelle Codex-Version erforderliche Responses API und die Streaming-Events unterstützt werden.
- Die in der Konsole aufgelisteten tatsächlichen Modell-IDs und ob das Zielmodell verfügbar ist.
- Ob Tool-Aufrufe und Function Calling vollständig hin und zurück funktionieren.
- Ob Latenz und kontinuierliche Ausgabegeschwindigkeit den Anforderungen langer Aufgaben entsprechen.
- Ob die Cache-Nutzung korrekt erkannt und separat abgerechnet wird.
Diese Informationen richten sich nach der Service-Konsole und der technischen Dokumentation; das Erkennungsskript aus Abschnitt 5.3 lässt sich direkt zur Überprüfung verwenden. In der Praxis besteht die übliche Vorgehensweise darin, das Monatsabo von Route A für tägliche, häufig wiederkehrende Aufgaben zu nutzen und den verbrauchsbasierten Kanal für schwierige Probleme und Vergleichstests einzusetzen, die ein stärkeres Modell erfordern. Beide Provider werden in derselben config.toml eingetragen und über --profile oder eine Änderung von model_provider gewechselt.
8 Häufig gestellte Fragen
F1: Welcher Ansatz bietet bei der Nachbildung von Astra + Codex in China die höchste Wiedergabetreue?
Die höchste Wiedergabetreue bietet Route C: das originale Codex CLI zusammen mit einer echt nutzbaren GPT-6 Astra API. Damit bleiben beide Kernkomponenten erhalten – Modell und Harness. Voraussetzung ist, dass der Anbieter nachweislich das Originalmodell bereitstellt und das Responses-Protokoll samt Tool-Aufrufen vollständig unterstützt. Wenn eine Lokalisierung des Modells gefordert ist, ist Route A die beste Wahl, um das Codex-Ausführungserlebnis nachzubilden.
F2: Eignet sich Qwen4-Max-Preview für den langfristigen Einsatz in Codex?
Für die aktuelle Evaluierung ist es geeignet. Das Modell wird ausschließlich im Bailian Token-Plan angeboten und geht nach Ende der Vorschauphase am 25. November 2026 um 24:00 Uhr offline. Es empfiehlt sich, die Testaufgaben noch während der Vorschauphase abzuschließen und parallel ein langfristig verfügbares Alternativmodell für die Produktionsumgebung vorzubereiten.
F3: Warum lässt sich die neue Codex-Version nicht mit dem alten Coding-Plan von Alibaba Cloud verbinden?
Codex verlangt ab Version 0.94.0 die Responses API, während der alte Coding-Plan das Chat-Completions-Protokoll nutzt; offiziell wird dafür Codex 0.93.0 oder eine ältere Version empfohlen. Wechseln Sie zum Token-Plan und setzen Sie `wire_api = „responses“`, dann klappt es auch mit dem neuen Codex. Beachten Sie, dass der Token-Plan einen eigenen API-Schlüssel verwendet.
F4: Lassen sich die Credits von Bailian und die Punkte von TokenHub direkt vergleichen?
Ein direkter Vergleich ist nicht möglich. Beides sind Maßeinheiten der jeweiligen Plattform, und auch die Abbuchungsrate unterscheidet sich je nach Modell. Verlässlicher ist es, dieselbe Aufgabe auf beiden Seiten laufen zu lassen und zu vergleichen, welcher Anteil des Monatskontingents für eine erfolgreich abgeschlossene Aufgabe verbraucht wird.
F5: Wie lässt sich schnell prüfen, ob ein Drittanbieter-Kanal Codex ausführen kann?
Schicken Sie zunächst mit dem Python-Skript aus Abschnitt 5.3 eine Responses-Anfrage mit einem function-Tool und prüfen Sie, ob ein `function_call`-Ausgabeelement zurückkommt und die Nutzungsstatistik korrekt nach Posten aufgeschlüsselt ist. Binden Sie dann Codex ein und führen Sie eine vollständige Aufgabe inklusive Tests aus. Nach der Registrierung bei APIYI apiyi.com können Sie ein kostenloses Testkontingent erhalten und damit diesen Prüfschritt abschließen; welche Modelle konkret verfügbar sind, richtet sich nach der Konsole.
F6: Ist es normal, dass dasselbe Modell in OpenCode und Codex unterschiedlich abschneidet?
Ja, das ist normal. Das Harness bestimmt die Strategie zum Lesen von Code, die Tool-Schleife, die Kontextkomprimierung und die Testgewohnheiten – all das verändert die tatsächliche Leistung des Modells. Beim Vergleich sollte man entweder das Harness festhalten und das Modell testen oder das Modell festhalten und das Harness testen, damit nicht zwei Variablen gleichzeitig variieren.
F7: Bekommt man bei der Nutzung von Codex über einen API-Schlüssel die Codex-Funktionen aus einem ChatGPT-Abo?
Die API-Schlüssel-Variante bietet eine Kombination aus Codex CLI und Modell-API. Codex-Cloud-Aufgaben, die Desktop-Version und kontospezifische ChatGPT-Funktionen hängen von der Kontolizenzierung bei OpenAI ab; Drittanbieter-API-Kanäle können diese Leistungen nicht bereitstellen.
F8: Wie lassen sich die Gesamtkosten beim Wechsel zwischen mehreren Modellen im Griff behalten?
Indem Sie die Aufgaben nach Stufen aufteilen: schwierige Aufgaben an leistungsfähige Modelle, Massenprüfungen und einfache Refactorings an Modelle der Flash-Klasse, und bei Modellen mit Spitzen-/Nebenzeittarifierung asynchrone Aufgaben in die Nacht legen. Bewerten Sie einheitlich nach den Kosten pro erfolgreich abgeschlossener Aufgabe; bei volumenabhängigen Kanälen wie APIYI apiyi.com lässt sich der tatsächliche Verbrauch jedes Modells einzeln nachprüfen.
9 Zusammenfassung: Key Takeaways
- Drei Routen, drei Schwerpunkte: Route A bewahrt das Codex-Erlebnis, Route B die Modellfreiheit, Route C das Originalmodell.
- Astra + Codex ist eine Kombination aus fünf Schichten: Modell, Ausführungssystem, Tool-Ökosystem, Zustandsverwaltung und Nutzungserlebnis bestimmen gemeinsam das Ergebnis.
- Route A hat fertige Konfigurationen: Bailian und TokenHub stellen beide offizielle Codex-Konfigurationen bereit, der Kern ist
wire_api = "responses". - Qwen4-Max-Preview hat ein Enddatum: nur im Token-Plan verfügbar, am 2026-11-25 um 24:00 Uhr endet die Preview und das Modell wird abgeschaltet.
- Paket-Einheiten lassen sich nicht direkt vergleichen: Credits, Punkte, Token und RMB-Fen gehören zu unterschiedlichen Messsystemen – vergleichbar wird es erst mit einem Test an echten Aufgaben.
- Aufgaben sprechen lassen: fünf Arten realer Aufgaben, acht Metriken, die Kosten pro erfolgreich erledigter Aufgabe als Grundlage für die Beschaffung.
- Das Modell als austauschbare Komponente: feste Harness, einheitlicher Zugangskanal, Modellwechsel je nach Aufgabe – so bleibt die Umgebung stabil und kontrollierbar.
Der pragmatischste Einstieg: in derselben Codex-Umgebung zwei Provider konfigurieren – ein chinesisches Cloud-Paket für Alltagsaufgaben, ein nutzungsbasierter Kanal für Vergleichstests und schwierige Aufgaben. Einmal mit der Methode aus Abschnitt 6 durchlaufen, dann über die langfristige Kombination entscheiden. Empfohlen ist, über APIYI apiyi.com schnell eine Vergleichsgruppe aufzubauen und mit einer einheitlichen Schnittstelle chinesische Modelle und die GPT-Serie auf demselben Aufgabensatz zu prüfen.
📚 Referenzen
- Offizielle Modell-Dokumentation zu GPT-6 Astra: Modellspezifikationen, Inferenzstufen und Preisgestaltung
- Link:
developers.openai.com/api/docs/models/gpt-6-astra -
Beschreibung: Kontextfenster, maximale Ausgabelänge, Tool-Unterstützung und Tarife für lange Kontexte
-
OpenAI Codex Harness: Design des Codex-Ausführungsframeworks
- Link:
developers.openai.com/blog/codex-as-a-platform -
Beschreibung: Offizielle Erläuterungen zu Agent-Schleife, Tool-Rückgabe, Kontextverwaltung und Sandbox
-
Codex-Anbindung an Alibaba Cloud Model Studio (Bailian): So konfigurieren Sie den Token Plan
- Link:
help.aliyun.com/zh/model-studio/codex -
Beschreibung: Felder in der config.toml, Responses-Protokoll und Versionsanforderungen
-
Alibaba Cloud Token Plan Personal Edition: Tarifpreise und Credits
- Link:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
Beschreibung: Tarifstufen, Kontingente und Erstkauf-Rabatt nach der Anpassung vom 2026-11-09
-
Offizielle Dokumentation zu Qwen4-Max-Preview: Modellspezifikationen und Vorschauzeitraum
- Link:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
Beschreibung: 1M-Kontext, Protokollkompatibilität und Abschalttermin
-
Codex-CLI-Konfiguration für Tencent Cloud TokenHub: Offizielles Anbindungstutorial
- Link:
cloud.tencent.cn/document/product/1823/130071 -
Beschreibung: Provider-Konfiguration und Vorgehen beim Ersetzen der Modell-ID
-
Tarife und Credit-Raten von Tencent Cloud TokenHub: Abrechnungsregeln
- Link:
cloud.tencent.cn/document/product/1823/130060 - Link:
cloud.tencent.com/document/product/1823/133811 -
Beschreibung: Tarifstufen, Credit-Raten der Modelle sowie Abrechnung zu Spitzen- und Nebenzeiten
-
Offizielles Repository von OpenCode: Open-Source-Coding-Agent
- Link:
github.com/anomalyco/opencode -
Beschreibung: Provider-Konfiguration und Sicherheitshinweise
-
Qwen Code, Kimi Code CLI, DeepSeek Harness: Native Harnesses
- Link:
help.aliyun.com/zh/model-studio/qwen-code - Link:
github.com/MoonshotAI/kimi-code - Link:
help.aliyun.com/zh/model-studio/deepseek-harness - Beschreibung: Installation, Anbindung und Funktionsumfang
Autor: Technikteam von APIYI
Fachlicher Austausch: Schreiben Sie uns gerne über die Startseite der offiziellen APIYI-Website an – weitere Unterlagen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com


