Resumen: Comparamos las combinaciones disponibles en China desde tres capas —modelo, agente de programación y canal de API— y luego, con tareas reales de programación, costos y compatibilidad, elegimos el plan de reproducción que mejor se adapte.
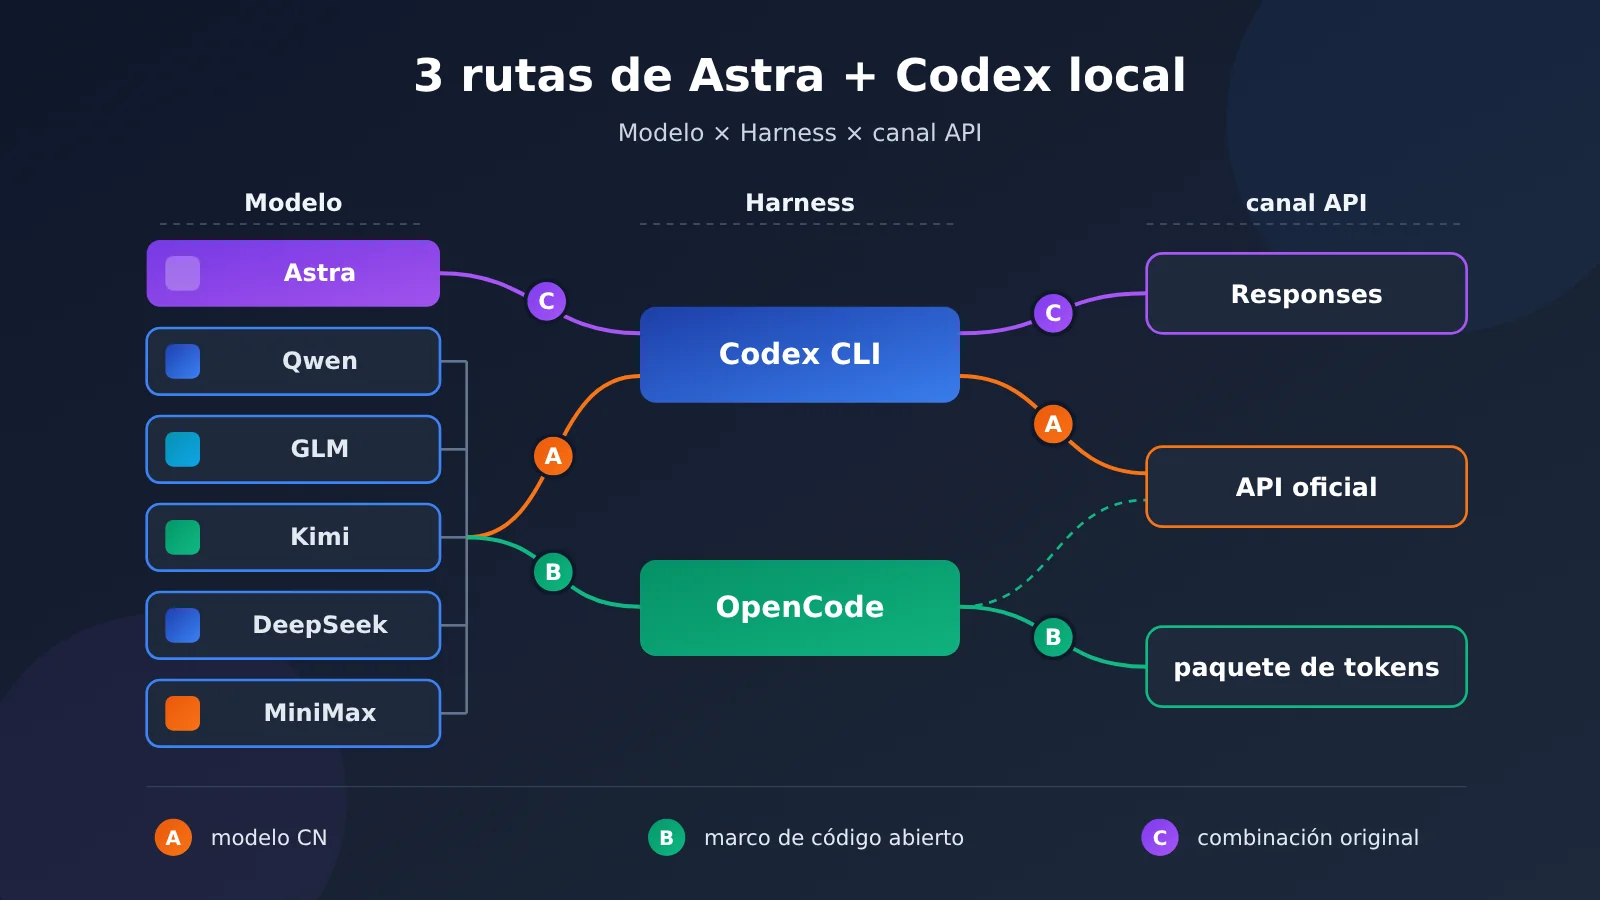
La reproducción más fiel de Astra + Codex en China tiene tres rutas que vale la pena probar. Ruta A: mantener el Codex CLI original y acceder a modelos insignia chinos mediante las interfaces compatibles con Responses de Alibaba Cloud Bailian o Tencent Cloud TokenHub. Esta ruta conserva la experiencia de ejecución de Codex. Ruta B: cambiar a Harness abiertos como OpenCode para conectar varios modelos chinos. Esta ruta ofrece la mayor libertad de elección de modelo. Ruta C: siempre que sea legal y conforme a la normativa y que el servicio esté realmente disponible, mantener el modelo GPT-6 Astra y conectarlo al Codex original mediante un canal de API que soporte por completo el protocolo Responses. Esta ruta es la que reproduce con mayor fidelidad la combinación original.
Si se exige que el modelo sea chino, la ruta A es el punto de partida; Qwen4-Max-Preview solo está disponible hasta las 24:00 del 25 de noviembre de 2026, por lo que es adecuado para evaluación, no como única dependencia a largo plazo. Si solo se exige usarlo en el entorno de red de China, sin exigir que el modelo sea chino, la ruta C es la más cercana al original en cuanto a inteligencia del modelo. La decisión final entre las tres rutas debe basarse en la tasa de éxito, el tiempo, el costo y la compatibilidad de herramientas de un mismo lote de tareas reales de programación, no en rankings ni en el precio por token.
A continuación, primero descomponemos Astra + Codex en cinco componentes de capacidad para aclarar qué se reproduce realmente; después presentamos las dos configuraciones oficiales de integración y la comparación de planes de la ruta A, los cuatro Harness de la ruta B y los modelos chinos que conviene probar primero; luego resumimos en una tabla general los compromisos de las tres rutas; y, por último, damos un método reproducible de pruebas con cinco tipos de tareas, tomando el «costo por tarea exitosa» como indicador central para elegir.
Lo que hay que saber: terminología básica
| Término | Explicación |
|---|---|
| GPT-6 Astra | Modelo insignia de razonamiento de OpenAI, orientado a razonamiento complejo, ingeniería de software y tareas de agente de larga duración; su ID de modelo es gpt-6-astra. |
| Codex | Agente de programación de OpenAI, capaz de leer proyectos, modificar código, ejecutar comandos y verificar resultados. |
| Harness | Marco de ejecución que conecta las decisiones del modelo con herramientas reales; se encarga del bucle de herramientas, del contexto, de los permisos y de la recuperación ante fallos. |
| Responses API | Protocolo de interfaz de OpenAI que admite la salida del modelo, el razonamiento y la invocación de herramientas; la nueva versión de Codex depende de él para funcionar. |
| Chat Completions | Protocolo de interfaz de conversación más antiguo de OpenAI; la versión anterior de Codex lo utiliza. |
| Provider | Proveedor que presta servicios de modelo a las herramientas de agente; en el archivo de configuración se representa como un conjunto de parámetros de conexión. |
| Base URL | Dirección base de acceso a la API del servicio de modelos; al cambiar de canal, es principalmente lo que se modifica. |
| Token Plan | Esquema de facturación en el que el proveedor de nube ofrece una cuota mensual de invocaciones del modelo mediante un paquete. |
| Credits / créditos | Unidad de medida dentro de un paquete que se usa para descontar la cuota de invocaciones; las unidades de distintos proveedores no son directamente intercambiables. |
| Ventana de contexto | Límite de contenido que el modelo puede procesar en una sola solicitud, medido en tokens. |
| Nivel de razonamiento | Parámetro que controla la profundidad de pensamiento del modelo; Astra ofrece cinco niveles, de low a max. |
| Acierto de caché | Cuando el servidor reutiliza una entrada enviada repetidamente, se factura a una tarifa más baja. |
| MCP | Protocolo abierto que conecta aplicaciones de modelos con herramientas externas y fuentes de datos. |
| Function Calling | Mecanismo por el cual el modelo emite solicitudes de invocación estructuradas, la aplicación ejecuta la función y devuelve el resultado. |
| Facturación por franjas horarias | Los precios se distinguen según la franja horaria; en horas pico se consume más cuota. |
Contenido
1 ¿Qué hace que Astra + Codex sea tan potente?
1.1 ¿Qué aporta Astra?
GPT-6 Astra es el modelo de razonamiento insignia de OpenAI. Su posicionamiento oficial abarca razonamiento complejo, ingeniería de software, modificación de código en múltiples pasos, operación de navegadores y computadoras, análisis de investigación y producción de documentos profesionales. Lo que aporta a Codex es “capacidad de juicio”: entender bases de código desconocidas, diseñar planes de cambio, interpretar los errores y ajustar la estrategia.
Las especificaciones oficiales del modelo (datos verificados el 2026-11-13) son las siguientes:
- Ventana de contexto: 1,050,000 tokens; salida máxima: 128,000 tokens.
- Niveles de razonamiento: low, medium, high, xhigh, max.
- Precio estándar (USD / millón de tokens): entrada $10, salida $50, entrada en caché $1, escritura en caché de 30 minutos $12.50; cuando la entrada supera los 272K tokens se aplica una tarifa de contexto largo más alta.
- Herramientas de Responses API: Web Search, File Search, Hosted Shell, Apply Patch, Computer Use, MCP, etc.
El último elemento requiere una explicación aparte: estas herramientas son capacidades que ofrece la plataforma OpenAI; que un cliente o una pasarela de terceros pueda usarlas depende de qué herramientas haya integrado realmente.
1.2 ¿Qué tareas completa Codex?
En el artículo sobre Codex Harness publicado por OpenAI en agosto de 2026, el núcleo de Codex se resume en el bucle del agente, la comprensión de la base de código y la operación de archivos, la ejecución de comandos, la invocación de herramientas y la devolución de resultados, la gestión de contexto multiturno, la aprobación del usuario, los límites de seguridad del sandbox, y la observación del proceso de ejecución y la recuperación ante fallos.
La división de responsabilidades está clara: el modelo se encarga del juicio y la generación, mientras que el Harness se encarga de llevar las decisiones del modelo al sistema de archivos y al terminal reales. Un modelo de chat muy potente solo puede completar la tarea de programación completa de “leer el proyecto → modificar código → ejecutar pruebas → corregir fallos → volver a verificar” cuando cuenta con este sistema de ejecución.
1.3 ¿Replicamos el modelo o todo el agente?
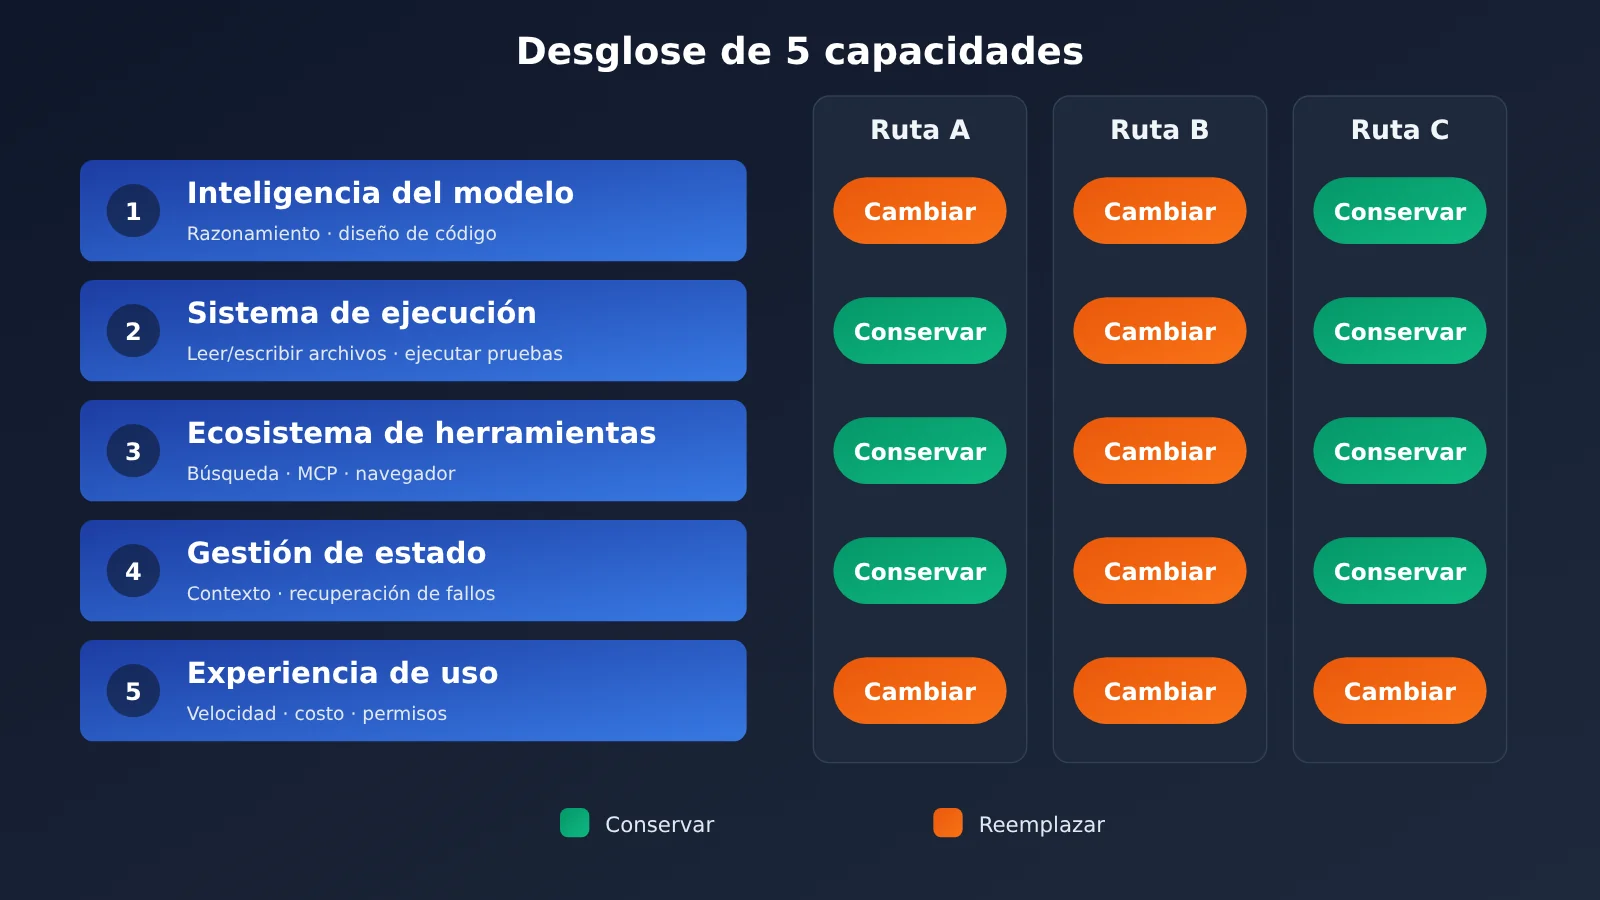
Si descomponemos la experiencia original, obtenemos cinco componentes:
- Inteligencia del modelo: comprensión de tareas complejas, diseño de código, razonamiento y depuración.
- Sistema de ejecución: lectura de proyectos, edición de archivos, ejecución de comandos y ejecución de pruebas.
- Ecosistema de herramientas: búsqueda en internet, lectura de páginas web, MCP, procesamiento de archivos y operación del navegador.
- Gestión de estado: contexto de tareas largas, bucle de invocación de herramientas y recuperación ante fallos.
- Experiencia de uso: velocidad de respuesta, estabilidad, costo, control de permisos y facilidad de operación.
Cambiar el modelo afecta principalmente al punto 1, pero lo que el usuario percibe al final es la suma de los cinco. Aquí es donde se separan las tres rutas: la ruta A reemplaza el punto 1 y conserva los puntos 2 y 4; la ruta B reemplaza al mismo tiempo los puntos 1, 2 y 4; la ruta C conserva, en la medida de lo posible, los puntos 1, 2 y 4, y las diferencias se concentran en el punto 5 y en los detalles de protocolo que introduce el canal de API.
2 Mantener Codex y conectar modelos chinos (ruta A)
2.1 Alibaba Cloud Bailian Token Plan + Codex
Alibaba Cloud ya publicó la documentación oficial de integración con Codex; Token Plan ofrece una interfaz compatible con Responses y puede conectarse directamente con la nueva versión de Codex. En ~/.codex/config.toml (en Windows, normalmente C:\Users\<nombre de usuario>\.codex\config.toml) escribe:
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
En la variable de entorno a la que apunta env_key debe ir la clave API exclusiva del paquete Token Plan. A la hora de configurar hay varios detalles técnicos en los que es fácil tropezar:
- Versión del protocolo: desde la versión 0.94.0, Codex exige la API Responses. El antiguo Coding Plan de Alibaba Cloud usa Chat Completions, y la recomendación oficial es combinarlo con Codex 0.93.0 o una versión anterior; los entornos que se mantienen a largo plazo deberían optar por Token Plan.
- Aislamiento de claves: Token Plan, Coding Plan y el pago por uso utilizan tres conjuntos distintos de claves API.
- Región: Token Plan actualmente solo admite China North 2 (Pekín).
- Metadatos del modelo: los modelos nuevos necesitan que el ID y los metadatos estén configurados correctamente para obtener compatibilidad completa en la interfaz de selección de modelos de Codex.
Lo más destacado de Bailian en este momento es Qwen4-Max-Preview, disponible desde el 11 de noviembre de 2026 (ID de modelo qwen4-max-preview). La documentación oficial confirma que se trata de un nuevo modelo insignia multimodal de última generación: admite desarrollo de código, tareas complejas de agentes, comprensión de imágenes y video, razonamiento profundo (activado por defecto), invocación de herramientas, búsqueda en internet y salida estructurada, y es compatible con los tres protocolos OpenAI Chat Completions, Responses y Anthropic Messages. Longitud de contexto de 1M tokens, presupuesto máximo de salida de 393,216 tokens, y tanto el razonamiento como la respuesta final comparten ese presupuesto.
Sus condiciones de uso también son claras: por ahora solo está disponible en Token Plan y no admite pago por uso; el periodo de vista previa va del 11 de noviembre de 2026 a las 10:00 (hora de Pekín) al 25 de noviembre a las 24:00, y después se retira. A la fecha de este artículo queda menos de dos semanas para probarlo, así que conviene aprovechar para hacer evaluaciones; los entornos de producción deberían preparar también modelos alternativos.
2.2 Tencent Cloud TokenHub + Codex
Tencent Cloud ofrece un tutorial oficial específico para integrar Codex CLI; el mismo archivo de configuración se escribe así:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
Hay que reemplazar $model_id con el ID exacto del modelo que admite el paquete actualmente. La biblioteca de modelos de TokenHub incluye GLM-5.3, Kimi K3, la serie DeepSeek V4, MiniMax M3, la serie Hunyuan Hy de Tencent y algunos modelos ligeros y de enrutamiento automático; el mismo paquete también admite herramientas como Claude Code, Cline y OpenClaw.
La ventaja de TokenHub es «una configuración de Codex, varios modelos chinos»: basta cambiar una línea de model para que el mismo Harness ejecute, uno tras otro, GLM, Kimi, DeepSeek y MiniMax, lo que resulta muy práctico para hacer comparaciones horizontales. El inventario de modelos, las versiones y las políticas de cuota se ajustan dinámicamente; antes de cada prueba conviene tomar como referencia los ID de modelo que aparecen en la consola.
2.3 ¿Cuáles son las diferencias entre los dos paquetes?
Ambos se llaman Token Plan, pero usan unidades de medida distintas: Bailian usa Credits y TokenHub usa puntos, y no se pueden convertir directamente entre sí. Los datos de la siguiente tabla están actualizados al 2026-11-13 y los precios están expresados en RMB/mes:
| Dimensión de comparación | Alibaba Cloud Bailian Token Plan (versión personal) | Tencent Cloud TokenHub Token Plan general (versión personal) |
|---|---|---|
| Nivel y tarifa mensual | Lite ¥39, Essential ¥79, Standard ¥139, Pro ¥312 | Lite ¥39, Standard ¥99, Pro ¥299, Max ¥599 |
| Asignación mensual | 20.000 / 45.000 / 80.000 / 200.000 Credits | 780 / 1.980 / 5.980 / 11.980 puntos |
| Agentes concurrentes recomendados | 1—2 / 2—3 / 3—4 / 6—8 | La documentación no ofrece un indicador equivalente |
| Descuentos y beneficios | Lite y Essential: primera compra para nuevos usuarios a ¥19,5 y ¥39,5 (hasta el 2026-11-30); Standard y Pro incluyen el beneficio AgentStudio Harness | Tarifas de deducción con descuento por tiempo limitado en algunos modelos; referencia de compra de puntos: ¥1 = 20 puntos |
| Protocolo de conexión de Codex | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| Modelos representativos | Serie Qwen, incluido Qwen4-Max-Preview exclusivo de Token Plan | GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3, Hunyuan Hy |
| Método de medición | Credits deducidos según el modelo | Desde el 2026-08-31, deducción de puntos, con tasas distintas entre modelos |
| Restricciones de uso | Solo región China North 2 (Pekín); los planes de programación interactiva no deberían usarse directamente para automatización arbitraria de backends comerciales | El catálogo de modelos y las promociones pueden cambiar |
Al comparar estos dos planes, ordenar por tarifa mensual tiene poco sentido; lo clave es «cuánta cuota consume cada tarea completada con el modelo que quiero usar en este plan». El valor de Bailian se concentra en el ecosistema Qwen y en el actualmente exclusivo Qwen4-Max-Preview; el valor de TokenHub se concentra en compartir una misma cuota entre varios modelos nacionales.
TokenHub hace públicas las tarifas de deducción de puntos de cada modelo. A continuación se muestran algunas tarifas promocionales consultadas el 2026-11-13, ya convertidas a RMB/millón de tokens según ¥1 = 20 puntos:
| Modelo | Entrada normal | Salida | Entrada con acierto de caché | Nota |
|---|---|---|---|---|
| GLM-5.3 | ¥4,40 | ¥15,40 | ¥1,10 | Al finalizar la promoción, se restablece el precio de lista |
| GLM-5.3-Flash | ¥0,56 | ¥1,96 | ¥0,161 | Escenarios sensibles a velocidad y coste |
| Kimi K3 | ¥15,00 | ¥75,00 | ¥1,50 | Al finalizar la promoción, se restablece el precio de lista |
| Kimi K2.7 Code | ¥5,20 | ¥21,60 | ¥1,04 | Modelo especializado en código |
| DeepSeek V4.1 Flash (valle) | ¥0,40 | ¥1,60 | ¥0,008 | Facturación por horas punta y valle |
| DeepSeek V4.1 Flash (punta) | ¥0,80 | ¥3,20 | ¥0,016 | Días laborables de 09:00—12:00 y 14:00—18:00 |
| MiniMax M3 | ¥2,10 | ¥8,40 | ¥0,42 | Precio para entrada ≤ 512K tokens |
Hay que entender esta tabla junto con dos ideas. Primero, la suscripción mensual se cobra según la tarifa mensual del plan, y los importes de la tabla son el valor de referencia de los puntos, que sirven para comparar la velocidad de consumo entre modelos. Segundo, la facturación por horas punta y valle de DeepSeek se aplica desde el 30 de octubre de 2026; el consumo en hora punta es aproximadamente el doble que en hora valle, por lo que ejecutar por la noche tareas asíncronas por lotes, como revisiones de código y análisis de pruebas, permite ahorrar cuota de forma notable.
Hagamos un cálculo con GLM-5.3: una tarea de código de gran tamaño consumió 100,000 Token de entrada normal, 300,000 Token de aciertos de caché y 30,000 Token de salida, lo que equivale a un valor de referencia en créditos de aproximadamente ¥1.232 según 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40. Los aciertos de caché representan la mayor parte de la entrada, que es justamente la forma típica de las tareas de Agent, y también demuestra que la tarifa de caché influye mucho en el coste total de los escenarios de programación.
3 ¿Cambiar de Harness acerca más a Astra + Codex? (Ruta B)
3.1 OpenCode: la clave es la libertad de usar varios modelos
OpenCode es un AI Coding Agent de código abierto que admite una gran cantidad de LLM Provider: con /connect se añaden proveedores, con /models se cambia de modelo, admite Base URL personalizada y modelos locales, se puede usar en terminal, escritorio y algunos entornos de desarrollo, y ofrece capacidades de búsqueda de archivos, modificación, ejecución de comandos y flujos de trabajo de Agent. Alibaba Cloud ya publica instrucciones oficiales de conexión: basta seleccionar Alibaba Token Plan (China) para usar el paquete de Bailian.
Las advertencias de seguridad oficiales de OpenCode merecen tomarse en serio: el Agent local predeterminado no tiene aislamiento de seguridad a nivel de sistema, y la aprobación de permisos no sustituye a un contenedor o a una máquina virtual. Al ejecutar código no confiable o tareas de automatización con permisos elevados, conviene hacerlo dentro de Docker o de una máquina virtual.
3.2 Qwen Code, Kimi Code y DeepSeek Harness
Los tres Harness nativos prestan servicio cada uno a su ecosistema de modelos correspondiente:
- Qwen Code: Alibaba Cloud lo ofrece en tres formatos —CLI, escritorio e IDE—; basta iniciar sesión en Bailian, seleccionar la región e introducir la API Key para conectarse, y cuenta con búsqueda en el repositorio de código, edición de archivos y ejecución de comandos. Es la opción prioritaria para equipos que usan principalmente modelos Qwen y quieren reducir la adaptación de protocolos.
- Kimi Code CLI: herramienta de codificación en terminal mantenida por Moonshot AI (月之暗面), compatible con lectura y modificación de código, invocación de Shell, obtención de contenido web, reanudación de sesiones, modos de plan y aprobación e integración con editores; también permite configurar modelos compatibles de terceros. En Windows se instala mediante el script oficial de PowerShell y depende de Git Bash de Git for Windows; la versión antigua Kimi CLI dejó de recibir mantenimiento en septiembre de 2026, así que los usuarios nuevos deben usar directamente Kimi Code CLI.
- DeepSeek Harness: framework de Agent de código abierto que ofrece a la vez Web UI y CLI, admite Provider personalizado y configuración de herramientas, y puede conectarse a los distintos esquemas de facturación de Bailian. Se inicia con
npx @deepseek-ai/dsh web, y la dirección predeterminada eshttp://127.0.0.1:3080. A la hora de elegirlo, conviene fijarse sobre todo en la estabilidad de ejecución de herramientas, el control de permisos y la adaptación al protocolo del modelo objetivo.
3.3 Por qué el Harness influye en el rendimiento del modelo
Un mismo modelo dentro de distintos Harness puede dar resultados muy diferentes, porque el Harness determina «qué ve el modelo, qué puede hacer y qué pasa cuando se equivoca»:
- Estrategia de lectura de código: cuántos archivos se leen de una vez y en qué orden se busca determinan si la comprensión del proyecto por parte del modelo es completa.
- Diseño del bucle de herramientas: cómo se devuelven los resultados de las herramientas y si se reintenta automáticamente tras un fallo determinan si una tarea larga llega a completarse.
- Compresión del contexto: qué historial se conserva y qué detalles se descartan en conversaciones largas influye directamente en si el modelo «olvida el objetivo».
- Parches y pruebas: si se sobrescribe el archivo completo o se usa un parche diff, y si por defecto se ejecutan pruebas después de modificar, determinan la precisión de los cambios y el riesgo de regresión.
Por eso, las puntuaciones obtenidas en la Ruta B son el resultado de la combinación «modelo + ese Harness». Al compararlas con la Ruta A, hay que recordar que las estrategias de ejecución de ambos lados son distintas de por sí.
4 ¿Qué modelos nacionales vale la pena probar?
4.1 Qwen4-Max-Preview
Según las especificaciones públicas, sus 1M de contexto, un presupuesto compartido de 393.216 tokens entre razonamiento y salida, la llamada de herramientas y las salidas estructuradas lo convierten en una opción adecuada para probar codificación compleja, análisis de contextos largos y flujos de trabajo de agentes de múltiples turnos. Además, es compatible tanto con Responses como con Anthropic Messages, así que se puede conectar a Codex y también a herramientas del estilo Claude Code.
La ventana temporal es la primera restricción a tener en cuenta al elegirlo: la vista previa finaliza y se retira el 2026-11-25 a las 24:00. Lo recomendable es aprovechar este periodo para ejecutar todo el conjunto de tareas de prueba y usar los resultados como referencia frente a los futuros modelos Qwen de versión oficial, configurando en paralelo un modelo alternativo disponible a largo plazo para el entorno de producción.
4.2 GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3
Estas cuatro familias están dentro de un mismo plan de TokenHub, y lo más práctico es asignarlas según el tipo de tarea:
- Lógica compleja y modificación de múltiples archivos: GLM-5.3, Kimi K3 y DeepSeek V4-Pro como grupo de alta capacidad para comparar. Kimi K3 tiene el precio de salida más alto de la tabla, por lo que conviene reservarlo para las tareas más difíciles y así comprobar el techo de rendimiento.
- Tareas orientadas a código: Kimi K2.7 Code está pensado específicamente para comparar escenarios de modificación de código, y también se puede combinar con Kimi Code CLI para probar la experiencia nativa.
- Tareas de alta frecuencia y bajo costo: GLM-5.3-Flash y DeepSeek V4-Flash sirven para escenarios sensibles al costo y a la velocidad, como revisión de código o refactorización masiva.
- Estabilidad en contextos largos y precisión en la llamada de herramientas: MiniMax M3 entra como candidato, teniendo en cuenta que por encima del umbral de 512K de entrada el precio aumenta.
4.3 ¿Cómo determinar cuál se acerca más a Astra?
La longitud del contexto, la cantidad de parámetros, el posicionamiento publicitario y el precio por token no permiten establecer un ranking fiable entre modelos, y las puntuaciones de benchmark promocionadas por distintas fuentes tampoco son comparables entre sí. La única forma confiable de juzgar «quién se acerca más a Astra + Codex» es usar el mismo harness y el mismo lote de tareas, registrando de manera uniforme la tasa de éxito, el tiempo de ejecución, el costo en tokens, la compatibilidad de herramientas y el número de intervenciones humanas. El método concreto se describe en la sección 6.
5. Tres rutas de reproducción: ¿cómo elegir la adecuada?
5.1 Si quieres la experiencia de operación del Codex original: ruta A
Conserva el Codex Harness y conéctalo a un servicio nacional que soporte oficialmente el protocolo Responses. Si tu modelo principal es Qwen, elige Bailian; si quieres alternar entre varios modelos chinos, elige TokenHub. Las ventajas son el bajo coste de aprendizaje y migración: la operación de archivos y el sistema de ejecución de agentes son los originales. El trade-off: la inteligencia del modelo difiere de Astra, el grado de implementación de la interfaz compatible afecta la experiencia de invocación de herramientas, y los parámetros de contexto y razonamiento de cada modelo deben ajustarse por separado.
5.2 Si quieres modelos chinos y libertad multimodelo: ruta B
OpenCode combinado con API de múltiples modelos chinos, complementado con Qwen Code, Kimi Code o DeepSeek Harness cuando sea necesario. Es la opción más adecuada para desarrolladores que usan varios modelos a largo plazo y no quieren atarse a un único proveedor, y también la más cómoda para comparar horizontalmente el rendimiento de distintos modelos en una misma tarea. El coste: la estrategia de ejecución difiere de la de Codex, y la integración de múltiples Provider implica trabajo extra de configuración y mantenimiento.
5.3 Si quieres conservar al máximo las capacidades de Astra: ruta C
La combinación de la ruta C es «Codex CLI original + GPT-6 Astra + un servicio de acceso API disponible». Siempre que el canal realmente ofrezca el GPT-6 Astra original y soporte por completo la Responses API, los eventos en streaming, la invocación de herramientas y la gestión de contexto que Codex necesita, podrás conservar a la vez los dos componentes centrales: el modelo y el Harness. Esta ruta resuelve la disponibilidad de red; sustituir el modelo por uno chino es otro asunto.
Tomando APIYI como ejemplo, la forma de conexión es idéntica a la de la ruta A: basta cambiar un conjunto de configuración de Provider:
model_provider = "APIYI"
model = "gpt-6-astra"            # Prevalece el ID de modelo que aparezca realmente en la consola de APIYI
model_reasoning_effort = "high"  # Ajusta entre low y max según la dificultad de la tarea

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Antes de conectar, conviene usar un script para confirmar que el canal realmente soporta el protocolo Responses y la invocación de herramientas, y no solo devuelve texto plano:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # Sustituye por el ID de modelo disponible en la consola
    reasoning={"effort": "medium"},
    input="读取 src/app.py 并告诉我入口函数名",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "读取项目中的文件内容",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# En condiciones normales debe devolver un elemento de salida de tipo function_call con parámetros estructurados
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # Comprueba si entrada, salida, caché y tokens de razonamiento se contabilizan por separado
Esta prueba cubre las tres cosas de las que Codex depende más: el protocolo Responses, la devolución de Function Calling y el desglose del uso por partidas. Cuando el script pase, conecta Codex y ejecuta una tarea completa que incluya «modificar código + ejecutar pruebas», para confirmar que los eventos en streaming y el bucle de herramientas multi-turno funcionan bien.
Aunque el modelo sea el mismo, la experiencia de la ruta C sigue dependiendo del enrutamiento real del modelo, del nivel de razonamiento, de la latencia y el throughput de salida de la API, del acierto de caché, de la compatibilidad del protocolo del gateway y del coste del canal. Las tareas de Codex de escritorio, las tareas en la nube y las funciones exclusivas de la cuenta de ChatGPT dependen del propio sistema de autorización de OpenAI; con una clave API estás usando la combinación de Codex CLI + API del modelo, así que a la hora de planificar deberías dejar esas funciones fuera del alcance.
🚀 Consejo para empezar rápido: Si quieres comparar las rutas A y C, puedes registrarte en APIYI apiyi.com y obtener crédito de prueba gratuito; después, usa un mismo entorno Codex para probar, por separado, modelos nacionales y modelos de la serie GPT. La disponibilidad concreta de modelos y el soporte de protocolos de APIYI deben consultarse en la consola y en la documentación de docs.apiyi.com.
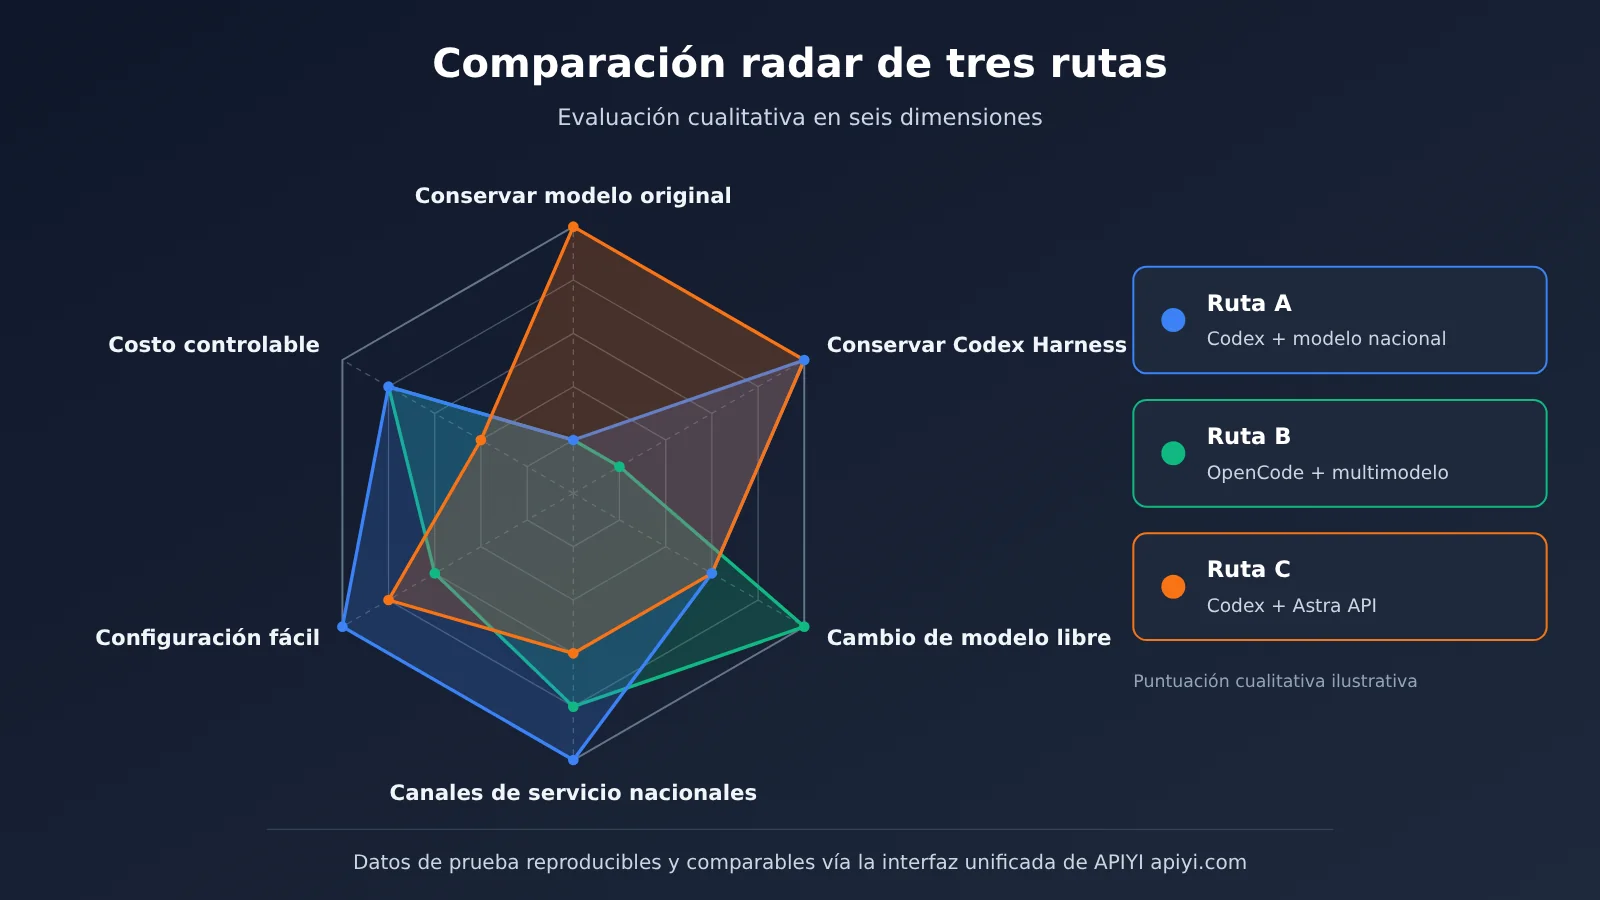
A continuación se resumen las ventajas y desventajas de las tres rutas:
| Dimensión de comparación | Ruta A: Codex + modelos nacionales | Ruta B: OpenCode, etc. + múltiples modelos nacionales | Ruta C: Codex + Astra API |
|---|---|---|---|
| Conservar el modelo original | No, se sustituye por Qwen / GLM / Kimi, etc. | No | Sí (siempre que el canal permita verificarlo) |
| Conservar Codex Harness | Sí | No, se sustituye por un Harness abierto | Sí |
| Cambio de modelo | Cambiar el ID del modelo dentro de la misma plataforma | Cambio libre entre múltiples Provider | Cambio entre los modelos compatibles con el canal |
| Canales de servicio en China | Alibaba Cloud Bailian, Tencent Cloud TokenHub | Bailian, TokenHub y otros servicios compatibles | Canales de terceros compatibles con Responses, como APIYI apiyi.com |
| Complejidad de configuración | Baja, la plataforma oficial ofrece una configuración lista para usar | Media, requiere mantener varios Provider | Baja, siempre que se valide primero el protocolo |
| Modalidad de costos | Plan mensual (Credits / puntos) | Suscripción o pago por uso, según el Provider | Pago por uso; el precio unitario de Astra es superior al de la mayoría de los modelos nacionales |
| Adecuado para | Experiencia de Codex original + uso de modelos nacionales | Flujo de trabajo con múltiples modelos a largo plazo | Conservar al máximo las capacidades originales |
5.4 Límites de red y seguridad para el uso en China
Que la API del modelo utilice una dirección accesible desde China solo resuelve el tramo de la invocación del modelo. Durante su trabajo, el agente también accede a fuentes de software como GitHub, npm y PyPI, a documentación oficial externa, a servicios MCP de terceros y a la búsqueda web; la accesibilidad de esas conexiones debe confirmarse por separado. La búsqueda en línea también es una capacidad independiente: las búsquedas integradas de los proveedores de nube, las herramientas de búsqueda web incluidas en Harness y las Search API / MCP de implementación propia tienen sus propias restricciones de acceso, facturación e invocación.
En materia de seguridad, un agente de programación puede modificar archivos, ejecutar Shell y leer variables de entorno, por lo que conviene seguir estas pautas:
- Guardar la clave API en variables de entorno o en una herramienta de gestión de credenciales, y nunca escribirla en el código fuente ni en el repositorio Git.
- Realizar los cambios complejos en una rama Git independiente, y mantener en el proyecto control de versiones y copias de seguridad recuperables.
- Limitar el acceso del agente a archivos sensibles fuera del directorio de trabajo, y colocar el código no confiable en un contenedor o una máquina virtual.
- Mantener la aprobación humana para operaciones de alto riesgo, como eliminación, despliegue y pagos.
6 Las pruebas con tareas reales valen más que los rankings de modelos
6.1 Configurar cinco tipos de tareas de prueba
Usando un proyecto real que incluya frontend, backend, pruebas y configuración de dependencias, se diseñan cinco tipos de tareas que evalúan por separado la capacidad del modelo y la capacidad del Harness:
- Comprensión del proyecto: se pide explicar la arquitectura y las relaciones entre los módulos clave, observando la localización de archivos, la comprensión de dependencias entre archivos y si se pueden proporcionar referencias de rutas verificables.
- Desarrollo entre archivos: añadir una nueva funcionalidad que requiera cambios en varios puntos, observando la precisión de las modificaciones, la integridad funcional y si se introducen regresiones.
- Corrección de bugs: proporcionar un proyecto con pruebas de fallo reproducibles, observando si encuentra la causa raíz, si modifica el lugar correcto, si ejecuta las pruebas de forma proactiva y si no rompe otros casos de prueba.
- Flujo de trabajo de agente de largo recorrido: completar la cadena continua de «entender los requisitos → modificar el código → ejecutar pruebas → detectar fallos → corregir → volver a verificar», observando si mantiene el objetivo y si puede ajustar la estrategia según los errores.
- Consulta de documentación en línea: tras leer la documentación más reciente del SDK, migrar un fragmento de código de una API antigua, observando si puede acceder realmente a la red para extraer el contenido, si aplica la nueva API en el código y si distingue entre «herramienta no disponible» y «resultado de búsqueda vacío».
6.2 Registrar la tasa de éxito, el tiempo y el coste
Cada combinación de «modelo + Harness» ejecuta el mismo conjunto de tareas, repitiendo al menos tres veces para tomar la media y registrando de forma unificada las siguientes métricas:
| Métrica | Forma de cálculo u observación |
|---|---|
| Tasa de éxito de tareas | Número de tareas completadas con éxito / número total de tareas |
| Tasa de éxito al primer intento | Proporción de tareas completadas en el primer intento sin corrección manual |
| Tiempo total de la tarea | Desde el envío de la tarea hasta la verificación final exitosa |
| Número de invocaciones del modelo | Número acumulado de solicitudes a la API por tarea |
| Número de invocaciones de herramientas | Número de invocaciones de lectura, edición, Shell, búsqueda, etc. |
| Uso de tokens | Desglose de entrada, salida, aciertos de caché y uso de razonamiento |
| Coste real de la tarea | Coste real para completar una tarea exitosa |
| Número de intervenciones manuales | Número de ajustes y correcciones manuales del usuario |
Para que el experimento sea reproducible, se fijan las siguientes variables: la misma instantánea (snapshot) del repositorio de código, la misma versión del Harness, el mismo nivel de razonamiento o configuración de pensamiento y el mismo periodo de tiempo (especialmente importante para modelos con facturación por picos y valles como DeepSeek). Antes de comenzar cada tarea, se restablece el repositorio a la instantánea para evitar que las modificaciones de la ronda anterior afecten a la siguiente.
6.3 Usar el coste de una tarea exitosa como indicador central de compra
El método de cálculo recomendado es: coste de una tarea exitosa = coste total de todas las tentativas ÷ número de tareas exitosas. Los costes de las tentativas fallidas deben incluirse, porque también consumen cuota.
Un modelo con precio unitario bajo no es necesariamente más barato. Si un modelo requiere más rondas de razonamiento, modificaciones repetidas y reintentos, o si necesita con frecuencia intervención manual, el consumo total para completar una tarea puede superar al de un modelo con precio unitario más alto que acierta a la primera. Por el contrario, en tareas simples y de alta frecuencia, el bajo precio unitario y la alta velocidad de los modelos de nivel Flash suelen aportar un ahorro real. Solo calculando el coste «por cada tarea exitosa» se pueden comparar ambos tipos de modelos con la misma vara de medir.
💰 Recomendación para evaluar costes: los canales de facturación por uso son los más convenientes para realizar este tipo de experimentos, porque el desglose de tokens y el coste de cada solicitud pueden verificarse línea por línea. Llamando a múltiples modelos con una sola clave a través de APIYI apiyi.com, se pueden reunir las facturas de distintos modelos en un mismo panel de control para calcular el coste de una tarea exitosa.
7 Escenario de APIYI: hacer del modelo un componente reemplazable
El análisis anterior lleva a una misma conclusión: un entorno estable para programar con IA debería fijar el Harness y tratar el modelo como un componente reemplazable. Codex u OpenCode se encargan de la ejecución y la gestión del estado, el canal de API se encarga de proporcionar el modelo, y el modelo se cambia de forma flexible según la dificultad de la tarea y el presupuesto.
APIYI (apiyi.com) actúa en esta arquitectura como una capa de acceso unificada: una clave API permite invocar OpenAI, Claude, Gemini y otros modelos principales, con una interfaz compatible con el protocolo de OpenAI y facturación por uso. Para quienes programan, antes de elegir cualquier canal de API (incluido APIYI), conviene verificar uno por uno los siguientes aspectos:
- Si admite la Responses API y los eventos de streaming que exige la versión actual de Codex.
- Los ID reales de los modelos listados en la consola y si el modelo objetivo está disponible.
- Si las llamadas a herramientas y Function Calling pueden completar el ciclo de ida y vuelta sin problemas.
- Si la latencia y la velocidad de salida sostenida cubren las necesidades de tareas largas.
- Si el uso de caché se reconoce correctamente y se factura por separado.
Esta información debe contrastarse con la consola de servicio y la documentación técnica; el script de sondeo de la sección 5.3 sirve para verificarla directamente. A la hora de llevarlo a la práctica, lo habitual es usar el plan de suscripción mensual de la ruta A para tareas cotidianas de alta frecuencia, y el canal de pago por uso para problemas difíciles que requieren modelos más potentes y para pruebas comparativas. Ambos proveedores se escriben en el mismo config.toml, y se cambia entre ellos con --profile o modificando model_provider.
8 Preguntas frecuentes
Q1: Para replicar Astra + Codex en China, ¿qué ruta ofrece la mayor fidelidad?
La ruta C es la que alcanza mayor fidelidad: Codex CLI original junto con una API GPT-6 Astra real y operativa, conservando los dos componentes centrales, el modelo y el harness. La condición es que se pueda verificar que el canal ofrece el modelo original y que soporte por completo el protocolo Responses y las llamadas a herramientas. Si el requisito es usar un modelo nacional, la ruta A es la mejor opción para replicar la experiencia de ejecución de Codex.
Q2: ¿Conviene usar Qwen4-Max-Preview en Codex a largo plazo?
Es adecuado para la evaluación actual. El modelo solo está disponible en Bailian Token Plan y se retirará al terminar el periodo de vista previa, el 25 de noviembre de 2026 a las 24:00. Conviene aprovechar la vista previa para completar las tareas de prueba y, al mismo tiempo, preparar un modelo alternativo que esté disponible a largo plazo para el entorno de producción.
Q3: ¿Por qué la nueva versión de Codex no puede conectarse al antiguo Coding Plan de Alibaba Cloud?
Desde la versión 0.94.0, Codex exige la API Responses, mientras que el antiguo Coding Plan usa el protocolo Chat Completions y la documentación oficial indica que debe combinarse con Codex 0.93.0 o una versión anterior. Basta cambiar a Token Plan y configurar `wire_api = «responses»` para conectar con la nueva versión de Codex; ten en cuenta que Token Plan usa una clave API independiente.
Q4: ¿Se pueden comparar directamente los Credits de Bailian con los puntos de TokenHub?
No se pueden comparar directamente. Son unidades de medida de cada plataforma y la velocidad de descuento varía según el modelo. Lo más fiable es ejecutar la misma tarea en ambas plataformas y comparar «qué proporción de la cuota mensual consume completar una tarea con éxito».
Q5: ¿Cómo verificar rápidamente si un canal de terceros puede ejecutar Codex?
Primero usa el script de Python de la sección 5.3 para enviar una solicitud Responses con una herramienta function, confirma que devuelve un elemento de salida `function_call` y que el desglose de uso es correcto; después conecta Codex y ejecuta una tarea completa que incluya pruebas. Al registrarte en APIYI apiyi.com puedes obtener crédito de prueba gratuito para completar esta verificación; los modelos disponibles concretos son los que figuren en la consola.
Q6: ¿Es normal que el mismo modelo se comporte distinto en OpenCode y en Codex?
Sí, es normal. El harness determina la estrategia de lectura del código, el bucle de herramientas, la compresión de contexto y los hábitos de prueba, y todo eso cambia el rendimiento real del modelo. Al comparar, mantén fijo el harness y evalúa el modelo, o mantén fijo el modelo y evalúa el harness, para evitar que cambien dos variables a la vez.
Q7: Si uso Codex mediante una clave API, ¿obtengo las funciones de Codex incluidas en la suscripción de ChatGPT?
La vía de la clave API ofrece la combinación de Codex CLI más la API del modelo. Las tareas en la nube de Codex, la versión de escritorio y las funciones exclusivas de la cuenta ChatGPT dependen de la autorización de la cuenta de OpenAI, y los canales de API de terceros no pueden ofrecer esas ventajas.
Q8: Al cambiar entre varios modelos, ¿cómo controlar el costo total?
Estratifica según la tarea: usa modelos de mayor capacidad para los problemas difíciles, deja las revisiones masivas y las refactorizaciones simples a modelos de nivel Flash y, con los modelos que admiten facturación por horas pico y valle, mueve las tareas asíncronas a la noche. Evalúa todo con el «costo por tarea completada con éxito»; los canales de pago por uso como APIYI apiyi.com facilitan revisar transacción por transacción el consumo real de cada modelo.
9 Resumen: conclusiones clave
- Tres rutas, tres enfoques: la ruta A preserva la experiencia de Codex, la ruta B preserva la libertad de modelo y la ruta C preserva el modelo original.
- Astra + Codex es una combinación de cinco capas: modelo, sistema de ejecución, ecosistema de herramientas, gestión de estado y experiencia de uso determinan conjuntamente el resultado.
- La ruta A tiene configuración lista para usar: Bailian y TokenHub ofrecen configuración oficial de Codex; lo esencial es
wire_api = "responses". - Qwen4-Max-Preview tiene fecha límite: exclusivo de Token Plan; la vista previa finaliza y se retira el 2026-11-25 a las 24:00.
- Las unidades de los planes no son comparables entre sí: Credits, puntos, tokens y yuan pertenecen a sistemas de medición distintos; solo se pueden comparar con pruebas reales por tarea.
- Que hablen las tareas: cinco tipos de tareas reales y ocho métricas, usando el costo por tarea exitosa como base para la compra.
- Convertir el modelo en un componente reemplazable: Harness fijo y canal de acceso unificado; cambiar de modelo según la tarea es lo que hace que el entorno sea estable y controlable.
La forma más pragmática de empezar es configurar dos Provider en el mismo entorno de Codex: un plan de nube nacional se encarga de las tareas diarias y un canal de pago por uso se encarga de las pruebas de comparación y de las tareas de alta dificultad. Ejecuta una ronda con el método de la sección 6 y luego decide la combinación a largo plazo. Se recomienda montar rápidamente un grupo de control con APIYI apiyi.com y validar, mediante una interfaz unificada, los modelos nacionales y la serie GPT sobre el mismo conjunto de tareas.
📚 Referencias
- Documentación oficial del modelo GPT-6 Astra: especificaciones del modelo, niveles de razonamiento y precios
- Enlace:
developers.openai.com/api/docs/models/gpt-6-astra -
Descripción: ventana de contexto, salida máxima, compatibilidad con herramientas y tarifas de contexto largo
-
OpenAI Codex Harness: diseño del framework de ejecución de Codex
- Enlace:
developers.openai.com/blog/codex-as-a-platform -
Descripción: documentación oficial sobre el bucle del agente, retorno de herramientas, gestión del contexto y sandbox
-
Integración de Codex en Alibaba Cloud Bailian: método de configuración de Token Plan
- Enlace:
help.aliyun.com/zh/model-studio/codex -
Descripción: campos de config.toml, protocolo Responses y requisitos de versión
-
Token Plan Personal de Alibaba Cloud: precios de planes y créditos
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
Descripción: niveles, cuotas y oferta de primera compra tras el ajuste del 2026-11-09
-
Documentación oficial de Qwen4-Max-Preview: especificaciones del modelo y periodo de vista previa
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
Descripción: contexto de 1M, compatibilidad de protocolo y fecha de retirada
-
Configuración de Codex CLI en Tencent Cloud TokenHub: tutorial oficial de integración
- Enlace:
cloud.tencent.cn/document/product/1823/130071 -
Descripción: configuración del proveedor y método para reemplazar el ID del modelo
-
Planes y tarifas de créditos de Tencent Cloud TokenHub: reglas de facturación
- Enlace:
cloud.tencent.cn/document/product/1823/130060 - Enlace:
cloud.tencent.com/document/product/1823/133811 -
Descripción: niveles de planes, tarifas de créditos por modelo y facturación por horas pico y valle
-
Repositorio oficial de OpenCode: agente de programación de código abierto
- Enlace:
github.com/anomalyco/opencode -
Descripción: configuración del proveedor y notas de seguridad
-
Qwen Code, Kimi Code CLI y DeepSeek Harness: Harness nativos
- Enlace:
help.aliyun.com/zh/model-studio/qwen-code - Enlace:
github.com/MoonshotAI/kimi-code - Enlace:
help.aliyun.com/zh/model-studio/deepseek-harness - Descripción: instalación, integración y alcance de capacidades
Autor: equipo técnico de APIYI
Contacto técnico: no dude en contactarnos a través de la página de inicio del sitio oficial de APIYI. Para más recursos de integración, visite el centro de documentación docs.apiyi.com