الملخص: لقد انقسم إنتاج الفيديو بالذكاء الاصطناعي إلى مسارين تقنيين: توليد الفيديو الأصلي، ورندر الكود بواسطة الوكيل (Agent). الأول يتفوق في المشاهد الواقعية والحركة الطبيعية، بينما يتفوق الثاني في الرسوم المتحركة الدقيقة والتعبير البياني والإنتاج الهندسي القابل للتعديل. وفهم الفرق بين المسارين هو ما يتيح لك بناء سير عمل فعّال لإنتاج الفيديو.
الخلاصة أولاً: توليد الفيديو الأصلي ورندر الكود بواسطة الوكيل يخدمكل منهما مهام مختلفة. الشخصيات، والإحساس بالتصوير الحقيقي، والحركة الطبيعية، ولغة الكاميرا — تُترك لنماذج الفيديو الأصلية مثل Seedance وKling وVeo؛ أما المخططات البيانية والمعادلات ودروس البرمجيات ومعامل الأسعار والمحتوى النمطي بالجملة — فتُترك لسلسلة رندر الكود المكوّنة من Remotion وManim وFFmpeg. وعند الجمع بين الاثنين، يمكنك الحصول على مشاهد طبيعية وتحكم دقيق في الوقت نفسه، وهذه هي أكثر خطط الإنتاج عملية في الوقت الحالي.
لمحة عن المحتوى: سيشرح ما يلي أولاً الفرق الجوهري بين المسارين في آلية المخرجات، ثم يفصّل قدرات وتكلفة نماذج الفيديو الأصلية (Seedance 2.5، Kling 4.0، Veo 3.1) وسلسلة أدوات رندر الكود (Remotion، Manim، FFmpeg، Claude Motion، Codex)، مع الاستعانة ببيانات التقييم المستقل من VibeVideoBench لتوضيح المستوى الحقيقي للوكيل في إنتاج الفيديو. وأخيراً نقدّم سير عمل إنتاج مختلطاً نتخذ فيه الفيلم الإعلاني للمنتج مثالاً، موضحين الجزء الذي يتولاه كل نموذج وأداة.
للتعرف على: مسرد مصطلحات مسار تقنية فيديو الذكاء الاصطناعي
| المصطلح | الشرح |
|---|---|
| Text-to-Video | إنشاء فيديو مباشرةً اعتمادًا على موجه نصي |
| Image-to-Video | إنشاء فيديو متحرك اعتمادًا على صورة مرجعية |
| Multimodal Reference | استخدام الصور والفيديو والصوت وغيرها من الوسائط في الوقت نفسه لتوجيه عملية الإنشاء |
| Keyframe | الإطار المفتاحي، ويُستخدم لتحديد حالة الصورة عند نقطة زمنية معينة |
| Timestamp-level Editing | تعديل مقطع معين من المحتوى بدقة وفق نقطة زمنية في الفيديو |
| Agent | نظام ذكاء اصطناعي قادر على التخطيط للمهام واستدعاء الأدوات وفحص النتائج وتصحيحها ذاتيًا |
| Remotion | أداة لصنع رسوم متحركة للفيديو باستخدام مكونات React والشيفرة البرمجية |
| Manim | محرك لصنع رسوم متحركة رياضية وعلمية باستخدام Python |
| FFmpeg | أداة سطر أوامر تتولى ترميز الفيديو وتركيب الصوت والمونتاج وتحويل الصيغ |
| ffprobe | أداة فحص تأتي مع FFmpeg، تقرأ الدقة ومعدل الإطارات والمدة والمسارات الصوتية |
| TTS | تحويل النص إلى كلام، ويُستخدم لإنشاء التعليق الصوتي تلقائيًا |
| Deterministic Rendering | العرض الحتمي، إذ تُنتج الشيفرة البرمجية والمعاملات نفسها الصورة نفسها في كل مرة |
| Claude Motion | ميزة من Anthropic تغلف الرسوم المتحركة المدفوعة بالشيفرة داخل منتج، وهي حاليًا في مرحلة Beta |
| Cache Hit | معدل إصابة الذاكرة المؤقتة، إذ تُقرأ السياقات المتكررة من الذاكرة المؤقتة مباشرةً، ما يقلل تكلفة الـ Tokens بشكل ملحوظ |
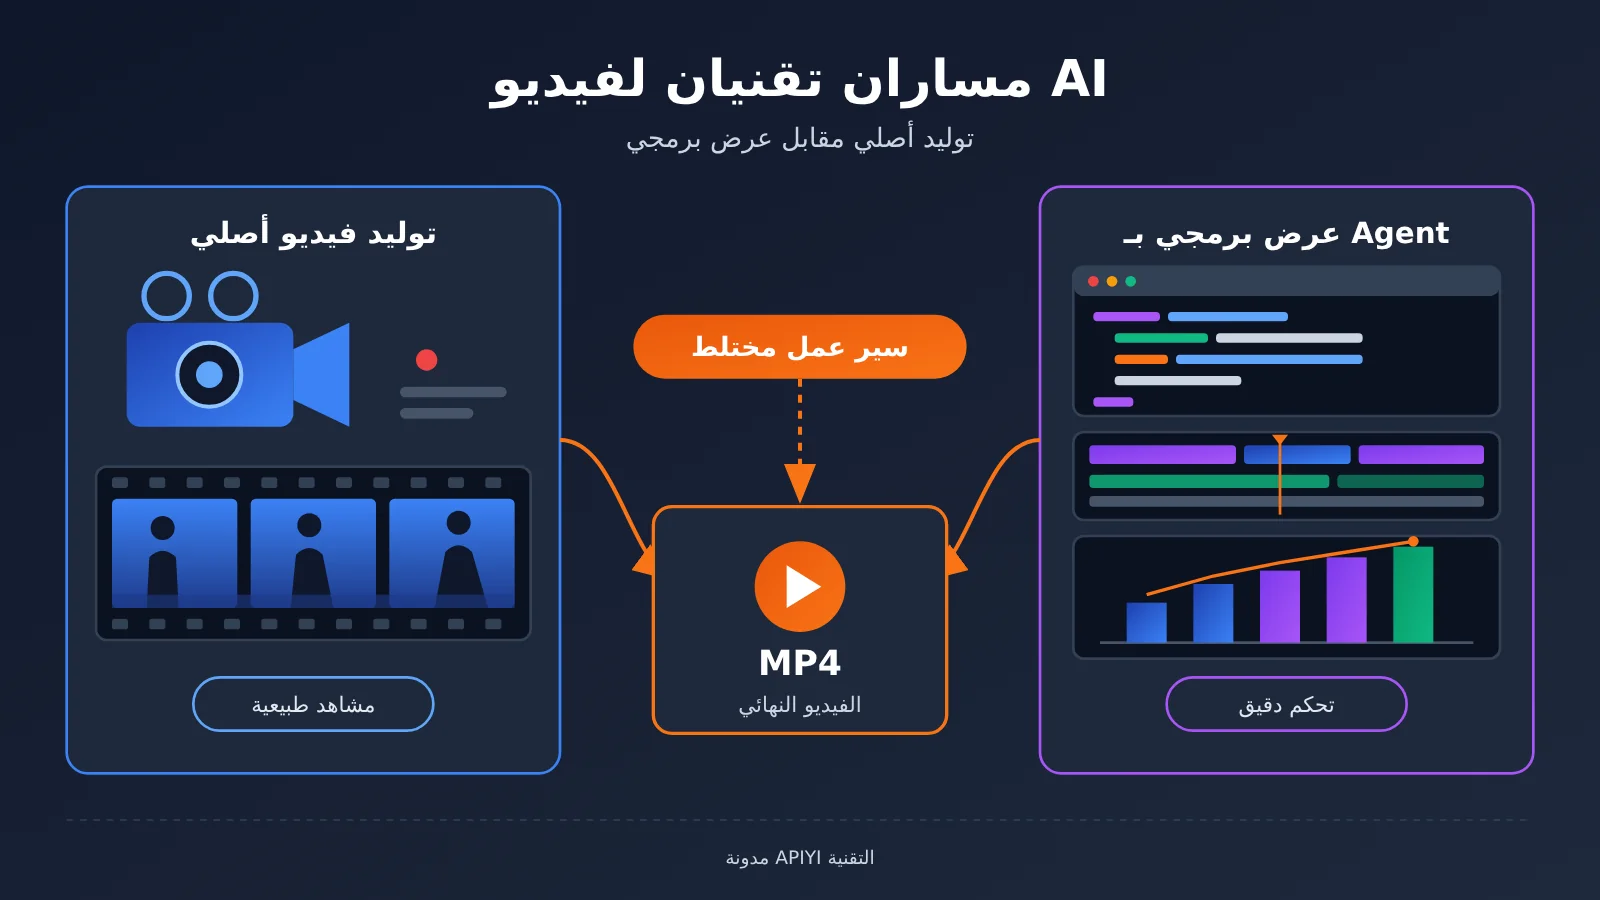
1 المسارَان التقنيان لفيديو الذكاء الاصطناعي: آليتا الإخراج مختلفتان تمامًا
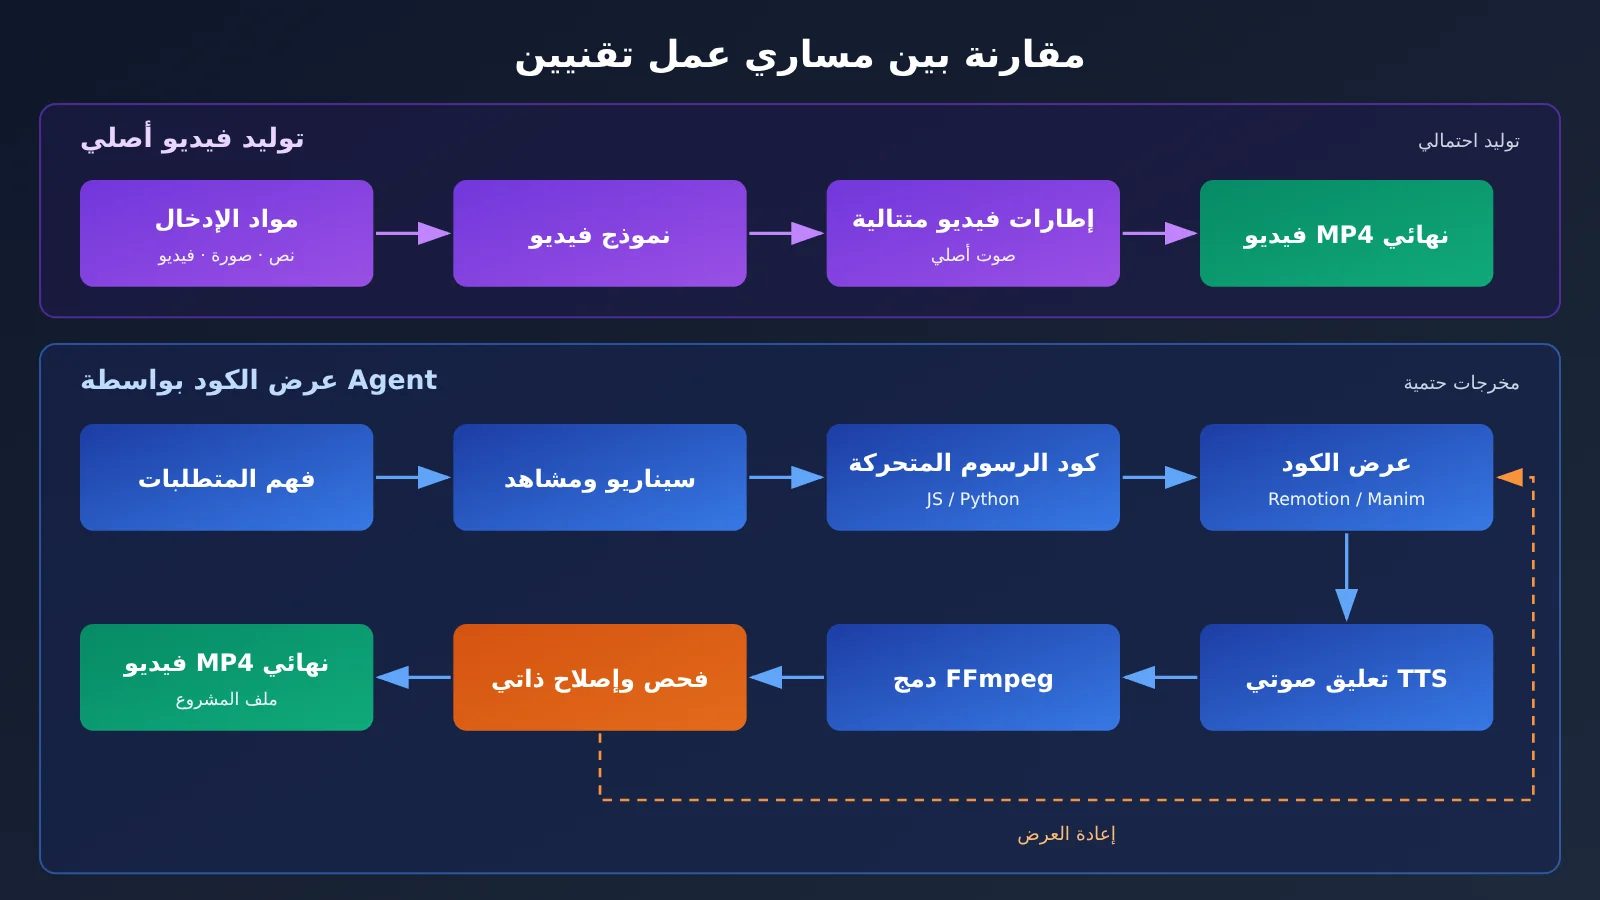
يستطيع المسارَان تسليم ملف MP4، لكن طريقة إنتاجهما للصورة مختلفة كليًا. في التوليد الأصلي للفيديو يرسم النموذج كل إطار مباشرةً، أما في العرض البرمجي بالوكيل فيكتب النموذج برنامج إنتاج فيديو، ثم يُخرج محرك العرض الصورة وفق ذلك البرنامج. وهذا الفرق هو ما يحدد كل الاختلافات بينهما في دقة التحكم وقابلية التعديل والتكلفة.
1.1 التوليد الأصلي للفيديو: النموذج يبتكر إطارات متصلة مباشرةً
يقوم التوليد الأصلي للفيديو على تحويل النص إلى فيديو (Text-to-Video) وتحويل الصورة إلى فيديو (Image-to-Video). يقدّم المستخدم وصفًا نصيًا أو صورة مرجعية، فيُخرج النموذج إطارات فيديو متصلة مباشرةً، وتُولَّد الشخصيات والأشياء والبيئات والحركات المتصلة والحركة الفيزيائية داخل الصورة دفعةً واحدة بواسطة النموذج. ويمكن كذلك كتابة حركة الكاميرا (التقريب والتبعيد) وتغيّر حجم اللقطة والانتقال بين المشاهد ضمن المُوجِّه.
والنماذج الجديدة أصبحت قادرة على توليد صوت أصلي بالتزامن، وتدعم استخدام عدة صور مرجعية وفيديوهات مرجعية للتحكم في مظهر الشخصيات والمشاهد والأسلوب البصري. ميزتها أن الصورة طبيعية وواقعية؛ أما الثمن فهو أن كل إطار يأتي من توليد احتمالي، فلا تكون نتيجتان من المُوجِّه نفسه متطابقتين، كما أن التعديل بدقة البكسل يعتمد على إعادة التوليد أو على وظائف تحرير مخصصة.
1.2 العرض البرمجي بالوكيل: الذكاء الاصطناعي يكتب برنامج إنتاج الفيديو بنفسه
يتيح العرض البرمجي بالوكيل لنموذج اللغة الكبير أن يعمل مخرجًا ومبرمجًا في آن واحد. وتشمل العملية الكاملة عادةً ما يلي:
- فهم الطلب وتحديد الموضوع والجمهور والأسلوب البصري؛
- كتابة النص والراوي التعليقي (voiceover) واللوحة السردية (storyboard) والخط الزمني؛
- كتابة شيفرة الرسوم المتحركة باستخدام JavaScript وPython (Remotion وManim وThree.js وCairo وBlender وغيرها)؛
- استدعاء TTS لتوليد الراوي التعليقي، وإنتاج الموسيقى والمؤثرات الصوتية؛
- استدعاء FFmpeg لدمج الصوت والصورة؛
- فحص الصورة والصوت وتزامن التوقيت، وإصلاح المشكلات ثم إعادة العرض؛
- إخراج ملف MP4 النهائي وملفات المشروع القابلة لإعادة الاستخدام.
مخرجات هذا المسار حتمية: إذا لم تتغير الشيفرة والمعاملات لا يتغير نتيجة العرض. وتعديل رقم واحد أو سطر ترجمة أو لون واحد لا يحتاج سوى تغيير الشيفرة وإعادة العرض، مع بقاء بقية الصورة كما هي. وهو متألق في تصوير البيانات وتقديم المنتجات ونشر المعرفة والإنفوجرافيك الديناميكي، أما توليد أشخاص حقيقيين ولقطات تصوير واقعية فيعتمد على مواد جاهزة أو أصول ثلاثية الأبعاد.
2 مسار توليد الفيديو الأصلي: ما المهام التي يناسبها؟
في عام 2026، رفعت نماذج الفيديو الأصلية مدة التوليد في المرة الواحدة إلى 30 ثانية، وتحوّل تركيز المنافسة إلى المراجع متعددة الوسائط، والتحكم في الإطارات المفتاحية، والتحرير المستمر بعد التوليد. يلخص الجدول التالي القدرات المعلنة لثلاثة نماذج رائدة.
| القدرة | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| تاريخ الإصدار/الإتاحة | صدر في 2026-07-31 | API متاحة بالكامل في 2026-10-28 | مذكور في وثائق Gemini API |
| مدة التوليد في المرة الواحدة | حتى 30 ثانية | حتى 30 ثانية | يدعم تمديد الفيديو |
| المواد المرجعية | 30 صورة، 10 مقاطع فيديو، 10 مقاطع صوتية | 10 صور، 5 مقاطع فيديو، مع خلط حتى 15 عنصرًا | توليد موجه بالصور |
| طريقة التحكم الأساسية | تمديد متعدد الجولات، تحرير بالطوابع الزمنية، وتحرير الشاشة الخضراء وموضع الكاميرا | حتى 10 إطارات مفتاحية، ومرجع صوتي | التحكم في الإطار الأخير، وتمديد الفيديو |
| الصوت | يدعم المرجع الصوتي | يدعم مرجع الصوت البشري | توليد صوت أصلي |
| طريقة الفوترة | حسب الدقة والمدة (بما في ذلك استهلاك Token) | حسب Unit/ثانية | حسب مواصفات التوليد |
2.1 Seedance 2.5: توليد متواصل لمدة 30 ثانية ومراجع متعددة الوسائط
أصدر فريق Seed التابع لبايت دانس نموذج Seedance 2.5 في 31 يوليو 2026، ويبلغ الحد الأقصى للتوليد في المرة الواحدة 30 ثانية، ويمكن أن يتضمن التوليد الواحد عدة لقطات متتابعة. وقدراته المرجعية هي الأوسع بين المعاملات المعلنة حاليًا: حتى 30 صورة مرجعية، و10 مقاطع فيديو مرجعية، و10 مقاطع صوتية مرجعية، إذ يمكن تسليم إعداد الشخصية وصور المشهد ومرجع الحركة والموسيقى التصويرية معًا إلى النموذج لتنظيمها في مشهد معقد.
وعلى مستوى التحرير، يدعم Seedance 2.5 تمديد فيديو موجود على مدى عدة جولات مع الحفاظ قدر الإمكان على اتساق الشخصيات والمشاهد والأصوات، كما يدعم تعديل حركات الشخصية والحبكة عند نقاط زمنية محددة، ويدعم أيضًا تحرير الشاشة الخضراء وتحرير زاوية الكاميرا واتساق الشخصيات المتعددة. ويمكنه كذلك استخدام مرجع Clay Render (التصيير الطيني) للتحكم في البنية المكانية ومواضع وقوف الشخصيات وحركة الكاميرا. وتغطي الأمثلة الرسمية أداء شخصيات الأوبرا الصينية والعروض المسرحية والتفاعل بين شخصيات متعددة والانتقالات المتتابعة بين المشاهد، وهذا النوع من المحتوى متعدد الشخصيات واللقطات الطويلة والسرد المتواصل هو بالضبط الجزء الأصعب في إنجازه عبر التصيير بالكود.
2.2 Kling 4.0: التحكم بواسطة الإطارات الرئيسية ومراجع الفيديو
أصبح Kling 4.0 متاحًا على نطاق واسع عبر API في 28 أكتوبر 2026، ويصل طول التوليد الواحد إلى 30 ثانية، ويدعم دقتي 720p و1080p، وتشمل نسب الشاشة 21:9 والنسبة التكيفية. وأبرز مزاياه هي إمكانية استخدام ما يصل إلى 10 إطارات رئيسية: إذ يمكن للمنشئ تثبيت عدة حالات للصورة على الخط الزمني، ليكمل النموذج الحركة بين الإطارات الرئيسية، مما يجعل اتجاه الكاميرا ووضعية الشخصية أكثر قابلية للتحكم.
أما المواد المرجعية، فيدعم Kling 4.0 ما يصل إلى 10 صور مرجعية و5 مقاطع فيديو مرجعية، وبحد أقصى 15 عنصرًا في الإدخال المختلط الواحد، كما يوفر مرجع Omni متعدد الوسائط والمرجع الصوتي. وهو يجمع توليد الفيديو انطلاقًا من النص، وتوليده انطلاقًا من الصور، والمواد المرجعية، وتحرير الفيديو في منتج واحد، ويناسب المشاريع التي تحتاج إلى ثبات ملامح الشخصية أو تحديد مسار كاميرا معين أو إعادة تحرير فيديو موجود.
2.3 Veo 3.1: الصوت الأصلي وتمديد الفيديو
تقدم Google عبر Gemini API فئتين من منتجات توليد الفيديو. يركز Veo 3.1 على توليد الصوت الأصلي، وتمديد الفيديو، والتحكم في الإطار الأخير، والتوليد الموجه بالصور، ويناسب إنتاج مقاطع «بصورة وصوت» دفعة واحدة؛ بينما يركز Gemini Omni Flash على المدخلات متعددة الوسائط، واتساق الشخصيات، وفهم الفيديو، والتحرير الحواري متعدد الجولات. ويمثل الاثنان اتجاهين في مجال الفيديو المولّد بالذكاء الاصطناعي: توليد مقاطع عالية الجودة، ثم مواصلة التحرير والتعديل والتمديد بعد التوليد.
أما OpenAI، فقد أوقفت خدمة منتج Sora في 26 أبريل 2026، وأُغلق نموذج Sora 2 وVideos API في 24 سبتمبر 2026، وأوضح إشعار الإيقاف الرسمي أنه لا توجد واجهة API بديلة مطابقة. ويدعم Images 2.6، الذي أطلقته OpenAI في 4 نوفمبر 2026، إخراج رسوم GIF متحركة من 2 إلى 16 إطارًا، ويناسب الرموز التعبيرية المتحركة، وتكرار حركات الشخصيات، ومعاينات لوحات القصة، ويختلف عن إنتاج فيديو MP4 كامل من حيث سير العمل.
2.4 مزايا توليد الفيديو الأصلي وتكاليفه
تتركز المزايا الأساسية لتوليد الفيديو الأصلي في أربعة جوانب: حركات الشخصيات الطبيعية، والحركة الفيزيائية الموثوقة، وحركات الكاميرا السينمائية، والتعبير الإبداعي المفتوح. تحتاج هذه القدرات عند تنفيذها بالكود إلى كم كبير من أصول الرسوم المتحركة والضبط اليدوي، بينما يمكن مع نموذج الفيديو توليدها دفعة واحدة.
أما من حيث التكلفة، فيُحتسب الفيديو الأصلي وفق مواصفات الإخراج والمدة. وعلى سبيل المثال، إليك الأسعار الرسمية لـ Seedance 2.5 بحسب تحديث BytePlus ModelArk بتاريخ 13 نوفمبر 2026:
| مواصفات الإخراج | السعر المرجعي لفيديو 5 ثوانٍ | التقدير لكل ثانية |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
من 720p إلى 1080p، تزداد التكلفة لكل ثانية بنحو 2.5 مرة. يمثل الجدول أعلاه تقديرات للمواصفات النموذجية الرسمية؛ ويؤثر طول فيديو الإدخال ودقته ومعدل الإطارات واستهلاك الرموز (Token) الفعلي في الفاتورة النهائية. أما Kling 4.0 فيُحتسب بوحدات Unit الخاصة بالمنصة: 720p بواقع 1 Unit/ثانية، و1080p بواقع 1.5 Units/ثانية، وKling 4.0 Flash 720p بواقع 0.6 Units/ثانية، وعند وجود فيديو إدخال فإن التكلفة تتأثر أيضًا بمدة الإدخال؛ وUnit هي وحدة الفوترة في المنصة، ويلزم تحويلها إلى مبلغ فعلي وفق قواعد المنصة.
يجب ملاحظة أن هذه الأسعار تقابل تكلفة “توليد واحد”. فالفيديو الأصلي ينطوي على عشوائية، وغالبًا ما يتطلب الإنتاج الفعلي توليدًا متعددًا ثم الاختيار، لذا تكون تكلفة اللقطات القابلة للاستخدام النهائية أعلى عادةً من سعر التوليد الواحد.
3 مسار تصيير الشيفرة عبر الوكيل: جعل الذكاء الاصطناعي مهندس إنتاج فيديو
يكمن جوهر مسار تصيير الشيفرة في مجموعة من الأدوات الناضجة مفتوحة المصدر أو التجارية، حيث يتولى نموذج اللغة الكبير ترجمة المتطلبات إلى شيفرة تستطيع هذه الأدوات تنفيذها، ثم يدير جدولة العملية وفحصها وإصلاحها.
3.1 Remotion: رسوم متحركة بـ React وإنتاج فيديو آلي
يستخدم Remotion مكوّنات React لوصف المشهد، ويتحكم في موضع العناصر وحجمها وشفافيتها وحركتها عبر رقم الإطار. ويمكن للمطورين استخدام React وHTML وCSS وJavaScript مباشرة لصناعة الرسوم المتحركة، كما يمكن دمج النصوص والمخططات والصور والفيديو والصوت داخل المشهد مع تحكم دقيق في كل إطار. ويَدعم التصيير الدفعي عبر CLI، والتصيير من جهة الخادم، والتصيير السحابي عبر Lambda، ويمكنه تمرير معاملات مختلفة لتوليد فيديوهات ذات محتوى مختلف على دفعات.
عملية التصيير الرسمية بسيطة جدًا:
# تثبيت Remotion
npm install remotion @remotion/cli

# تصيير تركيبة الفيديو (Composition) المحددة وإخراجها بصيغة MP4
npx remotion render HelloWorld out.mp4
أما من حيث الترخيص، فإن Remotion مجاني للأفراد والشركات الصغيرة التي لا يتجاوز عدد أفرادها 3 أشخاص، ويُسمح بالاستخدام التجاري عند الالتزام بالشروط؛ وتُحسب خطة Automators بسعر $0.01 لكل عملية تصيير، بحد أدنى للاستهلاك الشهري قدره $100؛ وخطة Creators بسعر $25 لكل مقعد شهريًا؛ وخطة Enterprise بدءًا من $500 شهريًا (تم التحديث في 14 نوفمبر 2026). رسوم ترخيص التصيير في Remotion وتكلفة رموز (Tokens) التي يستهلكها نموذج الذكاء الاصطناعي عند كتابة الشيفرة هما تكلفتان مستقلتان، ويجب حساب كل منهما على حدة عند تقدير التكاليف.
3.2 Manim: رسوم متحركة دقيقة للرياضيات والعلوم
Manim هو محرك رسوم متحركة مكتوب بلغة Python، متخصص في عرض المعادلات الرياضية، وتحويلات الأشكال الهندسية، ومحاكاة حركة الأجسام الفيزيائية، وشرح طريقة عمل الخوارزميات، وتوضيح التجارب العلمية. فالمعادلات ومحاور الإحداثيات والأشكال الهندسية والعلاقات الحركية بين الكائنات تُعرَّف جميعها عبر الشفرة البرمجية، ما يعني أن موضع كل رمز وكل منحنى يمكن التحكم فيه بدقة. أما نماذج الفيديو الأصلية فغالبًا ما تُنتج معادلات بها أخطاء في الحروف أو خلل في البنية، وهذا بالضبط المجال الذي يتفوق فيه Manim.
لبدء الاستخدام السريع، يكفي أمر واحد من المثال الرسمي لإخراج ملف MP4:
manim -pql main.py CreateCircle
3.3 FFmpeg: تحويل مختلف المواد إلى الفيديو النهائي
FFmpeg هو “خط التجميع النهائي” في سلسلة التصيير البرمجي بأكملها. فهو مسؤول عن ترميز الفيديو وتحويل صيغه، ودمج الصوت، وتوصيل المقاطع المتعددة، وحرق الترجمة، والقص والتحجيم، وتحويل معدل الإطارات، وتغيير الصيغ. أما الأداة المرافقة ffprobe فتستطيع قراءة دقة الفيديو النهائي ومعدل إطافته ومدته ومعلومات مسار الصوت، ويستخدمها الوكيل للتحقق الآلي: فإن لم تكن المواصفات مطابقة، يعود إلى الخطوة السابقة لإصلاحها.
# دمج المقاطع (يسرد ملف list.txt ملفات المقاطع سطرًا بسطر)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# دمج التعليق الصوتي وحرق الترجمة
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# فحص مواصفات المخرجات
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion: تحويل الرسوم المتحركة البرمجية إلى ميزة منتج عادية
أطلقت Anthropic في 8 أكتوبر 2026 نسخة Claude Motion Beta، لتقديم الرسوم المتحركة المدفوعة بالكود مباشرة إلى مستخدمي المؤسسات. يصف المستخدم متطلباته للرسوم المتحركة باللغة الطبيعية، فيقوم Claude بتنظيم النصوص والرسوم البيانية والأشكال والصور في صورة رسوم متحركة برمجية ويحفظها في Artifacts؛ ويمكن للمستخدم مواصلة التعديل عبر المحادثة، أو الدخول إلى المحرر لضبطها يدويًا، ثم تصديرها أخيرًا بصيغة MP4.
تشمل الاستخدامات النموذجية: تحويل التقرير المالي الربعي إلى رسوم متحركة تفسيرية مدتها 30 ثانية، وتحويل خطة التسعير إلى رسم مقارنة متحرك، وتحويل خطوات تشغيل المنتج إلى رسوم متحركة إرشادية، وتحويل مواد الاجتماعات إلى فيديو ترويجي داخلي. من حيث شروط الاستخدام، فإن النسخة التجريبية Beta متاحة لمستخدمي Team وEnterprise؛ إذ تكون مفعّلة افتراضيًا في Team، بينما تحتاج في Enterprise إلى تفعيل من مسؤول المؤسسة، وتُحتسب الاستخدامات ضمن حصة الباقة. ولا يستدعي Claude Motion نموذج توليد الفيديو الأصلي، ولذلك لا يمكنه توليد أشخاص حقيقيين أو لقطات متتابعة بأسلوب التصوير الواقعي.
تكمن قيمة Claude Motion للمنتج في عتبة الاستخدام: يمكن للعاملين في العمليات والمالية والتسويق داخل المؤسسات الحصول مباشرة على دقة الرسوم المتحركة البرمجية وقابليتها للتعديل، من دون الحاجة إلى بناء مشروع Remotion.
3.5 GPT + Codex: وكيل يستدعي الأدوات لإنجاز إنتاج الفيديو
ثمة شكل آخر يتمثل في ترك نموذج عام يستدعي الأدوات ذاتيًا داخل بيئة تطوير الوكلاء. وقد أُطلق VibeVideoBench في 26 أكتوبر 2026 خصيصًا لتقييم هذه القدرة: 239 مهمة حقيقية لإنتاج الفيديو تغطي 12 فئة من المحتوى، بما في ذلك قصص البيانات، والمقررات التعليمية، وشرح الأوراق البحثية، والتسويق للعلامات التجارية، وعرض ميزات المنتجات. وتتطلب كل مهمة أن يسلّم الذكاء الاصطناعي، داخل بيئة اختبار معزولة (sandbox) وفي غضون 60 دقيقة، وبشكل مستقل: ملف MP4 قابلًا للتشغيل، ومشروعًا هندسيًا يمكن من خلاله إعادة توليد الفيديو، بالإضافة إلى جدول زمني وتعليمات الإنتاج. وقد أنجزت 9 أنظمة وكلاء ذكية ما مجموعه 2,151 تشغيلًا، وجميعها شُغّلت في بيئة التطوير الأصلية الخاصة بكل منها وبأقصى قوة استدلال متاحة، من دون السماح بإضافة تعليمات بشرية في منتصف التشغيل.
فيما يلي مقارنة بين النظامين الأعلى ترتيبًا (متوسط لجان التحكيم الثلاث، ونطاق التقييم 1–5):
| المقياس | GPT-6 Astra (Codex CLI) | Claude Opus 5.5 (Claude Code) |
|---|---|---|
| تسليم الفيديو بنجاح | 238/239 (99.6%) | 239/239 (100%) |
| معدل مطابقة المواصفات | 93.7% | 99.6% |
| معدل اجتياز متطلبات المهمة | 97.1% | 97.3% |
| درجة الجودة الإجمالية | 4.109 | 4.074 |
| معدل نجاح المهام الصارم | 74.5% | 76.3% |
| Elo للتفضيل البشري | 1242 | 1203 |
| متوسط تكلفة المهمة | $8.19 | $15.38 |
| تكلفة المهمة الوسيطية / P90 | $7.88 / $11.88 | $10.19 / $31.22 |
| متوسط رموز الإخراج (Tokens) | 61K | 130.7K |
| إصابة الذاكرة المؤقتة (Cache Hit) | 97% | 65% |
في هذه المجموعة من الاختبارات، كانت الجودة الإجمالية والتفضيل البشري لـ GPT-6 Astra أعلى قليلًا، وكان متوسط تكلفة المهمة أقل بنحو 46.7%؛ وقد سلّم Claude Opus 5.5 جميع المهام الـ239، وكان معدل مطابقة المواصفات ومعدل نجاح المهام الصارم أعلى. ويرجع الاختلاف الرئيسي في التكلفة إلى كفاءة استخدام Tokens: إذ يقل عدد Tokens الناتجة لدى Astra بنحو 53.3%، وتبلغ نسبة إصابة الذاكرة المؤقتة 97%، في حين أن نحو 76% من تكلفة مهام Opus تأتي من Cache Write. وعلى الرغم من أن سعر الوحدة القياسي للإدخال والإخراج لدى Astra يبلغ 2.5 ضعف سعر Opus، فإن التكلفة الفعلية لإنجاز مهمة واحدة أقل.
يتطلب تفسير هذه البيانات مراعاة منهجية التقييم: فموضوع التقييم هو نظام وكيل متكامل يتكوّن من «النموذج + بيئة التنفيذ»، وهناك اختلافات بين Codex CLI وClaude Code اللذين يستخدمهما GPT وClaude؛ وتُنفَّذ كل مهمة مرة واحدة فقط، بمهلة 60 دقيقة؛ ومعامل ارتباط ترتيب الأنظمة بين لجان التحكيم الثلاث هو 0.933–0.950، ومعامل ارتباطه مع ترتيب Elo البشري هو 0.98، لكن نسبة توافق التفضيل البشري مع نتيجة التحكيم لفيديو واحد هي 73.3%. لذلك، تناسب هذه الدرجات للحكم على المستوى التقريبي على مستوى النظام، ولا تناسب التعميم على جميع مهام الفيديو، ولا يمكن أن تحل محل تقييم نماذج Text-to-Video الأصلية.
يكشف VibeVideoBench أيضًا عن العقبة الرئيسية التي تواجه الوكلاء عند إنشاء الفيديو: فمن بين 2,151 عملية تشغيل، لم يُسلِّم 224 منها فيديو قابلًا للتشغيل، وكانت 169 من هذه الحالات مرتبطة بمشكلات إدارة الوقت، مثل بدء العرض النهائي في وقت متأخر جدًا، أو بطء التشغيل، أو عدم بدء العرض من الأساس، وهو ما يمثل نحو 75% من حالات الفشل. وهكذا انتقلت صعوبة عمل وكيل الفيديو من سؤال “هل يستطيع كتابة شيفرة الحركة؟” إلى إدارة جدولة العرض وتسليم المخرجات.
وبالمقارنة مع Claude Motion، فإن بيئات الوكلاء مثل Codex وClaude Code موجّهة إلى المطورين: إذ يمكنهم الجمع بحرية بين Remotion وManim وFFmpeg وTTS وتسجيل الشاشة، وإنتاج ملفات مشروع كاملة، ما يجعلها مناسبة للربط بخطوط الإنتاج الآلية. أما Claude Motion فهي موجّهة إلى المستخدمين النهائيين في المؤسسات، وتتميز بتفاعل أبسط، وتتركّز قدراتها على حركة النصوص والمخططات والأشكال.
4 كيف تختار بين توليد الفيديو الأصلي وعرض الشيفرة بواسطة الوكيل؟
4.1 المهام المناسبة لتوليد الفيديو الأصلي
- أسلوب التصوير الواقعي للأشخاص: ظهور أشخاص حقيقيين أمام الكاميرا، مع تعبيرات الوجه وحركات الجسد؛
- مشاهد استخدام المنتج: لقطات تُظهر المنتج وهو يُستخدم في بيئة واقعية؛
- الحركة الطبيعية ولغة الكاميرا: الدفع والسحب والتأرجح والتحريك، والتصوير المتتبع، وتغيير حجم اللقطة؛
- الإعلانات ذات الطابع السينمائي: الأفلام الترويجية للعلامات التجارية التي تُقدّم الإضاءة والأجواء وجودة الملمس أولاً؛
- أداء الشخصيات والحكايات المتسلسلة: تفاعل شخصيات متعددة، والسرد بلقطة طويلة؛
- البيئات الطبيعية المعقدة: الطقس، وتدفق المياه، ومشاهد شوارع المدينة وغيرها من المشاهد التي يصعب نمذجتها.
4.2 المهام المناسبة للإنتاج القائم على الكود
- مخططات بيانات دقيقة: يجب أن تكون الأرقام والإحداثيات والنسب دقيقة؛
- دروس تشغيل البرامج: تسجيل الشاشة مع تعليقات وإبراز وشرح الخطوات؛
- شروحات رياضية وعلمية: اشتقاق المعادلات، والتحولات الهندسية، وعرض الخوارزميات؛
- إنفوجرافيك متحرك: عرض تدريجي للمعلومات المنظمة؛
- مقارنة مواصفات المنتج وشرح الأسعار: كل قيمة قابلة للتحقق والتعديل؛
- محتوى دفعي قائم على القوالب: إنشاء مئات الفيديوهات دفعة واحدة باستبدال البيانات في القالب نفسه.
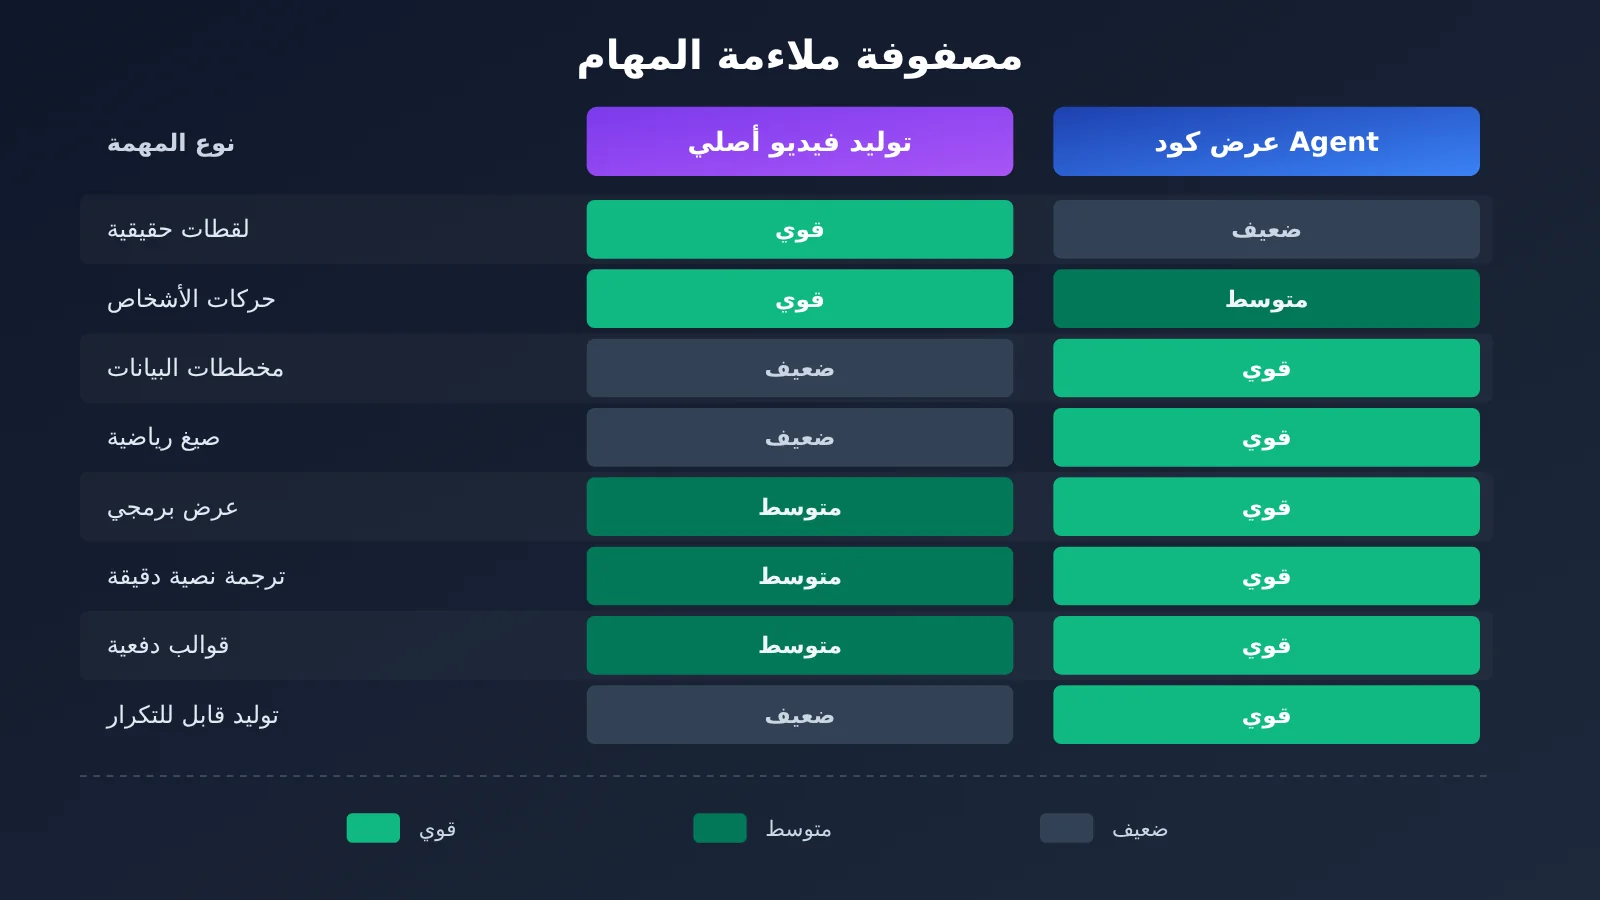
يلخص الجدول التالي مدى توافق المسارين مع المهام الشائعة:
| المهمة | توليد الفيديو الأصلي | العرض البرمجي بالوكيل |
|---|---|---|
| لقطات تصوير حي بطابع سينمائي | قوي | يتطلب مواد جاهزة أو أصولًا ثلاثية الأبعاد |
| حركات بشرية طبيعية | قوي | يعتمد على أصول الرسوم المتحركة |
| حركة كاميرا معقدة | قوي | يمكن برمجتها بدقة |
| عرض البيانات بدقة | يصعب ضمانه | قوي |
| تحريك المعادلات الرياضية | عرضة للخطأ | قوي |
| عرض واجهة البرنامج | يتطلب مراجع ومعالجة لاحقة | قوي |
| ترجمة نصية دقيقة | يتطلب تدقيقًا لاحقًا | قوي |
| عرض ديناميكي للمنتج | قوي | قوي |
| الإنتاج الدفعي بقالب موحد | يتطلب توليدًا متكررًا وفرزًا | قوي |
| التعديل الدقيق لتفصيل واحد | يعتمد على إعادة التوليد أو التحرير | قوي |
| إعادة توليد الرسوم المتحركة نفسها بشكل متكرر | يتأثر بالعشوائية | قوي |
تشير دراسة VibeVideoBench أيضًا إلى أن العرض البرمجي مناسب بشكل خاص لمهام مثل المعادلات الدقيقة، ومخططات البيانات، ومشاهد الألعاب ذات القواعد المتسقة، والتعليق الصوتي المتزامن.
💡 نصيحة للاختيار: يمكن اختصار معيار القرار في جملة واحدة — إذا كان المشهد يحتاج إلى أن يبدو «واقعيًا» فاستخدم نموذج توليد الفيديو الأصلي، وإذا كانت المعلومات تحتاج إلى أن تكون «دقيقة بلا أخطاء» فاستخدم العرض البرمجي. تعتمد السيناريوهات واللوحات القصصية وأكواد الرسوم المتحركة في مسار العرض البرمجي على نموذج لغة كبير عام. نوصي أولًا باختبار أداء GPT وClaude وGemini كل على حدة في مهامك المتعلقة بالسيناريو والكود عبر APIYI apiyi.com وباستخدام مفتاح API نفسه، ثم تحديد النموذج الأساسي.
4.3 هيكل التكلفة للمسارين
تختلف بنية التكاليف بين المسارين اختلافًا كبيرًا، لذا فإن المقارنة المباشرة لسعر الوحدة محدودة الفائدة:
- توليد الفيديو الأصلي: يُحتسب أساسًا حسب دقة الإخراج ومدته، إضافة إلى الاستهلاك الإضافي الناتج عن إدخال فيديو مرجعي؛ أما التوليد والفرز المتكرران بسبب العشوائية فهما تكلفة خفية.
- عرض الشفرة البرمجية عبر Agent: يشمل رسوم Token للنموذج العام (الإدخال، والإخراج، وقراءة الذاكرة المؤقتة وكتابتها)، وحوسبة تنفيذ الشفرة والعرض، وتراخيص الأدوات (مثل الترخيص التجاري لـ Remotion)، وتكاليف مواد TTS والموسيقى والمؤثرات الصوتية.
عند المقارنة ينبغي الاعتماد على «التكلفة الإجمالية للفيديو النهائي القابل للتسليم»: إذا كانت لقطة فيديو أصلية واحدة تتطلب خمس عمليات توليد لاختيار نتيجة صالحة واحدة، فإن تكلفتها الحقيقية تساوي خمسة أضعاف السعر المعلن؛ وبالمثل، إذا كان معدل إصابة الذاكرة المؤقتة منخفضًا في مهمة Agent واحدة وأُعيد العرض مرارًا، فإن تكاليف Token ترتفع بسرعة أيضًا. وتشير بيانات VibeVideoBench إلى أن النموذج الأعلى سعرًا للوحدة يمكن أن يحقق تكلفة مهمة أقل بفضل عدد أقل من Tokens الإخراج ومعدل إصابة أعلى في الذاكرة المؤقتة؛ وعند اختيار النموذج ينبغي النظر إلى التكلفة المقاسة فعليًا لكل مهمة.
💰 تحسين التكلفة: تمثل رسوم النماذج نسبة مرتفعة في مسار عرض الشفرة، وغالبًا ما تتضمن سياقات طويلة واستدعاءات متعددة الجولات. من خلال استدعاء عدة نماذج رئيسية بالدفع حسب الاستخدام عبر APIYI apiyi.com، يمكنك استخدام الشفرة نفسها لمقارنة التكلفة الفعلية لإنجاز مهمة الفيديو نفسها بين نماذج مختلفة، ثم توزيع النماذج حسب نوع المهمة.
5 الحل الأكثر فعالية: دمج مسارَي تقنية فيديو الذكاء الاصطناعي
5.1 سير عمل إنتاج هجين
دمج المسارين معًا، بحيث يتولى نموذج الفيديو الأصلي مسؤولية المشاهد الطبيعية، ويتولى العرض بالكود مسؤولية التعبير الدقيق، هو الحل الأكثر قابلية للتطبيق حاليًا:
- الإبداع ولوحة المشاهد: يتولى GPT أو Claude الأفكار والسيناريو ولوحة المشاهد، ويحدد طريقة الإنتاج لكل مشهد؛
- المشاهد الطبيعية: يتولى Seedance أو Kling أو Veo توليد مشاهد الأشخاص والأماكن واستخدام المنتجات؛
- المشاهد الدقيقة: يتولى Remotion مسؤولية الرسوم البيانية للبيانات، والترجمة النصية، وعناصر العلامة التجارية، ورسوم متحركة لمواصفات المنتج؛
- التعليق الصوتي: يولّد TTS التعليق الصوتي بناءً على السيناريو؛
- التركيب: يجمع FFmpeg المشاهد، ويدمج المسارات الصوتية، ويحرق الترجمة النصية داخل الفيديو؛
- التحقق والتصحيح: يفحص وكيل الذكاء الاصطناعي المواصفات باستخدام ffprobe، ويتحقق من تزامن الصوت والصورة والترجمة النصية، وعند اكتشاف مشكلة يعود إلى المرحلة المعنية لإصلاحها.
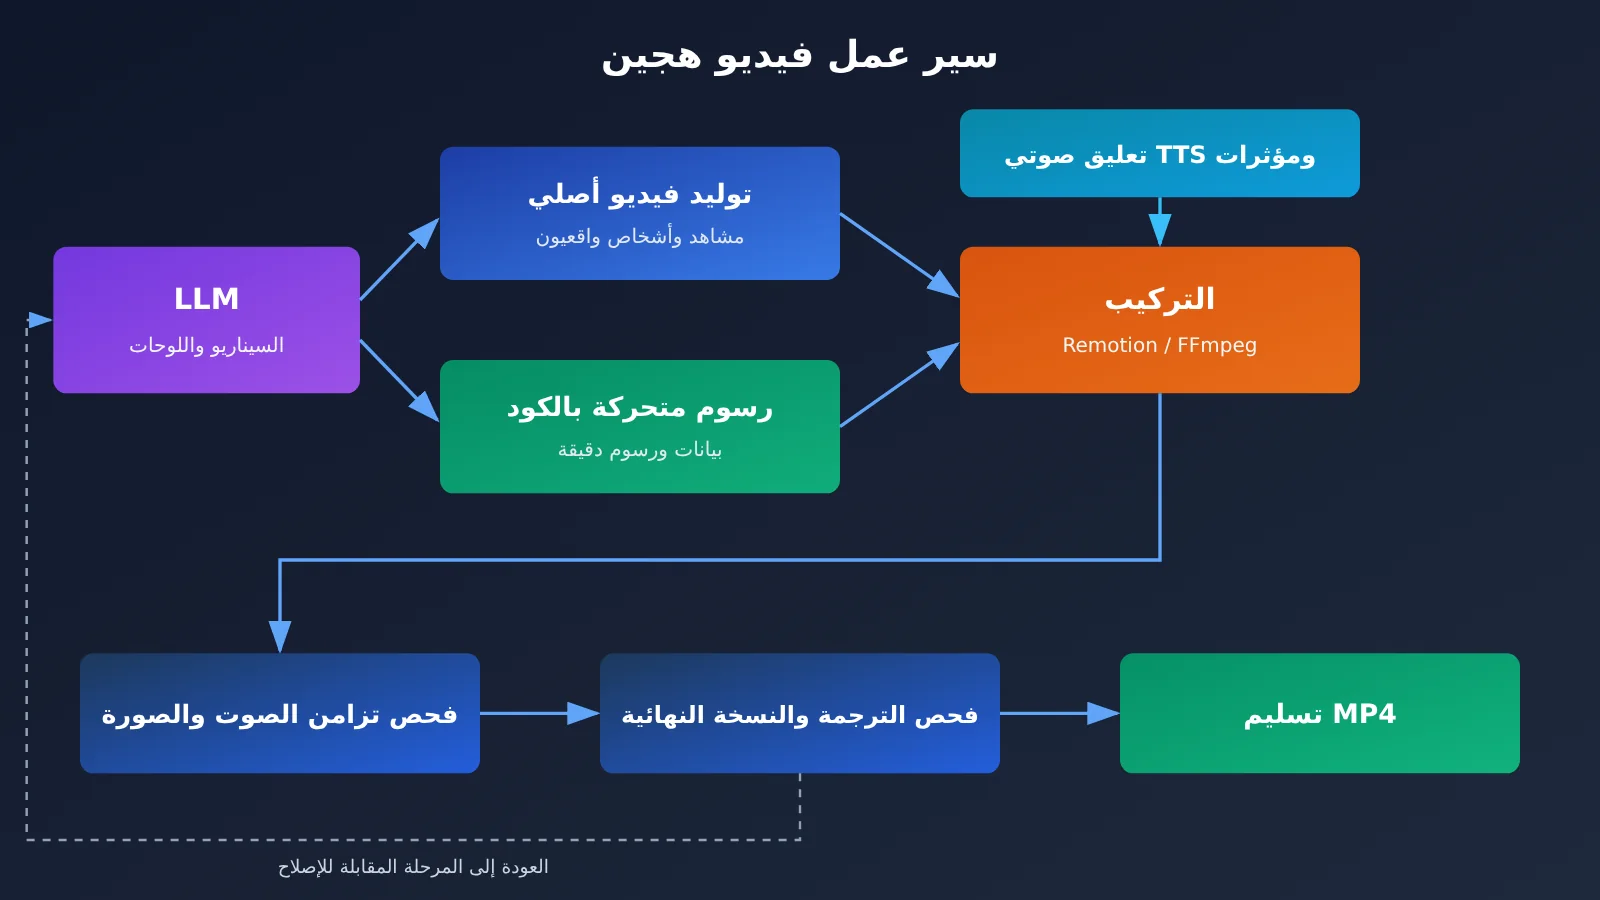
في الشكل أعلاه، تُنجز مرحلتا السيناريو ولوحة المشاهد وفحص النسخة النهائية بواسطة نموذج لغة كبير عام، ويمكن توحيد هذا الاستدعاء عبر APIYI على apiyi.com، باستخدام واجهة واحدة متوافقة مع OpenAI للتبديل بين GPT وClaude وGemini.
5.2 مثال شامل: توزيع الأدوار في فيلم ترويجي لمنتج
لنأخذ فيلمًا ترويجيًا لتطبيق جوال كمثال، ويمكن توزيع الأدوار بين الأجزاء على النحو التالي:
- لقطات الأجواء الافتتاحية (المستخدم وهو يستخدم المنتج أثناء التنقل أو في مكتبه): تُسند إلى Seedance 2.5 أو Kling 4.0. استخدم صور المنتج وصور تصميم الشخصية كمرجع لضمان اتساق مظهر الشخصية والمنتج؛ ويمكن لـ Kling 4.0 تثبيت تكوين المشهد الافتتاحي والختامي باستخدام الإطارات المفتاحية. وبحسب تقديرات Seedance 2.5 الرسمية، تبلغ تكلفة 720p حوالي $0.231 في الثانية، وعند تخطيط الميزانية يجب أيضًا ترك هامش لتوليدات متعددة.
- مقطع عرض الوظائف: سجّل واجهة التطبيق الفعلية، ثم استخدم Remotion لإضافة إطارات التمييز وأرقام الخطوات والعلامات الديناميكية. محتوى الواجهة مأخوذ من تسجيل شاشة حقيقي، لذلك لن تظهر أزرار “اختلقها” النموذج.
- مقطع المعلمات والأسعار: استخدم مكونات Remotion لعرض جدول مقارنة الوظائف وبطاقات الأسعار. عند تعديل الأسعار، يكفي تغيير ملف البيانات وإعادة العرض، وتبقى بقية المشاهد دون تغيير.
- التعليق الصوتي والترجمة: يكتب نموذج لغة كبير نص التعليق الصوتي، ويولّد TTS الصوت، ويُخرج في الوقت نفسه ملف ترجمة SRT.
- التجميع والفحص النهائي: يدمج FFmpeg جميع المقاطع ويركّب المسار الصوتي، ويستخدم الوكيل ffprobe للتحقق من المدة والدقة والمسار الصوتي، ثم يفحص كل مقطع للتأكد من تزامن الترجمة مع التعليق الصوتي.
نتيجة هذا التوزيع هي: اللقطات الواقعية يضمنها نموذج الفيديو، وكل المعلومات القابلة للتحقق يضمنها الكود، وفي التعديلات اللاحقة يكفي إعادة عرض المقاطع المقابلة فقط.
5.3 توليد لوحة قصة مع وسوم توجيه المسارات باستخدام API
الخطوة الأولى في سير العمل الهجين هي أن يُخرج نموذج اللغة الكبير لوحة قصة منظّمة، مع تحديد المسار الذي سيُستخدم لكل مشهد. يستخدم المثال التالي واجهة متوافقة مع OpenAI لإنجاز هذه الخطوة:
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة OpenAI المتوافقة من APIYI
)

MODEL = "your-model-name"  # استبدل باسم النموذج الفعلي من قائمة نماذج المنصة

prompt = """为一款记账 App 写 30 秒宣传片分镜,输出 JSON 数组。
每个镜头包含 id、duration、description、route 字段。
route 只能是 native(真实人物与场景,交给视频模型)
或 code(数据、参数、字幕、界面标注,交给 Remotion 渲染)。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
عرض التنفيذ الكامل: توزيع مسارات لوحة القصة + توليد معلمات عرض Remotion
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # النموذج المسؤول عن الإبداع ولوحة القصة
CODER_MODEL = "your-coder-model"      # النموذج المسؤول عن توليد معلمات العرض/الكود


def plan_storyboard(brief: str) -> list[dict]:
    """اجعل النموذج يخرج JSON للوحة القصة مع وسم route."""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "你是视频导演,只输出合法 JSON 数组。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """توليد معلمات مكوّن Remotion للمشاهد ذات المسار code."""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "把镜头描述转换为 Remotion 组件 props,只输出 JSON 对象。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """استدعاء Remotion CLI لعرض مشهد واحد."""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("为一款记账 App 写 30 秒宣传片分镜,"
                            "字段:id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("已渲染:", path)
        else:
            # تُسلّم مشاهد native إلى نموذج توليد الفيديو؛ هنا يُسجّل الموجه بانتظار التوليد
            print("待原生生成:", shot["id"], shot["description"])
🚀 بداية سريعة: خطوات توليد لوحة القصة (storyboard) والمعلمات أعلاه لا تحتاج إلا إلى نموذج لغة كبير عام. ننصح بالsign up في APIYI عبر apiyi.com والاستفادة من رصيد الاختبار المجاني للمستخدمين الجدد، ثم تشغيل نموذجين أو ثلاثة على الطلب نفسه الخاص بالفيديو الترويجي، ومقارنة جودة لوحة القصة واستهلاك الـ Token، قبل تثبيت النموذج داخل سير عمل الإنتاج.
6 الخلاصة: محور المنافسة في فيديو الذكاء الاصطناعي هو سير عمل إنتاجي متكامل
أصبحت علاقة الملاءمة بين المسارين التقنيين والمهام واضحة تمامًا: التوليد الأصلي للفيديو مسؤول عن الصور الواقعية وأداء الممثلين ولغة الكاميرا، إذ لكل من Seedance 2.5 وKling 4.0 وVeo 3.1 تركيز مختلف على التوليد المتواصل لمدة 30 ثانية، والمراجع متعددة الوسائط، والإطارات المفتاحية، والتحرير المستمر؛ أما العرض بالكود البرمجي فيتولاه الوكيل الذكي (Agent) ليتعامل مع المعلومات الدقيقة والعرض القابل للتكرار والإنتاج بالجملة، حيث يشكّل Remotion وManim وFFmpeg القاعدة الأدواتية، ويحوّلها Claude Motion إلى منتج جاهز لمستخدمي المؤسسات، بينما يمكّن Codex وClaude Code المطوّرين من بناء خط أنابيب أتمتة متكامل.
وتُظهر نتائج VibeVideoBench أن أنظمة الوكيل الذكي الرائدة باتت تسلّم فيديو مكتملًا بشكل مستقر، وأن الأسباب الرئيسية للفشل تتمركز في جدولة العرض وإدارة الوقت؛ أما تكلفة المهمة الواحدة فتتحدد بكفاءة الـ Token ومعدل إصابة الذاكرة المؤقتة (cache)، لا بسعر الوحدة للنموذج. وهذا يعني أن المنافسة في إنتاج الفيديو تنتقل من جودة الصورة لدى نموذج واحد إلى القدرة على تنظيم سير العمل بأكمله: “التوليد، والتحرير، والعرض، والتسليم”.
مراجعة النقاط الأساسية:
- الفرق بين المسارين: التوليد الأصلي يُخرج النموذج منه الصور مباشرة، أما العرض بالكود فيكتب النموذج برنامجًا ثم يتم عرضه؛
- متى يناسب التوليد الأصلي: الشخصيات، والإحساس بالتصوير الواقعي، والحركة الطبيعية، والإعلانات ذات الطابع السينمائي، والحكايات المتصلة؛
- متى يناسب العرض بالكود: مخططات البيانات، والمعادلات، ودروس البرمجيات، وجداول المعلمات والأسعار، والمحتوى القالبي القابل للتكرار بالجملة؛
- أساس مقارنة التكلفة: يُعتمد التكلفة الإجمالية للفيديو النهائي القابل للتسليم، مع احتساب إعادة المحاولة والـ Token وتكلفة العرض والتراخيص؛
- الممارسة المثلى: سير عمل هجين، يتولى فيه نموذج الفيديو الصور الطبيعية، ويتولى الكود التعبير الدقيق؛
- استدعاء نماذج متعددة: النص البرمجي ولوحة القصة وكود الرسوم المتحركة وفحص النسخة النهائية — كل منها يناسبه نموذج مختلف، والواجهة الموحّدة تقلل تكلفة التبديل.
في الإنتاج الفعلي، غالبًا ما يستدعي الفيديو الواحد عدة نماذج لغة كبيرة لتنجز على التوالي الأفكار والترميز والفحص. وننصح باستخدام APIYI عبر apiyi.com لمفاتيح API موحّدة تستدعي بها GPT وClaude وGemini وغيرها، بحيث توزّع النماذج حسب المهمة وتدفع حسب الاستخدام، وتُبقي تركيزك على سير العمل نفسه.
المراجع
- تقييم VibeVideoBench الرسمي: تقييم للوكلاء الذكية في توليد الفيديو المدفوع بالكود
- الرابط:
vibevideobench.github.io -
الوصف: لوحة صدارة تضم 239 مهمة، ودرجات الجودة، وتحليل التكلفة وأسباب الفشل
-
الإعلان الرسمي عن Seedance 2.5: التوليد لمدة 30 ثانية والمراجع متعددة الوسائط
- الرابط:
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
الوصف: الحد الأقصى للمواد المرجعية، وقدرات التمديد والتحرير بالطوابع الزمنية
-
تسعير BytePlus ModelArk: أسعار واجهة برمجة تطبيقات Seedance 2.5
- الرابط:
docs.byteplus.com/en/docs/modelark/model-pricing -
الوصف: أسعار مرجعية لتوليد الفيديو بدقات مختلفة
-
توثيق Kling API: إعلان تحديث Kling 4.0 والفوترة
- الرابط:
kling.ai/document-api/apiReference/updateNotice -
الوصف: الإطارات المفتاحية، والمراجع متعددة المواد، وقواعد الفوترة بوحدة Unit
-
توثيق توليد الفيديو في Gemini API: Veo 3.1 وGemini Omni Flash
- الرابط:
ai.google.dev/gemini-api/docs/video -
الوصف: الصوت الأصلي، وتمديد الفيديو، وقدرات التحرير متعدد الجولات
-
توثيق Remotion وأسعار الترخيص
- الرابط:
remotion.dev/docs/render،remotion.dev/docs/license/pricing -
الوصف: أوامر التصيير وخيارات الترخيص التجاري
-
توثيق Manim Community
- الرابط:
docs.manim.community/en/stable -
الوصف: طريقة استخدام محرك الرسوم المتحركة الرياضية والعلمية
-
توثيق FFmpeg الرسمي
- الرابط:
ffmpeg.org/documentation.html -
الوصف: الترميز والتركيب والترجمة النصية والفحص عبر ffprobe
-
دليل استخدام Claude Motion
- الرابط:
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
الوصف: مسار ميزة Beta وشروط إتاحتها
-
إيقاف واجهات OpenAI API
- الرابط:
developers.openai.com/api/docs/deprecations - الوصف: معلومات عن إيقاف Sora 2 وواجهة Videos API
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد التكامل يمكنكم زيارة مركز توثيق docs.apiyi.com