
Ringkasan: Membandingkan kombinasi yang tersedia di China dari tiga lapisan—model, agen pemrograman, dan saluran API—lalu memilih skema reproduksi yang cocok untuk diri sendiri berdasarkan tugas pemrograman nyata, biaya, dan kompatibilitas.
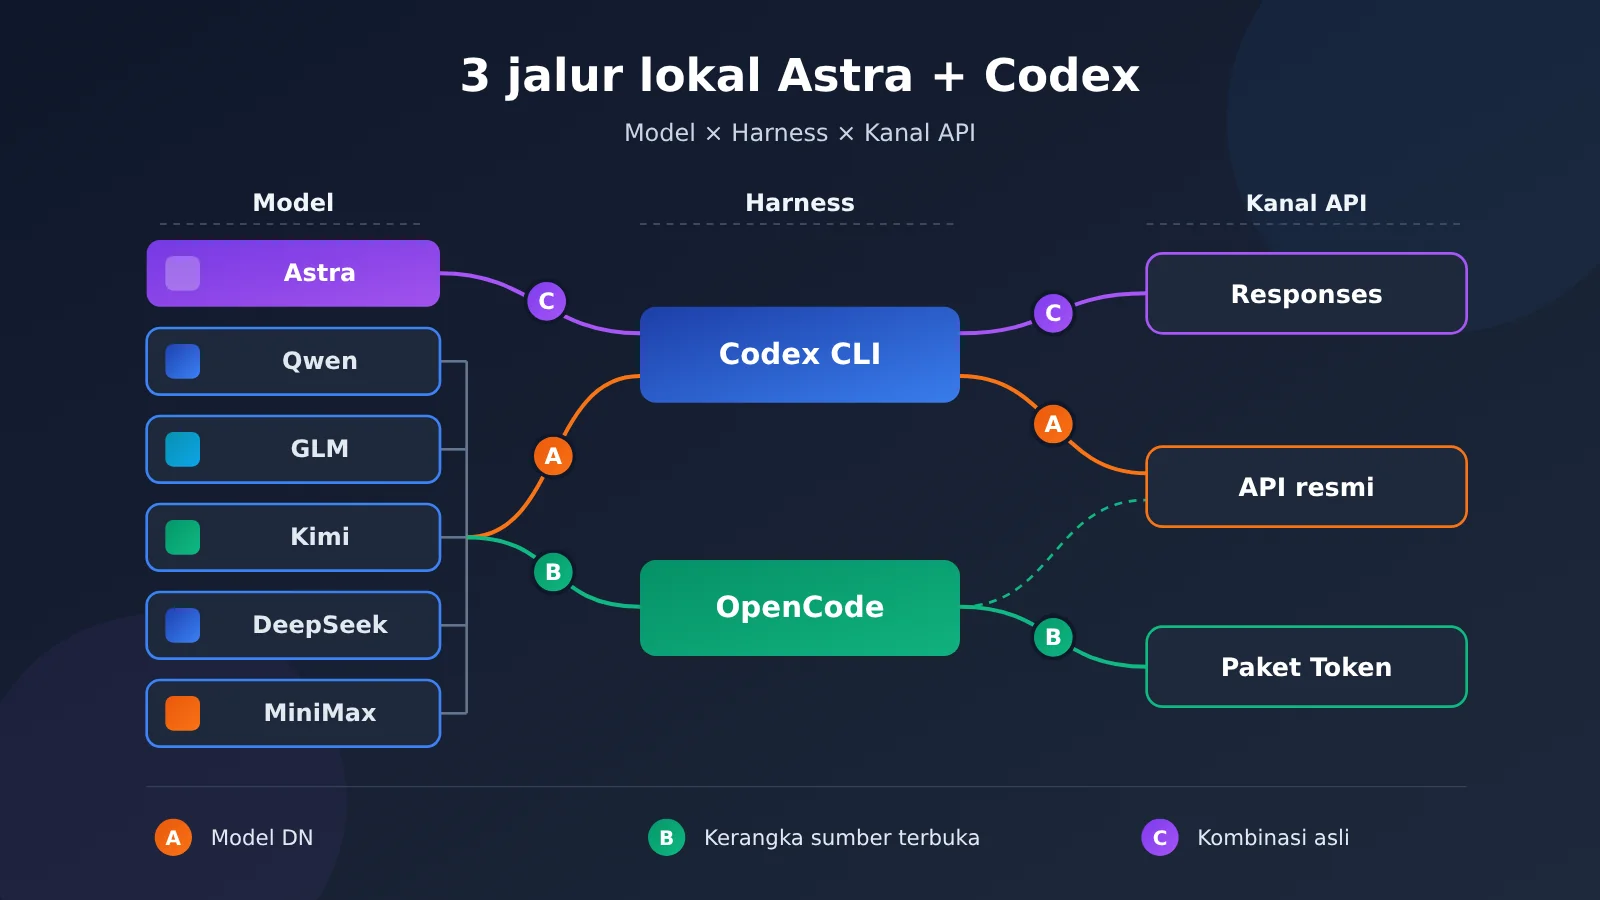
Untuk mereproduksi Astra + Codex semaksimal mungkin di China, ada tiga rute yang layak diuji. Rute A: mempertahankan Codex CLI versi asli, lalu mengakses model unggulan domestik melalui antarmuka kompatibel Responses dari Alibaba Cloud Bailian atau Tencent Cloud TokenHub—rute ini mempertahankan pengalaman eksekusi Codex. Rute B: beralih ke Harness terbuka seperti OpenCode untuk mengakses beberapa model domestik—rute ini memberikan kebebasan pemilihan model paling besar. Rute C: dengan prasyarat legal dan patuh aturan serta layanan yang benar-benar tersedia, mempertahankan model GPT-6 Astra dan mengakses Codex versi asli melalui saluran API yang mendukung protokol Responses secara penuh—rute ini memiliki tingkat kesetiaan tertinggi terhadap kombinasi aslinya.
Jika model harus dilokalkan, Rute A adalah titik awal, di mana Qwen4-Max-Preview hanya dibuka hingga 25 November 2026 pukul 24:00, sehingga cocok untuk evaluasi tetapi tidak cocok menjadi satu-satunya ketergantungan jangka panjang. Jika hanya menuntut penggunaan dalam lingkungan jaringan domestik tanpa menuntut lokalisasi model, Rute C paling mendekati versi asli dalam hal kecerdasan model. Pemilihan akhir di antara ketiga rute harus ditentukan oleh tingkat keberhasilan, waktu yang dibutuhkan, biaya, dan kompatibilitas alat pada kumpulan tugas pemrograman nyata yang sama—bukan oleh peringkat atau harga satuan token.
Di bawah ini, Astra + Codex pertama-tama dipecah menjadi lima komponen kapabilitas untuk menjelaskan apa sebenarnya yang “direproduksi”; kemudian disajikan dua set konfigurasi akses resmi dan perbandingan paket untuk Rute A, empat Harness untuk Rute B, serta model domestik yang layak diuji lebih dulu; selanjutnya satu tabel ringkasan merangkum pilihan dari ketiga rute; dan terakhir diberikan metode pengujian lima jenis tugas yang dapat direproduksi, dengan “biaya per tugas yang berhasil” sebagai indikator inti dalam memilih.
To Know: Pengetahuan Dasar Istilah
| Istilah | Penjelasan |
|---|---|
| GPT-6 Astra | Model penalaran unggulan OpenAI, ditujukan untuk penalaran kompleks, rekayasa perangkat lunak, dan tugas Agen jangka panjang, dengan ID model gpt-6-astra. |
| Codex | Agen pemrograman OpenAI yang dapat membaca proyek, mengubah kode, menjalankan perintah, dan memverifikasi hasil. |
| Harness | Kerangka eksekusi yang menghubungkan keputusan model ke alat nyata, bertanggung jawab atas loop alat, konteks, izin, dan pemulihan kegagalan. |
| Responses API | Protokol antarmuka OpenAI yang mendukung output model, penalaran, dan pemanggilan alat; Codex versi baru bergantung padanya untuk berjalan. |
| Chat Completions | Protokol antarmuka percakapan OpenAI yang lebih lama; Codex versi lama menggunakannya. |
| Provider | Penyedia layanan model untuk alat Agen; dalam file konfigurasi muncul sebagai sekumpulan parameter akses. |
| Base URL | Alamat akses dasar API layanan model; saat mengganti saluran, ini yang terutama diubah. |
| Token Plan | Skema penagihan kuota pemanggilan model bulanan yang disediakan penyedia cloud. |
| Credits / kredit | Satuan pengukuran dalam paket untuk memotong kuota pemanggilan; satuan dari penyedia berbeda tidak dapat langsung dipertukarkan. |
| Jendela konteks | Batas konten yang dapat diproses model dalam satu permintaan, dihitung dalam Token. |
| Tingkat penalaran | Parameter yang mengontrol kedalaman berpikir model; Astra menyediakan lima tingkat dari low hingga max. |
| Hit cache | Input yang dikirim berulang kali digunakan kembali oleh server dan ditagih dengan tarif lebih rendah. |
| MCP | Protokol terbuka yang menghubungkan aplikasi model dengan alat eksternal dan sumber data. |
| Function Calling | Mekanisme di mana model menghasilkan permintaan pemanggilan terstruktur, aplikasi menjalankan fungsi, lalu mengembalikan hasilnya. |
| Penagihan puncak/non-puncak | Harga dibedakan berdasarkan periode waktu; periode puncak mengonsumsi kuota lebih banyak. |
Isi Utama
1 Di mana sebenarnya kekuatan Astra + Codex?
1.1 Apa yang ditawarkan Astra
GPT-6 Astra adalah model penalaran unggulan OpenAI, dengan posisi resmi yang mencakup penalaran kompleks, rekayasa perangkat lunak, modifikasi kode multi-langkah, operasi browser dan komputer, analisis riset, serta produksi dokumen profesional. Yang diberikannya kepada Codex adalah “daya penilaian”: memahami basis kode yang asing, merancang rencana perubahan, membaca pesan error dan menyesuaikan strategi.
Spesifikasi model resmi (tanggal verifikasi data 2026-11-13) adalah sebagai berikut:
- Jendela konteks: 1.050.000 Token; output maksimum: 128.000 Token.
- Tingkat penalaran: low, medium, high, xhigh, max.
- Harga standar (USD / juta Token): input $10, output $50, input cache $1, penulisan cache 30 menit $12.50; bila input melebihi 272K Token berlaku tarif konteks panjang yang lebih tinggi.
- Alat Responses API: Web Search, File Search, Hosted Shell, Apply Patch, Computer Use, MCP, dan lain-lain.
Poin terakhir perlu dipahami secara terpisah: alat-alat ini adalah kemampuan yang disediakan platform OpenAI, dan apakah sebuah klien atau gateway pihak ketiga bisa memakainya bergantung pada alat mana yang benar-benar diintegrasikannya.
1.2 Tugas apa yang diselesaikan Codex
Dalam artikel Codex Harness yang diumumkan OpenAI pada Agustus 2026, inti Codex dirangkum sebagai loop Agent, pemahaman basis kode dan operasi file, eksekusi perintah, pemanggilan alat dan pengembalian hasil, manajemen konteks multi-putaran, persetujuan pengguna, batas keamanan sandbox, serta observasi proses eksekusi dan pemulihan dari kegagalan.
Pembagian tugasnya jelas: model bertanggung jawab atas penilaian dan generasi, sedangkan Harness bertanggung jawab menerapkan keputusan model ke sistem file dan terminal yang nyata. Model chat yang sangat kuat pun hanya bisa menyelesaikan tugas pemrograman lengkap “baca proyek → ubah kode → jalankan tes → perbaiki kegagalan → verifikasi ulang” bila dilengkapi sistem eksekusi ini.
1.3 Yang perlu direplikasi: model, atau seluruh Agent?
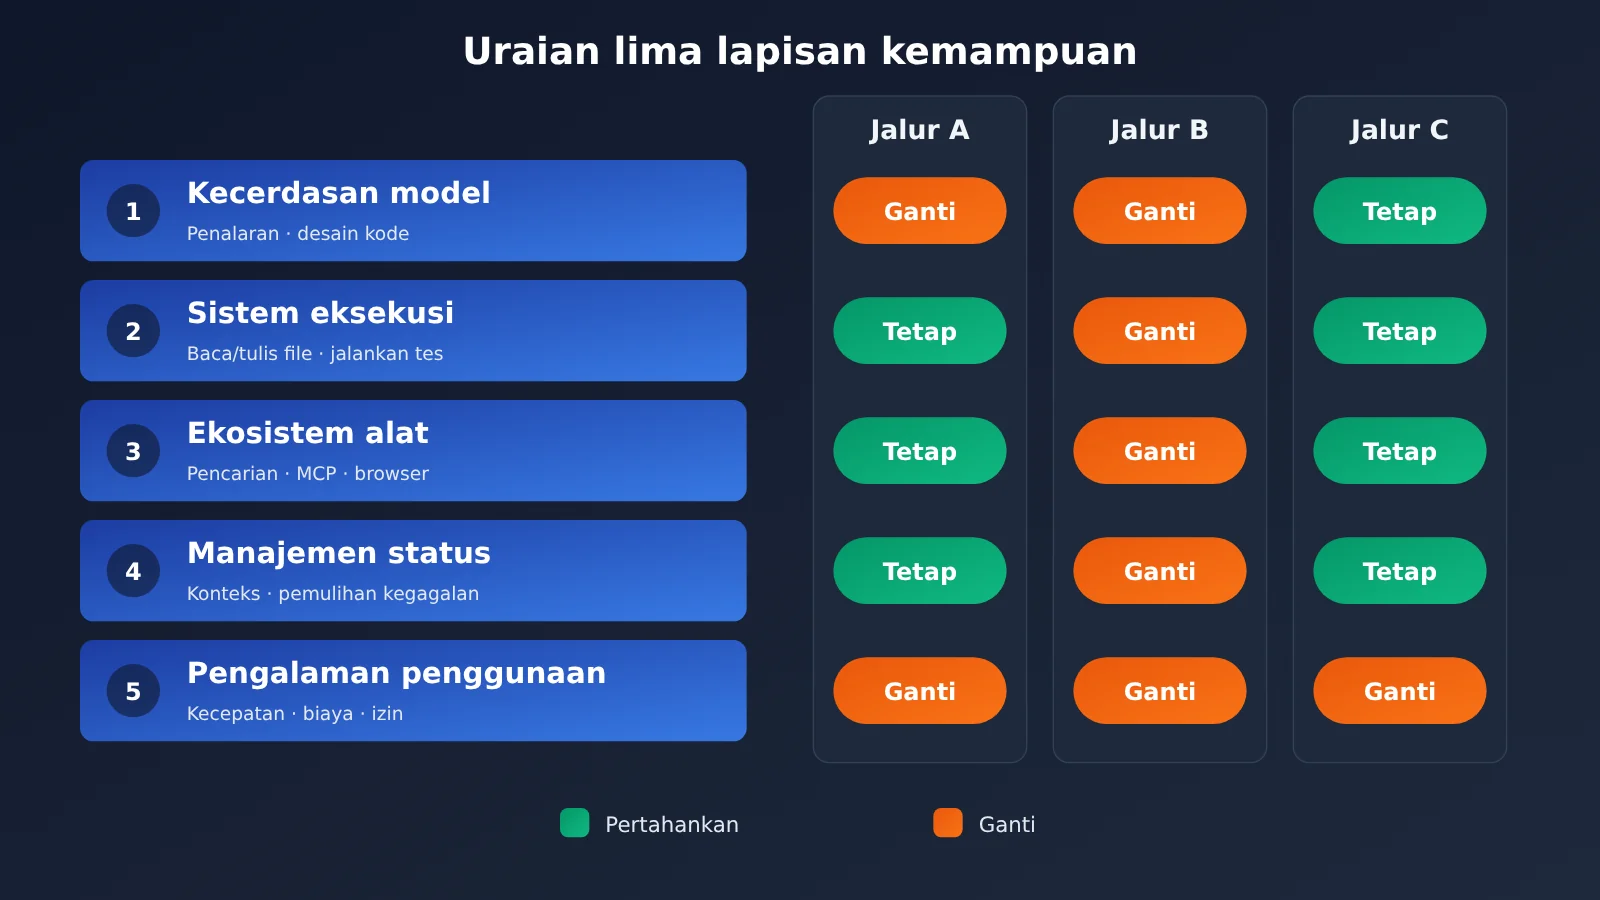
Jika pengalaman asli diuraikan, kita mendapatkan lima komponen:
- Kecerdasan model: pemahaman tugas kompleks, desain kode, penalaran dan debugging.
- Sistem eksekusi: membaca proyek, mengedit file, menjalankan perintah, menjalankan tes.
- Ekosistem alat: pencarian online, pembacaan halaman web, MCP, pemrosesan file, operasi browser.
- Manajemen status: konteks tugas panjang, loop pemanggilan alat, pemulihan dari kegagalan.
- Pengalaman penggunaan: kecepatan respons, stabilitas, biaya, kontrol izin, dan kemudahan operasi.
Mengganti model terutama mengubah poin 1, tetapi yang akhirnya dirasakan pengguna adalah total dari kelima poin. Inilah juga garis pemisah tiga jalur: jalur A mengganti poin 1 sambil mempertahankan poin 2 dan 4; jalur B mengganti poin 1, 2, dan 4 sekaligus; jalur C sedapat mungkin mempertahankan poin 1, 2, dan 4, dengan perbedaan terpusat pada poin 5 dan detail protokol yang dibawa oleh saluran API.
2 Mempertahankan Codex, Menghubungkan Model Domestik (Jalur A)
2.1 Token Plan Alibaba Cloud Bailian + Codex
Alibaba Cloud telah merilis dokumentasi integrasi resmi Codex. Token Plan menyediakan antarmuka yang kompatibel dengan Responses sehingga bisa langsung tersambung ke Codex versi baru. Tulis berikut ini di ~/.codex/config.toml (di Windows umumnya C:\Users\<username>\.codex\config.toml):
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
Variabel lingkungan yang ditunjuk env_key harus diisi API Key khusus paket dari Token Plan. Saat konfigurasi, ada beberapa detail teknis yang mudah bikin tersandung:
- Versi protokol: Codex sejak 0.94.0 mewajibkan Responses API. Coding Plan versi lama Alibaba Cloud memakai Chat Completions, dan pihak resmi mengharuskan dipasangkan dengan Codex 0.93.0 atau versi lebih lama; lingkungan yang dipelihara jangka panjang sebaiknya memilih Token Plan.
- Isolasi Key: Token Plan, Coding Plan, dan penagihan per pemakaian memakai tiga set kunci API yang berbeda.
- Wilayah: Token Plan saat ini hanya mendukung Tiongkok Utara 2 (Beijing).
- Metadata model: Model baru perlu konfigurasi ID model dan metadata yang benar agar mendapat dukungan penuh di antarmuka pemilihan model Codex.
Yang paling layak diperhatikan di Bailian saat ini adalah Qwen4-Max-Preview yang dirilis 11 November 2026 (ID model qwen4-max-preview). Dokumentasi resmi mengonfirmasi bahwa ini adalah model multimodal unggulan generasi baru, mendukung pengembangan kode, tugas agen yang kompleks, pemahaman gambar dan video, mendukung penalaran mendalam (aktif secara default), pemanggilan tool, pencarian web, dan output terstruktur, serta kompatibel dengan tiga protokol: OpenAI Chat Completions, Responses, dan Anthropic Messages. Panjang jendela konteks 1M Token, anggaran output maksimum 393,216 Token, dan proses berpikir bersama jawaban akhir berbagi anggaran tersebut.
Syarat penggunaannya juga jelas: saat ini hanya tersedia di Token Plan, tidak mendukung penagihan per pemakaian; masa pratinjau berlangsung dari 11 November 2026 pukul 10:00 hingga 25 November pukul 24:00 waktu Beijing, dan setelah itu model ditarik. Per tanggal artikel ini, sisa waktu pengujian kurang dari dua minggu, jadi cocok untuk segera diuji; lingkungan produksi sebaiknya sekaligus menyiapkan model alternatif.
2.2 TokenHub Tencent Cloud + Codex
Tencent Cloud menyediakan tutorial integrasi resmi khusus untuk Codex CLI. Penulisan file konfigurasi yang sama adalah sebagai berikut:
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id perlu diganti dengan ID model persis yang saat ini didukung paket. Pustaka model TokenHub mencakup GLM-5.3, Kimi K3, seri DeepSeek V4, MiniMax M3, seri Tencent Hunyuan Hy, serta sebagian model ringan dan model routing otomatis. Paket yang sama juga mendukung tool seperti Claude Code, Cline, dan OpenClaw.
Keunggulan TokenHub ada pada “satu konfigurasi Codex, banyak model domestik”: cukup ubah satu baris model, Harness yang sama bisa menjalankan GLM, Kimi, DeepSeek, dan MiniMax secara bergantian, sangat pas untuk perbandingan horizontal. Stok model, versi, dan kebijakan kuota bisa berubah secara dinamis; sebelum setiap pengujian, ID model yang tercantum di konsollah yang jadi acuan.
2.3 Apa bedanya kedua paket ini
Keduanya bernama Token Plan, tetapi satuan pengukurannya berbeda: Bailian memakai Credits, TokenHub memakai poin, dan keduanya tidak bisa dikonversi langsung. Data pada tabel berikut per 2026-11-13, satuan harga semuanya yuan / bulan:
| Dimensi perbandingan | Alibaba Cloud Bailian Token Plan (Edisi Personal) | Tencent Cloud TokenHub Token Plan Umum (Edisi Personal) |
|---|---|---|
| Tingkat dan biaya bulanan | Lite ¥39, Essential ¥79, Standard ¥139, Pro ¥312 | Lite ¥39, Standard ¥99, Pro ¥299, Max ¥599 |
| Kuota bulanan | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 poin |
| Agent konkuren yang disarankan | 1—2 / 2—3 / 3—4 / 6—8 | Dokumentasi tidak mencantumkan metrik sejenis |
| Diskon dan benefit | Pembelian pertama pengguna baru Lite dan Essential: ¥19.5 dan ¥39.5 (hingga 2026-11-30); Standard dan Pro disertai benefit AgentStudio Harness | Tarif potongan poin diskon waktu terbatas untuk sebagian model; referensi pembelian poin ¥1 = 20 poin |
| Protokol integrasi Codex | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| Model unggulan | Seri Qwen, termasuk Qwen4-Max-Preview yang hanya tersedia di Token Plan | GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3, Hunyuan Hy |
| Metode penghitungan | Credits dipotong berdasarkan model | Sejak 2026-08-31, potongan poin; laju berbeda antar model |
| Batasan penggunaan | Hanya China North 2 (Beijing); paket pemrograman interaktif tidak boleh langsung digunakan untuk otomasi backend komersial apa pun | Pustaka model dan aktivitas promosi dapat berubah |
Saat membandingkan kedua paket ini, peringkat biaya bulanan tidak terlalu penting. Kuncinya adalah “berapa kuota yang dipotong setiap kali satu tugas diselesaikan untuk model yang ingin saya gunakan di paket ini”. Nilai Bailian berpusat pada ekosistem Qwen dan Qwen4-Max-Preview yang saat ini eksklusif; nilai TokenHub berpusat pada satu kuota yang dipakai bersama oleh beberapa model dalam negeri.
TokenHub mempublikasikan tarif potongan poin untuk tiap model. Berikut sebagian tarif diskon waktu terbatas yang dicek pada 2026-11-13, sudah dikonversi dengan patokan ¥1 = 20 poin ke RMB per juta Token:
| Model | Input normal | Output | Input cache hit | Catatan |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | Harga kembali ke tarif resmi setelah diskon berakhir |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | Skenario yang sensitif terhadap kecepatan dan biaya |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | Harga kembali ke tarif resmi setelah diskon berakhir |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | Model khusus kode |
| DeepSeek V4.1 Flash (Nonpuncak) | ¥0.40 | ¥1.60 | ¥0.008 | Penagihan puncak/nonpuncak |
| DeepSeek V4.1 Flash (Puncak) | ¥0.80 | ¥3.20 | ¥0.016 | Hari kerja 09:00—12:00, 14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | Harga untuk input ≤ 512K Token |
Tabel ini perlu dipahami bersama dua hal. Pertama, langganan bulanan ditagih berdasarkan biaya bulanan paket; nominal dalam tabel adalah nilai referensi poin, yang digunakan untuk membandingkan laju konsumsi antar model. Kedua, penagihan puncak/nonpuncak DeepSeek berlaku sejak 30 Oktober 2026; konsumsi pada jam puncak sekitar dua kali lipat dibanding jam nonpuncak. Menjalankan tugas asinkron seperti pemeriksaan kode dan analisis pengujian secara batch pada malam hari dapat menghemat kuota secara signifikan.
Mari lakukan perhitungan dengan GLM-5.3: sebuah tugas kode berskala besar mengonsumsi total 100,000 token input biasa, 300,000 token cache hit, dan 30,000 token output, yang setara dengan nilai kredit referensi sekitar 0.1 × ¥4.40 + 0.3 × ¥1.10 + 0.03 × ¥15.40 ≈ ¥1.232. Cache hit menempati porsi terbesar dari input—inilah bentuk khas tugas Agent—dan hal ini juga menunjukkan bahwa tarif cache sangat memengaruhi total biaya pada skenario pemrograman.
3 Mengganti Harness, bisakah lebih mendekati Astra + Codex? (Jalur B)
3.1 OpenCode: fokus pada kebebasan multi-model
OpenCode adalah AI Coding Agent sumber terbuka yang mendukung banyak LLM Provider: gunakan /connect untuk menambahkan penyedia layanan, gunakan /models untuk mengganti model, mendukung Base URL kustom dan model lokal, dapat digunakan di terminal, desktop, dan sebagian lingkungan pengembangan, serta memiliki kemampuan pencarian file, pengeditan, eksekusi perintah, dan alur kerja Agent. Alibaba Cloud telah menyediakan petunjuk integrasi resmi; pilih Alibaba Token Plan (China) untuk menggunakan paket Bailian.
Panduan keamanan resmi OpenCode patut diperhatikan dengan serius: Agent lokal bawaan tidak memiliki isolasi keamanan tingkat sistem, dan persetujuan izin tidak dapat menggantikan container atau mesin virtual. Saat menjalankan kode yang tidak tepercaya atau tugas otomasi dengan hak akses tinggi, jalankan di dalam Docker atau mesin virtual.
3.2 Qwen Code, Kimi Code, dan DeepSeek Harness
Ketiga Harness native ini masing-masing melayani ekosistem modelnya sendiri:
- Qwen Code: Alibaba Cloud menyediakan tiga bentuk—CLI, desktop, dan IDE. Masuk ke Bailian, pilih region, masukkan kunci API, lalu terhubung; tersedia pencarian basis kode, pengeditan file, dan eksekusi perintah. Tim yang terutama menggunakan model Qwen dan ingin mengurangi penyesuaian protokol sebaiknya memprioritaskannya.
- Kimi Code CLI: alat pengodean terminal yang dikelola Moonshot AI, mendukung pembacaan dan pengubahan kode, pemanggilan Shell, pengambilan konten web, pemulihan sesi, mode perencanaan dan persetujuan, integrasi editor, serta dapat mengonfigurasi model kompatibel pihak ketiga. Di Windows, instal melalui skrip PowerShell resmi dan bergantung pada Git Bash dari Git for Windows; Kimi CLI versi lama telah berhenti dirawat pada September 2026, pengguna baru sebaiknya langsung menggunakan Kimi Code CLI.
- DeepSeek Harness: kerangka Agent sumber terbuka yang menyediakan Web UI dan CLI sekaligus, mendukung kustomisasi Provider dan konfigurasi alat, serta dapat terhubung ke berbagai skema penagihan Bailian. Jalankan dengan
npx @deepseek-ai/dsh web; alamat defaultnyahttp://127.0.0.1:3080. Saat memilihnya, fokuslah menilai stabilitas eksekusi alat, kontrol izin, dan kecocokan dengan protokol model target.
3.3 Mengapa Harness memengaruhi performa model
Model yang sama dimasukkan ke Harness yang berbeda dapat menghasilkan perbedaan besar; alasannya, Harness menentukan “apa yang dilihat model, apa yang dapat dilakukannya, dan apa yang terjadi setelah ia salah”:
- Strategi pembacaan kode: berapa banyak file yang dibaca sekaligus dan dalam urutan apa pencarian dilakukan menentukan apakah pemahaman model terhadap proyek lengkap.
- Desain siklus alat: bagaimana hasil alat dikembalikan dan apakah percobaan ulang otomatis dilakukan setelah gagal menentukan apakah tugas panjang dapat diselesaikan.
- Kompresi konteks: sejarah mana yang dipertahankan dan detail mana yang dibuang dalam sesi panjang secara langsung memengaruhi apakah model “lupa tujuan”.
- Patch dan pengujian: apakah menggunakan penimpaan seluruh file atau patch diff, dan apakah pengujian dijalankan secara default setelah perubahan, menentukan akurasi perubahan dan risiko regresi.
Jadi, hasil yang diukur pada Jalur B adalah hasil kombinasi “model + Harness tersebut”. Saat membandingkannya dengan Jalur A, ingatlah bahwa strategi eksekusi kedua sisi memang sudah berbeda sejak awal.
4 Model domestik apa saja yang layak diuji?
4.1 Qwen4-Max-Preview
Dari spesifikasi publiknya, konteks 1M, anggaran bersama untuk proses berpikir dan output sebesar 393,216 Token, pemanggilan alat, dan output terstruktur membuatnya cocok untuk menguji pengodean kompleks, analisis konteks panjang, dan alur kerja Agent multi-putaran. Model ini juga kompatibel dengan Responses dan Anthropic Messages, sehingga dapat diintegrasikan dengan Codex maupun alat sejenis Claude Code.
Jendela waktu menjadi batasan utama dalam memilihnya: versi preview berakhir dan dihentikan pada 2026-11-25 pukul 24:00. Cara yang disarankan adalah menjalankan seluruh rangkaian tugas pengujian dengan model ini selama periode tersebut, menjadikan hasilnya sebagai acuan untuk model Qwen versi resmi berikutnya, serta mengonfigurasi model alternatif yang tersedia dalam jangka panjang di lingkungan produksi.
4.2 GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3
Keempat seri ini berada dalam satu paket TokenHub, sehingga mengalokasikannya berdasarkan jenis tugas adalah cara paling praktis:
- Logika kompleks dan modifikasi multi-file: GLM-5.3, Kimi K3, dan DeepSeek V4-Pro sebagai kelompok pembanding berkemampuan tinggi. Harga output Kimi K3 adalah yang tertinggi dalam tabel, sehingga cocok ditempatkan pada tugas tersulit untuk menguji batas atas.
- Tugas berorientasi kode: Kimi K2.7 Code secara khusus menjadi pembanding untuk skenario modifikasi kode, dan dapat dipadukan dengan Kimi Code CLI untuk menguji pengalaman aslinya.
- Tugas berfrekuensi tinggi dengan biaya rendah: GLM-5.3-Flash dan DeepSeek V4-Flash digunakan untuk skenario yang sensitif terhadap biaya dan kecepatan, seperti pemeriksaan kode dan refactoring massal.
- Stabilitas konteks panjang dan akurasi pemanggilan alat: MiniMax M3 dimasukkan sebagai kandidat; perhatikan bahwa harga naik di atas ambang input 512K.
4.3 Bagaimana menentukan mana yang paling mendekati Astra
Panjang konteks, jumlah parameter, positioning promosi, dan harga satuan Token tidak dapat menghasilkan peringkat yang andal untuk model-model ini; skor benchmark promosi dari sumber yang berbeda juga sulit dibandingkan. Untuk menentukan “mana yang paling mendekati Astra + Codex”, satu-satunya cara yang andal adalah mencatat secara seragam tingkat keberhasilan tugas, waktu eksekusi, biaya Token, kompatibilitas alat, dan jumlah intervensi manual pada Harness yang sama dan kumpulan tugas yang sama; metode spesifiknya lihat Bagian 6.
5 Tiga jalur reproduksi, bagaimana sebaiknya memilihnya?
5.1 Ingin pengalaman operasi Codex versi asli: pilih Jalur A
Pertahankan Codex Harness, lalu sambungkan ke layanan domestik yang secara resmi mendukung protokol Responses. Jika model utama adalah Qwen, pilih Bailian; jika ingin berpindah-pindah di antara beberapa model buatan dalam negeri, pilih TokenHub. Keunggulannya adalah biaya belajar dan migrasi yang rendah, karena operasi file dan sistem eksekusi Agent masih versi asli. Komprominya adalah kemampuan intelektual model yang berbeda dari Astra, tingkat implementasi antarmuka yang kompatibel akan memengaruhi pengalaman pemanggilan alat (tool call), dan parameter konteks serta penalaran tiap model perlu disesuaikan satu per satu.
5.2 Ingin model buatan dalam negeri dan kebebasan multi-model: pilih Jalur B
OpenCode dipadukan dengan API multi-model domestik, dan bila perlu tambahkan Qwen Code, Kimi Code, atau DeepSeek Harness. Jalur ini paling cocok untuk pengembang yang sejak awal memakai banyak model dan tidak ingin terikat pada satu vendor, sekaligus paling mudah untuk membandingkan performa berbagai model dalam menangani tugas yang sama secara berdampingan. Harganya adalah strategi eksekusi yang berbeda dari Codex, serta pekerjaan konfigurasi dan pemeliharaan tambahan akibat integrasi multi-Provider.
5.3 Ingin mempertahankan kemampuan Astra semaksimal mungkin: pilih Jalur C
Kombinasi Jalur C adalah “Codex CLI versi asli + GPT-6 Astra + layanan akses API yang tersedia”. Selama kanal tersebut benar-benar menyediakan GPT-6 Astra versi asli dan mendukung penuh Responses API, event streaming, pemanggilan alat, serta manajemen konteks yang dibutuhkan Codex, dua komponen inti—model dan Harness—bisa dipertahankan sekaligus. Jalur ini menyelesaikan masalah ketersediaan jaringan, dan itu adalah hal yang berbeda dari penggantian dengan model buatan dalam negeri.
Mengambil APIYI sebagai contoh, cara integrasinya persis sama dengan Jalur A, hanya perlu mengganti satu set konfigurasi Provider:
model_provider = "APIYI"
model = "gpt-6-astra"            # Sesuaikan dengan ID model yang benar-benar tercantum di konsol APIYI
model_reasoning_effort = "high"  # Sesuaikan antara low ~ max sesuai tingkat kesulitan tugas

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Sebelum integrasi, sebaiknya gunakan skrip singkat untuk memastikan kanal benar-benar mendukung protokol Responses dan pemanggilan alat, bukan hanya dapat mengembalikan teks biasa:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # Ganti dengan ID model yang tersedia di konsol
    reasoning={"effort": "medium"},
    input="Baca src/app.py dan beri tahu saya nama fungsi entry point",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "Membaca isi file di dalam proyek",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# Dalam kondisi normal harus mengembalikan item output bertipe function_call, dengan parameter terstruktur
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # Periksa apakah Token input, output, cache, dan penalaran dihitung secara terpisah
Probe ini mencakup tiga hal yang paling diandalkan Codex: protokol Responses, pengembalian Function Calling, dan statistik penggunaan secara terperinci. Setelah skrip lolos, barulah integrasikan ke Codex, jalankan tugas lengkap yang mencakup “mengubah kode + menjalankan tes”, dan pastikan event streaming serta siklus alat multi-putaran berjalan normal.
Meskipun modelnya sama, pengalaman Jalur C tetap dipengaruhi oleh routing model yang sebenarnya, tingkat penalaran, latensi API dan throughput output, hit cache, kompatibilitas protokol gateway, serta biaya kanal. Codex desktop, tugas cloud, dan fitur eksklusif akun ChatGPT bergantung pada sistem otorisasi OpenAI sendiri; saat menggunakan kunci API, yang dipakai adalah kombinasi Codex CLI dengan API model, sehingga dalam perencanaan bagian fitur tersebut sebaiknya dikecualikan.
🚀 Saran cepat untuk memulai: Ingin membandingkan rute A dan rute C secara berdampingan? Daftar di APIYI apiyi.com dan ambil kuota uji gratis, lalu jalankan model dalam negeri dan model seri GPT di lingkungan Codex yang sama. Untuk ketersediaan model spesifik dan dukungan protokol di APIYI, lihat konsol dan dokumentasi docs.apiyi.com sebagai acuan.
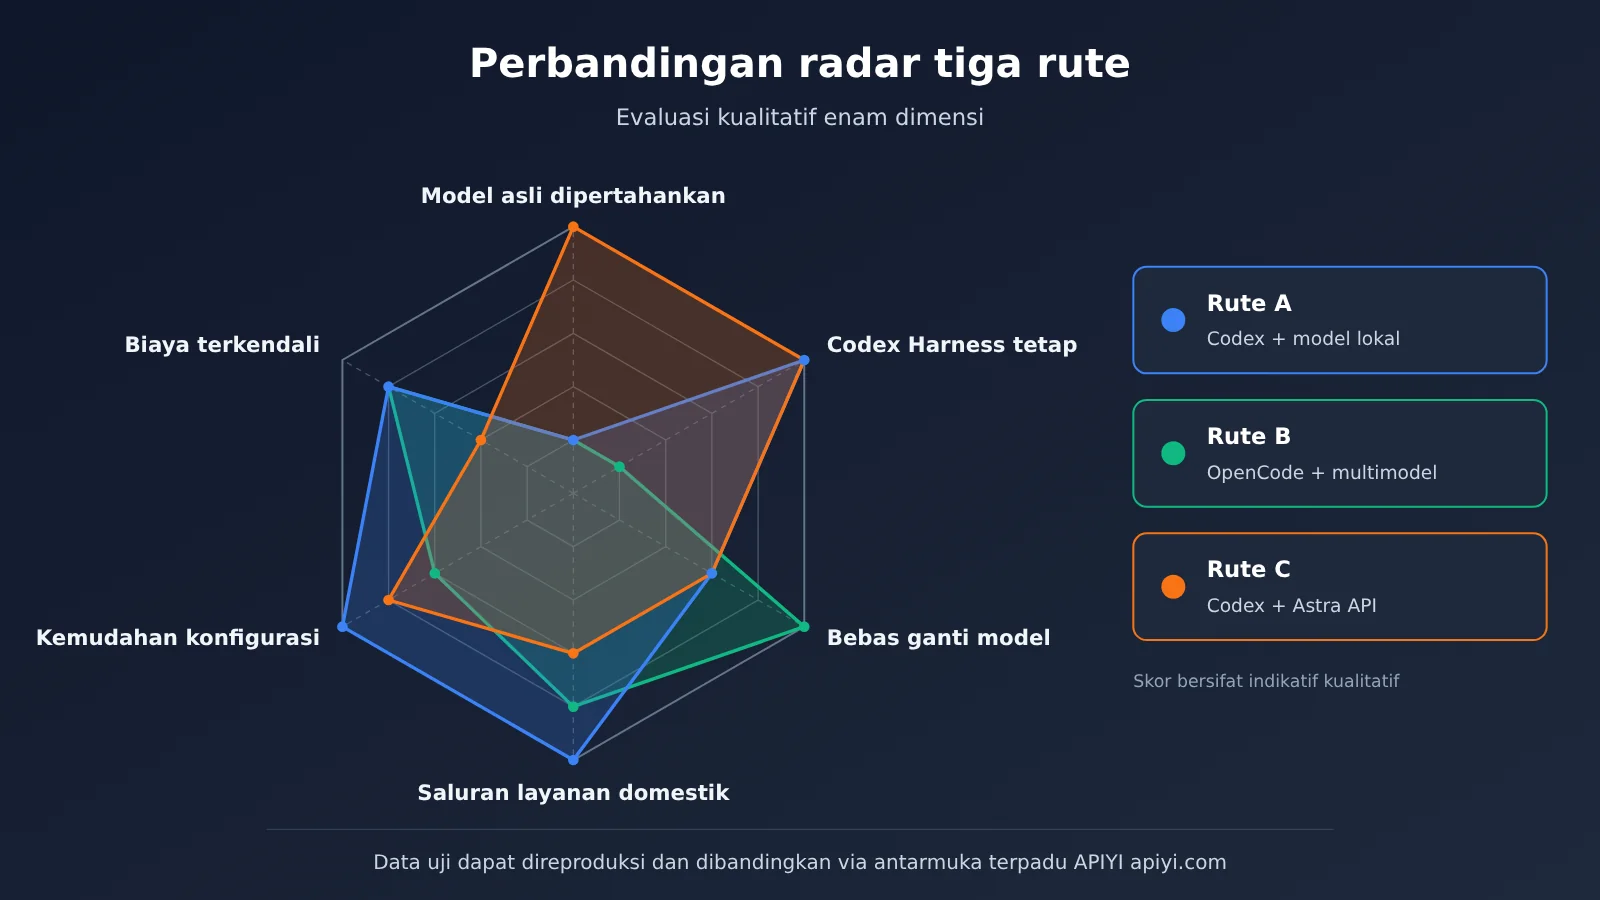
Ringkasan pilihan dari ketiga rute adalah sebagai berikut:
| Dimensi perbandingan | Rute A: Codex + model dalam negeri | Rute B: OpenCode dll. + multi-model domestik | Rute C: Codex + Astra API |
|---|---|---|---|
| Mempertahankan model asli | Tidak, diganti dengan Qwen / GLM / Kimi dll. | Tidak | Ya (dengan syarat saluran dapat diverifikasi) |
| Mempertahankan Codex Harness | Ya | Tidak, diganti dengan Harness terbuka | Ya |
| Pergantian model | Ubah model ID di platform yang sama | Bebas berganti antar Provider | Berganti antar model yang didukung saluran |
| Saluran layanan domestik | Alibaba Cloud Bailian, Tencent Cloud TokenHub | Bailian, TokenHub, dan layanan kompatibel lainnya | Saluran pihak ketiga yang mendukung Responses, seperti APIYI apiyi.com |
| Kompleksitas konfigurasi | Rendah, konfigurasi siap pakai dari pihak resmi | Sedang, perlu memelihara beberapa Provider | Rendah, dengan syarat protokol diverifikasi lebih dulu |
| Bentuk biaya | Paket bulanan (Credits / poin) | Paket atau bayar per penggunaan, tergantung Provider | Bayar per penggunaan, harga satuan Astra lebih tinggi daripada kebanyakan model dalam negeri |
| Cocok untuk kebutuhan | Pengalaman Codex asli + model dalam negeri | Alur kerja multi-model jangka panjang | Mempertahankan kemampuan asli semaksimal mungkin |
5.4 Batasan jaringan dan keamanan saat digunakan di dalam negeri
API model yang memakai alamat yang dapat diakses dari dalam negeri hanya menyelesaikan satu bagian rantai, yaitu pemanggilan model. Saat bekerja, Agent juga mengakses sumber perangkat lunak seperti GitHub, npm, dan PyPI, dokumentasi resmi eksternal, layanan MCP pihak ketiga, serta pencarian web — keterjangkauan rantai-rantai ini perlu dikonfirmasi secara terpisah. Pencarian online juga merupakan kemampuan tersendiri: pencarian bawaan penyedia cloud, alat online bawaan Harness, dan Search API / MCP yang dibangun sendiri masing-masing memiliki batasan akses, penagihan, dan pemanggilan.
Dari sisi keamanan, Agent pemrograman dapat mengubah file, menjalankan Shell, dan membaca variabel lingkungan. Sebaiknya lakukan hal-hal berikut:
- Simpan API Key di variabel lingkungan atau alat manajemen kredensial, jangan pernah menuliskannya ke kode sumber maupun repositori Git.
- Lakukan perubahan kompleks pada branch Git terpisah, dan pertahankan kontrol versi serta cadangan yang dapat dipulihkan pada proyek.
- Batasi akses Agent ke file sensitif di luar direktori kerja, dan tempatkan kode yang tidak tepercaya di dalam container atau mesin virtual.
- Pertahankan persetujuan manusia untuk operasi berisiko tinggi seperti penghapusan, deployment, dan pembayaran.
6 Pengujian tugas dunia nyata lebih bernilai daripada peringkat model
6.1 Menyiapkan lima jenis tugas pengujian
Dengan menggunakan proyek nyata yang mencakup frontend, backend, pengujian, dan konfigurasi dependensi, rancang lima jenis tugas untuk menguji kemampuan model dan kemampuan Harness secara terpisah:
- Pemahaman proyek: Meminta penjelasan arsitektur dan hubungan modul inti, amati lokasi file, pemahaman dependensi lintas file, serta apakah dapat memberikan referensi path yang dapat diverifikasi.
- Pengembangan lintas file: Menambahkan fitur baru yang perlu diubah di beberapa tempat, amati akurasi perubahan, kelengkapan fitur, dan apakah menimbulkan regresi.
- Perbaikan bug: Menyediakan proyek dengan pengujian gagal yang dapat direproduksi, amati apakah menemukan akar masalah, memperbaiki lokasi yang tepat, menjalankan pengujian secara proaktif, dan tidak merusak kasus uji lain.
- Alur kerja Agent jangka panjang: Menyelesaikan rangkaian berkelanjutan “pemahaman kebutuhan → perubahan kode → menjalankan pengujian → menemukan kegagalan → perbaikan → verifikasi ulang”, amati apakah tujuan tetap terjaga dan apakah strategi dapat disesuaikan berdasarkan error.
- Penelusuran dokumentasi secara online: Setelah membaca dokumentasi SDK terbaru, migrasikan sebagian kode API lama, amati apakah benar-benar dapat mengambil isi halaman secara online, apakah API baru diterapkan ke dalam kode, dan apakah dapat membedakan “alat tidak tersedia” dengan “hasil pencarian kosong”.
6.2 Mencatat tingkat keberhasilan, waktu, dan biaya
Setiap kombinasi “model + Harness” menjalankan rangkaian tugas yang sama, diulang setidaknya tiga kali dan diambil rata-rata, serta mencatat metrik berikut secara seragam:
| Metrik | Cara penghitungan atau pengamatan |
|---|---|
| Tingkat keberhasilan tugas | Jumlah tugas yang berhasil diselesaikan / total tugas |
| Tingkat lolos percobaan pertama | Proporsi keberhasilan dalam sekali percobaan tanpa koreksi manual |
| Total waktu penyelesaian tugas | Dari tugas dikirim hingga verifikasi akhir berhasil |
| Jumlah pemanggilan model | Jumlah kumulatif permintaan API per tugas |
| Jumlah pemanggilan alat | Jumlah pemanggilan untuk membaca, mengedit, Shell, mencari, dan sebagainya |
| Penggunaan Token | Rincian input, output, hit cache, dan penggunaan reasoning |
| Biaya tugas aktual | Biaya nyata untuk menyelesaikan satu tugas berhasil |
| Jumlah intervensi manual | Jumlah penyesuaian dan perbaikan manual oleh pengguna |
Agar eksperimen dapat direproduksi, tetapkan variabel berikut: snapshot repositori kode yang sama, versi Harness yang sama, tingkat penalaran atau pengaturan thinking yang sama, periode waktu yang sama (terutama penting untuk model dengan penagihan puncak/non-puncak seperti DeepSeek). Sebelum setiap tugas dimulai, reset repositori ke snapshot agar perubahan dari putaran sebelumnya tidak memengaruhi putaran berikutnya.
6.3 Menjadikan biaya satu tugas berhasil sebagai indikator pengadaan utama
Cara penghitungan yang disarankan adalah: Biaya per tugas berhasil = total biaya seluruh percobaan ÷ jumlah tugas berhasil. Biaya dari percobaan yang gagal harus dimasukkan karena juga mengonsumsi kuota.
Model dengan harga satuan rendah belum tentu lebih murah. Jika sebuah model memerlukan lebih banyak putaran penalaran, revisi berulang, dan percobaan ulang, atau sering membutuhkan intervensi manual, total konsumsi untuk menyelesaikan satu tugas bisa melebihi model dengan harga satuan lebih tinggi yang mampu melakukannya dengan benar dalam sekali percobaan. Sebaliknya, pada tugas sederhana dan berfrekuensi tinggi, harga satuan rendah dan kecepatan tinggi model kelas Flash sering kali memberikan penghematan nyata. Dengan menghitung biaya per “setiap tugas berhasil”, kedua jenis model baru dapat dibandingkan secara setara.
💰 Saran evaluasi biaya: Kanal dengan penagihan berdasarkan pemakaian paling memudahkan eksperimen semacam ini, karena rincian Token dan biaya setiap permintaan dapat diperiksa per transaksi. Dengan menggunakan APIYI apiyi.com untuk memanggil beberapa model dengan satu Key, tagihan berbagai model dapat dihitung di backend yang sama untuk biaya per tugas berhasil.
7 Skenario APIYI: Menjadikan Model sebagai Komponen yang Dapat Diganti
Analisis di atas mengarah pada satu kesimpulan yang sama: lingkungan pemrograman AI yang stabil seharusnya menetapkan Harness secara tetap dan memperlakukan model sebagai komponen yang dapat diganti. Codex atau OpenCode bertugas menangani eksekusi dan manajemen status, saluran API menyediakan model, dan model dapat diganti secara fleksibel sesuai tingkat kesulitan tugas serta anggaran.
APIYI apiyi.com dalam arsitektur ini berperan sebagai lapisan akses terpadu: satu kunci API untuk memanggil model-model utama seperti OpenAI, Claude, dan Gemini, dengan antarmuka yang kompatibel dengan protokol OpenAI serta penagihan berdasarkan pemakaian. Bagi pengguna yang berkecimpung di bidang pemrograman, sebelum memilih saluran API mana pun (termasuk APIYI), sebaiknya periksa satu per satu poin berikut:
- Apakah mendukung Responses API dan peristiwa streaming yang dibutuhkan oleh versi Codex saat ini.
- ID model sebenarnya yang tercantum di konsol, serta apakah model target masih tersedia.
- Apakah pemanggilan alat dan Function Calling dapat berjalan penuh dua arah.
- Apakah latensi dan kecepatan output berkelanjutan memenuhi kebutuhan tugas panjang.
- Apakah penggunaan cache dikenali dengan benar dan ditagih secara terpisah.
Informasi ini mengacu pada konsol layanan dan dokumentasi teknis; skrip deteksi di Bagian 5.3 dapat langsung digunakan untuk memverifikasinya. Dalam praktiknya, pendekatan yang umum adalah menggunakan paket langganan bulanan dari jalur A untuk tugas harian berfrekuensi tinggi, dan menggunakan saluran berbasis pemakaian untuk soal-soal sulit yang membutuhkan model lebih kuat serta pengujian perbandingan. Kedua Provider dituliskan dalam satu config.toml yang sama, lalu beralih dengan --profile atau mengubah model_provider.
8 Pertanyaan yang Sering Diajukan
Q1:Untuk mereproduksi Astra + Codex di dalam negeri, jalur mana yang tingkat fidelitasnya paling tinggi?
Yang paling mendekati versi asli adalah jalur C: Codex CLI versi asli yang dipasangkan dengan API GPT-6 Astra yang benar-benar berfungsi, sehingga kedua komponen inti—model dan Harness—tetap dipertahankan. Syaratnya, kanal tersebut dapat diverifikasi menyediakan model versi asli dan mendukung penuh protokol Responses serta pemanggilan tool. Jika model diharuskan buatan dalam negeri, jalur A adalah pilihan terbaik untuk mereproduksi pengalaman eksekusi Codex.
Q2:Apakah Qwen4-Max-Preview cocok dipakai jangka panjang di Codex?
Model ini cocok untuk pengujian saat ini. Model tersebut hanya tersedia di Bailian Token Plan dan akan dihentikan setelah masa preview berakhir pada 25 November 2026 pukul 24:00. Sebaiknya selesaikan tugas pengujian selama masa preview, sekaligus siapkan model alternatif yang bisa dipakai jangka panjang untuk lingkungan produksi.
Q3:Mengapa Codex versi baru tidak bisa terhubung ke Coding Plan versi lama Alibaba Cloud?
Codex sejak versi 0.94.0 mewajibkan Responses API, sedangkan Coding Plan versi lama memakai protokol Chat Completions; pihak resmi mewajibkan penggunaan Codex 0.93.0 atau versi lebih lama. Beralih ke Token Plan dan setel `wire_api = “responses”` agar bisa terhubung ke Codex versi baru. Perhatikan bahwa Token Plan memakai kunci API tersendiri.
Q4:Apakah Credits Bailian dan poin TokenHub bisa dibandingkan secara langsung?
Tidak bisa dibandingkan langsung. Keduanya merupakan satuan pengukuran masing-masing platform, dan laju pemotongan antar model juga berbeda. Cara yang lebih andal adalah menjalankan tugas yang sama di kedua sisi, lalu membandingkan “proporsi kuota paket yang terpakai untuk menyelesaikan satu tugas sukses terhadap biaya bulanan”.
Q5:Bagaimana cara cepat memverifikasi apakah kanal pihak ketiga bisa menjalankan Codex?
Pertama, kirim satu permintaan Responses dengan tool function memakai skrip Python di bagian 5.3, pastikan keluaran `function_call` dikembalikan dan statistik rincian penggunaan normal, lalu hubungkan ke Codex dan jalankan tugas lengkap yang menyertakan pengujian. Setelah mendaftar di APIYI apiyi.com, Anda bisa klaim kuota uji gratis untuk menyelesaikan langkah verifikasi ini; model yang tersedia mengikuti yang tertera di konsol.
Q6:Apakah normal jika model yang sama berperilaku berbeda di OpenCode dan Codex?
Normal. Harness menentukan strategi pembacaan kode, siklus tool, kompresi konteks, dan kebiasaan pengujian, yang semuanya mengubah performa aktual model. Saat membandingkan, tetapkan Harness tetap untuk menguji model, atau tetapkan model tetap untuk menguji Harness, agar dua variabel tidak berubah sekaligus.
Q7:Jika memakai Codex lewat kunci API, apakah saya bisa mendapatkan fitur Codex yang ada di langganan ChatGPT?
Metode kunci API menyediakan kombinasi Codex CLI plus API model. Tugas cloud Codex, aplikasi desktop, dan fitur khusus akun ChatGPT bergantung pada otorisasi akun OpenAI; kanal API pihak ketiga tidak dapat menyediakan hak tersebut.
Q8:Saat berganti-ganti antar model, bagaimana cara mengendalikan total biaya?
Lapisan berdasarkan tugas: gunakan model berkapabilitas tinggi untuk masalah sulit, serahkan pemeriksaan massal dan refaktor sederhana ke model kelas Flash, dan untuk model yang mendukung tarif puncak/off-peak, jadwalkan tugas asinkron pada malam hari. Evaluasi secara seragam memakai “biaya per tugas sukses”; kanal berbasis pemakaian seperti APIYI apiyi.com memudahkan pengecekan konsumsi aktual setiap model transaksi demi transaksi.
9 Ringkasan: Key Takeaways
- Tiga rute, tiga penekanan: Rute A mempertahankan pengalaman Codex, Rute B mempertahankan kebebasan model, Rute C mempertahankan model asli.
- Astra + Codex adalah kombinasi lima lapisan: model, sistem eksekusi, ekosistem alat, manajemen status, dan pengalaman penggunaan bersama-sama menentukan hasil.
- Rute A punya konfigurasi siap pakai: Bailian dan TokenHub sama-sama menyediakan konfigurasi Codex resmi, intinya adalah
wire_api = "responses". - Qwen4-Max-Preview punya tanggal batas: Hanya untuk Token Plan, pratinjau berakhir dan dihentikan pada 2026-11-25 24:00.
- Unit paket tidak bisa dibandingkan secara campur: Credits, poin, Token, dan yuan termasuk sistem pengukuran yang berbeda; hanya perbandingan berdasarkan pengujian nyata per tugas yang bisa dilakukan.
- Biarkan tugas yang berbicara: lima jenis tugas nyata, delapan indikator, dengan biaya per tugas sukses sebagai dasar pengadaan.
- Jadikan model sebagai komponen yang bisa diganti: Harness tetap, saluran akses terpadu, ganti model sesuai tugas, barulah lingkungan stabil dan terkendali.
Cara memulai paling praktis adalah mengonfigurasi dua Provider dalam lingkungan Codex yang sama: satu paket cloud domestik untuk menangani tugas sehari-hari, satu saluran bayar sesuai penggunaan untuk menangani pengujian pembanding dan tugas sulit; jalankan satu putaran dengan metode di Bagian 6, lalu tentukan kombinasi jangka panjang. Disarankan membangun kelompok pembanding dengan cepat melalui APIYI apiyi.com, menggunakan antarmuka terpadu untuk memverifikasi model domestik dan seri GPT pada rangkaian tugas yang sama.
📚 Referensi
- Dokumentasi Model Resmi GPT-6 Astra: spesifikasi model, tingkat penalaran, dan harga
- Tautan:
developers.openai.com/api/docs/models/gpt-6-astra -
Keterangan: jendela konteks, output maksimum, dukungan tool, dan tarif konteks panjang
-
OpenAI Codex Harness: desain framework eksekusi Codex
- Tautan:
developers.openai.com/blog/codex-as-a-platform -
Keterangan: penjelasan resmi tentang loop Agent, pengembalian hasil tool, manajemen konteks, dan sandbox
-
Integrasi Codex di Alibaba Cloud Bailian: cara konfigurasi Token Plan
- Tautan:
help.aliyun.com/zh/model-studio/codex -
Keterangan: field config.toml, protokol Responses, dan persyaratan versi
-
Token Plan Alibaba Cloud Edisi Personal: harga paket dan Credits
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
Keterangan: tingkat paket, kuota, dan diskon pembelian pertama setelah penyesuaian 2026-11-09
-
Dokumentasi Resmi Qwen4-Max-Preview: spesifikasi model dan periode pratinjau
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max-preview -
Keterangan: konteks 1M, kompatibilitas protokol, dan waktu penghentian layanan
-
Konfigurasi Codex CLI Tencent Cloud TokenHub: tutorial integrasi resmi
- Tautan:
cloud.tencent.cn/document/product/1823/130071 -
Keterangan: konfigurasi Provider dan cara mengganti model ID
-
Paket dan Tarif Poin Tencent Cloud TokenHub: aturan penagihan
- Tautan:
cloud.tencent.cn/document/product/1823/130060 - Tautan:
cloud.tencent.com/document/product/1823/133811 -
Keterangan: tingkat paket, tarif poin model, dan penagihan jam sibuk/jam sepi
-
Repositori Resmi OpenCode: Coding Agent sumber terbuka
- Tautan:
github.com/anomalyco/opencode -
Keterangan: konfigurasi Provider dan catatan keamanan
-
Qwen Code, Kimi Code CLI, DeepSeek Harness: Harness native
- Tautan:
help.aliyun.com/zh/model-studio/qwen-code - Tautan:
github.com/MoonshotAI/kimi-code - Tautan:
help.aliyun.com/zh/model-studio/deepseek-harness - Keterangan: instalasi, integrasi, dan cakupan kemampuan
Penulis: Tim Teknologi APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs resmi APIYI. Untuk materi integrasi lainnya, kunjungi pusat dokumentasi docs.apiyi.com


