
Résumé : comparer les combinaisons disponibles en Chine sur trois couches — modèles, agents de programmation et canaux API — puis choisir sa solution de reproduction en s’appuyant sur des tâches de programmation réelles, le coût et la compatibilité.
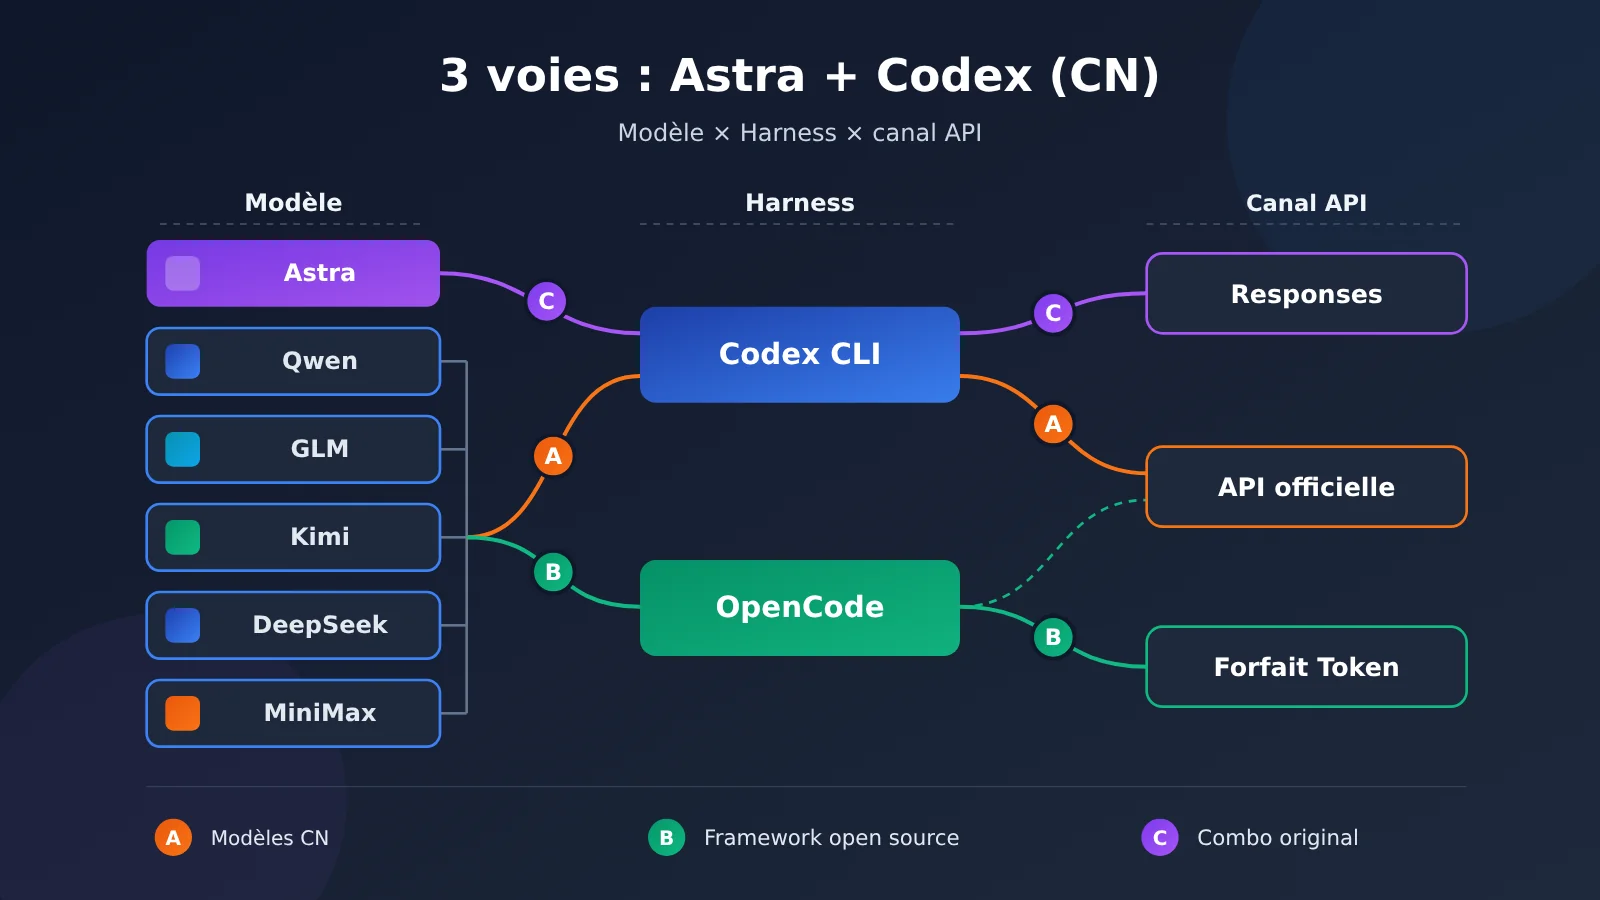
Trois voies méritent d’être testées pour reproduire Astra + Codex autant que possible en Chine. Voie A : conserver le Codex CLI original et brancher des modèles phares chinois via l’interface compatible Responses d’Alibaba Cloud Bailian ou de Tencent Cloud TokenHub, cette voie préserve l’expérience d’exécution de Codex. Voie B : passer à un Harness ouvert comme OpenCode pour intégrer plusieurs modèles chinois, cette voie offre la plus grande liberté de choix de modèle. Voie C : sous réserve de conformité légale et de disponibilité effective du service, conserver le modèle GPT-6 Astra et connecter le Codex original via un canal API prenant pleinement en charge le protocole Responses, cette voie offre la meilleure fidélité à la combinaison d’origine.
Si l’on exige des modèles chinois, la voie A est un point de départ ; Qwen4-Max-Preview n’est disponible que jusqu’au 25 novembre 2026 à 24:00, ce qui en fait une option d’évaluation plutôt qu’une dépendance unique à long terme. Si l’on souhaite seulement l’utiliser depuis le réseau chinois sans exiger des modèles chinois, la voie C est la plus proche de l’original en matière d’intelligence du modèle. Le choix final entre les trois voies doit dépendre du taux de réussite, du temps d’exécution, du coût et de la compatibilité des outils sur un même lot de tâches de programmation réelles, et non d’un classement ou du prix unitaire des tokens.
La suite décompose d’abord Astra + Codex en cinq composants de capacité, pour préciser ce que « reproduire » signifie réellement ; elle présente ensuite les deux configurations officielles de connexion et la comparaison des offres pour la voie A, les quatre Harness de la voie B, ainsi que les modèles chinois à tester en priorité ; puis un tableau récapitulatif rassemble les arbitrages entre les trois voies ; enfin, une méthode de test reproductible sur cinq types de tâches fait du « coût par tâche réussie » l’indicateur central du choix.
À savoir : notions préliminaires
| Terme | Explication |
|---|---|
| GPT-6 Astra | Le modèle de raisonnement phare d’OpenAI, positionné sur le raisonnement complexe, l’ingénierie logicielle et les tâches Agent de longue haleine ; son ID de modèle est gpt-6-astra. |
| Codex | L’agent de programmation d’OpenAI, capable de lire un projet, de modifier le code, d’exécuter des commandes et de vérifier les résultats. |
| Harness | Le cadre d’exécution qui relie les décisions du modèle aux outils réels ; il gère la boucle d’outils, le contexte, les permissions et la reprise après échec. |
| Responses API | Le protocole d’interface d’OpenAI qui prend en charge les sorties du modèle, le raisonnement et l’appel d’outils ; la nouvelle version de Codex s’appuie dessus pour fonctionner. |
| Chat Completions | Le protocole d’interface de conversation plus ancien d’OpenAI, utilisé par les anciennes versions de Codex. |
| Provider | Le fournisseur qui met des services de modèle à disposition des outils Agent ; dans le fichier de configuration, il se présente sous la forme d’un ensemble de paramètres de connexion. |
| Base URL | L’adresse d’accès de base de l’API du service de modèle ; c’est principalement elle que l’on modifie lorsqu’on change de canal. |
| Token Plan | La formule de facturation par abonnement mensuel proposée par les fournisseurs cloud, qui offre un quota d’invocations du modèle. |
| Credits / points | L’unité de mesure servant à déduire le quota d’invocations au sein d’une formule ; les unités des différents fournisseurs ne sont pas directement interchangeables. |
| Fenêtre de contexte | La limite de contenu qu’un modèle peut traiter en une seule requête, exprimée en Tokens. |
| Niveau de raisonnement | Le paramètre qui contrôle la profondeur de réflexion du modèle ; Astra propose cinq niveaux, de low à max. |
| Cache hit | Lorsque des entrées envoyées à plusieurs reprises sont réutilisées par le serveur, elles sont facturées à un tarif réduit. |
| MCP | Un protocole ouvert qui relie les applications de modèle aux outils externes et aux sources de données. |
| Function Calling | Le mécanisme par lequel le modèle émet une demande d’appel structurée, l’application exécute la fonction puis renvoie le résultat. |
| Facturation heures creuses / heures de pointe | Une tarification qui distingue les prix selon les plages horaires : les heures de pointe consomment davantage de quota. |
Texte principal
1 Où réside vraiment la force d’Astra + Codex ?
1.1 Qu’apporte Astra ?
GPT-6 Astra est le modèle de raisonnement phare d’OpenAI. Son positionnement officiel couvre le raisonnement complexe, l’ingénierie logicielle, les modifications de code en plusieurs étapes, les opérations dans le navigateur et sur l’ordinateur, l’analyse de recherche et la production de documents professionnels. Ce qu’il apporte à Codex, c’est le « jugement » : comprendre une base de code inconnue, concevoir un plan de modification, interpréter les erreurs et ajuster la stratégie.
Les spécifications officielles du modèle (informations vérifiées le 13 novembre 2026) sont les suivantes :
- Fenêtre de contexte : 1,050,000 tokens ; sortie maximale : 128,000 tokens.
- Niveaux de raisonnement : low, medium, high, xhigh, max.
- Tarifs standard (USD / million de tokens) : entrée $10, sortie $50, entrée mise en cache $1, écriture en cache de 30 minutes $12.50 ; au-delà de 272K tokens en entrée, un tarif de contexte long plus élevé s’applique.
- Outils de l’API Responses : Web Search, File Search, Hosted Shell, Apply Patch, Computer Use, MCP, etc.
Le dernier point demande une lecture à part : ces outils sont des capacités fournies par la plateforme OpenAI ; qu’un client ou une passerelle tierce puisse les utiliser dépend des outils qu’il intègre réellement.
1.2 Quelles tâches Codex prend-il en charge ?
Dans l’article « Codex Harness » publié par OpenAI en août 2026, le cœur de Codex est résumé ainsi : boucle d’agent, compréhension de la base de code et manipulation de fichiers, exécution de commandes, appels d’outils et renvoi des résultats, gestion du contexte sur plusieurs tours, approbation par l’utilisateur, limites de sécurité du bac à sable, ainsi qu’observation du déroulement de l’exécution et récupération après échec.
La répartition des rôles est claire : le modèle juge et génère, le Harness traduit les décisions du modèle en actions concrètes sur le système de fichiers et le terminal réels. Un modèle de chat très puissant ne peut accomplir la tâche de programmation complète « lire le projet → modifier le code → lancer les tests → corriger les échecs → revérifier » qu’avec ce système d’exécution.
1.3 Faut-il reproduire le modèle ou l’agent dans son ensemble ?
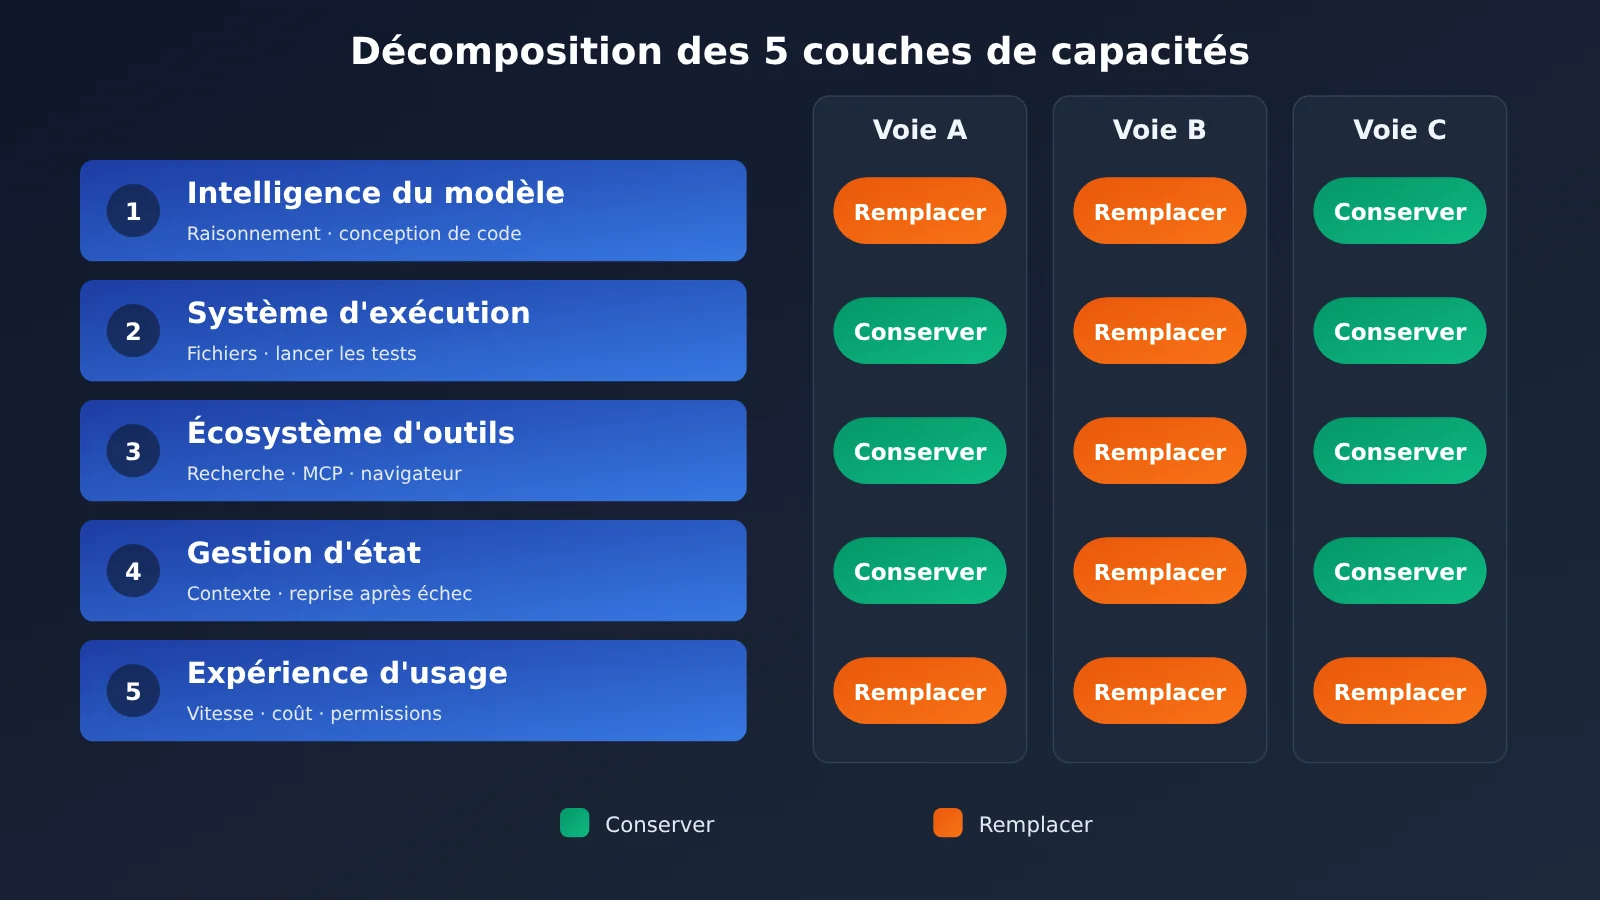
Si l’on décompose l’expérience originale, on obtient cinq composants :
- Intelligence du modèle : compréhension de tâches complexes, conception de code, raisonnement et débogage.
- Système d’exécution : lecture du projet, édition de fichiers, exécution de commandes, lancement des tests.
- Écosystème d’outils : recherche en ligne, lecture de pages web, MCP, traitement de fichiers, opérations dans le navigateur.
- Gestion d’état : contexte des tâches longues, boucle d’appels d’outils, récupération après échec.
- Expérience d’utilisation : vitesse de réponse, stabilité, coût, contrôle des permissions et facilité d’utilisation.
Changer de modèle modifie principalement le point 1, mais ce que l’utilisateur perçoit au final est la somme des cinq. C’est aussi la ligne de partage entre les trois voies : la voie A remplace le point 1 et conserve les points 2 et 4 ; la voie B remplace en même temps les points 1, 2 et 4 ; la voie C conserve autant que possible les points 1, 2 et 4, les différences se concentrant sur le point 5 et sur les détails de protocole propres au canal API.
2 Conserver Codex et brancher des modèles chinois (voie A)
2.1 Alibaba Cloud Bailian Token Plan + Codex
Alibaba Cloud a publié une documentation officielle pour intégrer Codex ; Token Plan fournit une interface compatible Responses, ce qui permet de connecter directement la nouvelle version de Codex. Dans ~/.codex/config.toml (sous Windows, généralement C:\Users\<nom d'utilisateur>\.codex\config.toml), ajoutez :
model_provider = "Token_Plan"
model = "auto"

[model_providers.Token_Plan]
name = "Token_Plan"
base_url = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
env_key = "OPENAI_API_KEY"
wire_api = "responses"
La variable d’environnement pointée par env_key doit contenir la clé API propre au forfait Token Plan. Lors de la configuration, quelques détails techniques sont faciles à rater :
- Version du protocole : depuis la version 0.94.0, Codex exige l’API Responses. L’ancien Coding Plan d’Alibaba Cloud utilise Chat Completions et doit, selon la documentation officielle, être associé à Codex 0.93.0 ou à une version antérieure ; pour un environnement maintenu sur le long terme, mieux vaut choisir Token Plan.
- Isolation des clés : Token Plan, Coding Plan et la facturation à l’usage reposent sur trois jeux de clés API différents.
- Région : Token Plan n’est actuellement disponible qu’en Chine du Nord 2 (Pékin).
- Métadonnées du modèle : un nouveau modèle doit avoir un ID et des métadonnées correctement configurés pour bénéficier d’un support complet dans l’interface de sélection de modèles de Codex.
Chez Bailian, le modèle le plus intéressant du moment est Qwen4-Max-Preview, mis en ligne le 11 novembre 2026 (ID de modèle qwen4-max-preview). La documentation officielle le présente comme le nouveau modèle phare multimodal : il prend en charge le développement de code, les tâches d’agents complexes, la compréhension d’images et de vidéos, ainsi que la réflexion approfondie (activée par défaut), l’appel d’outils, la recherche web et les sorties structurées. Il est compatible avec les trois protocoles OpenAI Chat Completions, Responses et Anthropic Messages. Sa fenêtre de contexte atteint 1 M de tokens, avec un budget de sortie maximal de 393 216 tokens, budget partagé entre la réflexion et la réponse finale.
Ses conditions d’utilisation sont tout aussi claires : il n’est actuellement proposé que dans Token Plan et n’est pas disponible à la facturation à l’usage ; la période de prévisualisation va du 11 novembre 2026 à 10h00 (heure de Pékin) au 25 novembre à 24h00, après quoi il sera retiré. À la date de rédaction de cet article, il reste moins de deux semaines pour le tester : c’est le moment de se lancer dans les évaluations, tout en prévoyant dès maintenant un modèle de remplacement pour la production.
2.2 Tencent Cloud TokenHub + Codex
Tencent Cloud propose un tutoriel officiel dédié à l’intégration de Codex CLI ; dans le même fichier de configuration, cela s’écrit ainsi :
model_provider = "Tencent_Cloud_Token_Plan"
model = "$model_id"

[model_providers.Tencent_Cloud_Token_Plan]
name = "Tencent_Cloud_Token_Plan"
base_url = "https://tokenhub.tencentmaas.com/plan/v3"
env_key = "Token_Plan_API_KEY"
wire_api = "responses"
$model_id doit être remplacé par l’ID de modèle exact pris en charge par le forfait. Le catalogue de modèles de TokenHub comprend GLM-5.3, Kimi K3, la série DeepSeek V4, MiniMax M3, la série Hy de Tencent Hunyuan, ainsi que certains modèles légers et à routage automatique ; le même forfait prend aussi en charge des outils comme Claude Code, Cline et OpenClaw.
L’avantage de TokenHub, c’est « une seule configuration Codex, plusieurs modèles chinois » : il suffit de changer la ligne model pour faire tourner successivement GLM, Kimi, DeepSeek et MiniMax sur le même harness, ce qui est idéal pour des comparaisons croisées. Le catalogue de modèles, les versions et les politiques de quota évoluent en permanence : avant chaque test, fiez-vous aux ID de modèles listés dans la console.
2.3 Quelles différences entre les deux forfaits
Les deux offres portent le même nom, Token Plan, mais leurs unités de mesure diffèrent : Bailian utilise des Credits, TokenHub des 积分, et l’on ne peut pas passer directement de l’un à l’autre. Les données ci-dessous sont datées du 2026-11-13 et les prix sont exprimés en RMB par mois :
| Critère de comparaison | Alibaba Cloud Bailian Token Plan (version personnelle) | Tencent Cloud TokenHub Token Plan universel (version personnelle) |
|---|---|---|
| Niveaux et tarif mensuel | Lite ¥39, Essential ¥79, Standard ¥139, Pro ¥312 | Lite ¥39, Standard ¥99, Pro ¥299, Max ¥599 |
| Quota mensuel | 20,000 / 45,000 / 80,000 / 200,000 Credits | 780 / 1,980 / 5,980 / 11,980 积分 |
| Agents concurrents recommandés | 1—2 / 2—3 / 3—4 / 6—8 | La documentation ne donne pas d’indicateur équivalent |
| Promotions et avantages | Lite et Essential : premier achat à ¥19.5 et ¥39.5 pour les nouveaux utilisateurs (jusqu’au 2026-11-30) ; Standard et Pro incluent l’avantage AgentStudio Harness | Taux de déduction promotionnel à durée limitée sur certains modèles ; achat de 积分 : référence ¥1 = 20 积分 |
| Protocole d’accès Codex | Responses (wire_api = "responses") |
Responses (wire_api = "responses") |
| Modèles représentatifs | Série Qwen, dont Qwen4-Max-Preview réservé au Token Plan | GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3, Hunyuan Hy |
| Mode de facturation | Déduction en Credits selon le modèle | Déduction en 积分 depuis le 2026-08-31, avec des taux différents selon le modèle |
| Limites d’utilisation | Uniquement Chine du Nord 2 (Pékin) ; les forfaits de programmation interactive ne doivent pas être utilisés tels quels pour automatiser un backend commercial quelconque | Le catalogue de modèles et les promotions peuvent évoluer |
Pour comparer ces deux forfaits, le classement par prix mensuel n’a pas grand intérêt. L’essentiel est de répondre à la question : « pour le modèle que je veux utiliser, combien d’unités me coûte chaque tâche terminée dans ce forfait ? ». La valeur de Bailian se concentre sur l’écosystème Qwen et sur Qwen4-Max-Preview, actuellement exclusif ; celle de TokenHub vient du fait que plusieurs modèles chinois se partagent un même quota.
TokenHub publie les taux de déduction en 积分 de chaque modèle. Voici quelques tarifs promotionnels à durée limitée relevés le 2026-11-13, convertis en RMB par million de tokens sur la base de ¥1 = 20 积分 :
| Modèle | Entrée normale | Sortie | Entrée avec cache touché | Remarques |
|---|---|---|---|---|
| GLM-5.3 | ¥4.40 | ¥15.40 | ¥1.10 | Retour au tarif catalogue à la fin de la promotion |
| GLM-5.3-Flash | ¥0.56 | ¥1.96 | ¥0.161 | Scénarios sensibles à la vitesse et au coût |
| Kimi K3 | ¥15.00 | ¥75.00 | ¥1.50 | Retour au tarif catalogue à la fin de la promotion |
| Kimi K2.7 Code | ¥5.20 | ¥21.60 | ¥1.04 | Modèle spécialisé pour le code |
| DeepSeek V4.1 Flash (heures creuses) | ¥0.40 | ¥1.60 | ¥0.008 | Tarification heures pleines / heures creuses |
| DeepSeek V4.1 Flash (heures pleines) | ¥0.80 | ¥3.20 | ¥0.016 | Jours ouvrés 09:00—12:00, 14:00—18:00 |
| MiniMax M3 | ¥2.10 | ¥8.40 | ¥0.42 | Prix pour une entrée ≤ 512K tokens |
Il faut garder deux points à l’esprit pour lire ce tableau. Premièrement, l’abonnement mensuel est facturé au prix mensuel du forfait ; les montants indiqués dans le tableau correspondent à la valeur de référence des crédits, destinée à comparer le rythme de consommation d’un modèle à l’autre. Deuxièmement, la facturation en heures pleines et heures creuses de DeepSeek entrera en vigueur le 30 octobre 2026 : la consommation en heures pleines sera environ le double de celle en heures creuses. Exécuter la nuit, par lots, des tâches asynchrones comme les vérifications de code ou l’analyse de tests permet donc d’économiser nettement du quota.
Faisons le calcul avec GLM-5.3 : une tâche de code volumineuse consomme au total 100 000 tokens d’entrée standard, 300 000 tokens servis depuis le cache et 30 000 tokens de sortie, soit une valeur de référence en crédits de 0,1 × 4,40 ¥ + 0,3 × 1,10 ¥ + 0,03 × 15,40 ¥ ≈ 1,232 ¥. La part servie depuis le cache représente l’essentiel de l’entrée : c’est exactement la forme typique d’une tâche d’agent, et cela montre aussi que le tarif du cache pèse fortement sur le coût total dans les scénarios de programmation.
3 Changer de Harness permet-il de se rapprocher d’Astra + Codex ? (voie B)
3.1 OpenCode : la liberté de choix entre plusieurs modèles
OpenCode est un agent de codage IA open source qui prend en charge de nombreux fournisseurs de LLM : on ajoute un fournisseur avec /connect, on change de modèle avec /models, et on peut définir une URL de base personnalisée ou utiliser des modèles locaux. Il fonctionne dans le terminal, en application de bureau et dans certains environnements de développement, avec recherche de fichiers, modification, exécution de commandes et workflows d’agent. Alibaba Cloud propose une documentation d’intégration officielle : il suffit de choisir Alibaba Token Plan (China) pour utiliser l’offre Bailian.
La documentation de sécurité officielle d’OpenCode mérite d’être prise au sérieux : par défaut, l’agent local ne bénéficie pas d’une isolation de sécurité au niveau système, et l’approbation des autorisations ne peut pas remplacer un conteneur ou une machine virtuelle. Pour exécuter du code non fiable ou des tâches d’automatisation à privilèges élevés, il faut passer par Docker ou une machine virtuelle.
3.2 Qwen Code, Kimi Code et DeepSeek Harness
Ces trois Harness natifs sont chacun dédiés à l’écosystème de modèles correspondant :
- Qwen Code : Alibaba Cloud propose trois formes — CLI, application de bureau et IDE. Il suffit de se connecter à Bailian, de choisir la région et de saisir la clé API pour l’utiliser. L’outil offre recherche dans le code, édition de fichiers et exécution de commandes. À privilégier pour les équipes qui utilisent principalement les modèles Qwen et souhaitent réduire les adaptations de protocole.
- Kimi Code CLI : outil de codage en terminal maintenu par Moonshot AI. Il permet de lire et modifier du code, d’appeler le Shell, de récupérer du contenu Web, de reprendre des sessions, propose des modes planification et approbation, s’intègre à l’éditeur et peut aussi configurer des modèles tiers compatibles. Sous Windows, l’installation se fait via le script PowerShell officiel et dépend de Git Bash, fourni avec Git for Windows ; l’ancienne version de Kimi CLI n’est plus maintenue depuis septembre 2026, les nouveaux utilisateurs doivent donc utiliser directement Kimi Code CLI.
- DeepSeek Harness : framework d’agent open source proposant à la fois une interface Web et une CLI, avec prise en charge de fournisseurs personnalisés et de configuration d’outils, et compatible avec les différentes formules de facturation de Bailian. Pour le lancer :
npx @deepseek-ai/dsh web, avec l’adresse par défauthttp://127.0.0.1:3080. Si vous le choisissez, examinez en priorité la stabilité d’exécution des outils, le contrôle des autorisations et l’adéquation avec le protocole du modèle ciblé.
3.3 Pourquoi le Harness influence les performances du modèle
Un même modèle placé dans différents Harness peut donner des résultats très différents, car le Harness détermine ce que le modèle « voit », ce qu’il peut faire et ce qui se passe en cas d’erreur :
- Stratégie de lecture du code : le nombre de fichiers lus en une fois et l’ordre de recherche déterminent si la compréhension du projet par le modèle est complète.
- Conception de la boucle d’outils : la manière dont les résultats des outils sont renvoyés et le déclenchement ou non d’une nouvelle tentative automatique après un échec déterminent si une tâche longue peut aller au bout.
- Compression du contexte : dans les longues sessions, les historiques conservés et les détails écartés influencent directement le risque que le modèle « oublie l’objectif ».
- Patchs et tests : le choix entre remplacer le fichier entier et appliquer un patch diff, ainsi que le lancement ou non des tests après modification par défaut, déterminent la précision des changements et le risque de régression.
Ainsi, les résultats mesurés par la voie B sont ceux d’une combinaison « modèle + ce Harness ». Pour les comparer à ceux de la voie A, il faut garder à l’esprit que les stratégies d’exécution des deux côtés sont intrinsèquement différentes.
4 Quels modèles chinois valent le coup d’être testés ?
4.1 Qwen4-Max-Preview
D’après les spécifications publiques, ses 1M de contexte, son budget partagé de 393,216 tokens entre réflexion et sortie, l’appel d’outils et la sortie structurée en font un bon candidat pour tester du code complexe, l’analyse de longs contextes et les workflows Agent multi-tours. Il est compatible à la fois avec Responses et Anthropic Messages, ce qui permet de le brancher aussi bien sur Codex que sur des outils de type Claude Code.
La fenêtre temporelle est la première contrainte à garder en tête quand on le choisit : la preview se termine le 2026-11-25 à 24:00, avec retrait du service à la clé. L’approche recommandée : profiter de cette période pour lui faire passer toute la batterie de tests, garder les résultats comme référence pour la future version officielle de Qwen, et prévoir en parallèle, en production, un modèle de secours disponible sur le long terme.
4.2 GLM-5.3, Kimi K3, DeepSeek V4, MiniMax M3
Ces quatre séries tiennent dans un seul forfait TokenHub, et le plus simple est de répartir selon le type de tâche :
- Logique complexe et modifications multi-fichiers : GLM-5.3, Kimi K3 et DeepSeek V4-Pro comme groupe de comparaison à haute capacité. Kimi K3 affiche le prix de sortie le plus élevé du tableau, ce qui en fait un bon candidat pour les tâches les plus difficiles, histoire de tester la limite haute.
- Tâches ciblées sur le code : Kimi K2.7 Code sert spécifiquement de référence pour les scénarios de modification de code, et peut aussi s’accompagner de Kimi Code CLI pour tester l’expérience native.
- Tâches fréquentes à faible coût : GLM-5.3-Flash et DeepSeek V4-Flash pour la vérification de code, la refactorisation par lots et autres scénarios sensibles au coût et à la vitesse.
- Stabilité sur long contexte et précision de l’appel d’outils : MiniMax M3 entre dans la sélection, en gardant en tête que le prix grimpe au-delà du seuil de 512K en entrée.
4.3 Comment savoir qui est le plus proche d’Astra
La longueur de contexte, le nombre de paramètres, le positionnement marketing et le prix par token ne permettent pas d’établir un classement fiable des modèles, et les benchmarks promotionnels des différentes sources manquent de comparabilité. Pour savoir « qui est le plus proche d’Astra + Codex », la seule méthode fiable consiste à utiliser le même harness et le même lot de tâches, en enregistrant de façon uniforme le taux de réussite, le temps d’exécution, le coût en tokens, la compatibilité des outils et le nombre d’interventions humaines. La méthode détaillée est à la section 6.
5 Trois pistes pour reproduire la configuration : comment choisir ?
5.1 Vous voulez l’expérience d’utilisation du Codex original : choisissez la piste A
On garde le Codex Harness et on se connecte à un service national qui prend officiellement en charge le protocole Responses. Pour travailler essentiellement avec Qwen, prenez Bailian ; pour passer d’un modèle chinois à l’autre, prenez TokenHub. L’avantage, c’est un coût d’apprentissage et de migration faible : les opérations sur les fichiers et le système d’exécution de l’Agent restent ceux de la version originale. En contrepartie, l’intelligence du modèle diffère de celle d’Astra, le degré d’implémentation des interfaces compatibles influence l’expérience d’appel des outils, et il faut régler séparément la fenêtre de contexte et les paramètres de raisonnement de chaque modèle.
5.2 Vous voulez des modèles chinois et la liberté du multi-modèle : choisissez la piste B
OpenCode combiné à des API multi-modèles nationales, avec au besoin Qwen Code, Kimi Code ou le DeepSeek Harness en complément. C’est la solution la plus adaptée aux développeurs qui utilisent plusieurs modèles sur la durée et ne veulent pas s’enfermer chez un seul fournisseur ; c’est aussi la plus pratique pour comparer côte à côte la façon dont différents modèles traitent une même tâche. Le prix à payer : la stratégie d’exécution diffère de celle de Codex, et la connexion de plusieurs Provider entraîne un travail de configuration et de maintenance supplémentaire.
5.3 Vous voulez préserver au maximum les capacités d’Astra : choisissez la piste C
La combinaison de la piste C, c’est « Codex CLI original + GPT-6 Astra + un service d’accès API disponible ». Si le canal fournit réellement le GPT-6 Astra original et prend pleinement en charge l’API Responses, les événements en streaming, l’appel d’outils et la gestion du contexte dont Codex a besoin, alors on conserve à la fois le modèle et le Harness, les deux composants essentiels. Cette piste règle la question de la disponibilité réseau ; c’est une chose distincte du remplacement par des modèles chinois.
Prenons APIYI comme exemple : la méthode de connexion est identique à la piste A, il suffit de changer le jeu de configurations Provider :
model_provider = "APIYI"
model = "gpt-6-astra"            # se fier à l'ID de modèle réellement listé dans la console APIYI
model_reasoning_effort = "high"  # ajuster entre low et max selon la difficulté de la tâche

[model_providers.APIYI]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Avant de vous connecter, mieux vaut vérifier avec un petit script que le canal prend vraiment en charge le protocole Responses et l’appel d’outils, et qu’il ne se contente pas de renvoyer du texte brut :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

resp = client.responses.create(
    model="gpt-6-astra",  # remplacer par l'ID de modèle disponible dans la console
    reasoning={"effort": "medium"},
    input="Lis src/app.py et indique-moi le nom de la fonction d'entrée",
    tools=[{
        "type": "function",
        "name": "read_file",
        "description": "Lire le contenu d'un fichier du projet",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }],
)

# En temps normal, la réponse doit contenir un élément de type function_call, avec des paramètres structurés
for item in resp.output:
    print(item.type, getattr(item, "arguments", None))
print("usage:", resp.usage)  # vérifier que les tokens d'entrée, de sortie, de cache et de raisonnement sont bien comptés séparément
Ce test couvre les trois choses dont Codex dépend le plus : le protocole Responses, le retour du Function Calling et la ventilation des statistiques d’usage. Une fois le script validé, connectez Codex et lancez une tâche complète comprenant « modification du code + exécution des tests », pour confirmer que les événements en streaming et la boucle d’outils sur plusieurs tours fonctionnent correctement.
Même lorsque le modèle est identique, l’expérience de la route C reste tributaire du routage effectif vers le modèle, du niveau de raisonnement, de la latence et du débit de sortie de l’API, des succès du cache, de la compatibilité protocolaire de la passerelle et des coûts du canal. Le client de bureau Codex, les tâches cloud et les fonctionnalités propres au compte ChatGPT reposent sur le système d’autorisation d’OpenAI lui-même ; passer par une clé API revient à combiner Codex CLI et l’API de modèle, et il faut donc exclure ces fonctionnalités du périmètre dès la phase de planification.
🚀 Conseil pour démarrer rapidement : pour comparer les routes A et C, vous pouvez vous inscrire sur APIYI apiyi.com et profiter d’un quota de test gratuit, puis exécuter les modèles chinois et la série GPT dans le même environnement Codex. Le catalogue exact des modèles disponibles sur APIYI et la prise en charge des protocoles sont à vérifier dans la console et dans la documentation docs.apiyi.com.
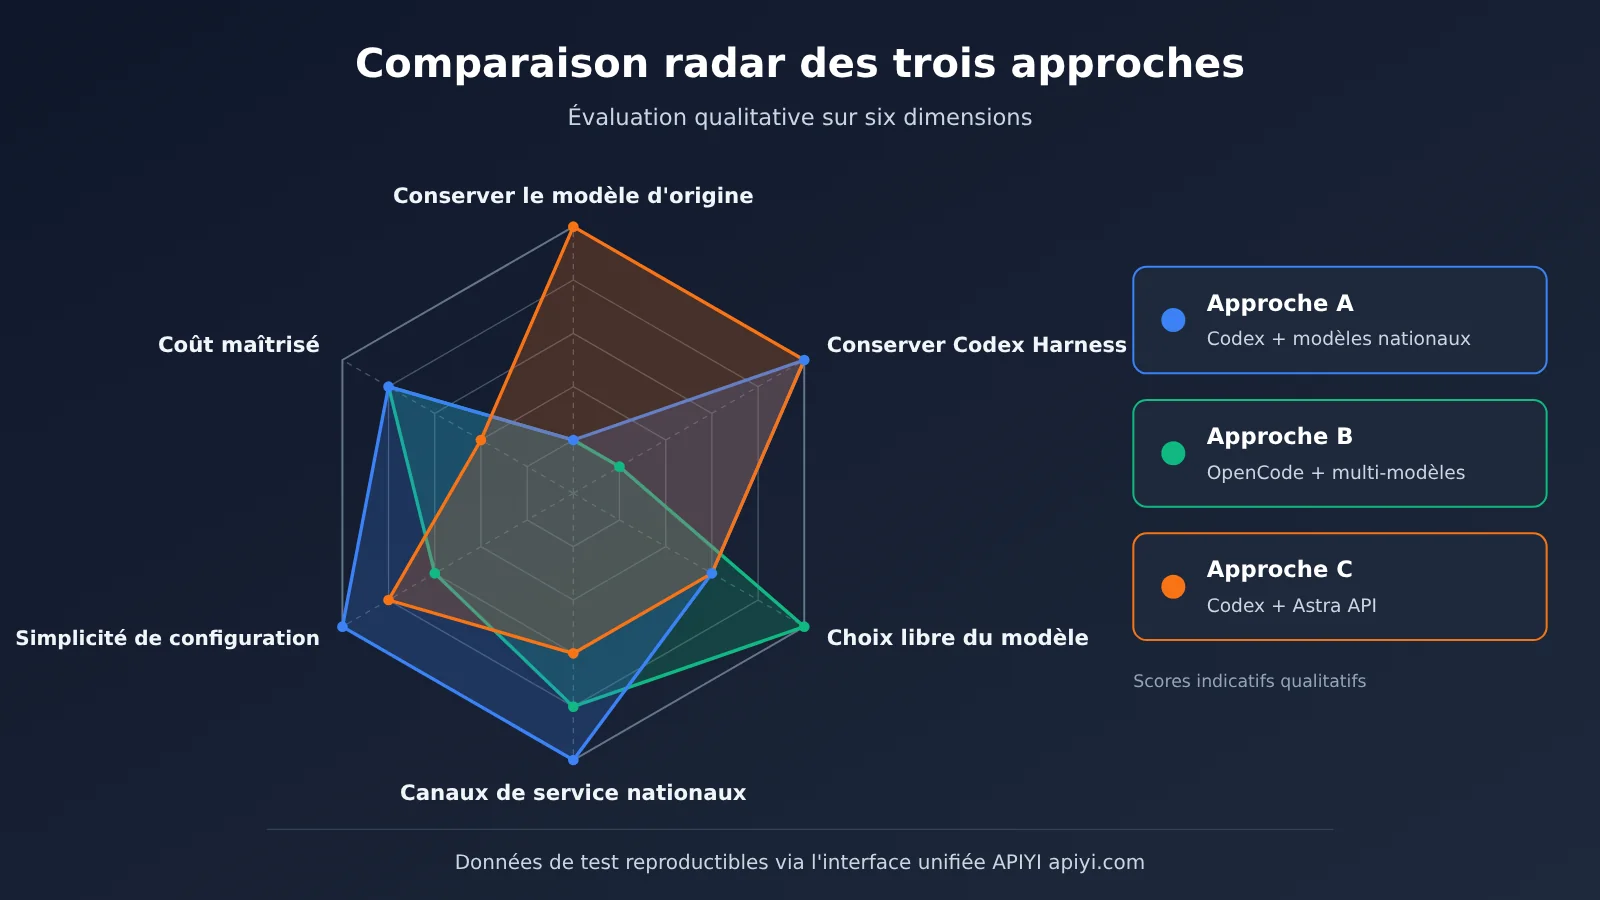
Le récapitulatif des compromis entre les trois routes est le suivant :
| Dimension de comparaison | Route A : Codex + modèles chinois | Route B : OpenCode et assimilés + plusieurs modèles chinois | Route C : Codex + Astra API |
|---|---|---|---|
| Conserver le modèle d’origine | Non, remplacé par Qwen / GLM / Kimi, etc. | Non | Oui (à condition que le canal puisse le vérifier) |
| Conserver le harness Codex | Oui | Non, remplacé par un harness ouvert | Oui |
| Changement de modèle | Modifier l’ID du modèle au sein de la même plateforme | Bascule libre entre plusieurs fournisseurs | Bascule entre les modèles pris en charge par le canal |
| Canaux de service en Chine | Alibaba Cloud Bailian, Tencent Cloud TokenHub | Bailian, TokenHub et autres services compatibles | Canaux tiers prenant en charge Responses, comme APIYI apiyi.com |
| Complexité de configuration | Faible, configuration prête à l’emploi fournie par l’éditeur | Moyenne, nécessite de maintenir plusieurs fournisseurs | Faible, à condition de valider d’abord le protocole |
| Structure de coût | Abonnement mensuel (credits / points) | Forfait ou paiement à l’usage, selon le fournisseur | Facturation à l’usage, le prix unitaire d’Astra est plus élevé que celui de la plupart des modèles chinois |
| Besoins couverts | Expérience Codex originale + modèles chinois | Flux de travail multi-modèles sur le long terme | Conserver au maximum les capacités d’origine |
5.4 Frontières réseau et sécurité pour un usage en Chine
Faire pointer l’API du modèle vers une adresse accessible depuis la Chine ne règle que le segment de l’invocation du modèle. Pendant son travail, l’agent accède aussi à des sources logicielles comme GitHub, npm et PyPI, à de la documentation officielle externe, à des services MCP tiers et à la recherche web : la disponibilité de ces liaisons doit être vérifiée séparément. La recherche en ligne est également une capacité à part entière : la recherche intégrée des fournisseurs cloud, les outils web fournis avec le harness et une Search API / MCP auto-hébergée ont chacune leurs propres contraintes d’accès, de facturation et d’appel.
Côté sécurité, un agent de programmation peut modifier des fichiers, exécuter un shell et lire des variables d’environnement. Voici quelques bonnes pratiques :
- Stocker la clé API dans une variable d’environnement ou un gestionnaire de secrets, et ne jamais l’écrire dans le code source ni dans un dépôt Git.
- Effectuer les modifications complexes sur une branche Git dédiée, avec un versionnement du projet et une sauvegarde restaurable.
- Restreindre l’accès de l’agent aux fichiers sensibles situés hors du répertoire de travail, et isoler le code non fiable dans un conteneur ou une machine virtuelle.
- Conserver une validation humaine pour les opérations à risque élevé : suppression, déploiement, paiement.
6 Les tests sur des tâches réelles ont plus de valeur que les classements de modèles
6.1 Mettre en place cinq types de tâches de test
À partir d’un projet réel comprenant un front-end, un back-end, des tests et une configuration de dépendances, concevez cinq types de tâches pour évaluer séparément les capacités du modèle et celles du Harness :
- Compréhension du projet : demandez au modèle d’expliquer l’architecture et les relations entre les modules clés. Observez sa capacité à localiser les fichiers, à comprendre les dépendances entre fichiers et à fournir des références de chemins vérifiables.
- Développement multi-fichiers : ajoutez une nouvelle fonctionnalité qui nécessite des modifications à plusieurs endroits. Observez la précision des modifications, si la fonctionnalité est complète et si des régressions ont été introduites.
- Correction de bug : fournissez un projet avec un test en échec reproductible. Observez si le modèle identifie la cause racine, modifie le bon endroit, exécute les tests de sa propre initiative et ne casse pas les autres cas de test.
- Flux de travail d’un agent sur une longue séquence : faire parcourir toute la chaîne « compréhension du besoin → modification du code → exécution des tests → détection de l’échec → correction → nouvelle vérification ». Observez si le modèle maintient l’objectif et s’il adapte sa stratégie en fonction des erreurs.
- Consultation de documentation en ligne : après avoir lu la documentation du SDK la plus récente, migrez un extrait de code utilisant une ancienne API. Observez si le modèle accède réellement au réseau pour récupérer le contenu, s’il applique la nouvelle API dans le code et s’il sait distinguer « outil indisponible » de « résultat de recherche vide ».
6.2 Enregistrer le taux de réussite, la durée et le coût
Chaque combinaison « modèle + Harness » exécute le même ensemble de tâches, au moins trois fois pour faire une moyenne, et on enregistre de manière uniforme les indicateurs suivants :
| Indicateur | Mode de calcul ou d’observation |
|---|---|
| Taux de réussite des tâches | Nombre de tâches réussies / nombre total de tâches |
| Taux de réussite au premier essai | Proportion de tâches réussies du premier coup, sans correction humaine |
| Durée totale de la tâche | Depuis le lancement de la tâche jusqu’à la validation finale réussie |
| Nombre d’invocations du modèle | Nombre cumulé de requêtes API par tâche |
| Nombre d’appels d’outils | Nombre d’appels pour la lecture, l’édition, le Shell, la recherche, etc. |
| Consommation de tokens | Détail des tokens en entrée, en sortie, des cache hits et du raisonnement |
| Coût réel d’une tâche | Coût réel pour accomplir une tâche réussie |
| Nombre d’interventions humaines | Nombre de fois où l’utilisateur a ajusté ou corrigé manuellement |
Pour rendre l’expérience reproductible, fixez les variables suivantes : le même instantané du dépôt de code, la même version du Harness, le même niveau de raisonnement ou les mêmes réglages de réflexion, et la même plage horaire (ce qui est particulièrement important pour les modèles à tarification variable selon les heures creuses et les heures de pointe, comme DeepSeek). Avant chaque tâche, réinitialisez le dépôt à partir de l’instantané de référence, afin que les modifications de la série précédente n’influencent pas la suivante.
6.3 Utiliser le coût d’une tâche réussie comme indicateur d’achat principal
Le calcul recommandé est le suivant : coût d’une tâche réussie = coût total de toutes les tentatives ÷ nombre de tâches réussies. Les coûts des tentatives échouées doivent être inclus, car elles consomment elles aussi du crédit.
Un modèle au prix unitaire bas n’est pas forcément le moins cher. S’il lui faut plus de tours de raisonnement, des modifications répétées, de nouvelles tentatives ou des interventions humaines fréquentes, son coût total pour accomplir une tâche peut dépasser celui d’un modèle plus cher qui réussit du premier coup. À l’inverse, sur des tâches simples et fréquentes, le faible prix unitaire et la vitesse des modèles de la gamme Flash apportent souvent de vraies économies. En ramenant le coût à « chaque tâche réussie », on peut comparer les deux types de modèles avec le même étalon.
💰 Conseil pour l’évaluation des coûts : les canaux facturés à l’usage sont les plus pratiques pour ce type d’expérience, car on peut vérifier ligne par ligne le détail des tokens et le coût de chaque requête. Avec APIYI apiyi.com, on peut appeler plusieurs modèles avec une seule clé API et regrouper les factures des différents modèles dans une même console pour calculer le coût d’une tâche réussie.
7 Cas d’usage APIYI : faire du modèle un composant interchangeable
L’analyse qui précède mène à la même conclusion : un environnement de programmation IA stable doit fixer le Harness et traiter le modèle comme un composant remplaçable. Codex ou OpenCode se charge de l’exécution et de la gestion d’état, le canal API fournit le modèle, et l’on bascule flexibly entre les modèles selon la difficulté de la tâche et le budget.
APIYI (apiyi.com) joue ici le rôle de couche d’accès unifiée : une seule clé API permet d’appeler les principaux modèles OpenAI, Claude, Gemini, etc., avec une interface compatible avec le protocole OpenAI et une facturation à l’usage. Pour les utilisateurs qui programment, avant de choisir un canal API (y compris APIYI), il est conseillé de vérifier point par point :
- La prise en charge de l’API Responses et des événements de streaming exigés par la version actuelle de Codex.
- Les ID de modèle réels listés dans la console, ainsi que la disponibilité du modèle visé.
- Le bon fonctionnement complet des appels d’outils et du Function Calling, allers-retours compris.
- La latence et la vitesse de sortie continue, suffisantes pour les tâches longues.
- La reconnaissance correcte de l’utilisation du cache et sa facturation séparée.
Ces informations font foi via la console de service et la documentation technique ; le script de sondage de la section 5.3 peut servir directement à les vérifier. En pratique, l’approche courante consiste à utiliser le forfait mensuel de la route A pour les tâches quotidiennes à haute fréquence, et le canal facturé à l’usage pour les problèmes difficiles nécessitant des modèles plus puissants ainsi que pour les tests comparatifs. Les deux Provider se déclarent dans le même config.toml, et l’on bascule avec --profile ou en modifiant model_provider.
8 Questions fréquentes
Q1 : Pour reproduire Astra + Codex en Chine, quelle voie offre la meilleure fidélité ?
C’est la voie C qui offre la meilleure fidélité : le Codex CLI original associé à une API GPT-6 Astra réellement utilisable, ce qui conserve les deux composants essentiels que sont le modèle et le Harness. La condition est que le canal soit vérifiable comme fournissant le modèle original et qu’il prenne pleinement en charge le protocole Responses ainsi que l’appel d’outils. Si l’on exige un modèle domestique, la voie A reste le meilleur choix pour reproduire l’expérience d’exécution de Codex.
Q2 : Qwen4-Max-Preview est-il adapté à une utilisation prolongée dans Codex ?
Il convient pour l’évaluation actuelle. Ce modèle n’est proposé que dans le Token Plan de Bailian (百炼), et sera retiré à la fin de la période de prévisualisation, le 25 novembre 2026 à 24h00. Nous vous conseillons de profiter de cette période pour terminer vos tâches de test, tout en préparant pour l’environnement de production un modèle alternatif utilisable à long terme.
Q3 : Pourquoi la nouvelle version de Codex ne peut-elle pas se connecter à l’ancienne Coding Plan d’Alibaba Cloud ?
Depuis la version 0.94.0, Codex exige l’API Responses, alors que l’ancienne Coding Plan utilise le protocole Chat Completions ; la documentation officielle recommande donc de l’employer avec Codex 0.93.0 ou une version antérieure. Il suffit de passer au Token Plan et de configurer `wire_api = « responses »` pour connecter le nouveau Codex ; notez que le Token Plan utilise une clé API distincte.
Q4 : Les Credits de Bailian et les points de TokenHub sont-ils directement comparables ?
Non, ils ne le sont pas. Ce sont des unités de mesure propres à chaque plateforme, et le taux de déduction varie selon les modèles. L’approche la plus fiable consiste à exécuter la même tâche des deux côtés, puis à comparer « la part du quota du forfait mensuel consommée pour accomplir une tâche réussie, rapportée au coût mensuel ».
Q5 : Comment vérifier rapidement si un canal tiers peut faire tourner Codex ?
Commencez par envoyer, avec le script Python de la section 5.3, une requête Responses incluant un outil function, afin de confirmer que l’élément de sortie `function_call` est bien renvoyé et que la ventilation de la consommation est normale ; ensuite, branchez Codex et exécutez une tâche complète incluant des tests. Après votre inscription sur APIYI apiyi.com, vous pouvez recevoir un quota de test gratuit pour effectuer cette vérification ; les modèles réellement disponibles font foi dans la console.
Q6 : Un même modèle qui se comporte différemment dans OpenCode et dans Codex, est-ce normal ?
Oui, c’est normal. Le Harness détermine la stratégie de lecture du code, la boucle d’outils, la compression du contexte et les habitudes de test, autant d’éléments qui modifient le comportement réel du modèle. Lors d’une comparaison, il faut fixer le Harness pour tester le modèle, ou fixer le modèle pour tester le Harness, afin d’éviter que les deux variables ne changent en même temps.
Q7 : En utilisant Codex via une clé API, peut-on bénéficier des fonctionnalités Codex de l’abonnement ChatGPT ?
La méthode par clé API fournit une combinaison Codex CLI + API de modèle. Les tâches cloud de Codex, l’application de bureau et les fonctionnalités réservées au compte ChatGPT dépendent de l’autorisation de compte OpenAI ; un canal API tiers ne peut pas fournir ces avantages.
Q8 : Comment maîtriser le coût total lors du passage d’un modèle à l’autre ?
En hiérarchisant selon la tâche : les problèmes difficiles avec un modèle à forte capacité, les vérifications en masse et les refactorisations simples confiées à un modèle de niveau Flash, et pour les modèles à tarification heures pleines / heures creuses, placer les tâches asynchrones la nuit. Évaluez toujours avec le « coût par tâche réussie » ; un canal à l’usage comme APIYI apiyi.com facilite la vérification ligne par ligne de la consommation réelle de chaque modèle.
9 Récapitulatif : Key Takeaways
- Trois approches pour trois priorités différentes : l’approche A préserve l’expérience Codex, l’approche B préserve la liberté de choix du modèle, l’approche C préserve le modèle d’origine.
- Astra + Codex, c’est une combinaison à cinq couches : le modèle, le système d’exécution, l’écosystème d’outils, la gestion d’état et l’expérience d’utilisation déterminent ensemble le résultat.
- L’approche A dispose de configurations prêtes à l’emploi : Bailian et TokenHub proposent tous deux une configuration Codex officielle, dont le cœur est
wire_api = "responses". - Qwen4-Max-Preview a une date limite : réservé au Token Plan, la préversion se termine et le modèle est retiré le 2026-11-25 à 24h00.
- Les unités des forfaits ne sont pas comparables : les Credits, les points, les tokens et les centimes de yuan relèvent de systèmes de mesure différents ; seule une mesure réelle sur des tâches permet de comparer.
- Laisser les tâches parler : cinq types de tâches réelles, huit indicateurs, et le coût par tâche réussie comme base d’achat.
- Faire du modèle un composant remplaçable : un Harness fixe, un canal d’accès unifié, un changement de modèle selon la tâche — voilà un environnement stable et maîtrisable.
La façon la plus pragmatique de démarrer, c’est de configurer deux Providers dans le même environnement Codex : un forfait cloud national pour les tâches quotidiennes, et un canal à l’usage pour les tests comparatifs et les tâches difficiles. Lancez un cycle avec la méthode de la section 6, puis décidez de la combinaison à long terme. Je recommande de monter rapidement un groupe de comparaison via APIYI apiyi.com, en utilisant une interface unifiée pour évaluer les modèles chinois et la série GPT sur le même ensemble de tâches.
📚 Références
- Documentation officielle du modèle GPT-6 Astra : spécifications du modèle, niveaux de raisonnement et tarification
- Lien :
developers.openai.com/api/docs/models/gpt-6-astra -
Description : fenêtre de contexte, sortie maximale, prise en charge des outils et tarification pour le contexte long
-
OpenAI Codex Harness : conception du cadre d’exécution de Codex
- Lien :
developers.openai.com/blog/codex-as-a-platform -
Description : explications officielles sur la boucle de l’agent, le renvoi des résultats d’outils, la gestion du contexte et le bac à sable
-
Intégration de Codex sur Alibaba Cloud Bailian : méthode de configuration de Token Plan
- Lien :
help.aliyun.com/zh/model-studio/codex -
Description : champs de config.toml, protocole Responses et exigences de version
-
Alibaba Cloud Token Plan version personnelle : prix des forfaits et Credits
- Lien :
help.aliyun.com/zh/model-studio/token-plan-personal-overview -
Description : niveaux, quotas et offre de première souscription après l’ajustement du 2026-11-09
-
Documentation officielle de Qwen4-Max-Preview : spécifications du modèle et période de prévisualisation
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max-preview -
Description : contexte de 1M, compatibilité des protocoles et date de retrait
-
Configuration de Codex CLI sur Tencent Cloud TokenHub : tutoriel d’intégration officiel
- Lien :
cloud.tencent.cn/document/product/1823/130071 -
Description : configuration du Provider et méthode de remplacement de l’ID du modèle
-
Forfaits et taux de crédits de Tencent Cloud TokenHub : règles de facturation
- Lien :
cloud.tencent.cn/document/product/1823/130060 - Lien :
cloud.tencent.com/document/product/1823/133811 -
Description : niveaux de forfait, taux de crédits par modèle et facturation en heures pleines et heures creuses
-
Dépôt officiel d’OpenCode : agent de codage open source
- Lien :
github.com/anomalyco/opencode -
Description : configuration du Provider et notes de sécurité
-
Qwen Code, Kimi Code CLI, DeepSeek Harness : Harness natifs
- Lien :
help.aliyun.com/zh/model-studio/qwen-code - Lien :
github.com/MoonshotAI/kimi-code - Lien :
help.aliyun.com/zh/model-studio/deepseek-harness - Description : installation, intégration et étendue des capacités
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com


