ملاحظة الكاتب: وجدت دراسة من ستانفورد أن 44% من الاستنتاجات الشائعة حول نماذج اللغة الكبيرة أصبحت قديمة، وأن متوسط صلاحية الاستنتاجات التي أمكن تقدير تاريخ تقادمها لا يتجاوز 15.7 شهرًا. يحوّل هذا المقال نتائج الدراسة إلى قائمة تحقق يمكن لفرق التطوير استخدامها مباشرة لإعادة الاختبار عند اختيار النموذج.
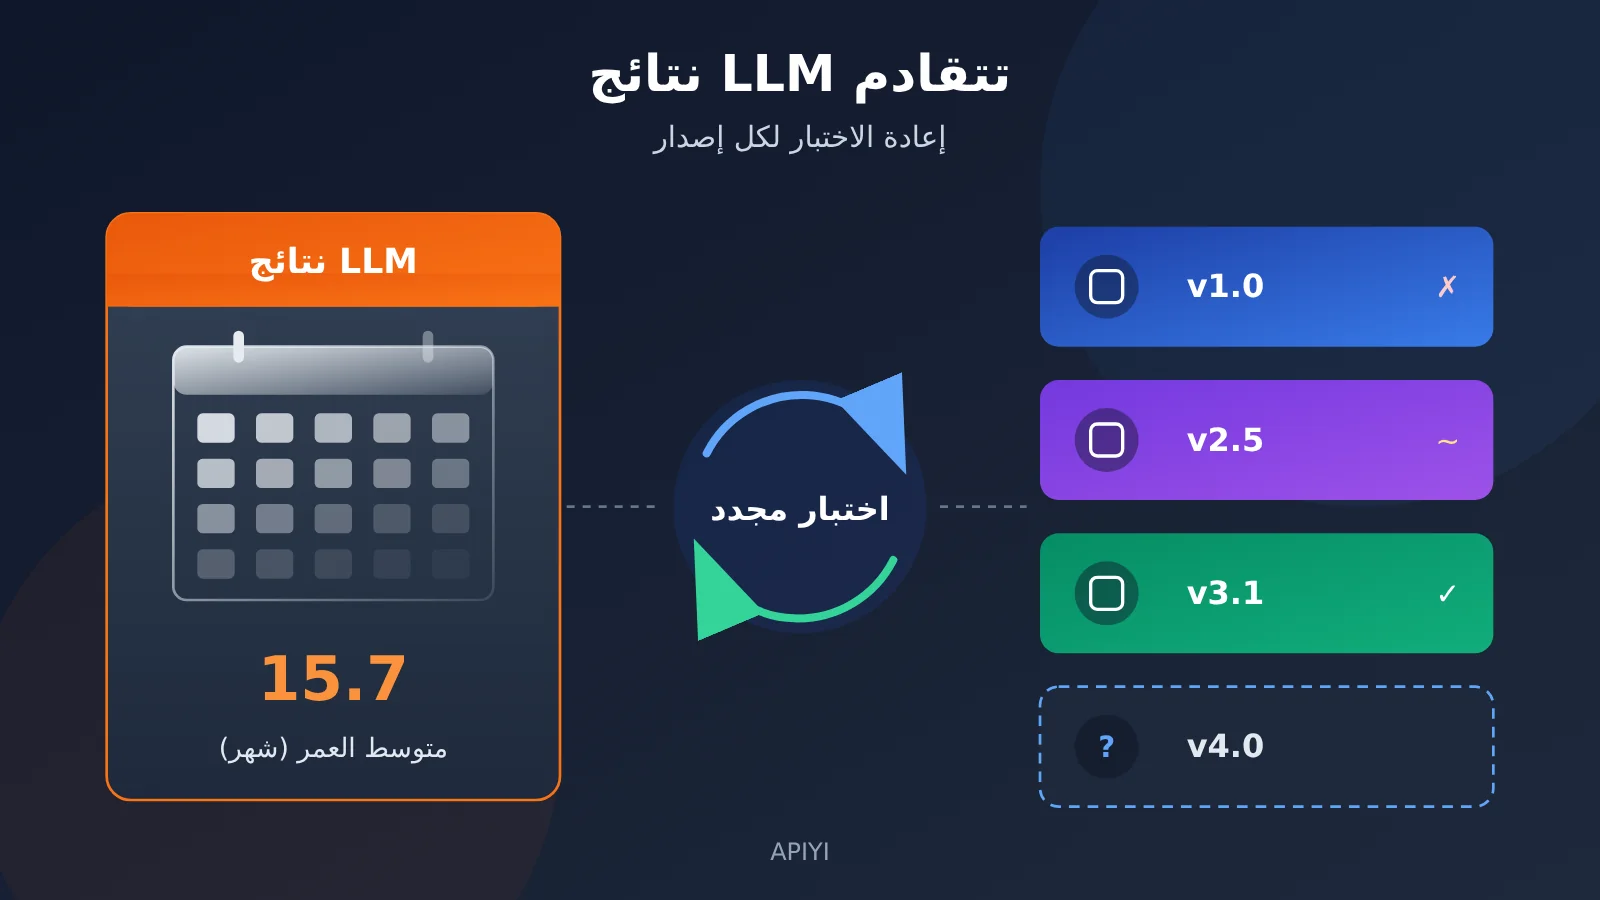
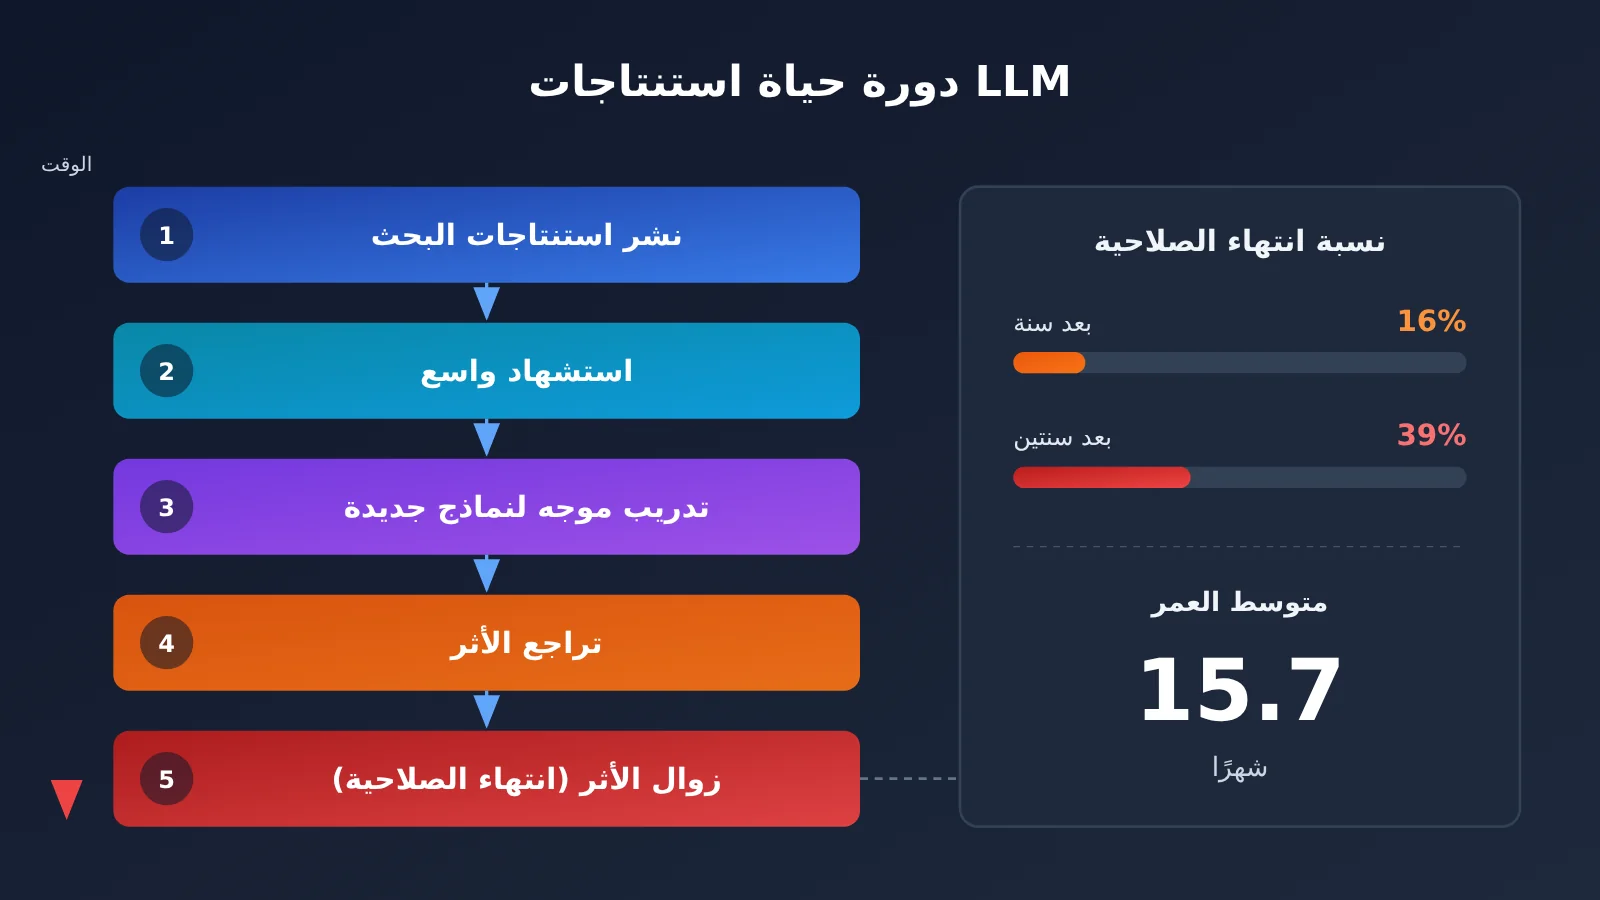
«لا يستطيع نموذج معين عدّ حروف r في كلمة strawberry»، و«تضيع المعلومات الموجودة في منتصف السياق الطويل»، و«تختلق النماذج المراجع». ربما سمعت هذه العبارات مرارًا في الأبحاث والمجموعات التقنية واجتماعات اختيار النماذج. أعاد الباحثان في ستانفورد، Owen Queen وJames Zou، اختبار 50 استنتاجًا واسع الانتشار حول نماذج اللغة الكبيرة باستخدام 20 نموذجًا، ووجدا أن 44% منها أصبح قديمًا، وأن الاستنتاجات التي أمكن تقدير تاريخ تقادمها صمدت في المتوسط 15.7 شهرًا فقط.
هذه ليست مقالة أخرى تكتفي بالقول إن «النماذج تزداد قوة». تقدم الدراسة بيانات واضحة عن أنواع الاستنتاجات التي تتقادم أسرع من غيرها، وتلك التي تصمد مدة أطول، وحجم الفروق بين نماذج الجيل الواحد. ويحوّل هذا المقال توصيات الباحثَين للأوساط الأكاديمية إلى خطوات عملية يمكن لفرق التطوير اتباعها عند اختيار النماذج.
الفائدة الأساسية: بعد قراءة المقال، ستعرف أي العبارات من نوع «النموذج لا يجيد X» أقل موثوقية، وستكتسب عادة تسجيل اسم النموذج وإصداره وتاريخ الاختبار، والاحتفاظ بالموجه، ثم إعادة الاختبار على النموذج المستهدف.
أبرز نتائج البحث حول تقادم استنتاجات نماذج اللغة الكبيرة
لنبدأ بجدول يلخص أهم الأرقام في الدراسة. نُشرت النماذج المستخدمة بين يوليو 2024 وسبتمبر 2026، وطورتها 8 جهات مختلفة، ونُشر التقرير عن الدراسة في 3 نوفمبر 2026.
| النقطة | بيانات الدراسة | ما تعنيه عند اختيار نموذج |
|---|---|---|
| نسبة الاستنتاجات المتقادمة | من بين 50 استنتاجًا، تقادم 44% وضعف تأثير 34% بوضوح | معظم عيوب النماذج المتداولة على الإنترنت لم يعد من الممكن الاستشهاد بها مباشرة |
| النسبة التي ما زالت صحيحة | بقي 16% فقط على حاله، بينما أصبح 6% أقوى | بعض الميول «العنيدة» تستحق المتابعة على المدى الطويل |
| متوسط العمر | من بين 22 استنتاجًا أمكن تقدير وقت تقادمها، بلغ المتوسط 15.7 شهرًا | ينبغي التعامل بحذر مع نتائج التقييم التي مضى عليها أكثر من عام |
| التراكم بمرور الوقت | تقادم 16% بعد عام، وارتفعت النسبة إلى 39% بعد عامين | كلما كان الاستنتاج أقدم، زادت الحاجة إلى إعادة اختباره |
| الاختلاف بين نماذج الجيل الواحد | في النماذج الصادرة بين يوليو وسبتمبر 2026، تراوح عدد الاستنتاجات المتقادمة بين 11 و30 | لا يمكن استنتاج قدرات النموذج من تاريخ إصداره |
نتيجتان أساسيتان حول تقادم استنتاجات نماذج اللغة الكبيرة
تتعلق النتيجة الأولى بمعنى «التقادم». ففي الدراسة، يعني التقادم أن التأثير الذي قام عليه الاستنتاج الأصلي قد اختفى عمليًا في النماذج الأحدث، وليس أنه تحسن جزئيًا فحسب. وهناك 34% أخرى من الاستنتاجات «ضعف تأثيرها بوضوح»، أي إن المشكلة لا تزال موجودة، لكنها لم تعد بالحدة التي وصفتها الورقة الأصلية. وبجمع الفئتين، نجد أن قرابة ثمانية أعشار الاستنتاجات الشائعة لم تعد قابلة للتطبيق كما هي على نماذج اليوم.
أما النتيجة الثانية فهي أن «عمر» الاستنتاج يرتبط ارتباطًا وثيقًا بنوعه. فالاستنتاجات المتعلقة بنواقص القدرات، التي تصف ما «لا يستطيع النموذج فعله»، تتقادم أسرع من غيرها. في المقابل، تدوم الاستنتاجات المتعلقة بالتفضيلات، التي تصف «ما يميل النموذج إلى فعله»، لفترة أطول. ويفسر الباحثون ذلك بأن أخطاء القدرات عادةً ما تكون لها «إجابة صحيحة»، مما يمنح المطورين هدفًا واضحًا لتحسين التدريب. أما التفضيلات والميول فلا إجابة معيارية لها، ولذلك يصعب «إصلاحها».
أي الاستنتاجات عن نماذج LLM تصبح قديمة بسرعة؟
فهم نوع الاستنتاج هو الخطوة الأولى لتحديد أولوية إعادة اختباره. يقسّم الجدول التالي الاستنتاجات النموذجية إلى فئتين: استنتاجات يسهل أن تصبح قديمة، وأخرى تدوم نسبيًا، استنادًا إلى ما ورد في التقرير عن الدراسة.
| نوع الاستنتاج | أمثلة نموذجية | حالته في الدراسة | أولوية إعادة الاختبار |
|---|---|---|---|
| قصور الاستدلال والقدرات | عدّ الحروف في strawberry، وإجراء عمليات حسابية بأنظمة عدّ غير مألوفة، وفقدان المعلومات في منتصف السياق الطويل، والتخلي عن الإجابة الصحيحة بعد اعتراض المستخدم | أصبحت 5 من أصل 9 استنتاجات عن الاستدلال قديمة، ولم يبقَ أي منها كما هو أو يزداد وضوحًا | الأعلى: يجب إعادة الاختبار قبل الاستشهاد |
| الدقة الواقعية والهلوسة | اختلاق مراجع علمية | انخفضت الظاهرة إلى ما يقارب الصفر في بعض النماذج، لكنها لا تزال مرتفعة في نماذج أخرى | عالية: الفروق كبيرة جدًا، ويجب اختبار كل نموذج على حدة |
| الاستدلال المركّب | الأسئلة التي تتطلب خطوتين استدلاليتين، و«لعنة الانعكاس»، وتناقض الإجابات عن الأسئلة الزمنية المتناظرة | ضعفت الظواهر، لكن لا يزال بالإمكان رصدها | متوسطة إلى عالية: المشكلة لا تزال موجودة، لكن حجمها تغيّر كثيرًا |
| التحيزات عند أداء دور المقيّم | تفضيل النموذج إجاباته الخاصة، ومنح أوراق بحثية مقبولة وأخرى مرفوضة درجات متقاربة، والتأثر بطريقة صياغة الملخصات الطبية | بقيت كما هي أو ازدادت وضوحًا | متوسطة: خطر طويل الأمد، لكن يلزم التحقق منه دوريًا |
| التملّق ومجاراة المستخدم | مسايرة آراء المستخدم | تشكّل نسبة مرتفعة من الاستنتاجات التي بقيت كما هي أو ازدادت وضوحًا | متوسطة: تزداد أولويتها في تطبيقات خدمة العملاء والاستشارات |
| ميول توزيع المخرجات | التحيز السياسي نحو اليسار، والتشابه الشديد بين إجابات الأسئلة المفتوحة، والتوزيع غير المتساوي للأرقام العشوائية المُولّدة | بقيت كما هي أو ازدادت وضوحًا | متوسطة: تستحق الانتباه عند توليد المحتوى وأخذ العينات |
تجدر الإشارة إلى أن متن التقرير يذكر، بشأن استنتاجات الاستدلال، أن «5 من أصل 9 استنتاجات أصبحت قديمة، ولم يبقَ أي منها كما هو أو يزداد وضوحًا»، بينما يقول التعليق المرافق للشكل إن «الاستنتاجات التسعة جميعها تراجعت». وعند قراءة العبارتين معًا، يُفهم أن 5 استنتاجات أصبحت قديمة، وأن الاستنتاجات المتبقية ضعفت أيضًا، ولم يبقَ أي منها على حاله. ولأننا لم نطّلع على القائمة الكاملة للاستنتاجات الخمسين أو على منهجية إعادة الاختبار في الورقة الأصلية، فيُرجى الرجوع إليها للتحقق من التصنيف الدقيق.
لماذا تستمر نتائج دراسات تفضيلات نماذج اللغة الكبيرة لفترة أطول؟
من بين 11 نتيجة ظلت قائمة أو ازدادت وضوحًا، تتعلق 3 نتائج باستخدام نموذج اللغة الكبير بوصفه مقيّمًا، و3 أخرى بميله إلى مجاملة المستخدم ومسايرته. أما البقية فتتناول الميول السياسية، وتشابه الإجابات عن الأسئلة المفتوحة، وعدم انتظام توزيع الأرقام العشوائية. وتشترك هذه المشكلات في أمر واحد: يصعب تحديد ما يُعد مخرجات «صحيحة»، ومن ثم يصعب التخلص منها عبر تدريب مخصص.
بالنسبة إلى فرق التطوير، يعني ذلك ترتيبًا للمخاطر قد يخالف التوقعات. فالمشكلة التي يكثر الحديث عنها، وهي أن «النموذج لا يستطيع عدّ الحروف»، غالبًا ما لم تعد مشكلة منذ فترة، بينما تستحق الميول المنهجية الأقل وضوحًا مزيدًا من الانتباه. إذا كنت تستخدم نموذج لغة كبيرًا في التقييم الآلي أو منح الدرجات أو التوصية، فمن المهم إدراج مشكلات التفضيلات ضمن اختبارات الانحدار الدورية.
نتائج دراسات التحيز الاجتماعي في نماذج اللغة الكبيرة متباينة
أشار الباحثون إلى أن نتائج دراسات التحيز الاجتماعي لم تتبع اتجاهًا واحدًا. فالانحياز السياسي نحو اليسار لا يزال قائمًا، بينما تراجعت الصور النمطية المرتبطة بالجنس والتحيزات في الارتباطات الضمنية. أما التحيز ضد المتحدثين بالإنجليزية الأفريقية الأمريكية، فقد انعكس اتجاهه في بيانات الاتجاهات. وهذا يؤكد مجددًا أن أي تعميم من قبيل «النماذج متحيزة عمومًا بطريقة معينة» لا يكون ذا معنى إلا عند ربطه بنموذج محدد ونقطة زمنية محددة.
لماذا لا يمكن استنتاج أداء نماذج اللغة الكبيرة من الشركة المطوّرة أو تاريخ الإصدار؟
عند اختيار نموذج، تعتمد فرق كثيرة على حدس بسيط: النموذج الأحدث أفضل بالضرورة من الأقدم، ونماذج الشركة الواحدة متقاربة في الأداء، والنموذج الكبير أكثر ثباتًا من الصغير. لكن بيانات البحث تنقض هذه الافتراضات مباشرةً.
أبرز مثال هو اختبار اختلاق المراجع. في الدراسة الأصلية التي أجراها Walters وWilder عام 2023، اختلق GPT-3.5 نسبة 55% من المراجع. وعندما اختبر باحثو ستانفورد النماذج الحالية باستخدام الموجه نفسه، بلغت النسبة 0% لدى GPT-6.1 Sol و1% لدى Claude Sonnet 5.5، بينما ظلت 69% من مراجع Qwen3.7-Flash مختلقة، رغم أنه صدر أيضًا عام 2026. وهي نسبة أعلى حتى من نسبة GPT-3.5 قبل ثلاث سنوات.
والفروق بين النماذج الصادرة في الفترة نفسها مذهلة أيضًا. فمن بين النماذج الصادرة بين يوليو وسبتمبر 2026، تراوح عدد النتائج التي «نُقضت» بين 11 لدى DeepSeek V4 Pro و30 لدى GPT-6.1 Sol. وتشير الدراسة بوضوح إلى أن تاريخ الإصدار والشركة المطوّرة وحجم النموذج لا تكفي للتنبؤ بهذا النمط على نحو موثوق.
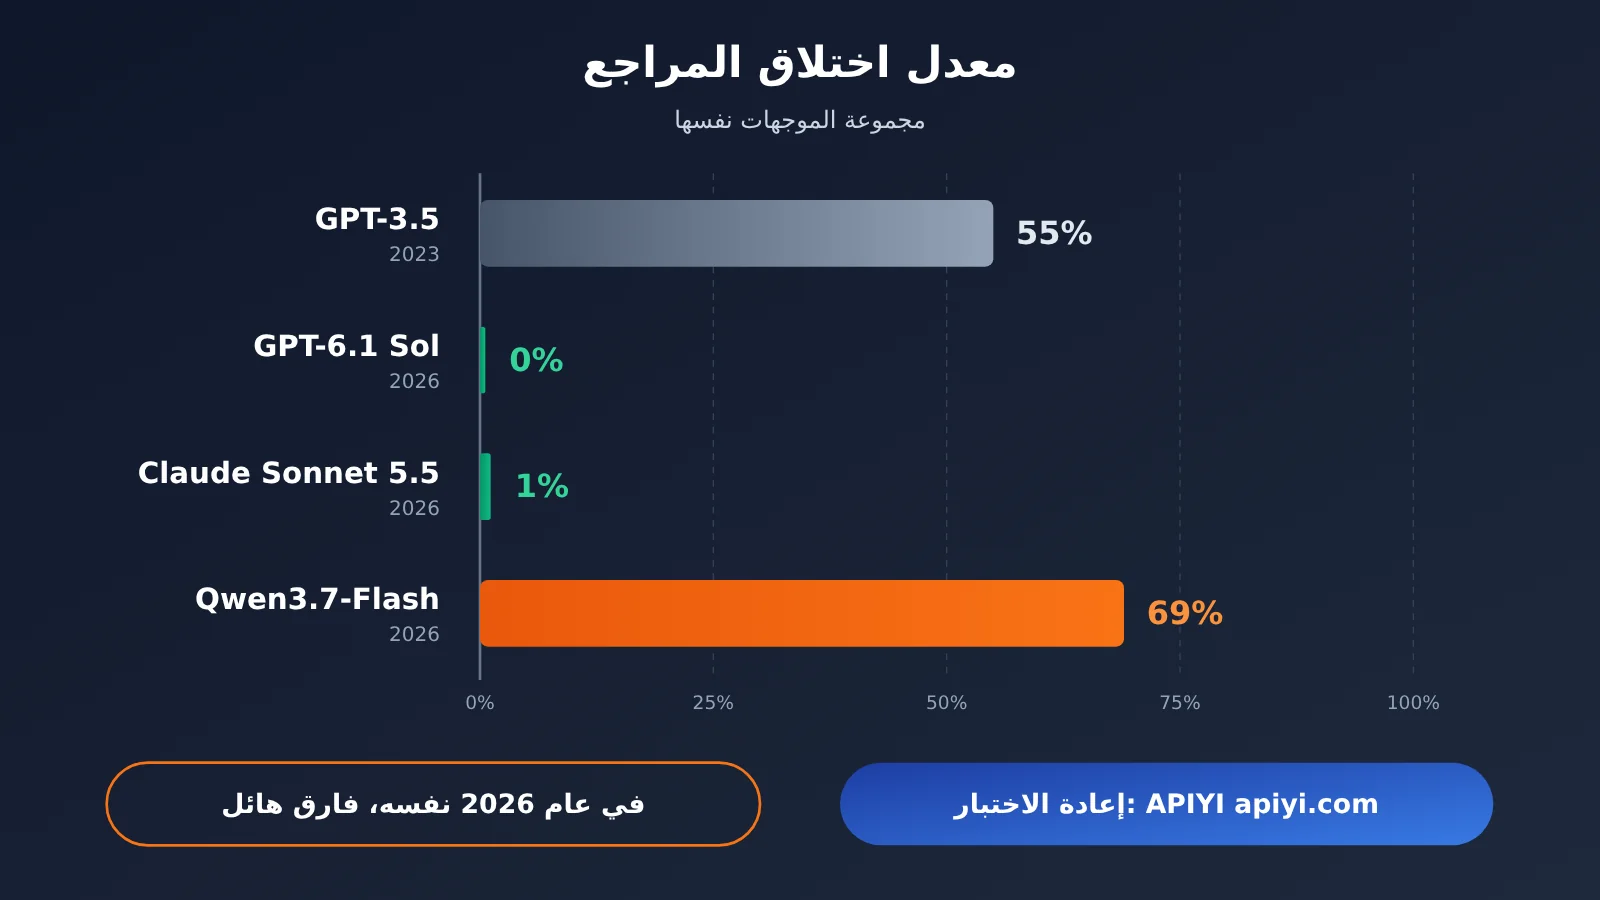
الرسالة الأساسية من هذا المخطط هي أن نماذج الحقبة نفسها قد تقع عند طرفين متباعدين تمامًا في الاختبار نفسه. وإذا أردت إعادة إجراء هذه المقارنة داخل فريقك، فيمكنك استخدام منصة بواجهة موحدة مثل APIYI على apiyi.com لتجربة مجموعة الموجهات نفسها عبر عدة نماذج مرشحة. وللتعرف على النماذج المتاحة، راجع قائمة النماذج الرسمية للمنصة.
كذلك، ينبّه الباحثون إلى أن التحسن لا يعني أن «المشكلة حُلّت بالكامل». ففي الأسئلة ذات الخطوتين، التي تتطلب الجمع بين حقيقتين معروفتين، أخطأ Claude Sonnet 5.5 في نحو 10% من الأسئلة المركّبة، رغم قدرته على الإجابة عن السؤالين الفرعيين كلٍّ على حدة. وكانت النسبة التي أبلغت عنها الورقة الأصلية لـ ChatGPT هي 43%. صحيح أن النسبة انخفضت كثيرًا، لكن إذا كان عملك يعتمد على دمج الحقائق عبر خطوات متعددة، فقد تظل نسبة 10% كافية للتسبب في مشكلات تشغيلية.
دليل سريع لإعادة اختبار نماذج اللغة الكبيرة عند اختيارها: قائمة من 5 خطوات
ينصح الباحثون المجتمع الأكاديمي بالتعامل مع الاستنتاجات التجريبية حول نماذج اللغة الكبيرة بوصفها «ملاحظات عن نموذج محدد في وقت محدد»، لا حقائق عامة. كما ينصحون بتوثيق النموذج وإصداره وتاريخ الاختبار، وإتاحة الموجهات وشفرة التحليل، لتسهيل إعادة الاختبار على النماذج المستقبلية. ويمكن لفرق التطوير تطبيق هذه التوصيات مباشرة تقريبًا عند اختيار النماذج.
الخطوة 1: استكمال البيانات الوصفية لكل استنتاج عن نماذج اللغة الكبيرة
سواء جاء الاستنتاج من ورقة بحثية أو مدونة أو تجربة أحد الزملاء أو اختباراتك الخاصة، استكمل أولًا الحقول الواردة في الجدول التالي. إذا افتقد الاستنتاج حقولًا أساسية، فلا يمكن التعامل معه إلا بوصفه «مؤشرًا يحتاج إلى التحقق»، وليس أساسًا لاتخاذ القرار.
| حقل البيانات الوصفية | ما يجب تسجيله | لماذا يجب تسجيله |
|---|---|---|
| اسم النموذج | اسم النموذج الكامل، وليس «نموذج من شركة معينة» | قد تختلف نماذج الشركة الواحدة اختلافًا كبيرًا |
| الإصدار المحدد | رقم الإصدار أو معرّف اللقطة | قد يتغير أداء النموذج بعد تحديثه مع بقاء اسمه كما هو |
| تاريخ الاختبار | التاريخ بدقة حتى اليوم | لتحديد «عمر» الاستنتاج، بالاسترشاد بمتوسط عمر يبلغ 15.7 شهرًا |
| الموجه الكامل | موجه النظام ومدخلات المستخدم والأمثلة | لا يمكن إعادة الاختبار بالنتائج نفسها عند تغيير الموجه |
| معلمات الاستدعاء | درجة الحرارة والحد الأقصى لطول المخرجات وغيرها | تؤثر معلمات أخذ العينات في الاستنتاجات المتعلقة بالاستقرار |
| معايير التقييم | ما يُعد نجاحًا وما يُعد إخفاقًا | وإلا فلن تكون نتائج اختبارات الأشخاص المختلفين قابلة للمقارنة |
| حجم العينة | عدد حالات الاختبار | لا تكفي لقطة شاشة لمحادثة واحدة لاستنتاج نسبة |
الخطوة 2: تحديد أولوية إعادة اختبار LLM حسب نوع النتيجة
عندما تصادف نتيجة، حدّد أولًا نوعها. اعتبر النتائج المتعلقة بضعف القدرات، مثل عدم القدرة على العد أو الحساب أو التذكر، أو تغيير الإجابة عند الاعتراض عليها، «مرجحًا جدًا أنها لم تعد صالحة»، وأعد اختبارها قبل الاستشهاد بها. أما النتائج المتعلقة بالميول والتفضيلات، مثل تفضيل الذات والمجاملة المفرطة وتشابه المخرجات، فاعتبر أنها «مرجحة الاستمرار»، وأدرجها في اختبارات الانحدار طويلة المدى.
ثم ضع عمر النتيجة في الحسبان: وفقًا لبيانات البحث، تبلغ احتمالية عدم صلاحية النتيجة التي مر عليها أكثر من عام نحو 16%، وترتفع إلى 39% بعد أكثر من عامين. وإذا كانت نماذجك المرشحة قد حلّت محل النموذج الذي تتناوله النتيجة، فأعد اختبارها مهما كانت شهرتها.
الخطوة 3: تحويل النتائج إلى حالات اختبار قابلة للتنفيذ لـ LLM
لا يمكن اختبار عبارة مثل «النموذج ضعيف في فهم المستندات الطويلة» مباشرةً؛ بل يجب تحويلها إلى حالات محددة. مثلًا، ضع معلومة أساسية في بداية مستند طويل، ثم في وسطه، ثم في نهايته، واطرح سؤالًا عنها في كل حالة واحسب نسبة الإجابات الصحيحة. أو اطلب من النموذج تقديم إجابة صحيحة، ثم حاكِ اعتراض مستخدم عليها واحسب نسبة تغييره للإجابة.
عند إعداد حالات الاختبار، اجعلها أقرب ما يمكن إلى بيانات عملك الفعلية، بدلًا من الاكتفاء بأمثلة مبسطة من الأوراق البحثية. فمن المرجح أن النماذج المختلفة دُرّبت خصيصًا على الأسئلة الكلاسيكية التي تبيّن في البحث أنها «لم تعد صالحة». واجتيازها لا يعني بالضرورة أن النموذج سينجح مع بيانات عملك أيضًا.
الخطوة 4: أعد الاختبار على جميع نماذج اللغة الكبيرة المرشحة باستخدام مجموعة الموجهات نفسها
يكمن مفتاح إعادة الاختبار في ضبط المتغيرات: استخدم مجموعة الموجهات نفسها، والمعلمات نفسها، ومعايير التقييم نفسها، وغيّر النموذج فقط. إذا احتاج كل نموذج إلى التكامل مع حزمة SDK مستقلة ومعالجة المصادقة على حدة، فسترتفع تكلفة إعادة الاختبار إلى درجة قد تجعل الفريق يتجنبها.
🚀 نصيحة عملية: تعتمد APIYI apiyi.com على معيار OpenAI API الموحد، وتتيح استدعاء أكثر من 200 نموذج باستخدام رمز وصول واحد. عند التبديل بين النماذج المرشحة، يكفي تعديل المعلمة
modelمع إبقاء الموجهات والمعلمات الأخرى دون تغيير، مما يجعلها مناسبة لهذا النوع من المقارنات. لمعرفة النماذج والإصدارات المدعومة، راجع قائمة النماذج الرسمية على المنصة.
الخطوة 5: أنشئ سجلًا لنتائج نماذج اللغة الكبيرة وراجعه دوريًا
احفظ نتائج كل إعادة اختبار في «سجل للنتائج» يتضمن على الأقل النص الأصلي للنتيجة، والبيانات الوصفية، ونتائج إعادة الاختبار، وموعد المراجعة التالية. وبالنظر إلى متوسط العمر البالغ 15.7 شهرًا، يُنصح بمراجعة النتائج التي تعتمد عليها الأعمال الأساسية كل ثلاثة أو ستة أشهر. أما عند التخطيط لترقية إصدار النموذج، فيجب إجراء إعادة اختبار شاملة دون استثناء.
| السيناريو | نطاق إعادة الاختبار المقترح | التوقيت |
|---|---|---|
| الاختيار الأولي | جميع النتائج المؤثرة في القرار + حالات الاستخدام الأساسية للأعمال | قبل مراجعة قرار الاختيار |
| ترقية إصدار النموذج | جميع حالات اختبار الانحدار | قبل التبديل في بيئة الإنتاج |
| الاستشهاد بنتائج خارجية | النتائج ذات الصلة فقط | قبل إدراجها في وثيقة الحل |
| التشغيل اليومي | النتائج المتعلقة بالتفضيلات والميول + حالات الاستخدام عالية المخاطر | كل ثلاثة أو ستة أشهر |
| ظهور خلل في بيئة الإنتاج | القدرات المرتبطة بالخلل | فورًا |
💡 نصيحة للاختيار: عند اختيار النموذج، لا تبدأ بالسؤال «أي نموذج هو الأقوى؟». حدّد أولًا أنواع الأخطاء الأكثر ضررًا لأعمالك، ثم أعد اختبار النماذج المرشحة بناءً عليها. باستخدام الواجهة الموحدة من APIYI apiyi.com، يمكنك مقارنة عدة نماذج ضمن مسار اختبار واحد، وتقليل المتغيرات الإضافية الناتجة عن التكامل.
الأسئلة الشائعة FAQ
س1: ماذا يعني أن نتيجة عن نماذج اللغة الكبيرة أصبحت «متقادمة»؟
في دراسة ستانفورد، تعني «متقادمة» أن الأثر الذي استندت إليه نتيجة تجريبية عن نماذج اللغة الكبيرة قد اختفى تقريبًا في النماذج الجديدة. ويختلف ذلك عن «التراجع»، الذي يعني أن المشكلة لا تزال موجودة، لكن بدرجة أقل بكثير. ومن أصل 50 نتيجة، أصبحت 44% متقادمة، وتراجعت 34%.
س2: ما الفرق بين النتائج المتعلقة بقصور قدرات نماذج اللغة الكبيرة والنتائج المتعلقة بميولها؟
تصف نتائج قصور القدرات ما «لا يستطيع النموذج فعله»، مثل عدّ الحروف، وإجراء العمليات الحسابية، وفقدان المعلومات في السياقات الطويلة. ولهذه المهام إجابات صحيحة واضحة، ويسهل إصلاحها بتدريب موجّه، لذا تتقادم نتائجها بأسرع وتيرة. أما نتائج الميول فتصف «كيف يميل النموذج إلى التصرف»، مثل تفضيل إجاباته الخاصة أو مجاملة المستخدم. ولا توجد لها إجابات معيارية، لذلك تستمر مدة أطول.
س3: متى نُشرت دراسة تقادم النتائج المتعلقة بنماذج اللغة الكبيرة؟
نُشر التقرير المتعلق بها في 3 نوفمبر 2026. واختبرت الدراسة 20 نموذجًا من 8 جهات مطوّرة، صدرت بين يوليو 2024 وسبتمبر 2026. وبما أن النماذج تتطور بسرعة، فإن الأرقام الواردة في هذا المقال مرتبطة بفترة زمنية محددة؛ لذا يُنصح بمراجعة الورقة البحثية الأصلية قبل استخدامها.
س4: ما الفرق الأكثر حاجة إلى إعادة اختبار نماذج اللغة الكبيرة عند صدور إصدارات جديدة؟
تشمل أبرز الحالات:
– **الفرق التي تختار نموذجًا أو تستبدله**: لتجنب استبعاد نماذج مرشحة بناءً على انطباعات عن عيوبها قبل عامين
– **الفرق التي تستخدم نماذج اللغة الكبيرة للتقييم ومنح الدرجات**: لأن ميولًا مثل تفضيل النموذج لإجاباته وتأثره بالصياغة لا تزال موجودة
– **التطبيقات التي تتطلب دقة في الحقائق**: إذ تتفاوت نسبة اختلاق المراجع بين نماذج الجيل نفسه من 0% إلى 69%
– **منتجات المحادثة لخدمة العملاء والاستشارات**: لأن الميل إلى مجاملة المستخدم ومسايرته يحتاج إلى مراقبة مستمرة
س5: كيف يمكن إعادة الاختبار على عدة نماذج لغة كبيرة بتكلفة منخفضة؟
الفكرة الأساسية هي توحيد طبقة الوصول، بحيث يسهل «تغيير النموذج فقط، دون تغيير المتغيرات الأخرى»:
1. تفضل بزيارة APIYI على apiyi.com لتسجيل حساب والحصول على مفتاح API
2. تحقق من توفر النماذج المرشحة وإصداراتها في قائمة النماذج الرسمية
3. استخدم المجموعة نفسها من الموجهات والمعلمات، وغيّر معلمة model فقط لاستدعاء النماذج واحدًا تلو الآخر، مع تسجيل النتائج والبيانات الوصفية
بهذه الطريقة، يمكنك تركيز جهودك على تصميم حالات الاختبار بدلًا من تكرار العمل على ربط واجهات مزودين مختلفين.
س6: هل يمكن الاكتفاء بدرجات النماذج الجديدة في قوائم التصنيف بدلًا من إعادة الاختبار؟
لا يُنصح بالاعتماد عليها بالكامل. تُظهر الدراسة أن تاريخ الإصدار والشركة المطوّرة وحجم النموذج لا تتنبأ بشكل موثوق بأدائه في نتائج محددة، وأن الفروق بين النماذج الصادرة في الفترة نفسها قد تكون كبيرة. تصلح قوائم التصنيف للفرز الأولي، لكن القرار النهائي ينبغي أن يستند إلى نتائج إعادة الاختبار باستخدام بيانات عملك.
س7: ما حدود دراسة نماذج اللغة الكبيرة هذه؟
أولًا، لا يمكن الاطلاع على القائمة الكاملة للنتائج الخمسين ومنهجية إعادة اختبارها إلا بالرجوع إلى الورقة البحثية الأصلية، إذ لا تغطي التقارير الثانوية كل التفاصيل. ثانيًا، توجد اختلافات بين متن التقرير والتعليق المرافق للرسم بشأن النتائج المتعلقة بالاستدلال، لذا ينبغي الرجوع إلى النص الأصلي. أخيرًا، ترصد الدراسة بدورها «نماذج محددة في نقطة زمنية محددة»، ووفقًا لمنطق الباحثين أنفسهم، قد تتقادم نتائجها أيضًا بمرور الوقت.
أبرز النقاط حول تقادم نتائج دراسات نماذج اللغة الكبيرة
- نسبة التقادم مرتفعة: من بين 50 نتيجة شائعة حول نماذج اللغة الكبيرة، تقادمت 44% وضعفت صحة 34% منها بوضوح
- مدة صلاحيتها قصيرة: استمرت النتائج التي أمكن تقدير عمرها 15.7 شهرًا في المتوسط، وتقادم نحو أربعين بالمئة منها بعد عامين
- النتائج المتعلقة بنواقص القدرات الأسرع تقادمًا: ينبغي إعطاء الأولوية لإعادة اختبار النتائج المتعلقة بعدّ الحروف والحساب وفقدان المعلومات في السياقات الطويلة
- الميول التفضيلية أكثر استمرارية: ينبغي إدراج تفضيل النموذج لذاته والتملّق وتشابه المخرجات في اختبارات الانحدار طويلة الأمد
- لا يمكن الاستدلال من الشركة أو تاريخ الإصدار: تراوحت نسبة اختلاق المراجع بين 0% و69% لدى نماذج صدرت جميعها في عام 2026
- البيانات الوصفية شرط أساسي: يصعب إعادة إنتاج النتيجة إذا غاب أي من اسم النموذج أو إصداره أو التاريخ أو الموجه
- الواجهة الموحدة تقلل تكلفة إعادة الاختبار: يمكن استخدام APIYI apiyi.com لإجراء مقارنة بين النماذج بتغيير معامل model فقط
الخلاصة
تصبح الاستنتاجات المتعلقة بنماذج اللغة الكبيرة قديمة في غضون 15.7 شهرًا في المتوسط. وتذكّرنا هذه البيانات بما يلي:
- للاستنتاجات مدة صلاحية: ينبغي التعامل مع أي قول عن نموذج لغة كبير على أنه «ملاحظة عن نموذج معين في وقت معين»
- النوع يحدد الأولوية: أعطِ الأولوية لإعادة اختبار أوجه القصور في القدرات، وراقب التفضيلات والميول على المدى الطويل
- الإصدار هو العامل الحاسم: لا يمكن للشركة المطوّرة أو تاريخ الإصدار أو حجم النموذج أن يغني عن الاختبار الفعلي للإصدار المعني
في المرة القادمة التي تسمع فيها خلال اجتماع لاختيار نموذج أن «نموذجًا ما لا يجيد X»، اطرح ثلاثة أسئلة أولًا: أي إصدار؟ ومتى اختُبر؟ وهل لا يزال الموجه متاحًا؟ إذا لم تتوفر الإجابات، فأدرج الأمر في قائمة إعادة الاختبار.
يُنصح باستخدام APIYI على apiyi.com لدمج النماذج المرشحة في سير عمل اختبار موحّد، وإعادة اختبارها سريعًا باستخدام المجموعة نفسها من الموجهات. وتُعتمد القائمة الرسمية لمعرفة النماذج المتاحة.
📚 المراجع
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds: تقرير عن دراسة ستانفورد حول تقادم الاستنتاجات المتعلقة بنماذج اللغة الكبيرة
- الرابط:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
التوضيح: يتضمن بيانات أساسية، منها تقادم 44% من الاستنتاجات، ومتوسط عمرها البالغ 15.7 شهرًا، وحالات اختلاق المراجع، والفروق بين نماذج الجيل نفسه
-
الورقة البحثية الأصلية لـ Owen Queen وJames Zou: دراسة أعاد فيها باحثون من ستانفورد اختبار 50 استنتاجًا حول نماذج اللغة الكبيرة
- الرابط: يُرجى البحث في منصات البحث الأكاديمي باستخدام أسماء المؤلفين وعنوان الورقة
- التوضيح: لم نتمكن من الحصول على النص الكامل للورقة الأصلية؛ يُرجى الرجوع إليها للاطلاع على قائمة الاستنتاجات الخمسين ومنهجية إعادة الاختبار
الكاتب: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ويمكنكم زيارة مركز التوثيق على docs.apiyi.com للاطلاع على مزيد من موارد دمج النماذج