ملاحظة الكاتب: ننطلق من مراجعة تجربة Astra لتعديل أوزان Qwen3.5-0.8B، لنوضح الفرق بين «الإجابة الخاطئة» و«الإجابة غير المكتملة» عند تقييم نماذج التفكير، وكيفية تقسيم النتائج بحسب حدوث اقتطاع للإجابة.
في 2 نوفمبر، نشر أربعة باحثين من مختبر MIT CSAIL تدوينة بعنوان «شرارات البرمجة في فضاء الأوزان». وذكرت التدوينة أن GPT-6 Astra عدّل نحو 0.016% فقط من معاملات Qwen3.5-0.8B، فارتفعت نتيجته في MATH-500 من 7.9% إلى 48.1%، مع ارتفاع كبير أيضًا في GSM8K وIFEval. وسرعان ما انتشر الخبر بوصفه حدثًا بارزًا في «تعديل الذكاء الاصطناعي لعقل ذكاء اصطناعي آخر».
هذا لا يعني التقليل من شأن البحث. يضم المستودع العام للبحث سجلات تفصيلية لكل جولة من أصل 1,125 عملية استدعاء. وعندما أعادت مراجعة صحفية احتساب النتائج وفق سجلات كل مسألة، توصلت إلى استنتاج أكثر تواضعًا: جاءت الزيادة في الدرجات بالكامل تقريبًا من أن «النموذج بات قادرًا أخيرًا على إكمال الإجابة»، وليس من أنه «أصبح أفضل في الرياضيات».
القيمة الأساسية: لا نعيد هنا مناقشة ما إذا كان RSI قد تحقق. بل ننظم نتائج هذه المراجعة في طريقة قابلة لإعادة الاستخدام لتقييم نماذج التفكير، تساعدك عند اختيار النموذج أو ضبط إعداداته أو قبل إطلاقه على تحديد ما إذا كان تغير الدرجات ناتجًا عن اختلاف في القدرات، أم عن اقتطاع الإجابات بسبب الدوران في حلقات متكررة.
نظرة سريعة على أبرز تفاصيل واقعة تقييم نماذج التفكير
لنبدأ بجمع الحقائق الأساسية المتعلقة بالتقييم. تستند البيانات التالية إلى منشور المدونة الأصلي ومراجعات وسائل الإعلام للمستودع العام.
| البند | التفاصيل |
|---|---|
| تاريخ النشر | 2 نوفمبر 2026، على مدونة باحثين من MIT CSAIL |
| النموذج المعدّل | Qwen3.5-0.8B، مع تعديل 131,072 وزنًا، أي نحو 0.016% |
| النتائج المعلنة | MATH-500 من 7.9% إلى 48.1%؛ وGSM8K من 13.8% إلى 67.1%؛ وIFEval من 21.0% إلى 62.3% |
| إعدادات التقييم | تفعيل وضع التفكير، وحد أقصى للمخرجات يبلغ 32,768 رمزًا، ودرجة حرارة 0.6 |
| حالة النموذج الأساسي | نحو 93% من الإجابات بلغت الحد الأقصى دون أن تتوقف |
| الحالة بعد التعديل | انخفضت نسبة الإجابات التي بلغت الحد الأقصى من 93% إلى 33% |
| خلاصة المراجعة | أصلح التعديل مشكلة التكرار في المقام الأول، ولم يحسّن القدرة الرياضية |
كيف يحدث «اقتطاع الإجابات» عند تقييم نماذج التفكير؟
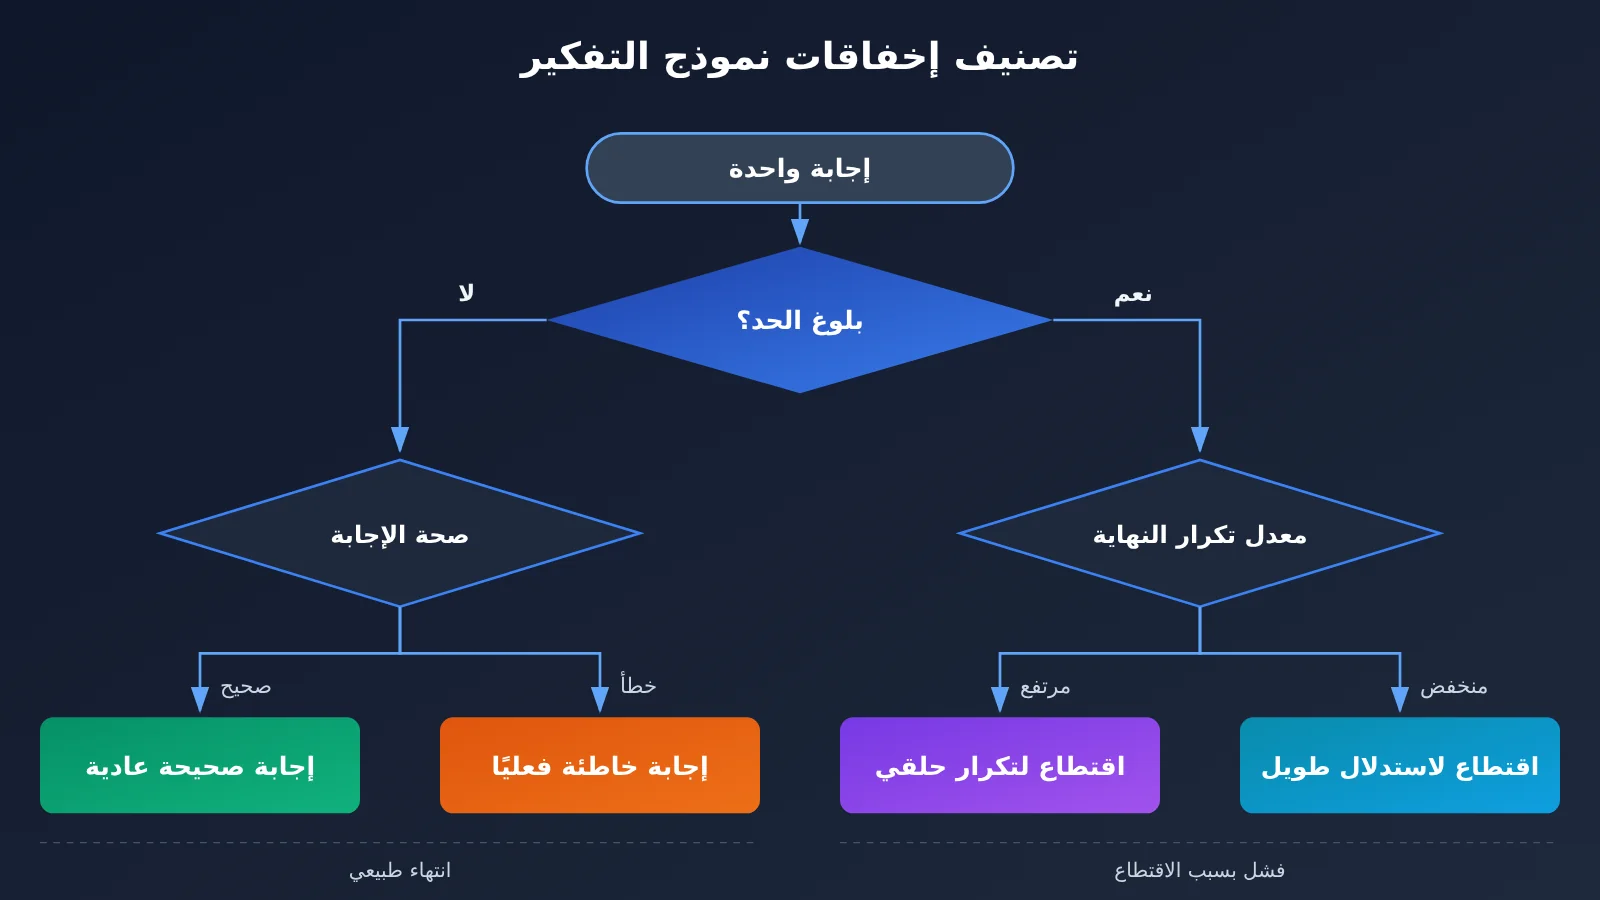
في المرة الأولى، طلب Astra من Qwen حل 96 مسألة تدريبية، فأجاب عن 11 منها فقط إجابة صحيحة. أما المسائل الـ85 المتبقية، فلم تكن المشكلة أنه حلها خطأ، بل إن إجاباتها جميعًا بلغت الحد الأقصى للطول دون أن تتوقف. وعند تحليل نهايات النصوص المقتطعة على شكل مقاطع من ثماني كلمات، تبيّن أن نحو 95% منها محتوى مكرر. أما المسائل الـ11 التي انتهت إجاباتها بصورة طبيعية، فقد أجاب عنها كلها إجابة صحيحة.
يشير ذلك إلى أن السبب الرئيسي لانخفاض نتيجة النموذج الأساسي هو «عدم تسليم الإجابة»، لا «العجز عن الحل». ومن اللافت أن الموجه الذي قدّمه الباحثون إلى Astra في الجولة الأولى أدرج بالفعل «الاقتطاع بسبب بلوغ الحد الأقصى للرموز، وغالبًا ما يكون نتيجة تكرار النموذج لأفكاره» ضمن أنواع الإخفاق، وذكر «إصلاح ما يدفع إلى التكرار» مثالًا على تحسين فعّال. كما أوضح تقرير Astra النهائي أنه استهدف التكرار، وليس المعرفة الرياضية.
تفصيل بيانات تقييم نموذج التفكير: التحسن كله يتركز في المسائل التي اقتُطعت إجاباتها
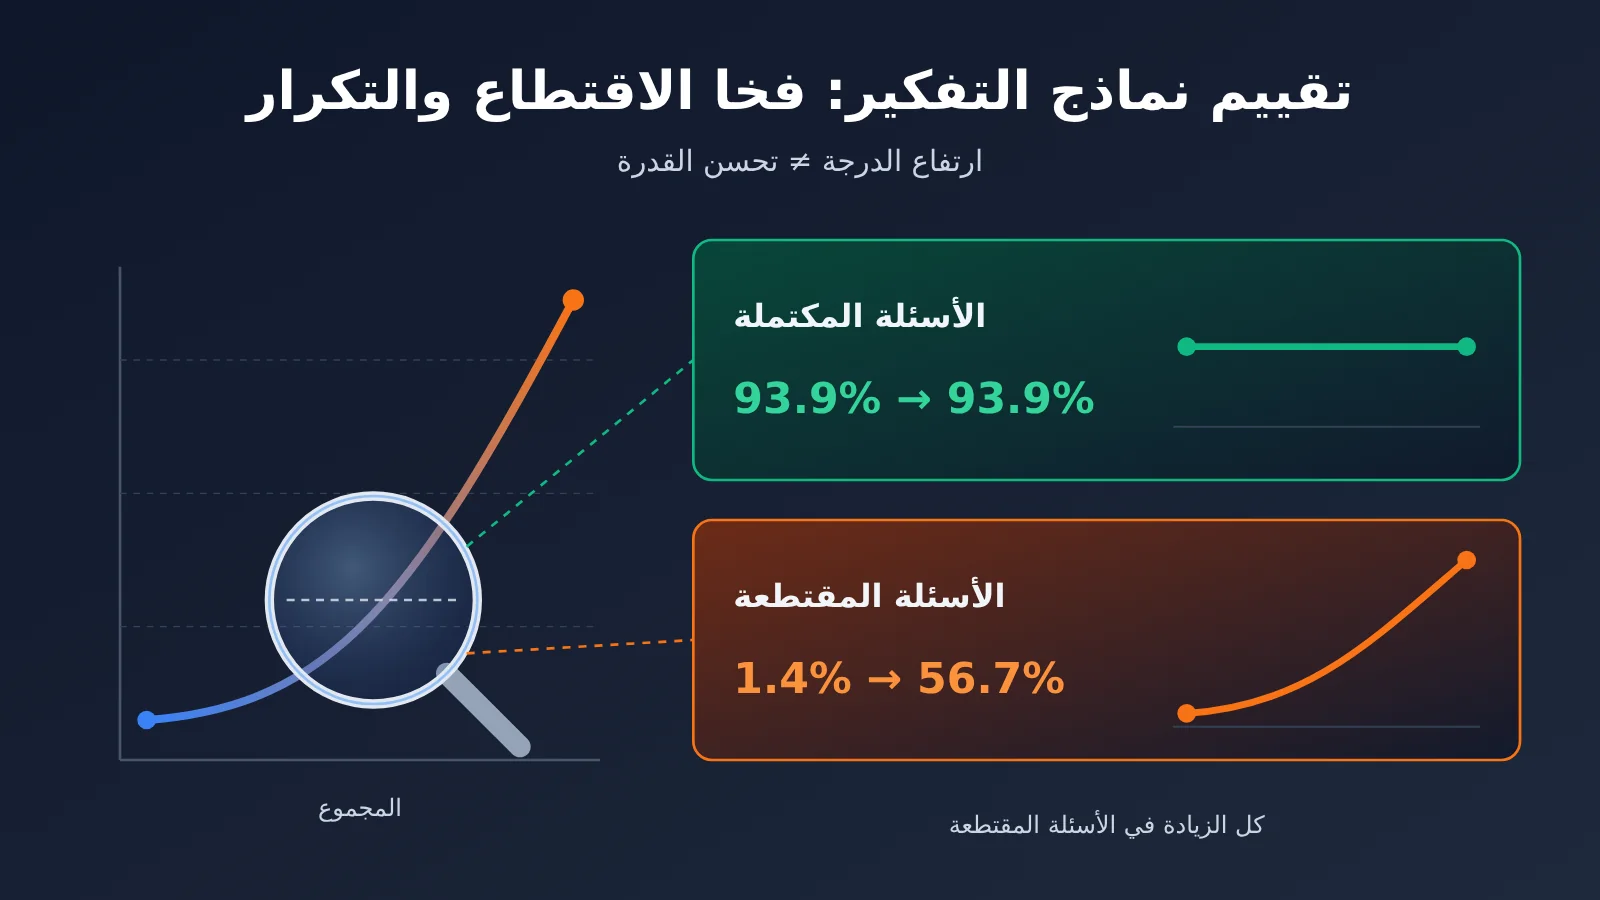
أكثر الأدلة إقناعًا في المراجعة هو اختبار مقارن قبل التعديل وبعده، شمل 1,152 مسألة تدريبية محجوزة للتقييم. وعند تقسيم المسائل إلى مجموعتين بحسب ما إذا كانت الإجابة قد اقتُطعت في الأصل، تتضح النتيجة:
| مجموعة المسائل | العدد | نسبة الإجابات الصحيحة قبل التعديل | نسبة الإجابات الصحيحة بعد التعديل | التغير |
|---|---|---|---|---|
| مسائل كان النموذج يكمل إجابتها أصلًا | 114 | 93.9% | 93.9% | بلا تغيير |
| مسائل اقتُطعت إجاباتها في الأصل | 1,038 | 1.4% | 56.7% | مصدر التحسن كله |
| تحولت من إجابة خاطئة إلى صحيحة | 579 | — | — | منها 576 مسألة اقتُطعت إجاباتها في الأصل |
| تحولت من إجابة صحيحة إلى خاطئة | 5 | — | — | ضمن نطاق التذبذب |
هناك تفصيل آخر يسهل إغفاله: قبل التعديل، لم يكن هناك سوى 7 مسائل أكمل النموذج إجابتها لكنه أخطأ فيها، ثم ارتفع العدد بعد التعديل إلى 245. فقد ظهرت أخطاء النموذج الحسابية الفعلية بعدما توقفت الحلقات المتكررة. وفي اختبار MATH-500 الرسمي، انخفض متوسط طول الإجابة من 30,868 رمزًا إلى 22,037 رمزًا، وتركز الانخفاض أيضًا في الإجابات التي كانت تبلغ الحد الأقصى في الأصل.
التحقق من نتائج تقييم نموذج التفكير باستخدام نموذج للمقارنة
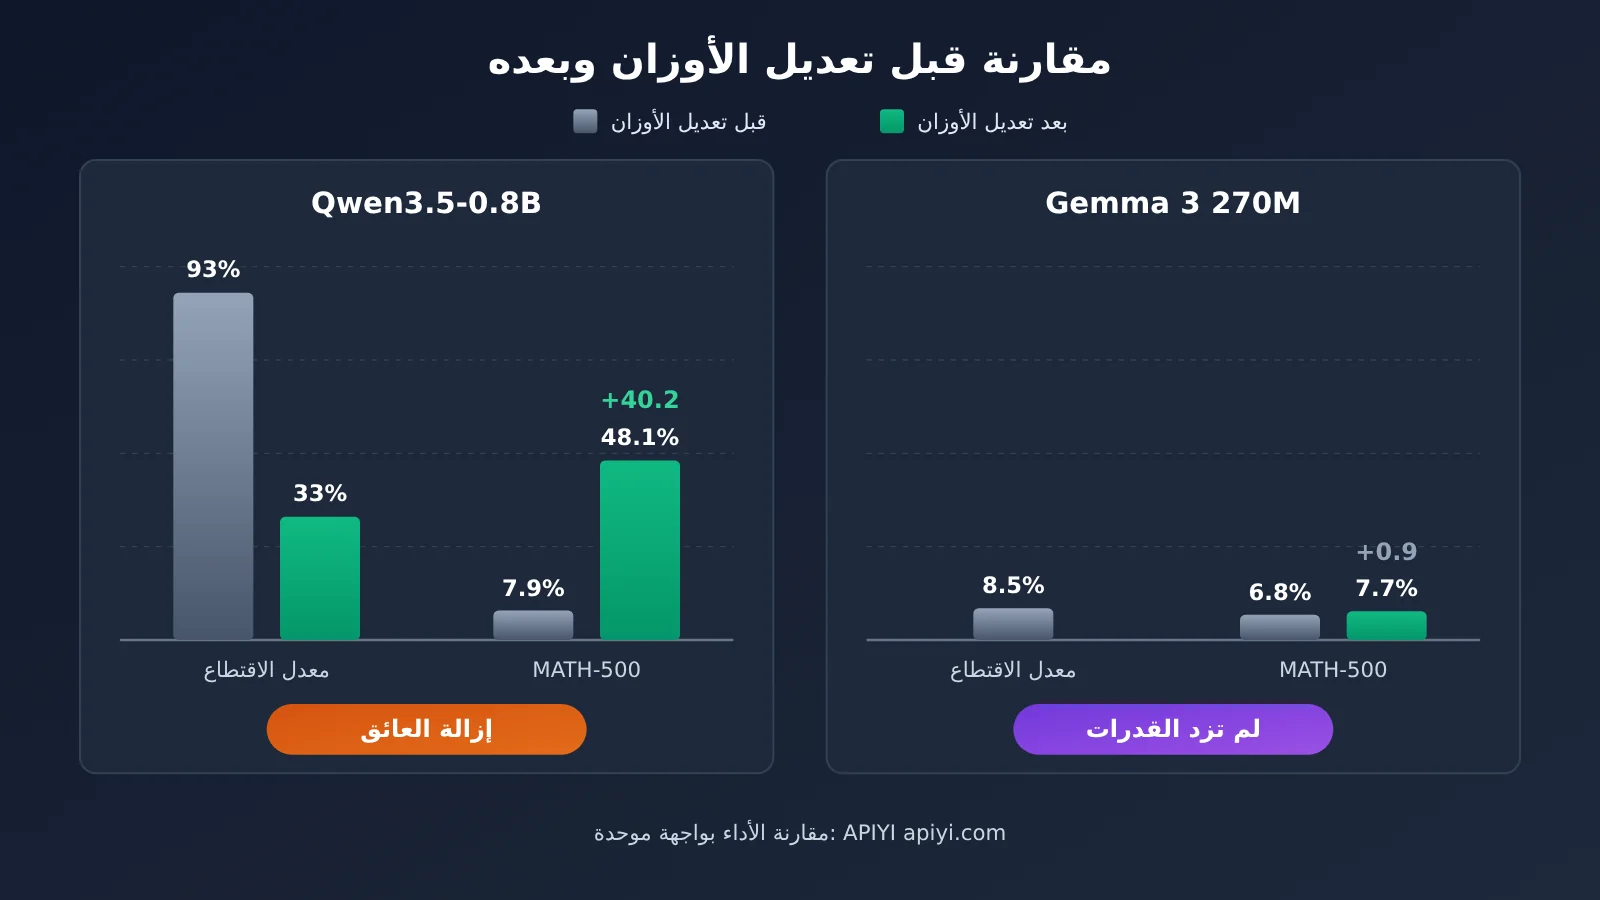
أدرك الباحثون هذه النقطة أيضًا، فأجروا التجربة نفسها على Gemma 3 270M. وتوضح المقارنة بين التجربتين الفرق بين «إزالة عائق» و«إضافة قدرة».
| وجه المقارنة | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| نسبة الإجابات التي بلغت الحد الأقصى | نحو 93% | نحو 8.5% |
| نوع الإخفاق الرئيسي | حلقات متكررة تمنع إكمال الإجابة | أخطاء حسابية وخطوات استدلال غير صحيحة |
| نتيجة MATH-500 بعد تعديل الأوزان | 7.9%→48.1% | 6.8%→7.7% كحد أقصى |
| طبيعة التحسن | إزالة عائق يحجب القدرة | يكاد لا يضيف قدرات لم تكن موجودة أصلًا |
يقر متن التدوينة الأصلية أيضًا بأن تعديل الأوزان يمكنه إزالة العوائق التي تحجب القدرة، لكنه لا يضيف إلى النموذج قدرة لا يمتلكها. وبالنسبة إلى من يقيّم النماذج، تعني هذه العبارة أن «الارتفاع الكبير في النتيجة» قد يحمل دلالات مختلفة تمامًا بحسب طبيعة الإخفاقات.
فخ إعدادات تقييم نماذج التفكير: درجة الحرارة ومفتاح التفكير
هناك نقطة غالبًا ما تُغفل في هذا الجدل: إعدادات التقييم نفسها قد تدفع النموذج إلى الوقوع في حلقة تكرار. فالمعلومات الواردة في بطاقة النموذج الرسمية لـ Qwen3.5-0.8B، التي استندت إليها المراجعة، تختلف عن الإعدادات التي استخدمها الباحث فعليًا.
| الإعداد | ما ورد في بطاقة النموذج | إعداد التقييم التجريبي | التأثير |
|---|---|---|---|
| وضع التفكير | معطّل افتراضيًا في نموذج 0.8B | فُرض تفعيله | يصبح النموذج الصغير أكثر عرضة للوقوع في حلقة تفكير |
| درجة الحرارة (المهام النصية في وضع التفكير) | القيمة الموصى بها 1.0 | 0.6 | القيمة 0.6 مخصصة في بطاقة النموذج لمهام فهم الصور وكتابة الشفرة |
| التوصيات للتعامل مع التكرار | تعديل إعدادات أخذ العينات وإيقاف البث في الوقت المناسب | الاستمرار في التوليد حتى الحد الأقصى البالغ 32,768 رمزًا | صُنّف عدد كبير من الإجابات على أنه فاشل |
تجدر الإشارة إلى أن معلومات بطاقة النموذج أعلاه منقولة عن مراجعة إعلامية، لذا يُنصح بالرجوع مباشرةً إلى بطاقة النموذج الرسمية من Qwen قبل التقييم. والمهم هنا هو المنهجية: قد يتغير «خط الأساس» للنموذج نفسه تمامًا عند تغيير إعدادات أخذ العينات. وإذا قيس خط الأساس بإعدادات تزيد احتمال التكرار، فسيبدو أي تعديل يجعل النموذج «يتوقف» كأنه قفزة كبيرة في قدراته.
قائمة التحقق لتقييم نماذج التفكير: افصل النتائج حسب حالة الاقتطاع قبل استخلاص النتائج
يمكن تلخيص الدروس المستفادة من هذه المراجعة في عملية تقييم تصلح لأي نموذج تفكير. سواء كنت تختار نموذجًا، أو تضبط معلماته، أو تتحقق من أثر تغيير في الضبط الدقيق أو الموجه، يمكنك مراجعة النقاط التالية واحدة تلو الأخرى.
| بند التحقق | الإجراء | مؤشر الحكم |
|---|---|---|
| 1. التقسيم حسب الاقتطاع | احسب نسبة finish_reason == "length"، ثم احسب الدقة لكل مجموعة |
إذا تجاوزت نسبة الاقتطاع 10%، فلا يمكن مقارنة الدرجات الإجمالية مباشرةً |
| 2. فحص معدل التكرار | احسب تكرار n-gram في نهاية الإجابات المقتطعة | ارتفاع معدل التكرار في النهاية يشير إلى حلقة تكرار، لا إلى طول عملية الاستدلال |
| 3. مراجعة معلمات أخذ العينات | قارن درجة الحرارة وtop_p وخيار تفعيل التفكير بما ورد في بطاقة النموذج | إذا اختلفت عن التوصيات الرسمية، فاذكر ذلك بصورة منفصلة |
| 4. المقارنة الزوجية | قارن كل سؤال قبل التغيير وبعده، واحسب عدد الإجابات التي تحولت من خطأ إلى صواب والعكس | إذا تركز التحسن في مجموعة الإجابات المقتطعة، فهو نتيجة «إزالة عائق» |
| 5. المقارنة بين النماذج | أضف نموذجًا للمقارنة بمعدل اقتطاع منخفض، باستخدام الموجه والمعلمات نفسها | إذا لم تتحسن نتائج نموذج المقارنة، فالتحسن لا يشير إلى زيادة في القدرة |
🎯 نصيحة للتقييم: عند المقارنة بين النماذج، من أكثر المهام إزعاجًا كتابة شفرة استدعاء منفصلة لكل نموذج. عبر واجهة APIYI apiyi.com المتوافقة مع OpenAI، يمكنك استخدام السكربت نفسه ومجموعة الموجهات والمعلمات نفسها لاستدعاء نماذج رائدة من عدة مزودين، مما يسهل إخراج «معدل الاقتطاع» كعمود إحصائي ثابت.
سكربت تقييم نماذج التفكير: مثال مبسّط
تحسب الشفرة التالية نسبة الأسئلة التي قُطعت إجاباتها بسبب حد الطول. وتشير القيمة length في finish_reason إلى بلوغ الحد max_tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # استبدله باسم النموذج الفعلي
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
عرض الشفرة الكاملة (بما في ذلك معدل الدقة لكل مجموعة ومعدل التكرار في نهاية النص)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """حساب نسبة تكرار n-gram في نهاية النص (يمكن تقسيم النص الصيني إلى أحرف بدلًا من الكلمات)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)]، وjudge: دالة تتحقق من صحة الإجابة"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
لاحظ أن طريقة تفعيل وضع التفكير أو إيقافه تختلف بين النماذج: فبعضها يستخدم حقلًا في الطلب، وبعضها يميّز الوضع عبر اسم النموذج، وبعضها يحدده في قالب الموجه. كما يختلف احتساب محتوى التفكير ضمن max_tokens وإرجاعه بشكل منفصل من نموذج إلى آخر. احرص على مراجعة وثائق كل نموذج قبل التقييم.
🚀 للبدء بسرعة: إذا أردت التحقق من طريقة التقسيم هذه أولًا، يمكنك التسجيل في APIYI عبر apiyi.com واستخدام رصيد الاختبار المجاني لتجربة نموذجين أو ثلاثة من نماذج التفكير على بضع عشرات من الأسئلة. قارن معدلات القطع أولًا، ثم قرر ما إذا كنت تريد توسيع نطاق التقييم.
تحليل آثار واقعة تقييم نماذج التفكير
التأثير على المطورين
- لم تعد الدرجة الإجمالية وحدها موثوقة: النظر إلى نسبة الإجابات الصحيحة الإجمالية فقط يخلط بين الإجابات غير المكتملة والإجابات الخاطئة. ينبغي أن يتضمن تقرير التقييم قبل الإطلاق عمودين على الأقل: معدل اقتطاع الإجابات ونسبة الإجابات الصحيحة لكل فئة.
- قد يُساء تفسير فوائد ضبط المعلمات: قد يؤدي رفع الحد الأقصى للمخرجات أو تعديل درجة الحرارة أو إضافة عقوبة التكرار إلى تحسن كبير في النتائج. لكن هذا يعني «إزالة عائق»، وليس تغيير النموذج.
- تتأثر بيئة الإنتاج أيضًا: يظهر الاقتطاع أثناء التقييم في بيئة الإنتاج على هيئة استجابات طويلة جدًا وتكاليف خارجة عن السيطرة وانتظار طويل للمستخدمين. وتوصي بطاقة النموذج نفسها بالجمع بين البث التدريجي للمخرجات واكتشاف التكرار والاقتطاع المبكر.
التأثير على أبحاث تقييم النماذج
- ادعاءات «التحسن الكبير» تحتاج إلى أدلة مفصلة: أظهرت هذه المراجعة أن نتيجة تبدو كأنها قفزة في القدرات قد لا تكون سوى إصلاح لخلل، عند تحليلها بحسب الاقتطاع. لذا يجدر التساؤل عن التغير في معدل الاقتطاع عند النظر في أي ادعاء مستقبلي بتحسين نموذج صغير أو نموذج تفكير.
- أهمية أكبر لتصميم مجموعات المقارنة: تشير كل من التجربة الإضافية على Gemma 3 270M وتجربة المقارنة باستخدام اتجاهات عشوائية التي أجرتها Astra بنفسها، والتي لم تتغير فيها النتائج إلا بنحو 1.5 نقطة مئوية، إلى أن تصميم المقارنة أساسي للتمييز بين الإشارة الحقيقية والضوضاء.
الأسئلة الشائعة FAQ
Q1: ما «فخ الاقتطاع» في تقييم نماذج التفكير؟
يحدث عندما يدخل النموذج في حلقة تكرار أثناء التفكير، ويواصل الكتابة حتى يبلغ الحد الأقصى للرموز دون تقديم إجابة، فيصنّف نظام التقييم النتيجة على أنها خطأ. تعكس الدرجة المنخفضة هنا أن النموذج «لم يُكمل الإجابة»، لا أنه «لا يعرف الحل».
Q2: كيف نميّز بين الدرجة المنخفضة بسبب الاقتطاع وتلك الناتجة عن ضعف القدرات؟
قسّم الأسئلة إلى مجموعتين بحسب بلوغها الحد الأقصى، ثم احسب نسبة الإجابات الصحيحة لكل مجموعة على حدة. إذا كانت النسبة مرتفعة في الأسئلة المكتملة وقريبة من الصفر في المجموعة المقتطعة، فالمشكلة هي التكرار. أما إذا كثرت الأخطاء في الأسئلة المكتملة نفسها، فهذا يشير إلى ضعف القدرات. وتُجسّد المقارنة بين Qwen وGemma هاتين الحالتين.
Q3: متى نُشرت تجربة Astra لتعديل Qwen؟
نُشرت التدوينة الأصلية في 2 نوفمبر 2026، ونُشر المقال الإعلامي الذي راجع التجربة استنادًا إلى سجلات المستودع العام في 5 نوفمبر. تستند بيانات هذا المقال إلى تلك المراجعة، ويُنصح بالرجوع إلى المصدر الرسمي لـ Qwen للتحقق من تفاصيل بطاقة النموذج.
Q4: في أي سيناريوهات تصلح طريقة التقييم هذه؟
– **اختيار النموذج**: مقارنة أداء نماذج التفكير المختلفة في مهام الرياضيات أو البرمجة
– **ضبط المعلمات**: تقييم الأثر الفعلي لتغيير درجة الحرارة والحد الأقصى ومفتاح التفكير
– **التحقق من التحسينات**: تحديد ما إذا كان الضبط الدقيق أو الموجهات أو تعديل الأوزان قد حسّن القدرات أم أزال عائقًا فحسب
Q5: كيف نستخدم واجهة موحدة لإجراء تقييم مقارن لعدة نماذج تفكير؟
1. سجّل حسابًا على APIYI عبر apiyi.com واحصل على مفتاح API
2. اضبط base_url في برنامج هذا المقال على `https://api.apiyi.com/v1`
3. ثبّت الموجه ودرجة الحرارة وmax_tokens، وغيّر اسم النموذج فقط، ثم اعرض معدل الاقتطاع ونسبة الإجابات الصحيحة لكل مجموعة
تختلف طريقة تفعيل التفكير بين النماذج، لذا يجب تعديل معلمات الطلب وفقًا لتوثيق كل نموذج.
Q6: ما حدود طريقة التقسيم هذه؟
لا يكشف التقسيم بحسب الاقتطاع إلا عن الإجابات التي «لم تكتمل»، ولا يستطيع تحديد ما إذا كانت الإجابة المكتملة صحيحة بالمصادفة. كذلك يجب ضبط عتبة معدل التكرار في نهاية النص بحسب اللغة والمهمة؛ ويُنصح بتقسيم النص الصيني حسب الأحرف بدلًا من المسافات. بالإضافة إلى ذلك، لا تُرجع بعض النماذج محتوى التفكير كاملًا، لذا يلزم الاستعانة بإحصاءات الرموز في usage. وإذا كانت الميزانية محدودة، يمكنك البدء بتجربة عينة صغيرة عبر APIYI على apiyi.com، ثم توسيع نطاقها بعد التأكد من منهجية الإحصاء.
أهم خلاصات تقييم نماذج التفكير
- مصدر الزيادة: بلغت دقة Qwen في الأسئلة الـ114 التي أكمل الإجابة عنها 93.9% قبل التعديل وبعده؛ وجاءت الزيادة بالكامل من الأسئلة التي اقتُطعت إجاباتها.
- نوع الإخفاق: بلغت 93% من إجابات خط الأساس حدّ الإخراج، وكان نحو 95% من محتوى نهاياتها مكررًا.
- اختلاف المعلمات: استُخدمت درجة حرارة 0.6 في التقييم، بينما توصي بطاقة النموذج بدرجة حرارة 1.0 لنص التفكير.
- دليل المقارنة: كان معدل الاقتطاع منخفضًا لدى Gemma 3 270M، ولم يتحسن أداؤه على MATH-500 بعد تعديل الأوزان إلا بأقل من نقطة مئوية واحدة.
- جوهر المنهج: فصل الإجابات المقتطعة أولًا حسب
finish_reason، ثم مقارنة الدقة. - كيف تبدأ: استخدم واجهة APIYI الموحدة عبر apiyi.com لإحصاء الاقتطاع في عدة نماذج بالمعلمات نفسها.
الخلاصة
يقدّم الجدل حول «تعديل Astra لأوزان Qwen» تنبيهًا لكل من يقيّم نماذج التفكير:
- حلّل الزيادة الكبيرة في النتيجة أولًا: قسّم الإجابات بحسب بلوغها الحد الأقصى للرموز (tokens)، واعرف من أي مجموعة جاءت الزيادة.
- المعلمات جزء من خط الأساس: تحقّق من درجة الحرارة، وتفعيل التفكير، والحد الأقصى للإخراج بالرجوع إلى بطاقة النموذج، وأدرجها في التقرير.
- ميّز بين إزالة عائق وزيادة القدرات: استخدم نموذجًا للمقارنة ذي معدل اقتطاع منخفض للتحقق من طبيعة التحسن.
في المرة المقبلة التي ترى فيها استنتاجًا مثل «هذا التعديل ضاعف النتائج عدة مرات»، اطرح سؤالًا أولًا: كم تغيّر معدل الاقتطاع؟ غالبًا ما يكشف هذا السؤال الحقيقة أكثر من النتيجة الإجمالية.
إذا كنت تستعد لتقييم عدة نماذج تفكير قبل إطلاقها، فنوصي باستخدام APIYI عبر apiyi.com لإجراء إحصاء لمعدلات الاقتطاع باستخدام السكربت والمعلمات نفسيهما، ثم تحديد النموذج المناسب.
📚 المراجع
- مقالة مراجعة من 硅星人 Pro (أعاد 36氪 نشرها): الضجة حول «تعديل Astra لعقل Qwen» لا ترتبط كثيرًا بتحسين الذات التكراري (RSI) الذي نطمح إليه
- الرابط:
36kr.com/p/4056494372181124 -
التوضيح: بيانات اختبارات مزدوجة أُعيد حسابها اعتمادًا على سجلات كل مسألة في المستودع العام، وهي المصدر الرئيسي لبيانات هذا المقال
-
مدونة باحثي MIT CSAIL: Sparks of Weight-Space Programming
-
التوضيح: الوصف الأصلي للتجربة وجداول النتائج. يُنصح بمراجعة إعدادات التجربة 8 في النص الأصلي
-
بطاقة النموذج الرسمية لـ Qwen3.5-0.8B: شرح معلمات أخذ العينات ووضع التفكير
- التوضيح: للتحقق من الحالة الافتراضية لوضع التفكير، ودرجة الحرارة الموصى بها، وتوصيات التعامل مع التكرار
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يُرجى التواصل معنا عبر الموقع الرسمي لـ APIYI على apiyi.com. ولمزيد من إرشادات الاستخدام، تفضل بزيارة مركز التوثيق على docs.apiyi.com