أفاد عدد متزايد من المطورين مؤخراً بتجربة تبدو «غير بديهية»: إذ إن claude-opus-5-5 لا يبدو بطيئاً إطلاقاً، بل ينهي في كثير من المهام العمل قبل claude-sonnet-5-5. وإذا كان النموذج الرائد أسرع وأقوى، فهل لم يتبقَّ لـ Sonnet سوى ميزة واحدة هي «أنه أرخص إلى النصف»؟ الإجابة ليست بهذه البساطة. سنفكك في هذا المقال الفروقات الحقيقية بين claude-sonnet-5-5 وclaude-opus-5-5 بالاستناد إلى 6 مجموعات من البيانات العامة، مع التركيز على سؤال أكثر واقعية: كيف ينبغي توزيع الأدوار والجمع بين النموذجين في سيناريوهات الوكلاء (Agent) المؤسسية التي تتضمن إدخالات ومخرجات طويلة؟
القيمة الأساسية: بعد قراءة هذا المقال، ستعرف السبب الحقيقي وراء «سرعة» Opus، والمزايا العملية القوية التي يمتلكها Sonnet إلى جانب السعر، وبنية وكيل ثنائية النماذج Opus + Sonnet يمكن تطبيقها مباشرة.
نظرة سريعة على المعلمات الأساسية لـ claude-sonnet-5-5 وclaude-opus-5-5
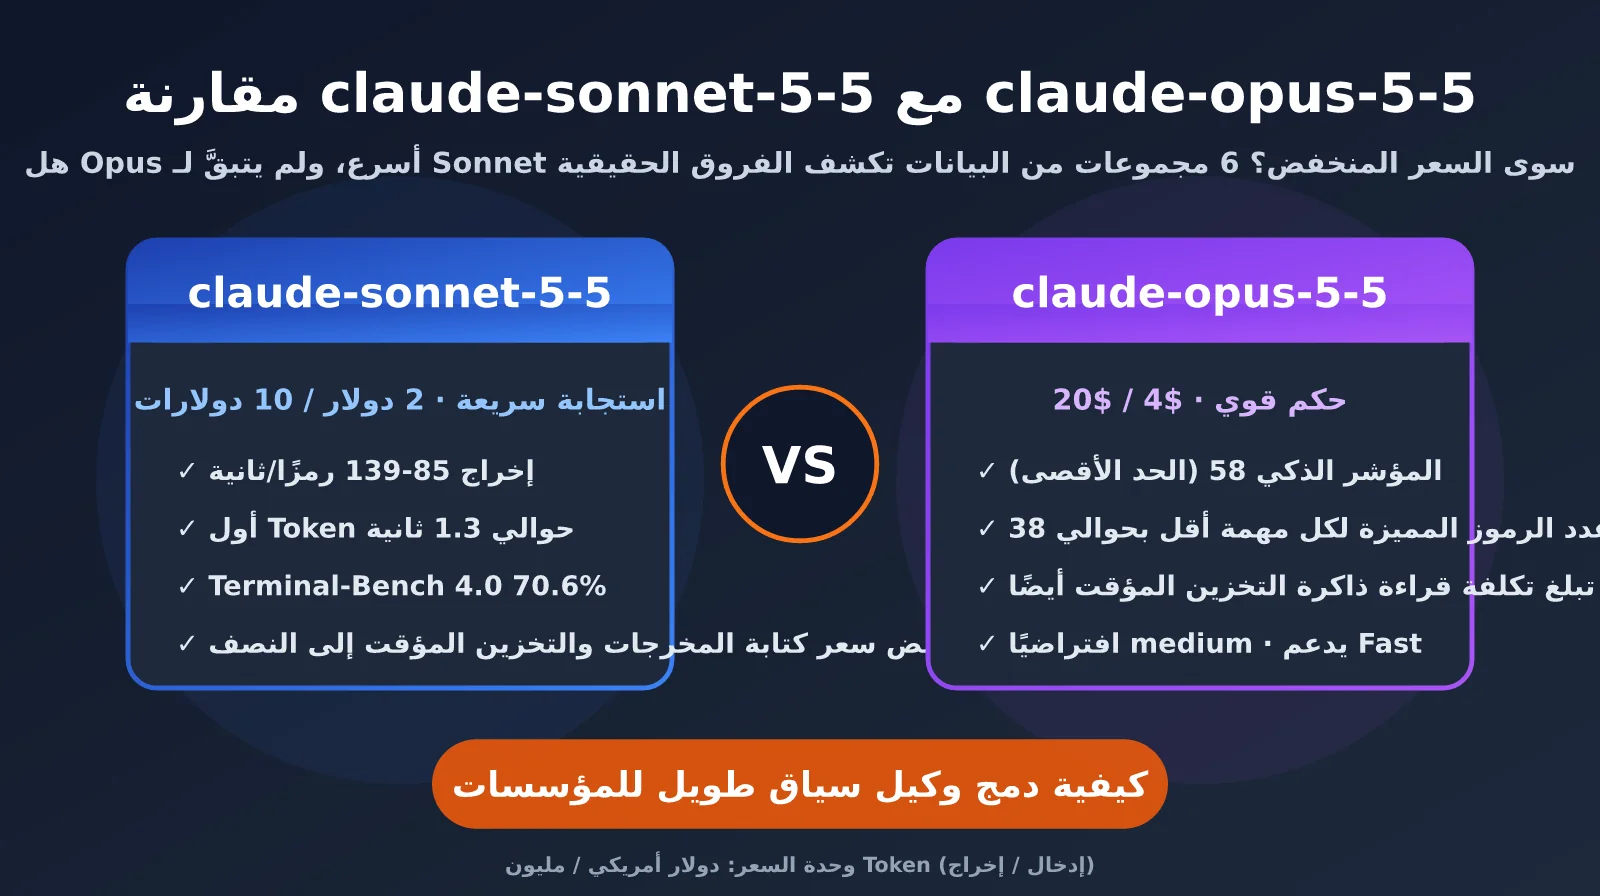
صدر claude-opus-5-5 في 22 سبتمبر 2026، بينما صدر claude-sonnet-5-5 في 28 سبتمبر، وكلاهما ينتمي إلى عائلة Claude 5.5. وأبرز تغيير يستحق الاهتمام في هذا الجيل هو أن سعر Opus انخفض: انخفض السعر المعلن من $5/$25 في Opus 5 بنسبة 20% إلى $4/$20، كما انخفض سعر قراءة ذاكرة التخزين المؤقت من $0.50 إلى $0.20، ليصبح مطابقاً تماماً لـ Sonnet. أما Sonnet 5.5 فحافظ على تسعير $2/$10، وتذكر الجهة الرسمية أن تكلفة المهمة الواحدة فيه أقل بما يصل إلى نحو 30% مقارنة بالجيل السابق.
| المعلمة | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| تاريخ الإصدار | 2026-09-28 | 2026-09-22 |
| سعر الإدخال / الإخراج | $2 / $10 | $4 / $20 |
| قراءة ذاكرة التخزين المؤقت | $0.20 | $0.20 (5% من سعر الإدخال الأساسي) |
| كتابة ذاكرة التخزين المؤقت لمدة 5 دقائق | $2.50 | $5 |
| سعر Batch | $1 / $5 | $2 / $10 |
| نافذة السياق | مليون Token، دون تكلفة إضافية للسياق الطويل | مليون Token، دون تكلفة إضافية للسياق الطويل |
| الحد الأقصى للإخراج | 128K (300K في النسخة التجريبية من Batch) | 128K (300K في النسخة التجريبية من Batch) |
| مستوى الاستدلال الافتراضي في API | high | medium |
| وضع Fast | غير مدعوم | مدعوم، بسرعة إخراج تقارب 2.5 ضعف، $8 / $40 |
| المنصات المتاحة | APIYI apiyi.com، وواجهة Anthropic API الرسمية | APIYI apiyi.com، وواجهة Anthropic API الرسمية |
يخفي الجدول تفصيلين يؤثران مباشرة في التجربة. أولاً، يختلف مستوى الاستدلال الافتراضي بين النموذجين: إذ يستخدم Opus مستوى medium افتراضياً، بينما يكون الإعداد الافتراضي لـ Sonnet في API هو high، وهذا هو السبب الرئيسي الذي يجعل كثيرين يشعرون بأن Opus أسرع. ثانياً، سعر قراءة ذاكرة التخزين المؤقت متطابق، ما يعني أن فارق تكلفة الإدخال بينهما يتقلص بدرجة كبيرة في سيناريوهات الوكلاء التي تعيد استخدام سياقات طويلة بكثافة.
🎯 اقتراح للاختبار: عند مقارنة النموذجين، احرص دائماً على تحديد مستوى الاستدلال نفسه صراحةً، وإلا ستصبح النتائج مضللة بدرجة كبيرة. نوصي باستخدام مفتاح واحد عبر APIYI apiyi.com لاستدعاء
claude-sonnet-5-5وclaude-opus-5-5كلٌّ على حدة؛ إذ يكفي تبديل معامليmodelوreasoning_effortفقط لإجراء اختبار مقارنة منضبط.
لماذا يبدو claude-opus-5-5 أسرع من claude-sonnet-5-5؟
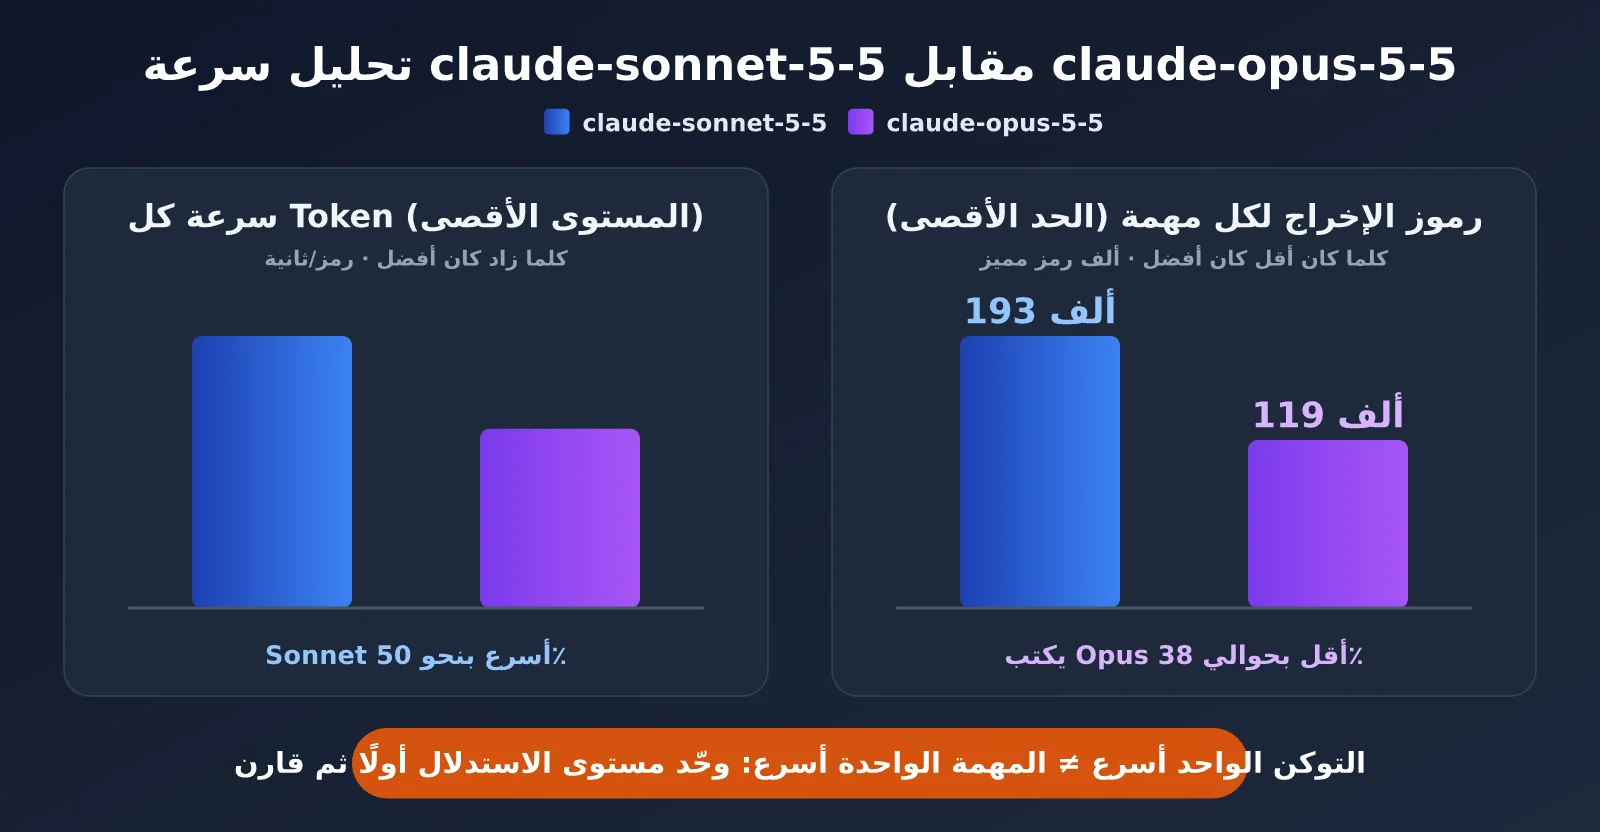
من حيث سرعة التوليد البحتة، فإن claude-sonnet-5-5 أسرع بوضوح في الواقع. تُظهر قياسات Artificial Analysis أن سرعة إخراج Sonnet 5.5 تتراوح بين 85 و139 رمز Token في الثانية باختلاف مستويات الاستدلال، مقابل 74 إلى 93 رمز Token في الثانية لـ Opus 5.5. كما تصنّف Anthropic رسميًا زمن استجابة Sonnet بأنه «سريع»، وOpus بأنه «متوسط». فمن أين يأتي الانطباع بأن «Opus أسرع»؟ هناك ثلاثة أسباب رئيسية.
السبب الأول: الإعدادات الافتراضية مختلفة، وSonnet يفكر بدرجة إضافية افتراضيًا
خفض Opus 5.5 مستوى API الافتراضي من high في الجيل السابق إلى medium. وتقول الشركة إن مستوى medium فيه يوازي أو يتجاوز مستوى high في Opus 5. أما الإعداد الافتراضي لـ API في Sonnet 5.5 فما زال high، ولا يمكن تعطيل وضع التفكير فيه. وقد وجدت اختبارات مستقلة أن عدد رموز الإخراج في Sonnet عند مستوى high يبلغ قرابة ضعف medium، من دون تحسن ملحوظ في الجودة. لذلك، إذا استدعيت النموذجين مباشرة بالإعدادات الافتراضية، فإن Sonnet يكون عمليًا «يفكر بدرجة إضافية»، ومن الطبيعي أن يستغرق وقتًا أطول.
السبب الثاني: كفاءة Opus في استخدام الرموز أعلى
في اختبار مؤشر الذكاء لدى Artificial Analysis، أنتج Sonnet 5.5 عند مستوى max متوسطًا يقارب 193 ألف رمز لكل مهمة، وهو أعلى رقم رصدته المؤسسة؛ بينما أنتج Opus 5.5 في المستوى نفسه نحو 119 ألف رمز. السرعة الأعلى لكل رمز لا تعني بالضرورة سرعة أعلى لكل مهمة. فقد يخرج Sonnet رموزًا أكثر بنحو 50% كل ثانية، لكن إذا احتاج إلى كتابة محتوى أكثر بنسبة 60%، فقد يعادله Opus في زمن التنفيذ من البداية إلى النهاية، أو يتجاوزه.
السبب الثالث: وضع Fast متاح حصريًا لـ Opus
يدعم Opus 5.5 وضع Fast ضمن معاينة بحثية، حيث يستخدم النموذج نفسه إعداد استدلال أسرع يمكنه رفع سرعة الإخراج إلى نحو 2.5 مرة، بسعر $8/$40. إذا فعّلت وضع Fast لـ Opus في أداة برمجة، فسيزداد انطباعك بأن «Opus سريع» بشكل أكبر. لكن يجب الانتباه إلى أن وضع Fast يرفع فقط عدد رموز الإخراج في الثانية، ولا يحسن زمن وصول أول رمز، كما أنه لا يشارك ذاكرة التخزين المؤقت للموجهات مع السرعة القياسية.
| مقياس السرعة | claude-sonnet-5-5 | claude-opus-5-5 | ملاحظات |
|---|---|---|---|
| سرعة الإخراج (رمز Token/ثانية) | 85-139 | 74-93 | Sonnet أسرع لكل رمز |
| رموز الإخراج لكل مهمة (مستوى max) | نحو 193 ألفًا | نحو 119 ألفًا | Opus أكثر كفاءة في استخدام الرموز |
| زمن وصول أول رمز (المستويات المنخفضة) | نحو 1.3 ثانية (medium) |
نحو 14.3 ثانية (low) |
Sonnet يبدأ الاستجابة أسرع |
| تصنيف زمن الاستجابة الرسمي | سريع | متوسط | من صفحة نماذج Anthropic |
| مدة مهام برمجية فعلية (جهة خارجية) | 29 دقيقة و27 ثانية | 44 دقيقة و50 ثانية | Sonnet أسرع بنحو 1.5 مرة |
الخلاصة: قد ينفذ Opus بسرعة أكبر عند استخدام الإعدادات الافتراضية، لكن عند ضبط كلا النموذجين على المستويات المناسبة، يبقى Sonnet متفوقًا بوضوح في سرعة الاستجابة. وينطبق ذلك خصوصًا على زمن وصول أول رمز؛ إذ يبدأ Sonnet بالإخراج بعد نحو 1.3 ثانية في مستوى medium، وهذا عامل حاسم لوكلاء Agent التفاعليين الموجهين للمستخدمين.
هل يملك claude-sonnet-5-5 ميزة السعر فقط؟ مقارنة بيانات القدرات
لنبدأ برقم قد يبدو مفاجئًا: عند مستوى max، ليس Sonnet أرخص من Opus بالضرورة. عند تشغيل مجموعة مؤشر الذكاء الكاملة لدى Artificial Analysis، بلغت تكلفة Sonnet 5.5 (max) نحو $8,977، مقابل نحو $8,708 لـ Opus 5.5 (max). أي إن Opus كان أقل تكلفة قليلًا وحقق نتيجة أعلى أيضًا: 58 مقابل 56. والسبب هو كفاءة استخدام الرموز التي ذكرناها سابقًا. لذلك، إذا كنت تستخدم Sonnet عند مستوى max فقط، فقد لا تحصل حتى على ميزة سعرية.
فأين تكمن قيمة Sonnet إذًا؟ يعرض الجدول التالي نتائج النموذجين في مؤشر الذكاء بحسب مستوى الاستدلال، ويوضح طريقة استخدامه الأنسب:
| مستوى الاستدلال | مؤشر ذكاء claude-sonnet-5-5 | مؤشر ذكاء claude-opus-5-5 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
في الذكاء الشامل، يتفوق Opus في جميع مستويات الاستدلال المتطابقة. كما أن أفضليته أوضح في مؤشرات المجالات المتخصصة مثل الدقة الواقعية (AA-Omniscience: 66% مقابل 54%)، والقانون، والمالية، والاستراتيجية. لكن Sonnet يمتلك مزايا عملية قوية لا يمكن لـ Opus استبدالها في الجوانب التالية:
- برمجة الوكلاء عبر الطرفية: في Terminal-Bench 4.0، حقق Sonnet عند
maxنسبة 70.6%، متقدمًا على Opus عندxhighبنسبة 66.4%. لكن عند مستوىxhighنفسه، يبقى Opus متفوقًا بنسبة 66.4% مقابل 61.5%؛ أي إن Sonnet يحتاج إلى أعلى إعداداته ليتجاوزه. - زمن الاستجابة: زمن وصول أول رمز وسرعة الإخراج في الثانية أفضل بوضوح، ما يجعله مناسبًا للتفاعل الفوري وسيناريوهات الواجهة الأمامية ذات الإخراج المتدفق.
- الإدخال غير الموجود في التخزين المؤقت وكتابة التخزين المؤقت: سعر كل منهما نصف سعر Opus فقط، لذا فهو أنسب للمهام ذات الإدخالات الطويلة لمرة واحدة، مثل المستندات الجديدة في كل طلب.
- المخرجات الطويلة والمعالجة الدفعية: سعر الإخراج هو $10 مقابل $20، وفي المعالجة الدفعية يصبح $5 مقابل $10، ما يضاعف ميزة التكلفة مباشرة عند توليد تقارير أو مستندات طويلة على نطاق واسع.
- التنفيذ عالي التوازي: وفق تموضع Anthropic الرسمي، يُعد Sonnet الشريك الأسرع والأقل تكلفة لـ Opus، وهو مناسب لتشغيل عدد كبير من المهام الفرعية الواضحة بالتوازي كوكيل فرعي.
في معايير عامة أخرى، يتقدم Opus بنحو نقطتين في CursorBench 4.0 (57.8% مقابل 55.5%)، وFrontierCode 1.1 (54.4% مقابل 52.1%)، وOSWorld 2.1 (81.8% مقابل 80.1%). أما في ProgramBench، وهو اختبار مجمع من جهة خارجية لإعادة بناء البرامج ضمن سياقات طويلة، فقد سجل Opus نسبة 91.2% مقابل 79.7% لـ Sonnet، مع اتساع ملحوظ في الفارق. وهذا يعني أن أفضلية Opus تزداد كلما تطلبت المهمة أحكامًا دقيقة ضمن نافذة سياق فائقة الطول.
💡 إرشاد للاختيار: الاستخدام الأنسب لـ Sonnet يكون بين مستويي
mediumوxhigh، باعتباره «منفذًا»؛ بينما يناسب Opus دور «صانع القرار» بدءًا من مستوىmedium. وإذا أردت التحقق من الفروق في نشاطك، يمكنك تشغيل مهمة المستندات الطويلة نفسها مع النموذجين عبر APIYI apiyi.com، ثم مقارنة جودة النتائج والتكلفة الفعلية.
التكلفة الفعلية لسيناريوهات Agent المؤسسية ذات السياق الطويل
يتضمن الحمل النموذجي لـ Agent في الشركات: عقودًا أو مستودعات شيفرة أو قواعد معرفة يصل حجمها بسهولة إلى مئات الآلاف من الرموز المميزة (Token) في المدخلات، بينما تشمل المخرجات تقارير مطوّلة أو إعادة صياغة دفعات كبيرة أو شيفرة موزعة على ملفات متعددة. وبما أن كلا النموذجين يدعمان سياقًا يصل إلى مليون رمز مميز من دون رسوم إضافية للسياق الطويل، فإن العاملين الحاسمين فعليًا في التكلفة هما معدل إصابة ذاكرة التخزين المؤقت وطول المخرجات. يقدّر الجدول التالي بعض السيناريوهات النموذجية وفقًا للأسعار الرسمية (يُقدَّر Sonnet بنحو 1.6 ضعف رموز مخرجات Opus، بما يعكس فرق كفاءة الرموز بينهما في إعداد max):
| السيناريو | مكونات الحمل | claude-sonnet-5-5 | claude-opus-5-5 | نسبة التكلفة |
|---|---|---|---|---|
| أسئلة متابعة متعددة الجولات بسياق طويل | سياق من 500 ألف رمز، إصابة ذاكرة مؤقتة بنسبة 95%، و25 ألف رمز جديد للكتابة | نحو $0.28 (مخرجات 12 ألف رمز) | نحو $0.37 (مخرجات 7.5 ألف رمز) | 1 : 1.3 |
| التحميل الأولي لمستند طويل | كتابة 500 ألف Token في ذاكرة مؤقتة لمدة 5 دقائق + 10 آلاف رمز مخرجات | نحو $1.35 | نحو $2.70 | 1 : 2 |
| إنشاء تقرير مطوّل | 50 ألف رمز إدخال + 50 ألف رمز مخرجات (نفس حجم المخرجات) | نحو $0.60 | نحو $1.20 | 1 : 2 |
| إنشاء دفعات دون اتصال | وضع Batch، 100 ألف رمز لكل من الإدخال والإخراج | نحو $0.60 | نحو $1.20 | 1 : 2 |
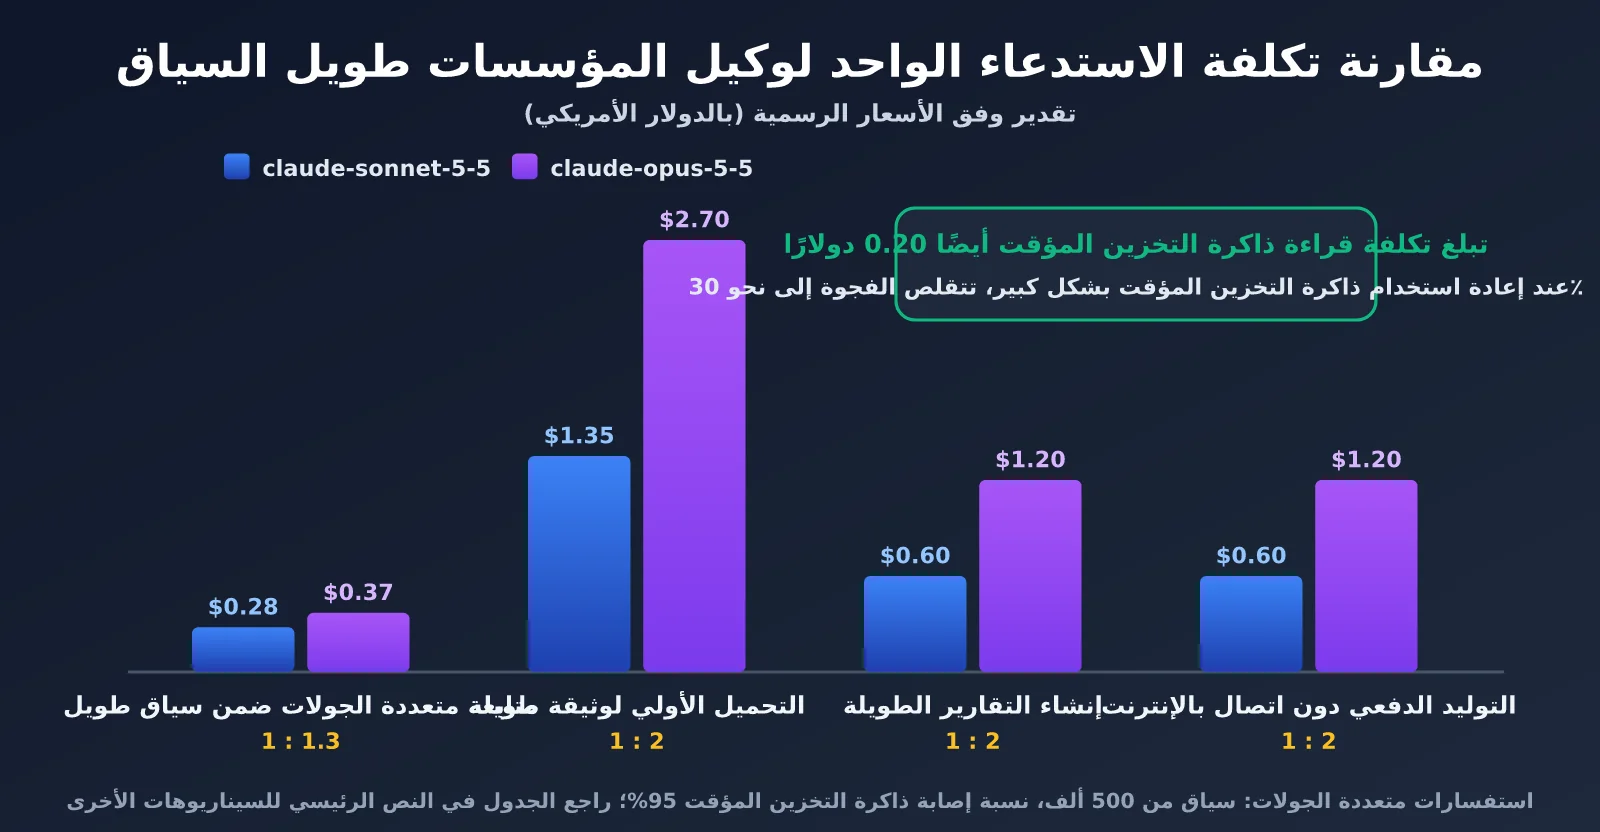
يكشف هذا الجدول قاعدة مهمة جدًا: في أسئلة المتابعة متعددة الجولات التي تجمع بين «مدخلات طويلة + إصابة مرتفعة للذاكرة المؤقتة + مخرجات قصيرة»، تكون تكلفة Opus أعلى من Sonnet بنحو 30% فقط. ويرجع ذلك إلى أن الجزء الأكبر من التكلفة، أي قراءة الذاكرة المؤقتة، له السعر نفسه في النموذجين، كما أن Opus يستهلك رموز مخرجات أقل. أما في سيناريوهات «التحميل الأول لمستند جديد» و«إنشاء مخرجات طويلة»، فتعود أفضلية Sonnet في التكلفة إلى مستواها الكامل، أي نحو النصف. بعبارة أخرى، يناسب Opus مهام «إعادة قراءة المادة الطويلة نفسها مرارًا وإصدار الأحكام بناءً عليها»، بينما يناسب Sonnet مهام «استيعاب مادة جديدة دفعة واحدة» أو «إنشاء كميات كبيرة من المحتوى».
هناك تفصيل آخر يسهل الوقوع في خطئه: لا يمكن مشاركة ذاكرة الموجه المؤقتة بين النماذج. فإذا قرأ Opus مستندًا حجمه 500 ألف Token مرة واحدة، ثم قرأه Sonnet لاحقًا، فيجب دفع تكلفة كتابة الذاكرة المؤقتة مرتين، كلٌّ على حدة. لذلك، يتمثل جوهر بنية النموذجين في إبقاء السياق الطويل «مقيمًا» قدر الإمكان لدى نموذج واحد، مع إرسال ملخصات مهام مختصرة فقط إلى النموذج الآخر.
خطة مناسبة للجمع بين claude-sonnet-5-5 و claude-opus-5-5
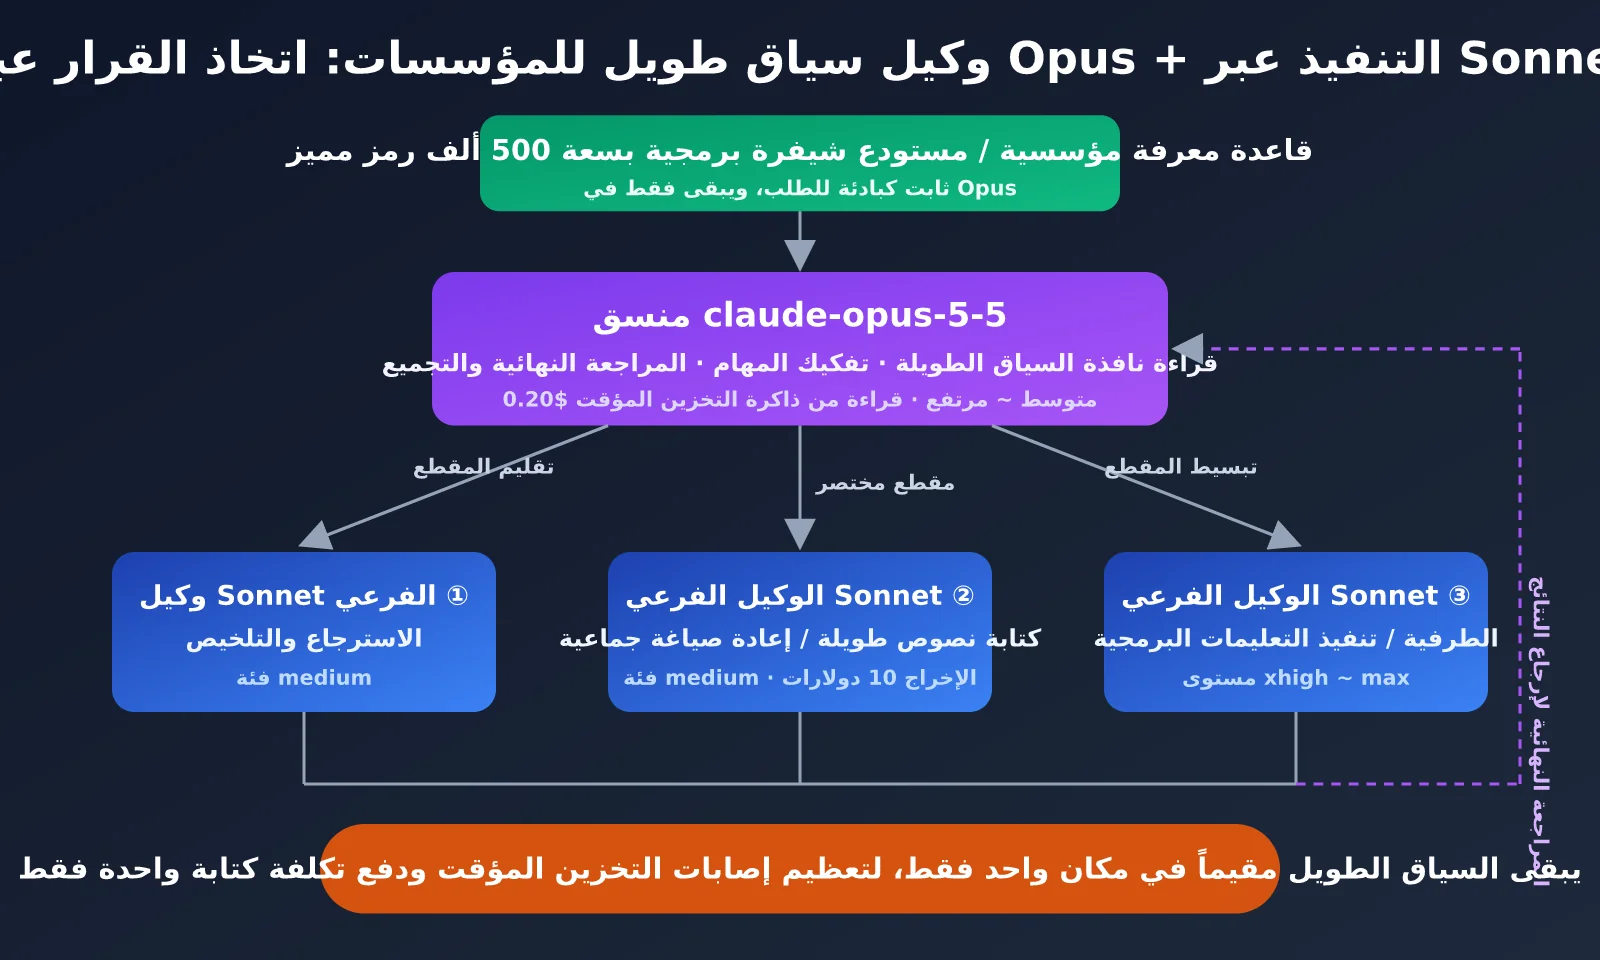
استنادًا إلى البيانات أعلاه، نوصي بأن يعتمد Agent المحتوى الطويل للمؤسسات بنيةً طبقية تقوم على مبدأ: يتخذ Opus القرارات، وينفذ Sonnet. وتنقسم هذه البنية إلى نمطين بحسب الجهة التي تحتفظ بنافذة السياق الطويلة.
النمط الأول: تنسيق Opus + وكلاء Sonnet فرعيون متوازيون
يناسب السيناريوهات التي تتطلب أحكامًا معقدة بالاستناد إلى مواد طويلة، مثل مراجعة العقود، وترحيل الشيفرة بين مستودعات متعددة، والعناية الواجبة. يحتفظ Opus بالسياق الطويل الكامل — مع الاستفادة من ذاكرة التخزين المؤقت على المدى الطويل — ويتولى فهم الصورة الكاملة، وتفكيك المهام، وتوزيعها على عدة وكلاء Sonnet فرعيين. يحصل كل Sonnet على الجزء الصغير الخاص به من المواد وتعليمات واضحة، ثم ينفذ بسرعة وبالتوازي عند مستوى medium. وأخيرًا، يجمع Opus النتائج ويجري المراجعة النهائية.
في هذا النمط، تُدفع تكلفة تخزين السياق الطويل المكلفة مرة واحدة فقط، بينما يتولى Sonnet إنتاج المقاطع النصية الطويلة مستفيدًا من سعر الإخراج الأقل إلى النصف.
النمط الثاني: Sonnet في الواجهة + تصعيد احتياطي إلى Opus
يناسب السيناريوهات التفاعلية ذات الزيارات الكثيفة، مثل أسئلة وأجوبة قاعدة المعرفة المؤسسية، ووكيل خدمة العملاء، ومساعد تكنولوجيا المعلومات الداخلي. يحتفظ Sonnet بالسياق الطويل، ويقدم استجابة لأول Token في نحو ثانية واحدة عند مستوى medium. وعند مواجهة طلب منخفض الثقة، أو يتضمن حكمًا متعلقًا بالامتثال، أو عندما يعبّر المستخدم بوضوح عن عدم رضاه، يُصعَّد السؤال المختصر والمقاطع الأساسية إلى Opus لمعالجتها.
يتعامل Sonnet مع معظم الزيارات بتكلفة منخفضة، ولا يُستدعى Opus إلا لعدد محدود من الطلبات الصعبة.
| دور Agent | النموذج الموصى به | المستوى الموصى به | السبب |
|---|---|---|---|
| المنسق / المخطط | claude-opus-5-5 | medium ~ high | ذكاء شامل ودقة أعلى في الحقائق، وكفاءة جيدة في استخدام Token |
| تحليل السياق الطويل والمراجعة النهائية | claude-opus-5-5 | high ~ xhigh | تفوق واضح في إصدار أحكام دقيقة ضمن السياقات الطويلة |
| كتابة النصوص الطويلة / إعادة الصياغة المجمعة | claude-sonnet-5-5 | medium | سعر الإخراج أقل إلى النصف، وسرعة إخراج أعلى في الثانية |
| Agent فرعي لتنفيذ الأوامر الطرفية / الشيفرة | claude-sonnet-5-5 | xhigh ~ max | أفضل نتيجة عند المستوى الكامل في Terminal-Bench |
| واجهة المحادثة الفورية | claude-sonnet-5-5 | medium | زمن استجابة أول Token يقارب 1.3 ثانية |
| المعالجة الدفعية غير المتصلة | claude-sonnet-5-5 | medium | Batch بسعر $1/$5، مع دعم مخرجات طويلة حتى 300K |
تنفيذ تنسيق Opus + تنفيذ Sonnet عبر الواجهة نفسها
فيما يلي مثال مبسط جدًا للنمط الأول. يستخدم واجهة متوافقة مع OpenAI، ويشترك النموذجان في مفتاح واحد:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
عرض المثال الكامل: وكلاء فرعيون متوازيون + بادئة ثابتة للسياق الطويل
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 长文档固定放在 system 前缀,只驻留在 Opus 上,便于多轮命中缓存
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Sonnet 子 Agent 只接收精简片段,并行执行
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. 回到 Opus 终审,复用同一长上下文前缀
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 ابدأ بسرعة: تفرض حسابات Claude الرسمية متطلبات مرتفعة على منطقة التسجيل ووسيلة الدفع، وغالبًا ما تواجه فرق الشركات عوائق في مرحلة التفعيل. يمكنك أولًا التسجيل في APIYI عبر apiyi.com للحصول على رصيد تجريبي، ثم استخدام مفتاح واحد لاستدعاء كل من claude-opus-5-5 وclaude-sonnet-5-5، وتشغيل بنية النموذجين أعلاه قبل تقييم تكلفة التوسع.
توصيات لاتخاذ القرار بين claude-sonnet-5-5 وclaude-opus-5-5
يمكن تلخيص التحليل السابق في 4 مبادئ قابلة للتنفيذ:
- حدّد مستوى الأداء قبل مقارنة النماذج: استخدم Sonnet بمستوى
medium~xhigh، وOpus بمستوىmedium~high، لتجنب هدر الـToken الناتج عن استخدام Sonnet افتراضيًا بمستوىhigh. - استخدم Opus للسياق الطويل ذي إعادة استخدام التخزين المؤقت العالية: تكلفة قراءة التخزين المؤقت متساوية، بينما يزيد سعر Opus بنحو 30% فقط، مقابل دقة أعلى وإعادة عمل أقل.
- استخدم Sonnet لتحميل المواد الجديدة والمخرجات الطويلة: فسعر كتابة التخزين المؤقت وسعر المخرجات يساويان نصف سعر Opus، ويمكن خفض التكلفة إلى النصف إضافيًا عبر Batch للمهام غير المتصلة بالوقت الفعلي.
- احتفظ بالسياق الطويل في مكان واحد فقط: لا يمكن مشاركة التخزين المؤقت بين النماذج؛ لذا مرّر إلى الوكلاء الفرعيين مقتطفات مختصرة فقط، لتجنب دفع تكلفة كتابة التخزين المؤقت بشكل متكرر.
أما وضع Fast في Opus، فهو مناسب للحالات التي تكون فيها سرعة الاستجابة الفردية بالغة الأهمية والميزانية مرتفعة. لكنه يضاعف السعر ولا يشارك التخزين المؤقت. بالنسبة إلى معظم وكلاء المؤسسات، يكون إسناد التفاعل الفوري إلى Sonnet بمستوى medium أكثر جدوى اقتصاديًا من تفعيل Fast في Opus.
الأسئلة الشائعة
س1: هل ما زالت هناك حاجة إلى claude-sonnet-5-5 رغم أن claude-opus-5-5 سريع بالفعل؟
نعم. تأتي سرعة Opus أساسًا من مستوى الأداء الافتراضي الأقل وكفاءة الـToken الأعلى، لكن Sonnet لا يزال يتفوق بوضوح في سرعة الإخراج في الثانية وزمن وصول أول Token، كما أن سعر الإخراج لديه لا يتجاوز نصف سعر Opus. لذلك يظل Sonnet الأنسب لسيناريوهات مثل كتابة النصوص الطويلة، والمحادثات الفورية، والوكلاء الفرعيين المتوازيين.
س2: هل يمكن لـ claude-sonnet-5-5 عند تشغيله بمستوى max أن يحل محل Opus؟
يمكن ذلك في مهام محددة مثل البرمجة عبر الطرفية؛ إذ تتفوق نتيجة Sonnet (max) في Terminal-Bench 4.0 حتى على Opus. لكن مؤشر الذكاء الإجمالي يظل أقل بنقطتين، كما يستهلك Sonnet عددًا أكبر من الـToken عند مستوى max، ما يجعل التكلفة الإجمالية مساوية لتكلفة Opus أو أعلى قليلًا. إذا كنت تحتاج إلى أعلى جودة ممكنة، فعادةً ما يكون استخدام Opus مباشرةً أوفر.
س3: كيف يمكن لوكيل مستندات طويلة في المؤسسات التحكم في تكلفة النموذجين؟
المفتاح هو رفع معدل إصابة التخزين المؤقت: ثبّت المستندات الطويلة في بادئة الطلب، واجعل نموذجًا واحدًا فقط يحتفظ بالسياق الكامل، بينما تستقبل الوكلاء الفرعية مقتطفات مختصرة فقط. يُنصح بالاستدعاء عبر APIYI apiyi.com ومراقبة استخدام Token التخزين المؤقت في الاستجابة، ثم تعديل بنية البادئة تدريجيًا. وغالبًا ما يكون معدل إصابة التخزين المؤقت أقوى رافعة لخفض التكلفة.
س4: ما الذي يجب الانتباه إليه عند الترحيل من Sonnet 5 أو Opus 5 إلى الإصدار 5.5؟
يتضمن نموذجا 5.5 تغييرات غير متوافقة مع الواجهات السابقة: لا يمكن تعطيل وضع التفكير، كما أن فرض استدعاء الأدوات (عندما تكون قيمة tool_choice هي any أو tool) سيُرجع الخطأ 400، وتحتاج أدوات تشغيل الحاسوب القديمة أيضًا إلى الترقية. قبل الترحيل، يُنصح بتشغيل حالات الاختبار الانحداري في بيئة اختبار أولًا، ثم مقارنة مخرجات النموذجين القديم والجديد بالتوازي قبل تحويل حركة الإنتاج.
الخلاصة
المقارنة بين claude-sonnet-5-5 وclaude-opus-5-5 ليست ببساطة «الأغلى أفضل والأرخص أضعف». فبعد خفض سعر Opus 5.5، أصبحت تكلفة قراءة البيانات المخزنة مؤقتًا مساوية لـ Sonnet، كما أن مستوى medium الافتراضي يوفر كفاءة عالية بما يكفي. ويتفوق Opus بشكل شامل في الأحكام الدقيقة ضمن السياقات الطويلة والذكاء المركب. في المقابل، يتمتع Sonnet 5.5 بمزايا لا يمكن الاستغناء عنها في سرعة الاستجابة، وتكلفة المخرجات، والبرمجة عبر الطرفية، والتنفيذ عالي التوازي. لذلك، لا تقتصر ميزة Sonnet على السعر فقط، لكنها تظهر عند استخدامه بالمستوى والدور المناسبين.
بالنسبة إلى وكلاء الذكاء الاصطناعي في المؤسسات الذين يتعاملون مع مدخلات ومخرجات طويلة، فإن التركيبة الأكثر منطقية هي: «Opus للقرار، وSonnet للتنفيذ». يحتفظ Opus بالسياق الطويل ويتولى التخطيط والمراجعة النهائية، بينما ينفذ Sonnet بالتوازي مهام الكتابة والتنفيذ على مستوى medium، وتُسند الأجزاء غير المتصلة بالوقت الفعلي إلى Batch. عمليًا، يمكنك أولًا تثبيت المستوى وإجراء اختبارات مقارنة، ثم تقسيم الوكلاء وفق جدول الأدوار الوارد في هذا المقال، وأخيرًا تحسين التكلفة باستمرار عبر مؤشري معدل إصابة التخزين المؤقت وعدد رموز المخرجات.
إذا أردت التحقق سريعًا من هذا النهج ثنائي النماذج، فننصح باستخدام APIYI عبر apiyi.com لاستدعاء claude-opus-5-5 وclaude-sonnet-5-5 من واجهة موحدة. تتوافق واجهة المنصة مع صيغة OpenAI، ويكفي مفتاح API واحد للتبديل بحرية بين النموذجين، ما يجعلها مناسبة لاختبارات الاختيار وتنسيق النماذج المتعددة في بيئات الإنتاج.
المراجع:
– وثائق تسعير Anthropic: platform.claude.com/docs/en/about-claude/pricing
– وثائق وضع Fast من Anthropic: platform.claude.com/docs/en/build-with-claude/fast-mode
– مقارنة Artificial Analysis بين Sonnet 5.5 وOpus 5.5: artificialanalysis.ai
– تحليل Digital Applied لإطلاق Opus 5.5: digitalapplied.com
– مقارنة Sonnet 5.5 وOpus 5.5 من Kingy AI وEmergent: kingy.ai، emergent.sh
نبذة عن الكاتب: فريق APIYI التقني، متخصص في ربط واجهات API لنماذج اللغة الكبيرة وتطبيقاتها الهندسية. نرحب بتواصلكم عبر APIYI على apiyi.com لتبادل الخبرات حول تنسيق وكلاء claude-opus-5-5 وclaude-sonnet-5-5 وتحسين التكاليف.