作者注:從一個 30 分鐘的軟件開發 Agent 任務出發,拆解 Agent 多輪調用中普通輸入、緩存寫入、緩存讀取、輸出與工具往返的費用構成,對比三家服務商的緩存計費,並用 12 次調用的示例說明緩存在什麼條件下才真正省錢。
2026 年 11 月 9 日,Google Cloud 發佈 TPU 8tx 與 TPU 8i Max 兩套第八代 TPU 系統,同時開源了用於 KV Cache 傳輸的 TPU Sync。“Agent 時代的內存牆”再次成爲話題,很多開發者自然會問:底層 KV Cache 越來越快,我的 Agent API 賬單會不會隨之變便宜?
核心價值:讀完本文,你將拿到一個完整的 Agent 成本公式、三家服務商的緩存計費對照,以及一套可以馬上落地的成本優化清單。
Agent 多輪調用 API 成本:核心信息速覽
| 信息項 | 詳情 |
|---|---|
| 背景事件 | 2026-11-09 Google 發佈 TPU 8tx、TPU 8i Max 及 TPU Sync,聚焦 Agent 的內存與 KV Cache 瓶頸 |
| 開發者關心的問題 | 底層優化能否轉化爲 Agent API 賬單下降 |
| 核心結論 | 賬單由普通輸入、緩存寫入、緩存讀取、輸出 Token、調用次數與工具費用共同決定 |
| 關鍵變量 | 前綴是否穩定、緩存 TTL 是否覆蓋工具等待時間、歷史上下文是否失控 |
| 影響範圍 | 編碼 Agent、長文檔 Agent、多 Agent 協作等多輪調用場景 |
Agent 多輪調用的 30 分鐘任務長什麼樣
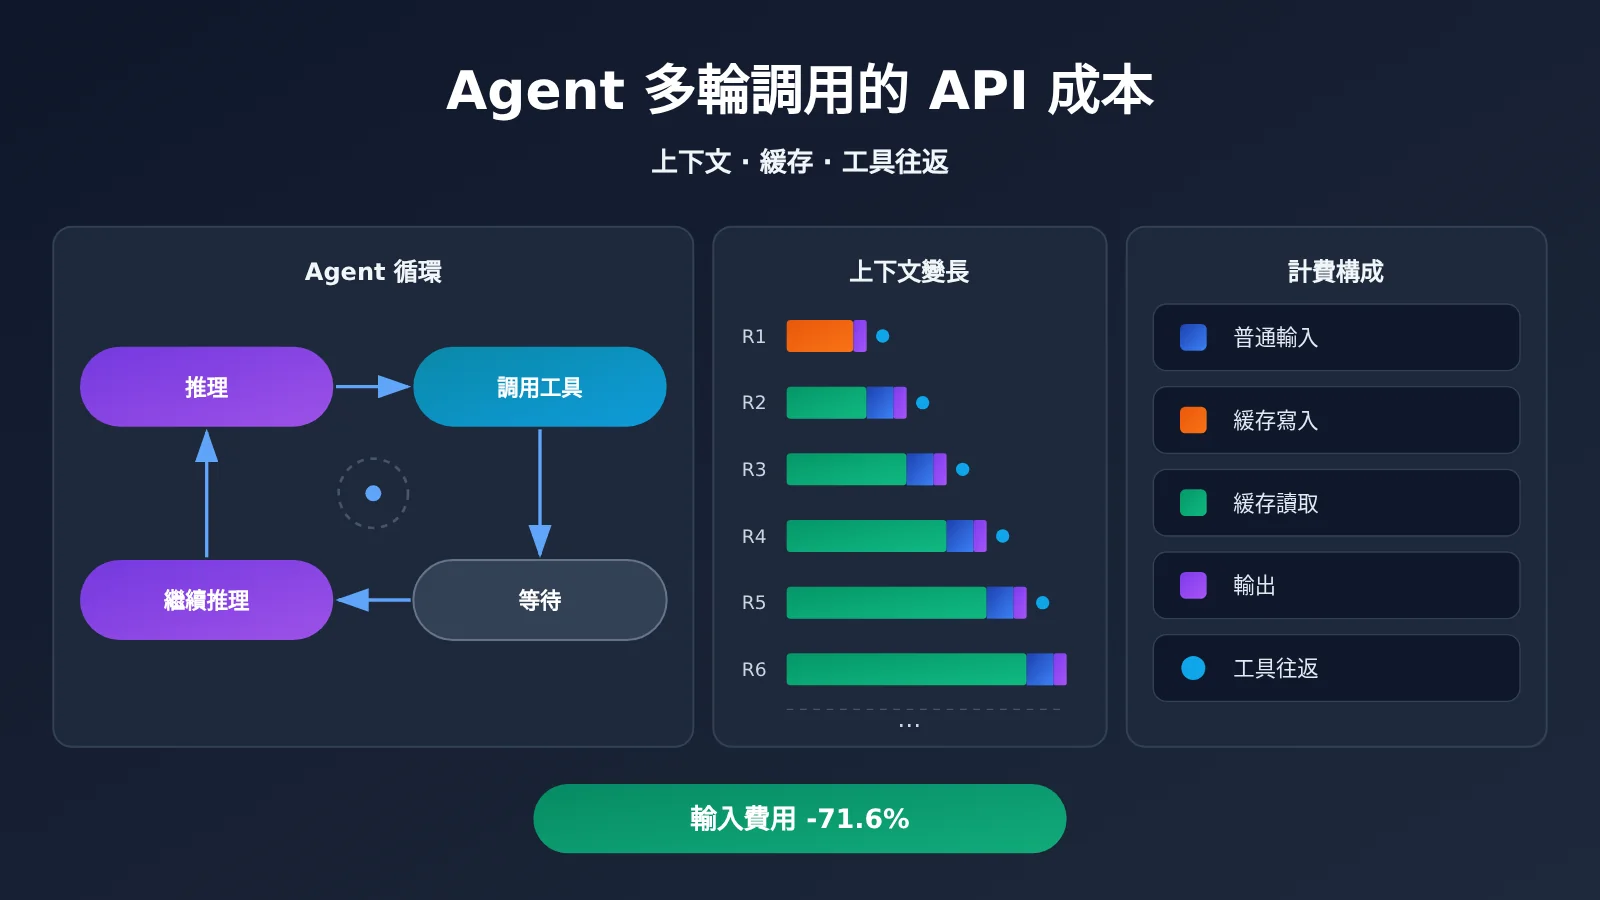
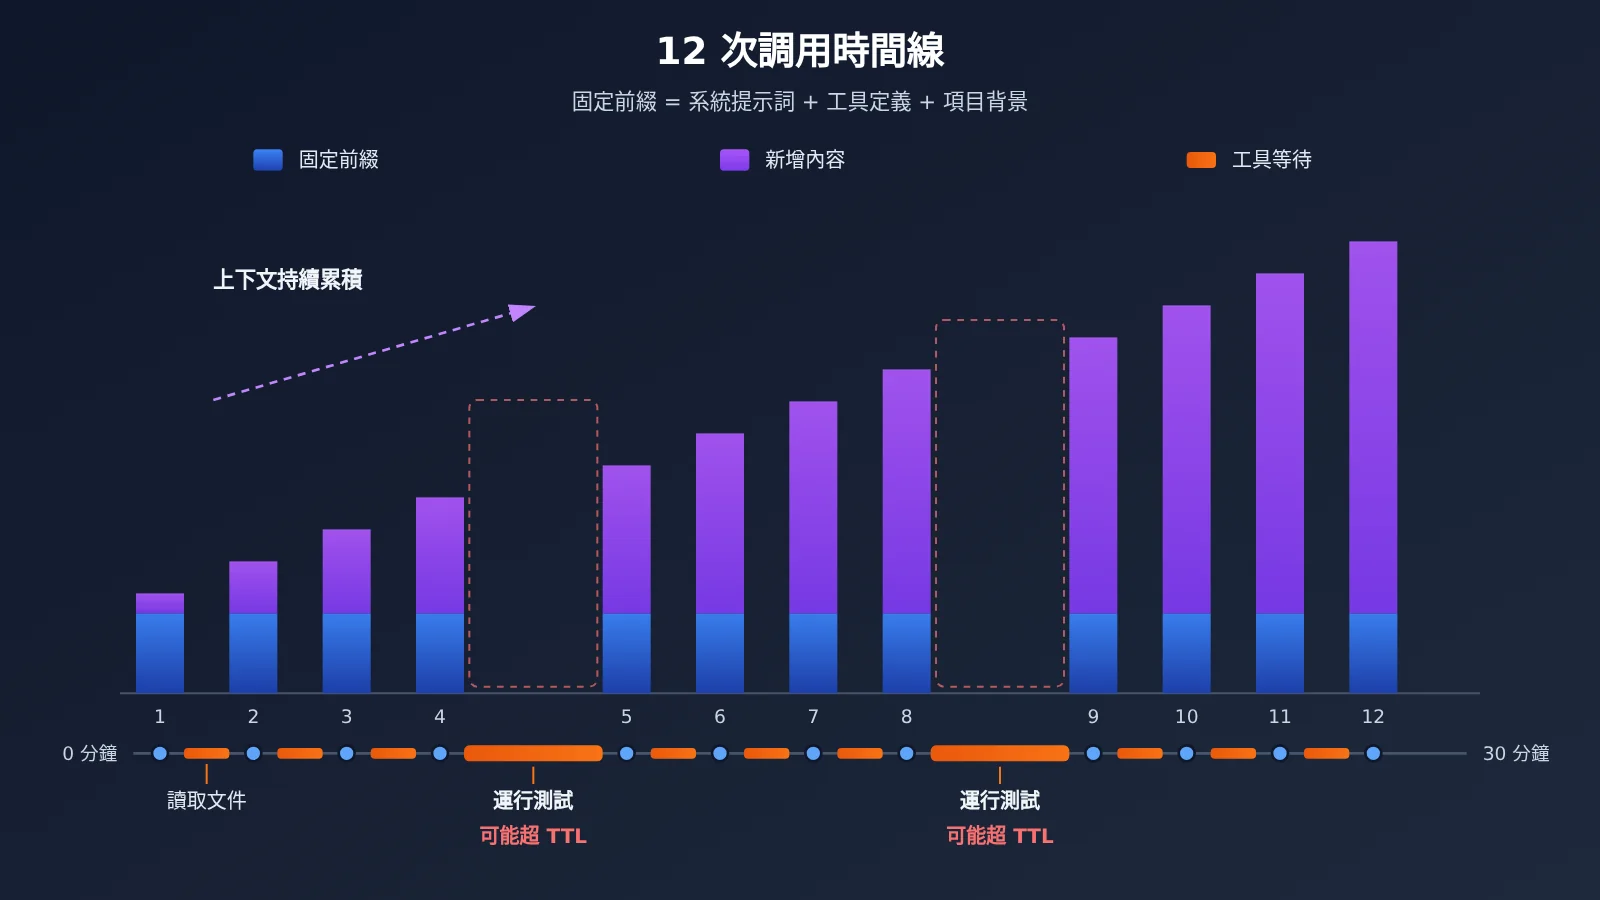
設想一個軟件開發 Agent 接到需求:修復某個模塊的測試失敗。它先讀取項目結構和相關源碼,生成修改方案,調用工具寫文件、跑測試,等待測試結果,再根據報錯繼續推理。30 分鐘裏,這樣的“推理—工具—等待—推理”循環可能發生十幾次。
問題在於,大模型 API 本質上是無狀態的。每一次請求,Agent 都要把系統提示詞、工具定義、項目背景以及之前的對話和工具輸出重新發給模型。第 12 次請求攜帶的內容,往往包含了前 11 輪幾乎全部的歷史,這就是“上下文重複計算”的來源。
Agent 多輪調用 API 成本由哪些部分組成
把一次 Agent 任務拆開看,費用至少包含五類。前四類是模型 Token 費用,第五類則發生在模型之外,卻常常被忽略。
| 成本項 | 含義 | 計費特點 |
|---|---|---|
| 普通輸入 | 未命中緩存、按標準價處理的輸入 Token | 標準輸入單價 |
| 緩存寫入 | 創建可複用緩存的那部分輸入 | 部分服務商與模型按高於標準輸入的倍率計費 |
| 緩存讀取 | 命中已有緩存的輸入 | 通常遠低於標準輸入單價 |
| 輸出 Token | 模型生成的內容,含工具調用參數 | 一般是單價最高的部分,緩存無法降低 |
| 工具與外部執行 | 搜索、代碼執行、數據庫等外部服務 | 按各自服務計費,且會增加模型調用輪數 |
據此可以寫出一個單任務成本公式:
任務總成本 = Σ(普通輸入 × 輸入單價 + 緩存寫入 × 寫入單價 + 緩存讀取 × 讀取單價 + 輸出 × 輸出單價)+ 工具與外部執行費用
公式中的 Σ 是對任務內每一次模型調用求和。這意味着調用次數本身就是乘數:工具往返越多,模型調用越多,固定前綴被重複計費的次數也越多。工具調用並不只花工具自己的錢,它還會把一次推理拆成多次,每次都要重新攜帶上下文。
Agent 多輪調用中 KV Cache、Prompt Cache 與上下文壓縮的區別
討論 Agent 成本時,三個概念最容易混用。它們分屬不同層面,對賬單的影響也完全不同。
| 技術 | 所在層面 | 具體含義 | 對 API 用戶的影響 |
|---|---|---|---|
| KV Cache | 模型推理底層 | 保存注意力計算中的 Key/Value 狀態,避免重複計算歷史 Token | 用戶不直接控制,影響服務商的成本與延遲 |
| Prompt Cache | API 服務層 | 服務商複用重複提示詞前綴,單獨計費緩存寫入與讀取 | 直接體現在賬單的緩存字段上 |
| 上下文壓縮 | 應用層 | 對歷史內容做摘要、篩選或裁剪後再傳入 | 減少實際傳入的 Token,但可能損失細節 |
值得注意的是,OpenAI 官方文檔說明 Prompt Cache 實際保存的是 KV Tensor,而不是原始 Token 文本。因此 Prompt Caching 可以理解爲底層 KV 狀態複用能力的服務化與計費化,它與 KV Cache 並非毫無關係,但用戶能感知到的只有計費規則。
上下文壓縮則是另一回事。它改變的是後續請求“攜帶什麼”,而不是“如何複用”。壓縮得越激進,Token 越少,但 Agent 遺忘關鍵細節的風險也越高。
Agent 多輪調用的底層優化爲什麼不等於賬單下降
Google 這次發佈的 TPU 8i Max 將 HBM 帶寬和片上 SRAM 翻倍,TPU Sync 在 Ironwood 平臺的內部測試中將 KV Cache 傳輸延遲降低超過 90%,Agent Compute Engine 則在 Agent 空閒時暫停會話、把工作內存移出芯片。這些優化作用於服務商的資源利用率和推理延遲(例如 TTFT),對用戶可能體現爲更快的響應。
但 API 價格是服務商的商業定價,用戶賬單仍按 Token 計量。硬件效率提升可能在長期內影響定價,卻不存在自動、等比例的傳導關係。另外,TPU 8tx 與 TPU 8i Max 截至 2026-11-10 仍標記爲 Coming soon,尚未公佈價格。對開發者而言,能立刻控制的是自己的 Token 結構,而不是上游的硬件。
Agent 多輪調用 API 成本:三家服務商緩存計費對比
三家主流服務商都提供緩存機制,但觸發方式、TTL 和計費口徑差異明顯。下表依據各家官方文檔整理,具體以對應模型和接口的說明爲準。
| 服務商 | 緩存機制 | TTL 選項 | 寫入計費 | 讀取計費 | 可用平臺 |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching,支持模型自動前綴緩存 | 部分新模型默認 30 分鐘,部分模型支持 12 小時 | 支持相應配置的模型與接口:30 分鐘爲普通輸入 1.25 倍,12 小時爲 2.5 倍;其他緩存模式可能不另收寫入費 | 通常爲普通輸入 0.1 倍,部分模型更低 | 官方 API、API易 apiyi.com |
| Anthropic | Prompt Caching | 默認 5 分鐘,可延長至 1 小時 | 5 分鐘爲普通輸入 1.25 倍,1 小時爲 2 倍 | 因模型而異 | 官方 API、API易 apiyi.com |
| Google Gemini | Context Caching,隱式緩存 + 顯式緩存 | 顯式緩存可設置 TTL | 顯式緩存另有按緩存 Token 數與存儲時長計算的費用 | 命中可降低重複輸入費用 | 官方 API、API易 apiyi.com |
以 Claude Sonnet 5.5 的官方價格爲例:普通輸入每百萬 Token $2.00,5 分鐘緩存寫入 $2.50,1 小時緩存寫入 $4.00,緩存讀取 $0.10。緩存讀取只有普通輸入的 5%,這正是重複前綴能被大幅壓縮成本的原因。
需要提醒的是,OpenAI 官方明確說明緩存命中並非每次都能保證;Gemini 的顯式緩存也不是“免費存儲”,存儲時長本身會計費。緩存是一種有條件的折扣,而不是默認生效的降價。
🎯 技術建議:不同上游模型的緩存能力、計費規則和返回字段並不統一,統一網關不會自動讓所有模型獲得相同的緩存優惠。建議通過 API易 apiyi.com 用同一套 OpenAI 兼容代碼分別測試候選模型,以實際返回的 usage 字段和賬單爲準。
Agent 多輪調用緩存成本實算:12 次調用示例
沿用前文的 30 分鐘開發任務,並使用 Claude Sonnet 5.5 官方價格構造示例。假設條件如下:
- 任務共調用模型 12 次,每次輸入 22,000 Token;
- 其中 20,000 Token 是重複的系統提示詞、工具定義和項目背景;
- 每次新增 2,000 Token;
- 採用 1 小時緩存,後續請求均成功複用。
不使用緩存:12 × 22,000 × $2 / 1,000,000 = $0.528。
使用 1 小時緩存:首次寫入 20,000 Token 爲 $0.080,首次普通輸入 2,000 Token 爲 $0.004,後續 11 次緩存讀取爲 $0.022,後續 11 次新增輸入爲 $0.044,合計 $0.150,輸入費用節省約 71.6%。
這個示例只計算輸入 Token,不包含輸出 Token、工具調用和外部服務費用。真實 Agent 的歷史還會逐輪增長,但結論方向不變:重複上下文是 Agent 多輪調用中最容易被放大的成本。
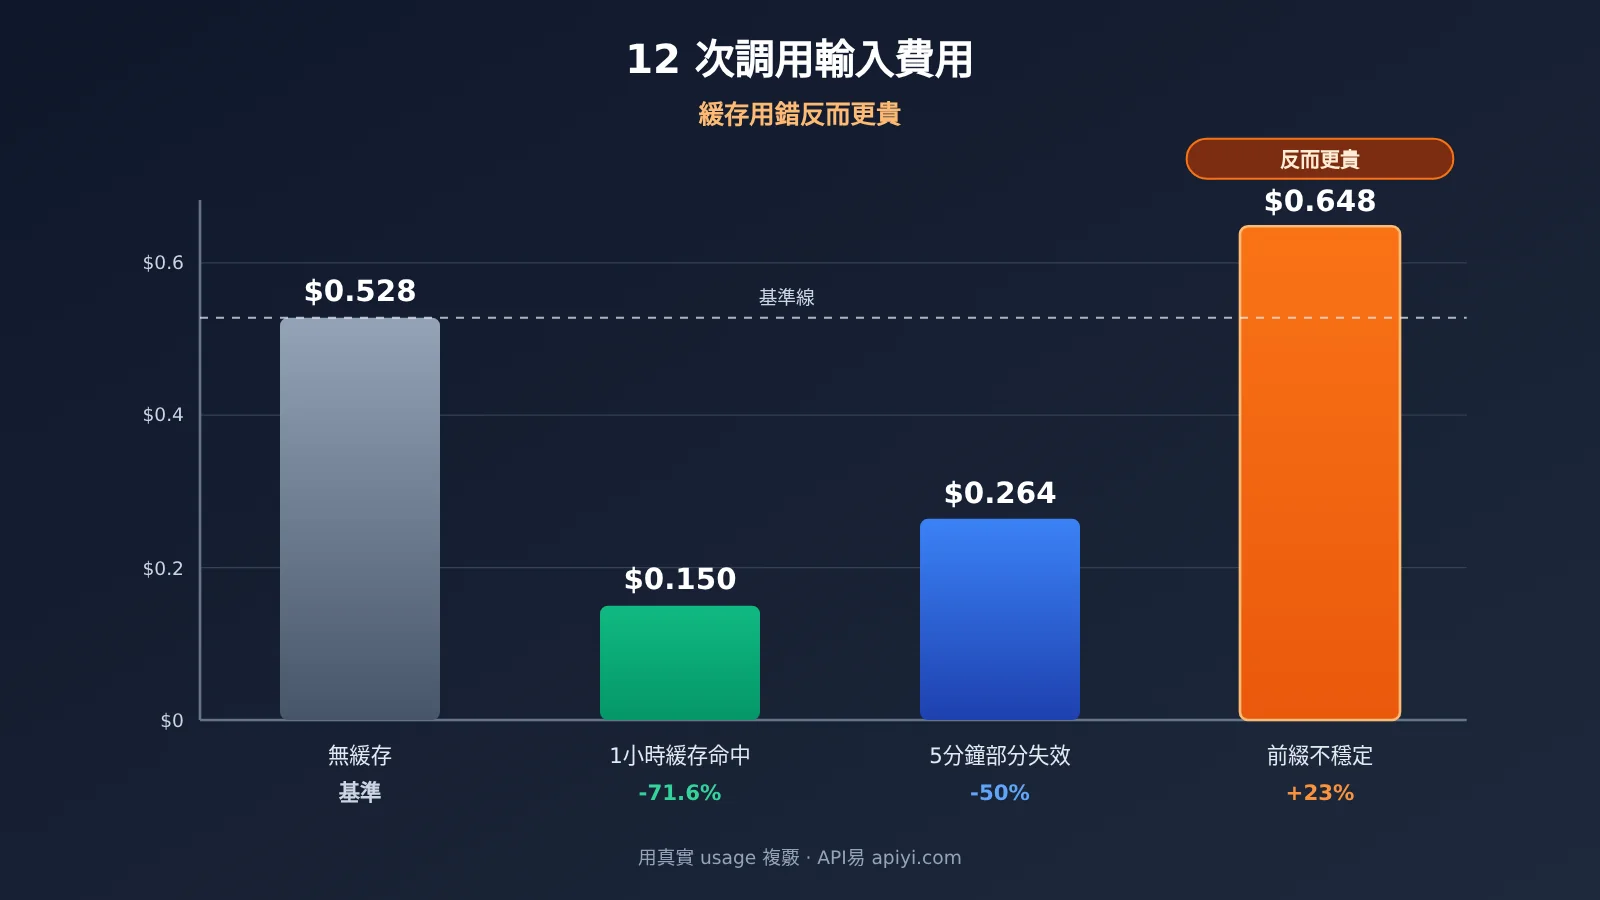
緩存失效、前綴變化與 TTL 對 Agent 成本的影響
上面是理想情況。下面用同一組價格,對三種常見“走樣”做補充推演(以下爲本文按官方單價自行計算的示意場景)。
| 場景 | 假設 | 輸入費用 | 相對無緩存 |
|---|---|---|---|
| 無緩存 | 12 次全部按普通輸入 | $0.528 | 基準 |
| 1 小時緩存全命中 | 寫入 1 次,讀取 11 次 | $0.150 | 節省約 71.6% |
| 5 分鐘緩存全命中 | 寫入單價 $2.50,讀取 11 次 | $0.120 | 節省約 77.3% |
| 5 分鐘緩存部分失效 | 工具等待超時導致共寫入 4 次、讀取 8 次 | $0.264 | 節省約 50% |
| 前綴不穩定 | 前綴每次變化,12 次都按 5 分鐘寫入計費 | $0.648 | 反而多花約 23% |
幾點解讀可以直接用於決策:
- TTL 要覆蓋工具等待:5 分鐘緩存寫入更便宜,但只要測試運行或人工確認超過 5 分鐘,緩存就會過期重寫,節省幅度明顯縮水。
- 前綴穩定比 TTL 更關鍵:把時間戳、隨機 ID 放在提示詞最前面,會讓每次請求都無法命中,在需要付寫入溢價的模式下,緩存反而讓賬單變貴。
- 長 TTL 不是越長越好:1 小時寫入單價是 5 分鐘的 1.6 倍,只有當調用間隔確實可能超過 5 分鐘時才划算。
如何降低 Agent 多輪調用的 API 成本
極簡示例:記錄每次調用的緩存命中
優化的第一步是“看見”成本。下面的代碼通過 OpenAI 兼容接口發起請求,並打印 usage 中的緩存相關字段:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="your-model-name",  # 替換爲要測試的模型
    messages=[
        {"role": "system", "content": "固定的系統提示詞與工具說明……"},
        {"role": "user", "content": "本輪新增的任務內容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("輸入:", usage.prompt_tokens, "輸出:", usage.completion_tokens,
      "緩存命中:", getattr(details, "cached_tokens", None))
查看完整實現:穩定前綴 + 單任務成本追蹤
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 固定前綴:系統指令、工具定義、公共項目背景,放在最前且保持字節級不變
STABLE_PREFIX = [
    {"role": "system", "content": "你是代碼修復 Agent。工具定義與項目規範如下……"},
]

@dataclass
class TaskCost:
    # 單價:美元 / 百萬 Token,按所用模型官方價格填寫
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # 只追加新消息,不重排歷史;動態信息(時間戳等)放在最後
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "測試 test_auth 失敗,報錯如下……", tracker)
print(tracker.summary())
注意,上面的估算只覆蓋讀取折扣;若所用模型對緩存寫入單獨計費,需要按其返回字段補充寫入項。不同模型的 usage 字段名稱和含義可能不同,應以實際返回爲準。
🚀 快速開始:推薦先在 API易 apiyi.com 用免費測試額度跑通上面的追蹤腳本,拿到同一任務在不同模型下的緩存命中率與單任務成本,再決定生產環境用哪個模型、哪種 TTL。
Agent 多輪調用成本優化的五個動作
- 穩定提示詞前綴:系統指令、工具定義、公共參考資料放在最前面,時間戳、用戶動態信息放在最後,工具定義的順序和字段也不要隨意變動。
- 合理選擇 TTL:調用密集、間隔短的任務用短 TTL;存在長時間測試、構建或人工審批的 Agent,評估更長 TTL 的寫入溢價是否能被避免的重寫抵消。
- 控制歷史上下文:只追加、不重排,避免破壞緩存前綴;對冗長的工具輸出做摘要,保留關鍵結論、任務狀態和必要證據。
- 減少不必要的模型調用:能批量執行的工具合併成一次調用,確定性步驟交給代碼而不是交給模型判斷,從源頭減少往返輪數。
- 監控真實指標:按任務記錄普通輸入、緩存寫入、緩存讀取、輸出 Token、緩存命中率、TTFT 和總成本,用任務級成本而非單次請求成本做評估。
Agent 多輪調用 API 成本影響分析
對開發者的影響
- 成本模型要從“單次請求”升級爲“單個任務”:Agent 的費用取決於整條調用鏈,只看單價會嚴重低估實際賬單。
- 提示詞工程開始兼顧計費結構:前綴的穩定性直接決定緩存能否生效,提示詞結構設計成爲成本工程的一部分。
- 多模型選型需要實測:緩存摺扣比例、TTL 和寫入溢價因模型而異,同樣的任務換模型後成本差異可能很大。
對行業的影響
- 基礎設施競爭聚焦 Agent 負載:Google 將內存帶寬、KV Cache 傳輸和 Agent 暫停恢復作爲重點,說明多輪、長上下文已成爲主流負載形態。
- 用戶收益更先體現在延遲上:底層優化首先改善 TTFT 和吞吐,Token 價格是否下調取決於服務商定價策略,開發者不宜提前計入預算。
常見問題 FAQ
Q1:Agent 多輪調用的 API 成本爲什麼比預想高?
因爲 API 是無狀態的,每次調用都要重新攜帶系統提示詞、工具定義和歷史上下文。調用次數越多,這部分固定內容被重複計費的次數越多,工具往返還會進一步增加調用輪數。
Q2:KV Cache 和 Prompt Cache 是一回事嗎?
不完全是。KV Cache 是模型推理底層的狀態複用;Prompt Cache 是服務商在 API 層對可複用前綴的緩存與計費,OpenAI 文檔說明其保存的正是 KV Tensor。用戶只能通過計費規則感知 Prompt Cache,無法直接控制 KV Cache。
Q3:Google 新 TPU 發佈後,API 價格會馬上下降嗎?
沒有依據這樣判斷。TPU 8tx 與 TPU 8i Max 截至 2026-11-10 仍爲 Coming soon,未公佈價格。硬件優化主要改善服務商的資源利用率和延遲,是否傳導到 Token 價格取決於各服務商的定價。
Q4:緩存一定能省錢嗎?
不一定。若前綴每次變化導致無法命中,而所用模式又對緩存寫入收取溢價,費用反而會高於不使用緩存。工具等待超過 TTL 時,頻繁重寫也會削弱節省效果。
Q5:如何快速對比不同模型的緩存效果?
建議用同一個 Agent 任務在多個模型上跑相同流程,記錄緩存命中率和單任務總成本。通過 API易 apiyi.com 可以用一個 API Key 調用 OpenAI、Claude、Gemini 等模型,只需切換 model 參數即可對比。
Q6:上下文壓縮有什麼風險?
壓縮會改變後續請求攜帶的內容,可能丟失關鍵細節,導致 Agent 重複犯錯、反而增加調用輪數。另外,壓縮後的內容如果每輪都重新生成,還會破壞緩存前綴,需要與緩存策略一起設計。
Q7:在統一網關上調用時,緩存優惠是否對所有模型一致?
不一致。緩存能力、計費規則和返回字段取決於上游模型本身。在 API易 apiyi.com 上測試時,應針對每個模型單獨確認緩存字段與實際扣費,再納入成本預算。
Agent 多輪調用 API 成本核心要點 Key Takeaways
- 成本單位是任務:Agent 賬單是整條調用鏈的累加,而非單次請求。
- 重複上下文是大頭:12 次調用示例中,1 小時緩存可讓輸入費用節省約 71.6%。
- 緩存是有條件折扣:前綴不穩定或 TTL 過短時,節省縮水甚至反向增加費用。
- 三家計費口徑不同:寫入倍率、讀取折扣、存儲費用需按具體模型確認。
- 硬件優化≠賬單下降:底層 KV 優化先改善延遲,價格取決於服務商定價。
- 先度量再優化:藉助 API易 apiyi.com 用統一接口實測各模型緩存命中率與任務成本。
總結
Agent 多輪調用的 API 成本由上下文重複計算、緩存命中與工具往返共同決定,三者缺一不可:
- 上下文重複計算決定了成本的基數,調用越多,重複越多;
- 緩存命中決定了重複部分能打幾折,前綴穩定性和 TTL 是關鍵;
- 工具往返既帶來外部費用,又放大模型調用次數。
Google 在基礎設施層對 KV Cache 和內存牆的投入,會讓 Agent 運行得更快,但開發者能立刻掌控的是自己的 Token 結構。建議從穩定前綴、合理 TTL、精簡歷史、減少調用和任務級監控五個方面着手,並通過 API易 apiyi.com 用真實數據驗證每一項優化的效果。
📚 參考資料
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max:第八代 TPU 新系統發佈公告
- 鏈接:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
說明:瞭解 Agent 內存牆與 KV Cache 背景
-
Google Cloud Blog – Introducing TPU Sync:KV Cache 與權重傳輸開源庫
- 鏈接:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
說明:底層 KV Cache 傳輸優化及測試口徑
-
OpenAI API 文檔 – Prompt Caching:緩存機制與最佳實踐
- 鏈接:
platform.openai.com/docs/guides/prompt-caching -
說明:前綴緩存規則、保留時間與監控建議
-
Anthropic 文檔 – Prompt Caching:緩存 TTL 與計費說明
- 鏈接:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
說明:5 分鐘與 1 小時緩存的寫入、讀取價格
-
Google AI for Developers – Context Caching:Gemini 隱式與顯式緩存
- 鏈接:
ai.google.dev/gemini-api/docs/caching - 說明:顯式緩存 TTL 與存儲費用說明
作者:APIYI 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 首頁聯繫我們,更多接入資料可查閱 docs.apiyi.com 文檔中心