Nota do autor: o preço por token do Terra é 10 vezes maior que o do Luna, mas a diferença de precisão varia de 4,7 a 18,7 pontos percentuais. Com dados de testes reais do Plotly, DualEntry e OSWorld, este artigo calcula o custo real de “cada resultado correto” na automação em lote.
A OpenAI lançou o GPT-6.1 Terra em 26 de outubro de 2026, pouco mais de um mês depois da chegada do GPT-6 Luna. Os preços de API dos dois modelos diferem em nada menos que 10 vezes, mas, em testes comparativos de terceiros, a vantagem do Terra em precisão variou de menos de 5 a quase 19 pontos percentuais. Em tarefas de automação em lote, uma pergunta passou a dominar as discussões entre desenvolvedores: essa diferença de preço vale a pena?
Esta não é uma avaliação de modelos baseada em impressões. Plotly, DualEntry e Artificial Analysis divulgaram resultados de testes no dia do lançamento do Terra, e a própria OpenAI publicou dados do OSWorld 2.1, do MMMU-Pro e sobre taxas de erros factuais. Neste artigo, reunimos esses dados para responder a uma pergunta específica: quantos resultados corretos e realmente úteis o gasto adicional traz?
O que você vai encontrar: ao final do artigo, você saberá em quais tipos de tarefas em lote a diferença entre GPT-6.1 Terra e GPT-6 Luna é grande e em quais ela é quase nula. Também terá acesso ao código de uma solução híbrida: “triagem inicial com Luna + validação por regras + Terra como recurso final”.
GPT-6.1 Terra e GPT-6 Luna: principais informações
Os dois modelos fazem parte da família GPT-6, mas têm propostas bem diferentes. A OpenAI descreve o Luna como um modelo de alta eficiência para tarefas bem definidas, frequentes e em grande escala. Já o Terra se destaca em raciocínio visual, operação precisa do computador e escrita natural, ocupando a faixa intermediária entre Luna e Sol.
| Informação | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Data de lançamento | 22 de setembro de 2026 | 26 de outubro de 2026 |
| ID da API | gpt-6-luna |
gpt-6.1-terra |
| Posicionamento oficial | Tarefas frequentes, em grande escala e com regras claras | Raciocínio visual, operação do computador e tarefas em várias etapas |
| Contexto / saída máxima | 1.050.000 / 128.000 tokens | 1.050.000 / 128.000 tokens |
| Nível de raciocínio | 6 níveis, de none a max; padrão medium | 6 níveis, de none a max; padrão medium |
| Cenários típicos | Classificação por etiquetas, triagem de e-mails, extração de campos | Lançamento de faturas, correspondência de imagens de produtos, operação de interfaces |
Em termos de especificações, os dois são quase “iguais”: ambos aceitam entradas de texto e imagem e oferecem suporte a Structured Outputs, Function Calling, Responses API, Batch API e ferramentas como Web Search, File Search e Computer Use. As diferenças estão em dois pontos: preço e capacidade de lidar com tarefas complexas.
Vale destacar que o guia de escolha de modelos da OpenAI não diz “use o Luna para tarefas em lote” ou “use o Terra quando precisar de precisão”. A recomendação oficial é testar os modelos com o mesmo conjunto de entradas reais e escolher a configuração de menor custo que atenda aos requisitos de qualidade. Esse é o ponto de partida para entender todos os dados deste artigo.
Diferença de preço da API entre GPT-6.1 Terra e GPT-6 Luna
Segundo os preços oficiais da Standard API da OpenAI para contexto curto, em dólares por milhão de tokens:
| Item | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| Tokens de entrada | $0.10 | $1.00 | 10 vezes |
| Entrada em cache | $0.01 | $0.05 | 5 vezes |
| Tokens de saída | $0.50 | $5.00 | 10 vezes |
| Gravação em cache por 30 minutos | $0.125 | $1.25 | 10 vezes |
| Entrada / saída em Batch | Cerca de $0.05 / $0.25 | Cerca de $0.50 / $2.50 | 10 vezes |
As tarifas dos modos Batch e Flex são cerca de metade das do Standard, enquanto as do modo Fast são aproximadamente o dobro. Há dois pontos de custo fáceis de ignorar. Primeiro, quando uma única solicitação ultrapassa 272.000 tokens de entrada, a entrada e o cache de toda a solicitação são cobrados pelo dobro, e a saída, por 1,5 vez. Segundo, ferramentas como pesquisa na web e controle de computador podem ter cobranças adicionais. Tokens de raciocínio, novas tentativas e chamadas de agentes em várias etapas também afetam o consumo real.
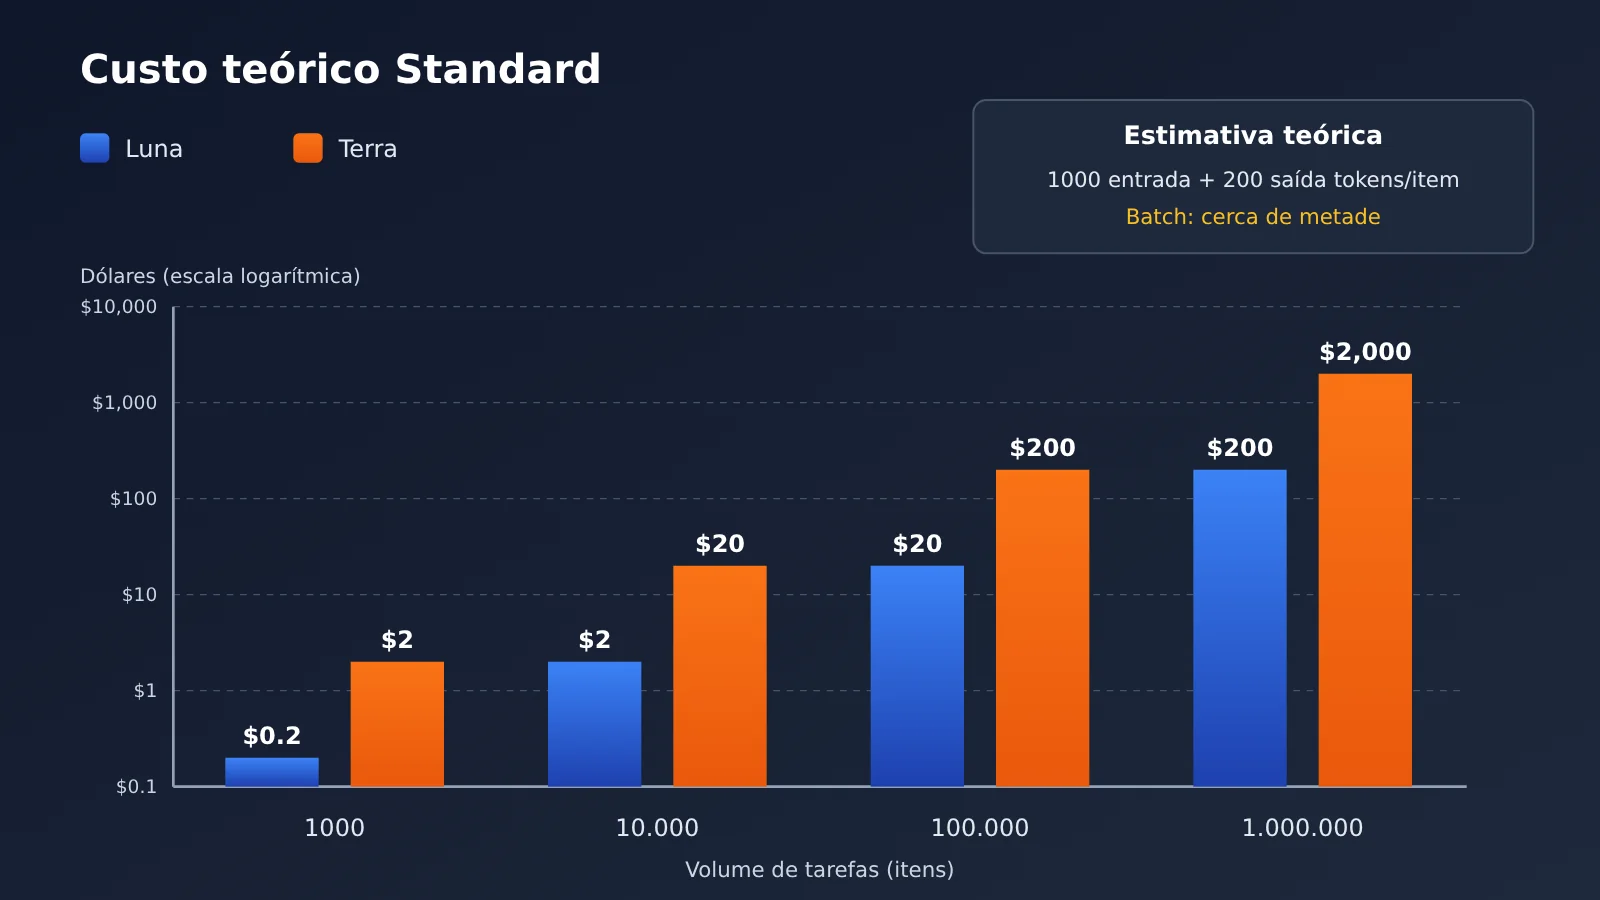
Portanto, “10 vezes mais caro” se refere ao preço unitário dos tokens nas mesmas condições de cobrança, não significa que toda tarefa custará 10 vezes mais. Vamos a uma estimativa teórica: supondo 1.000 tokens de entrada e 200 de saída por registro, sem cache nem novas tentativas, processar 100 mil registros no modo Standard custaria cerca de $20 com o Luna e $200 com o Terra; em Batch, seriam cerca de $10 e $100. Esses valores são apenas estimativas calculadas com base nos preços públicos, não uma fatura real.
GPT-6.1 Terra vs. GPT-6 Luna: dados de 4 testes reais
O preço por si só mostra quanto você gasta. Agora, é hora de ver o que você recebe em troca. Os quatro conjuntos de dados abaixo vêm de instituições diferentes e avaliam tipos distintos de tarefas, mostrando como a diferença de precisão aumenta conforme a dificuldade.
43 questões de análise de dados da Plotly: 10 vezes mais caro, 2 respostas corretas a mais
O DataAnalyticsBench, desenvolvido por pesquisadores da Plotly e da Mila, simula o data warehouse de uma empresa de energia eólica, com cerca de 20 milhões de linhas de dados sintéticos. Os dois modelos responderam às mesmas 43 perguntas usando o mesmo conjunto de ferramentas. Veja os resultados:
| Métrica | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Respostas corretas | 38/43 (88,4%) | 40/43 (93,0%) |
| Custo total dos testes | $0.13 | $1.31 |
| Tempo mediano por pergunta | 18 segundos | 15 segundos |
| Análise comum / perguntas ambíguas / solicitações impossíveis / qualidade dos dados | Pontuação máxima em todas | Pontuação máxima em todas |
| Armadilhas estatísticas | 3/5 | 4/5 |
| Identificação de padrões ocultos | 2/5 | 3/5 |
A descoberta mais importante está nos resultados por categoria. Os dois tiveram desempenho idêntico em análises comuns, identificação de necessidades ambíguas, recusa de solicitações impossíveis e detecção de problemas básicos de qualidade dos dados. A diferença apareceu apenas nas duas categorias de análise mais profunda: armadilhas estatísticas e identificação de padrões ocultos. O Terra acertou uma questão a mais em cada uma.
Numa conta aproximada, o Terra custou $1.18 a mais e acertou mais 2 questões, o equivalente a cerca de $0.59 por resposta correta adicional. Esse é um custo marginal calculado a partir do total dos testes, não um preço fixo para corrigir erros em produção. Se a pergunta influenciar uma decisão de negócio, $0.59 é barato; se for apenas para encontrar mais um padrão irrelevante em um relatório interno, pagar 10 vezes mais não faz sentido.
Outro detalhe: o Terra foi mais rápido por pergunta porque deu respostas mais curtas e fez menos chamadas (em média, cerca de 4,5 invocações do modelo e 1.460 tokens de saída), não porque gerou texto mais rapidamente. Sua velocidade de saída foi de cerca de 64 tokens por segundo. Vale lembrar que a amostra tinha apenas 43 questões e que o Terra foi executado pelo OpenRouter com a configuração padrão de inferência. Portanto, não dá para concluir que ele tenha 93% de precisão em toda análise de dados empresariais.
101 tarefas contábeis do DualEntry: diferença chega a 11,9 pontos percentuais
O Accounting AI Benchmark da DualEntry se aproxima mais das operações reais de uma empresa. As 101 tarefas abrangem oito categorias: classificação de transações, lançamentos contábeis, contas a pagar e a receber, conciliação bancária, relatórios financeiros, fechamento mensal e conhecimento contábil. Cada modelo passa por três rodadas e precisa acertar pelo menos duas para ser aprovado em uma tarefa.
Luna obteve 66,3%, Terra alcançou 78,2% e o GPT-6.1 Sol, usado como referência, chegou a 81,2%. Nos resultados detalhados de Terra, foram 13/13 em classificação de transações, 12/13 em lançamentos contábeis e 10/12 em conciliação bancária. Já em contas a pagar, o resultado foi de apenas 7/13; em contas a receber e fechamento mensal, foi de 7/12 em cada categoria. A DualEntry também observou que Terra e Luna empataram na última posição em contas a pagar.
Para a automação em larga escala, a estabilidade é ainda mais importante que a precisão em uma única tentativa. Terra acertou todas as três rodadas em 65,3% das tarefas, contra 68,3% de Sol. O índice de Luna foi menor, mas a fonte não informou o valor exato. Se um modelo acerta uma tarefa contábil hoje e erra a mesma tarefa amanhã, o custo da revisão manual pode subir rapidamente. No teste, Terra levou em média 16,1 segundos por tarefa, com custo de tokens de cerca de $0.042 por tarefa e aproximadamente $12.73 no total das três rodadas. A fonte não informou com clareza o custo correspondente de Luna, então não fazemos estimativas aqui.
OSWorld 2.1 e taxa de erros factuais: a maior diferença está nas tarefas complexas
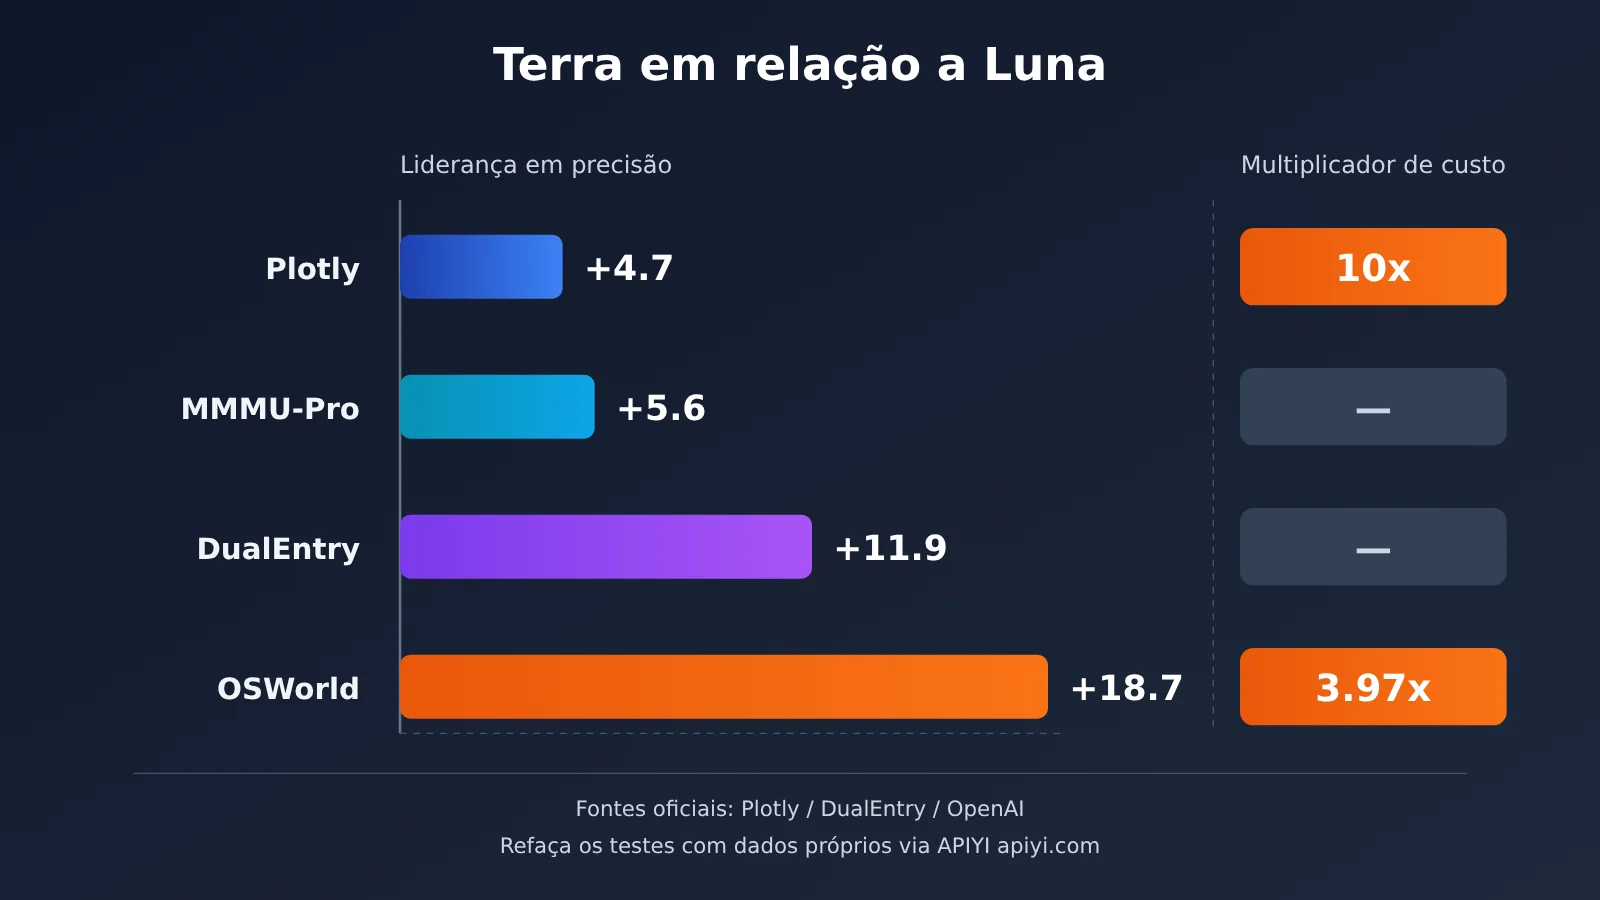
O OSWorld 2.1, benchmark de uso de computadores apresentado pela OpenAI no anúncio do Terra, avalia se o modelo consegue entender a interface, clicar nos botões certos e concluir operações com várias etapas. No nível mais alto de raciocínio, o Luna atingiu 55,5% e o Terra, 74,2% — uma diferença de 18,7 pontos percentuais. O custo estimado por tarefa foi de US$ 0,30 e US$ 1,19, respectivamente: uma diferença de cerca de 3,97 vezes, não de 10 vezes. Isso acontece porque cada modelo consome uma quantidade diferente de tokens para concluir a mesma tarefa.
Os resultados do teste de erros factuais são ainda mais impactantes. Nas questões factuais difíceis desenvolvidas pela OpenAI, as taxas de erro do Luna nos níveis Low, Medium e Max foram de 44,3%, 31,2% e 18,4%, respectivamente. As do Terra foram de 16,7%, 10,1% e 4,3%. A taxa de erro do Terra no nível Low ainda é menor que a do Luna no nível Max. Em compreensão visual, no MMMU-Pro e no nível mais alto de raciocínio, o Luna alcançou 79,9% e o Terra, 85,5%.
Todos esses dados vêm de gráficos oficiais da OpenAI, não de testes independentes de terceiros. As questões factuais difíceis foram criadas especificamente para induzir erros, então isso não significa que o Luna tenha uma taxa de erro de 44,3% na escrita do dia a dia. Da mesma forma, as pontuações do OSWorld só se aplicam às condições em que foram testadas.
Índice geral da Artificial Analysis: também é preciso otimizar a intensidade do raciocínio
A avaliação independente da Artificial Analysis oferece outra perspectiva. No nível Max, o índice geral de inteligência é de cerca de 38 para o Luna e 48 para o Terra. Os custos correspondentes do benchmark geral são de aproximadamente US$ 0,07 e US$ 0,40 — uma diferença de cerca de 5,7 vezes. A diferença no índice de agentes de programação é ainda maior: 31 para o Luna e 48 para o Terra.
Mas o AA-LCR, teste de compreensão de documentos longos, é um contraponto: ambos atingem cerca de 83% na configuração máxima de raciocínio. Além disso, o Terra está na fronteira de Pareto entre custo e capacidade nos níveis Low e Medium, dentro do escopo testado pela instituição, mas não necessariamente no Max. Em outras palavras, na automação em lote, é preciso ajustar não só o modelo, mas também a intensidade do raciocínio.
Guia rápido de automação em lote com GPT-6.1 Terra e GPT-6 Luna
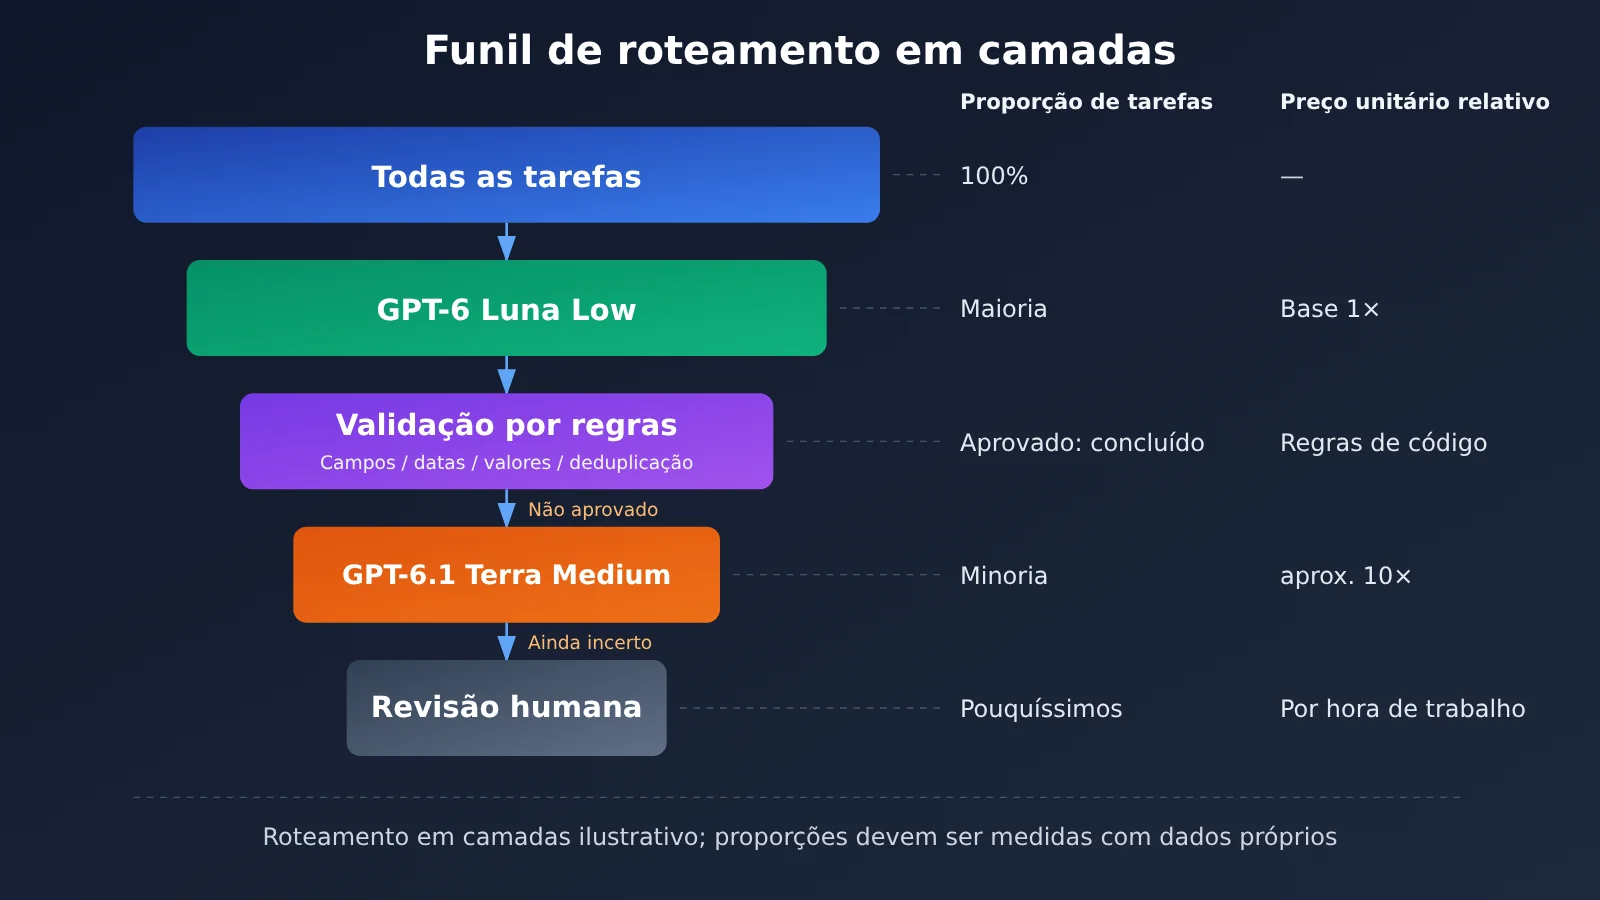
Juntando os dados acima, chegamos a uma conclusão prática: deixe a maioria das tarefas com regras claras para o Luna e encaminhe ao Terra apenas as mais complexas, de alto risco ou que não passem na validação. O exemplo mínimo executável abaixo usa primeiro o Luna para extrair campos de uma nota fiscal e depois aplica regras de validação no código. Só se o resultado não passar na validação é que a tarefa vai para o Terra.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
Veja o código completo de roteamento em camadas
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 Comece rápido: a recomendação oficial é primeiro testar os dois modelos com uma mesma chave API e depois executar seus próprios exemplos. A APIYI apiyi.com oferece uma interface compatível com a OpenAI: para alternar entre
gpt-6-lunaegpt-6.1-terra, basta mudar o parâmetromodel. Novos usuários recebem créditos gratuitos para testes, ideais para começar com uma comparação em pequena escala.
O ponto principal dessa estrutura está na segunda etapa. Não considere uma resposta correta só porque “Luna diz ter muita certeza”: a confiança declarada pelo próprio modelo nem sempre é confiável. Priorize regras verificáveis: se há campos ausentes, se as datas são válidas, se os valores batem, se os campos principais correspondem ao texto original e se há registros duplicados.
Análise do impacto do GPT-6.1 Terra e do GPT-6 Luna
Impacto para desenvolvedores: escolha conforme o tipo de tarefa
Com base no posicionamento oficial e nos testes acima, estas são algumas opções iniciais para tarefas comuns em lote. Vale lembrar que as recomendações se baseiam em avaliações públicas, e não em testes específicos para todos esses cenários. Antes de colocar em produção, valide os resultados com seus próprios dados.
| Cenário de uso | Recomendação inicial | Motivo | Plataformas disponíveis |
|---|---|---|---|
| Classificar 100 mil artigos com etiquetas | GPT-6 Luna | Regras claras e resultados verificáveis por amostragem; ambos tiraram nota máxima na análise comum do Plotly | APIYI apiyi.com, OpenAI oficial |
| Inserir dados de capturas de tela de faturas / pedidos | GPT-6.1 Terra | Melhor desempenho em visão e execução de tarefas; os valores ainda precisam ser verificados por programa | APIYI apiyi.com, OpenAI oficial |
| Resumo diário de notícias sobre IA | Luna para triagem inicial + Terra para leitura detalhada | Luna cuida da remoção de duplicatas e da classificação; Terra avalia a importância das notícias | APIYI, OpenAI oficial |
| Triagem de e-mails de atendimento e criação de rascunhos | Principalmente Luna | Encaminhar chamados de alto risco, como reclamações e reembolsos, para um modelo mais avançado ou atendimento humano | APIYI, OpenAI oficial |
| Alterar páginas web e código em lote | Terra ou Sol | Índice de agentes de programação: Terra 48, Luna 31 | APIYI, OpenAI oficial |
Outro ponto que desenvolvedores costumam deixar passar é a capacidade de processamento. No plano Build listado oficialmente, o Luna tem limite de 2 milhões de tokens por minuto e uma fila Batch de até 20 milhões, enquanto os limites do Terra são de 1 milhão e 3 milhões, respectivamente. No plano Launch, os limites do Luna são de 10 milhões e 1 bilhão, contra 4 milhões e 200 milhões para o Terra. Em tarefas em lote com mais de 100 mil itens, o Luna permite colocar uma quantidade bem maior na fila. Mas esses são limites de uso, não de velocidade de geração, e podem variar conforme a conta.
Impacto no setor: do “preço por chamada” ao “custo por resultado válido”
No dia do lançamento do Terra, surgiram duas opiniões na comunidade do Reddit. Algumas pessoas acharam que o Terra ocupava uma posição difícil: o Luna já era barato o suficiente, enquanto o Sol era mais potente. Outras apontaram que a taxa de erros factuais do Terra Low já era menor que a do Luna Max e que, por isso, não dava para olhar apenas o preço por chamada. Usuários do Codex também relataram que o Terra com alta intensidade de raciocínio não necessariamente consumia menos cota que o Sol com intensidade média. Já usuários do Luna viram a vantagem de cota ser anulada pelo retrabalho em tarefas complexas de desenvolvimento. São relatos individuais, e a cota da assinatura do Codex não é a mesma coisa que a cobrança por tokens da API. Portanto, esses relatos não servem para estimar custos de API.
Ainda assim, eles apontam para a mesma tendência: a métrica para avaliar a automação em escala está mudando de “quanto custa cada chamada” para “quanto custa cada resultado válido”. Uma fórmula simples ajuda a entender:
Custo total = custo de chamadas à API + custo de ferramentas + custo de novas tentativas + custo de revisão humana + perdas causadas por erros
O Luna leva clara vantagem nos dois primeiros itens, enquanto o Terra reduz os três últimos com uma taxa de erros menor. Qual opção compensa mais depende do custo de cada erro para o seu negócio. Uma observação da MultiAI com uma amostra pequena também reforça esse ponto: com o raciocínio desativado, o Terra cometia erros em algumas tarefas de lógica e cálculo, mas melhorava bastante ao mudar para Medium. O Luna se saía bem em tarefas simples, mas cometia mais erros em problemas de lógica com várias etapas.
Como fazer seu próprio teste comparativo
Os dados públicos ainda não respondem a algumas perguntas importantes: qual é a taxa de erro dos dois modelos na classificação de 100 mil artigos reais em chinês? Como eles se comportam em operação contínua? Quanto uma estratégia que combina os modelos pode economizar? A redução no custo de revisão humana compensa o preço mais alto do Terra? Só testando para descobrir.
Uma abordagem viável é reunir de 200 a 500 amostras reais da sua operação, cada uma com uma resposta correta definida. Por exemplo: 100 amostras de classificação simples, 100 de extração de informações importantes, 100 de identificação de conteúdo complexo, 50 de checagem de fatos e 50 de operações com ferramentas em várias etapas. Depois, execute quatro configurações — Luna Low, Luna Medium, Terra Low e Terra Medium — com as mesmas entradas, o mesmo comando, as mesmas ferramentas e os mesmos critérios de avaliação. Repita algumas tarefas várias vezes para observar a estabilidade.
Por fim, compare cinco resultados: precisão, custo de API por 1.000 entradas, tempo médio e tempo P95, número de revisões humanas e retrabalhos, e custo total por 1.000 resultados aprovados. Se usar uma plataforma de terceiros, considere as regras reais de cobrança dela e confira também os termos de tratamento de dados e os requisitos de conformidade.
Perguntas frequentes FAQ
Q1: Qual é a principal diferença entre GPT-6.1 Terra e GPT-6 Luna?
As especificações são quase iguais: ambos têm janela de contexto de 1.050.000 tokens e oferecem suporte às mesmas ferramentas. A diferença é que o Luna custa 10 vezes menos por token e é indicado para tarefas frequentes com regras claras. Já o Terra é significativamente melhor em compreensão visual, operação de computadores, análises complexas e precisão factual, sendo mais adequado para tarefas com várias etapas e alto custo em caso de erro.
Q2: O Terra custa 10 vezes mais, mas a precisão é só um pouco maior?
Depende do tipo de tarefa. No teste de análise de dados Plotly, a vantagem foi de cerca de 4,7 pontos percentuais; na tarefa contábil DualEntry, de 11,9 pontos percentuais; e na operação de desktop OSWorld, de 18,7 pontos percentuais. Além disso, no OSWorld, o custo por tarefa foi cerca de 3,97 vezes maior, não 10 vezes em todos os casos.
Q3: Dá para substituir o Terra pelo Luna com a intensidade de raciocínio em max?
Isso pode melhorar o desempenho em algumas tarefas, mas não elimina a diferença de capacidade entre os modelos. No teste oficial de perguntas factuais difíceis, o Luna Max teve uma taxa de erro de 18,4%, ainda maior que os 16,7% do Terra Low. Além disso, aumentar a intensidade de raciocínio eleva o consumo de tokens e pode fazer o Luna perder a vantagem de custo.
Q4: Como comparar rapidamente os dois modelos via API?
A recomendação é usar o mesmo código e trocar o nome do modelo para fazer a comparação:
1. Acesse APIYI em apiyi.com, crie uma conta e obtenha uma chave API e créditos gratuitos para testes
2. Defina `https://api.apiyi.com/v1` como base_url
3. Execute o mesmo conjunto de amostras com `gpt-6-luna` e `gpt-6.1-terra`, registrando a precisão e o consumo de tokens
Q5: Como reduzir ainda mais os custos em tarefas de grande escala?
Para tarefas que não precisam de resposta em tempo real, priorize a Batch API. A tarifa é cerca de metade da Standard, e a janela oficial de processamento é de 24 horas. Também vale manter cada entrada dentro de 272.000 tokens para evitar a cobrança adicional por contexto longo. Na APIYI, em apiyi.com, a cobrança é por uso, o que facilita começar com lotes pequenos para descobrir o consumo real de tokens por tarefa antes de aumentar o volume.
Q6: Quais são as limitações desses resultados de teste?
O Plotly tem apenas 43 questões e usa dados sintéticos; os resultados de OSWorld, MMMU-Pro e taxa de erro factual vêm da OpenAI e não foram reproduzidos de forma independente; e os resultados 24/24 e 18/18 do MultiAI não usam o mesmo conjunto de questões, então não podem ser comparados diretamente. Além disso, Structured Outputs garante apenas que o formato esteja correto, não que o conteúdo dos campos seja verdadeiro. Nenhuma pontuação de benchmark equivale necessariamente à precisão real no seu negócio.
Principais pontos sobre GPT-6.1 Terra e GPT-6 Luna
- Preço 10 vezes maior: Luna custa US$ 0,10 por entrada e US$ 0,50 por saída; Terra custa US$ 1,00 e US$ 5,00
- Diferença pequena em tarefas simples: ambos atingiram a pontuação máxima em testes como análises comuns no Plotly e identificação de perguntas ambíguas
- Diferença grande em tarefas complexas: Terra ficou 11,9 pontos à frente em contabilidade e 18,7 pontos à frente em operações no computador
- Precisão factual diferente: Terra Low teve uma taxa de erro de 16,7%, menor que os 18,4% do Luna Max
- A intensidade de raciocínio também importa: Terra Low e Medium oferecem melhor custo-benefício que o nível Max
- Roteamento em camadas é mais econômico: Luna faz a triagem inicial, regras validam os resultados, Terra resolve os casos restantes e pessoas fazem a revisão final
- Teste antes de colocar em produção: use de 200 a 500 amostras próprias para comparar quatro configurações na APIYI apiyi.com
Conclusão
Voltando à pergunta do título: qual é mais adequado para automação em larga escala, GPT-6.1 Terra ou GPT-6 Luna? A resposta depende da dificuldade da tarefa e do custo dos erros:
- Tarefas com regras claras e validação automática: Luna é um ponto de partida de baixo custo. Nos testes com Plotly, os dois tiveram o mesmo desempenho em análises comuns.
- Tarefas de alto risco, como reconhecimento visual, operações em várias etapas e finanças: o custo extra do Terra pode valer a pena, já que sua vantagem em precisão chega a 18,7 pontos percentuais.
- O verdadeiro objetivo da otimização: não é reduzir apenas o preço de cada chamada de API, mas o custo total por resultado aprovado, incluindo novas tentativas, revisão e prejuízos causados por erros.
Para a maioria das equipes, a melhor opção não é escolher apenas um dos dois, mas deixar o Luna cuidar da maior parte do trabalho simples e usar o Terra para resolver os casos mais difíceis. Vale começar com uma comparação em pequena escala usando amostras do seu negócio e, depois, definir a proporção de tarefas encaminhadas a cada modelo.
Uma opção é usar a APIYI apiyi.com para testar rapidamente o desempenho dos dois modelos no seu negócio. Com uma única chave API, é possível alternar entre modelos, com cobrança por uso, facilitando o cálculo preciso do custo por mil tarefas.
📚 Referências
- OpenAI: Introducing GPT-6.1 Terra: anúncio de lançamento com gráficos de OSWorld, MMMU-Pro e taxa de erros factuais
- Link:
openai.com/index/introducing-gpt-6-1-terra -
Descrição: fonte oficial sobre o posicionamento do Terra e seus resultados em benchmarks
-
Preços da API OpenAI e páginas dos modelos: preços, capacidades e limites de taxa do Luna e do Terra
- Link:
developers.openai.com/api/docs/pricing -
Descrição: fonte dos preços Standard, Batch, Flex e Fast
-
Documentação da OpenAI Batch API: custos e janela de processamento em lote
- Link:
developers.openai.com/api/docs/guides/batch -
Descrição: como reduzir custos em tarefas assíncronas de grande volume
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: 43 testes de análise de dados nas mesmas condições
- Link:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
Descrição: precisão, custos, tempo e resultados por categoria
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: teste com 101 tarefas de contabilidade
- Link:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
Descrição: precisão, categorias de tarefas e consistência em três rodadas
-
Artificial Analysis: avaliação do GPT-6.1 Terra: índice geral de inteligência e custo-benefício
- Link:
artificialanalysis.ai/models/releases/gpt-6-1-terra - Descrição: registros de testes independentes com diferentes níveis de raciocínio
Autor: equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial do site oficial da APIYI. Para mais informações sobre integração de modelos, acesse a documentação em docs.apiyi.com.