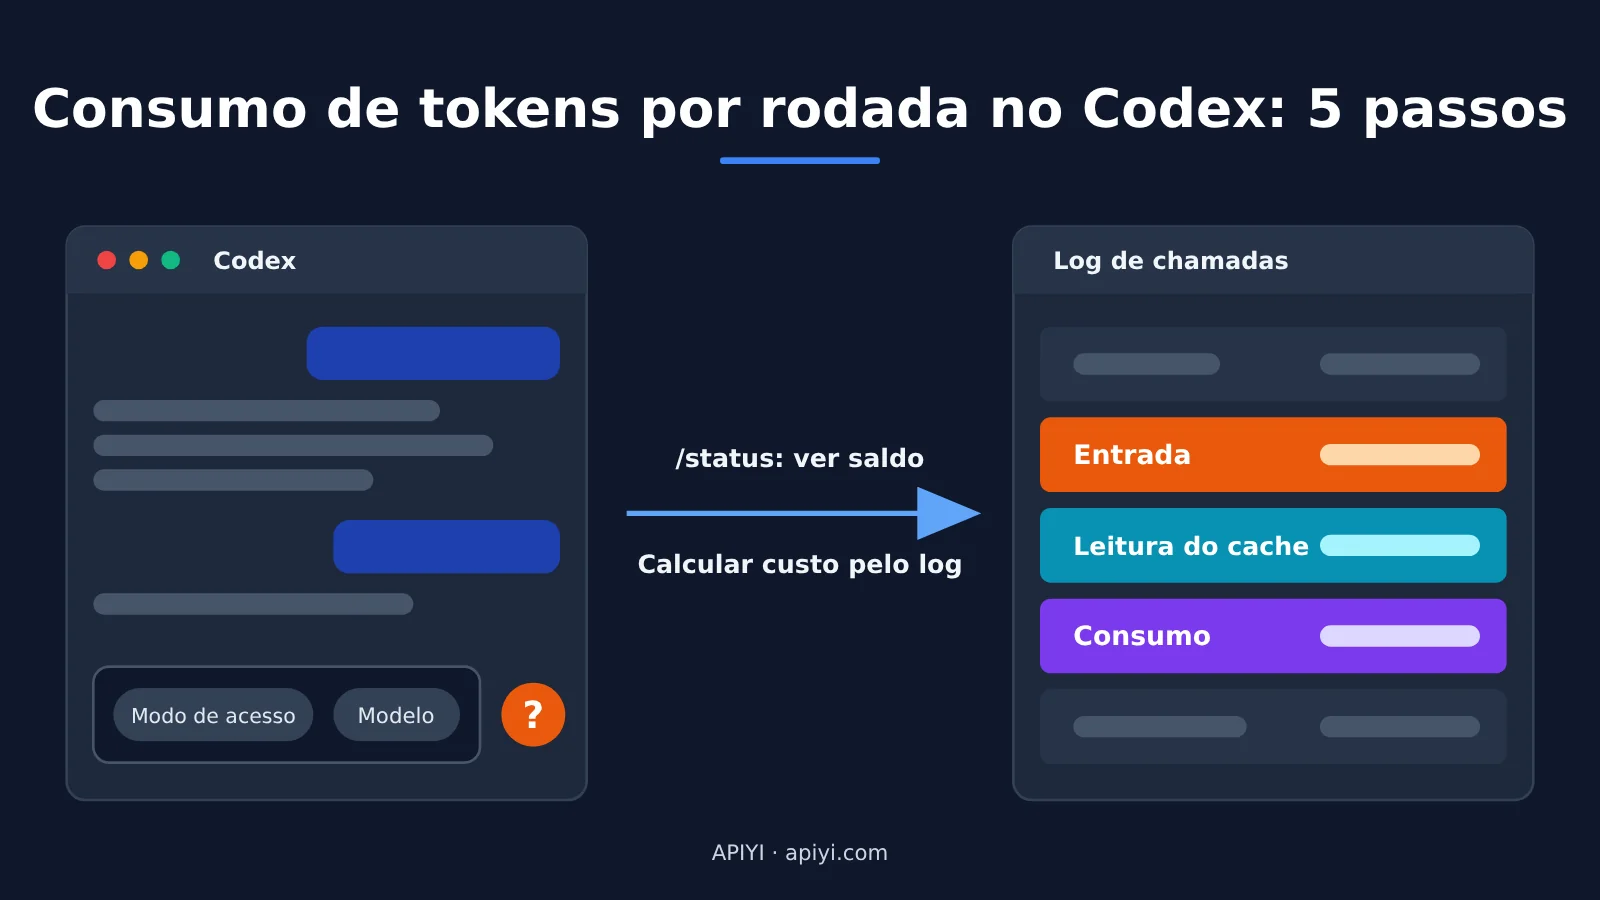
Nota do autor: não consegue ver o uso do contexto na caixa de entrada do Codex? A informação está em /status. Neste artigo, usamos os logs de invocação da APIYI para calcular, em 5 passos, o consumo de tokens e o custo de cada rodada do Codex. Também trazemos uma tabela para ajudar a decidir quando compactar o contexto ou abrir uma nova conversa.
Você conectou o Codex à APIYI e trabalhou por horas em uma mesma conversa. Abaixo da caixa de entrada, só aparecem o modo de permissão e o modelo. Sem ver quanto do contexto já foi usado, fica difícil saber se é hora de abrir uma nova janela.
A conclusão é esta: o Codex mostra o uso do contexto, mas a informação fica em /status; os dados para calcular o custo estão nos logs de invocação da APIYI / apiyi.com. Neste artigo, vamos explicar em cinco passos como usar os logs da APIYI para ver o consumo de tokens em cada rodada do Codex: o que observar, como somar os valores e quando compactar o contexto ou começar uma nova conversa.
Este não é mais um artigo só de conceitos. Em cada passo, você verá o que aparece na interface, onde clicar e um critério para conferir se deu tudo certo.
Por que o Codex não mostra o consumo de tokens em cada turno?
Muita gente acha que o Codex removeu a exibição do contexto. Na verdade, essas informações estão distribuídas em três lugares, e cada um mostra dados diferentes.
- Aplicativo para desktop / extensão de IDE: a caixa de entrada mostra apenas o modo de permissões e o modelo. Digite
/statuspara ver o ID da conversa, o uso do contexto (percentual já utilizado) e os limites de taxa disponíveis. - CLI:
/statusmostra o modelo atual, a política de aprovação, os diretórios com permissão de escrita e o uso atual de tokens. O rodapé da CLI já traz uma indicação de uso do contexto. Com/statusline, você pode adicionar estatísticas de contexto e contadores de tokens ao rodapé. As opções escolhidas são salvas emtui.status_line, no arquivoconfig.toml. codex exec --json: na execução não interativa, o Codex gera uma linha de evento JSON a cada mudança de estado. O eventoturn.completedincluiusage, com cinco campos:input_tokens,cached_input_tokens,cache_write_input_tokens,output_tokensereasoning_output_tokens.
Além disso, /usage mostra apenas a atividade de tokens no nível da conta e exige login pela conta oficial. Se você usa uma chave de terceiros, esse comando não se aplica.
Comparação das três formas de acompanhar o consumo de tokens no Codex
| Fonte | Onde funciona | O que mostra | O que não mostra |
|---|---|---|---|
| Logs de chamadas da APIYI | Desktop, IDE e CLI | Entrada, saída, leitura e escrita de cache e custo de cada requisição | Conteúdo da conversa; cada linha representa uma requisição, então é preciso somar os valores de cada turno |
Codex /status |
Interfaces interativas do desktop e da CLI | Uso do contexto, limites de taxa disponíveis e uso atual de tokens | Custo |
codex exec --json |
Apenas execução não interativa | Tokens de entrada, leitura e escrita de cache, saída e raciocínio por turno | Dados da interface interativa de terminal (TUI) e do aplicativo para desktop |
Das três opções, apenas os logs mostram o custo. Para isso, o serviço usado precisa oferecer logs e detalhes de uso. A assinatura oficial não disponibiliza detalhes por requisição.
Primeiro passo: definir como contabilizar o consumo de tokens do Codex
Antes de começar, lembre-se de uma coisa: uma requisição não equivale a uma rodada de conversa.
Uma requisição é uma chamada que o Codex faz ao modelo. Uma rodada é todo o processo entre você enviar uma mensagem e o Codex concluir a tarefa e responder. Durante uma rodada, o Codex lê arquivos, executa comandos e altera código. Ao fim de cada chamada de ferramenta, ele precisa enviar o resultado ao modelo junto com todo o histórico. Por isso, uma rodada costuma ocupar várias linhas no log; em tarefas complexas, podem ser dezenas.
Também vale lembrar que o modelo não se lembra do que foi dito antes. A entrada da rodada N ≈ todo o conteúdo das N-1 rodadas anteriores + o conteúdo novo da rodada atual. Esse é o principal motivo pelo qual conversas longas ficam cada vez mais caras.
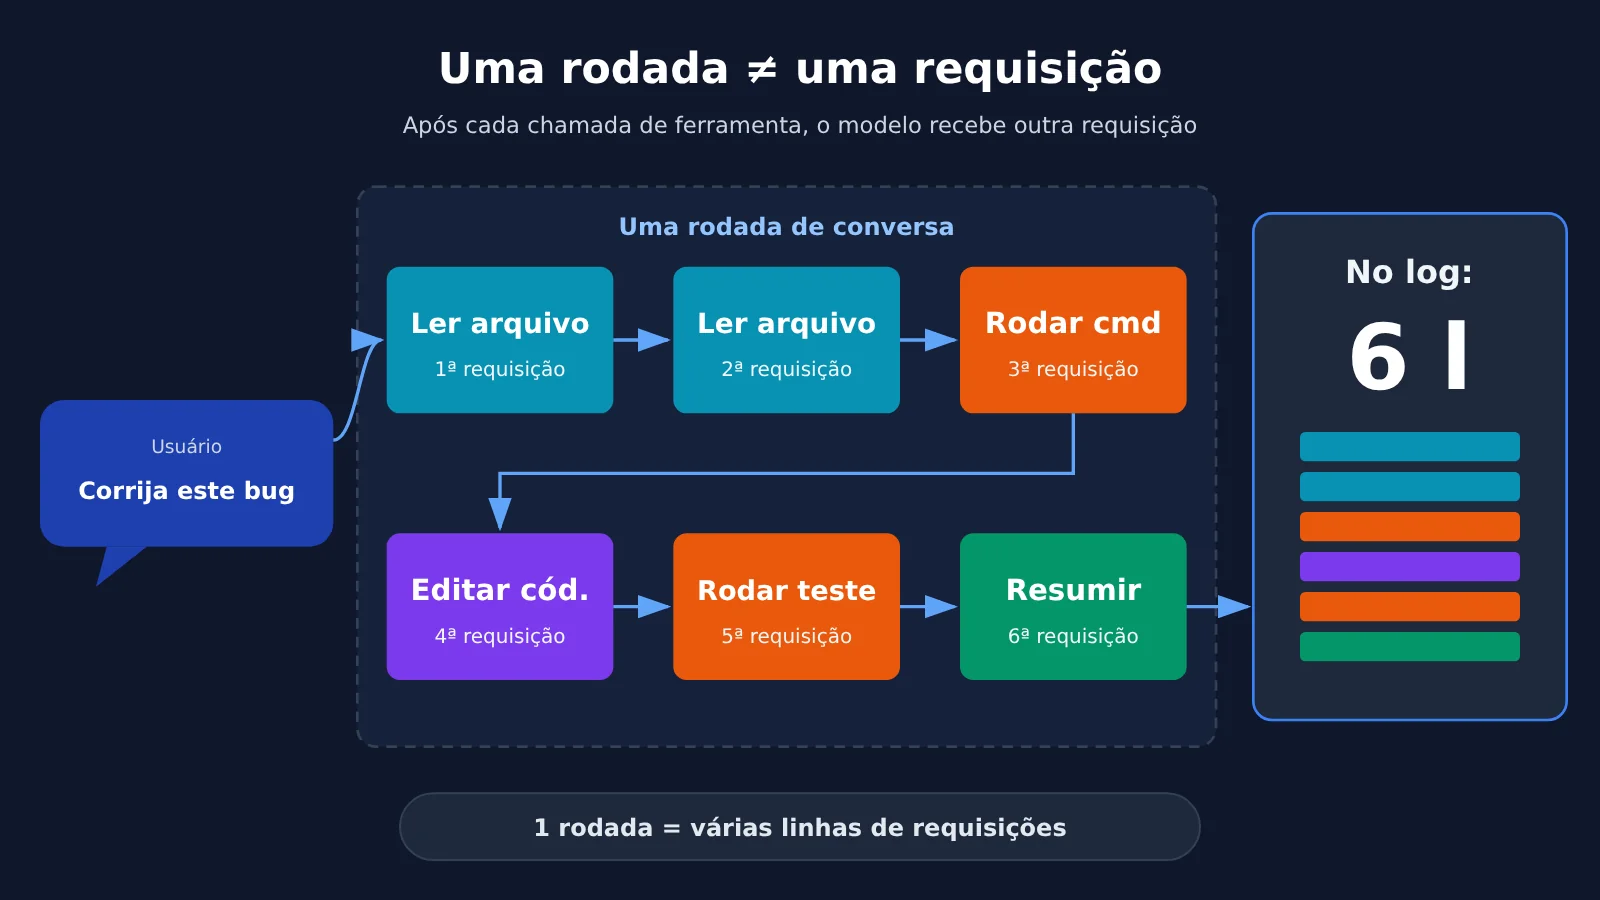
Critério de verificação: ao encontrar várias linhas de requisições no log, você consegue identificar que elas pertencem à mesma rodada, sem contar cada linha como uma rodada.
Segunda etapa: crie um token exclusivo para o Codex
Para fazer a contagem, é preciso que o log contenha apenas solicitações do Codex. Se o Codex compartilhar uma chave com scripts ou outras ferramentas, depois não será possível filtrar por token.
- Acesse a página de tokens no console da APIYI e clique em “Adicionar token”. Escolha um nome fácil de reconhecer, por exemplo, com a palavra “codex”.
- Abra o
config.tomldo Codex e adicione um provider emmodel_providers, combase_url = "https://api.apiyi.com/v1". Useenv_keypara indicar a variável de ambiente que contém esse token. - Aponte
model_providerpara esse provider. O aplicativo para desktop, o IDE e a CLI usam a mesma configuração, então basta alterá-la uma vez. - Use outras chaves para todas as demais ferramentas. Não reutilize esse token.
🎯 Dica técnica: token exclusivo, filtro de logs por token e exportação são os três recursos que o console da APIYI / apiyi.com oferece para fazer essa contagem. A assinatura oficial não mostra os detalhes de cada solicitação; com um token exclusivo, você consegue calcular o custo do Codex separadamente.
Verificação: na página de logs, clique em “Expandir” e selecione esse token no campo “Token” dos filtros avançados. A lista deve mostrar apenas as solicitações feitas pelo Codex.
Terceiro passo: entenda uma requisição no registro de chamadas
Acesse api.apiyi.com/log, a opção «Logs» no menu à esquerda. Cada linha da lista representa uma requisição à API.
Na parte superior, você pode filtrar por período, tipo, modelo e status do cache. A explicação do status diz: “Hit = leitura do cache; miss = criação do cache”. Ao clicar em «Expandir», você também pode filtrar por token, streaming, intervalos de prompt e conclusão, tempo até o primeiro byte e outros critérios.
O que significa cada coluna do registro
| Coluna | O que você verá | Como interpretar |
|---|---|---|
| Horário | Horário de conclusão da requisição | Por padrão, UTC+0, 8 horas atrás do horário de Pequim |
| Modelo | Por exemplo, gpt-5.6-terra | Se mudar de modelo, o cache não será compartilhado |
| Informações | Com ou sem streaming, tempo até o primeiro byte, tokens de prompt/conclusão e valor | Uma visão geral da requisição em uma única célula |
| Prompt / Conclusão | Dois números | Prompt = tokens de entrada; conclusão = tokens de saída. Os tokens de raciocínio normalmente entram na conclusão |
| Consumo | Valor em dólares | Valor antes do desconto, já com o multiplicador do grupo aplicado |
| Detalhes | Multiplicadores, tokens gravados no cache e tokens lidos do cache | Leituras e gravações do cache aparecem separadamente aqui, sem precisar adivinhar |
Nas requisições com cache, a coluna «Informações» mostra tanto os números de leitura quanto os de gravação. As linhas sem detalhes de cache mostram apenas uma combinação como “Sem streaming, primeiro byte: N segundos, prompt/conclusão, valor”. Modelos de imagem e vídeo cobrados por requisição também exibem prompt e conclusão, mas seus valores não são calculados por token. Por isso, não aplique a eles o cálculo deste artigo.
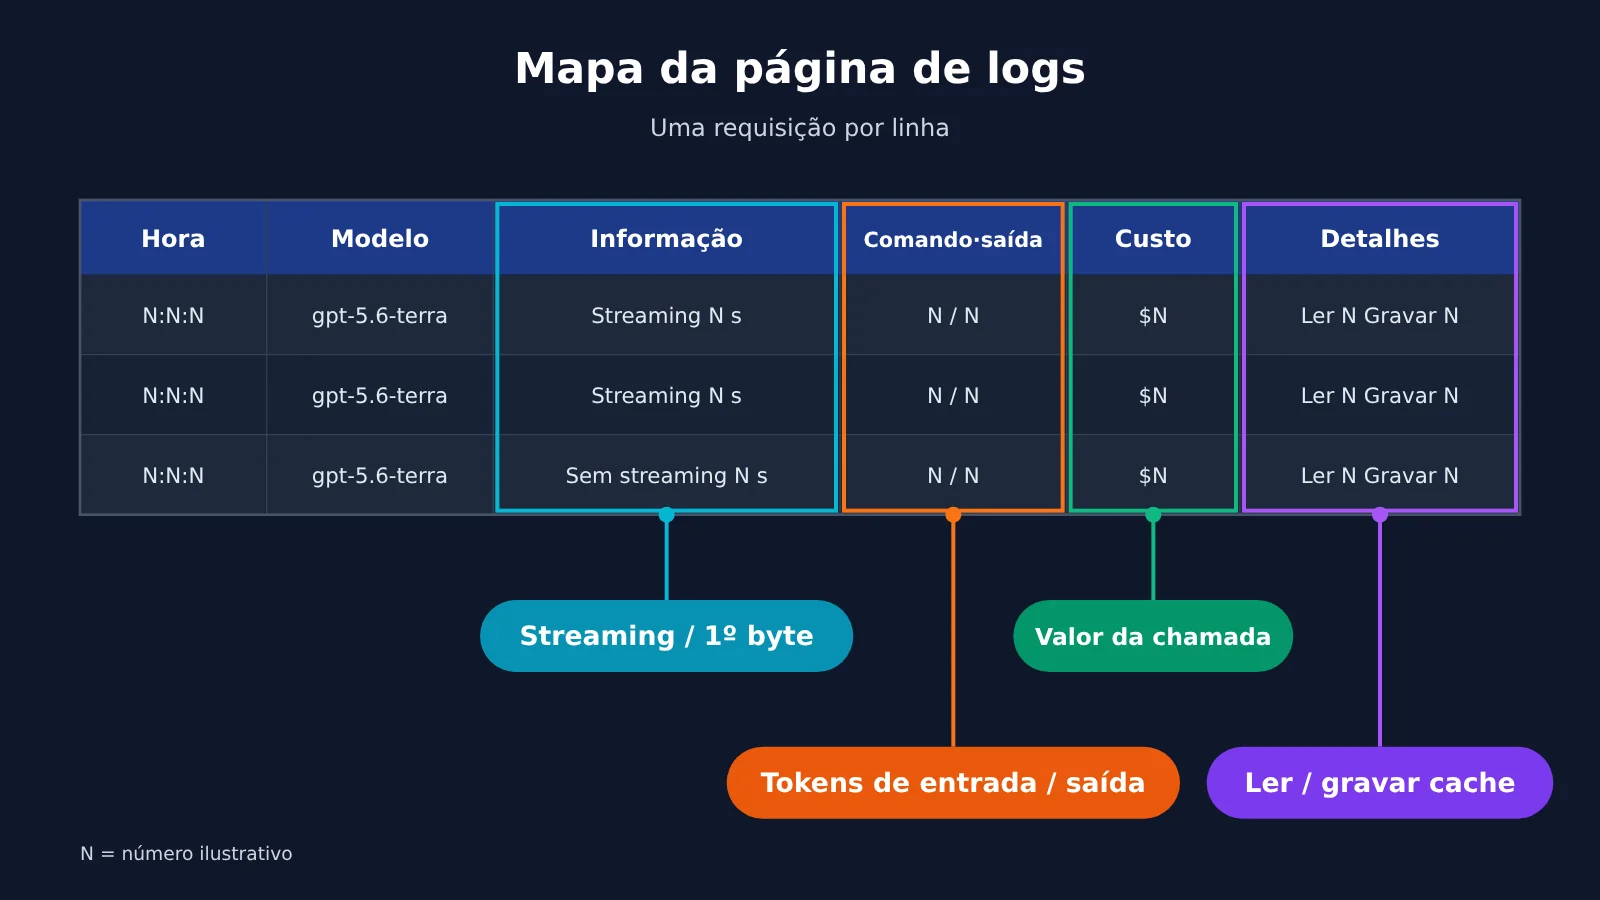
Verificação: escolha qualquer linha e confira se você consegue dizer quantos tokens entraram, quantos saíram, quantos foram lidos do cache e quanto custou a requisição.
Quarta etapa: somar várias linhas de log para calcular o consumo de tokens de uma rodada do Codex
Cada linha representa apenas uma solicitação. Para saber o consumo de uma rodada da conversa, é preciso somar as solicitações.
A regra é: some todas as solicitações do mesmo token e do mesmo modelo feitas em uma janela de aproximadamente 5 minutos após o envio do comando. Ajuste essa janela conforme a sua necessidade.
- Consultar diretamente na página: filtre por token, modelo e intervalo de tempo e confira os tokens de entrada e saída em cada linha. É uma boa opção para consultas ocasionais.
- Exportar e recalcular: clique em “Exportar” no canto superior direito da lista, baixe o arquivo Excel ou CSV e agrupe os dados por horário para fazer a soma.
- API de consulta de logs: chame
GET /api/log/selfusando um token de acesso pessoal para autenticação (começa comnap_; uma chave API que começa comsk_retornará erro 401). Passe os parâmetrostype=2(apenas consumo),token_name,start_timestampeend_timestamp(segundos Unix). O parâmetro de paginação usa camelCase:pageSize. Se você escreverpage_size, ele será ignorado sem aviso. - Converter em dinheiro: o cálculo é
quota ÷ 500.000 = dólares. O campootheré uma string JSON e precisa ser interpretado novamente para acessar detalhes comousage.
Ao usar a API de consulta, informe sempre a janela de tempo, de preferência com no máximo 1 dia. Sem ela, a API buscará todo o histórico, e contas com muitos dados podem apresentar erro por tempo limite. Consultar os logs não consome créditos.
Como calcular o custo de uma rodada do Codex
| Modelo | Entrada | Leitura de cache | Saída | Contexto | Exemplo: total por rodada |
|---|---|---|---|---|---|
| gpt-5.6-sol | $4 | $0.4 | $20 | 1.000.000 | Cerca de $0.214 |
| gpt-5.6-terra | $2 | $0.2 | $12 | 1.000.000 | Cerca de $0.107 |
| gpt-5.6-luna | $0.2 | $0.02 | $1.2 | 1.000.000 | Cerca de $0.011 |
Todos os preços são por milhão de tokens, consultados em 28/10/2026. Quando a entrada de uma única solicitação ultrapassa 272.000 tokens, o preço de entrada dobra.
💰 Sobre os preços: consulte a lista de modelos da plataforma APIYI / apiyi.com para conferir os modelos e preços. Os exemplos da tabela consideram uma rodada com 120.000 tokens de entrada, dos quais 96.000 foram encontrados no cache, e 4.000 tokens de saída. No caso do sol: 24.000 sem cache × $4 + 96.000 do cache × $0.4 + 4.000 de saída × $20. Dividindo por um milhão, o total fica em cerca de $0.214.
Esses números mostram duas coisas. Primeiro, os 96.000 tokens encontrados no cache custaram apenas cerca de $0.038: o cache é fundamental para controlar o custo de conversas longas. Segundo, usando o luna para a mesma rodada de trabalho, o custo fica próximo de um vigésimo do valor do sol. Porém, a página oficial do luna informa que seu desempenho é mais fraco em contextos muito longos, acima de 256K.
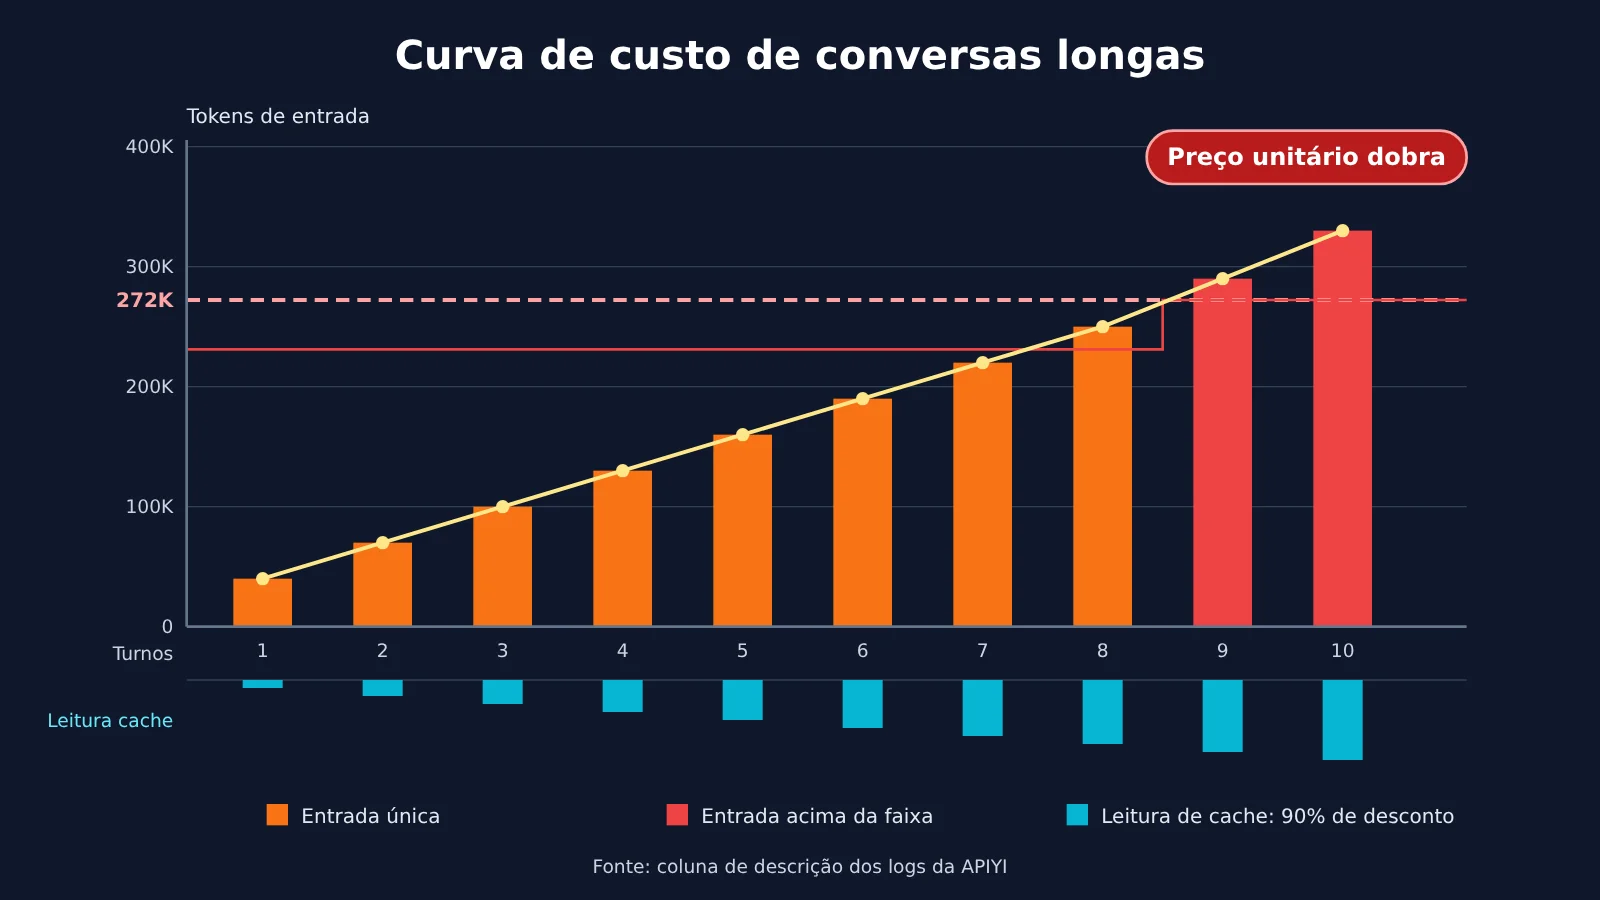
Critério de verificação: você consegue calcular quantos tokens de entrada esta rodada teve a mais que a anterior e dizer quantos desses tokens adicionais foram encontrados no cache.
Quinto passo: use os dados de tokens do Codex para decidir entre compactar ou abrir uma nova janela
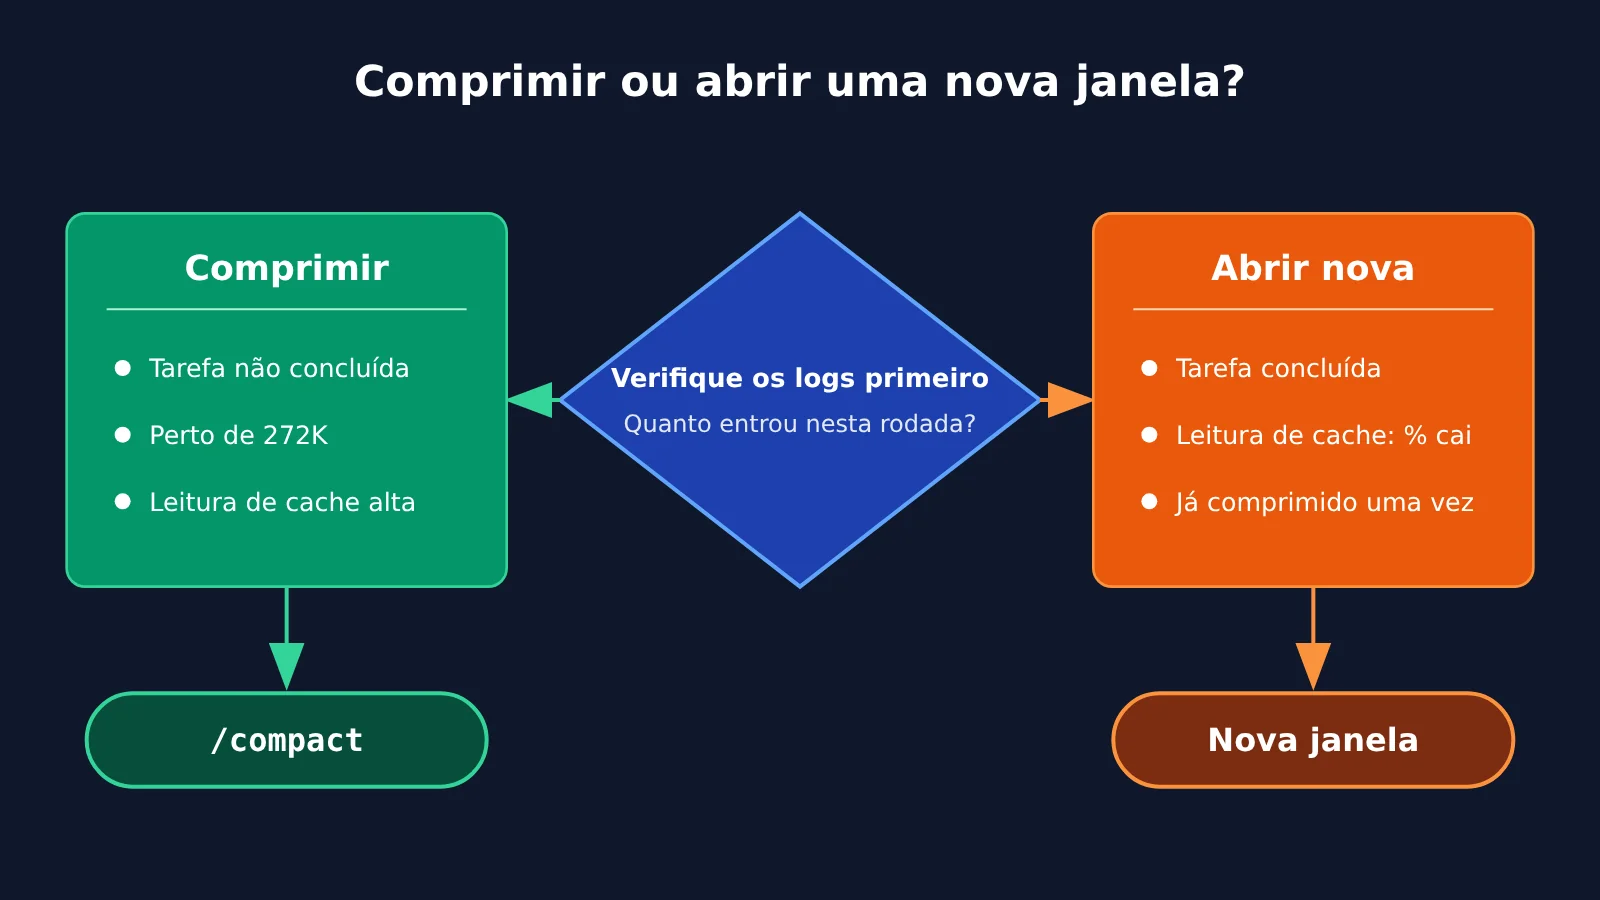
Com os dados de cada rodada em mãos, você pode tomar a decisão com base em números. Observe três sinais:
- Crescimento da entrada: se a entrada aumenta a cada rodada, as saídas das ferramentas e o histórico estão se acumulando rapidamente.
- Proporção de leitura do cache: se a proporção de leitura do cache em relação à entrada cair bastante na coluna de descrição, o prefixo mudou e a maior parte da nova entrada será cobrada pelo preço integral.
- Entrada por solicitação: ao se aproximar de 272.000 tokens, a próxima solicitação pode passar para a faixa de preço superior.
Tabela para decidir entre compactar e abrir uma nova janela
| O que você vê no log | Ação recomendada | Motivo |
|---|---|---|
| A entrada por solicitação está perto de 272.000 e a tarefa ainda não terminou | Execute /compact manualmente primeiro |
Evita que o preço da entrada dobre ao passar para a próxima faixa |
| A entrada por solicitação está perto de 272.000 e a tarefa chegou a uma pausa natural | Abra uma nova janela | Recomeçar deixa o contexto mais limpo do que compactar |
| A proporção de leitura do cache cai por várias rodadas seguidas | Abra uma nova janela para um novo assunto | O cache deixou de ser aproveitado, e continuar a conversa custará, em grande parte, o preço integral |
| O aumento da entrada por rodada cresce de repente | Verifique a saída das ferramentas e, se necessário, reduza tool_output_token_limit |
Saídas longas de comandos foram adicionadas ao histórico |
| A entrada está estável e a proporção de leitura do cache é alta | Continue a conversa atual | É quando uma conversa longa oferece o melhor custo-benefício |
| Você acabou de compactar e o contexto já está quase cheio de novo | Abra uma nova janela | Compactações repetidas deixam o resumo cada vez menos detalhado |
Como configurar a compactação de contexto no Codex
A compactação substitui os turnos mais antigos da conversa por um resumo conciso, liberando espaço no contexto. O Codex oferece duas opções: manual e automática.
- Compactação manual: digite
/compactno aplicativo para desktop ou na CLI. - Compactação automática: defina o limite de disparo com
model_auto_compact_token_limit. Se não preencher, será usado o valor padrão do modelo. - Escopo do limite:
model_auto_compact_token_limit_scopeaceitatotal(conta todo o contexto ativo) oubody_after_prefix(conta apenas a parte adicionada após o prefixo). - Ao usar um
base_urlde terceiros: como o nome do modelo não está na tabela interna do Codex, é recomendável definir manualmentemodel_context_windowe o limite de compactação automática. Para disparar a compactação antes de entrar em uma nova faixa de preço, defina o limite abaixo de 272.000. - Não ative
remote_compactionsem necessidade: ao definirv2, o provedor precisa oferecer suporte ao protocolo de compactação da API Responses. É mais seguro manterunsupportede usar a compactação local.
O custo da compactação
A compactação não é gratuita. Ela reescreve o prefixo do histórico, invalidando o cache. Com isso, a entrada da primeira requisição após a compactação é cobrada quase integralmente pelo preço normal. Por isso, depois de compactar, o ideal é começar um novo assunto, sem voltar a repetir tarefas antigas. A compactação também pode deixar detalhes de fora: não há garantia de que o resumo preserve todas as informações.
Perguntas frequentes
Q1: Não encontro uma requisição nos logs. Ela deixou de ser registrada?
Os logs registram apenas invocações cobradas com sucesso. Requisições que falham nas etapas de rede, autenticação ou validação de parâmetros não chegam ao provedor, não são cobradas e não aparecem nos logs. Por outro lado, se há um registro, isso significa que a requisição gerou consumo. Confira também se o filtro de token e o intervalo de tempo estão corretos.
Q2: Por que o valor é menor do que estimei com base nos tokens?
A causa mais comum é o cache. O canal OpenAI usa cache automático de prefixo: quando o prefixo tem pelo menos 1.024 tokens e permanece estável, ele pode ser reutilizado. A parte reutilizada é cobrada a 10% do preço de entrada. Na coluna de descrição dos logs da APIYI / apiyi.com, você pode ver o número de tokens lidos do cache. Além disso, os logs mostram o valor antes do desconto. O custo real é aproximadamente o valor do log ÷ (1 + percentual de bônus).
Q3: Por que o horário dos logs não bate com o horário em que fiz a operação?
Por padrão, os logs são exibidos em UTC+0. O horário de Pequim é UTC+8, uma diferença de 8 horas. Se você filtrar pela “rodada das três da tarde” no horário de Pequim, pode parecer que faltam dados. Basta converter o horário antes de aplicar o filtro.
Q4: Por quanto tempo os logs ficam disponíveis?
Planeje-se considerando que é possível consultar aproximadamente os últimos 30 dias. O período real de retenção pode ser maior, mas a plataforma não garante isso, e a política de limpeza pode mudar. Se precisar conferir os custos por um período maior, use regularmente a opção “Exportar” ou a API de consulta de logs para guardar seus próprios registros.
Q5: Os logs mostram quais arquivos o Codex leu e que conteúdo enviou?
Não. Os logs guardam apenas informações básicas necessárias para a cobrança, como número de tokens, valor e multiplicador. O conteúdo de entrada e saída não é registrado. Para saber o que aconteceu em uma rodada, consulte a própria conversa no Codex.
Q6: Existe uma maneira mais prática de registrar automaticamente o uso de cada rodada?
Se a execução for feita por script, você pode usar `codex exec –json` e ler os dados de uso no evento `turn.completed`. No uso interativo, é possível consultar periodicamente a API de logs, filtrando por um token dedicado e por janela de tempo, e agregar os resultados. Novos usuários podem primeiro obter créditos gratuitos de teste na APIYI / apiyi.com para testar todo o fluxo.
Pontos principais sobre o consumo de tokens por rodada no Codex
- A informação continua disponível: consulte o uso de contexto em
/status. Na CLI, você também pode usar/statuslinepara exibi-lo no rodapé. - Requisição ≠ rodada: uma rodada de conversa inclui várias chamadas de ferramentas, que aparecem em linhas separadas no log. É preciso somá-las pelo intervalo de tempo.
- Chave dedicada: crie uma chave API exclusiva para o Codex, facilitando a filtragem dos logs.
- Confira a coluna de detalhes: leituras e gravações de cache aparecem separadamente. A parte atendida pelo cache custa 10% do preço normal.
- Faixa de 272K: quando a entrada de uma única requisição ultrapassa 272.000 tokens, seu preço dobra.
- A compactação tem um custo: depois dela, o cache deixa de ser válido e quase toda a entrada daquela requisição é cobrada pelo preço cheio. Após compactar, vale a pena começar um novo assunto.
Resumo
Se você não encontra o uso de contexto no Codex, não é porque o recurso foi removido: ele só mudou de lugar. /status mostra quanto contexto ainda resta, enquanto os logs de chamadas mostram quanto cada rodada custou. Combinando os dois, você pode decidir com base em números se vale abrir uma nova janela.
Você já pode testar: crie uma chave API dedicada para o Codex, abra a página de logs da APIYI / apiyi.com, escolha uma rodada recente e some as requisições correspondentes.
📚 Referências
- Repositório oficial do OpenAI Codex: código-fonte da CLI e definições de eventos
- Link:
github.com/openai/codex -
Detalhes: o campo
usagedeturn.completedé definido emcodex-rs/exec/src/exec_events.rs -
Documentação oficial do Codex: comandos com barra e referência de configuração
- Link:
developers.openai.com/codex -
Detalhes: explicações sobre
/status,/compact,/statuslinee opções de configuração relacionadas à compactação -
Documentação de ajuda da APIYI: logs de chamadas, cobrança de cache e API de consulta de logs
- Link:
docs.apiyi.com - Detalhes: definição dos campos de log, regra de cobrança de cache com 90% de desconto e método de conversão de
quota
Autoria: Equipe técnica da APIYI
Troca de ideias: entre em contato conosco pela página inicial do site da APIYI. Para mais detalhes sobre configuração, consulte a central de documentação.