Nota do autor: esta avaliação da GPT-6 Luna Decisions API aborda quatro perspectivas — princípios, metodologia de teste prático, métricas de latência e cenários de negócio — para ajudar você a decidir se a “invocação orientada a decisões” é mais rápida e mais adequada ao seu negócio do que a invocação padrão do modelo.
Depois do lançamento oficial da Decisions API do GPT-6 Luna, a pergunta mais discutida entre desenvolvedores é: o quanto ela é realmente mais rápida do que a invocação padrão do modelo e quais negócios valem a pena migrar. Este artigo avalia a GPT-6 Luna Decisions API sob a ótica de integração real, cobrindo suas principais capacidades, os princípios por trás da aceleração, os métodos de teste e os cenários de uso.
Isto não é uma repetição do material promocional oficial. Em contas, regiões, níveis de concorrência e comandos diferentes, a diferença de latência pode ser grande. Por isso, este artigo não traz um “multiplicador fixo” que pode te induzir ao erro; em vez disso, oferece um script de avaliação reproduzível e critérios de decisão para você chegar a conclusões reais usando os dados do seu próprio negócio.
Valor principal: depois de ler este artigo, você será capaz de usar um script Python para quantificar a diferença de latência entre a GPT-6 Luna Decisions API e a invocação padrão, e decidir se ela é adequada para negócios de decisão, como classificação, roteamento, moderação e controle de riscos.
🎯 Nota sobre a avaliação: todos os códigos deste artigo foram escritos com base na interface compatível com OpenAI e podem ser executados diretamente via APIYI apiyi.com. O ID específico do modelo, os parâmetros da interface e a cobrança estão sujeitos à documentação oficial e ao console da plataforma.
Principais funcionalidades da Decisions API do GPT-6 Luna
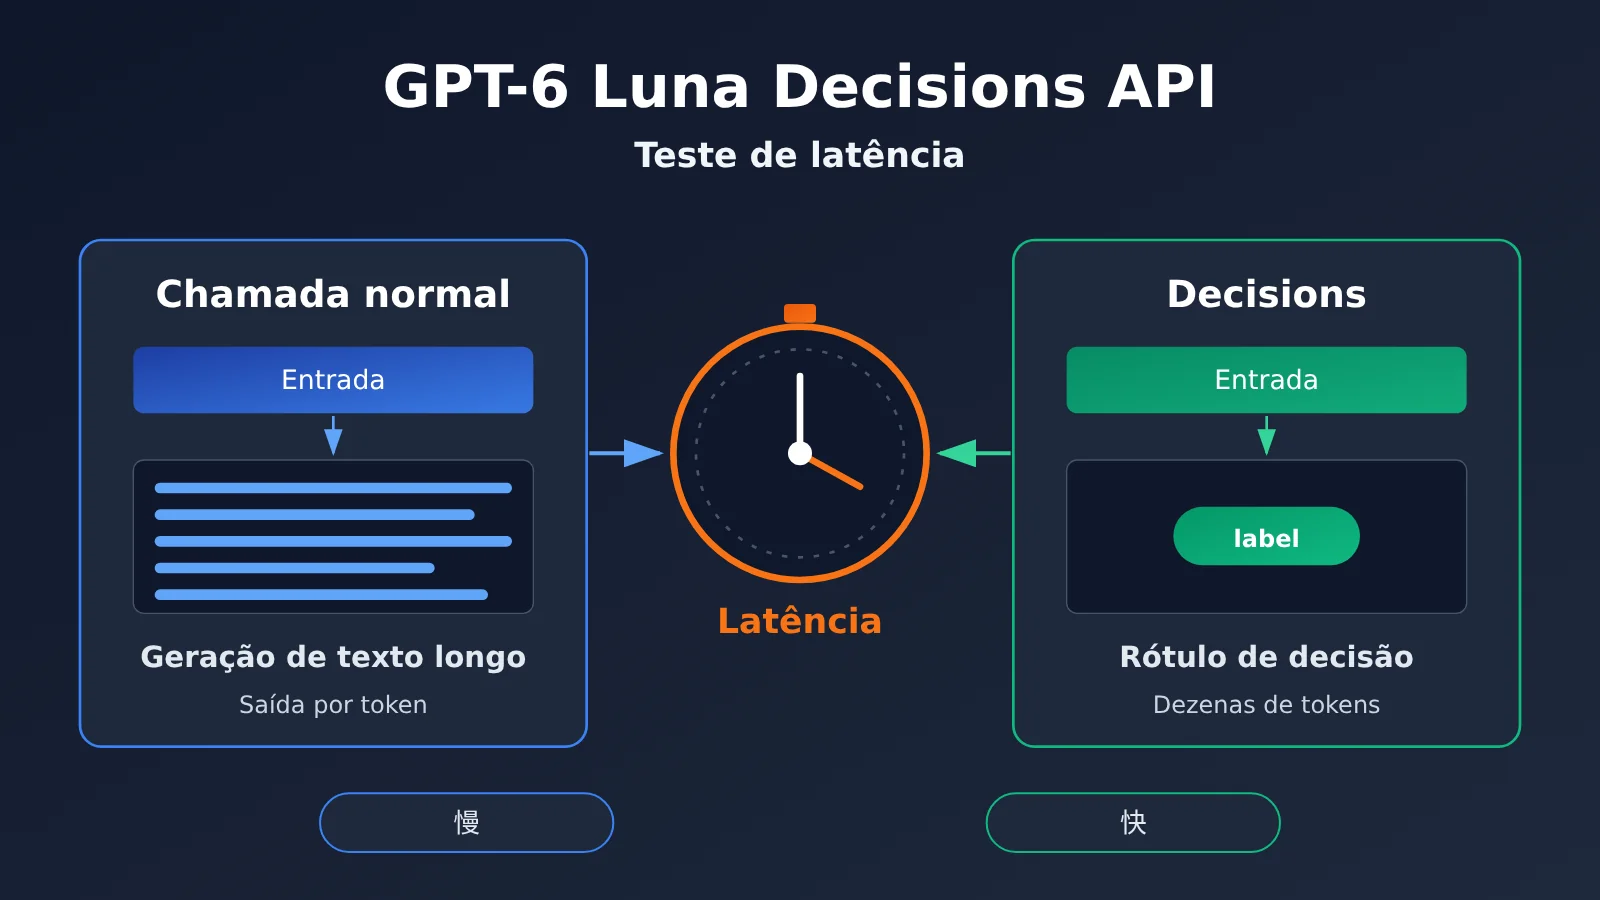
Antes de entender a Decisions API, vale enxergar a diferença de posicionamento dela em relação a uma invocação de chat comum. O objetivo da chamada comum é “gerar um conteúdo”; o da chamada de decisão é “dar um veredito dentro de opções limitadas”. Essas duas classes de tarefa têm comprimento de saída, restrições de formato e composição de latência completamente diferentes.
| Ponto-chave | Descrição | Valor para o desenvolvedor |
|---|---|---|
| Saída orientada a decisão | A saída se concentra em resultados estruturados como rótulos, opções e pontuações, em vez de textos longos | O resultado pode ser consumido diretamente pelo programa, sem parsing secundário |
| Saída curta | Um resultado típico de decisão tem apenas algumas dezenas de tokens, muito menos do que tarefas de geração comuns | O tempo total de resposta depende basicamente do primeiro token e do processamento da entrada |
| Formato restringível | Pode ser combinado com restrições de saída estruturada, como JSON Schema | Reduz a taxa de erros de formato e diminui as retentativas |
| Adequado para alto volume | Requisições de roteamento, classificação e moderação costumam ser volumosas e simples individualmente | As otimizações de latência e custo se multiplicam |
Diferenças entre a Decisions API e as invocações comuns
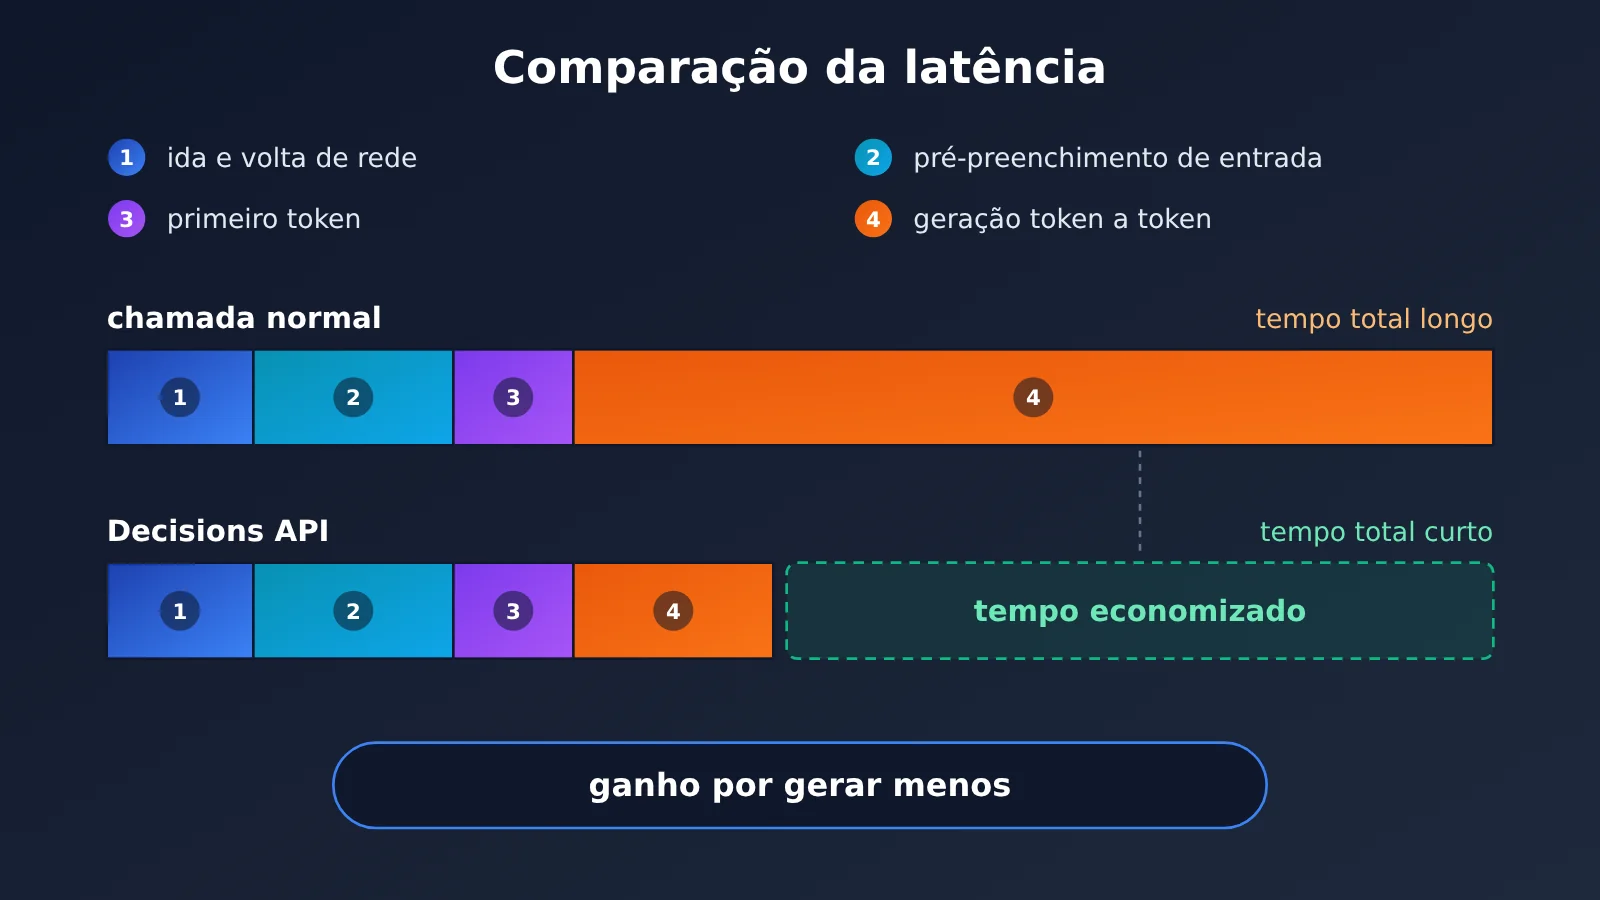
Do ponto de vista de engenharia, o tempo total de uma invocação comum de modelo é composto, grosso modo, por três partes: ida e volta pela rede, processamento da entrada (prefill) e geração token a token. Em tarefas de geração, a terceira parte costuma dominar — quanto mais longa a saída, mais lento o resultado.
A chamada de decisão comprime a saída em um resultado estruturado, e o tempo da etapa de geração encurta bastante. Ou seja, o ganho de velocidade da GPT-6 Luna Decisions API vem principalmente de “gerar menos”, e não de “gerar mais rápido”. Se o seu caso de uso exige texto longo por natureza, essa interface não foi feita para você.
De onde vem o ganho de velocidade da Decisions API
Interfaces orientadas a decisão costumam trazer benefícios extras em dois aspectos. O primeiro é a previsibilidade de formato: o programa não precisa usar regex para pescar a resposta no meio da linguagem natural, e a chance de retentativa por falha cai. O segundo é o controle do processo de raciocínio: se o modelo permitir ajustar a intensidade de raciocínio, cenários de decisão geralmente não precisam de cadeias de pensamento longas, o que reduz ainda mais a espera.
Vale reforçar que tudo isso é análise no nível do mecanismo. O ganho real de velocidade depende do comprimento de saída que você tinha antes: se o modelo já respondia com uma única palavra, o benefício da troca será bem limitado; se antes você pedia “explique primeiro e conclua depois”, o ganho será bastante evidente.
GPT-6 Luna Decisions API: início rápido
Exemplo mínimo
Abaixo está o menor exemplo possível de uma chamada de decisão usando saída estruturada. Substitua o nome do modelo pelo ID real do GPT-6 Luna que aparece no console da plataforma.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # Use o nome exato que aparece na lista de modelos do console
    messages=[{"role": "user", "content": "Conteúdo do ticket: a nota fiscal da minha empresa foi emitida errada. Identifique o departamento responsável."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
O segredo desse código está em max_tokens e response_format: o primeiro limita o teto de saída, o segundo garante que o resultado possa ser interpretado por um programa. Esses dois parâmetros são exatamente o núcleo do ganho de velocidade nas chamadas do tipo decisão.
Ver o script completo de avaliação (comparando a latência entre chamada comum e chamada de decisão)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Chamada pelo endpoint unificado da APIYI
)

MODEL = "gpt-6-luna"  # Use o ID real do console; se houver um modelo/endpoint Decisions dedicado, substitua aqui

SAMPLES = [
    "A nota fiscal da minha empresa foi emitida errada, dá para reemitir?",
    "O app fica dando erro de código de verificação no login",
    "Quero mudar o plano de mensal para anual",
    "O pedido aparece como entregue, mas eu não recebi",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """Retorna o tempo até o primeiro token, o tempo total e o tamanho da saída"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"Analise o ticket abaixo e explique qual departamento deve tratar e por quê: {prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"Ticket: {prompt}. Responda apenas com o departamento."}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
O script usa saída em streaming, então dá para capturar ao mesmo tempo o tempo até o primeiro token (TTFT) e o tempo total. A recomendação é rodar pelo menos 20 vezes por modo, alternando entre eles dentro do mesmo intervalo de tempo, para evitar distorções causadas por oscilação da rede.
🚀 Início rápido: a abordagem recomendada oficialmente é primeiro resgatar o crédito gratuito de teste para novos usuários em APIYI apiyi.com, rodar uma rodada com o script acima usando suas próprias amostras reais de solicitações e só então decidir se vale a pena integrar a GPT-6 Luna Decisions API ao ambiente de produção.
Dados de teste da GPT-6 Luna Decisions API
“Quanto mais rápido do que uma chamada comum?” não tem resposta única, então esta seção traz um framework de avaliação reproduzível. Execute conforme o ambiente e as métricas abaixo para que os números obtidos realmente orientem decisões de negócio.
Configuração do ambiente de teste
| Item de configuração | Configuração sugerida | Descrição |
|---|---|---|
| Ponto de entrada da chamada | Interface compatível com OpenAI (base_url apontando para o gateway unificado) | Garante que os dois modos usem o mesmo caminho de rede |
| Dados de amostra | 20 a 100 solicitações reais de negócio | Latências medidas com dados sintéticos costumam sair otimistas demais |
| Modo de chamada | stream=True |
Só assim é possível medir o tempo até o primeiro token |
| Concorrência | Primeiro com concorrência única, depois aumente gradualmente até o pico do negócio | Observe a variação de latência sob alta concorrência |
| Horário | Teste uma rodada no pico e outra no vale de um dia útil | Elimina diferenças de carga por horário |
Métricas centrais de latência
| Métrica | Significado | Critério de avaliação |
|---|---|---|
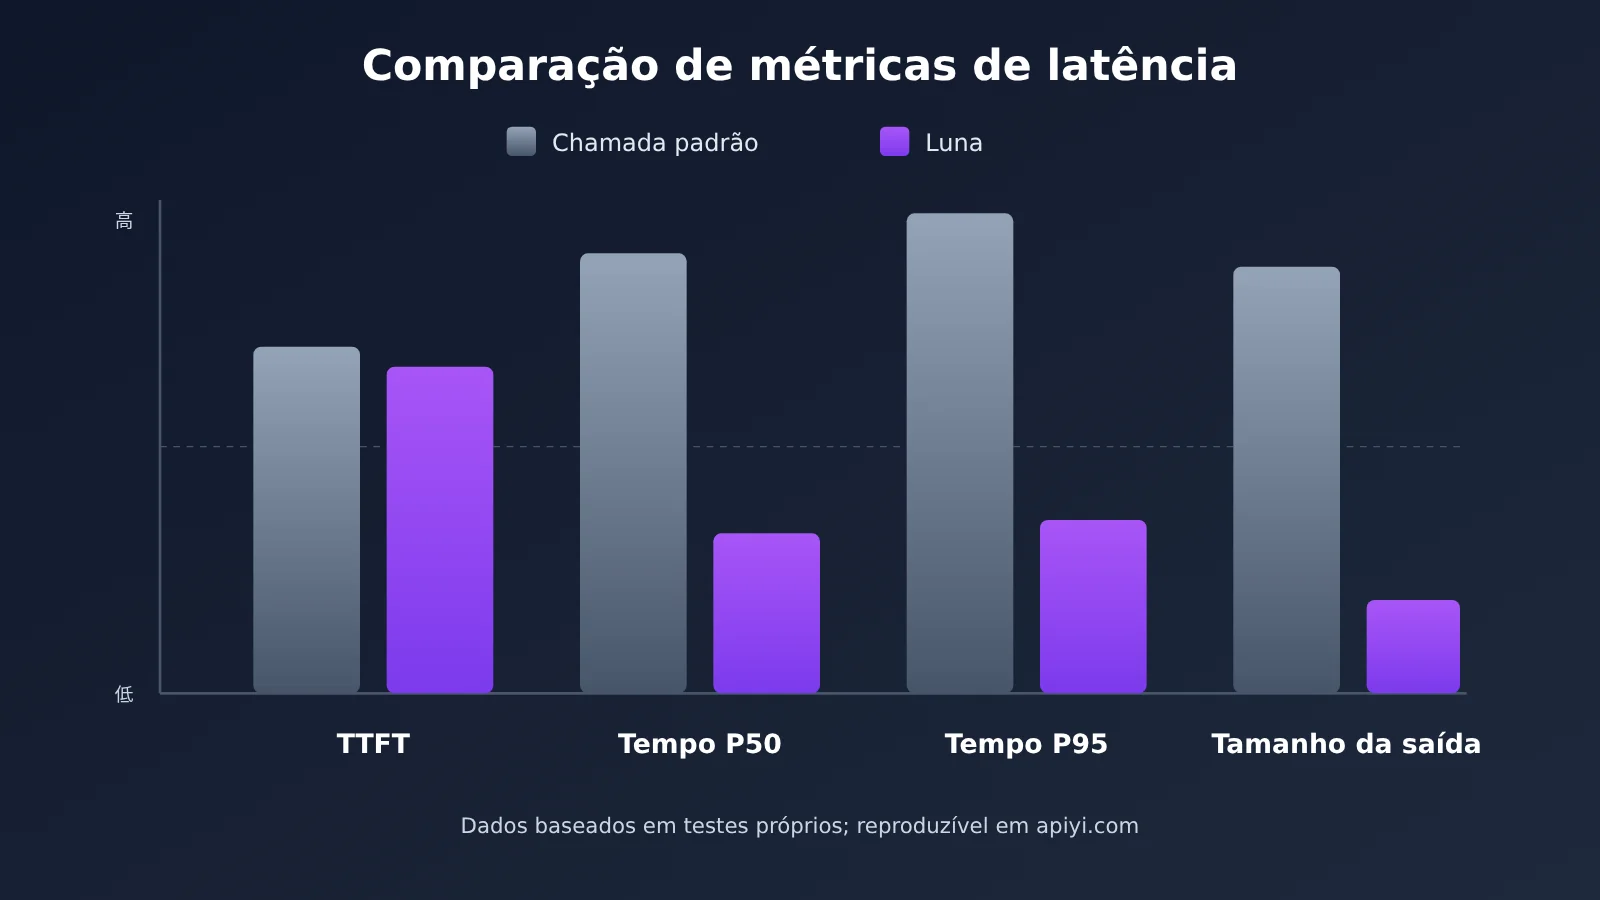
| TTFT (tempo até o primeiro token) | Do envio da solicitação até o recebimento do primeiro caractere | Costuma ser parecido nos dois modos e é afetado principalmente pelo comprimento da entrada |
| Tempo total P50 | Em quanto tempo metade das solicitações é concluída | Métrica central da vantagem do modo de decisão; quanto maior a diferença, mais vale a pena migrar |
| Tempo total P95 | Tempo das solicitações na cauda longa | Define o limite inferior da experiência do usuário; obrigatório para serviços online |
| Comprimento médio da saída | Número de caracteres ou tokens retornados a cada chamada | Ajuda a explicar o ganho de velocidade e está diretamente ligado ao custo |
| Taxa de sucesso de formato | Proporção de resultados retornados que podem ser analisados diretamente | Novas tentativas após falhas consomem o tempo economizado |
Como interpretar os resultados da avaliação da Decisions API
Se você notar que o TTFT é praticamente igual nos dois modos, mas o tempo total P50 tem uma diferença clara, isso indica que o ganho de velocidade vem mesmo de “gerar menos”, que é o resultado mais dentro do esperado. Nesse caso, vale comparar também o comprimento médio da saída: quanto maior a diferença entre os dois, mais significativa será a economia de tempo e de custo de saída.
Se a diferença no P50 não for grande, mas a diferença no P95 for evidente, isso mostra que a cauda longa das chamadas comuns vem principalmente de saídas longas ocasionais. Nesse cenário, mesmo sem um ganho chamativo na média, migrar para a GPT-6 Luna Decisions API ainda pode melhorar bastante a estabilidade de serviços online.
Há ainda o caso em que os dois modos quase não apresentam diferença. Isso normalmente significa que seu comando original já era bem contido. Aí, o valor da migração está mais na confiabilidade do formato do que na velocidade.
💡 Sugestão de validação: para o mesmo lote de amostras, teste de forma alternada no mesmo gateway. Recomendamos rodar a comparação diretamente pela interface unificada da APIYI apiyi.com, para evitar distorções nos resultados causadas por saídas de rede diferentes.
Para quais tipos de negócio a GPT-6 Luna Decisions API é indicada
O valor de uma interface de decisão não está em economizar algumas centenas de milissegundos numa única chamada, mas sim no fato de que, em cenários de alto volume, simples e que precisam que o programa consuma o resultado, esses milissegundos são multiplicados por milhares e milhares de requisições. A tabela abaixo organiza o grau de adequação de cinco tipos típicos de negócio.
| Cenário de negócio | Saída típica | Adequação | Observação |
|---|---|---|---|
| Roteamento de tickets de atendimento | Etiqueta de departamento + confiança | Alta | Volume de requisições grande, opções fixas, ganhos claros tanto em velocidade quanto em formato |
| Moderação de conteúdo | Aprovado / Rejeitado / Revisão humana | Alta | Sensível à latência P95, o resultado precisa acionar o fluxo diretamente |
| Seleção de ferramentas do Agent | Qual ferramenta chamar e com quais parâmetros | Alta | Em Agents de múltiplas etapas, cada passo economiza tempo e o ganho total se acumula |
| Triagem inicial de risco e antifraude | Nível de risco | Média | Adequado como primeira peneira; decisões críticas ainda exigem regras ou revisão humana como rede de segurança |
| Redação de textos longos / geração de relatórios | Grandes blocos de linguagem natural | Baixa | A própria tarefa exige saídas longas, não é o cenário-alvo de uma interface de decisão |
Comparação de soluções: Decisions API e outras abordagens de decisão
Para tarefas de decisão não existe apenas a opção de um Modelo de Linguagem Grande. A tabela abaixo coloca a GPT-6 Luna Decisions API lado a lado com algumas soluções comuns.
| Solução | Característica principal | Cenário indicado | Nível de latência | Plataformas disponíveis |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | Compreensão de LLM + saída curta e estruturada | Decisões semanticamente complexas com opções bem definidas | Baixa (conforme medição própria) | APIYI apiyi.com, API oficial |
| Chamada generativa comum | Flexível, pode incluir justificativa | Decisões de baixa frequência que precisam de explicação | Média a alta, cresce com o tamanho da saída | Principais plataformas de LLM |
| Classificação com modelo pequeno e leve | Barato e rápido, mas com compreensão limitada | Classificações semanticamente simples e com rotulagem suficiente | Baixa | Principais plataformas de LLM ou implantação própria |
| Motor de regras | Latência de milissegundos, totalmente controlável | Regras com condições claras e praticamente imutáveis | Muito baixa | Infraestrutura própria |
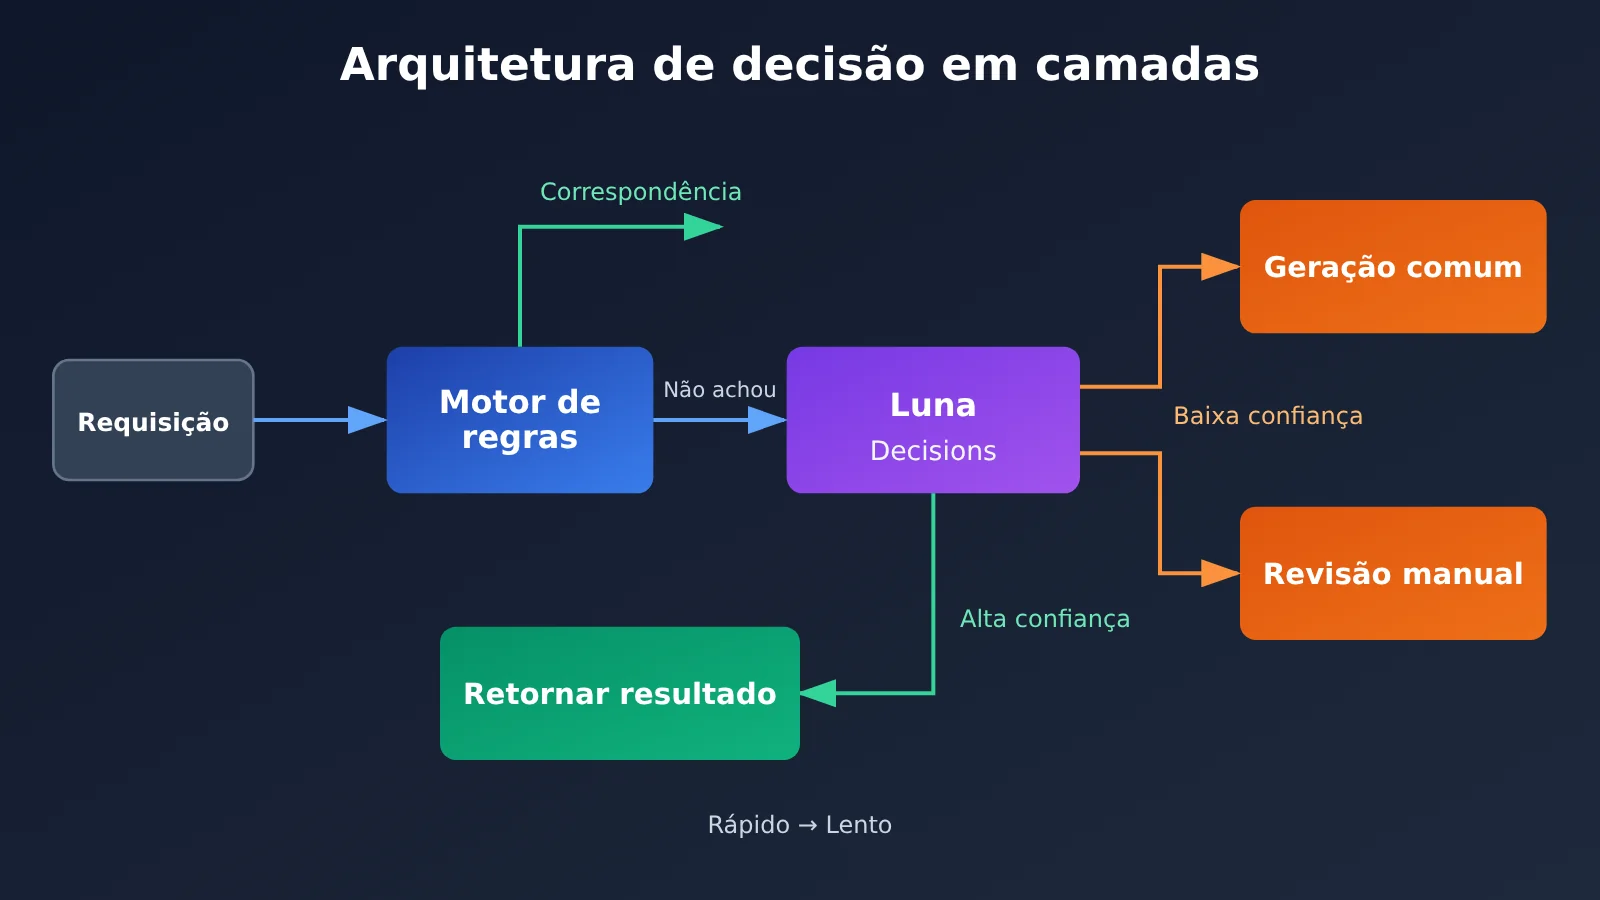
Análise comparativa: o motor de regras continua na liderança em velocidade e controlabilidade, mas, diante de entradas coloquiais e com formulações muito variadas, o custo de manutenção das regras sobe rapidamente. Os modelos pequenos e leves têm vantagem clara de custo, porém entendem pouco de semântica ambígua e de contextos longos. Em comparação, a GPT-6 Luna Decisions API se encaixa melhor em cenários de “semântica complexa, mas espaço de respostas limitado”, sendo uma escolha intermediária entre regras e chamadas generativas comuns.
Na prática, o mais comum é uma arquitetura em camadas: o motor de regras trata condições explícitas, a GPT-6 Luna Decisions API trata requisições ambíguas e, apenas quando é necessário explicar, recorre-se à chamada generativa comum.
Análise de prós e contras da API GPT-6 Luna Decisions
Vantagens
- Tempo total mais controlável: a saída é comprimida em resultados estruturados, o que reduz bastante o tempo da etapa de geração e deixa a latência de cauda mais estável.
- Resultados prontos para consumo: com o JSON Schema, o retorno pode entrar direto no fluxo de negócio, reduzindo código de parsing e retentativas por falha.
- Estrutura de custos mais amigável: menos tokens de saída significam custo de saída menor na mesma proporção, algo especialmente perceptível em cenários de alto volume.
- Baixa barreira de integração: como é baseada no protocolo compatível com OpenAI, o código existente normalmente só precisa ajustar o nome do modelo e as restrições de saída para fazer a troca.
Limitações
- Não é boa em explicar: o resultado da decisão não vem acompanhado de justificativa. Quando precisar de auditoria, vale fazer uma chamada comum extra sobre as amostras de baixa confiança para complementar a explicação.
- O ganho de velocidade varia conforme o cenário: se a chamada original já retornava apenas um rótulo, o benefício da migração é limitado. Recomendo quantificar com um script de avaliação antes de fazer a troca.
- O comprimento da entrada continua sendo um gargalo: a interface de decisão otimiza o lado da saída, então o tempo de prefill de contextos muito longos não desaparece. Quando necessário, faça primeiro um corte na entrada ou uma compressão via recuperação.
- Depende da qualidade do design das opções: definições pouco claras de enum fazem o modelo oscilar entre opções parecidas. O Schema deve trazer opções claras e mutuamente exclusivas.
Perguntas frequentes (FAQ)
Q1: O que é a GPT-6 Luna Decisions API?
É uma forma de invocação voltada para tarefas de decisão. A ideia central é fazer o modelo retornar resultados curtos e estruturados entre opções predefinidas, em vez de gerar textos longos. É ideal para cenários como classificação, roteamento, moderação e seleção de ferramentas. Os parâmetros específicos devem ser consultados na documentação oficial.
Q2: Quanto mais rápida é a Decisions API em comparação com a invocação normal do modelo?
Não existe um multiplicador único. O ganho de velocidade vem principalmente da redução do comprimento da saída: quanto mais longa era a saída original, maior o benefício após a migração. Recomendamos usar o script de avaliação deste artigo para comparar o tempo total P50 e P95 nos seus dados reais e chegar a uma conclusão válida para o seu negócio.
Q3: Qual é a diferença entre a GPT-6 Luna Decisions API e uma invocação comum com saída em JSON?
Uma invocação comum com restrições de JSON também pode produzir efeitos parecidos. A diferença entre as duas abordagens depende de o fornecedor ter feito otimizações específicas para cenários de decisão, como intensidade de raciocínio, restrições de saída e agendamento de serviço. A forma mais confiável de decidir continua sendo um teste comparativo real nas mesmas condições.
Q4: Quais tipos de negócio têm mais a ganhar migrando primeiro?
Priorize negócios com grande volume de requisições, espaço de respostas fixo e sensibilidade à latência, como roteamento de tickets de atendimento, moderação de conteúdo e seleção de ferramentas de Agent. Negócios que naturalmente exigem saídas longas, como redação de textos extensos e geração de relatórios, não são indicados para migração.
Q5: Como invocar rapidamente a GPT-6 Luna Decisions API via API?
Recomendamos seguir os passos abaixo:
1. Acesse APIYI apiyi.com, crie uma conta e obtenha sua chave API
2. No console, confirme na lista de modelos o ID real do modelo GPT-6 Luna
3. Defina o base_url do código deste artigo como `https://api.apiyi.com/v1`, substitua o nome do modelo e execute
A plataforma usa uma interface compatível com OpenAI, e uma única chave permite invocar outros modelos populares ao mesmo tempo para testes comparativos.
Q6: Como controlar o custo de invocação da Decisions API?
As saídas do tipo decisão já economizam tokens de saída. Para otimizar ainda mais, há três frentes: cortar contexto desnecessário, usar um motor de regras para interceptar requisições óbvias e fazer uma segunda invocação apenas para amostras de baixa confiança. No console da APIYI apiyi.com é possível ver o detalhamento de uso por modelo, o que ajuda a identificar os maiores consumidores de custo.
Q7: Quais são as limitações conhecidas da GPT-6 Luna Decisions API?
As principais limitações são: não fornece justificativa da decisão, o ganho de velocidade depende do comprimento da saída original e o tempo de pré-preenchimento de entradas muito longas não pode ser eliminado. Para decisões de alto risco, como nas áreas financeira e de saúde, recomendamos usá-la como apoio à decisão e manter uma etapa de revisão humana.
GPT-6 Luna Decisions API: principais pontos (Key Takeaways)
- Posicionamento claro: o Decisions API resolve o problema de “decidir rápido entre opções limitadas”, e não de gerar textos longos.
- De onde vem o ganho de velocidade: principalmente da saída mais curta. Quanto mais longa era a saída original, mais evidente fica o ganho ao trocar de abordagem.
- Métricas-chave: foque no tempo total P50 e P95. O TTFT costuma ser parecido nos dois modos.
- Melhores cenários: tarefas de decisão de alta frequência, como roteamento de tickets, moderação de conteúdo e escolha de ferramentas do Agent.
- Arquitetura recomendada: mecanismo de regras + Decisions API + invocação comum, em um esquema de fallback em camadas.
- Como começar: rodar um script de comparação na interface compatível com OpenAI, usar os seus próprios dados como referência e só então migrar.
Resumo
Os pontos centrais do GPT-6 Luna Decisions API:
- Rápido porque gera menos: a vantagem de velocidade vem principalmente da saída estruturada e curta, e não de um aumento na velocidade de geração por token.
- O valor depende do cenário: negócios de alta frequência, com opções fixas e sensíveis à latência são os que mais ganham — cenários de texto longo não se aplicam.
- A conclusão vem do teste real: a variação de ganho muda bastante conforme o comando e a amostra, então rode sempre com dados reais para chegar ao P50 e ao P95.
Se você trabalha com roteamento de atendimento, moderação de conteúdo ou orquestração de Agent, vale avaliar o GPT-6 Luna Decisions API com atenção. A sugestão é manter a invocação original como grupo de controle, migrar gradualmente uma parte do tráfego e, a partir daí, decidir se vale migrar tudo com base na latência e na taxa de sucesso de formato.
Recomendamos resgatar os créditos gratuitos via APIYI apiyi.com e usar o script deste artigo para validar rapidamente o ganho real de velocidade no seu cenário de negócio.
📚 Materiais de Referência
- Documentação oficial da API OpenAI: explicações sobre invocação de modelos, saída em streaming e saída estruturada
- Link:
platform.openai.com/docs -
Descrição: fonte autoritativa para confirmar o GPT-6 Luna e os parâmetros relacionados ao Decisions
-
SDK Python da OpenAI: cliente Python oficial
- Link:
github.com/openai/openai-python -
Descrição: o SDK usado pelo script de avaliação deste artigo, incluindo exemplos de chamada em streaming
-
Especificação JSON Schema: padrão de definição de restrições para saída estruturada
- Link:
json-schema.org - Descrição: especificação de referência para projetar as opções de decisão e os valores de enumeração
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para nos contatar pela página inicial do site APIYI; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com