Примечание автора: на примере разбора эксперимента, в котором Astra переписала веса Qwen3.5-0.8B, объясняем разницу между «неправильным ответом» и «незавершённым ответом» при оценке рассуждающих моделей, а также показываем, как разделять результаты с учётом усечения.
2 ноября четверо исследователей из MIT CSAIL опубликовали пост «Искры программирования в пространстве весов». В нём говорится, что GPT-6 Astra изменила всего около 0.016% параметров Qwen3.5-0.8B, и результат на MATH-500 вырос с 7.9% до 48.1%. Показатели на GSM8K и IFEval тоже существенно улучшились. Публикацию быстро подхватили как знаковый пример того, как «ИИ меняет мозг другого ИИ».
Это не попытка поставить исследование под сомнение. В открытом репозитории проекта есть пошаговые логи 1,125 вызовов. При разборе журналисты пересчитали результаты по каждой задаче и пришли к более скромному выводу: почти весь прирост объясняется тем, что «модель наконец смогла дописать ответы», а не тем, что «модель стала лучше решать математические задачи».
Главное в этой статье: мы не будем снова обсуждать, можно ли считать этот результат подтверждением RSI. Вместо этого мы собрали на основе разбора универсальный подход к оценке рассуждающих моделей. Он поможет при выборе, настройке или запуске модели понять, чем вызвано изменение результата: разницей в способностях или усечением из-за повторяющихся циклов.
Ключевые факты об оценке модели с режимом рассуждения
Сначала соберём основные факты, связанные с оценкой. Все данные взяты из оригинального блога и публикаций СМИ, в которых разобрали открытый репозиторий.
| Параметр | Подробности |
|---|---|
| Дата публикации | 2 ноября 2026 года, блог исследователей MIT CSAIL |
| Модифицированная модель | Qwen3.5-0.8B: изменено 131 072 веса, около 0,016% от общего числа |
| Заявленные результаты | MATH-500: 7,9%→48,1%; GSM8K: 13,8%→67,1%; IFEval: 21,0%→62,3% |
| Настройки оценки | Режим рассуждения включён, лимит вывода — 32 768 токенов, температура — 0,6 |
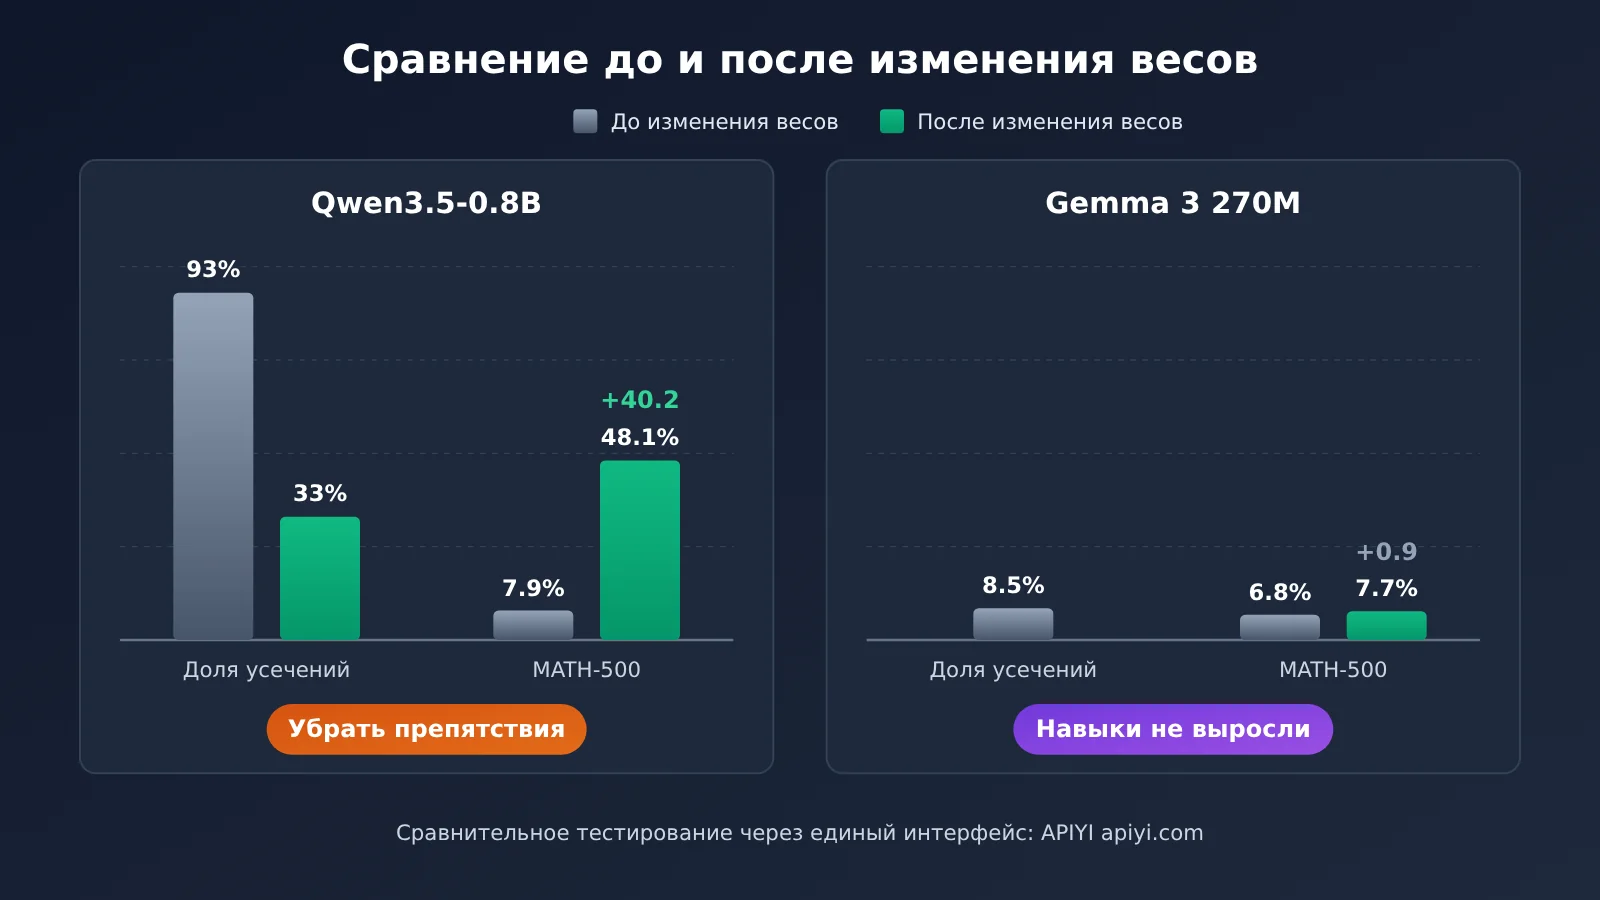
| Базовая модель | Около 93% ответов достигали лимита, но модель так и не останавливалась |
| После модификации | Доля ответов, достигших лимита, снизилась с 93% до 33% |
| Вывод разбора | Патч в основном устранил циклы повторений, но не улучшил математические способности модели |
Откуда берётся «обрезание» ответов при оценке моделей с режимом рассуждения
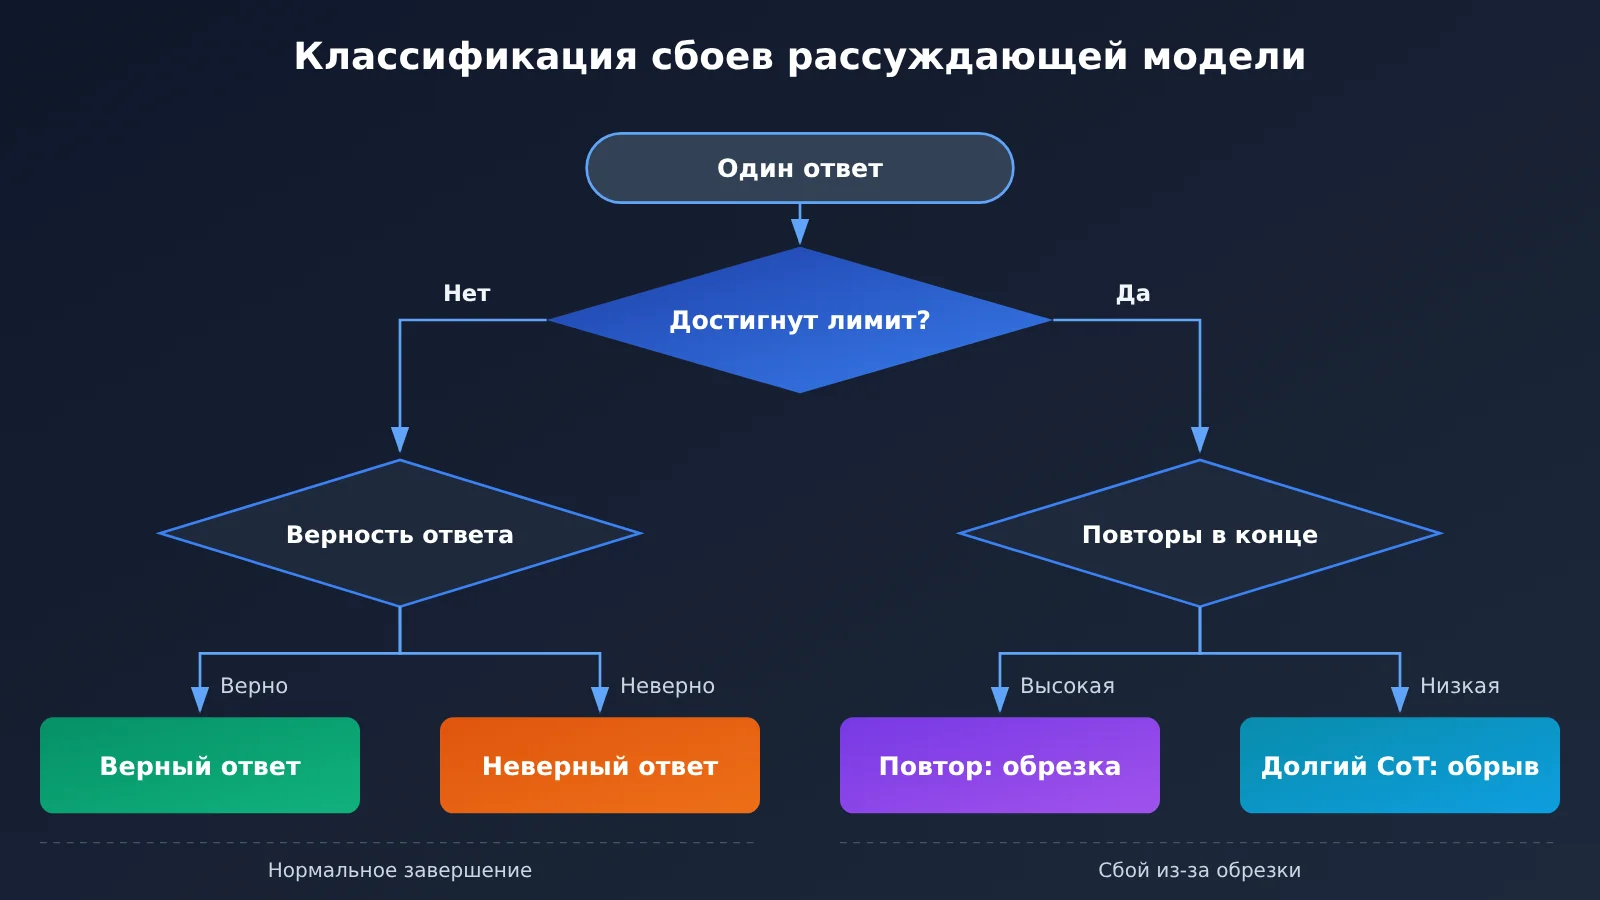
Когда Astra впервые запустила Qwen на 96 тренировочных задачах, модель правильно ответила только на 11. В остальных 85 случаях дело было не в ошибках вычислений: модель продолжала писать, пока не достигала лимита длины. При анализе конца обрезанных ответов по фрагментам из восьми слов выяснилось, что около 95% текста составляли повторения. Все 11 задач, в которых ответ завершился нормально, модель решила правильно.
Это говорит о том, что главной причиной низкого базового результата было не «не умеет решать», а «не может сдать работу». Примечательно, что в первом промпте для Astra исследователи уже указали один из типов сбоев: «ответ обрезается по лимиту токенов, часто из-за повторений в ходе рассуждения». А в качестве примера полезного улучшения предложили «исправить то, что вызывает повторения». В итоговом отчёте Astra тоже указала, что её целью были повторения, а не математические знания.
Разбор результатов оценки модели с рассуждениями: весь прирост пришёлся на обрезанные ответы
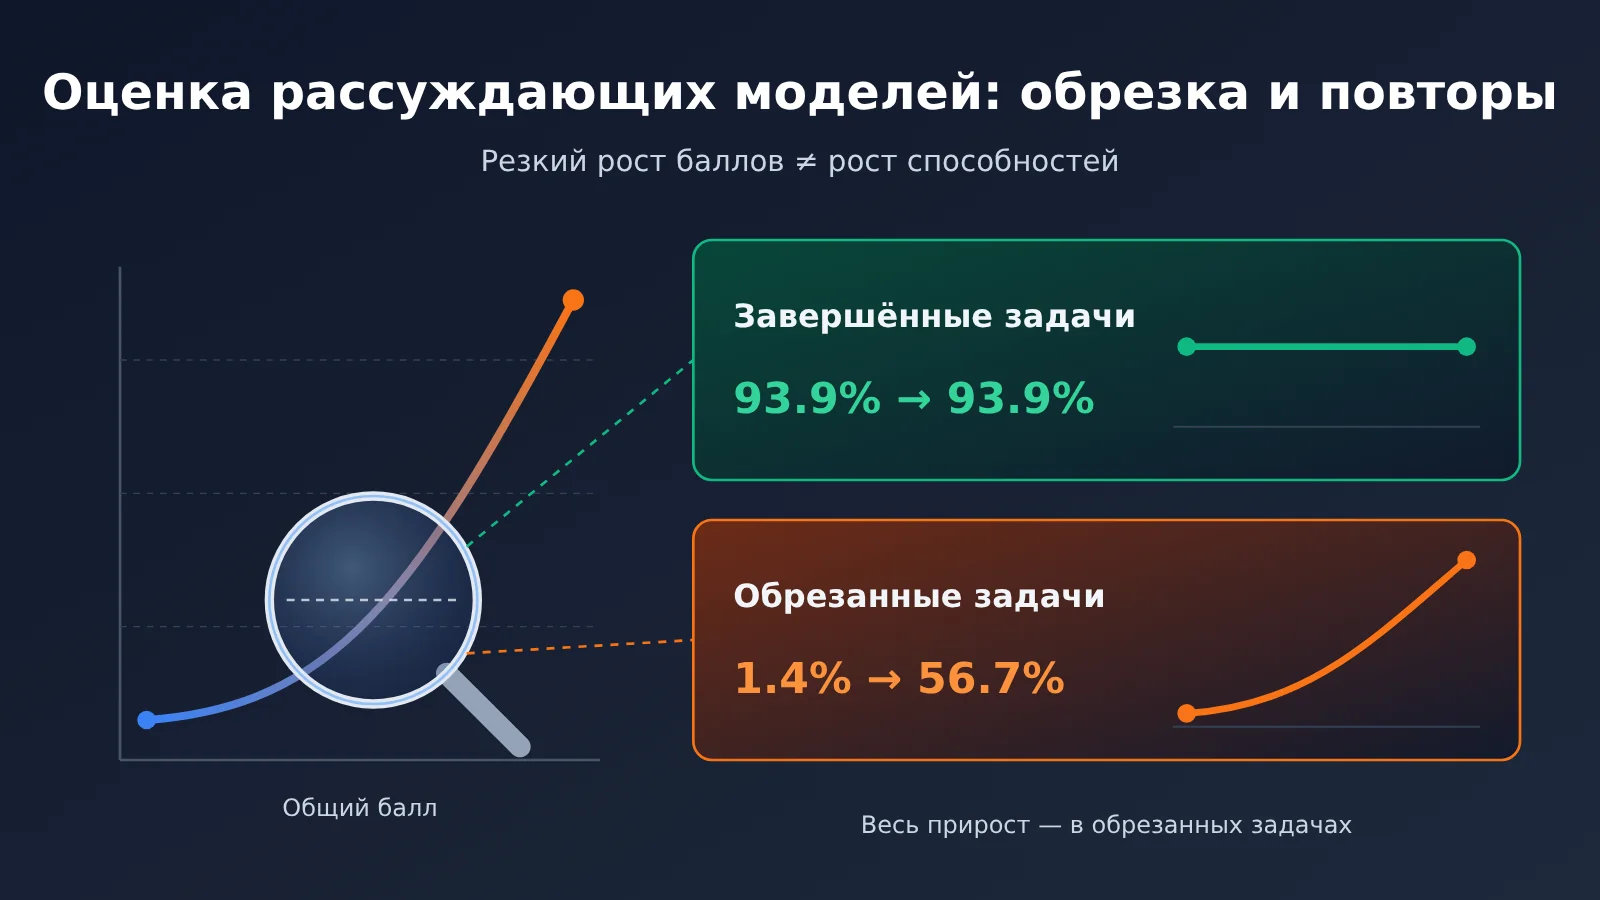
Самый убедительный результат в разборе — парное тестирование до и после изменения на 1 152 отложенных тренировочных задачах. Достаточно разделить их на две группы по тому, был ли исходный ответ обрезан, чтобы увидеть ясную картину.
| Группа задач | Число задач | Доля правильных ответов до изменения | Доля правильных ответов после изменения | Изменение |
|---|---|---|---|---|
| Задачи, на которые модель изначально успевала ответить | 114 | 93.9% | 93.9% | Без изменений |
| Задачи, на которых ответ изначально обрывался | 1,038 | 1.4% | 56.7% | Источник всего прироста |
| Ответ изменился с неправильного на правильный | 579 | — | — | Из них 576 изначально были обрезаны |
| Ответ изменился с правильного на неправильный | 5 | — | — | На уровне статистического шума |
Есть и деталь, которую легко упустить: до изменения модель завершала ответ с ошибкой всего в 7 задачах, а после — уже в 245. Когда повторяющиеся циклы прекратились, стали заметны настоящие вычислительные ошибки модели. В официальном тесте MATH-500 средняя длина ответа снизилась с 30,868 до 22,037 токенов. Это снижение также пришлось в основном на ответы, которые раньше достигали лимита.
Проверка выводов на контрольной модели
Исследователи и сами обратили на это внимание, поэтому провели такой же эксперимент с Gemma 3 270M. Сравнение двух экспериментов хорошо показывает, что «убрать препятствие» и «добавить способности» — не одно и то же.
| Показатель | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| Доля ответов, достигших лимита | Около 93% | Около 8.5% |
| Основной тип ошибок | Повторяющиеся циклы, ответ не завершается | Арифметические ошибки, некорректные шаги рассуждения |
| MATH-500 после изменения весов | 7.9%→48.1% | 6.8%→не более 7.7% |
| Характер улучшения | Устранено препятствие, мешавшее проявить имеющиеся способности | Добавить способности, которых изначально не было, почти не удалось |
В исходной статье авторы тоже признают: изменение весов может убрать препятствие, мешающее проявить способности, но не может добавить модели способности, которых у неё нет. Для специалистов по оценке моделей это означает следующее: один и тот же «резкий рост показателя» может иметь совершенно разный смысл в зависимости от характера ошибок.
Ловушка параметров при оценке рассуждающих моделей: температура и режим рассуждений
В этом споре часто упускают важный момент: сами настройки оценки могли провоцировать зацикливание. Согласно официальной карточке модели Qwen3.5-0.8B, на которую ссылается разбор в СМИ, рекомендации отличаются от настроек, использованных исследователями.
| Параметр | Рекомендация в карточке модели | Настройки эксперимента | Влияние |
|---|---|---|---|
| Режим рассуждений | У модели 0.8B по умолчанию выключен | Принудительно включён | Небольшая модель чаще зацикливается в процессе рассуждений |
| Температура для текстовых задач в режиме рассуждений | Рекомендуется 1.0 | 0.6 | В карточке модели значение 0.6 предназначено для задач анализа изображений и написания кода |
| Рекомендации при зацикливании | Изменить параметры сэмплирования и вовремя прерывать потоковый вывод | Генерация до лимита в 32,768 токенов | Многие ответы были признаны неудачными |
Стоит отметить, что информация из карточки модели приведена здесь по пересказу в СМИ. Перед оценкой лучше свериться с оригиналом официальной карточки Qwen. Главное здесь — подход: у одной и той же модели «базовый результат» может полностью измениться при другой настройке параметров сэмплирования. Если исходный результат получен в условиях, провоцирующих зацикливание, любое изменение, которое помогает модели остановиться, будет выглядеть как резкий скачок возможностей.
Чек-лист оценки рассуждающих моделей: сначала разберитесь с обрезанными ответами, потом делайте выводы
Из этого разбора можно вывести подход к оценке любой рассуждающей модели. Выбираете модель, настраиваете параметры или проверяете изменения после дообучения либо правки промпта — в любом случае можно пройтись по таблице.
| Что проверить | Что делать | На что обратить внимание |
|---|---|---|
| 1. Разделить ответы по признаку обрезания | Посчитать долю ответов с finish_reason == "length" и точность для каждой группы |
Если доля обрезанных ответов выше 10%, напрямую сравнивать общие результаты нельзя |
| 2. Проверить повторы | Подсчитать повторяющиеся n-граммы в конце обрезанных ответов | Высокая частота повторов указывает на зацикливание, а не на слишком длинное рассуждение |
| 3. Проверить параметры сэмплирования | Сверить температуру, top_p и настройку режима рассуждений с карточкой модели | Если параметры отличаются от официальных рекомендаций, это нужно отметить отдельно |
| 4. Провести попарное сравнение | Сопоставить ответы на каждый вопрос до и после изменения, посчитать переходы от неверного ответа к верному и наоборот | Если рост сосредоточен в группе обрезанных ответов, это результат «устранения препятствия» |
| 5. Провести сравнение с контрольной моделью | Добавить контрольную модель с низкой долей обрезанных ответов и использовать те же промпты и параметры | Если результат контрольной модели не растёт, улучшение не связано с ростом способностей |
🎯 Совет по оценке: при сравнении моделей самое хлопотное — писать отдельный код вызова для каждой из них. Через OpenAI-совместимый интерфейс APIYI apiyi.com можно вызывать популярные модели одним скриптом, используя одинаковые промпты и параметры. Так удобнее выводить долю обрезанных ответов в отдельном столбце статистики.
Скрипт для оценки моделей с режимом рассуждения: минимальный пример
Код ниже подсчитывает долю задач, в которых ответ был обрезан из-за ограничения длины. Значение finish_reason, равное length, означает, что достигнут предел max_tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # Замените на фактическое имя модели
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
Посмотреть полный код (с точностью по группам и долей повторов в конце ответа)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """Подсчитывает долю повторяющихся n-грамм в конце текста (для китайского можно разбивать текст на символы)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: функция проверки правильности ответа"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
Обратите внимание: единого способа включить или выключить режим рассуждения у разных моделей нет. В одних случаях он задаётся полем запроса, в других — именем модели или шаблоном промпта. То, учитываются ли рассуждения в max_tokens и возвращаются ли они отдельно, тоже зависит от модели. Перед оценкой обязательно изучите документацию каждой из них.
🚀 Быстрый старт: если вы хотите сначала проверить этот способ разбивки на группы, зарегистрируйтесь на APIYI apiyi.com и воспользуйтесь бесплатными тестовыми кредитами. Выберите две-три модели с режимом рассуждения, прогоните несколько десятков задач и сравните долю обрезанных ответов. После этого можно решить, стоит ли расширять оценку.
Анализ последствий инцидента с оценкой рассуждающей модели
Влияние на разработчиков
- Общий балл больше не даёт надёжной картины: если смотреть только на общую долю правильных ответов, легко смешать незавершённые и неправильные ответы. Перед запуском отчёт об оценке должен включать как минимум два показателя: долю усечённых ответов и долю правильных ответов по группам.
- Результат настройки параметров легко неверно истолковать: повышение лимита вывода, изменение температуры или добавление штрафа за повторы могут существенно улучшить балл. Но это скорее устранение препятствий, а не замена модели.
- Проблема затрагивает и продакшен: там усечение ответов при тестировании оборачивается слишком длинными ответами, неконтролируемым ростом расходов и долгим ожиданием для пользователей. В карточке модели рекомендуется использовать потоковую выдачу вместе с обнаружением зацикливания и досрочным прерыванием генерации.
Влияние на исследования оценки моделей
- «Значительное улучшение» требует детального разбора: этот анализ показал, что результат, похожий на скачок в способностях, после разделения ответов по признаку усечения может оказаться просто следствием исправления бага. В дальнейшем при любом заявлении об улучшении небольшой или рассуждающей модели стоит уточнять, как изменилась доля усечённых ответов.
- Дизайну контрольных экспериментов уделяется больше внимания: дополнительные эксперименты с Gemma 3 270M и собственный контрольный эксперимент Astra со случайным направлением, в котором результат изменился всего примерно на 1,5 процентного пункта, показывают, что контрольные группы помогают отличить реальный сигнал от шума.
Частые вопросы FAQ
Q1: Что такое «ловушка усечения» при оценке рассуждающих моделей?
Это ситуация, когда модель зацикливается в процессе рассуждения и продолжает писать до достижения лимита токенов, так и не дав ответа. Система оценки засчитывает такой результат как ошибку. Низкий балл в этом случае означает «не успела закончить», а не «не смогла решить».
Q2: Как отличить низкий балл из-за усечения от недостатка способностей?
Разделите задачи на две группы в зависимости от того, был ли достигнут лимит, и рассчитайте долю правильных ответов для каждой. Если среди завершённых задач она высока, а в группе с усечением близка к нулю, проблема в зацикливании. Если же модель часто ошибается и в завершённых задачах, это указывает на недостаток способностей. Сравнение Qwen и Gemma как раз иллюстрирует эти два случая.
Q3: Когда был опубликован эксперимент Astra по модификации Qwen?
Оригинальный пост в блоге вышел 2 ноября 2026 года, а статья в СМИ с разбором на основе журналов публичного репозитория — 5 ноября. Данные в этой статье приведены по разбору; детали карточки модели рекомендуется сверить с официальной публикацией Qwen.
Q4: Для каких задач подходит этот метод оценки?
— **Выбор модели**: сравнение разных рассуждающих моделей на математических задачах или задачах программирования
— **Настройка параметров**: оценка реального эффекта от изменения температуры, лимита токенов и включения или отключения режима рассуждения
— **Проверка улучшений**: определение того, повысили ли дообучение, промпт или редактирование весов способности модели либо лишь устранили препятствие
Q5: Как сравнить несколько рассуждающих моделей через единый интерфейс?
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ
2. Установите для base_url в скрипте из этой статьи значение `https://api.apiyi.com/v1`
3. Зафиксируйте промпт, температуру и max_tokens, меняйте только имя модели и выводите долю усечённых ответов и долю правильных ответов по группам
Способы включения режима рассуждения у моделей различаются, поэтому параметры запроса нужно настроить в соответствии с документацией каждой модели.
Q6: Какие ограничения есть у этого метода разделения?
Разделение по усечению позволяет выявить только незавершённые ответы, но не помогает определить, был ли завершённый ответ правильным по случайности. Порог повторяемости в конце ответа нужно подбирать с учётом языка и задачи: например, китайский текст рекомендуется разбивать по символам, а не по пробелам. Кроме того, некоторые модели возвращают содержимое рассуждений не полностью — в таких случаях нужно также учитывать статистику токенов в usage. При ограниченном бюджете можно сначала провести пробный запуск на небольшой выборке через APIYI apiyi.com, а затем, определившись с методикой подсчёта, увеличить масштаб.
Оценка моделей с рассуждением: главное
- Источник прироста: на 114 задачах, где Qwen успел завершить ответ, точность до и после изменения составила 93,9%. Весь прирост пришёлся на задачи с обрезанными ответами.
- Тип сбоя: в базовом тесте 93% ответов достигли лимита, причём около 95% текста в их конце составляли повторы.
- Различие параметров: температура 0,6 в тесте не совпадала с температурой 1,0, рекомендованной в карточке модели для текста рассуждений.
- Контрольный тест: у Gemma 3 270M доля обрезанных ответов была низкой, а после изменения весов результат на MATH-500 вырос менее чем на 1 процентный пункт.
- Суть метода: сначала разделить ответы по признаку усечения с помощью
finish_reason, а затем сравнить точность. - Как начать: через единый интерфейс APIYI apiyi.com собрать статистику усечений для нескольких моделей при одинаковых параметрах.
Итоги
Спор вокруг «изменения весов Qwen компанией Astra» напомнил всем, кто оценивает модели с рассуждением, о нескольких важных вещах:
- Резкий рост баллов нужно разбирать по частям: разделите ответы на группы по тому, достигли ли они лимита токенов, и посмотрите, откуда пришёл прирост.
- Параметры — часть базовых условий: температуру, настройку режима рассуждений и лимит вывода нужно сверить с карточкой модели и указать в отчёте.
- Устранение препятствия — не то же самое, что повышение способностей: используйте контрольную модель с низкой долей усечений, чтобы проверить, чем именно вызвано улучшение.
В следующий раз, когда увидите утверждение, что «какое-то изменение повысило результат в несколько раз», сначала спросите: насколько изменилась доля усечённых ответов? Зачастую этот вопрос говорит о происходящем больше, чем общий балл.
Если вы готовитесь оценить несколько моделей с рассуждением перед запуском, попробуйте через APIYI apiyi.com собрать статистику усечений с помощью одного скрипта и одинаковых параметров. Это поможет определиться с выбором модели.
📚 Источники
- Разбор Silicon Star Pro (перепубликация на 36氪): нашумевшая история о том, как «Astra переделала мозг Qwen», имеет мало общего с RSI, которого мы ждём
- Ссылка:
36kr.com/p/4056494372181124 -
Описание: попарные результаты тестов, пересчитанные по записям для каждой задачи из публичного репозитория; основной источник данных для этой статьи
-
Блог исследователей MIT CSAIL: Sparks of Weight-Space Programming
-
Описание: оригинальное описание эксперимента и таблицы результатов; рекомендуем свериться с оригиналом при изучении условий эксперимента 8
-
Официальная карточка модели Qwen3.5-0.8B: параметры сэмплирования и описание режима размышления
- Описание: сведения о том, включён ли режим размышления по умолчанию, рекомендуемой температуре и обработке зацикливания
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через официальный сайт APIYI — apiyi.com. Подробнее о вызовах моделей читайте в документации на docs.apiyi.com