Anmerkung des Autors: Ausgehend von einer Nachanalyse des Experiments, bei dem Astra die Gewichte von Qwen3.5-0.8B verändert hat, erklären wir den Unterschied zwischen „falsch beantwortet“ und „nicht zu Ende geschrieben“ bei der Bewertung von Reasoning-Modellen – und zeigen, wie sich Ergebnisse nach abgeschnittenen und vollständigen Antworten aufschlüsseln lassen.
Am 2. November veröffentlichten vier Forschende des MIT CSAIL den Blogbeitrag „Funken des Programmierens im Gewichtsraum“. Darin berichten sie, dass GPT-6 Astra nur rund 0,016 % der Parameter von Qwen3.5-0.8B verändert habe und das Ergebnis bei MATH-500 daraufhin von 7,9 % auf 48,1 % gestiegen sei. Auch bei GSM8K und IFEval legte das Modell deutlich zu. Der Beitrag wurde daraufhin vielfach als Meilenstein für „KI verändert das Gehirn einer KI“ geteilt.
Es geht nicht darum, die Studie infrage zu stellen. Das öffentliche Repository enthält detaillierte Protokolle zu 1.125 Aufrufen. Bei einer erneuten Auswertung der einzelnen Aufgaben kam eine journalistische Nachanalyse zu einem nüchterneren Schluss: Der Punkteanstieg war fast vollständig darauf zurückzuführen, dass „das Modell seine Antworten endlich zu Ende schreiben konnte“ – nicht darauf, dass es „besser in Mathematik geworden war“.
Der Nutzen dieses Artikels: Wir diskutieren nicht erneut, ob RSI erreicht wurde. Stattdessen leiten wir aus der Nachanalyse eine wiederverwendbare Methode zur Bewertung von Reasoning-Modellen ab. Sie hilft dir bei der Modellauswahl, beim Feintuning oder vor dem Produktiveinsatz zu beurteilen, ob eine Punktzahländerung auf unterschiedliche Fähigkeiten zurückgeht – oder auf abgeschnittene Antworten durch Wiederholungsschleifen.
Die wichtigsten Fakten zum Test des Denkmodells
Hier zunächst die zentralen Fakten zum Test. Die Angaben stammen aus dem ursprünglichen Blogbeitrag und Medienanalysen des öffentlichen Repositorys.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 2. November 2026, Blog von Forschenden des MIT CSAIL |
| Modifiziertes Modell | Qwen3.5-0.8B, 131,072 Gewichte geändert, rund 0.016% |
| Gemeldete Ergebnisse | MATH-500 7.9%→48.1%; GSM8K 13.8%→67.1%; IFEval 21.0%→62.3% |
| Testeinstellungen | Denkmodus aktiviert, Ausgabelimit 32,768 Token, Temperatur 0.6 |
| Ausgangszustand | Rund 93% der Antworten erreichten das Limit, ohne zu enden |
| Zustand nach der Änderung | Der Anteil der Antworten, die das Limit erreichten, sank von 93% auf 33% |
| Fazit der Analyse | Der Patch behob hauptsächlich Wiederholungsschleifen; die mathematischen Fähigkeiten verbesserten sich nicht |
Woher kommt das „Abschneiden“ beim Test von Denkmodellen?
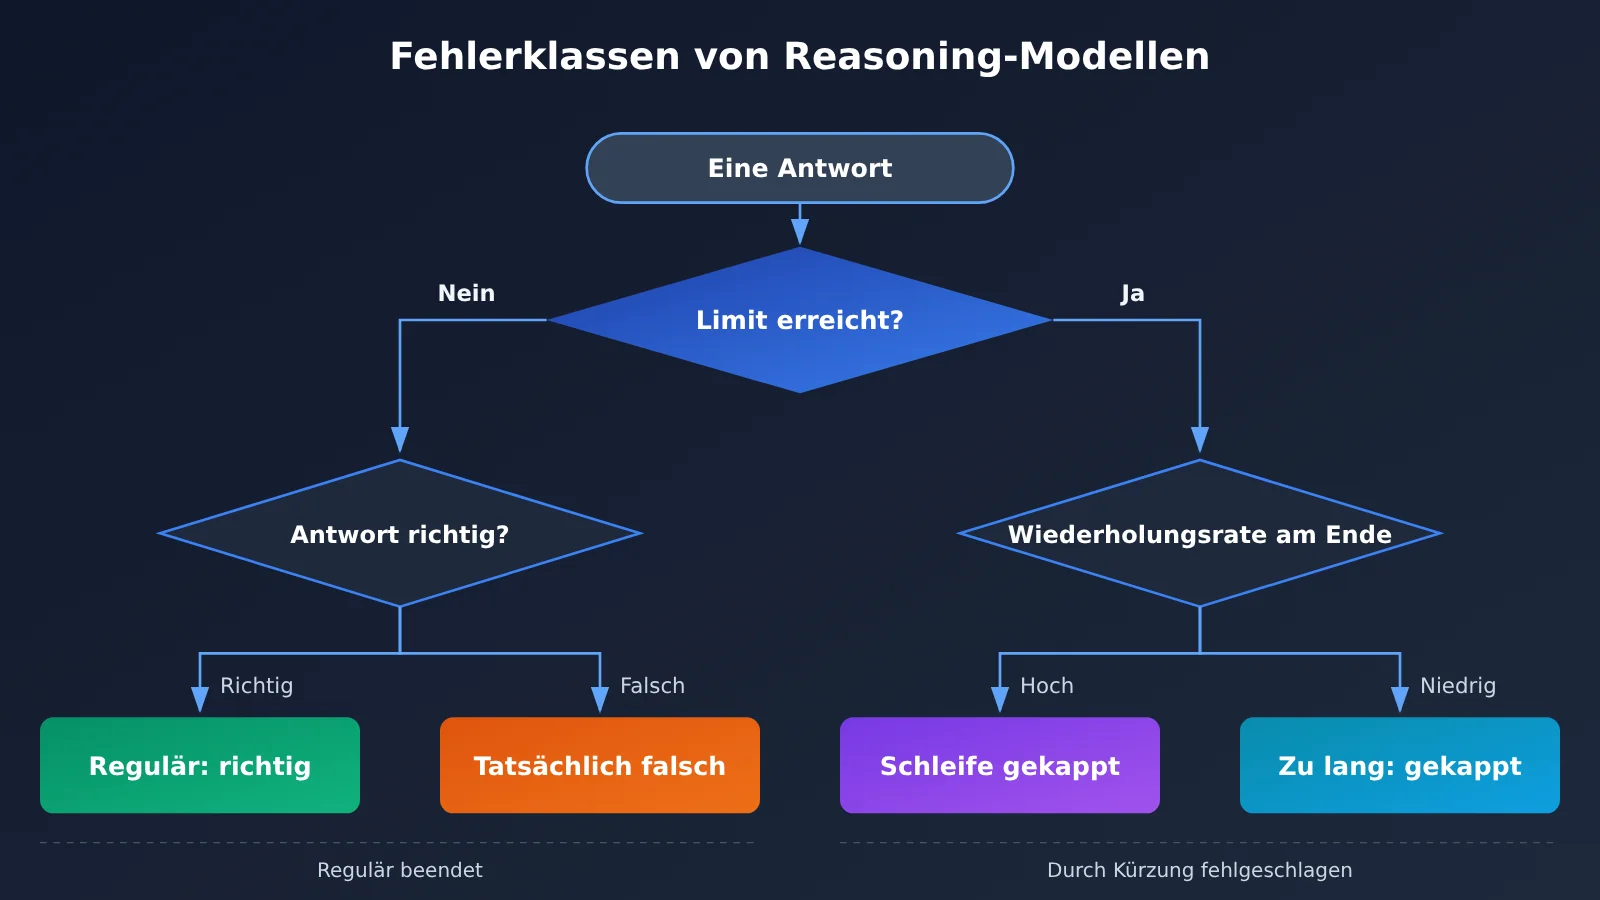
Als Astra Qwen erstmals 96 Übungsaufgaben bearbeiten ließ, beantwortete das Modell nur 11 richtig. Die übrigen 85 waren nicht etwa falsch berechnet: Bei allen erreichte die Ausgabe das Längenlimit, ohne zu enden. Eine Analyse des Endes der abgeschnittenen Texte in Abschnitten von jeweils acht Wörtern zeigte, dass rund 95% aus Wiederholungen bestanden. Die 11 Aufgaben, bei denen die Ausgabe regulär endete, waren alle richtig beantwortet.
Das zeigt: Der Hauptgrund für das schwache Ausgangsergebnis war, dass das Modell seine Antworten nicht rechtzeitig abgab – nicht, dass es die Aufgaben nicht lösen konnte. Bemerkenswert ist, dass die Forschenden in ihrer ersten Eingabeaufforderung an Astra bereits einen Fehlertyp nannten: Antworten, die am Token-Limit abgeschnitten werden, weil sich das Modell beim Nachdenken häufig wiederholt. Als Beispiel für eine wirksame Verbesserung führten sie an, die Ursache dieser Wiederholungen zu beheben. Auch Astras Abschlussbericht hält fest, dass die Änderung auf Wiederholungen abzielte, nicht auf mathematisches Wissen.
Auswertung der Reasoning-Modelle: Der gesamte Zuwachs entfällt auf abgeschnittene Antworten
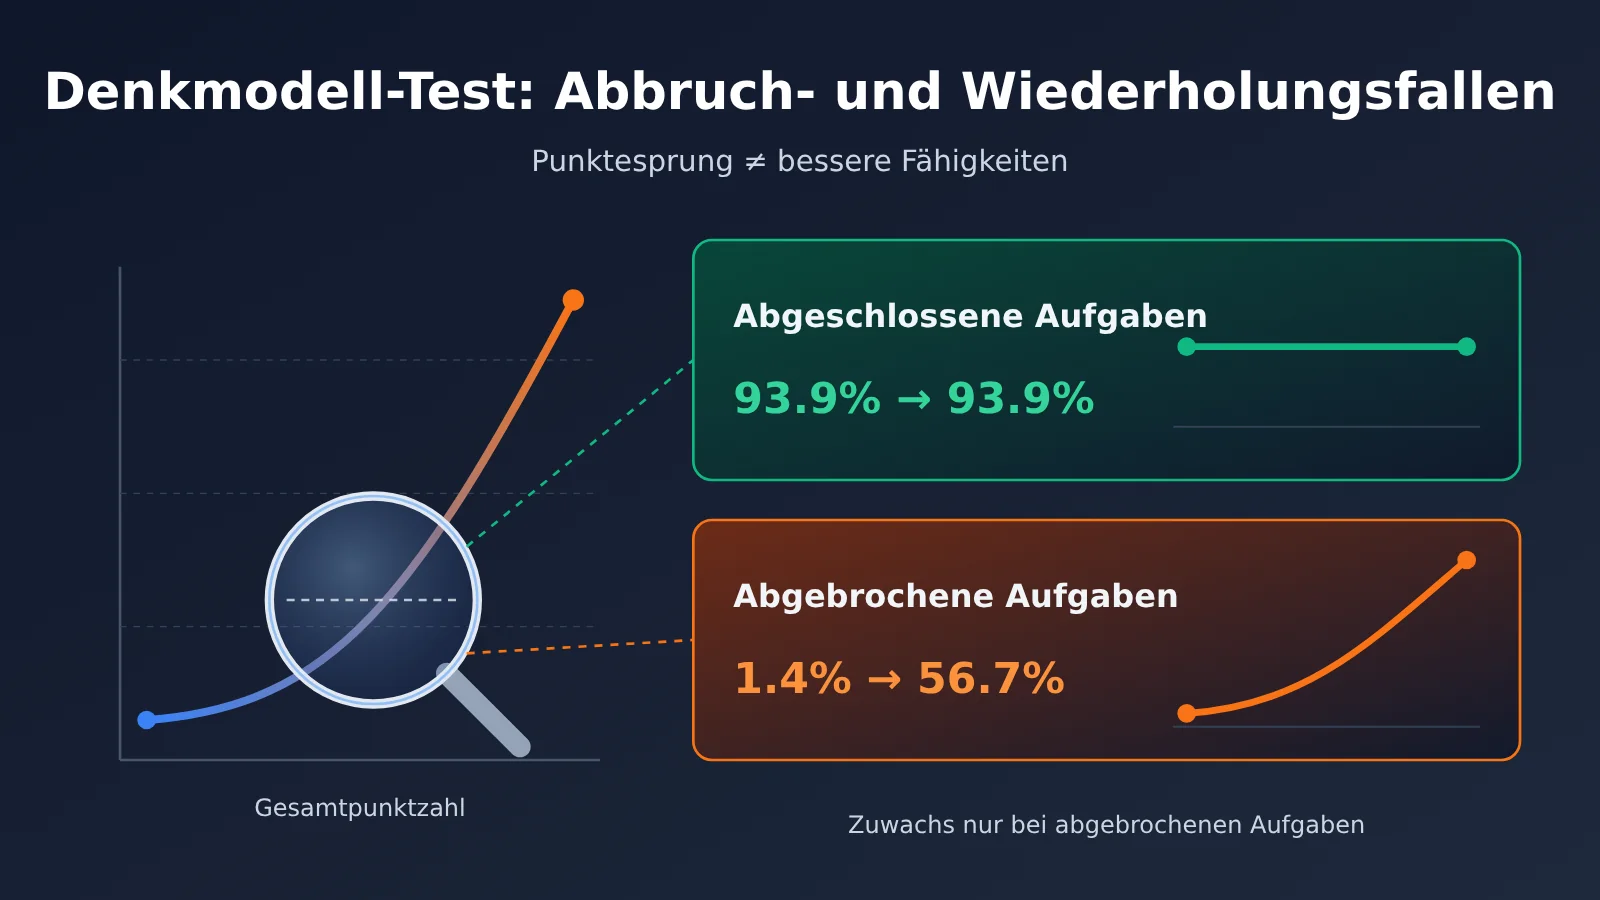
Am überzeugendsten ist ein Vorher-nachher-Vergleich anhand von 1.152 zurückgehaltenen Übungsaufgaben. Teilt man die Aufgaben danach auf, ob die Antwort ursprünglich abgeschnitten wurde, wird das Ergebnis deutlich.
| Aufgabengruppe | Anzahl | Trefferquote vorher | Trefferquote nachher | Veränderung |
|---|---|---|---|---|
| Ursprünglich vollständig beantwortet | 114 | 93,9 % | 93,9 % | Keine Veränderung |
| Ursprünglich abgeschnitten | 1.038 | 1,4 % | 56,7 % | Quelle des gesamten Zuwachses |
| Von falsch zu richtig | 579 | — | — | Davon wurden 576 ursprünglich abgeschnitten |
| Von richtig zu falsch | 5 | — | — | Im Bereich des Rauschens |
Ein leicht zu übersehendes Detail: Vor der Änderung gab es nur 7 Aufgaben, bei denen das Modell die Antwort zu Ende schrieb, aber falsch lag. Danach waren es 245. Erst nachdem die Wiederholungsschleifen aufhörten, wurden die tatsächlichen Rechenfehler des Modells sichtbar. Im offiziellen MATH-500-Benchmark sank die durchschnittliche Antwortlänge von 30.868 auf 22.037 Token. Auch dieser Rückgang konzentrierte sich auf Antworten, die zuvor an die Obergrenze gestoßen waren.
Überprüfung der Ergebnisse mit einem Vergleichsmodell
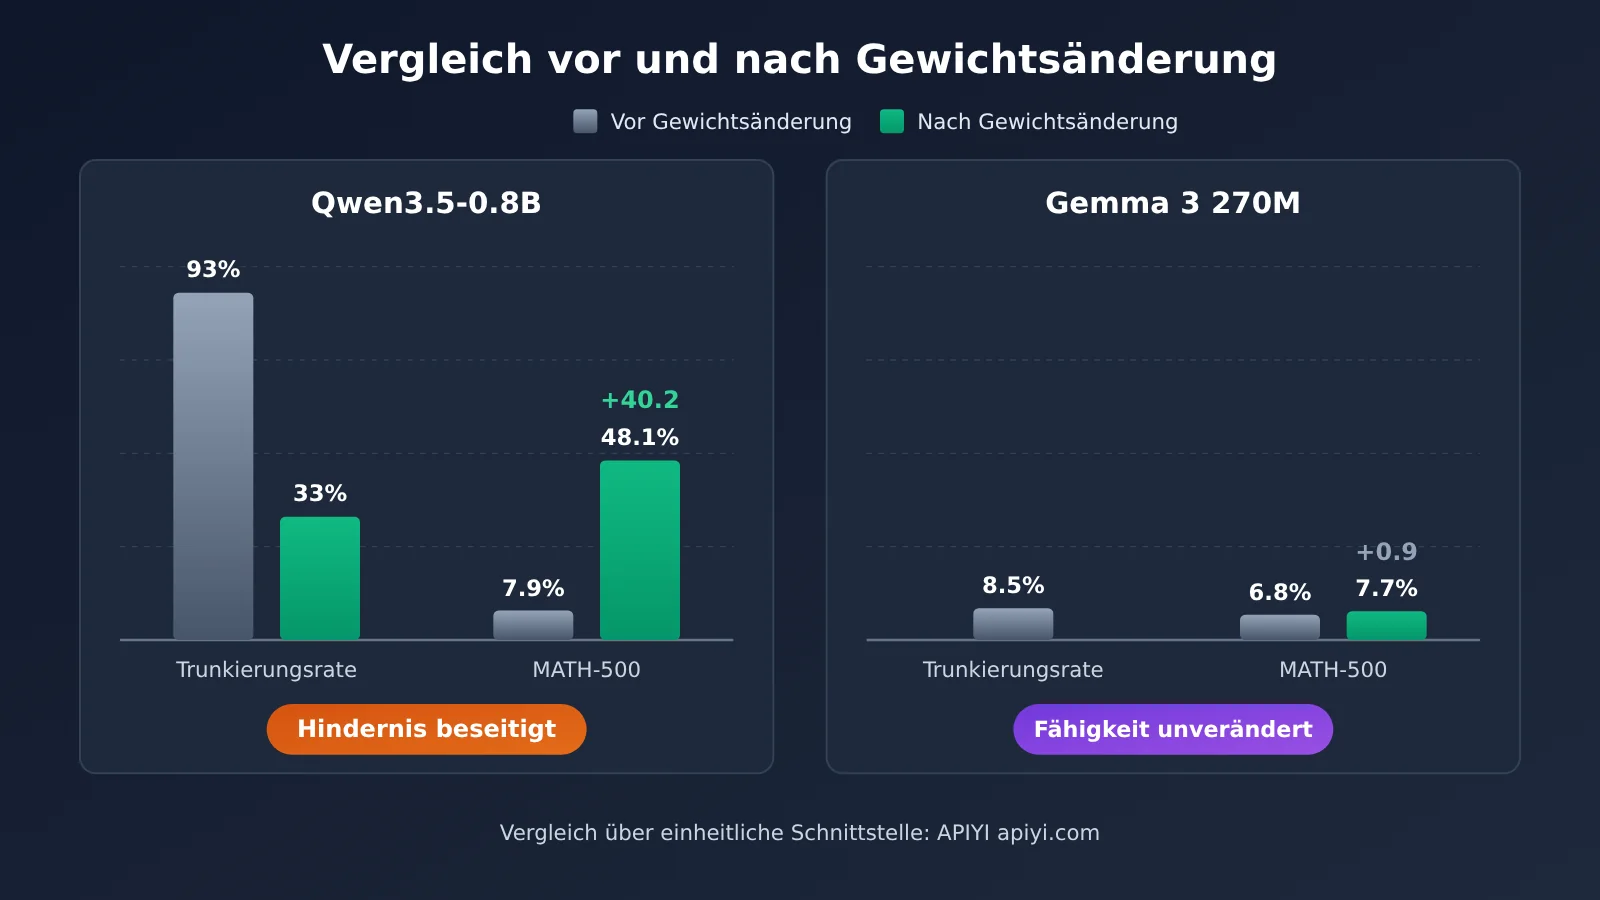
Auch den Forschenden war dieser Zusammenhang bewusst. Deshalb führten sie dasselbe Experiment mit Gemma 3 270M durch. Der Vergleich zeigt, dass es zwei verschiedene Dinge sind, ein Hindernis zu beseitigen und eine Fähigkeit hinzuzufügen.
| Vergleichspunkt | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| Anteil der Antworten, die an die Obergrenze stießen | Rund 93 % | Rund 8,5 % |
| Häufigste Fehlerarten | Wiederholungsschleifen, unvollständige Antworten | Rechenfehler, fehlerhafte Schlussfolgerungen |
| MATH-500 nach Änderung der Gewichte | 7,9 % → 48,1 % | 6,8 % → höchstens 7,7 % |
| Art der Verbesserung | Beseitigt ein Hindernis, das vorhandene Fähigkeiten blockiert | Kann kaum Fähigkeiten hinzufügen, die vorher nicht vorhanden waren |
Auch der ursprüngliche Blogbeitrag räumt ein: Das Ändern der Gewichte kann ein Hindernis beseitigen, das vorhandene Fähigkeiten blockiert. Es kann dem Modell aber keine Fähigkeiten hinzufügen, die es nicht besitzt. Für die Bewertung bedeutet das: Derselbe „starke Punkteanstieg“ kann je nach Art der Fehler etwas völlig anderes aussagen.
Die Parameterfalle bei der Bewertung von Reasoning-Modellen: Temperatur und Denkmodus
Ein Aspekt wird in der Debatte oft übersehen: Schon die Evaluierungseinstellungen können Schleifen begünstigen. Die Angaben aus der offiziellen Modellkarte von Qwen3.5-0.8B, die eine nachträgliche Analyse zitiert, weichen von den tatsächlichen Einstellungen der Forschenden ab.
| Parameter | Angabe in der Modellkarte | Einstellung im Experiment | Auswirkung |
|---|---|---|---|
| Denkmodus | Bei 0.8B standardmäßig ausgeschaltet | Erzwungen eingeschaltet | Das kleine Modell gerät leichter in Denkschleifen |
| Temperatur (Textaufgaben im Denkmodus) | 1.0 empfohlen | 0.6 | 0.6 ist in der Modellkarte für Bildverständnis und Programmieraufgaben vorgesehen |
| Empfehlung zum Umgang mit Schleifen | Sampling-Parameter anpassen und Streaming-Ausgabe rechtzeitig abbrechen | Ausgabe bis zur Grenze von 32.768 Token | Viele Antworten wurden als fehlgeschlagen gewertet |
Die Angaben aus der Modellkarte stammen aus einer Medienanalyse. Prüfen Sie vor einer Evaluierung am besten direkt das Original der offiziellen Qwen-Modellkarte. Entscheidend ist hier die Methode: Dasselbe Modell kann mit anderen Sampling-Parametern eine völlig andere „Baseline“ liefern. Wurde die Baseline unter Einstellungen ermittelt, die Schleifen begünstigen, kann jede Änderung, die das Modell zum rechtzeitigen Stoppen bringt, wie ein großer Fähigkeitssprung aussehen.
Checkliste für die Bewertung von Reasoning-Modellen: Erst Kürzungen analysieren, dann Schlussfolgerungen ziehen
Aus dieser Analyse lässt sich ein Bewertungsprozess ableiten, der für jedes Reasoning-Modell geeignet ist. Ob Sie ein Modell auswählen, Parameter anpassen oder eine Änderung am Fine-Tuning oder an der Eingabeaufforderung prüfen: Gehen Sie die folgende Checkliste Punkt für Punkt durch.
| Prüfschritt | Vorgehen | Indikator |
|---|---|---|
| 1. Nach Kürzung aufteilen | Anteil von finish_reason == "length" erfassen und die Trefferquote für jede Gruppe berechnen |
Liegt die Kürzungsrate über 10 %, sind die Gesamtergebnisse nicht direkt vergleichbar |
| 2. Wiederholungsrate prüfen | Am Ende gekürzter Antworten die n-Gramm-Wiederholungen zählen | Eine hohe Wiederholungsrate deutet auf eine Schleife hin, nicht auf eine zu lange Schlussfolgerung |
| 3. Sampling-Parameter prüfen | Temperatur, top_p und Reasoning-Einstellung mit der Modellkarte abgleichen | Abweichungen von den offiziellen Empfehlungen gesondert vermerken |
| 4. Paarweise vergleichen | Jede Aufgabe vor und nach der Änderung vergleichen; Wechsel von falsch zu richtig und umgekehrt zählen | Konzentriert sich der Zuwachs auf die Gruppe gekürzter Antworten, wurde vor allem ein Hindernis beseitigt |
| 5. Modelle vergleichen | Unter gleichen Eingabeaufforderungen und Parametern ein Vergleichsmodell mit niedriger Kürzungsrate hinzunehmen | Verbessert sich das Vergleichsmodell nicht, deutet das darauf hin, dass keine Fähigkeiten hinzugewonnen wurden |
🎯 Bewertungstipp: Beim Modellvergleich ist es besonders mühsam, für jedes Modell eigenen Aufrufcode zu schreiben. Über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com lassen sich mehrere gängige Modelle mit demselben Skript sowie denselben Eingabeaufforderungen und Parametern aufrufen. So können Sie die „Kürzungsrate“ einfach als feste Spalte in der Auswertung ausgeben.
Evaluierungsskript für Thinking-Modelle: ein Minimalbeispiel
Der folgende Code ermittelt, welcher Anteil der Antworten auf eine Reihe von Fragen durch das Längenlimit abgeschnitten wurde. Wenn finish_reason den Wert length hat, wurde das Limit max_tokens erreicht:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # Durch den tatsächlichen Modellnamen ersetzen
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
Vollständigen Code anzeigen (mit gruppierter Trefferquote und Wiederholungsrate am Textende)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """Ermittelt den Anteil wiederholter n-Gramme am Textende (für Chinesisch kann nach Zeichen aufgeteilt werden)."""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: Funktion zur Prüfung der Antwort auf Korrektheit"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
Beachten Sie, dass sich der Thinking-Modus je nach Modell unterschiedlich ein- und ausschalten lässt: Bei manchen wird er über ein Anfragefeld gesteuert, bei anderen über den Modellnamen oder die Vorlage für die Eingabeaufforderung. Auch ob die Thinking-Inhalte auf max_tokens angerechnet und separat zurückgegeben werden, hängt vom Modell ab. Prüfen Sie deshalb vor der Evaluierung jeweils die zugehörige Dokumentation.
🚀 Schnellstart: Wenn Sie diese Aufteilung zunächst testen möchten, können Sie sich bei APIYI auf apiyi.com registrieren und das kostenlose Testguthaben nutzen. Lassen Sie zwei oder drei Thinking-Modelle einige Dutzend Fragen beantworten, vergleichen Sie zunächst die Abbruchraten und entscheiden Sie dann, ob Sie die Evaluierung ausweiten möchten.
Analyse der Auswirkungen des Vorfalls bei der Bewertung von Reasoning-Modellen
Auswirkungen auf Entwickler
- Die Gesamtpunktzahl ist nicht mehr verlässlich: Wer nur auf die Gesamtgenauigkeit schaut, wirft unvollständige und falsche Antworten in einen Topf. Evaluierungsberichte sollten vor dem produktiven Einsatz mindestens zwei Spalten enthalten: die Abbruchrate und die Genauigkeit nach Gruppen.
- Der Nutzen von Parameteranpassungen kann falsch interpretiert werden: Ein höheres Ausgabelimit, eine angepasste Temperatur oder eine Wiederholungsstrafe können die Punktzahl deutlich steigern. Das beseitigt jedoch lediglich Hindernisse und bedeutet nicht, dass das Modell selbst verändert wurde.
- Auch die Produktionsumgebung ist betroffen: Was bei der Evaluierung als abgeschnittene Ausgabe auffällt, zeigt sich im Betrieb durch überlange Antworten, ausufernde Kosten und lange Wartezeiten. Die Model Card selbst empfiehlt Streaming-Ausgaben in Kombination mit Schleifenerkennung und frühzeitigem Abbruch.
Auswirkungen auf die Forschung zur Modellevaluierung
- Für „deutliche Verbesserungen“ braucht es differenzierte Nachweise: Die Aufarbeitung zeigt, dass ein vermeintlicher Fähigkeitssprung nach Aufschlüsselung der Abbrüche möglicherweise nur auf eine Fehlerbehebung zurückgeht. Bei künftigen Verbesserungsbehauptungen zu kleinen Modellen oder Reasoning-Modellen lohnt sich daher die Frage, wie sich die Abbruchrate verändert hat.
- Die Gestaltung von Kontrollgruppen gewinnt an Bedeutung: Sowohl das ergänzende Experiment mit Gemma 3 270M als auch Astras eigener Kontrollversuch mit zufälligen Richtungen, bei dem sich das Ergebnis nur um etwa 1,5 Prozentpunkte veränderte, zeigen: Gut gestaltete Kontrollen sind entscheidend, um echte Signale von Rauschen zu unterscheiden.
Häufig gestellte Fragen (FAQ)
Q1: Was ist die „Trunkierungsfalle“ bei der Bewertung von Reasoning-Modellen?
Dabei gerät das Modell während des Nachdenkens in eine Wiederholungsschleife und erreicht das Token-Limit, ohne eine Antwort zu liefern. Das Bewertungssystem wertet die Aufgabe dann als falsch. Die niedrige Punktzahl bedeutet in diesem Fall „nicht fertig geworden“ – nicht „konnte die Aufgabe nicht lösen“.
Q2: Wie unterscheidet man eine niedrige Punktzahl durch Trunkierung von einer durch mangelnde Fähigkeiten?
Teilen Sie die Aufgaben danach in zwei Gruppen ein, ob das Token-Limit erreicht wurde, und berechnen Sie für beide Gruppen die Erfolgsquote. Ist die Quote bei den abgeschlossenen Aufgaben hoch und liegt sie in der Trunkierungsgruppe nahe null, liegt das Problem an der Schleife. Enthalten dagegen schon die abgeschlossenen Aufgaben viele Fehler, deutet das auf mangelnde Fähigkeiten hin. Der Vergleich von Qwen und Gemma zeigt genau diese beiden Fälle.
Q3: Wann wurde das Experiment veröffentlicht, bei dem Astra Qwen verändert hat?
Der ursprüngliche Blogbeitrag erschien am 2. November 2026. Der Medienartikel, der das Experiment anhand der Logs des öffentlichen Repositorys nachzeichnet, wurde am 5. November veröffentlicht. Die Daten in diesem Artikel stammen aus dieser Nachbetrachtung. Details zur Modellkarte sollten Sie im offiziellen Qwen-Original überprüfen.
Q4: Für welche Szenarien eignet sich diese Bewertungsmethode?
– **Modellauswahl**: Die Leistung verschiedener Reasoning-Modelle bei Mathematik- oder Programmieraufgaben vergleichen
– **Parameteroptimierung**: Die tatsächlichen Auswirkungen von Änderungen an Temperatur, Limit und Reasoning-Schalter bewerten
– **Überprüfung von Verbesserungen**: Feststellen, ob Fine-Tuning, Eingabeaufforderungen oder die Bearbeitung von Gewichten die Fähigkeiten verbessern oder lediglich ein Hindernis beseitigen
Q5: Wie lassen sich mehrere Reasoning-Modelle über eine einheitliche Schnittstelle vergleichen?
1. Bei APIYI apiyi.com ein Konto registrieren und einen API-Schlüssel anfordern
2. Die base_url des Skripts in diesem Artikel auf `https://api.apiyi.com/v1` setzen
3. Eingabeaufforderung, Temperatur und max_tokens festlegen, nur den Modellnamen austauschen und die Trunkierungsrate sowie die Erfolgsquote je Gruppe ausgeben
Der Reasoning-Schalter wird bei den Modellen unterschiedlich gesetzt. Passen Sie die Anfrageparameter daher anhand der jeweiligen Dokumentation an.
Q6: Welche Grenzen hat diese Aufteilungsmethode?
Die Aufteilung nach Trunkierung erkennt nur, ob eine Antwort nicht fertiggestellt wurde. Sie zeigt nicht, ob eine abgeschlossene Antwort möglicherweise nur durch Glück richtig ist. Der Schwellenwert für die Wiederholungsrate am Textende muss an Sprache und Aufgabe angepasst werden; bei chinesischem Text empfiehlt sich eine Aufteilung nach Zeichen statt nach Leerzeichen. Außerdem geben manche Modelle ihren Denkprozess nicht vollständig zurück. Dann sollten Sie zusätzlich die Token-Statistik unter usage heranziehen. Bei begrenztem Budget können Sie zunächst mit einer kleinen Stichprobe bei APIYI apiyi.com testen und den Umfang erst erhöhen, wenn die Berechnungsgrundlage geklärt ist.
Die wichtigsten Erkenntnisse zur Bewertung von Reasoning-Modellen
- Quelle des Anstiegs: Bei den 114 Aufgaben, die Qwen vollständig beantwortete, lag die Trefferquote vorher wie nachher bei 93,9 %. Der gesamte Anstieg kam von den abgeschnittenen Antworten.
- Fehlertyp: Im Baseline-Test erreichten 93 % der Antworten das Limit; rund 95 % ihres letzten Abschnitts bestanden aus Wiederholungen.
- Abweichende Parameter: Die Testtemperatur von 0,6 entsprach nicht der in der Modellkarte empfohlenen Temperatur von 1,0 für Reasoning-Text.
- Kontrollvergleich: Gemma 3 270M hatte eine niedrige Abschneiderate. Nach der Gewichtsänderung verbesserte sich das Ergebnis auf MATH-500 um weniger als einen Prozentpunkt.
- Kern der Methode: Zuerst anhand von
finish_reasonnach abgeschnittenen und vollständigen Antworten aufteilen, dann die Trefferquoten vergleichen. - Praktischer Einstieg: Über die einheitliche Schnittstelle von APIYI apiyi.com mit denselben Parametern Abschneidestatistiken für mehrere Modelle erstellen.
Fazit
Die Kontroverse um Astras Änderung an den Qwen-Gewichten erinnert alle, die Reasoning-Modelle bewerten, an drei wichtige Punkte:
- Starke Ergebnisanstiege aufschlüsseln: Die Antworten danach gruppieren, ob sie das Token-Limit erreicht haben, und prüfen, aus welcher Gruppe der Anstieg stammt.
- Parameter gehören zur Baseline: Temperatur, Reasoning-Einstellung und Ausgabelimit müssen mit der Modellkarte abgeglichen und im Bericht festgehalten werden.
- Hindernisse beseitigen ist nicht dasselbe wie Fähigkeiten verbessern: Anhand eines Kontrollmodells mit niedriger Abschneiderate prüfen, worauf die Verbesserung tatsächlich zurückgeht.
Wenn also das nächste Mal jemand behauptet, eine Änderung habe das Ergebnis vervielfacht, lohnt sich zuerst die Frage: Wie stark hat sich die Abschneiderate verändert? Diese eine Frage sagt oft mehr aus als das Gesamtergebnis.
Wer gerade mehrere Reasoning-Modelle vor dem produktiven Einsatz bewertet, kann über APIYI apiyi.com mit denselben Skripten und Parametern zunächst deren Abschneideraten vergleichen und anschließend über die Modellauswahl entscheiden.
📚 Quellen
- Analyse von 硅星人 Pro (veröffentlicht bei 36氪): Das viel diskutierte „Astra baut Qwens Gehirn um“ hat wenig mit dem RSI zu tun, das wir uns wünschen
- Link:
36kr.com/p/4056494372181124 -
Hinweis: Enthält die anhand der Einträge zu jeder einzelnen Aufgabe im öffentlichen Repository neu berechneten Daten der gepaarten Tests. Sie bilden die wichtigste Datenquelle dieses Artikels.
-
Blog eines MIT-CSAIL-Forschers: Sparks of Weight-Space Programming
-
Hinweis: Originalbeschreibung des Experiments und Ergebnistabellen. Es empfiehlt sich, den Aufbau von Experiment 8 im Original nachzulesen.
-
Offizielle Modellkarte von Qwen3.5-0.8B: Sampling-Parameter und Denkmodus
- Hinweis: Zur Überprüfung des standardmäßigen Denkmodus, der empfohlenen Temperatur und der Hinweise zum Umgang mit Schleifen.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die offizielle APIYI-Website apiyi.com. Weitere Hinweise zu Modellaufrufen finden Sie im Dokumentationszentrum unter docs.apiyi.com.