Nota del autor: A partir de una revisión del experimento en el que Astra modificó los pesos de Qwen3.5-0.8B, explicamos la diferencia entre «responder mal» y «no terminar la respuesta» al evaluar modelos de razonamiento, y cómo desglosar los resultados según si hubo truncamiento.
El 2 de noviembre, cuatro investigadores del MIT CSAIL publicaron la entrada de blog «Chispas de programación en el espacio de pesos». Según el artículo, GPT-6 Astra modificó apenas el 0.016% de los parámetros de Qwen3.5-0.8B y su puntuación en MATH-500 subió del 7.9% al 48.1%. Los resultados en GSM8K e IFEval también mejoraron considerablemente. La noticia se compartió enseguida como un hito de «una IA que modifica el cerebro de otra IA».
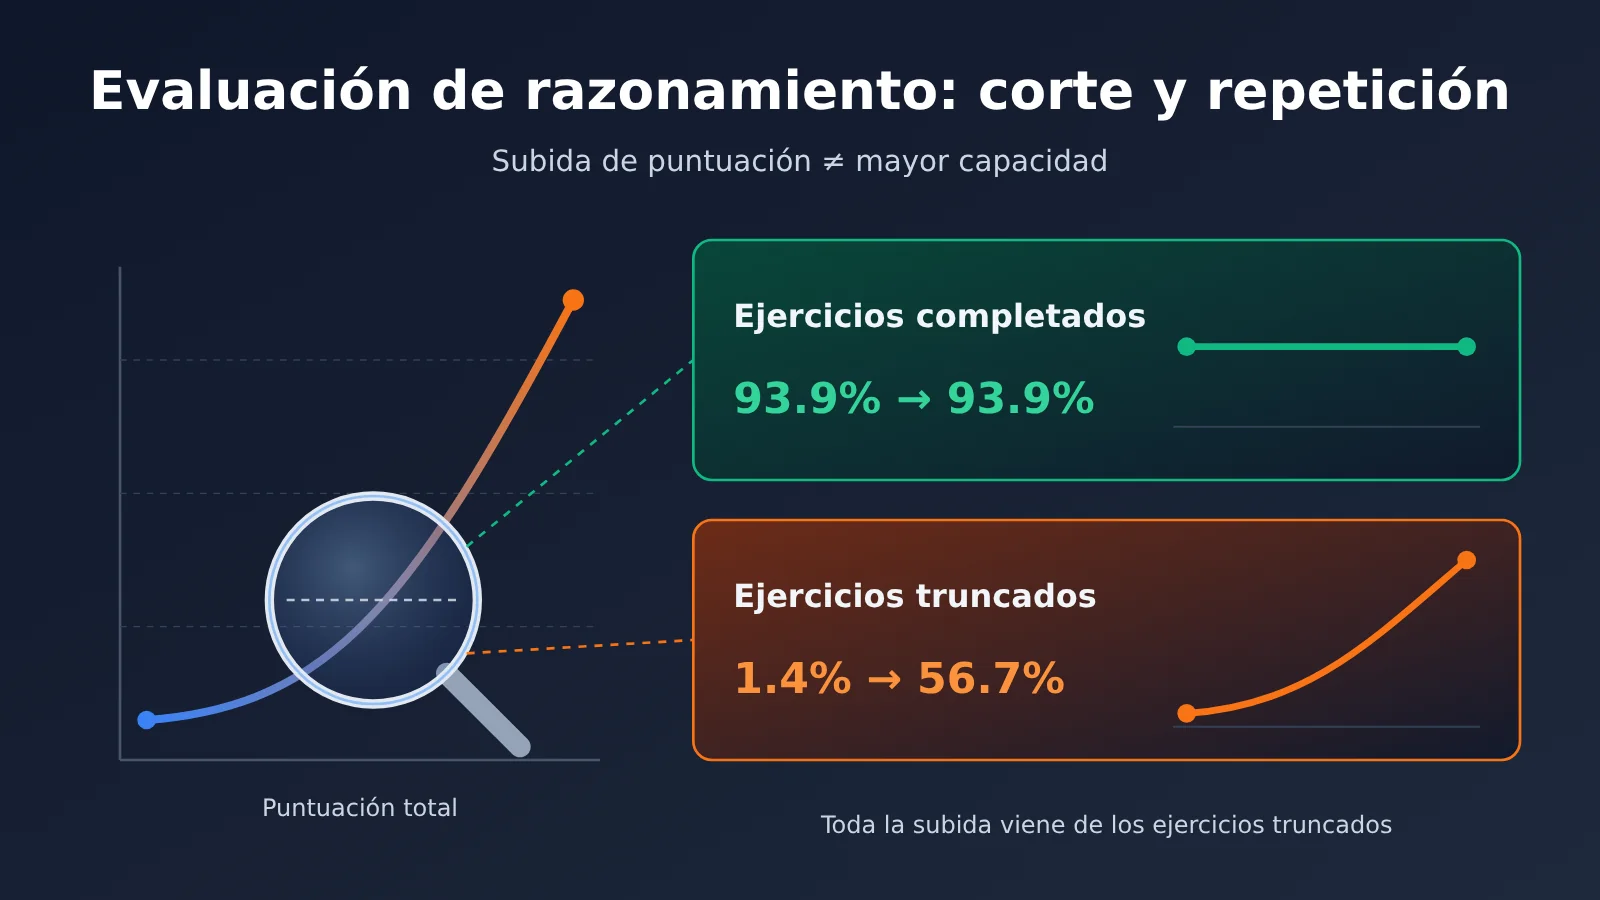
Esto no pretende restar valor a la investigación. El repositorio público del estudio contiene registros de 1,125 invocaciones, desglosados por ronda. Al volver a calcular los resultados a partir de los registros de cada problema, la revisión periodística llegó a una conclusión más sencilla: casi toda la mejora se debió a que «el modelo por fin pudo terminar de escribir las respuestas», no a que «el modelo mejorara en matemáticas».
Valor principal: este artículo no vuelve a debatir si la RSI es real. En cambio, convertimos esta revisión en un método reutilizable para evaluar modelos de razonamiento. Te ayudará a determinar, antes de elegir un modelo, ajustar sus parámetros o ponerlo en producción, si un cambio en la puntuación se debe a una diferencia de capacidad o a un truncamiento causado por bucles de repetición.
Resumen de la evaluación del modelo de razonamiento
Empecemos por los datos clave de la evaluación. Las cifras proceden del blog original y del análisis que hicieron los medios del repositorio público.
| Dato | Detalle |
|---|---|
| Fecha de publicación | 2 de noviembre de 2026, blog de investigadores de MIT CSAIL |
| Modelo modificado | Qwen3.5-0.8B; se modificaron 131,072 pesos, aproximadamente el 0.016% |
| Resultados anunciados | MATH-500: 7.9%→48.1%; GSM8K: 13.8%→67.1%; IFEval: 21.0%→62.3% |
| Configuración de la evaluación | Modo de razonamiento activado, límite de salida de 32,768 tokens y temperatura de 0.6 |
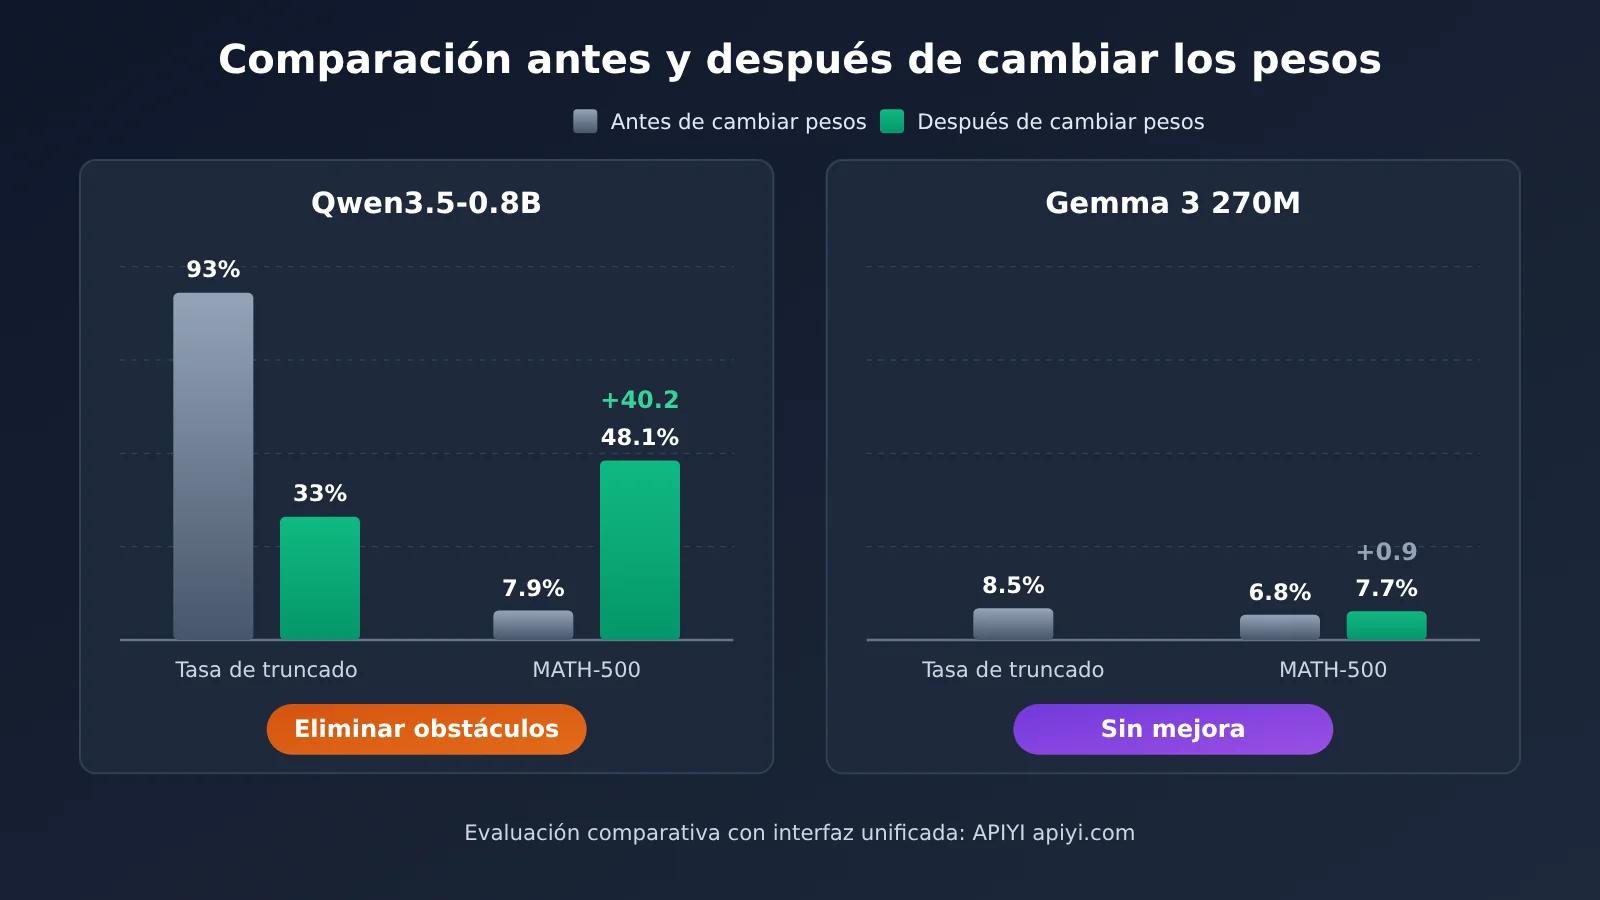
| Modelo base | Aproximadamente el 93% de las respuestas alcanzaban el límite sin detenerse |
| Modelo modificado | La proporción de respuestas que alcanzaban el límite bajó del 93% al 33% |
| Conclusión del análisis | El parche corrigió principalmente los bucles de repetición, pero no mejoró la capacidad matemática |
¿De dónde viene el «truncamiento» en la evaluación de modelos de razonamiento?
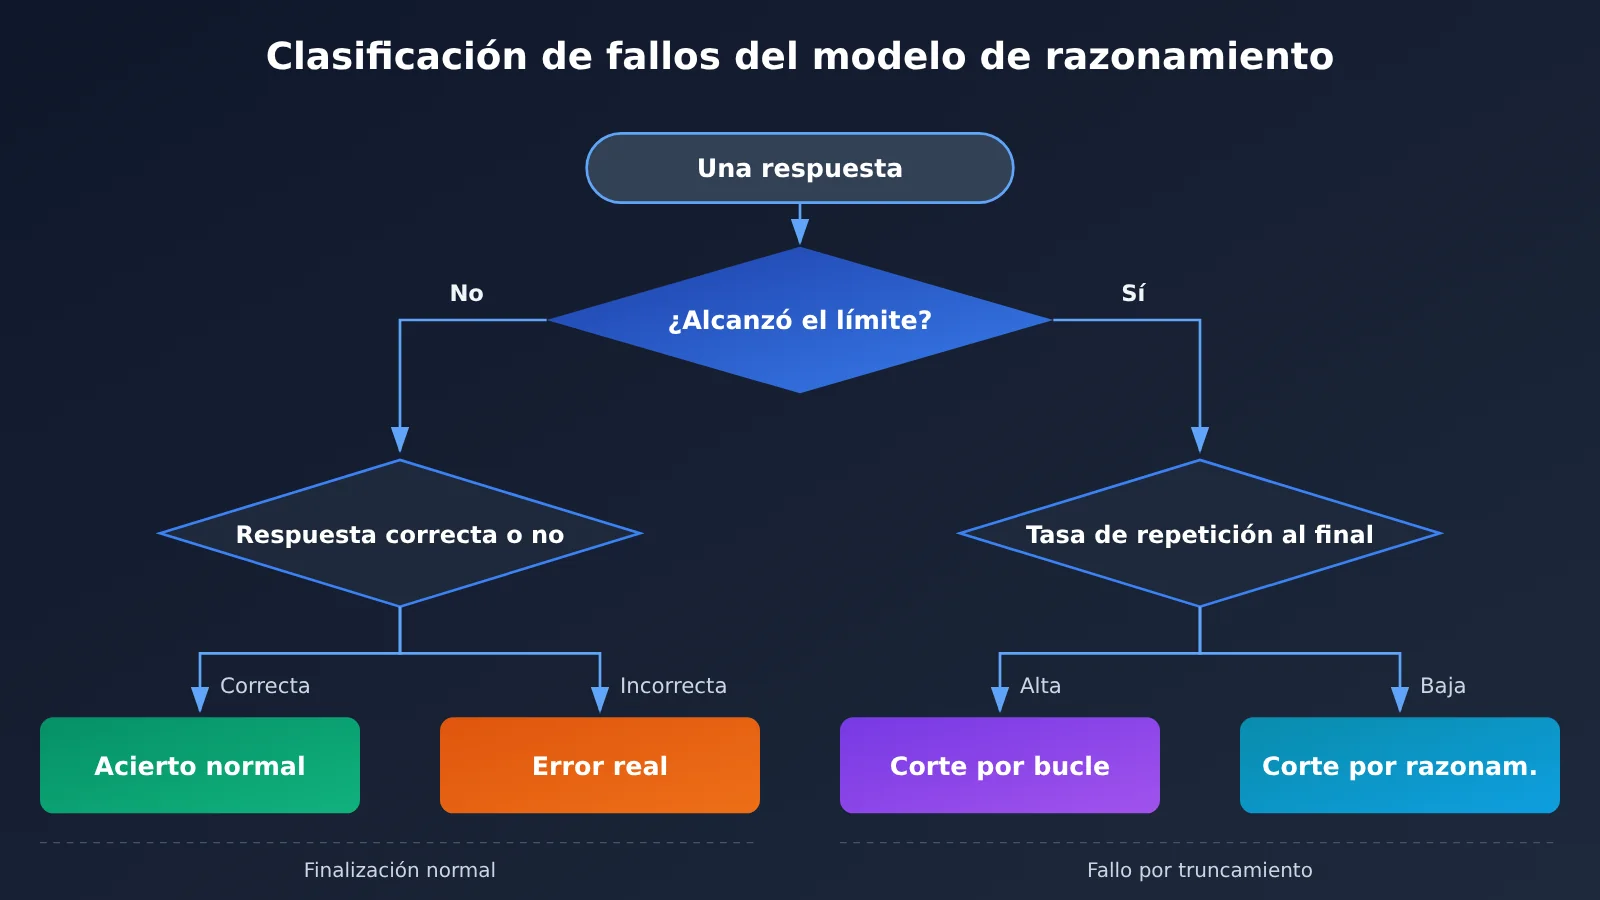
La primera vez que Astra puso a Qwen a resolver 96 ejercicios, solo acertó 11. Los 85 restantes no estaban mal calculados: en todos los casos, el modelo alcanzó el límite de longitud sin detenerse. Al analizar el final de los textos truncados en fragmentos de ocho palabras, aproximadamente el 95% era contenido repetido. Los 11 ejercicios que terminaron con normalidad estaban todos correctos.
Esto indica que la principal causa del bajo resultado del modelo base era que «no entregaba el examen», no que «no supiera resolverlo». Cabe destacar que, en la primera indicación que los investigadores dieron a Astra, ya se mencionaba como tipo de fallo que «al truncarse por el límite de tokens, el modelo suele repetirse durante el razonamiento». También se daba como ejemplo de mejora efectiva «corregir lo que provoca la repetición». El informe final de Astra dejó claro que su objetivo era la repetición, no el conocimiento matemático.
Desglose de la evaluación del modelo de razonamiento: toda la mejora se concentra en los problemas truncados
La evidencia más convincente del análisis es una prueba pareada, antes y después de la modificación, con 1,152 problemas de práctica reservados. Basta con dividirlos según si la respuesta original se truncó o no para que la conclusión quede clara.
| Grupo de problemas | Cantidad | Aciertos antes | Aciertos después | Cambio |
|---|---|---|---|---|
| Problemas que antes se completaban | 114 | 93.9% | 93.9% | Sin cambios |
| Problemas cuya respuesta antes se truncaba | 1,038 | 1.4% | 56.7% | Origen de toda la mejora |
| De incorrecto a correcto | 579 | — | — | 576 se habían truncado antes |
| De correcto a incorrecto | 5 | — | — | Dentro del margen de ruido |
Hay otro detalle fácil de pasar por alto: antes de la modificación, solo había 7 problemas que el modelo completaba pero respondía mal; después, fueron 245. Al detenerse los bucles, salieron a la luz los errores de cálculo reales del modelo. En la evaluación oficial de MATH-500, la longitud media de las respuestas bajó de 30,868 a 22,037 tokens. Esa reducción también se concentró en las respuestas que antes alcanzaban el límite.
Verificación de los resultados con un modelo de control
Los propios investigadores se dieron cuenta de esto y realizaron el mismo experimento con Gemma 3 270M. La comparación entre ambos experimentos muestra que «eliminar un obstáculo» y «añadir capacidad» son dos cosas distintas.
| Comparación | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| Proporción de respuestas que alcanzaban el límite | Aproximadamente 93% | Aproximadamente 8.5% |
| Tipo principal de fallo | Bucles repetitivos, respuestas incompletas | Errores aritméticos, pasos de razonamiento inválidos |
| MATH-500 tras modificar los pesos | 7.9%→48.1% | 6.8%→como máximo 7.7% |
| Naturaleza de la mejora | Elimina el obstáculo que impedía aprovechar la capacidad | Apenas puede añadir una capacidad que no existía |
El artículo original también lo reconoce: modificar los pesos puede eliminar obstáculos que impiden aprovechar una capacidad, pero no añadir una que el modelo no tiene. Para quienes evalúan modelos, esto significa que una misma «gran mejora de puntuación» puede tener significados completamente distintos según la estructura de los fallos.
La trampa de los parámetros al evaluar modelos de razonamiento: temperatura y activación del razonamiento
Hay un detalle de esta polémica que suele pasarse por alto: la propia configuración de la evaluación puede favorecer la aparición de bucles. La información de la ficha oficial del modelo Qwen3.5-0.8B citada en el análisis difiere de la configuración que usaron los investigadores.
| Parámetro | Indicaciones de la ficha del modelo | Configuración de la evaluación | Efecto |
|---|---|---|---|
| Modo de razonamiento | Desactivado por defecto en 0.8B | Activado de forma forzada | El modelo pequeño es más propenso a entrar en bucles de razonamiento |
| Temperatura (tareas de texto en modo de razonamiento) | Se recomienda 1.0 | 0.6 | En la ficha del modelo, 0.6 corresponde a tareas de interpretación de imágenes y escritura de código |
| Recomendaciones para gestionar bucles | Ajustar los parámetros de muestreo e interrumpir a tiempo la salida en streaming | Generación hasta el límite de 32,768 tokens | Muchas respuestas se consideraron fallidas |
Cabe aclarar que la información anterior de la ficha del modelo procede de un análisis publicado en medios. Antes de realizar una evaluación, conviene consultar directamente el texto original de la ficha oficial de Qwen. Lo importante aquí es el método: con el mismo modelo, basta cambiar los parámetros de muestreo para obtener una «línea base» completamente distinta. Si esa línea base se midió con una configuración propensa a generar bucles, cualquier cambio que consiga que el modelo «se detenga» parecerá un salto enorme en sus capacidades.
Lista de comprobación para evaluar modelos de razonamiento: separa los casos truncados antes de sacar conclusiones
Las lecciones de este análisis se pueden convertir en un proceso de evaluación aplicable a cualquier modelo de razonamiento. Ya sea que estés seleccionando un modelo, ajustando parámetros o validando un cambio de ajuste fino o de indicación, puedes revisar cada punto de la siguiente tabla.
| Punto de control | Cómo hacerlo | Señal para interpretar el resultado |
|---|---|---|
| 1. Separar por truncamiento | Calcula la proporción de respuestas con finish_reason == "length" y la tasa de aciertos de cada grupo |
Si la tasa de truncamiento supera el 10 %, no se pueden comparar directamente las puntuaciones globales |
| 2. Revisar la tasa de repetición | Calcula la repetición de n-gramas al final de las respuestas truncadas | Una repetición elevada al final indica un bucle, no un razonamiento demasiado largo |
| 3. Verificar los parámetros de muestreo | Compara la temperatura, top_p y la activación del razonamiento con la ficha del modelo | Si no coinciden con las recomendaciones oficiales, indícalo por separado |
| 4. Comparar por pares | Compara cada pregunta antes y después del cambio y cuenta los casos que pasan de incorrectos a correctos y viceversa | Si la mejora se concentra en el grupo truncado, se trata de «eliminar un obstáculo» |
| 5. Comparar con un modelo de referencia | Con la misma indicación y los mismos parámetros, añade un modelo de referencia con baja tasa de truncamiento | Si el modelo de referencia no mejora, el cambio no supone un aumento de capacidad |
🎯 Consejo para la evaluación: al comparar modelos, lo más engorroso es escribir código de invocación distinto para cada proveedor. Con la interfaz compatible con OpenAI de APIYI, apiyi.com, puedes invocar los principales modelos de distintos proveedores con el mismo script, las mismas indicaciones y los mismos parámetros. Así podrás incluir fácilmente la «tasa de truncamiento» como columna fija en los resultados.
Script de evaluación de modelos de razonamiento: ejemplo mínimo
El siguiente código calcula la proporción de preguntas cuyas respuestas se truncaron por alcanzar el límite de longitud. Un finish_reason igual a length indica que se alcanzó max_tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API de APIYI compatible con OpenAI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # Sustituir por el nombre del modelo real
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
Ver la implementación completa (incluye la tasa de aciertos por grupo y la tasa de repetición al final)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """Calcula la proporción de n-gramas repetidos al final del texto (para chino se puede dividir por caracteres)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: función que determina si la respuesta es correcta"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
Ten en cuenta que los parámetros para activar o desactivar el modo de razonamiento varían según el modelo: algunos se controlan mediante campos de la solicitud, otros se distinguen por el nombre del modelo y otros se configuran en la plantilla de indicaciones. También depende del modelo si el contenido del razonamiento cuenta para max_tokens y si se devuelve por separado. Antes de evaluar, consulta la documentación correspondiente a cada modelo.
🚀 Para empezar rápido: si solo quieres probar este método de clasificación, puedes registrarte en APIYI apiyi.com y usar el crédito de prueba gratuito. Elige dos o tres modelos de razonamiento, evalúalos con unas decenas de preguntas y compara sus tasas de truncamiento antes de decidir si amplías la evaluación.
Análisis del impacto del incidente de evaluación de modelos de razonamiento
Impacto para los desarrolladores
- La puntuación global ya no basta: si solo se mira el porcentaje total de respuestas correctas, se confunden las respuestas incompletas con las incorrectas. Antes de poner un modelo en producción, el informe de evaluación debería incluir al menos dos columnas: tasa de truncamiento y porcentaje de respuestas correctas por grupo.
- Los beneficios de ajustar parámetros pueden malinterpretarse: aumentar el límite de salida, ajustar la temperatura o añadir una penalización por repetición puede mejorar mucho la puntuación. Pero eso equivale a «quitar obstáculos»; no significa que el modelo haya cambiado.
- El entorno de producción también se ve afectado: los truncamientos observados en la evaluación se traducen en producción en respuestas excesivamente largas, costos fuera de control y esperas para los usuarios. La propia ficha del modelo recomienda combinar la salida en streaming con la detección de bucles y el truncamiento anticipado.
Impacto en la investigación sobre evaluación de modelos
- Las «grandes mejoras» necesitan pruebas desglosadas: este análisis muestra que un resultado que parece un salto de capacidad puede ser, al desglosarlo por truncamiento, simplemente la corrección de un error. En adelante, ante cualquier afirmación de mejora en modelos pequeños o modelos de razonamiento, conviene preguntar cómo cambió la tasa de truncamiento.
- El diseño de los grupos de control cobra más importancia: tanto el experimento adicional con Gemma 3 270M como el control con direcciones aleatorias realizado por Astra —en el que la puntuación solo varió alrededor de 1,5 puntos porcentuales— muestran que el diseño de los controles es clave para distinguir una señal real del ruido.
Preguntas frecuentes FAQ
Q1: ¿Qué es la «trampa de truncamiento» al evaluar modelos de razonamiento?
Ocurre cuando el modelo entra en un bucle repetitivo durante el razonamiento y sigue escribiendo hasta alcanzar el límite de tokens sin dar una respuesta. El sistema de evaluación lo considera un error. En ese caso, la puntuación baja refleja que «no terminó», no que «no supiera resolverlo».
Q2: ¿Cómo se distingue una puntuación baja por truncamiento de una causada por falta de capacidad?
Divide los problemas en dos grupos según hayan alcanzado o no el límite y calcula la tasa de aciertos de cada uno. Si la tasa es alta en los problemas completados y cercana a cero en los truncados, el problema está en el bucle. Si hay muchos errores incluso entre los completados, eso sí apunta a una falta de capacidad. La comparación entre Qwen y Gemma ilustra estos dos casos.
Q3: ¿Cuándo se publicó este experimento de Astra para modificar Qwen?
La publicación original del blog apareció el 2 de noviembre de 2026, y el artículo de análisis basado en los registros del repositorio público se publicó el 5 de noviembre. Los datos de este artículo se basan en ese análisis; para los detalles de la tarjeta del modelo, conviene consultar la publicación oficial de Qwen.
Q4: ¿Para qué situaciones sirve este método de evaluación?
– **Selección de modelos**: comparar el rendimiento de distintos modelos de razonamiento en tareas de matemáticas o programación
– **Ajuste de parámetros**: evaluar el efecto real de cambiar la temperatura, el límite o la activación del razonamiento
– **Validación de mejoras**: determinar si el ajuste fino, las indicaciones o la edición de pesos mejoran la capacidad o eliminan un obstáculo
Q5: ¿Cómo se comparan varios modelos de razonamiento mediante una interfaz unificada?
1. Registra una cuenta en APIYI apiyi.com y obtén una clave API
2. Configura el base_url del script de este artículo como `https://api.apiyi.com/v1`
3. Mantén fijos la indicación, la temperatura y max_tokens; cambia solo el nombre del modelo y muestra la tasa de truncamiento y la tasa de aciertos de cada grupo
La forma de activar el razonamiento varía según el modelo, por lo que tendrás que ajustar los parámetros de la solicitud siguiendo su documentación.
Q6: ¿Qué limitaciones tiene este método de división?
La separación por truncamiento solo permite identificar las respuestas que «no se terminaron»; no puede determinar si una respuesta completada se acertó por suerte. El umbral de repetición al final del texto debe ajustarse según el idioma y la tarea; para el chino, se recomienda dividir el texto por caracteres en lugar de por espacios. Además, algunos modelos no devuelven todo el contenido de razonamiento, por lo que hay que consultar también las estadísticas de tokens en usage. Si tienes un presupuesto limitado, puedes empezar con una prueba de muestra pequeña en APIYI apiyi.com y ampliar la escala después de confirmar los criterios de medición.
Puntos clave de la evaluación de modelos de razonamiento
- Origen de la mejora: Qwen obtuvo un 93,9 % tanto antes como después en las 114 preguntas que completó; toda la mejora provino de las respuestas truncadas.
- Tipo de fallo: en la prueba de referencia, el 93 % de las respuestas alcanzó el límite y aproximadamente el 95 % del contenido final era repetitivo.
- Diferencia en los parámetros: la temperatura de evaluación fue de 0,6, distinta del 1,0 recomendado en la ficha del modelo para el texto de razonamiento.
- Evidencia de contraste: Gemma 3 270M presentó una baja tasa de truncamiento y, tras modificar sus pesos, su puntuación en MATH-500 mejoró menos de un punto porcentual.
- Método clave: separar primero las respuestas truncadas según
finish_reasony después comparar las tasas de acierto. - Cómo empezar: usar la interfaz unificada de APIYI apiyi.com para calcular las tasas de truncamiento de varios modelos con los mismos parámetros.
Resumen
La polémica por la «modificación de los pesos de Qwen por parte de Astra» deja una advertencia para quienes evalúan modelos de razonamiento:
- Desglosa primero los grandes saltos de puntuación: agrupa las respuestas según hayan alcanzado o no el límite de tokens y comprueba de dónde viene la mejora.
- Los parámetros forman parte de la referencia: contrasta la temperatura, la activación del razonamiento y el límite de salida con la ficha del modelo, e inclúyelos en el informe.
- Distingue entre eliminar obstáculos y aumentar la capacidad: usa un modelo de contraste con una tasa de truncamiento baja para comprobar la verdadera naturaleza de la mejora.
La próxima vez que veas una conclusión como «cierto cambio multiplicó el resultado», pregunta primero: ¿cuánto cambió la tasa de truncamiento? Esa pregunta suele revelar más que la puntuación total.
Si estás preparando la evaluación de varios modelos de razonamiento antes de llevarlos a producción, puedes usar APIYI apiyi.com para calcular sus tasas de truncamiento con los mismos scripts y parámetros antes de decidir cuál elegir.
📚 Referencias
- Análisis retrospectivo de Silicon Pro (publicado por 36Kr): La viral «transformación del cerebro de Qwen por Astra» tiene poco que ver con el RSI que buscamos
- Enlace:
36kr.com/p/4056494372181124 -
Descripción: Datos de pruebas pareadas recalculados a partir de los registros de cada pregunta del repositorio público; fuente principal de datos de este artículo.
-
Blog de investigadores del MIT CSAIL: Sparks of Weight-Space Programming
-
Descripción: Descripción original del experimento y tablas de resultados. Se recomienda consultar la configuración del experimento 8 en el texto original.
-
Ficha oficial del modelo Qwen3.5-0.8B: Parámetros de muestreo y explicación del modo de razonamiento
- Descripción: Para verificar el estado predeterminado del modo de razonamiento, la temperatura recomendada y las sugerencias para gestionar los bucles.
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos a través del sitio oficial de APIYI, apiyi.com. Para más información sobre las invocaciones, visita el centro de documentación en docs.apiyi.com.