작성자 주: Astra가 Qwen3.5-0.8B의 가중치를 수정한 실험을 다시 살펴보며, 추론 모델 평가에서 ‘답을 틀린 것’과 ‘답을 끝까지 쓰지 못한 것’의 차이, 그리고 잘림 여부에 따라 결과를 나누어 분석하는 방법을 설명해요.
11월 2일, MIT CSAIL의 연구자 네 명이 블로그 글 《가중치 공간 프로그래밍의 불꽃》을 공개했어요. 글에 따르면 GPT-6 Astra는 Qwen3.5-0.8B의 파라미터 중 약 0.016%만 수정했는데, MATH-500 점수가 7.9%에서 48.1%로 올랐어요. GSM8K와 IFEval 점수도 크게 상승하면서, 이 연구는 ‘AI가 AI의 두뇌를 바꾼’ 상징적인 사례로 널리 공유됐어요.
이 연구를 부정하려는 것은 아니에요. 연구의 공개 저장소에는 1,125회 호출에 대한 회차별 로그가 있어요. 언론이 문항별 기록을 다시 집계해 살펴본 결과, 더 단순한 결론이 나왔어요. 점수 상승의 거의 전부는 ‘모델의 수학 실력이 좋아진 것’이 아니라 ‘마침내 답을 끝까지 쓸 수 있게 된 것’에서 비롯됐다는 거예요.
핵심 가치: 이 글에서는 RSI의 성립 여부를 다시 논하지 않아요. 대신 이번 분석을 재사용할 수 있는 추론 모델 평가 방법으로 정리했어요. 모델 선정, 파라미터 조정 또는 서비스 출시 전에 점수 변화가 능력 차이 때문인지, 반복 루프로 인한 출력 잘림 때문인지 판단하는 데 도움이 될 거예요.
사고 모델 평가 사건 핵심 정보 한눈에 보기
먼저 평가와 관련된 핵심 사실을 정리해 볼게요. 아래 수치는 원본 블로그와 공개 저장소에 대한 언론의 재분석을 바탕으로 했어요.
| 정보 | 내용 |
|---|---|
| 공개일 | 2026년 11월 2일, MIT CSAIL 연구자 블로그 |
| 수정된 모델 | Qwen3.5-0.8B, 가중치 131,072개 수정, 전체의 약 0.016% |
| 발표된 성적 | MATH-500 7.9%→48.1%; GSM8K 13.8%→67.1%; IFEval 21.0%→62.3% |
| 평가 설정 | 사고 모드 활성화, 출력 상한 32,768 token, 온도 0.6 |
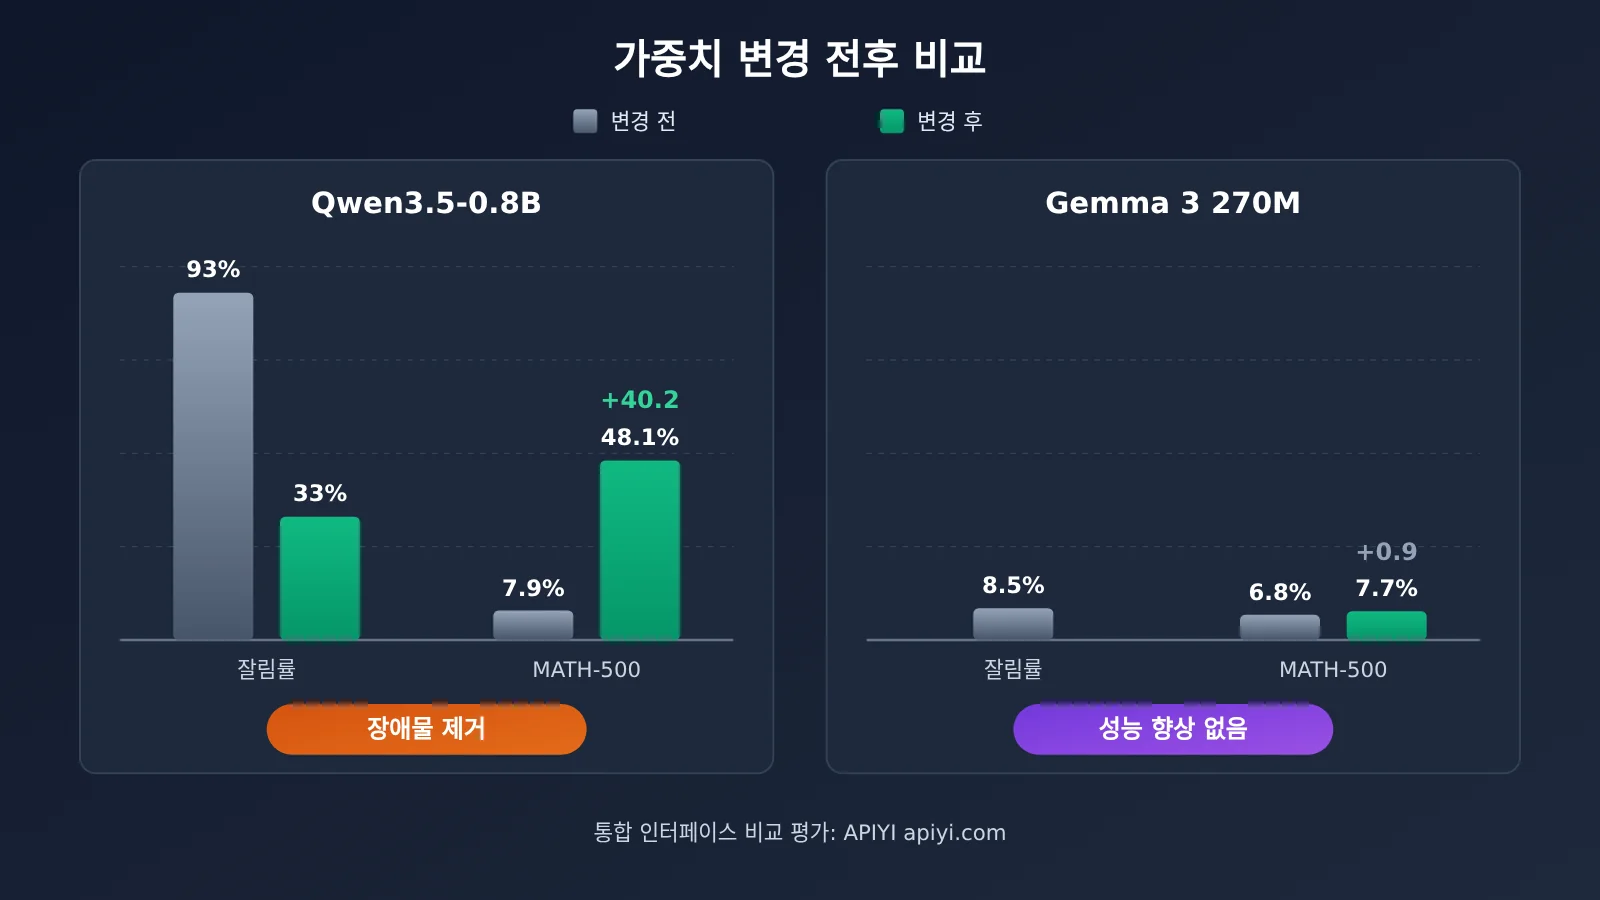
| 기준 모델 상태 | 응답의 약 93%가 상한에 도달할 때까지 멈추지 않음 |
| 수정 후 상태 | 상한에 도달한 비율이 93%에서 33%로 감소 |
| 재분석 결론 | 패치는 주로 반복 루프를 수정했으며, 수학 능력을 높이지는 않음 |
사고 모델 평가에서 ‘잘림’은 왜 발생할까요?
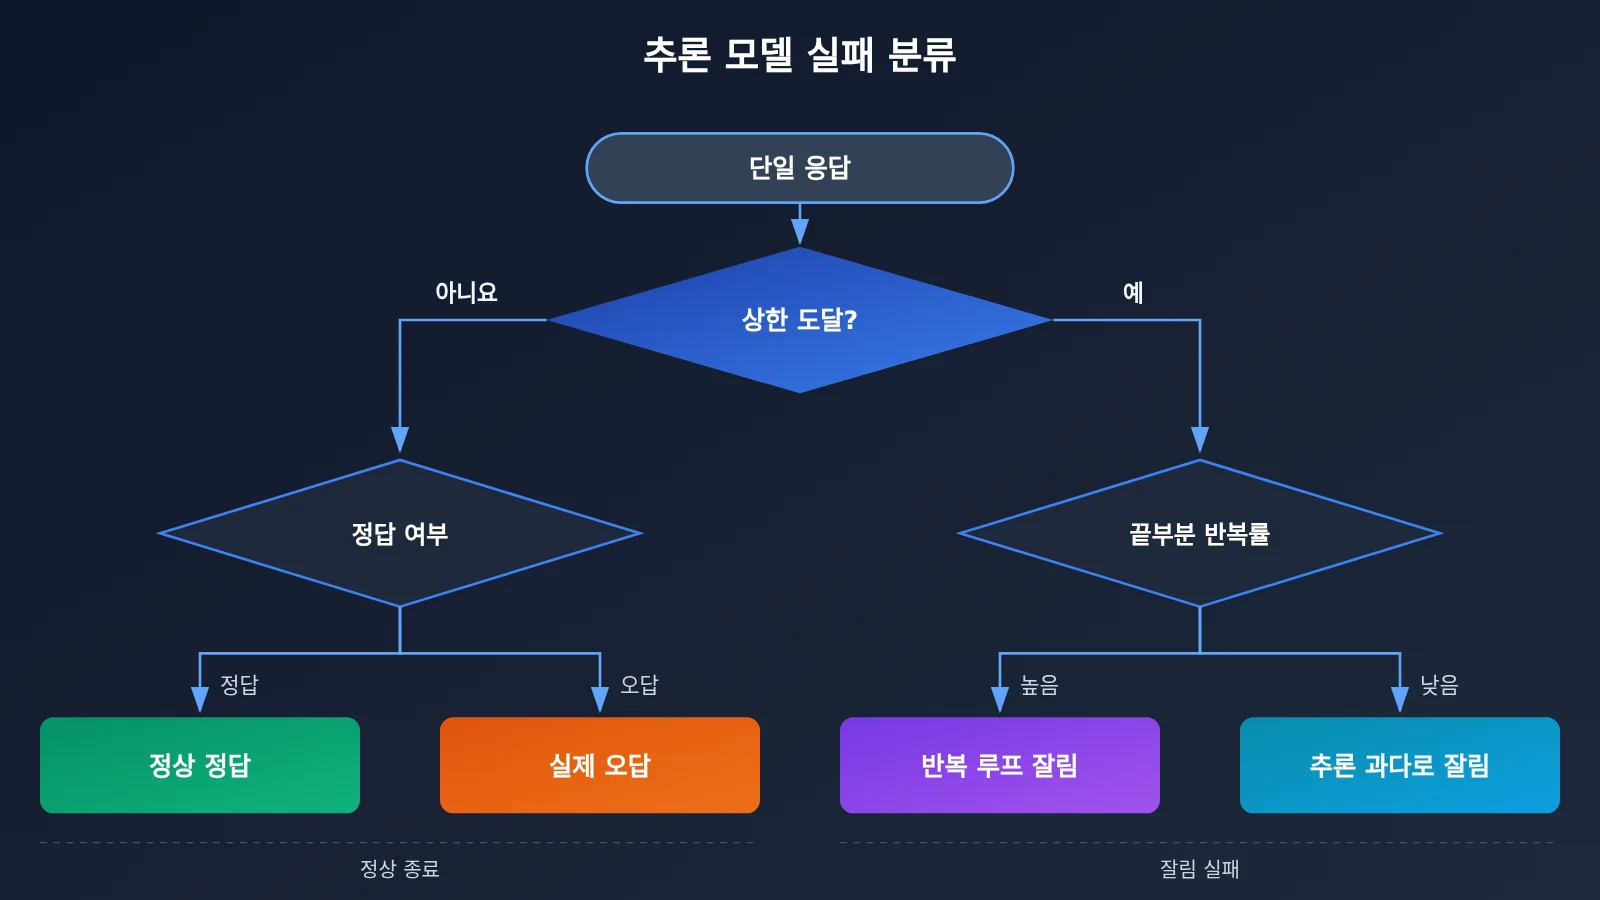
Astra가 처음 Qwen에 연습 문제 96개를 풀게 했을 때, 정답은 11개뿐이었어요. 나머지 85개는 계산을 틀린 게 아니라 모두 출력 길이 상한에 도달할 때까지 멈추지 않았어요. 잘린 텍스트의 끝부분을 8단어 단위로 분석한 결과, 약 95%가 반복된 내용이었어요. 정상적으로 끝난 11개 문제는 모두 정답이었고요.
즉, 기준 모델의 점수가 낮았던 주된 이유는 ‘문제를 못 풀어서’가 아니라 ‘답안지를 제출하지 못해서’였어요. 연구자들이 Astra에 처음 제시한 프롬프트에는 “token 상한으로 잘리는 경우, 사고 과정에서 같은 내용을 반복하는 일이 많다”는 내용이 실패 유형 중 하나로 들어 있었어요. 또 “반복을 유발하는 원인을 고치는 것”을 효과적인 개선의 예로 들었죠. Astra의 최종 보고서에도 수학 지식이 아닌 반복을 해결하는 데 초점을 맞췄다고 명시되어 있어요.
추론 모델 평가 데이터 분석: 점수 상승은 모두 응답이 잘린 문제에서 발생
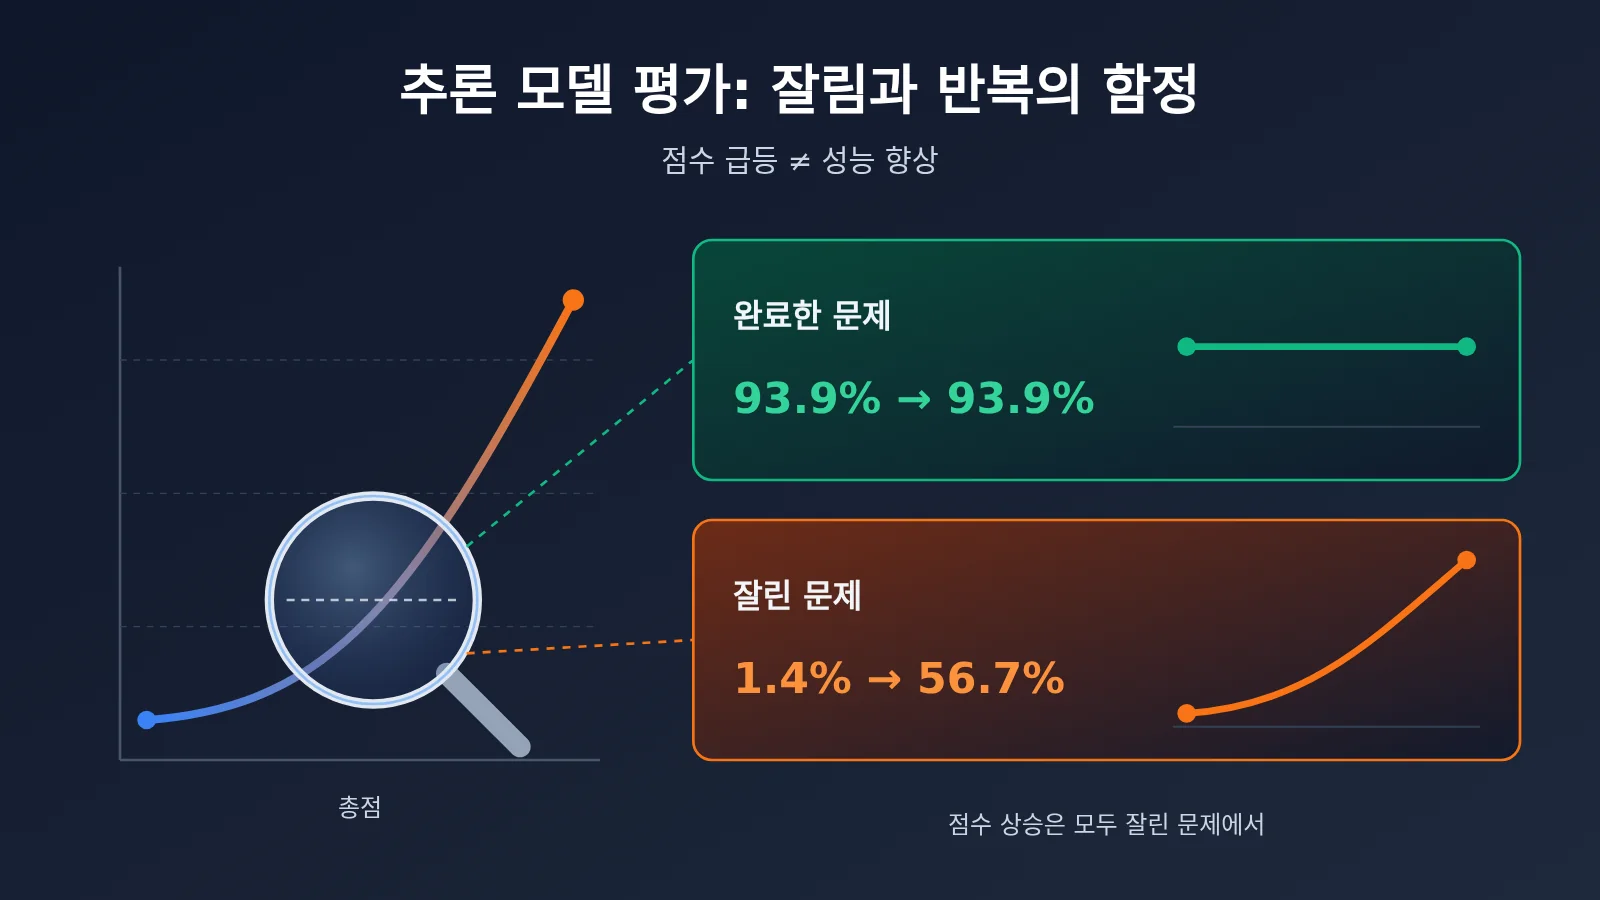
이번 분석에서 가장 설득력 있는 근거는 별도로 남겨둔 연습 문제 1,152개를 수정 전후로 비교한 테스트예요. 문제를 ‘원래 응답이 잘렸는지’에 따라 두 그룹으로 나누면 결과가 명확해져요.
| 문제 그룹 | 문제 수 | 수정 전 정답률 | 수정 후 정답률 | 변화 |
|---|---|---|---|---|
| 원래 답변을 끝까지 작성한 문제 | 114 | 93.9% | 93.9% | 변화 없음 |
| 원래 응답이 잘린 문제 | 1,038 | 1.4% | 56.7% | 점수 상승이 모두 이 그룹에서 발생 |
| 오답에서 정답으로 바뀐 문제 | 579 | — | — | 그중 576개는 원래 응답이 잘림 |
| 정답에서 오답으로 바뀐 문제 | 5 | — | — | 노이즈 수준 |
놓치기 쉬운 세부 사항도 있어요. 수정 전에는 ‘답변을 끝까지 작성했지만 틀린’ 문제가 7개뿐이었는데, 수정 후에는 245개로 늘었어요. 반복이 멈추자 모델의 실제 계산 오류가 드러난 거예요. 정식 MATH-500 평가에서는 평균 답변 길이가 30,868토큰에서 22,037토큰으로 줄었고, 감소분 역시 원래 길이 제한에 도달했던 답변에 집중됐어요.
대조 모델로 추론 모델 평가 결론 검증하기
연구자들도 이 점을 인식하고 Gemma 3 270M에서 같은 실험을 진행했어요. 두 실험을 비교하면 ‘장애물을 치우는 것’과 ‘능력을 높이는 것’이 다르다는 점이 잘 드러나요.
| 비교 항목 | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| 길이 제한에 도달한 비율 | 약 93% | 약 8.5% |
| 주요 실패 유형 | 반복 루프에 빠져 답변을 끝내지 못함 | 산술 오류, 성립하지 않는 추론 단계 |
| 가중치 수정 후 MATH-500 | 7.9%→48.1% | 6.8%→최대 7.7% |
| 개선의 성격 | 능력 발휘를 막는 장애물을 제거 | 원래 없던 능력을 늘리기는 거의 불가능 |
원문 블로그도 인정하듯, 가중치 수정으로 능력 발휘를 막는 장애물은 치울 수 있지만 모델에 없는 능력을 추가할 수는 없어요. 평가자에게 이 말이 중요한 이유는 같은 ‘점수 급상승’이라도 실패 원인에 따라 의미가 완전히 달라지기 때문이에요.
추론 모델 평가의 파라미터 함정: 온도와 추론 모드 스위치
이번 논란에서 자주 간과되는 전제가 있어요. 평가 설정 자체가 반복을 유발하기 쉬웠다는 점이에요. 사후 분석에서 인용한 Qwen3.5-0.8B 공식 모델 카드의 내용은 연구자가 실제로 사용한 설정과 차이가 있었어요.
| 파라미터 항목 | 모델 카드 설명 | 실험 평가 설정 | 영향 |
|---|---|---|---|
| 추론 모드 | 0.8B는 기본적으로 비활성화 | 강제 활성화 | 소형 모델이 추론 반복에 빠지기 쉬움 |
| 온도(추론 모드 텍스트 작업) | 1.0 권장 | 0.6 | 모델 카드에서 0.6은 이미지 이해와 코드 작성 작업에 해당 |
| 반복 처리 권장 사항 | 샘플링 파라미터를 조정하고 스트리밍 출력을 적시에 중단 | 32,768 토큰 한도까지 출력 | 다수의 답변이 실패로 판정됨 |
위 모델 카드 내용은 언론의 사후 분석을 통해 전해진 것이므로, 평가 전에 Qwen 공식 모델 카드 원문을 직접 확인하는 것이 좋아요. 여기서 강조할 것은 평가 방법이에요. 같은 모델이라도 샘플링 파라미터를 바꾸면 ‘기준선’이 완전히 달라질 수 있어요. 기준선 자체가 반복에 빠지기 쉬운 설정에서 측정됐다면, 모델이 ‘멈출 수 있게’ 하는 어떤 변경이든 성능의 비약적인 향상처럼 보일 수 있어요.
추론 모델 평가 체크리스트: 먼저 잘림을 분리하고 결론을 내리세요
이번 회고에서 얻은 교훈을 정리하면, 어떤 추론 모델에도 적용할 수 있는 평가 절차를 만들 수 있어요. 모델을 선택하거나 파라미터를 조정할 때, 또는 파인튜닝이나 프롬프트 변경 효과를 검증할 때 아래 표를 하나씩 확인해 보세요.
| 확인 항목 | 구체적인 방법 | 판단 기준 |
|---|---|---|
| 1. 잘림 여부로 분리 | finish_reason == "length" 비율을 집계하고 그룹별 정확도를 계산 |
잘림 비율이 10%를 넘으면 전체 점수를 직접 비교할 수 없음 |
| 2. 반복률 확인 | 잘린 응답의 끝부분에서 n-gram 반복률을 집계 | 끝부분의 반복률이 높으면 추론이 길어진 게 아니라 반복 루프에 빠진 것 |
| 3. 샘플링 파라미터 확인 | 모델 카드와 대조해 온도, top_p, 추론 모드 설정을 확인 | 공식 권장 설정과 다르면 별도로 명시 |
| 4. 짝지어 비교 | 변경 전후 결과를 문제별로 대조하고 오답에서 정답, 정답에서 오답으로 바뀐 수를 집계 | 점수 상승이 잘림 그룹에 집중됐다면 ‘장애물 제거’에 해당 |
| 5. 다른 모델과 비교 | 같은 프롬프트와 파라미터로 잘림 비율이 낮은 대조 모델을 추가 | 대조 모델의 점수가 오르지 않으면 개선 효과는 능력 향상이 아님 |
🎯 평가 팁: 여러 모델을 비교할 때 가장 번거로운 일은 모델마다 별도의 호출 코드를 작성하는 거예요. APIYI apiyi.com의 OpenAI 호환 인터페이스를 사용하면 같은 스크립트와 동일한 프롬프트, 파라미터로 여러 주요 모델을 호출하고 ‘잘림 비율’을 고정 집계 열로 출력하기 편리해요.
추론 모델 평가 스크립트: 간단한 예제
아래 코드는 여러 문제 중 길이 제한에 걸려 응답이 잘린 비율을 계산해요. finish_reason이 length이면 max_tokens에 도달했다는 뜻이에요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # 실제 모델명으로 바꾸세요
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
전체 구현 코드 보기(그룹별 정답률 및 응답 끝부분 반복률 포함)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """텍스트 끝부분의 n-gram 반복 비율을 계산해요(중국어는 문자 단위로 나눌 수 있어요)."""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: 답변의 정답 여부를 판별하는 함수"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
모델마다 추론 모드를 켜고 끄는 방식은 달라요. 요청 필드로 제어하기도 하고, 모델명으로 구분하거나 프롬프트 템플릿에 설정하기도 해요. 추론 내용이 max_tokens에 포함되는지, 별도로 반환되는지도 모델마다 다르므로 평가 전에 각 모델의 문서를 꼭 확인하세요.
🚀 빠른 시작: 이 분류 방법을 먼저 검증해 보고 싶다면 APIYI apiyi.com에 가입해 무료 테스트 크레딧으로 추론 모델 두세 개에 수십 개의 문제를 입력해 보세요. 잘림 비율의 차이를 확인한 뒤 평가 규모를 늘릴지 결정하면 돼요.
사고 모델 평가 사건의 영향 분석
개발자에게 미치는 영향
- 총점만으로는 판단하기 어려워요: 전체 정답률만 보면 ‘답변을 끝내지 못한 경우’와 ‘틀린 경우’를 구분할 수 없어요. 출시 전 평가 보고서에는 최소한 출력 잘림 비율과 그룹별 정답률을 포함해야 해요.
- 매개변수 조정 효과를 오해할 수 있어요: 출력 한도를 높이거나 온도를 조정하고 반복 페널티를 추가하면 점수가 크게 오를 수 있어요. 하지만 이는 ‘장애물을 치운 것’이지 모델이 바뀌었다는 뜻은 아니에요.
- 프로덕션 환경도 영향을 받아요: 평가에서 발생한 출력 잘림은 실제 서비스에서 지나치게 긴 응답, 비용 폭증, 사용자 대기로 이어져요. 모델 카드에서도 스트리밍 출력과 함께 반복 감지 및 조기 출력을 중단하는 방법을 권장해요.
모델 평가 연구에 미치는 영향
- ‘대폭 향상’의 근거를 나눠 살펴봐야 해요: 이번 분석에 따르면 능력이 비약적으로 향상된 것처럼 보이는 결과도 출력 잘림 여부에 따라 나눠 보면 단순한 버그 수정일 수 있어요. 앞으로 소형 모델이나 사고 모델의 개선을 주장할 때는 출력 잘림 비율이 어떻게 달라졌는지도 확인할 필요가 있어요.
- 대조군 설계가 더욱 중요해져요: Gemma 3 270M의 추가 실험과 Astra가 직접 수행한 무작위 방향 대조 실험에서는 성적이 약 1.5%포인트만 변했어요. 이는 대조군 설계가 실제 신호와 잡음을 구분하는 데 핵심적임을 보여줘요.
자주 묻는 질문 FAQ
Q1: 추론 모델 평가에서 ‘잘림 함정’이란 무엇인가요?
모델이 추론 과정에서 반복에 빠져 토큰 한도까지 출력하고도 답을 내놓지 못해 평가 시스템에서 오답 처리되는 상황을 말해요. 이때 낮은 점수는 ‘풀 줄 모른다’가 아니라 ‘끝까지 쓰지 못했다’는 뜻이에요.
Q2: 출력 잘림으로 인한 낮은 점수와 능력 부족으로 인한 낮은 점수는 어떻게 구분하나요?
문제를 토큰 한도 도달 여부에 따라 두 그룹으로 나눠 각각 정답률을 계산해요. 답변을 끝까지 출력한 문제의 정답률은 높고 잘린 문제는 거의 0점이라면 반복이 문제예요. 반면 끝까지 출력한 답변에도 오류가 많다면 능력이 부족하다는 뜻이에요. Qwen과 Gemma의 비교가 각각 이 두 사례에 해당해요.
Q3: Astra가 Qwen을 수정한 이번 실험은 언제 발표됐나요?
원본 블로그는 2026년 11월 2일에 공개됐고, 공개 저장소 로그를 바탕으로 분석한 미디어 기사는 11월 5일에 발행됐어요. 이 글의 데이터는 해당 분석을 기준으로 하며, 모델 카드의 세부 내용은 Qwen 공식 원문에서 확인하는 것이 좋아요.
Q4: 이 평가 방법은 어떤 상황에 적합한가요?
– **모델 선택**: 수학이나 코드 작업에서 다양한 추론 모델의 성능 비교
– **매개변수 조정**: 온도, 토큰 한도, 추론 기능 설정 변경의 실제 효과 평가
– **개선 효과 검증**: 파인튜닝, 프롬프트 또는 가중치 수정이 능력 향상으로 이어졌는지, 아니면 장애 요인만 제거했는지 판단
Q5: 통합 인터페이스로 여러 추론 모델을 어떻게 비교 평가하나요?
1. APIYI apiyi.com에서 계정을 등록하고 API 키를 발급받아요
2. 이 글의 스크립트에서 base_url을 `https://api.apiyi.com/v1`로 설정해요
3. 프롬프트, 온도, max_tokens를 고정하고 모델명만 바꿔 잘림 비율과 그룹별 정답률을 출력해요
모델마다 추론 기능 설정 방식이 다르므로 각 모델의 문서에 맞게 요청 매개변수를 조정해야 해요.
Q6: 이 그룹 분리 방법에는 어떤 한계가 있나요?
잘림 여부에 따른 분리는 ‘끝까지 쓰지 못했다’는 사실만 확인할 수 있고, 끝까지 출력한 답변이 운 좋게 맞은 것인지는 판단할 수 없어요. 답변 끝부분의 반복률 임계값은 언어와 작업에 맞게 조정해야 하며, 중국어 텍스트는 공백 대신 글자 단위로 나누는 것이 좋아요. 또한 일부 모델은 추론 내용을 완전히 반환하지 않으므로 usage의 토큰 통계도 함께 확인해야 해요. 예산이 한정돼 있다면 APIYI apiyi.com에서 소규모 샘플로 먼저 시험하고, 통계 기준을 확인한 뒤 규모를 늘릴 수 있어요.
추론 모델 평가 핵심 요점 Key Takeaways
- 점수 상승의 출처: Qwen이 답변을 완료한 114문제의 정답률은 변경 전후 모두 93.9%였으며, 상승분은 모두 잘린 답변에서 나왔어요.
- 실패 유형: 기준 모델 답변의 93%가 출력 한도에 도달했고, 답변 끝부분의 약 95%는 반복 내용이었어요.
- 파라미터 차이: 평가에 사용한 온도 0.6은 모델 카드에서 추론 텍스트에 권장하는 온도 1.0과 달랐어요.
- 대조 실험 근거: 잘림 비율이 낮은 Gemma 3 270M은 가중치 변경 후 MATH-500 점수가 1%포인트 미만으로 올랐어요.
- 핵심 방법: 먼저
finish_reason으로 잘린 답변을 분류한 다음 정답률을 비교해요. - 시작 방법: APIYI apiyi.com의 통합 인터페이스를 통해 동일한 파라미터로 여러 모델의 잘림 비율을 측정해요.
정리
이번 ‘Astra의 Qwen 가중치 변경’ 논란은 추론 모델을 평가하는 모든 사람에게 중요한 교훈을 남겼어요.
- 점수가 급등했다면 먼저 나눠 살펴보세요: 토큰 한도 도달 여부에 따라 그룹을 나누고, 어느 그룹에서 점수가 올랐는지 확인해요.
- 파라미터도 기준 조건의 일부예요: 온도, 추론 기능 활성화 여부, 출력 한도를 모델 카드와 대조하고 보고서에 명시해요.
- 장애물 제거와 능력 향상을 구분하세요: 잘림 비율이 낮은 대조 모델을 사용해 개선의 실제 성격을 검증해요.
다음에 ‘특정 변경으로 성적이 몇 배 올랐다’는 결론을 보게 된다면, 먼저 이렇게 물어보세요. 잘림 비율은 얼마나 달라졌을까요? 이 질문 하나가 전체 점수보다 진실을 더 잘 보여줄 때가 많아요.
여러 추론 모델을 출시 전에 평가할 계획이라면, APIYI apiyi.com을 통해 동일한 스크립트와 파라미터로 잘림 비율을 먼저 측정한 뒤 모델을 선택해 보세요.
📚 참고 자료
- 硅星人 Pro 분석 기사(36氪转载):화제가 된 「Astra의 Qwen 두뇌 개조」는 우리가 원하는 RSI와 큰 관계가 없다
- 링크:
36kr.com/p/4056494372181124 -
설명: 공개 저장소의 문항별 기록을 바탕으로 다시 계산한 쌍별 테스트 데이터로, 이 글의 핵심 데이터 출처예요.
-
MIT CSAIL 연구자 블로그:Sparks of Weight-Space Programming
-
설명: 실험의 원래 설명과 결과표를 담고 있어요. 실험 8의 설정을 원문과 함께 살펴보는 것을 권장해요.
-
Qwen3.5-0.8B 공식 모델 카드:샘플링 파라미터와 사고 모드 설명
- 설명: 사고 모드의 기본 상태, 권장 온도, 반복 처리에 관한 권장 사항을 확인할 수 있어요.
작성자: APIYI 기술팀
기술 교류: APIYI 공식 사이트 apiyi.com에서 문의해 주세요. 더 자세한 호출 안내는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.