Nos últimos dias, uma publicação no X teve muitas visualizações: um “desenvolvedor chinês de 23 anos” executou 300 instâncias do Claude Code em paralelo. Cada resultado era comparado ao arquivo de origem em cerca de 100 milissegundos, e mais de 100 perfis de empresas foram registrados no Obsidian “sem nenhum erro”.
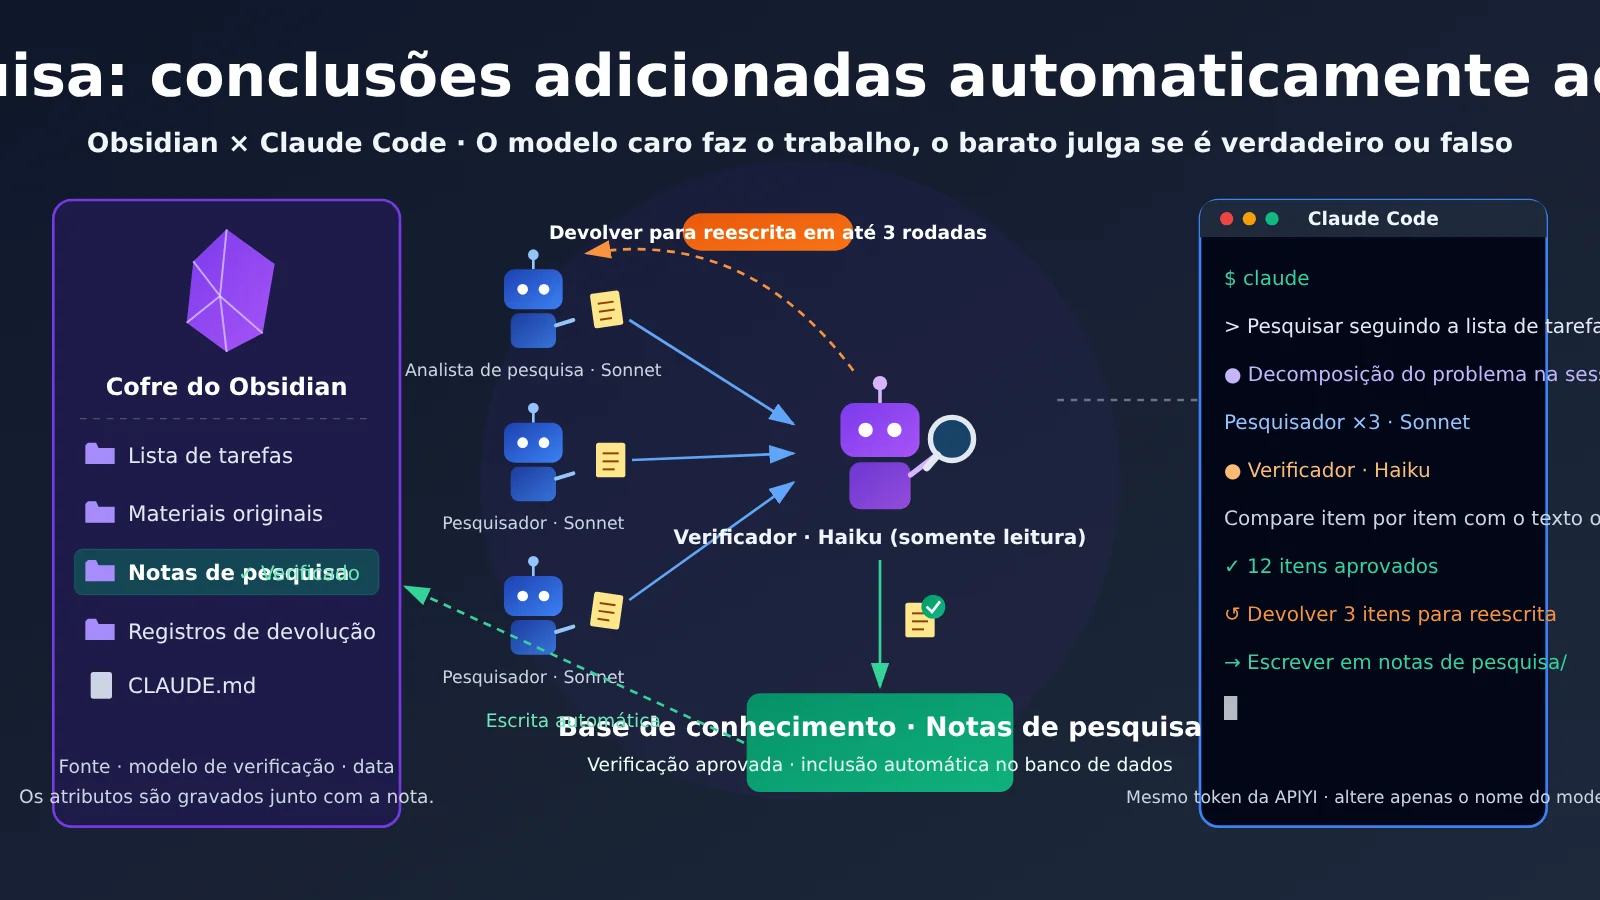
A ideia que realmente vale a pena aprender com a publicação é: o modelo caro faz o trabalho, o modelo barato verifica se as informações são verdadeiras, o que não passar volta para revisão e só o que for aprovado entra na base.
Um tutorial para seguir e colocar em prática. O processo é feito principalmente pela interface gráfica e conversando com o Claude Code em linguagem natural. Você não precisa saber programar.
Principal benefício: ao terminar de ler, você terá montado no seu computador uma pequena equipe de agentes de pesquisa. A sessão principal divide o tema em partes, alguns subagentes pesquisam em paralelo e um subagente de verificação, mais barato, examina cada ponto. As conclusões aprovadas são salvas automaticamente no Obsidian, com as fontes e os indicadores de verificação.
Antes de começar: pesquisa em enxame com Obsidian e Claude Code
Antes de colocar a mão na massa, confira se você atende aos requisitos abaixo.
- Objetivo: a sessão principal (Opus) divide o tema e consolida os resultados; 2 a 3 subagentes de pesquisa (Sonnet) buscam informações em paralelo; 1 subagente de verificação (Haiku) confere cada afirmação. As conclusões aprovadas são salvas na pasta «Notas de pesquisa» do Obsidian.
- Tempo necessário: reserve uma tarde para a configuração inicial. Depois, para cada pesquisa, basta escrever uma lista de tarefas e dar uma instrução para distribuí-las.
- Pré-requisitos: Obsidian para desktop e Claude Code instalados, uma conta da APIYI e acesso à internet para abrir os links das fontes.
- Nível de dificuldade: iniciante. Você não precisa escrever código; os arquivos de configuração aparecem apenas em blocos recolhíveis opcionais.
Abaixo está o roteiro completo, com um critério de conclusão para cada etapa. Conclua uma etapa, confira o critério correspondente e só então passe para a próxima.
| Etapa | O que fazer | Critério de conclusão (o que você verá ao terminar) |
|---|---|---|
| ① Criar o cofre | Criar um cofre no Obsidian, quatro pastas e um CLAUDE.md | As quatro pastas aparecem na barra lateral do Obsidian, e o CLAUDE.md está na raiz |
| ② Configurar o token | Configurar o token da APIYI no Claude Code | Ao abrir o Claude Code na pasta do cofre, você consegue conversar normalmente |
| ③ Criar subagentes | Pedir ao Claude para criar os agentes de pesquisa e de verificação | Ao digitar /agents, você vê os dois subagentes |
| ④ Distribuir as tarefas | Escrever uma lista de tarefas e distribuí-las em paralelo com uma instrução | Os arquivos com trechos de cada tarefa aparecem em «Fontes originais» |
| ⑤ Ciclo de verificação | Devolver o material para revisão, por até três rodadas | As conclusões aprovadas vão para «Notas de pesquisa»; as reprovadas, para «Registros de devolução» |
| ⑥ Conferir os resultados | Filtrar as notas verificadas no Obsidian | As propriedades das notas incluem status, fonte, modelo de verificação e data |
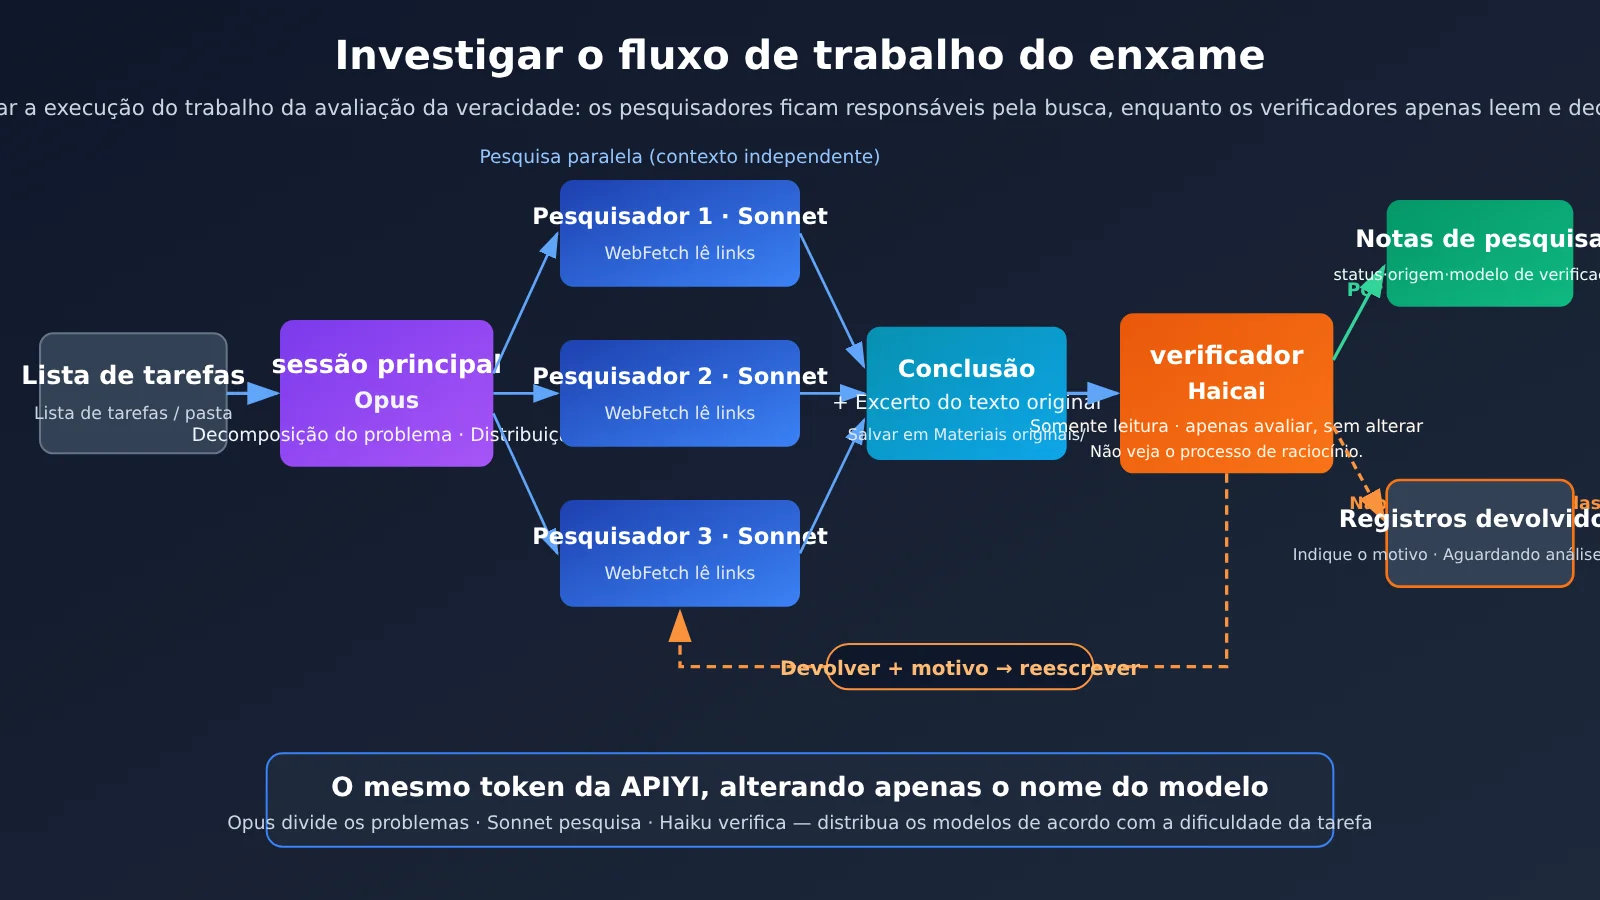
Pontos principais da pesquisa com agentes em enxame
| Categoria | Conteúdo | Como usar neste artigo |
|---|---|---|
| Documentação oficial (Claude Code / Obsidian) | Os subagentes têm contextos independentes, e é possível especificar as ferramentas e o modelo que cada um pode usar; a pesquisa paralela é um uso descrito oficialmente; o WebSearch permite até 200 chamadas por sessão, compartilhadas entre todos os subagentes; um vault do Obsidian é uma pasta comum com arquivos Markdown, e alterações externas são atualizadas automaticamente | Como base para a configuração |
| Teste pontual de terceiros | Em uma biblioteca de teste com 560 notas e 15 perguntas, o Claude Code sem nenhum plugin instalado acertou todas as respostas e consumiu menos tokens | Como referência para mostrar que não é preciso instalar plugins para começar; isso não representa o desempenho em bibliotecas grandes |
| Informações divulgadas na internet | Um desenvolvedor de 23 anos, 300 tarefas simultâneas, verificação em 100 milissegundos e zero erros; em outra publicação viral, aparecem --command-center, REA e JEV |
Aproveite apenas as ideias. A segunda publicação cita recursos que não existem na referência oficial da CLI — não copie o exemplo |
Por que dividir a pesquisa com agentes em enxame entre os papéis de “pesquisar” e “verificar”
Aumentar o número de agentes sem adicionar uma etapa de verificação só faz crescer a quantidade de alucinações que podem passar despercebidas. Quando a pesquisa e a verificação ficam a cargo de dois modelos diferentes, o verificador só precisa responder a uma pergunta: há evidências dessa conclusão no trecho original? Essa tarefa é bem mais simples do que fazer a pesquisa, então um Haiku mais barato já dá conta.
Há também uma sugestão bem prática nos comentários: o verificador não deve ver o raciocínio do pesquisador. Ele deve analisar apenas a conclusão e o texto original, para não ser influenciado pela argumentação do pesquisador. Além disso, o verificador só deve responder “aprovado” ou “reprovado + motivo” — não pode alterar o conteúdo. Se também começar a editar, os papéis de verificador e pesquisador acabam se misturando. A configuração deste artigo segue essas duas recomendações à risca.
Por que começar com o Obsidian sem instalar plugins ou MCP
Um vault do Obsidian é, na prática, uma pasta. As ferramentas de leitura e gravação que já vêm com o Claude Code podem manipular diretamente os arquivos .md ali dentro, e o Obsidian atualiza a exibição automaticamente. No teste de terceiros mencionado acima — uma biblioteca pequena, com 560 notas, e apenas uma execução por ferramenta —, o grupo de comparação sem nada instalado foi o que menos consumiu tokens. Por isso, não é necessário perder tempo com plugins no começo. Ainda não há dados sobre o desempenho em bibliotecas maiores.
Guia rápido: Obsidian + Claude Code para pesquisa com agentes em enxame
Passo ①: crie um vault no Obsidian e configure o CLAUDE.md
Abra o Obsidian e selecione “Criar novo vault” para criar uma biblioteca vazia. Dê a ela o nome 调研库 e escolha um local fácil de encontrar, como a pasta “Documentos”. Não coloque esse vault dentro da pasta de outro vault: aninhar bibliotecas pode quebrar os links internos.
Na barra de arquivos à esquerda, clique com o botão direito e selecione “Nova pasta”. Crie estas quatro pastas, nesta ordem: 任务清单, 原始资料, 调研笔记 e 打回记录.
Depois, crie uma nota chamada CLAUDE.md na raiz do vault e adicione as regras para salvar o conteúdo. Sempre que o Claude Code for iniciado nesse diretório, ele vai ler esse arquivo:
# 调研库入库规则
1. 只读写这 4 个文件夹:任务清单、原始资料、调研笔记、打回记录。绝不读写 .obsidian 文件夹。
2. 每条结论必须附来源链接和原文摘录(引号原样摘抄)。
3. 没有通过核查员核查的内容,不得写入「调研笔记」。
4. 打回超过 3 轮仍不通过的,写入「打回记录」并注明理由,等人工处理。
5. 调研笔记顶部写属性:status、来源、核查模型、日期。
Ao terminar, você verá: quatro pastas e um CLAUDE.md na barra lateral do Obsidian. Na raiz também haverá uma pasta de configuração .obsidian, que o Obsidian oculta por padrão. Ela guarda as configurações do próprio Obsidian e não deve ser alterada por nenhum agente.
Passo ②: conecte o token da APIYI ao Claude Code
Não vamos repetir aqui os detalhes da configuração. Siga o tutorial Como usar o magpie para conectar o Claude Code, o Codex, o Pi e o Hermes em uma única janela para conectar o token da APIYI pela interface gráfica e depois volte a este guia.
Só fique atento a estes dois pontos:
- Ao criar o token no painel da APIYI, selecione o grupo ClaudeCode.
- Preencha o endereço da API como
https://api.apiyi.come não acrescente/v1no final.
Depois de conectar, abra um terminal na pasta 调研库 e digite claude para iniciar. Faça uma pergunta qualquer. Se receber uma resposta normal, a conexão está funcionando.
Opcional: editar o settings.json manualmente (se preferir não usar a interface gráfica)
Edite `~/.claude/settings.json` e adicione estas duas opções ao campo env. Atenção: o nome da variável é `ANTHROPIC_AUTH_TOKEN`, não `ANTHROPIC_API_KEY`:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.apiyi.com",
    "ANTHROPIC_AUTH_TOKEN": "你的 APIYI 令牌"
  }
}
Se o Claude Code continuar pedindo para você entrar no site oficial ao iniciar, adicione `”hasCompletedOnboarding”: true` ao arquivo `~/.claude.json`.
Ao terminar, você verá: o Claude Code respondendo normalmente. No painel da APIYI, o token também terá um registro de uso, o que confirma que as solicitações foram enviadas com esse token.
Passo ③: peça ao Claude Code para criar os subagentes pesquisador e verificador
Os subagentes são arquivos Markdown com um cabeçalho YAML. Não precisa criá-los à mão: basta pedir ao Claude que faça isso. No Claude Code, envie a seguinte mensagem:
请在当前项目的 .claude/agents/ 下创建两个子代理:
1. researcher(调研员):模型 claude-sonnet-5-5。只用 WebFetch 读任务清单里给的链接,
   每条结论附来源链接和原文摘录,把结果写到「原始资料」文件夹。不给 Agent 工具。
2. fact-checker(核查员):模型 claude-haiku-5-5。只给 Read、Grep、Glob,
   不给 Write、Edit、Agent。它只接收“结论 + 原文摘录 + 来源文件路径”,
   不看调研员的推理过程,只输出「通过」或「打回 + 理由」,不得自己修改任何内容。
A sessão principal usa claude-opus-5-5 para dividir as perguntas, distribuir as tarefas e reunir os resultados. Você pode trocar o modelo com /model depois de iniciar ou defini-lo diretamente na ferramenta usada no passo ②.
Opcional: veja como são os arquivos dos dois subagentes
`.claude/agents/researcher.md`:
---
name: researcher
description: 按任务清单读取给定链接,产出带来源和原文摘录的调研结论
tools: Read, Grep, Glob, WebFetch, Write
model: claude-sonnet-5-5
maxTurns: 20
---
你是调研员。只读取任务里给出的链接。每条结论格式:
结论 / 来源链接 / 原文摘录(原样引用)。写入「原始资料」文件夹,不碰其他目录。
`.claude/agents/fact-checker.md`:
---
name: fact-checker
description: 逐条核对结论是否被原文摘录支持,只判定不修改
tools: Read, Grep, Glob
model: claude-haiku-5-5
maxTurns: 8
---
你是核查员。只看结论和原文,不接受任何推理说明。
每条输出「通过」或「打回:理由」。摘录不支持、数字对不上、来源缺失一律打回。
你没有写权限,也不得建议替换措辞以外的任何修改。
Atenção: depois de criar a pasta .claude/agents/ pela primeira vez, você precisa encerrar e abrir novamente a sessão do Claude Code. Depois disso, as alterações nos arquivos dos subagentes passam a valer automaticamente em poucos segundos. Como os subagentes não têm a ferramenta Agent, eles não podem delegar tarefas a outros subagentes. Isso evita uma cadeia de agentes difícil de controlar.
Ao terminar, você verá: ao digitar /agents, a lista exibirá researcher e fact-checker, cada um com o modelo correspondente.
Passo ④: crie a lista de tarefas e distribua a pesquisa paralela com uma frase
Na pasta 任务清单 do Obsidian, crie o arquivo 第一批.md. Aqui usamos como exemplo a pesquisa de cinco produtos. Inclua diretamente o link que deve ser consultado em cada tarefa. O motivo é que a documentação oficial não especifica se o WebSearch funciona em chamadas feitas por gateways de terceiros. Fornecer os links e pedir que o subagente os leia com WebFetch é a opção mais confiável.
# 第一批:5 个产品定价与功能
1. 产品 A:定价页 https://example-a.com/pricing ,功能页 https://example-a.com/features
2. 产品 B:https://example-b.com/pricing
3. 产品 C:https://example-c.com/docs/plans
4. 产品 D:https://example-d.com/pricing
5. 产品 E:https://example-e.com/changelog
每条要回答:最低付费档价格、是否有免费版、最近一次功能更新。
Volte ao Claude Code e envie esta mensagem:
读取 任务清单/第一批.md,把 5 条任务分给 researcher 子代理并行调研,
各自写入「原始资料」。全部完成后告诉我每条的结论数量。
Os cinco produtos são apenas um exemplo. O processo é o mesmo para monitorar concorrentes, resumir artigos acadêmicos ou acompanhar notícias do setor: inclua os links de cada tarefa e especifique as perguntas que precisam ser respondidas.
Ao terminar, você verá: cinco arquivos aparecendo aos poucos em 原始资料 no Obsidian. Cada um terá itens no formato “conclusão / link da fonte / trecho original”.
Passo ⑤: configure o ciclo de verificação, com no máximo três rodadas
Continue a conversa com a sessão principal:
对「原始资料」里的每条结论,只把“结论 + 原文摘录 + 来源路径”交给 fact-checker。
通过的,由你写入「调研笔记」,顶部属性填 status: 已核查、来源、核查模型: claude-haiku-5-5、日期。
打回的,把理由交给 researcher 重写后再核查,最多 3 轮;
3 轮仍不过的,写入「打回记录」并附理由,不要放进调研笔记。
Isso é o que a documentação oficial chama de “subagentes em cadeia”: primeiro, um subagente conclui o trabalho; depois, o resultado é passado a outro. Aqui, a sessão principal atua como coordenadora e controla rigorosamente o que o verificador pode ver: apenas a conclusão e o texto original, sem o raciocínio do pesquisador.
Ao terminar, você verá: conclusões verificadas em 调研笔记 e, possivelmente, alguns itens com justificativas em 打回记录. É normal haver registros de reprovação: isso mostra que o verificador está funcionando.
Passo ⑥: confira as conclusões verificadas no Obsidian
Abra qualquer nota de pesquisa. Os atributos no início devem ser parecidos com estes:
---
status: 已核查
来源: https://example-a.com/pricing
核查模型: claude-haiku-5-5
日期: 2026-10-21
---
Digite [status:已核查] na busca do Obsidian para filtrar todas as notas aprovadas na verificação. Na hora de conferir, vale escolher aleatoriamente duas ou três, abrir os links das fontes e checar o texto original.
Ao terminar, você verá: cada conclusão dos resultados filtrados poderá ser rastreada até o texto original. O conteúdo suspeito ficará concentrado em 打回记录, à espera de uma avaliação manual.
Divisão de funções e preços dos três modelos para pesquisa
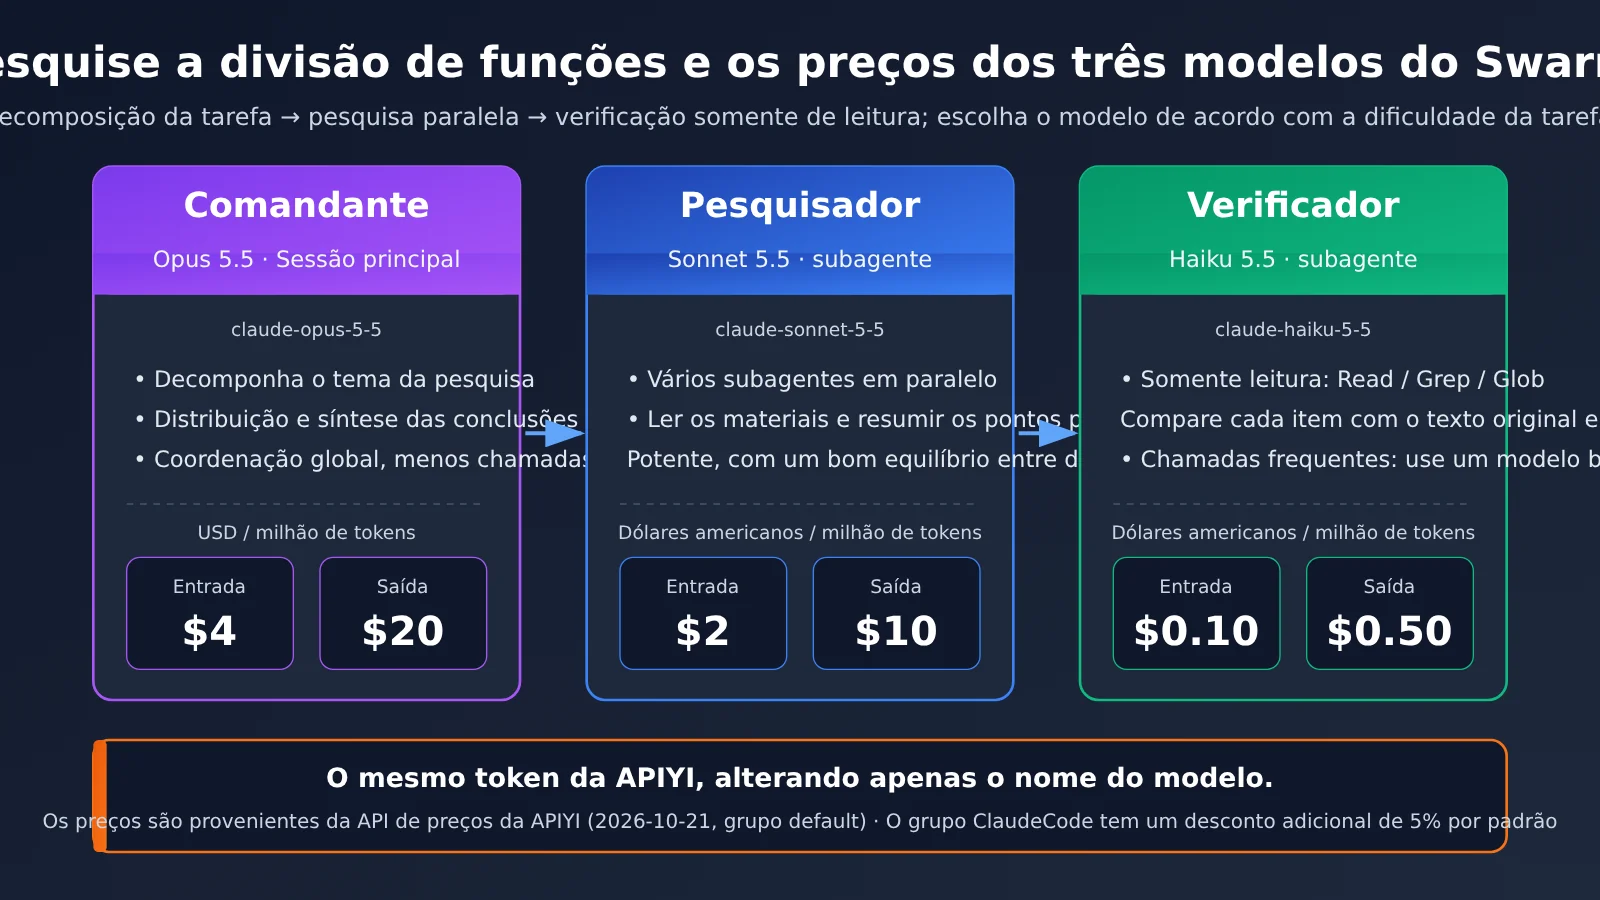
Os três papéis usam a mesma chave API da APIYI; a única diferença é o nome do modelo. Os preços da tabela vêm da interface de preços da APIYI, consultada em 21/10/2026 (grupo default). No grupo ClaudeCode, há ainda um desconto de 5%.
| Papel | Nome do modelo | Entrada (US$/milhão de tokens) | Saída (US$/milhão de tokens) | Por que escolher este modelo |
|---|---|---|---|---|
| Sessão principal: dividir as tarefas e resumir | claude-opus-5-5 |
4 | 20 | Precisa coordenar o trabalho como um todo; é usado poucas vezes |
| Pesquisador: ler materiais em paralelo | claude-sonnet-5-5 |
2 | 10 | Tem boa capacidade de leitura e síntese, com uma relação equilibrada entre custo e desempenho |
| Verificador: avaliar cada afirmação | claude-haiku-5-5 |
0.10 | 0.50 | As tarefas são simples e as chamadas frequentes, então vale usar um modelo mais barato |
Sobre os custos, vale deixar alguns pontos claros. Quanto mais subagentes houver, mais longos serão os resultados retornados por cada um e mais espaço ocuparão na janela de contexto da sessão principal. Além disso, cada subagente consome tokens individualmente durante sua execução.
Tabela de solução de problemas comuns do enxame de pesquisa
| Sintoma | Causa comum | Como resolver |
|---|---|---|
| O subagente não é chamado | A sessão não foi reaberta depois da criação da pasta agents; a descrição está vaga demais |
Feche e reabra o Claude Code; ao delegar a tarefa, diga explicitamente: “use o subagente researcher” |
| O verificador começa a editar o conteúdo | Write ou Edit foi incluído em tools, ou o subagente herdou todas as ferramentas |
Abra fact-checker.md e confirme que tools contém apenas Read, Grep e Glob |
O conteúdo foi gravado na pasta .obsidian |
O CLAUDE.md não está na raiz do cofre ou as regras não estão claras |
Mova o CLAUDE.md para a raiz e acrescente a regra “nunca leia nem grave arquivos em .obsidian” |
| Erro 401 | O token foi preenchido incorretamente, não pertence ao grupo ClaudeCode ou foi usada a variável API_KEY |
Copie o token novamente, confirme o grupo e altere o nome da variável para AUTH_TOKEN |
| Erro no endereço da solicitação | Há um /v1 extra no final do endereço |
Altere para https://api.apiyi.com |
| O WebSearch não está disponível | Ao usar um gateway de terceiros, não há confirmação oficial de que o recurso seja compatível; ou o limite de 200 sessões foi atingido | Inclua os links diretamente na lista de tarefas e use o WebFetch; comece uma nova conversa com /clear |
| As novas notas não aparecem no Obsidian | O Claude Code gravou os arquivos em outro diretório ou o cofre aberto não é o mesmo | Pergunte ao Claude Code: “Em qual caminho absoluto você acabou de gravar os arquivos?” e compare com o caminho do cofre |
Se não souber quais ferramentas estão disponíveis na sessão atual, pergunte diretamente ao Claude: “Quais ferramentas você tem disponíveis?”. Ele vai listar todas.
Quando não usar Obsidian com Claude Code para montar um enxame de pesquisa
Essa configuração tem um custo fixo e não é adequada para todos os cenários. Nos casos abaixo, conversar individualmente com o Claude costuma ser mais simples:
- Pesquisar apenas uma ou duas informações: o custo de dividir a tarefa, delegá-la e verificar os resultados pode ser maior que o da própria pesquisa.
- As informações estão todas em um único artigo: peça ao Claude que leia o artigo inteiro e faça um resumo; não é necessário trabalhar em paralelo.
- Você precisa de dados em tempo real: cotações de ações e taxas de câmbio, por exemplo, são mais adequadas para consulta em uma API especializada. Páginas da web podem conter informações desatualizadas.
- O orçamento está apertado: vários subagentes consomem tokens em proporção muito maior. Primeiro, vale mais a pena testar a solicitação em uma única sessão.
Guia rápido do enxame de pesquisa com Obsidian e Claude Code
Salve esta tabela e consulte-a sempre que começar uma nova rodada de pesquisa.
| Item | Valor ou prática |
|---|---|
| Estrutura do vault | Lista de tarefas / materiais originais / notas de pesquisa / registros de revisão + CLAUDE.md na raiz |
| Endereço da API | https://api.apiyi.com (sem /v1) |
| Token | Grupo ClaudeCode da APIYI; um único token para os três modelos |
| Divisão de modelos | Sessão principal: opus-5-5 / pesquisa: sonnet-5-5 / verificação: haiku-5-5 |
| Ferramentas do verificador | Apenas Read, Grep e Glob; sem Write, Edit ou Agent |
| Regras de verificação | Conferir apenas as conclusões e os textos originais; responder somente “aprovado” ou “devolver para revisão”; no máximo 3 rodadas |
| Acesso à internet | Inclua links na lista de tarefas e use WebFetch; as 200 chamadas de WebSearch por sessão são compartilhadas |
| Filtragem | Pesquise no Obsidian por [status:已核查] |
| Controle de custos | Faça um teste com 3 itens e depois confira o uso do token no painel da APIYI |
Perguntas frequentes
Q1: O que é um “enxame de pesquisa”?
É uma forma de trabalhar em que vários subagentes de IA pesquisam materiais em paralelo, cada um com uma parte da tarefa, e outro modelo verifica os resultados um a um. A configuração deste artigo usa uma sessão principal, 2 ou 3 pesquisadores e um verificador. Embora seja pequena, ela já aplica por completo a ideia de separar quem executa o trabalho de quem confere se as informações são verdadeiras.
Q2: É verdade que um Claude Code fez 300 tarefas sem nenhum erro, como dizem na internet?
Não há como confirmar. A identidade do desenvolvedor, as 300 tarefas em paralelo, os 100 milissegundos e a ausência de erros são informações que aparecem apenas na própria publicação. Os números também variam nas diferentes versões que a reproduzem. Este artigo aproveita apenas a ideia de usar um modelo mais caro para executar o trabalho e um mais barato para verificar os resultados.
Q3: Como ativar o modo de comando `–command-center` mencionado na publicação?
Não é possível. A referência oficial da CLI do Claude Code não inclui esse parâmetro, e REA e JEV também não são recursos oficiais. Para trabalhar em paralelo, use os subagentes oficiais. Se precisar executar tarefas por mais tempo, a recomendação oficial é usar os agentes em segundo plano (`claude agents`).
Q4: É obrigatório instalar um plugin do Obsidian ou usar MCP?
Não no começo. Um terceiro fez um teste pontual em um vault pequeno, com 560 notas, e o Claude Code acertou tudo sem instalar nada — além de usar menos tokens. Ainda não há dados sobre o desempenho em vaults maiores.
Q5: É preciso solicitar um token separado para cada modelo?
Não. Crie um token do grupo ClaudeCode em APIYI apiyi.com e use-o na sessão principal e nos dois subagentes. Basta configurar um nome de modelo diferente para cada um.
Q6: Como saber quanto custou esta pesquisa?
Acesse o painel da APIYI e confira o uso e os registros desse token. Recomendamos começar com 3 tarefas pequenas e ampliar a rodada depois de entender o consumo real.
Q7: Com um verificador, dá para garantir que não haverá erros?
Não. O verificador consegue avaliar se as conclusões correspondem aos trechos citados, mas talvez não perceba erros no próprio texto original nem problemas causados por uma seleção tendenciosa dos trechos. Por isso, na etapa ⑥, recomendamos conferir manualmente alguns itens por amostragem e consultar os registros de revisão periodicamente.
Principais pontos sobre o enxame de pesquisa
- A estratégia importa mais que a quantidade: use modelos caros para executar as tarefas e modelos baratos para verificar os resultados. O número de agentes não é o mais importante.
- A biblioteca é só uma pasta: o Claude Code lê e grava arquivos Markdown diretamente. Não é preciso instalar plugins para começar.
- O verificador precisa ter acesso somente de leitura: não dê a ele permissões de Write, Edit ou Agent. Ele deve apenas aprovar ou devolver o resultado.
- Isole o processo de raciocínio: o verificador deve consultar apenas a conclusão e o texto original, para não ser influenciado por quem fez a pesquisa.
- Use o WebFetch para acessar links: assim, você evita o limite do WebSearch e não precisa se preocupar com o suporte do gateway.
- Depois de 3 rodadas sem aprovação, passe para uma pessoa: registre o caso no histórico de devoluções, sem forçar a inclusão na biblioteca.
- Faça um teste antes de avaliar os custos: use o mesmo token da APIYI e consulte o uso real no painel de controle.
Resumo
Para montar um enxame de pesquisa com o Obsidian e o Claude Code, há três pontos principais:
- Estrutura clara: quatro pastas e um arquivo CLAUDE.md, com regras sobre quem pode gravar em cada lugar.
- Responsabilidades separadas: Sonnet faz a pesquisa, Haiku verifica e Opus coordena. O verificador não tem permissão para gravar.
- Fluxo fechado de inclusão na biblioteca: só o que for aprovado entra nas notas de pesquisa. O que não for aprovado volta para revisão; se não passar após 3 rodadas, fica a cargo de uma pessoa.
A recomendação é começar com três tarefas pequenas e testar o fluxo inteiro. Confira se os arquivos ficam nos locais certos, se a verificação funciona e se os custos estão dentro do esperado. Depois, substitua os exemplos por tarefas suas, como monitoramento de concorrentes, pesquisas acadêmicas ou notícias do setor. Para conectar os modelos, você pode usar um token do grupo ClaudeCode da APIYI, em apiyi.com. Os três modelos compartilham o mesmo token, o que facilita alternar entre eles.
📚 Referências
- Documentação de subagentes do Claude Code: criação de subagentes, permissões de ferramentas, campo de modelo e pesquisa paralela
- Link:
code.claude.com/docs/en/sub-agents -
Observação: principal referência para as configurações de subagentes deste artigo
-
Referência de ferramentas do Claude Code: comportamento e limites de uso do WebSearch e do WebFetch
- Link:
code.claude.com/docs/en/tools-reference -
Observação: explica por que recomendamos incluir os links diretamente na lista de tarefas
-
Configuração de modelos do Claude Code: aliases e nomes completos dos modelos
- Link:
code.claude.com/docs/en/model-config -
Observação: confirma a quais versões correspondem opus, sonnet e haiku
-
Documentação de ajuda do Obsidian: cofres e armazenamento de arquivos
- Link:
obsidian.md/help -
Observação: confirma que um cofre é apenas uma pasta comum e que alterações externas são atualizadas automaticamente
-
Teste prático de terceiros: comparação de ferramentas de IA para o Obsidian (um pequeno cofre com 560 artigos, em um único teste)
- Link:
agentskillshub.top/best/obsidian-second-brain/ -
Observação: referência para começar sem instalar plugins
-
Documentação de integração do Claude Code da APIYI
- Link:
docs.apiyi.com/scenarios/programming/claude-code - Observação: informações sobre grupos, endereços e variáveis de ambiente do Claude Code
Autor: equipe técnica da APIYI
Conversa técnica: se tiver algum problema durante a configuração, deixe um comentário. Para mais informações sobre integração, consulte a central de documentação da APIYI em docs.apiyi.com.