這幾天 X 上有一條帖子瀏覽量很高:一位“23 歲的中國開發者”並行跑了 300 個 Claude Code,每條輸出在約 100 毫秒內對照源文件覈對,100 多份公司檔案“零錯誤”地寫進了 Obsidian。
帖子裏真正值得學的思路:貴模型幹活,便宜模型判真假,不合格就打回重做,通過了才入庫。
一份照着做就能跑通的教程。整個過程以圖形界面操作和“對 Claude Code 說人話”爲主,不需要會寫代碼。
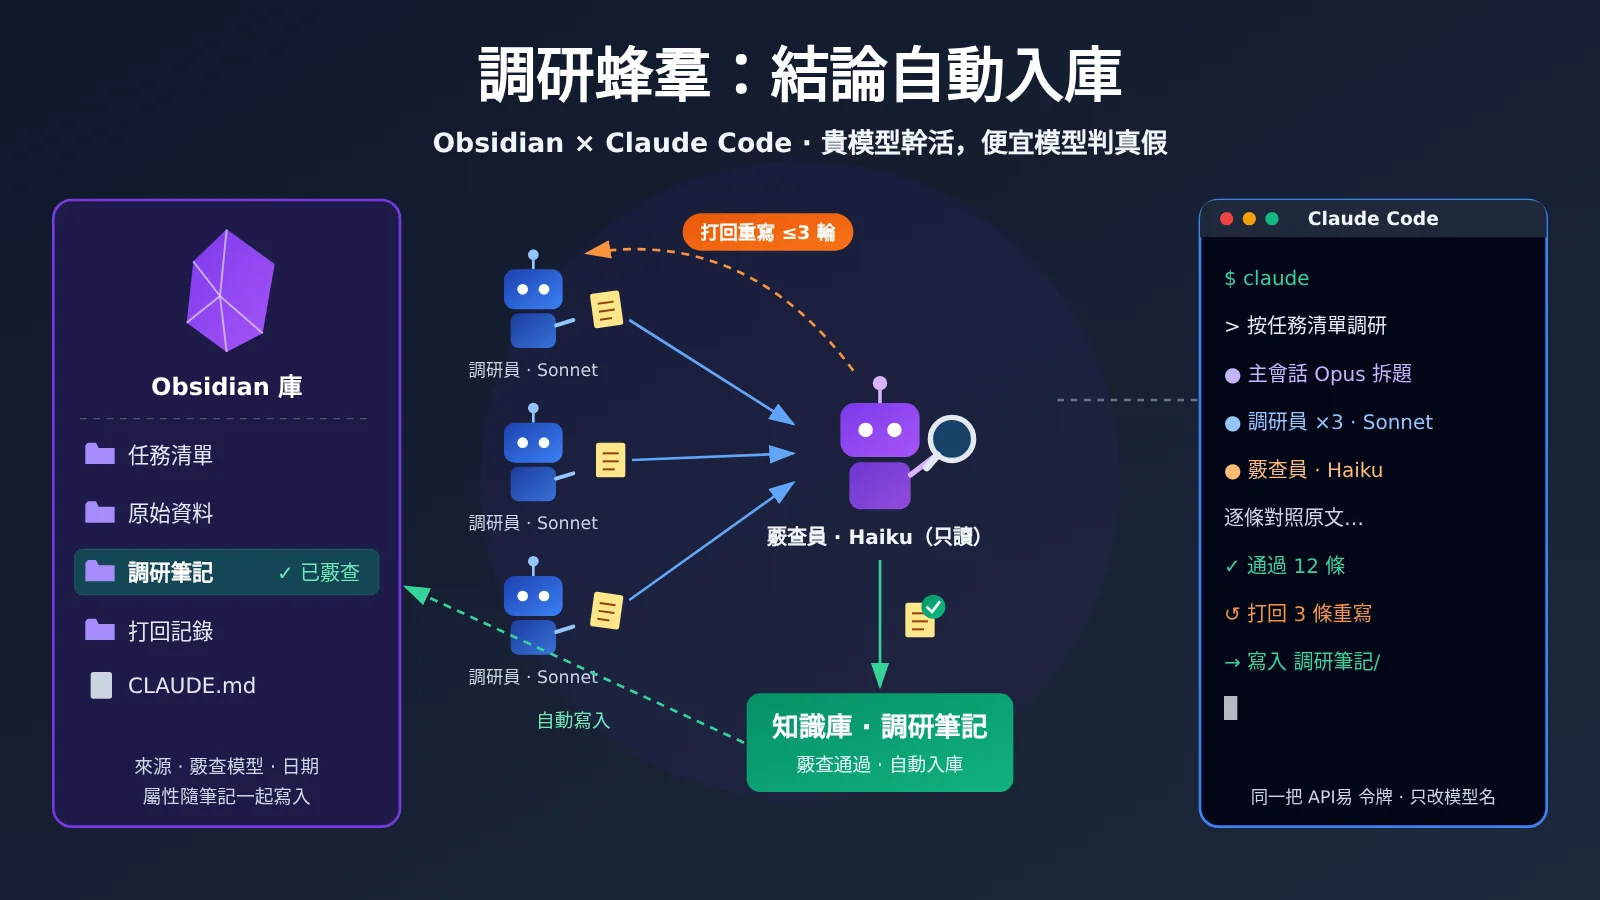
核心價值:讀完本文,你會在自己電腦上搭好一個小號調研蜂羣。主會話負責拆題,幾個調研子代理並行查資料,一個便宜的核查子代理逐條挑刺,通過覈查的結論會自動寫進 Obsidian 庫,並帶上來源和核查標記。
Obsidian 加 Claude Code 調研蜂羣:開始之前
動手之前,先確認下面幾項條件。
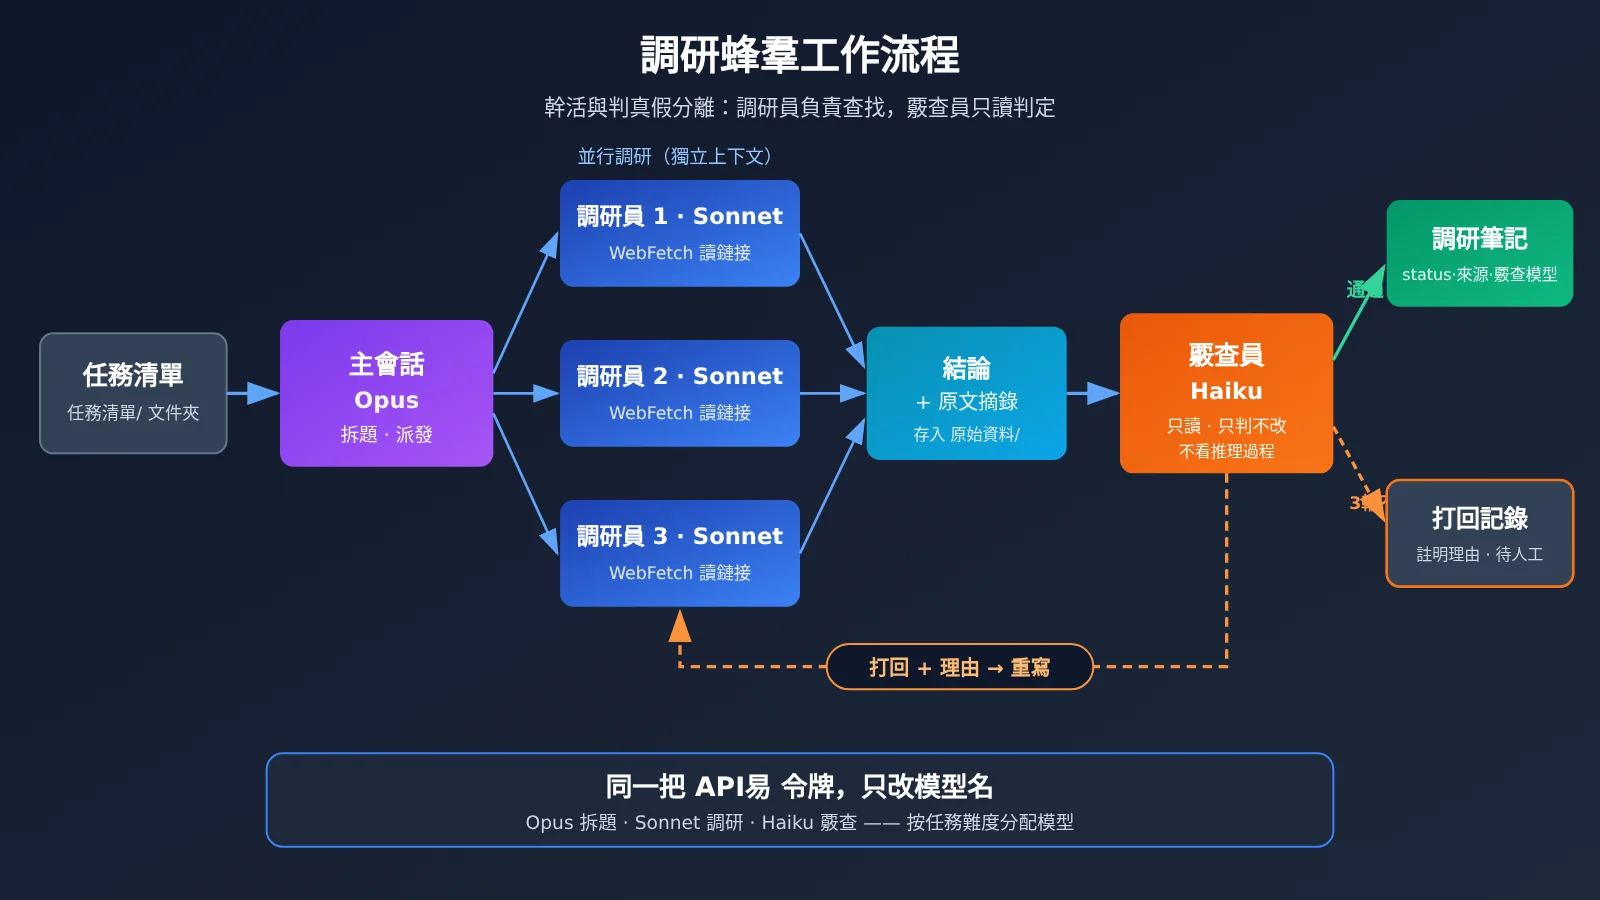
- 目標:主會話(Opus)拆題和彙總,2~3 個調研子代理(Sonnet)並行查資料,1 個核查子代理(Haiku)逐條判真假,通過的結論寫進 Obsidian 的「調研筆記」文件夾。
- 耗時:第一次搭建預留一個下午。之後每次調研只需要寫一份任務清單,再說一句話派發。
- 前置條件:已安裝 Obsidian 桌面端和 Claude Code,準備好一個 API易 賬號,電腦可以正常上網訪問目標資料鏈接。
- 難度:入門級。全程不需要寫代碼,配置文件只出現在可選的摺疊塊裏。
下面是整體路線圖,每一步都附了驗收標準。做完一步、對照驗收標準確認無誤後,再進入下一步。
| 步驟 | 做什麼 | 驗收標準(做完你會看到什麼) |
|---|---|---|
| ① 建庫 | 新建 Obsidian 庫、4 個文件夾和 CLAUDE.md | Obsidian 左側出現 4 個文件夾,根目錄有 CLAUDE.md |
| ② 接令牌 | 在 Claude Code 裏接好 API易 令牌 | 在庫文件夾裏打開 Claude Code,能正常對話 |
| ③ 建子代理 | 讓 Claude 寫調研員和核查員 | 輸入 /agents 能看到兩個子代理 |
| ④ 派任務 | 寫任務清單,一句話並行派發 | 「原始資料」裏出現每條任務的摘錄文件 |
| ⑤ 覈查循環 | 打回重寫,最多 3 輪 | 結論進入「調研筆記」,沒通過的進入「打回記錄」 |
| ⑥ 驗收 | 在 Obsidian 裏篩選已覈查筆記 | 筆記屬性帶 status、來源、覈查模型、日期 |
調研蜂羣核心要點
| 類別 | 內容 | 本文怎麼用 |
|---|---|---|
| 官方文檔(Claude Code / Obsidian) | 子代理有獨立上下文、可指定工具和模型;並行調研是官方寫明的用法;WebSearch 每個會話最多 200 次、所有子代理共用;Obsidian 庫就是一個裝 Markdown 的普通文件夾,外部改動會自動刷新 | 作爲搭建依據 |
| 第三方單次實測 | 560 篇筆記的測試庫、15 道題:什麼插件都不裝的 Claude Code 也全部答對,token 用量最少 | 作爲“入門不必裝插件”的參考,不代表大庫表現 |
| 網傳 | 23 歲開發者、300 併發、100 毫秒覈對、零錯誤;另一條熱帖裏的 --command-center、REA、JEV |
只借思路;後者在官方 CLI 參考裏不存在,不要照抄 |
調研蜂羣爲什麼要拆成“幹活”和“判真假”兩種角色
只增加代理數量、不加校驗,併發越多,混進來的幻覺也越多。把調研和核查拆給兩個模型之後,覈查員只需要回答一個問題:這句結論能不能在原文摘錄裏找到依據。這個任務比寫調研本身簡單得多,所以交給便宜的 Haiku 就夠用。
評論區還有一條很實用的建議:覈查員不要看調研員的推理過程,只看結論和原文,否則容易被調研員的說法帶偏。另外,覈查員只輸出“通過 / 打回 + 理由”,不能自己動手改。一旦覈查員也去改內容,它和調研員的職責就混在一起了。本文的配置完全按這兩條來做。
Obsidian 入門爲什麼不用裝插件或 MCP
Obsidian 的庫本質上就是一個文件夾,Claude Code 自帶的讀寫工具可以直接操作裏面的 .md 文件,Obsidian 會自動刷新顯示。前面提到的第三方實測(560 篇小庫、每個工具只跑一次)中,什麼都不裝的對照組反而最省 token。所以入門階段不需要折騰插件,庫規模變大之後表現如何,目前還沒有數據。
Obsidian 加 Claude Code 調研蜂羣快速上手
第 ① 步:用 Obsidian 新建庫並寫好 CLAUDE.md
打開 Obsidian,選擇「新建庫」(創建新的空庫),名字填 調研庫,位置選一個好找的目錄,比如「文檔」。不要把這個庫放進另一個庫的文件夾裏,庫裏套庫會讓內部鏈接失效。
在左側文件欄右鍵「新建文件夾」,依次建好 4 個文件夾:任務清單、原始資料、調研筆記、打回記錄。
然後在庫根目錄新建一個筆記,命名爲 CLAUDE.md,寫入入庫規則。Claude Code 每次在這個目錄啓動時都會讀取這份文件:
# 調研庫入庫規則
1. 只讀寫這 4 個文件夾:任務清單、原始資料、調研筆記、打回記錄。絕不讀寫 .obsidian 文件夾。
2. 每條結論必須附來源鏈接和原文摘錄(引號原樣摘抄)。
3. 沒有通過覈查員覈查的內容,不得寫入「調研筆記」。
4. 打回超過 3 輪仍不通過的,寫入「打回記錄」並註明理由,等人工處理。
5. 調研筆記頂部寫屬性:status、來源、覈查模型、日期。
做完你會看到:Obsidian 左側有 4 個文件夾和一個 CLAUDE.md。根目錄下還有一個 .obsidian 配置文件夾,Obsidian 默認把它隱藏,它存放的是 Obsidian 自己的設置,任何 Agent 都不應該改動它。
第 ② 步:給 Claude Code 接好 API易 令牌
這一步本文不重複講配置細節。請按 用 magpie 在窗口裏統一接入 Claude Code 等工具 這篇教程,在圖形窗口裏接好 API易 令牌,然後再回到這裏。
需要留意的只有兩點:
- 在 API易 控制檯創建令牌時,分組選 ClaudeCode。
- 接口地址填
https://api.apiyi.com,末尾不要加/v1。
接好之後,在 調研庫 文件夾裏打開終端,輸入 claude 啓動,隨便問一句,能正常回復就說明接通了。
可選:手動寫 settings.json(不想用圖形界面時)
編輯 `~/.claude/settings.json`,在 env 字段裏寫入下面兩項。注意變量名是 `ANTHROPIC_AUTH_TOKEN`,不是 `ANTHROPIC_API_KEY`:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.apiyi.com",
    "ANTHROPIC_AUTH_TOKEN": "你的 API易 令牌"
  }
}
如果啓動時一直要求登錄官網,可以在 `~/.claude.json` 里加上 `”hasCompletedOnboarding”: true`。
做完你會看到:Claude Code 正常回答問題。同時,API易 控制檯裏這把令牌出現了用量記錄,這說明請求確實是通過這把令牌發出去的。
第 ③ 步:一句話讓 Claude Code 寫調研員和核查員子代理
子代理就是帶 YAML 頭的 Markdown 文件,不用自己寫,直接讓 Claude 代勞。在 Claude Code 裏把下面這段話發給它:
請在當前項目的 .claude/agents/ 下創建兩個子代理:
1. researcher(調研員):模型 claude-sonnet-5-5。只用 WebFetch 讀任務清單裏給的鏈接,
   每條結論附來源鏈接和原文摘錄,把結果寫到「原始資料」文件夾。不給 Agent 工具。
2. fact-checker(覈查員):模型 claude-haiku-5-5。只給 Read、Grep、Glob,
   不給 Write、Edit、Agent。它只接收“結論 + 原文摘錄 + 來源文件路徑”,
   不看調研員的推理過程,只輸出「通過」或「打回 + 理由」,不得自己修改任何內容。
主會話本身用 claude-opus-5-5,負責拆題、分派任務和彙總結果。可以在啓動後用 /model 切換,也可以在第 ② 步的工具裏直接設置。
可選:查看兩個子代理文件長什麼樣
`.claude/agents/researcher.md`:
---
name: researcher
description: 按任務清單讀取給定鏈接,產出帶來源和原文摘錄的調研結論
tools: Read, Grep, Glob, WebFetch, Write
model: claude-sonnet-5-5
maxTurns: 20
---
你是調研員。只讀取任務裏給出的鏈接。每條結論格式:
結論 / 來源鏈接 / 原文摘錄(原樣引用)。寫入「原始資料」文件夾,不碰其他目錄。
`.claude/agents/fact-checker.md`:
---
name: fact-checker
description: 逐條覈對結論是否被原文摘錄支持,只判定不修改
tools: Read, Grep, Glob
model: claude-haiku-5-5
maxTurns: 8
---
你是覈查員。只看結論和原文,不接受任何推理說明。
每條輸出「通過」或「打回:理由」。摘錄不支持、數字對不上、來源缺失一律打回。
你沒有寫權限,也不得建議替換措辭以外的任何修改。
注意:第一次新建 .claude/agents/ 目錄後,需要退出並重新打開一次 Claude Code 會話,之後再修改子代理文件,幾秒內就會自動生效。沒有給 Agent 工具的子代理不能再往下派子代理,這樣可以避免層層套娃導致失控。
做完你會看到:輸入 /agents,列表裏出現 researcher 和 fact-checker,各自顯示對應的模型。
第 ④ 步:寫任務清單,一句話派發並行調研
在 Obsidian 的「任務清單」文件夾裏新建 第一批.md。下面以調研 5 個產品爲例,每條都直接給出要讀的鏈接。這樣做的原因是:經第三方網關調用時,WebSearch 是否可用官方文檔沒有寫明,直接給鏈接讓子代理用 WebFetch 讀取最穩妥。
# 第一批:5 個產品定價與功能
1. 產品 A:定價頁 https://example-a.com/pricing ,功能頁 https://example-a.com/features
2. 產品 B:https://example-b.com/pricing
3. 產品 C:https://example-c.com/docs/plans
4. 產品 D:https://example-d.com/pricing
5. 產品 E:https://example-e.com/changelog
每條要回答:最低付費檔價格、是否有免費版、最近一次功能更新。
回到 Claude Code,發送這句話:
讀取 任務清單/第一批.md,把 5 條任務分給 researcher 子代理並行調研,
各自寫入「原始資料」。全部完成後告訴我每條的結論數量。
這裏的 5 個產品只是示例。換成競品監控、論文要點、行業新聞,做法完全一樣:每條任務給出鏈接,再寫清楚要回答哪幾個問題即可。
做完你會看到:Obsidian 的「原始資料」裏陸續出現 5 個文件,每個文件裏是“結論 / 來源鏈接 / 原文摘錄”的條目。
第 ⑤ 步:設置覈查循環,打回最多 3 輪
繼續對主會話說:
對「原始資料」裏的每條結論,只把“結論 + 原文摘錄 + 來源路徑”交給 fact-checker。
通過的,由你寫入「調研筆記」,頂部屬性填 status: 已覈查、來源、覈查模型: claude-haiku-5-5、日期。
打回的,把理由交給 researcher 重寫後再覈查,最多 3 輪;
3 輪仍不過的,寫入「打回記錄」並附理由,不要放進調研筆記。
這就是官方所說的“鏈式子代理”:先讓 A 子代理做完,再把結果交給 B 子代理。主會話在這裏充當調度員,嚴格控制覈查員能看到的內容,只給結論和原文,不給推理過程。
做完你會看到:「調研筆記」裏出現已覈查的結論,「打回記錄」裏可能會有幾條附帶理由的條目。有打回記錄是正常的,說明覈查員在起作用。
第 ⑥ 步:在 Obsidian 裏驗收已覈查結論
打開任意一篇調研筆記,頂部屬性應該類似這樣:
---
status: 已覈查
來源: https://example-a.com/pricing
覈查模型: claude-haiku-5-5
日期: 2026-10-21
---
在 Obsidian 搜索框輸入 [status:已覈查],就能篩選出所有通過覈查的筆記。驗收時建議隨機抽兩三條,點開來源鏈接,親自核對一下原文。
做完你會看到:篩選結果中的每條結論都能追溯到原文,可疑內容都集中在「打回記錄」裏,等你人工判斷。
調研蜂羣三種模型分工與價格
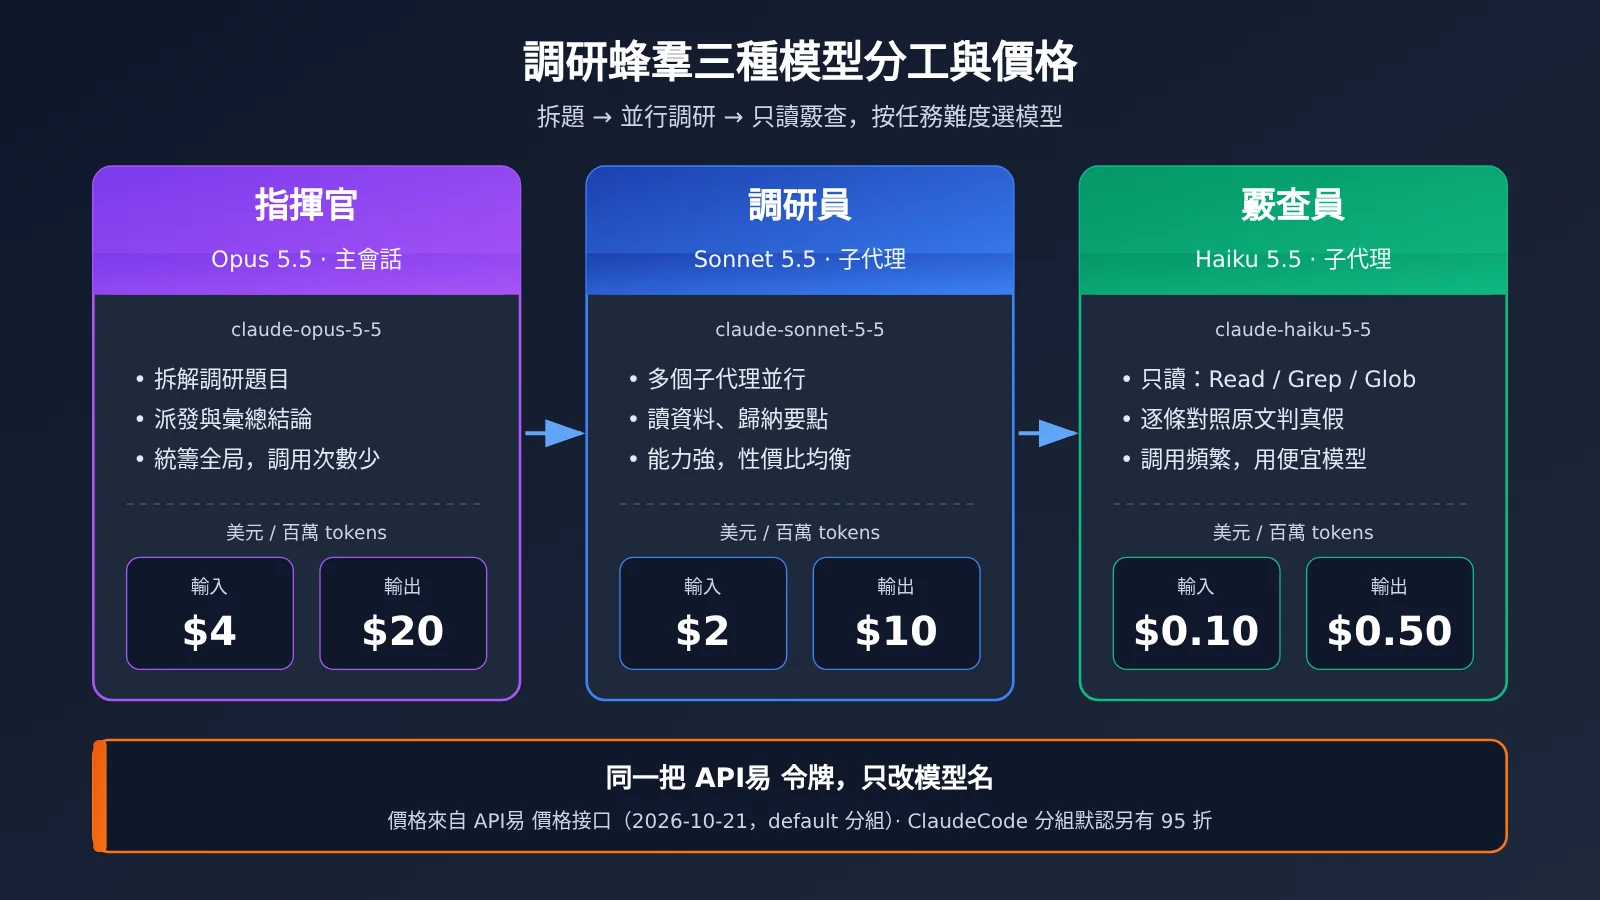
三個角色使用同一把 API易 令牌,區別只在模型名。下表價格來自 API易 2026-10-21 的價格接口(default 分組),ClaudeCode 分組默認還有 95 折。
| 角色 | 模型名 | 輸入(美元/百萬 tokens) | 輸出(美元/百萬 tokens) | 爲什麼這麼選 |
|---|---|---|---|---|
| 主會話:拆題、彙總 | claude-opus-5-5 |
4 | 20 | 需要統籌全局,調用次數少 |
| 調研員:並行讀資料 | claude-sonnet-5-5 |
2 | 10 | 讀取和歸納能力強,性價比均衡 |
| 覈查員:逐條判真假 | claude-haiku-5-5 |
0.10 | 0.50 | 任務簡單、調用頻繁,用便宜模型 |
關於成本,需要說清楚幾件事。子代理越多,每個子代理返回的結果越長,主會話的上下文就佔用得越多,每個子代理運行時也會單獨消耗 token。
調研蜂羣常見問題排錯表
| 現象 | 常見原因 | 處理辦法 |
|---|---|---|
| 子代理沒被調用 | 第一次新建 agents 目錄後沒有重開會話;description 寫得太模糊 | 退出後重新打開 Claude Code;派發時直接點名“用 researcher 子代理” |
| 覈查員自己動手改了內容 | tools 裏混進了 Write / Edit,或者繼承了全部工具 | 打開 fact-checker.md,確認 tools 只有 Read、Grep、Glob |
| 寫進了 .obsidian 文件夾 | CLAUDE.md 沒放在庫根目錄,或者規則沒寫清楚 | 把 CLAUDE.md 移到根目錄,補上“絕不讀寫 .obsidian” |
| 報 401 | 令牌填錯、不是 ClaudeCode 分組,或者用了 API_KEY 變量 | 重新複製令牌,確認分組,變量名改爲 AUTH_TOKEN |
| 請求地址報錯 | 地址末尾多了 /v1 |
改成 https://api.apiyi.com |
| WebSearch 不可用 | 經第三方網關時官方未說明是否支持;或者 200 次會話上限用完了 | 任務清單裏直接給鏈接,改用 WebFetch;用 /clear 開新對話 |
| Obsidian 裏看不到新筆記 | Claude Code 寫到了別的目錄;打開的不是同一個庫 | 在 Claude Code 裏問“你剛寫到了哪個絕對路徑”,和庫路徑對照 |
如果不確定當前會話裏有哪些工具可用,直接問 Claude“你現在有哪些工具”,它會列出來。
什麼時候不該用 Obsidian 加 Claude Code 搭調研蜂羣
這套搭法有固定開銷,不是所有場景都適合。遇到下面幾種情況,直接和 Claude 單聊會更省事:
- 只查一兩條信息:拆題、派發、覈查的流程開銷比調研本身還大。
- 資料都在一篇文章裏:讓 Claude 直接讀完再總結即可,不需要並行。
- 需要實時數據:比如股價、實時匯率,這類數據更適合調用專門的數據接口,讀網頁容易拿到過期內容。
- 預算很緊:多個子代理會成倍消耗 token,先用單會話把需求跑通更划算。
Obsidian 加 Claude Code 調研蜂羣速查表
把這張表保存下來,以後每次開新一批調研時對照着用。
| 項目 | 值或做法 |
|---|---|
| 庫結構 | 任務清單 / 原始資料 / 調研筆記 / 打回記錄 + 根目錄 CLAUDE.md |
| 接口地址 | https://api.apiyi.com(不加 /v1) |
| 令牌 | API易 ClaudeCode 分組,三種模型共用一把 |
| 模型分工 | 主會話 opus-5-5 / 調研 sonnet-5-5 / 覈查 haiku-5-5 |
| 覈查員工具 | 只有 Read、Grep、Glob,沒有 Write、Edit、Agent |
| 覈查規則 | 只看結論和原文,只輸出通過或打回,最多 3 輪 |
| 聯網 | 任務清單裏給鏈接,用 WebFetch;WebSearch 每會話 200 次共用 |
| 篩選 | Obsidian 搜索 [status:已覈查] |
| 控成本 | 先試跑 3 條,再到 API易 控制檯查看令牌用量 |
常見問題
Q1: 什麼是“調研蜂羣”?
調研蜂羣就是讓多個 AI 子代理同時分頭查資料,再由另一個模型逐條覈查的工作方式。本文的版本是一個主會話加 2~3 個調研員和 1 個核查員,規模雖小,但“幹活和判真假分離”的思路是完整的。
Q2: 網傳 300 個 Claude Code 零錯誤是真的嗎?
無法覈實。開發者身份、300 併發、100 毫秒、零錯誤都只有帖子本身的說法,各個轉述版本的數字也不一致。本文只借用它“貴模型幹活、便宜模型覈查”的思路。
Q3: 帖子裏的 –command-center 指揮官模式怎麼開?
開不了。Claude Code 官方 CLI 參考裏沒有這個參數,REA、JEV 也不是官方功能。想並行就用官方的子代理;需要長時間運行時,官方建議改用 background agents(`claude agents`)。
Q4: 必須裝 Obsidian 插件或 MCP 嗎?
入門階段不需要。第三方在 560 篇筆記的小庫上做過單次測試,什麼都不裝的 Claude Code 也全部答對,而且 token 用量最少。庫規模更大時表現如何,目前還沒有數據。
Q5: 三種模型要分別申請令牌嗎?
不用。在 API易 apiyi.com 創建一把 ClaudeCode 分組的令牌,主會話和兩個子代理都用它,只需要在各自配置裏寫不同的模型名。
Q6: 怎麼知道這次調研花了多少錢?
登錄 API易 控制檯,查看這把令牌的用量和日誌即可。建議先跑 3 條小任務,看清實際消耗後再擴大批次。
Q7: 加了覈查員就能保證零錯誤嗎?
不能。覈查員只能判斷結論和摘錄是否一致,原文本身有錯、或者摘錄選取有偏差時,它不一定能發現。所以第 ⑥ 步建議人工抽查幾條,並定期看一下打回記錄。
調研蜂羣核心要點
- 思路比數量重要:貴模型幹活、便宜模型判真假,代理多少不是關鍵。
- 庫就是文件夾:Claude Code 直接讀寫 Markdown,入門不需要插件。
- 覈查員必須只讀:不給 Write、Edit、Agent,只輸出通過或打回。
- 隔離推理過程:覈查員只看結論和原文,避免被調研員帶偏。
- 給鏈接用 WebFetch:避開 WebSearch 上限,也不用擔心網關是否支持。
- 3 輪不過就交給人:寫進打回記錄,不要硬塞進庫裏。
- 成本先試跑再看:同一把 API易 令牌,到控制檯查看實際用量。
總結
用 Obsidian 加 Claude Code 搭調研蜂羣,核心有三點:
- 結構清晰:4 個文件夾加一份 CLAUDE.md,規定好誰能寫哪裏。
- 職責分離:Sonnet 調研、Haiku 覈查、Opus 統籌,覈查員沒有寫權限。
- 閉環入庫:通過才進調研筆記,不通過就打回重做,3 輪不過交給人工。
建議先拿 3 條小任務把整個流程跑通,確認文件落點、覈查效果和費用都符合預期,再把示例替換成你自己的競品監控、論文或行業新聞。模型接入可以直接使用 API易 apiyi.com 的 ClaudeCode 分組令牌,三種模型共用一把,切換起來比較方便。
📚 參考資料
- Claude Code 子代理文檔:子代理的創建、工具權限、模型字段與並行調研
- 鏈接:
code.claude.com/docs/en/sub-agents -
說明:本文子代理配置的主要依據
-
Claude Code 工具參考:WebSearch、WebFetch 的行爲與次數上限
- 鏈接:
code.claude.com/docs/en/tools-reference -
說明:解釋爲什麼建議在任務清單裏直接給鏈接
-
Claude Code 模型配置:模型別名與完整模型名
- 鏈接:
code.claude.com/docs/en/model-config -
說明:確認 opus、sonnet、haiku 對應的版本
-
Obsidian 幫助文檔:庫與文件存儲方式
- 鏈接:
obsidian.md/help -
說明:確認庫就是普通文件夾,外部改動會自動刷新
-
第三方實測:Obsidian AI 工具對比(560 篇小庫,單次測試)
- 鏈接:
agentskillshub.top/best/obsidian-second-brain/ -
說明:入門不裝插件的參考依據
-
API易 Claude Code 接入文檔
- 鏈接:
docs.apiyi.com/scenarios/programming/claude-code - 說明:ClaudeCode 分組、地址與環境變量說明
作者:APIYI 技術團隊
技術交流:搭建過程中遇到問題,歡迎在評論區留言,更多接入說明可查閱 API易 docs.apiyi.com 文檔中心