Em 20 de outubro de 2026, um dos setores de disponibilidade do Google Cloud em Londres ficou sem energia por quase 8 horas. Cinco dias antes, o DeepSeek também ficou fora do ar durante boa parte da manhã. Muitos desenvolvedores estão se perguntando se seus próprios aplicativos de IA podem parar de funcionar na próxima vez.
Os serviços dos quais você depende podem cair a qualquer momento. Quem só usa APIs de modelos não precisa montar um data center, mas não pode deixar todo o negócio nas mãos de um único modelo.
O que você vai aprender: Ao terminar este artigo, você vai saber quais situações exigem ação, quais não exigem e como preparar uma alternativa para seus modelos.
O que cada uma das duas interrupções afetou nesta semana
Vamos começar pelo Google Cloud. De 20 de outubro de 2026, às 14h08, até as 22h, no horário de Pequim, a zona de disponibilidade europe-west2-b, em Londres, ficou fora do ar por causa de um problema no fornecimento de energia. Foram 7 horas e 52 minutos de interrupção. Os serviços afetados foram computação, armazenamento, bancos de dados e rede implantados nessa zona. Quem apenas chama remotamente uma API de modelo não foi afetado diretamente. Mas, se o seu serviço estava justamente nessa zona, naquela tarde tarefas em segundo plano, conexões com o banco de dados e interfaces externas ficaram paradas, sem que ninguém pudesse adiantar o trabalho por elas.
Agora, a DeepSeek. A partir de 15 de outubro de 2026, às 8h11, no horário de Pequim, houve interrupções parciais no site, nas conversas e nas APIs do V4 Pro e do V4.1 Flash. A página oficial de status registrou uma duração de 4 horas e 52 minutos; o serviço foi restabelecido às 13h04 do mesmo dia. Caixin e South China Morning Post falaram em “quase 5 horas”; essa é a descrição da imprensa. A duração considerada aqui segue o registro oficial. Mais tarde, a DeepSeek devolveu como créditos o valor consumido entre 8 e 14 de outubro. A empresa não divulgou a causa, então não vamos especular. Para os usuários, naquele período da manhã, poder ou não usar o serviço dependia de ter uma segunda opção — não da causa da interrupção.
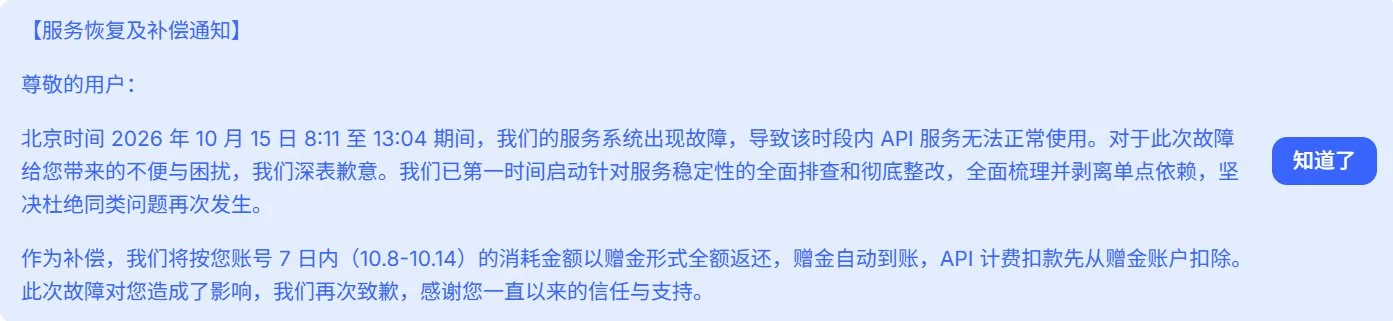
Imagem: aviso de restabelecimento do serviço e compensação enviado pela DeepSeek aos usuários. O serviço de API ficou indisponível das 8h11 às 13h04, no horário de Pequim, em 15 de outubro. O valor total consumido por cada conta entre 8 e 14 de outubro será devolvido em créditos bônus, creditados automaticamente. As cobranças da API serão descontadas primeiro do saldo de créditos bônus.
As duas interrupções doeram pelo mesmo motivo: o modelo é uma etapa do fluxo de trabalho do dia a dia. Quando a API cai, tarefas como escrever código, pesquisar informações e executar processamento em lote também param. Quando o serviço upstream volta, meio dia já se foi. A devolução de créditos compensa a fatura, mas não recupera o trabalho que ficou parado. Se uma equipe precisava entregar um lote de traduções, executar uma rodada de avaliação ou preparar um lançamento naquele dia, nada disso se conclui sozinho por causa da compensação posterior. O trabalho apenas fica para depois e ainda ocupa espaço no cronograma do dia seguinte.
| Item | Situação confirmada do incidente no Google Cloud |
|---|---|
| ID do incidente | Xs2XTHzAVC9YnafnPyzj |
| Escopo do impacto | Zona de disponibilidade europe-west2-b, na região europe-west2 |
| Causa | Problema no fornecimento de energia; a empresa não divulgou mais detalhes |
| Início | 20/10/2026, às 14h08, no horário de Pequim |
| Fim | 20/10/2026, às 22h, no horário de Pequim; duração de 7 horas e 52 minutos |
| Não afetado | Looker Studio |
Qual é a diferença entre zona de disponibilidade e região?
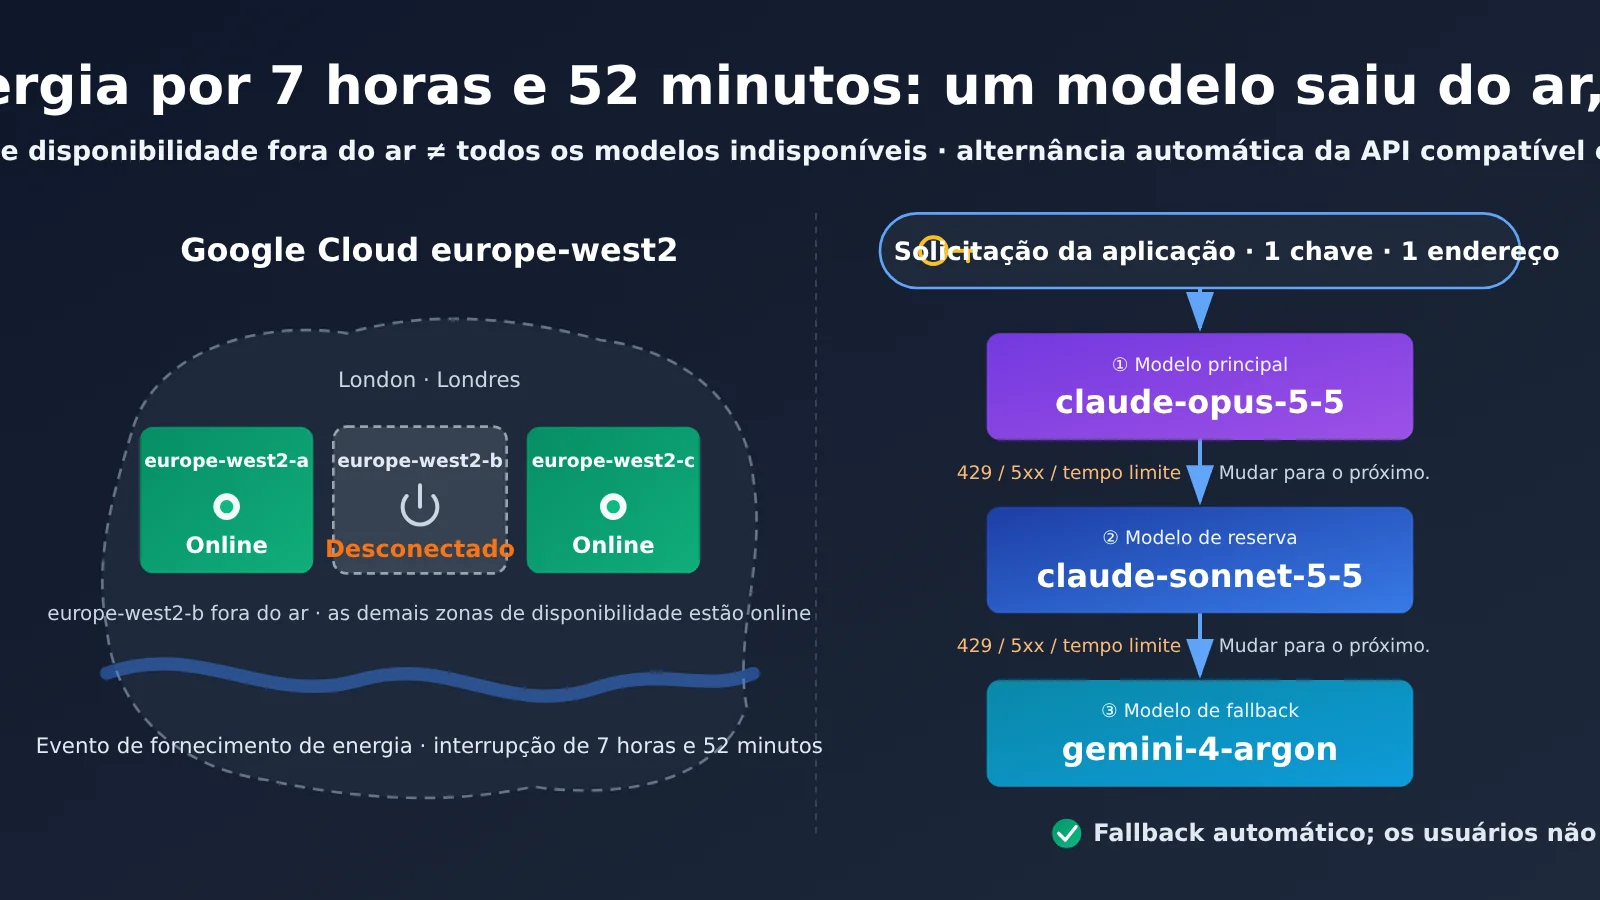
Quando muita gente ouve “Londres ficou sem energia”, a primeira reação é pensar que todo o Google Cloud em Londres caiu. Não foi o caso. Uma região (europe-west2) pode ser entendida como um conjunto de data centers do Google em Londres. As zonas de disponibilidade (europe-west2-a, b e c) são prédios separados dentro desse conjunto. Cada uma foi projetada para ter fornecimento de energia e rede próprios, de modo que as outras possam continuar funcionando se uma delas tiver um problema. Desta vez, uma das três zonas ficou sem energia; as outras duas continuaram operando normalmente.
Por isso, quem realmente foi afetado foram as equipes que mantinham os serviços apenas na zona b. As equipes que já distribuíam seus serviços pelas zonas a e c podiam redirecionar o tráfego para as zonas que continuavam funcionando, reduzindo bastante o impacto. Quem apenas chama remotamente uma API de modelo quase não sentiu essa interrupção no fornecimento de energia.
Comparando as duas interrupções
| Comparação | Google Cloud em Londres | DeepSeek |
|---|---|---|
| Horário (horário de Pequim) | 20/10/2026, das 14h08 às 22h | 15/10/2026, das 8h11 às 13h04 |
| Duração | 7 horas e 52 minutos | 4 horas e 52 minutos |
| O que foi afetado | Computação, armazenamento, bancos de dados e rede na zona europe-west2-b | Site, conversas e APIs do V4 Pro e do V4.1 Flash |
| Causa | Problema no fornecimento de energia; sem mais detalhes | Não divulgada oficialmente |
| Medida posterior | A recomendação oficial foi migrar para outra zona ou região, se possível | O consumo entre 8 e 14 de outubro foi devolvido em créditos |
| Quem só chama APIs de modelos | Não foi afetado diretamente | Foi diretamente afetado; sem uma opção de reserva, só restava esperar |
A comparação deixa clara a diferença: no incidente do Google Cloud, o problema foi para quem mantinha suas máquinas na zona b; a solução é implantar os serviços em várias zonas. No incidente da DeepSeek, o problema foi para quem dependia de um único provedor de modelos; a solução é preparar um modelo alternativo com antecedência. O primeiro caso é uma questão de data center; o segundo, de chamadas de API. A seguir, vamos falar do segundo.
Lições que podemos tirar desta falha
Um provedor pode ficar fora do ar. Por isso, é importante ter uma segunda e até uma terceira opção com antecedência — de preferência, de empresas diferentes. Trocar por um plano mais barato do mesmo provedor não é uma alternativa de verdade. Se o provedor inteiro tiver um problema, os dois planos podem cair juntos.
Também importa saber quando fazer a troca: só passe para outro modelo em caso de erros 429, 500, 502, 503, 504 ou de timeout. Esses erros indicam que o provedor pode estar temporariamente sobrecarregado; tentar outro modelo pode funcionar. Não faça a troca em caso de erros 401 ou 403, nem quando houver uma recusa por segurança de conteúdo. Nesses casos, o problema está na chave API ou no próprio conteúdo, e trocar por dez modelos não vai resolver. Outro ponto importante: se o banco de dados e o armazenamento que você hospeda estiverem em uma zona de disponibilidade fora do ar, trocar de modelo não adianta. Nesse caso, é preciso avaliar a implantação em várias zonas. A contingência de modelos e a recuperação de desastres do data center são coisas diferentes; não misture as duas.
Depois de configurar a alternativa, não a desative quando a falha terminar. Ela não gera chamadas extras no dia a dia: se o modelo principal funcionar, a opção de reserva nem será usada. Mas, quando surgir outro problema, ela entra em ação automaticamente, sem que alguém precise acordar no meio da noite para alterar o código. Antes de implementar a lógica, envie uma solicitação simples a cada modelo para confirmar que o nome está correto e que ele responde normalmente. Só depois pense em como encadear as opções. As respostas podem variar de um modelo para outro. Se o negócio exige um formato específico, defina-o claramente no comando do sistema para reduzir as diferenças ao trocar de modelo.
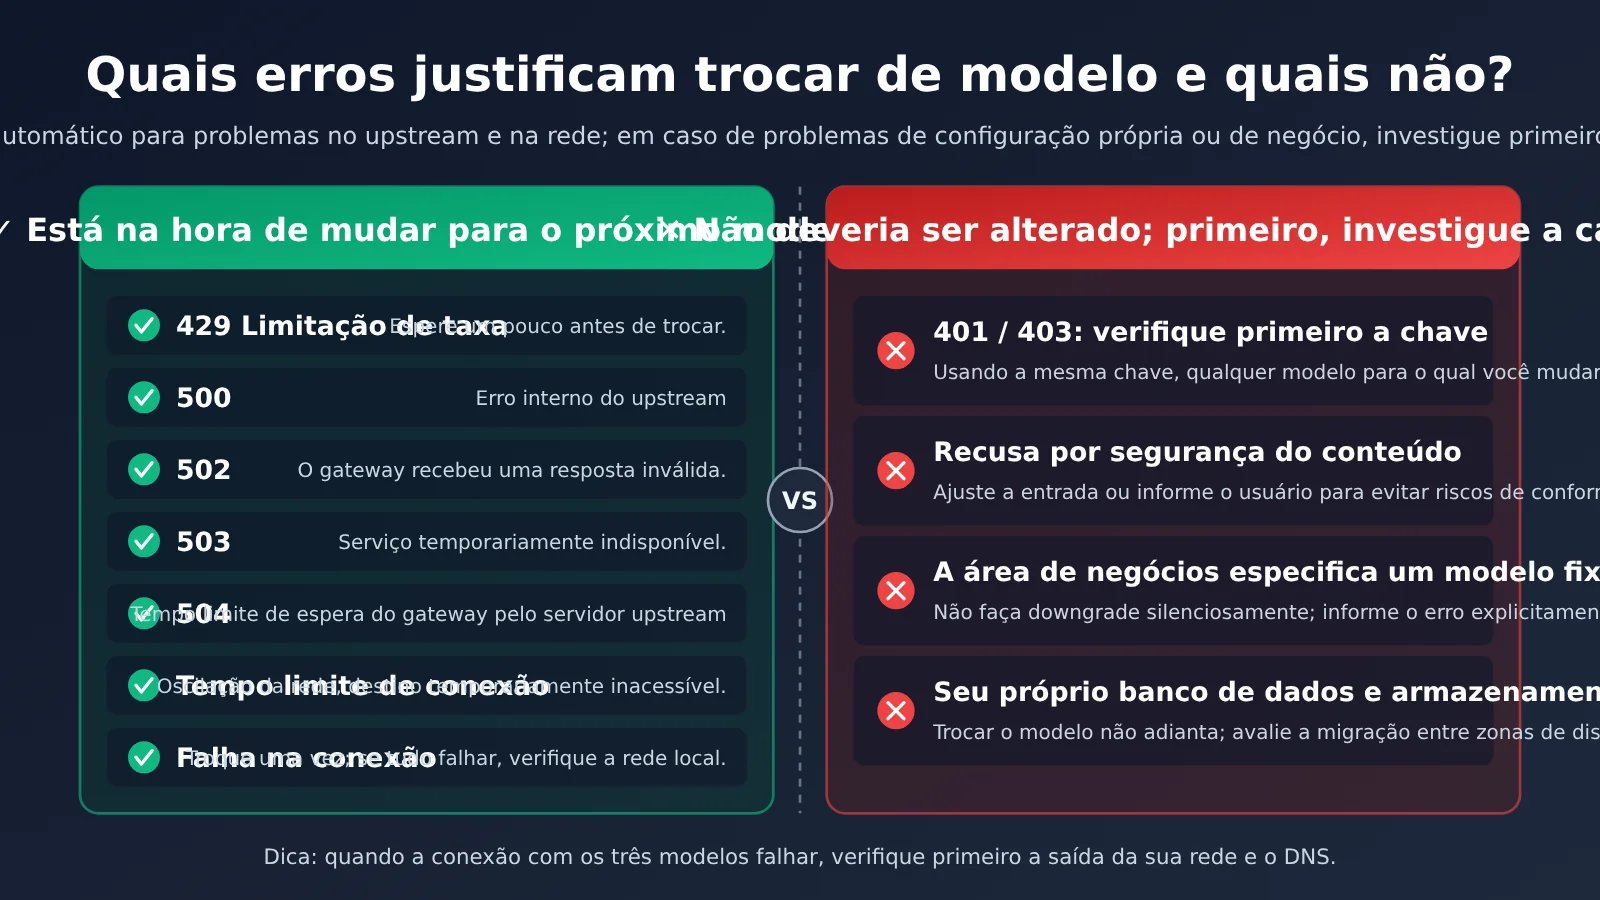
Como definir as configurações da cadeia de contingência
Saber apenas que “se falhar, troque” não basta. Trocar rápido ou devagar demais pode causar problemas. Estas são algumas das dúvidas mais comuns. Não há uma resposta única: adapte as recomendações ao seu negócio.
| Configuração | Recomendação | Por quê |
|---|---|---|
| Quantas vezes tentar novamente o mesmo modelo | No máximo uma vez; se falhar de novo, passe para o próximo | Quando o serviço upstream está com problemas, repetir a chamada ao mesmo modelo muitas vezes só costuma acrescentar mais uma fila |
| Quanto tempo esperar por uma chamada | Menos para conversas; mais para a geração de textos longos | Se a espera for muito longa, o usuário pode fechar a página antes de a troca acontecer |
| O que fazer em caso de erro 429 | Espere um ou dois segundos antes de trocar | Às vezes, a limitação de taxa é apenas um pico momentâneo e passa logo |
| Quanto tempo a cadeia inteira pode levar | A soma das três opções não deve ultrapassar o tempo que o usuário aceita esperar | Evita que a solicitação fique pendurada por muito tempo se as três opções estiverem lentas |
| O que registrar nos logs | Qual opção teve sucesso, qual falhou e qual foi o código do erro em cada tentativa | Depois, fica mais fácil identificar qual provedor está com problemas e decidir se é preciso mudar a ordem |
| Quando avisar alguém | Quando a proporção de uso da opção de reserva aumentar de repente | Quando a contingência funciona, o usuário não percebe — e a equipe também pode não perceber. Alguém precisa saber que o modelo principal está com problemas |
Esse último ponto é o mais fácil de esquecer. Quanto melhor a contingência funciona, mais silencioso fica o problema no modelo principal. Se ninguém olhar os logs, o modelo principal pode ficar fora do ar o dia inteiro sem que ninguém perceba. Enquanto isso, a conta acumula chamadas para os modelos de reserva.
Não é preciso trocar de chave para mudar de modelo
O pior cenário para criar uma contingência é ter que fazer mudanças demais. Se cada modelo exigir uma conta, um endereço e um formato de requisição diferentes, a maioria das equipes vai deixar para agir só depois que o problema acontecer de novo.
A solução da APIYI é usar o mesmo endereço https://api.apiyi.com/v1/chat/completions e a mesma chave, alterando apenas o campo model no corpo da requisição. O modelo principal é o claude-opus-5-5; se falhar, a próxima opção é o claude-sonnet-5-5 e, se ele também falhar, o gemini-4-argon. Os dois primeiros são do mesmo fornecedor, e o terceiro é de outro. Assim, se um fornecedor inteiro tiver problemas, ainda há uma alternativa. A mudança é pequena: basta adicionar ao código da aplicação uma lista de modelos para tentar em ordem. O formato da requisição, a autenticação e a estrutura da resposta continuam iguais, e os testes também são simples.
| Ordem | Nome do modelo | Preço de entrada | Preço de saída | Função |
|---|---|---|---|---|
| 1 | claude-opus-5-5 | 4 | 20 | Modelo principal |
| 2 | claude-sonnet-5-5 | 2 | 10 | Primeiro reserva, opção mais barata do mesmo fornecedor |
| 3 | gemini-4-argon | 2 | 10 | Segundo reserva, de outro fornecedor |
| Opcional | gpt-6-astra | 10 | 50 | Reserva mais cara, disponível apenas pela interface da OpenAI |
| Opcional | deepseek-v4.1-flash | 0.30 | 1.20 | Reserva mais barata |
Os preços da tabela estão em dólares por milhão de tokens. Foram organizados com base na página de preços de 2026-10-21, com multiplicador 1. Os preços podem mudar; consulte a página de preços em api.apiyi.com.
Configure a contingência em três etapas
Etapa 1: obtenha uma chave. Crie uma conta em api.apiyi.com e gere uma chave. O pagamento é por uso, e o serviço pode ser acessado diretamente da China, sem precisar vincular um cartão de crédito internacional. Com essa mesma chave, você pode chamar todos os modelos da tabela.
Etapa 2: teste cada modelo. Configure o endereço da API como https://api.apiyi.com/v1. Ele é compatível com o formato da interface da OpenAI, então, se você já usa a biblioteca oficial da OpenAI, basta trocar o endereço e a chave. Use o mesmo comando e teste o claude-opus-5-5, o claude-sonnet-5-5 e o gemini-4-argon, um por um. Confirme que todos retornam normalmente e que o formato das respostas é o esperado.
Etapa 3: defina a ordem e faça um teste. Adicione os nomes dos três modelos à configuração, na ordem escolhida, e defina quando alternar para o próximo conforme as regras da seção anterior. Depois de configurar, não coloque tudo em produção imediatamente: reduza temporariamente o tempo de espera do modelo principal para forçar um timeout. Verifique se a requisição passou para o segundo modelo e se isso ficou registrado nos logs. Só depois de passar nesse teste a contingência estará realmente pronta. Para consultar os parâmetros, acesse a documentação de integração em docs.apiyi.com.
Como definir a ordem para cada tipo de negócio
A ordem sugerida neste artigo prioriza a qualidade, mas não é a única opção. Dependendo do negócio, outro modelo pode vir primeiro.
| Tipo de negócio | Ordem sugerida | Motivo |
|---|---|---|
| Programação e raciocínio complexo | claude-opus-5-5 → claude-sonnet-5-5 → gemini-4-argon | Prioriza a qualidade; é a ordem padrão deste artigo |
| Atendimento ao cliente e conversas do dia a dia | claude-sonnet-5-5 → gemini-4-argon → deepseek-v4.1-flash | O volume de chamadas é alto e o preço por chamada importa; não é necessário usar o modelo mais caro como principal |
| Tradução em lote e resumos | deepseek-v4.1-flash → gemini-4-argon → claude-sonnet-5-5 | Como são muitas chamadas, a opção mais barata vem primeiro; se falhar, a próxima é uma opção mais robusta |
| Respostas com requisitos rígidos de formato | Primeiro, duas opções do mesmo fornecedor; por último, uma de outro fornecedor | Os modelos do mesmo fornecedor costumam ter estilos mais parecidos, o que reduz a diferença ao alternar |
A ordem deve seguir dois princípios: sempre que possível, escolha um fornecedor diferente para a última opção; e combine o preço por chamada com o valor da tarefa. A linha sobre tradução em lote também mostra bem a vantagem da contingência: se o DeepSeek, que vem primeiro, tivesse falhado em 15 de outubro, as requisições passariam automaticamente para os outros dois fornecedores e a tarefa ainda seria concluída.
Vale deixar claro: mudar de modelo ajuda a manter a etapa de chamada ao modelo funcionando, mas não resolve uma queda de energia no data center.
O provedor pode falhar: deixe outra opção pronta
Um exemplo público foi a interrupção oficial da DeepSeek em 15/10/2026. Na ocasião, a APIYI mudou para o canal da versão completa da Volcano Engine. Não foi preciso alterar o nome do modelo, e o ambiente de produção voltou ao normal. A fonte está nas atualizações em tempo real de docs.apiyi.com.
Falhas nos provedores acontecem, e isso não significa que alguém tenha feito algo errado. Deixar outra opção pronta é mais útil do que esperar horas. Em condições normais, isso quase não custa nada nem exige muito trabalho — basta preparar tudo antes do problema. Se você deixar para depois, vai ter que fazer as mudanças às pressas.
Quando algo der errado, o que verificar primeiro
Se as requisições começarem a falhar em grande escala, não corra para alterar o código. Reserve dois minutos para verificar três lugares: primeiro, o Google Cloud Service Health, para saber se houve um problema no data center; depois, a página de status oficial do fornecedor do modelo — neste caso, a página de status da DeepSeek; por fim, as atualizações em tempo real de docs.apiyi.com, onde a APIYI informa mudanças nas rotas dos provedores.
Se os três lugares indicarem que está tudo normal, volte a investigar o seu lado: a chave expirou? Há saldo suficiente? Há algum problema com a saída de rede ou o DNS? Se você inverter essa ordem, pode passar muito tempo procurando um erro no próprio código e só depois descobrir que o problema era no provedor.
Quatro coisas que você pode fazer hoje
- Liste todos os pontos da aplicação que chamam modelos e identifique quais dependem de um único fornecedor.
- Para cada ponto que dependa de apenas um fornecedor, adicione pelo menos um modelo reserva de outro fornecedor.
- Siga as regras acima: alterne apenas em casos de 429, erros 5xx e timeout, e registre cada mudança nos logs.
- Force um timeout no modelo principal e confirme que a requisição realmente passa para o modelo reserva.
Depois de fazer essas quatro coisas, na próxima falha — seja uma queda de energia no data center ou uma interrupção do fornecedor do modelo — sua aplicação pode ficar alguns segundos mais lenta, mas não vai parar por horas.
Perguntas frequentes
P1: Depois do apagão do Google Cloud em Londres, é preciso migrar tudo para fora de Londres imediatamente?
Não necessariamente. A recomendação oficial diz “se for viável”, não que todos precisem migrar imediatamente. Equipes com cargas de trabalho em europe-west2-b podem avaliar a migração para outra zona ou região. Já as equipes que apenas chamam APIs de modelos não precisam migrar; primeiro, devem configurar uma contingência para os modelos.
P2: Trocar de modelo pode ficar mais caro?
Com a ordem sugerida acima, na verdade, pode sair mais barato. O modelo principal, claude-opus-5-5, custa 4 para entrada e 20 para saída; os dois modelos reserva custam 2 para entrada e 10 para saída. O custo só aumenta se você incluir na lista de reservas um modelo como o gpt-6-astra, que custa 10 para entrada e 50 para saída.
P3: Uma única chave pode chamar modelos desses diferentes fornecedores?
Sim. Todos esses modelos usam o mesmo endereço compatível com a interface da OpenAI e a mesma chave; basta alterar o campo `model`. O gpt-6-astra é uma exceção: só está disponível pela interface da OpenAI. Tenha isso em mente ao usá-lo.
P4: A qualidade das respostas pode cair ao mudar para um modelo reserva?
Pode haver diferenças, especialmente ao passar do modelo mais potente para uma opção mais barata. Mas, para a maioria dos negócios, uma resposta um pouco mais lenta ou de qualidade ligeiramente inferior é melhor do que receber um erro. Em situações com requisitos rígidos de formato, especifique o formato de saída no comando system e compare antecipadamente as respostas de alguns modelos, usando o método da segunda etapa. Assim, você saberá o que esperar antes de colocar tudo em produção.
P5: Se não houver problemas, manter modelos reserva gera custos?
Não. No pagamento por uso, você só paga pelas requisições que realmente envia. Se o modelo principal responder com sucesso, os modelos reserva não serão chamados e não haverá custos. O único investimento é o tempo necessário para configurar tudo e o custo das poucas requisições de teste.
Principais pontos
- Duas interrupções: a queda de energia em europe-west2-b, do Google Cloud, durou 7 horas e 52 minutos; a interrupção registrada pela DeepSeek durou 4 horas e 52 minutos.
- O que os fatos mostram: não houve uma queda em toda a Europa, e os modelos não ficaram indisponíveis por causa disso. A DeepSeek não divulgou a causa da interrupção.
- Quando alternar: alterne apenas em casos de 429, 500, 502, 503, 504 e timeout. Não alterne em casos de 401, 403 ou rejeição por segurança de conteúdo.
- Como fazer: de preferência, escolha um modelo reserva de outro fornecedor. Use o mesmo endereço e a mesma chave; altere apenas o campo
model. - Como validar: depois da configuração, force um timeout no modelo principal e verifique se a requisição passou para o modelo reserva e se a mudança foi registrada nos logs.
Um crédito de compensação pode cobrir a conta, mas não recupera o trabalho parado. Defina a ordem dos modelos com antecedência. Assim, na próxima falha do provedor, os usuários sentirão apenas alguns segundos de lentidão.
Referências
- Google Cloud Service Health: incidente que afetou vários serviços em europe-west2 (Xs2XTHzAVC9YnafnPyzj), 2026-10-20
- Google Cloud Service Health: incidente do produto de segurança Google SecOps em europe-west2 (registro separado), 2026-10-20
- BBC: reportagem sobre os efeitos da falha do Google Cloud em bancos e serviços públicos do Reino Unido, 2026-10-20
- Página oficial de status da DeepSeek: registro da interrupção do serviço em 2026-10-15
- Documentação oficial: atualizações em tempo real de docs.apiyi.com
Autor: equipe técnica da APIYI
Discussão técnica: se você encontrar algum problema ao configurar a contingência dos modelos, deixe um comentário para conversarmos.