Ces derniers jours, un post très consulté a fait le tour de X : un « développeur chinois de 23 ans » aurait lancé 300 instances de Claude Code en parallèle. Chaque réponse était comparée au fichier source en une centaine de millisecondes, et plus de 100 fiches d’entreprise auraient été ajoutées à Obsidian « sans aucune erreur ».
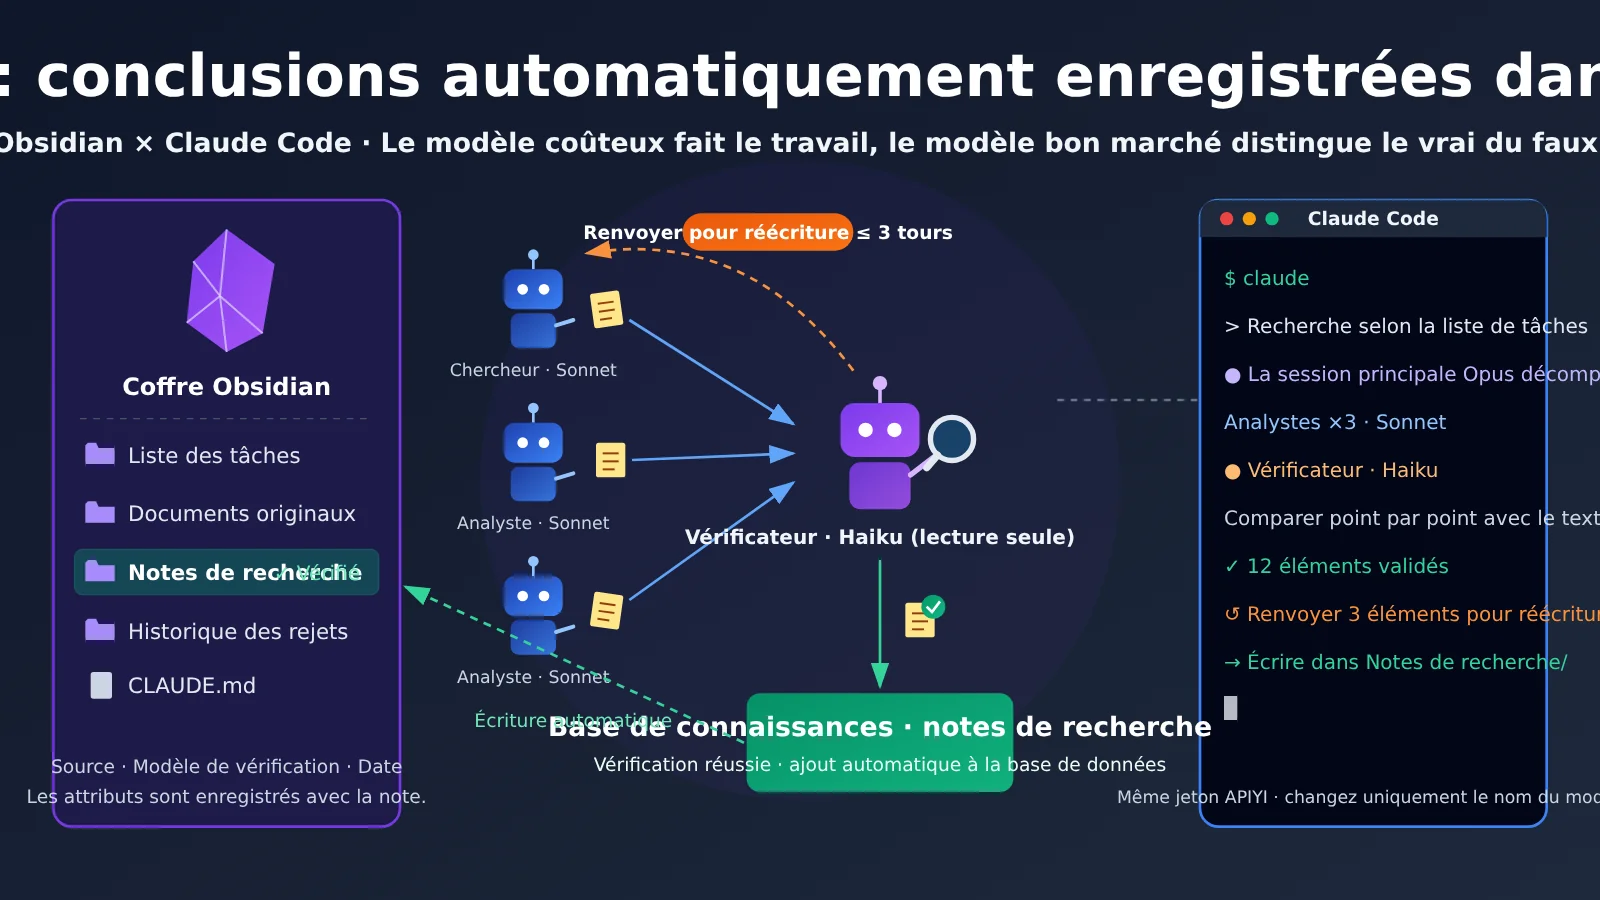
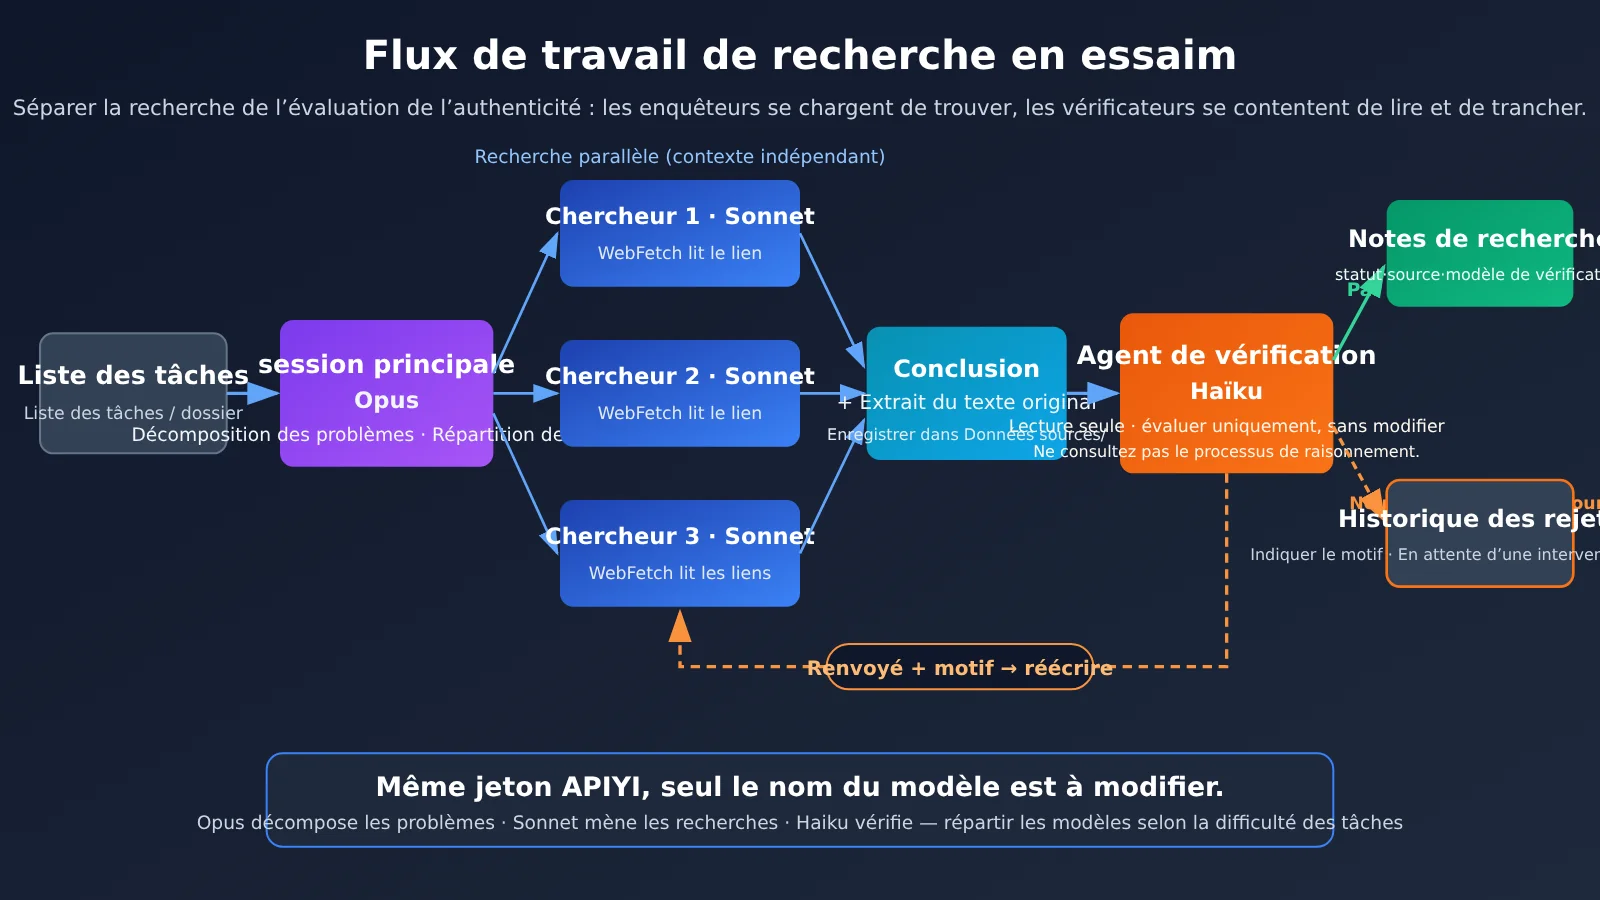
L’idée à retenir : les modèles coûteux font le travail, les modèles moins chers vérifient les résultats ; si une réponse ne passe pas le contrôle, elle est renvoyée pour être retravaillée, et seules les réponses validées sont ajoutées à la base de connaissances.
Voici un tutoriel que vous pouvez suivre pas à pas. Tout se fait principalement dans une interface graphique, en donnant des instructions en langage courant à Claude Code. Pas besoin de savoir coder.
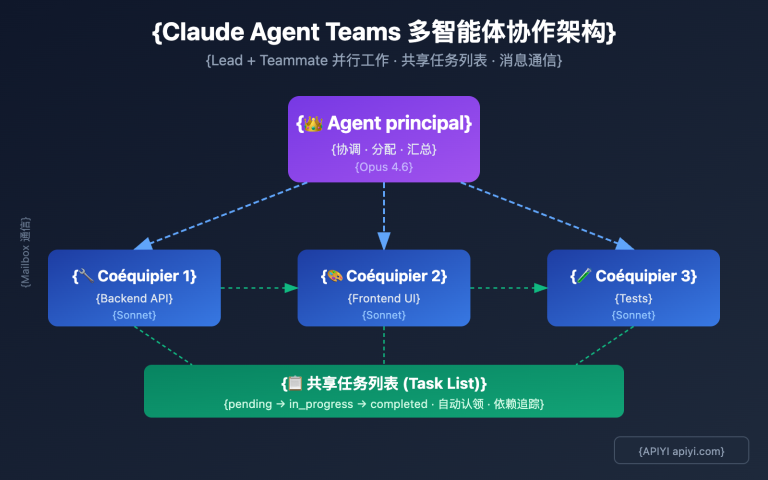
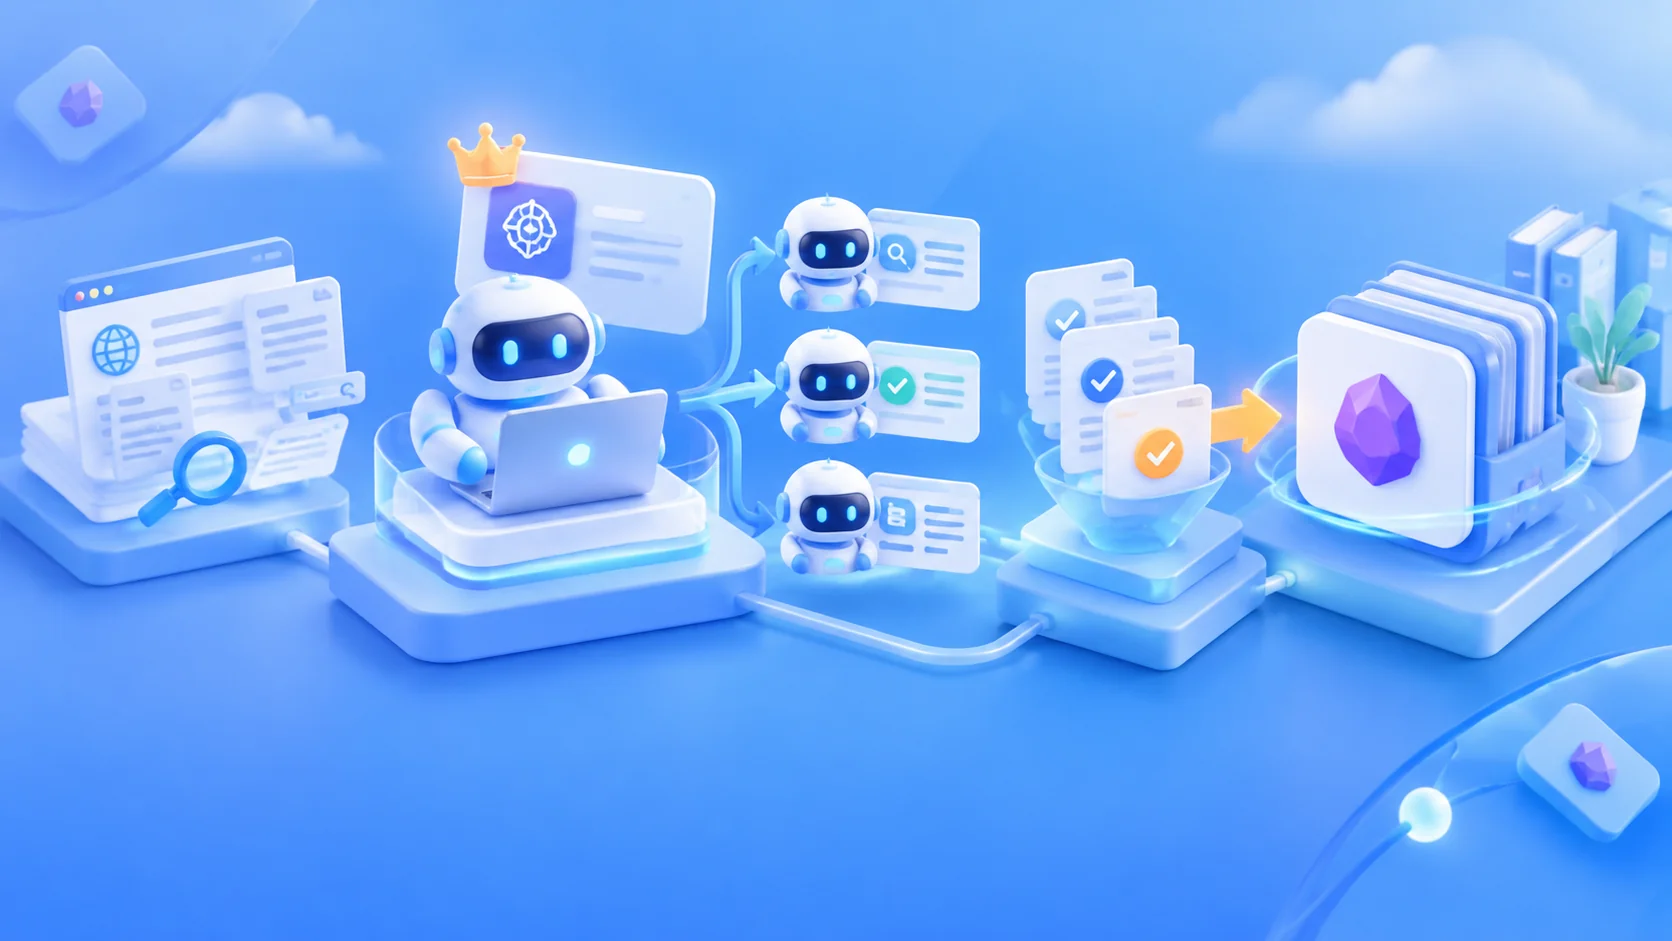
L’intérêt principal : à la fin de cet article, vous aurez installé sur votre ordinateur une petite équipe d’agents de recherche. La session principale découpe le sujet, plusieurs sous-agents de recherche trouvent des informations en parallèle, et un sous-agent de vérification, moins coûteux, examine chaque point à la loupe. Les conclusions validées sont ensuite automatiquement ajoutées à votre coffre Obsidian, avec leurs sources et une mention indiquant qu’elles ont été vérifiées.
Obsidian et Claude Code : mettre en place une équipe d’agents de recherche
Avant de vous lancer, vérifiez que vous remplissez les conditions suivantes.
- Objectif : la session principale (Opus) découpe le sujet et synthétise les résultats. Deux ou trois sous-agents de recherche (Sonnet) consultent les sources en parallèle, tandis qu’un sous-agent de vérification (Haiku) vérifie chaque affirmation. Les conclusions validées sont enregistrées dans le dossier « Notes de recherche » d’Obsidian.
- Durée : prévoyez un après-midi pour la première configuration. Ensuite, il suffira de rédiger une liste de tâches et de donner une consigne pour les lancer.
- Prérequis : Obsidian pour ordinateur et Claude Code installés, un compte APIYI, et une connexion Internet permettant d’accéder aux sources visées.
- Difficulté : débutant. Aucune ligne de code à écrire ; les fichiers de configuration ne figurent que dans des blocs repliables facultatifs.
Voici le plan général, avec un critère de validation pour chaque étape. Une fois une étape terminée, vérifiez le résultat attendu avant de passer à la suivante.
| Étape | À faire | Critère de validation (ce que vous devriez voir) |
|---|---|---|
| ① Créer le coffre | Créer un coffre Obsidian, 4 dossiers et un fichier CLAUDE.md | Les 4 dossiers apparaissent dans la barre latérale d’Obsidian et CLAUDE.md se trouve à la racine |
| ② Configurer le jeton | Configurer le jeton APIYI dans Claude Code | Depuis le dossier du coffre, vous pouvez ouvrir Claude Code et discuter normalement |
| ③ Créer les sous-agents | Demander à Claude de créer un agent de recherche et un agent de vérification | La commande /agents affiche les deux sous-agents |
| ④ Distribuer les tâches | Rédiger une liste de tâches et les lancer en parallèle avec une seule consigne | Un fichier d’extraits pour chaque tâche apparaît dans « Sources brutes » |
| ⑤ Mettre en place la boucle de vérification | Demander des réécritures, jusqu’à 3 cycles maximum | Les conclusions validées arrivent dans « Notes de recherche » et les éléments refusés dans « Historique des refus » |
| ⑥ Valider le résultat | Filtrer les notes vérifiées dans Obsidian | Les propriétés des notes contiennent le statut, les sources, le modèle de vérification et la date |
Points clés de l’étude sur l’essaim d’agents de recherche
| Catégorie | Contenu | Utilisation dans cet article |
|---|---|---|
| Documentation officielle (Claude Code / Obsidian) | Les sous-agents disposent d’un contexte indépendant et peuvent utiliser des outils et des modèles définis ; la recherche en parallèle est explicitement présentée comme un cas d’usage officiel ; WebSearch est limité à 200 appels par session, quota partagé entre tous les sous-agents ; un coffre Obsidian est un simple dossier contenant des fichiers Markdown, et les modifications externes sont automatiquement actualisées | Sert de base à la configuration |
| Test ponctuel par un tiers | Dans un coffre de test de 560 notes avec 15 questions, Claude Code sans aucun plugin a répondu correctement à toutes les questions, avec la consommation de jetons la plus faible | Sert de référence pour montrer qu’on peut débuter sans installer de plugin ; cela ne préjuge pas des résultats sur un grand coffre |
| Informations relayées en ligne | Un développeur de 23 ans, 300 tâches en parallèle, vérification en 100 ms, zéro erreur ; un autre fil très partagé mentionne --command-center, REA et JEV |
On peut s’en inspirer, mais la seconde série de paramètres ne figure pas dans la référence officielle de la CLI : ne la recopiez pas |
Pourquoi répartir l’essaim de recherche entre deux rôles : « chercher » et « vérifier »
Augmenter le nombre d’agents sans ajouter de vérification, c’est aussi augmenter le risque de laisser passer des hallucinations. En confiant la recherche et la vérification à deux modèles différents, le vérificateur n’a qu’une seule question à trancher : cette conclusion est-elle étayée par un extrait du texte source ? Cette tâche étant bien plus simple que la recherche elle-même, un modèle Haiku, moins coûteux, suffit.
Un conseil très utile a aussi été partagé dans les commentaires : le vérificateur ne doit pas voir le raisonnement de l’agent de recherche. Il ne doit consulter que la conclusion et le texte source, sinon il risque d’être influencé par les affirmations de l’agent. De plus, il doit uniquement répondre « validé » ou « refusé », avec une justification, et ne jamais modifier lui-même le contenu. Dès qu’il se met lui aussi à éditer, les rôles du vérificateur et de l’agent de recherche se confondent. La configuration présentée ici respecte ces deux principes.
Pourquoi on peut débuter avec Obsidian sans installer de plugin ni de MCP
Un coffre Obsidian est en réalité un simple dossier. Les outils de lecture et d’écriture intégrés à Claude Code peuvent directement manipuler les fichiers .md qu’il contient, et Obsidian actualise automatiquement leur affichage. Dans le test ponctuel par un tiers mentionné plus haut (un petit coffre de 560 notes, avec une seule exécution par outil), le groupe témoin sans aucun outil supplémentaire a consommé le moins de jetons. Il n’est donc pas nécessaire de s’embêter avec des plugins pour débuter. On ne dispose toutefois pas encore de données sur les performances avec des coffres plus volumineux.
Bien démarrer avec un essaim de recherche associant Obsidian et Claude Code
Étape ① : créer un coffre Obsidian et rédiger le fichier CLAUDE.md
Ouvrez Obsidian, choisissez « Créer un nouveau coffre » (pour créer un coffre vide), nommez-le 调研库 et choisissez un emplacement facile à retrouver, comme le dossier « Documents ». Ne placez pas ce coffre dans un autre coffre : les liens internes risqueraient de ne plus fonctionner.
Dans le panneau des fichiers, faites un clic droit et choisissez « Nouveau dossier ». Créez ces quatre dossiers : 任务清单, 原始资料, 调研笔记 et 打回记录.
Créez ensuite une note à la racine du coffre, nommez-la CLAUDE.md et indiquez-y les règles d’ajout de contenu. Claude Code lira ce fichier à chaque démarrage depuis ce dossier :
# 调研库入库规则
1. 只读写这 4 个文件夹:任务清单、原始资料、调研笔记、打回记录。绝不读写 .obsidian 文件夹。
2. 每条结论必须附来源链接和原文摘录(引号原样摘抄)。
3. 没有通过核查员核查的内容,不得写入「调研笔记」。
4. 打回超过 3 轮仍不通过的,写入「打回记录」并注明理由,等人工处理。
5. 调研笔记顶部写属性:status、来源、核查模型、日期。
Une fois cette étape terminée : le panneau de gauche d’Obsidian affiche les quatre dossiers et le fichier CLAUDE.md. À la racine se trouve aussi un dossier de configuration .obsidian, masqué par défaut par Obsidian. Il contient les paramètres propres à l’application et aucun agent ne doit y toucher.
Étape ② : configurer le jeton APIYI dans Claude Code
Nous ne détaillons pas à nouveau la configuration ici. Suivez le tutoriel Utiliser magpie pour configurer Claude Code, Codex, Pi, Hermes et d’autres outils depuis une interface graphique pour configurer le jeton APIYI dans l’interface graphique, puis revenez ici.
Voici les deux points à retenir :
- Lors de la création du jeton dans la console APIYI, choisissez le groupe ClaudeCode.
- Saisissez
https://api.apiyi.comcomme adresse de l’API, sans ajouter/v1à la fin.
Une fois la configuration terminée, ouvrez un terminal dans le dossier 调研库, saisissez claude pour démarrer Claude Code et posez-lui une question au hasard. S’il répond normalement, la connexion fonctionne.
Facultatif : modifier settings.json manuellement (si vous ne voulez pas utiliser l’interface graphique)
Modifiez `~/.claude/settings.json` et ajoutez ces deux éléments dans le champ env. Attention : le nom de la variable est `ANTHROPIC_AUTH_TOKEN`, et non `ANTHROPIC_API_KEY` :
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.apiyi.com",
    "ANTHROPIC_AUTH_TOKEN": "你的 APIYI 令牌"
  }
}
Si Claude Code vous demande sans cesse de vous connecter au site officiel au démarrage, ajoutez ` »hasCompletedOnboarding »: true` dans `~/.claude.json`.
Une fois cette étape terminée : Claude Code répond normalement à vos questions. Dans la console APIYI, vous devriez aussi voir apparaître une consommation associée à ce jeton, ce qui confirme que les requêtes passent bien par lui.
Étape ③ : demander à Claude Code de créer les sous-agents de recherche et de vérification
Un sous-agent est un fichier Markdown avec un en-tête YAML. Pas besoin de le rédiger vous-même : demandez à Claude de s’en charger. Dans Claude Code, envoyez-lui le texte suivant :
请在当前项目的 .claude/agents/ 下创建两个子代理:
1. researcher(调研员):模型 claude-sonnet-5-5。只用 WebFetch 读任务清单里给的链接,
   每条结论附来源链接和原文摘录,把结果写到「原始资料」文件夹。不给 Agent 工具。
2. fact-checker(核查员):模型 claude-haiku-5-5。只给 Read、Grep、Glob,
   不给 Write、Edit、Agent。它只接收“结论 + 原文摘录 + 来源文件路径”,
   不看调研员的推理过程,只输出「通过」或「打回 + 理由」,不得自己修改任何内容。
La session principale utilise claude-opus-5-5 et se charge de découper les questions, de distribuer les tâches et de regrouper les résultats. Vous pouvez changer de modèle après le démarrage avec /model, ou le définir directement dans l’outil utilisé à l’étape ②.
Facultatif : voir à quoi ressemblent les fichiers des deux sous-agents
`.claude/agents/researcher.md` :
---
name: researcher
description: 按任务清单读取给定链接,产出带来源和原文摘录的调研结论
tools: Read, Grep, Glob, WebFetch, Write
model: claude-sonnet-5-5
maxTurns: 20
---
你是调研员。只读取任务里给出的链接。每条结论格式:
结论 / 来源链接 / 原文摘录(原样引用)。写入「原始资料」文件夹,不碰其他目录。
`.claude/agents/fact-checker.md` :
---
name: fact-checker
description: 逐条核对结论是否被原文摘录支持,只判定不修改
tools: Read, Grep, Glob
model: claude-haiku-5-5
maxTurns: 8
---
你是核查员。只看结论和原文,不接受任何推理说明。
每条输出「通过」或「打回:理由」。摘录不支持、数字对不上、来源缺失一律打回。
你没有写权限,也不得建议替换措辞以外的任何修改。
À noter : après avoir créé le dossier .claude/agents/ pour la première fois, vous devez quitter Claude Code et relancer une session. Par la suite, les modifications apportées aux fichiers des sous-agents sont prises en compte automatiquement en quelques secondes. Un sous-agent qui ne dispose pas de l’outil Agent ne peut pas en déléguer à son tour : cela évite les chaînes de sous-agents incontrôlables.
Une fois cette étape terminée : saisissez /agents. La liste doit afficher researcher et fact-checker, chacun avec le modèle correspondant.
Étape ④ : rédiger une liste de tâches et lancer la recherche en parallèle en une phrase
Dans le dossier « 任务清单 » d’Obsidian, créez le fichier 第一批.md. Voici un exemple de recherche sur cinq produits, avec les liens à consulter pour chacun. En effet, la documentation officielle ne précise pas si WebSearch est disponible lors d’un appel via une passerelle tierce. Le plus sûr est donc de fournir directement les liens pour que les sous-agents les consultent avec WebFetch.
# 第一批:5 个产品定价与功能
1. 产品 A:定价页 https://example-a.com/pricing ,功能页 https://example-a.com/features
2. 产品 B:https://example-b.com/pricing
3. 产品 C:https://example-c.com/docs/plans
4. 产品 D:https://example-d.com/pricing
5. 产品 E:https://example-e.com/changelog
每条要回答:最低付费档价格、是否有免费版、最近一次功能更新。
Retournez dans Claude Code et envoyez-lui cette instruction :
读取 任务清单/第一批.md,把 5 条任务分给 researcher 子代理并行调研,
各自写入「原始资料」。全部完成后告诉我每条的结论数量。
Les cinq produits ne sont qu’un exemple. La méthode est la même pour surveiller des concurrents, résumer des articles scientifiques ou suivre l’actualité d’un secteur : indiquez un lien pour chaque tâche et précisez les questions auxquelles il faut répondre.
Une fois cette étape terminée : cinq fichiers apparaissent progressivement dans « 原始资料 » d’Obsidian, chacun contenant des éléments au format « conclusion / lien source / extrait du texte original ».
Étape ⑤ : configurer la boucle de vérification, avec un maximum de trois refus
Envoyez ensuite cette instruction à la session principale :
对「原始资料」里的每条结论,只把“结论 + 原文摘录 + 来源路径”交给 fact-checker。
通过的,由你写入「调研笔记」,顶部属性填 status: 已核查、来源、核查模型: claude-haiku-5-5、日期。
打回的,把理由交给 researcher 重写后再核查,最多 3 轮;
3 轮仍不过的,写入「打回记录」并附理由,不要放进调研笔记。
C’est ce que la documentation officielle appelle des « sous-agents en chaîne » : on demande d’abord à un sous-agent A de terminer sa tâche, puis on transmet le résultat à un sous-agent B. La session principale joue ici le rôle de coordinateur. Elle contrôle strictement les informations visibles par le vérificateur et ne lui transmet que la conclusion et le texte source, sans le raisonnement.
Une fois cette étape terminée : les conclusions vérifiées apparaissent dans « 调研笔记 ». Il peut aussi y avoir quelques entrées accompagnées de leur justification dans « 打回记录 ». C’est normal : cela signifie que le vérificateur fait son travail.
Étape ⑥ : valider les conclusions vérifiées dans Obsidian
Ouvrez une note de recherche au hasard. Les propriétés en haut de la note devraient ressembler à ceci :
---
status: 已核查
来源: https://example-a.com/pricing
核查模型: claude-haiku-5-5
日期: 2026-10-21
---
Saisissez [status:已核查] dans la barre de recherche d’Obsidian pour filtrer toutes les notes vérifiées. Pour la validation, nous vous conseillons d’en choisir deux ou trois au hasard et de consulter les liens sources afin de vérifier vous-même les textes d’origine.
Une fois cette étape terminée : chaque conclusion des résultats filtrés peut être retracée jusqu’à son texte source. Les éléments douteux sont regroupés dans « 打回记录 », où vous pourrez les examiner vous-même.
Répartition des rôles et tarifs des trois modèles de la ruche de recherche
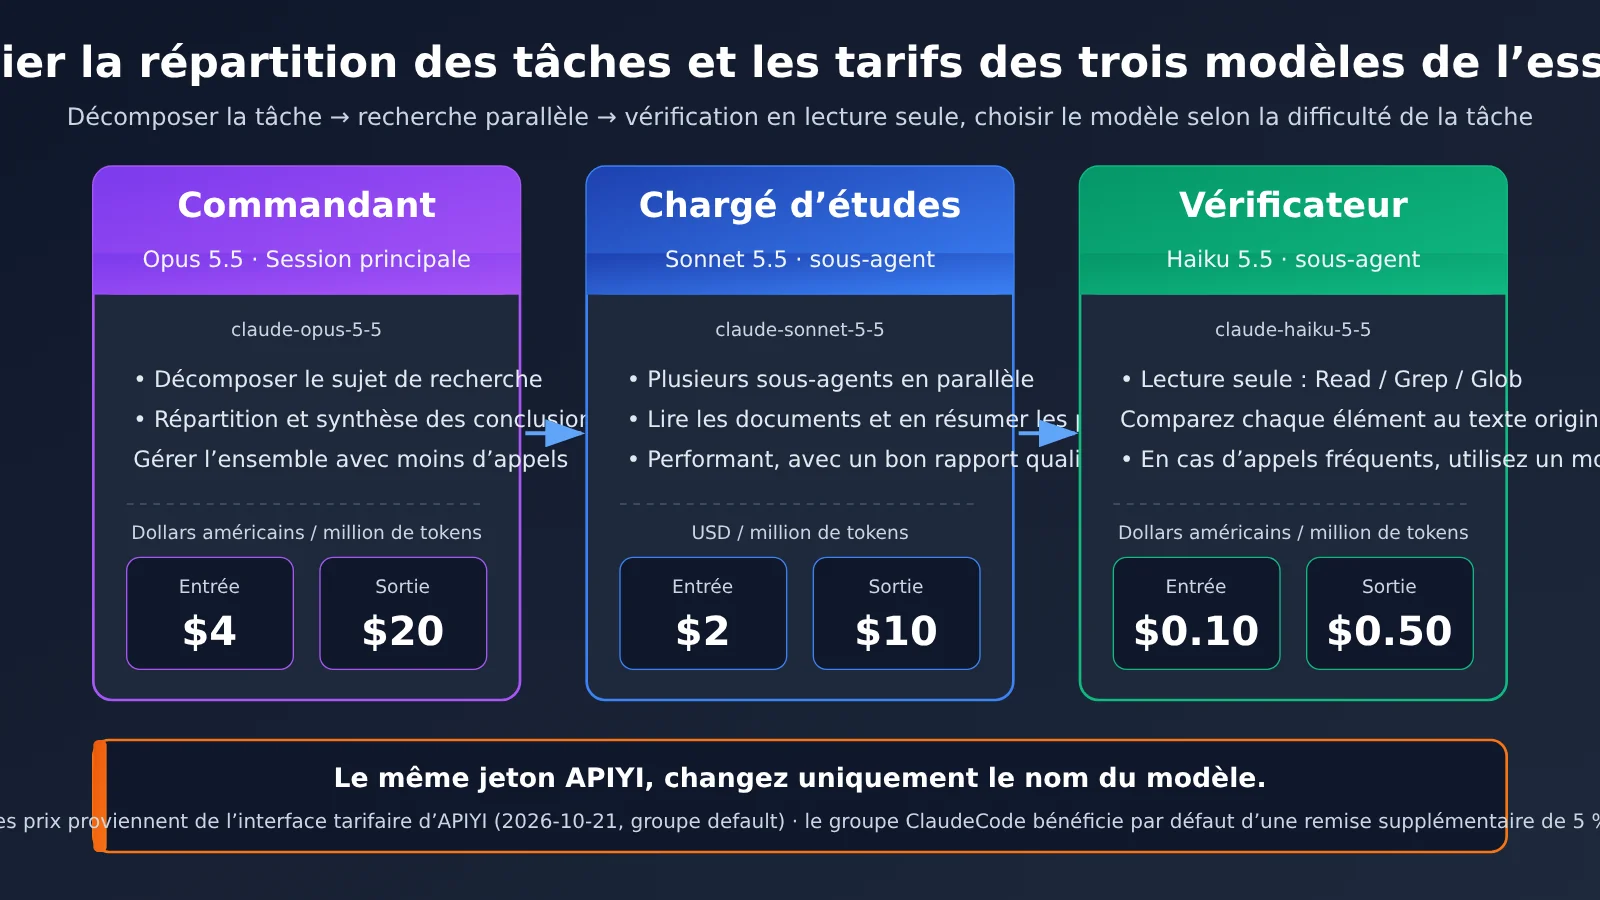
Les trois rôles utilisent le même jeton APIYI ; seul le nom du modèle change. Les tarifs ci-dessous proviennent de l’interface de tarification d’APIYI au 21 octobre 2026 (groupe default). Le groupe ClaudeCode bénéficie par défaut d’une remise de 5 %.
| Rôle | Nom du modèle | Entrée (USD par million de tokens) | Sortie (USD par million de tokens) | Pourquoi ce choix ? |
|---|---|---|---|---|
| Session principale : décomposer les questions et synthétiser | claude-opus-5-5 |
4 | 20 | Il faut coordonner l’ensemble, mais les appels sont peu nombreux. |
| Enquêteur : consulter les sources en parallèle | claude-sonnet-5-5 |
2 | 10 | Solide pour lire et synthétiser, avec un bon équilibre entre performances et coût. |
| Vérificateur : déterminer si chaque affirmation est vraie ou fausse | claude-haiku-5-5 |
0.10 | 0.50 | La tâche est simple et les appels fréquents : autant utiliser un modèle peu coûteux. |
Quelques points méritent d’être précisés concernant les coûts. Plus il y a de sous-agents, plus leurs résultats sont longs et plus ils occupent la fenêtre de contexte de la session principale. De plus, chaque sous-agent consomme ses propres tokens pendant son exécution.
Tableau de dépannage des problèmes courants liés à un essaim de recherche
| Problème | Causes fréquentes | Solution |
|---|---|---|
| Le sous-agent n’est pas appelé | La session n’a pas été rouverte après la création du dossier agents ; la description est trop vague |
Fermez puis rouvrez Claude Code ; lors de la délégation, précisez directement « utilise le sous-agent researcher » |
| Le vérificateur modifie lui-même le contenu | Write ou Edit figure parmi les outils, ou le vérificateur hérite de tous les outils |
Ouvrez fact-checker.md et vérifiez que les seuls outils sont Read, Grep et Glob |
Des fichiers sont écrits dans le dossier .obsidian |
CLAUDE.md ne se trouve pas à la racine du coffre, ou les règles ne sont pas assez claires |
Déplacez CLAUDE.md à la racine et ajoutez la consigne « ne jamais lire ni écrire dans .obsidian » |
| Erreur 401 | Le jeton est incorrect, il n’appartient pas au groupe ClaudeCode ou la variable API_KEY est utilisée |
Recopiez le jeton, vérifiez le groupe et remplacez le nom de la variable par AUTH_TOKEN |
| Erreur sur l’adresse de la requête | L’adresse se termine par un /v1 superflu |
Remplacez-la par https://api.apiyi.com |
| WebSearch ne fonctionne pas | La documentation officielle ne précise pas si cette fonctionnalité est prise en charge via une passerelle tierce, ou la limite de 200 sessions a été atteinte | Ajoutez directement les liens dans la liste des tâches et utilisez WebFetch ; lancez /clear pour démarrer une nouvelle conversation |
| Les nouvelles notes n’apparaissent pas dans Obsidian | Claude Code a écrit dans un autre dossier, ou le coffre ouvert n’est pas le bon | Demandez à Claude Code : « Dans quel chemin absolu as-tu écrit les fichiers ? », puis comparez-le au chemin du coffre |
Si vous ne savez pas quels outils sont disponibles dans la session en cours, demandez directement à Claude : « De quels outils disposes-tu actuellement ? » Il vous les énumérera.
Quand éviter d’associer Obsidian à Claude Code pour créer un essaim de recherche
Cette configuration entraîne des frais fixes et ne convient pas à toutes les situations. Dans les cas suivants, une simple conversation avec Claude sera plus efficace :
- Pour vérifier une ou deux informations seulement : le coût du découpage, de la délégation et de la vérification dépasse celui de la recherche elle-même.
- Si toutes les sources se trouvent dans un seul article : demandez simplement à Claude de le lire puis d’en faire un résumé. Le travail en parallèle n’est pas nécessaire.
- Si vous avez besoin de données en temps réel : pour les cours de Bourse ou les taux de change, par exemple, mieux vaut utiliser une interface spécialisée. Les pages Web peuvent contenir des informations périmées.
- Si votre budget est très serré : plusieurs sous-agents consomment beaucoup plus de jetons. Il est plus économique de commencer par traiter le besoin dans une seule session.
Tableau récapitulatif pour lancer un essaim de recherche avec Obsidian et Claude Code
Enregistrez ce tableau et consultez-le chaque fois que vous lancez une nouvelle série de recherches.
| Élément | Valeur ou méthode |
|---|---|
| Structure du coffre | Liste des tâches / Sources brutes / Notes de recherche / Historique des retours + fichier CLAUDE.md à la racine |
| Adresse de l’API | https://api.apiyi.com (sans /v1) |
| Jeton | Groupe ClaudeCode d’APIYI, un seul jeton partagé entre les trois modèles |
| Répartition des modèles | Session principale : opus-5-5 / Recherche : sonnet-5-5 / Vérification : haiku-5-5 |
| Outils du vérificateur | Uniquement Read, Grep et Glob ; sans Write, Edit ni Agent |
| Règles de vérification | Examiner uniquement les conclusions et les sources originales ; répondre uniquement « validé » ou « à reprendre » ; 3 tours maximum |
| Recherche en ligne | Ajouter les liens dans la liste des tâches et utiliser WebFetch ; WebSearch est partagé, à raison de 200 recherches par session |
| Filtrage | Rechercher [status:已核查] dans Obsidian |
| Maîtrise des coûts | Commencer par un essai de 3 tâches, puis consulter la consommation du jeton dans la console APIYI |
Questions fréquentes
Q1 : Qu’est-ce qu’un « essaim de recherche » ?
Un essaim de recherche est une méthode de travail où plusieurs sous-agents IA recherchent des informations en parallèle, puis un autre modèle vérifie leurs résultats un par un. Dans la configuration présentée ici, une session principale travaille avec 2 ou 3 agents de recherche et un vérificateur. L’équipe reste petite, mais le principe — séparer le travail de la vérification des faits — est bien appliqué.
Q2 : Est-il vrai que 300 Claude Code ont fonctionné sans aucune erreur, comme le prétend une publication en ligne ?
Impossible à vérifier. L’identité du développeur, les 300 tâches exécutées en parallèle, les 100 millisecondes et l’absence d’erreurs ne sont affirmées que dans la publication elle-même. Les chiffres varient également selon les reprises de l’histoire. Cet article reprend uniquement l’idée de confier le travail aux modèles les plus coûteux et la vérification aux moins coûteux.
Q3 : Comment activer le mode commandant `–command-center` mentionné dans la publication ?
Ce n’est pas possible. Ce paramètre ne figure pas dans la documentation officielle de la CLI Claude Code, et REA et JEV ne sont pas des fonctionnalités officielles. Pour travailler en parallèle, utilisez les sous-agents officiels. Pour les tâches de longue durée, la documentation recommande plutôt les agents en arrière-plan (`claude agents`).
Q4 : Faut-il installer un plugin Obsidian ou MCP ?
Pas pour commencer. Lors d’un test ponctuel réalisé par un tiers sur un petit coffre de 560 notes, Claude Code a répondu correctement à toutes les questions sans aucun plugin, tout en consommant le moins de jetons. On ne dispose pas encore de données sur ses performances avec des coffres plus volumineux.
Q5 : Faut-il demander un jeton distinct pour chacun des trois modèles ?
Non. Créez un jeton dans le groupe ClaudeCode sur APIYI, à l’adresse apiyi.com, puis utilisez-le pour la session principale et les deux sous-agents. Il suffit d’indiquer un nom de modèle différent dans la configuration de chacun.
Q6 : Comment savoir combien cette recherche a coûté ?
Connectez-vous à la console APIYI pour consulter la consommation et les journaux associés à ce jeton. Il est conseillé de commencer par trois petites tâches et de vérifier la consommation réelle avant d’augmenter le volume.
Q7 : Ajouter un vérificateur garantit-il l’absence d’erreurs ?
Non. Le vérificateur peut seulement juger si la conclusion correspond aux extraits cités. Il ne détectera pas forcément une erreur dans la source originale ou un biais dans le choix des extraits. C’est pourquoi l’étape ⑥ recommande de vérifier manuellement quelques résultats et de consulter régulièrement l’historique des retours.
Points clés sur une équipe d’agents de recherche
- La méthode compte plus que le nombre : les modèles coûteux font le travail, les modèles moins chers vérifient les résultats. Le nombre d’agents n’est pas le critère essentiel.
- Une bibliothèque, ce sont simplement des dossiers : Claude Code lit et modifie directement les fichiers Markdown. Aucun plugin n’est nécessaire pour commencer.
- Le vérificateur doit être en lecture seule : ne lui donnez pas accès à Write, Edit ou Agent. Il doit uniquement indiquer si le résultat est validé ou à reprendre.
- Isolez le raisonnement : le vérificateur ne consulte que la conclusion et le texte source, afin de ne pas se laisser influencer par la personne chargée de la recherche.
- Pour les liens, utilisez WebFetch : vous éviterez les limites de WebSearch et n’aurez pas à vous demander si la passerelle le prend en charge.
- Après 3 refus, passez la main à une personne : consignez le cas dans le journal des retours et ne l’intégrez pas de force à la bibliothèque.
- Commencez par un essai pour évaluer les coûts : avec le même jeton APIYI, consultez la consommation réelle dans le tableau de bord.
En résumé
Pour monter une équipe d’agents de recherche avec Obsidian et Claude Code, trois points sont essentiels :
- Une structure claire : 4 dossiers et un fichier CLAUDE.md, qui précisent où chacun peut écrire.
- Des rôles distincts : Sonnet mène les recherches, Haiku vérifie les résultats et Opus coordonne le tout. Le vérificateur n’a aucun droit d’écriture.
- Un processus d’intégration bien défini : seuls les résultats validés sont ajoutés aux notes de recherche. Les autres sont renvoyés pour être retravaillés ; après 3 refus, ils sont confiés à une personne.
Commencez par tester le processus de bout en bout avec 3 petites tâches. Vérifiez que les fichiers sont enregistrés au bon endroit, que les résultats sont correctement contrôlés et que les coûts sont conformes à vos attentes. Vous pourrez ensuite remplacer les exemples par vos propres sujets : veille concurrentielle, articles scientifiques ou actualités sectorielles. Pour connecter les modèles, vous pouvez utiliser directement un jeton du groupe ClaudeCode d’APIYI, sur apiyi.com. Les trois modèles partagent le même jeton, ce qui facilite le passage de l’un à l’autre.
📚 Références
- Documentation des sous-agents de Claude Code : création des sous-agents, autorisations d’accès aux outils, champ du modèle et recherches en parallèle
- Lien :
code.claude.com/docs/en/sub-agents -
Remarque : principale référence pour la configuration des sous-agents présentée dans cet article
-
Référence des outils de Claude Code : fonctionnement de WebSearch et WebFetch, et limites d’utilisation
- Lien :
code.claude.com/docs/en/tools-reference -
Remarque : explique pourquoi il est recommandé d’inclure directement des liens dans la liste des tâches
-
Configuration des modèles de Claude Code : alias et noms complets des modèles
- Lien :
code.claude.com/docs/en/model-config -
Remarque : confirme les versions correspondant à opus, sonnet et haiku
-
Documentation d’aide d’Obsidian : coffres et stockage des fichiers
- Lien :
obsidian.md/help -
Remarque : confirme qu’un coffre est un simple dossier et que les modifications externes sont automatiquement actualisées
-
Comparatif réalisé par un tiers : outils d’IA pour Obsidian (petit coffre de 560 articles, un seul test)
- Lien :
agentskillshub.top/best/obsidian-second-brain/ -
Remarque : référence pour débuter sans installer de module complémentaire
-
Documentation de connexion de Claude Code à APIYI
- Lien :
docs.apiyi.com/scenarios/programming/claude-code - Remarque : informations sur le groupe Claude Code, l’adresse et les variables d’environnement
Auteur : équipe technique d’APIYI
Échanges techniques : si vous rencontrez des difficultés pendant la configuration, n’hésitez pas à laisser un commentaire. Pour en savoir plus sur la connexion, consultez le centre de documentation d’APIYI à l’adresse docs.apiyi.com.