За последние несколько дней один пост в X набрал много просмотров. В нём рассказывалось о «23-летнем разработчике из Китая», который запустил 300 экземпляров Claude Code параллельно. Каждый результат сверяли с исходным файлом примерно за 100 миллисекунд, а больше 100 досье на компании без единой ошибки записали в Obsidian.
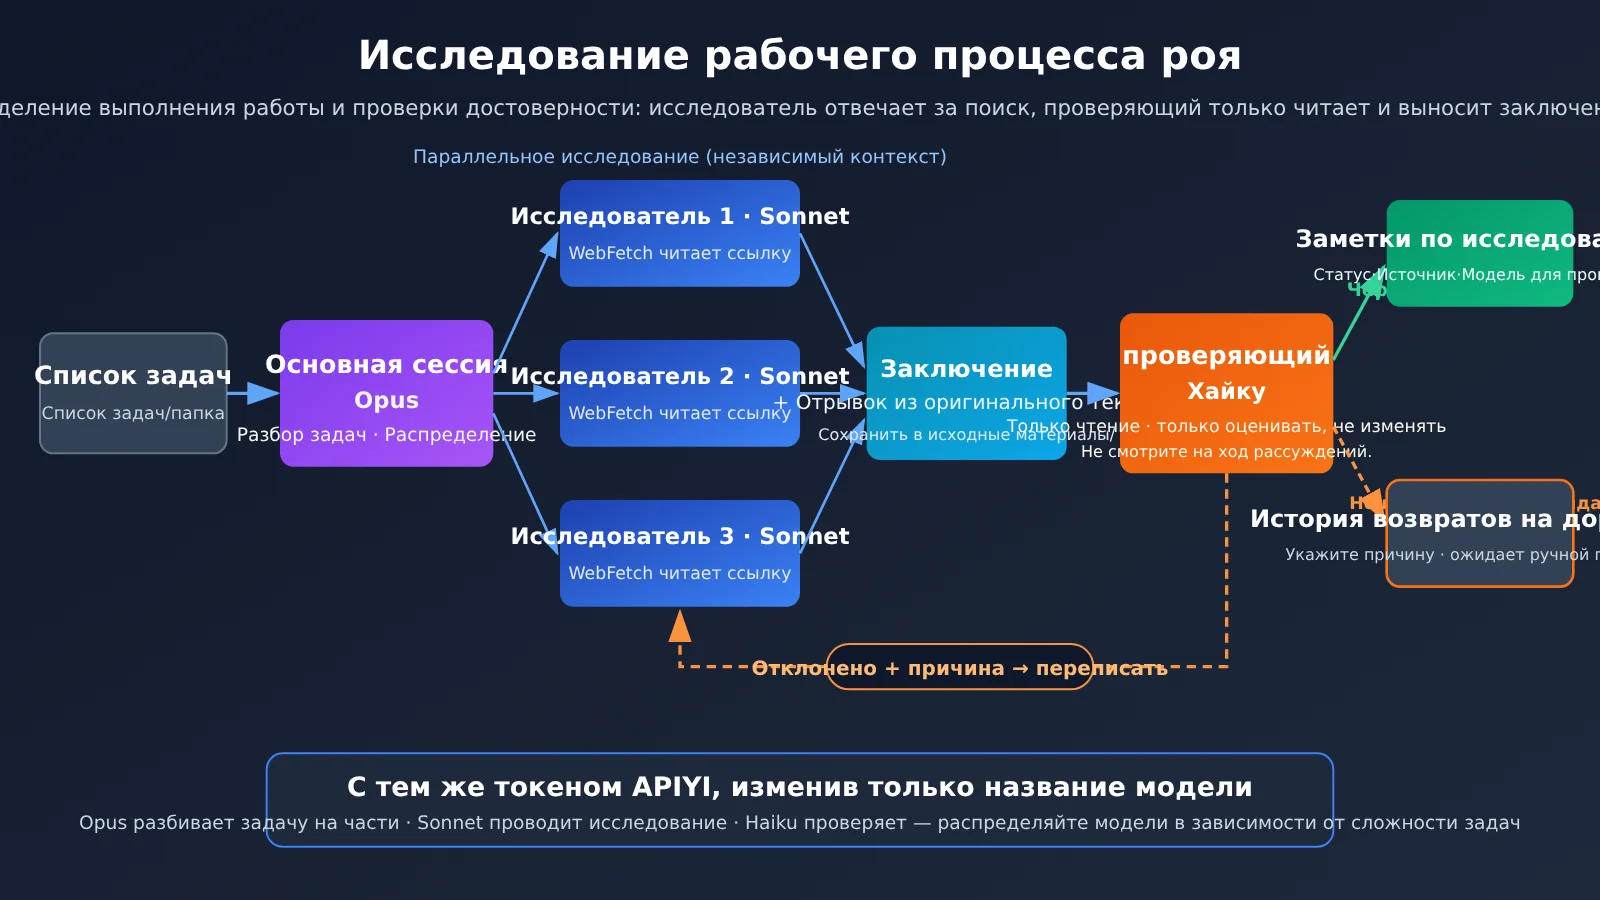
Главная мысль, которую стоит взять на заметку: дорогая модель выполняет работу, дешёвая проверяет факты, некачественные результаты отправляются на доработку, а в базу попадает только то, что прошло проверку.
Это пошаговая инструкция, по которой можно повторить процесс и запустить его у себя. В основном всё делается через графический интерфейс и обычные просьбы к Claude Code — программировать не нужно.
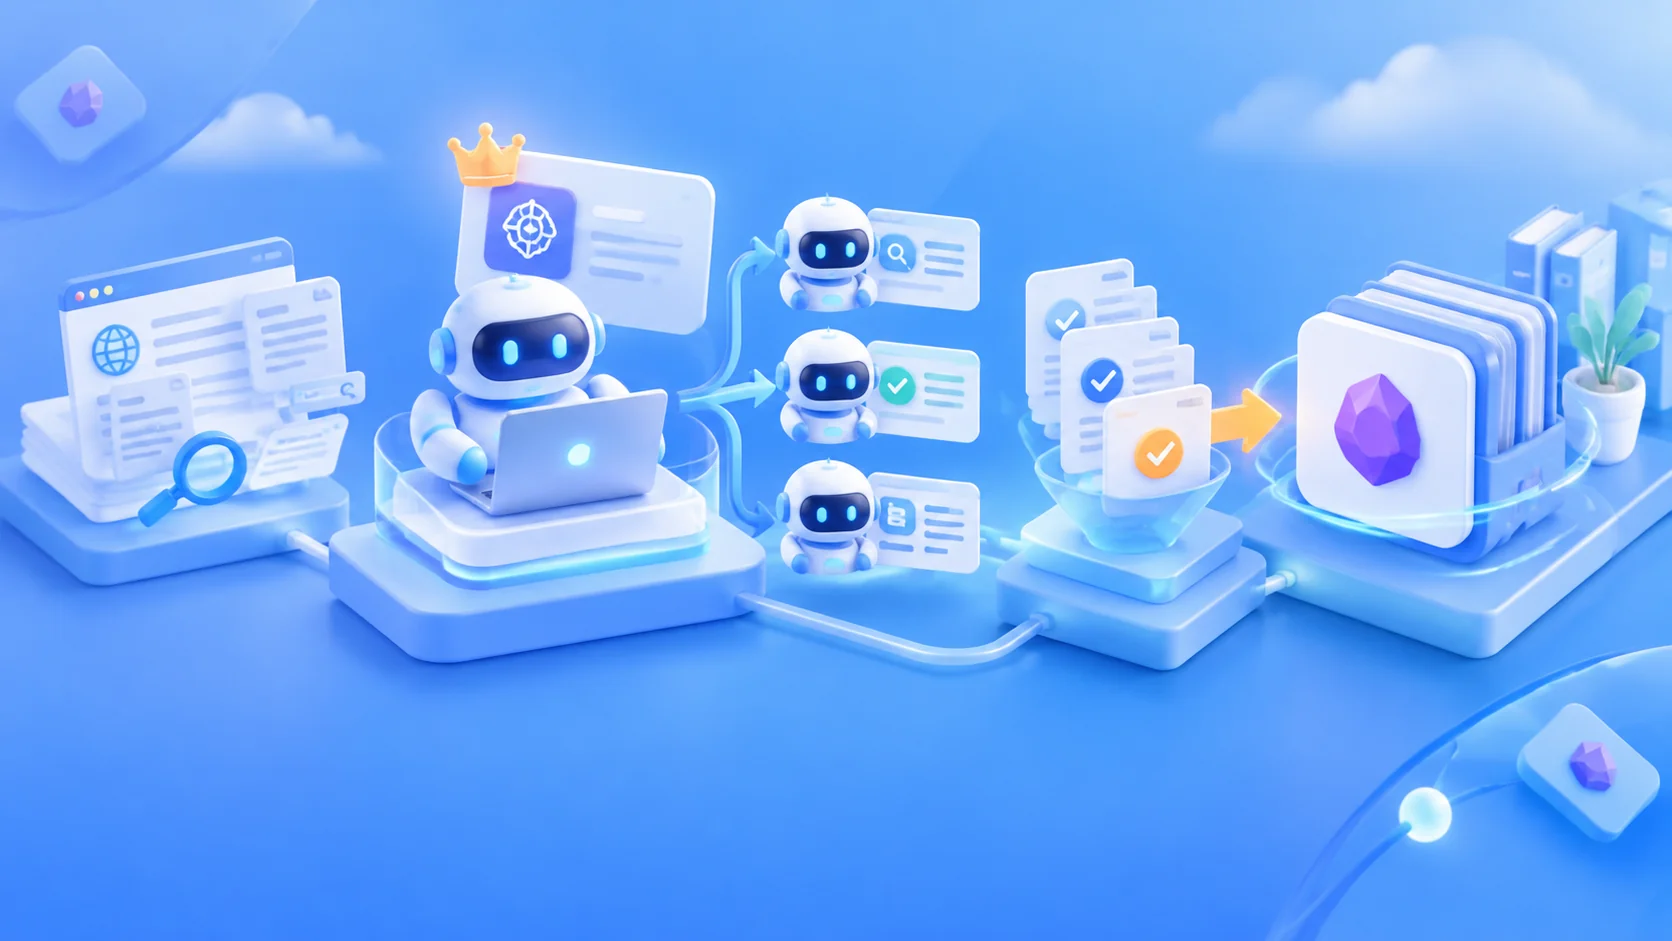
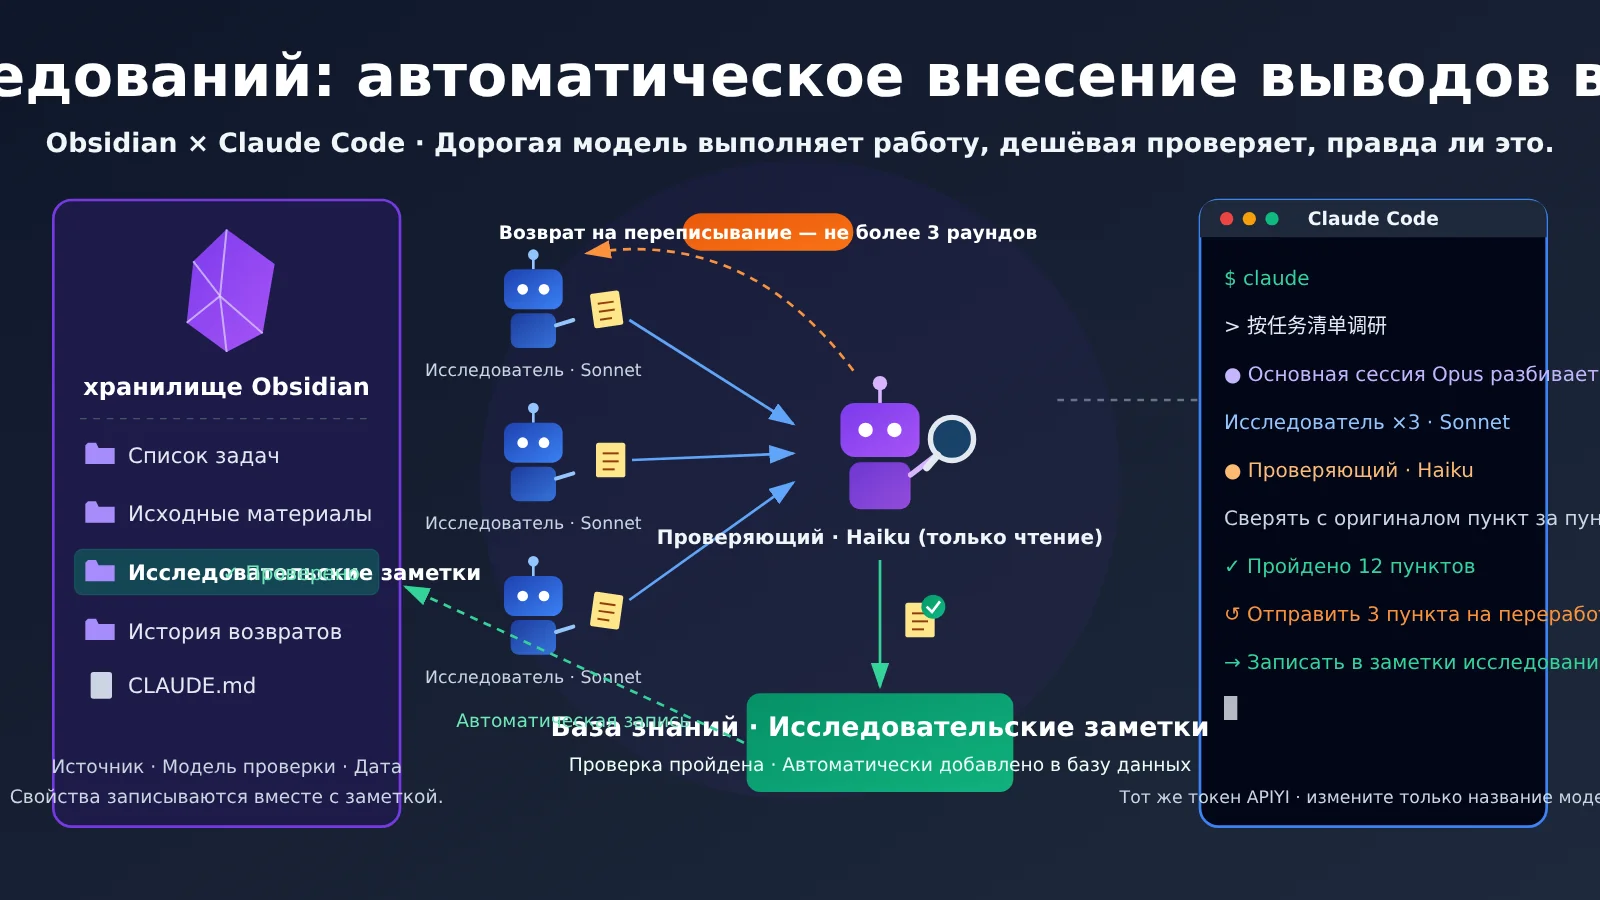
Главное: прочитав статью, вы настроите на своём компьютере небольшую исследовательскую команду агентов. Главная сессия будет разбивать задачу на части, несколько дочерних агентов — параллельно искать информацию, а отдельный недорогой агент-проверяющий — придирчиво проверять каждый пункт. Выводы, прошедшие проверку, будут автоматически сохраняться в хранилище Obsidian вместе с источниками и отметкой о проверке.
Исследовательский рой на базе Obsidian и Claude Code: перед началом
Прежде чем приступать, убедитесь, что всё готово.
- Цель: главный сеанс (Opus) разбивает задачу на части и подводит итоги, 2–3 исследовательских субагента (Sonnet) параллельно собирают материалы, а один субагент-проверяющий (Haiku) по пунктам проверяет факты. Подтверждённые выводы сохраняются в папку Obsidian «Исследовательские заметки».
- Время: на первую настройку заложите один день. Для каждого следующего исследования достаточно подготовить список задач и одной фразой поручить их агентам.
- Что понадобится: установленное приложение Obsidian для компьютера, Claude Code, аккаунт APIYI и доступ к интернету, чтобы открывать ссылки на нужные материалы.
- Сложность: начальный уровень. Писать код не придётся; файлы конфигурации приведены только в необязательных сворачиваемых блоках.
Ниже — общий план. Для каждого шага указан критерий готовности. Завершите шаг, проверьте результат и только потом переходите к следующему.
| Шаг | Что сделать | Критерий готовности: что вы увидите |
|---|---|---|
| ① Создать хранилище | Создать хранилище Obsidian, 4 папки и файл CLAUDE.md | Слева в Obsidian отображаются 4 папки, в корне лежит CLAUDE.md |
| ② Подключить токен | Настроить токен APIYI в Claude Code | Открыв Claude Code в папке хранилища, вы можете вести диалог |
| ③ Создать субагентов | Попросить Claude создать исследователей и проверяющего | Команда /agents показывает двух субагентов |
| ④ Поручить задачи | Подготовить список задач и одной фразой запустить их параллельно | В папке «Исходные материалы» появляются файлы с выдержками по каждой задаче |
| ⑤ Запустить цикл проверки | Возвращать работу на доработку, не более 3 раундов | Подтверждённые выводы попадают в «Исследовательские заметки», отклонённые — в «Журнал возвратов» |
| ⑥ Проверить результат | Отфильтровать проверенные заметки в Obsidian | В свойствах заметок есть status, источник, модель проверки и дата |
Ключевые выводы по исследованию роя
| Категория | Содержание | Как это используется в статье |
|---|---|---|
| Официальная документация (Claude Code / Obsidian) | У субагентов есть собственный контекст, им можно назначать инструменты и модели; параллельное исследование прямо указано как официальный сценарий использования; WebSearch поддерживает не более 200 вызовов за сеанс, лимит общий для всех субагентов; хранилище Obsidian — обычная папка с Markdown-файлами, внешние изменения отображаются автоматически | Основа для настройки |
| Разовое стороннее тестирование | В тестовой библиотеке из 560 заметок проверили 15 вопросов: Claude Code без плагинов ответил на все правильно и потратил меньше всего токенов | Пример того, что для начала плагины не нужны. Это не говорит о том, как система поведёт себя на большой библиотеке |
| Слухи из сети | Разработчик в возрасте 23 лет, 300 параллельных задач, проверка за 100 миллисекунд и ноль ошибок; а ещё --command-center, REA и JEV из другого популярного поста |
Можно взять только общую идею. Последних параметров нет в официальной справке по CLI — не копируйте их |
Зачем делить исследовательский рой на роли «собирать информацию» и «проверять факты»
Если просто увеличить число агентов, не добавив проверку, вместе с ростом параллельности будет расти и количество галлюцинаций. Когда исследование и проверку поручают двум разным моделям, проверяющему нужно ответить только на один вопрос: подтверждается ли вывод цитатой из первоисточника? Это намного проще, чем проводить исследование, поэтому для этой задачи хватит недорогой Haiku.
В комментариях попался ещё один полезный совет: проверяющий не должен видеть ход рассуждений исследователя — только вывод и первоисточник. Иначе он может попасть под влияние формулировок исследователя. Кроме того, проверяющий должен выводить только «принято» или «отклонено + причина» и не должен сам ничего исправлять. Если он начнёт править текст, его роль смешается с ролью исследователя. Настройки в этой статье учитывают оба правила.
Почему для знакомства с Obsidian не нужны плагины и MCP
По сути, хранилище Obsidian — это обычная папка. Claude Code умеет читать и записывать .md-файлы, а Obsidian автоматически обновляет их отображение. В упомянутом выше стороннем тесте — на небольшой библиотеке из 560 заметок, по одному запуску каждого инструмента — контрольная группа без дополнительных компонентов потратила меньше всего токенов. Поэтому на старте возиться с плагинами не нужно. Данных о том, как это будет работать на больших библиотеках, пока нет.
Быстрый старт: исследовательский рой в Obsidian с Claude Code
Шаг ①: создайте хранилище в Obsidian и подготовьте CLAUDE.md
Откройте Obsidian и выберите «Создать хранилище» — создайте новое пустое хранилище. Назовите его 调研库, а для расположения выберите папку, которую легко найти, например «Документы». Не размещайте хранилище внутри папки другого хранилища: вложенные хранилища могут нарушить работу внутренних ссылок.
В панели файлов слева щёлкните правой кнопкой мыши и выберите «Создать папку». Создайте 4 папки: 任务清单, 原始资料, 调研笔记, 打回记录.
Затем создайте заметку в корневой папке хранилища и назовите её CLAUDE.md. Добавьте в неё правила работы с файлами. Claude Code будет читать этот файл при каждом запуске из этой папки:
# 调研库入库规则
1. 只读写这 4 个文件夹:任务清单、原始资料、调研笔记、打回记录。绝不读写 .obsidian 文件夹。
2. 每条结论必须附来源链接和原文摘录(引号原样摘抄)。
3. 没有通过核查员核查的内容,不得写入「调研笔记」。
4. 打回超过 3 轮仍不通过的,写入「打回记录」并注明理由,等人工处理。
5. 调研笔记顶部写属性:status、来源、核查模型、日期。
В результате в Obsidian слева появятся 4 папки и файл CLAUDE.md. В корневой папке также будет скрытая по умолчанию папка настроек .obsidian. В ней хранятся настройки самого Obsidian, поэтому агентам нельзя её изменять.
Шаг ②: подключите APIYI к Claude Code
Подробную настройку здесь повторять не будем. Следуйте инструкции Как подключить Claude Code, Codex, Pi и Hermes через magpie в одном графическом интерфейсе, чтобы подключить API-ключ APIYI через графический интерфейс, а затем вернитесь к этой статье.
Обратите внимание на два момента:
- При создании ключа в панели APIYI выберите группу ClaudeCode.
- В качестве адреса API укажите
https://api.apiyi.com— без/v1в конце.
После подключения откройте терминал в папке 调研库, запустите Claude Code командой claude и задайте любой вопрос. Если он ответит, значит, подключение работает.
Необязательно: настройте settings.json вручную, если не хотите использовать графический интерфейс
Отредактируйте `~/.claude/settings.json` и добавьте две строки в поле env. Обратите внимание: переменная называется `ANTHROPIC_AUTH_TOKEN`, а не `ANTHROPIC_API_KEY`:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.apiyi.com",
    "ANTHROPIC_AUTH_TOKEN": "你的 APIYI 令牌"
  }
}
Если при запуске Claude Code постоянно просит войти на официальный сайт, добавьте `»hasCompletedOnboarding»: true` в `~/.claude.json`.
В результате Claude Code будет отвечать на вопросы. В панели APIYI также появится запись об использовании этого ключа — значит, запросы действительно отправляются через него.
Шаг ③: попросите Claude Code создать субагентов-исследователя и проверяющего
Субагенты — это Markdown-файлы с YAML-заголовком. Не нужно создавать их вручную: поручите это Claude Code. Отправьте ему такой запрос:
请在当前项目的 .claude/agents/ 下创建两个子代理:
1. researcher(调研员):模型 claude-sonnet-5-5。只用 WebFetch 读任务清单里给的链接,
   每条结论附来源链接和原文摘录,把结果写到「原始资料」文件夹。不给 Agent 工具。
2. fact-checker(核查员):模型 claude-haiku-5-5。只给 Read、Grep、Glob,
   不给 Write、Edit、Agent。它只接收“结论 + 原文摘录 + 来源文件路径”,
   不看调研员的推理过程,只输出「通过」或「打回 + 理由」,不得自己修改任何内容。
Для основного сеанса используйте claude-opus-5-5: он будет разбивать задачу на части, распределять их и собирать результаты. Модель можно сменить командой /model после запуска или задать в инструменте на шаге ②.
Необязательно: посмотрите, как выглядят файлы двух субагентов
`.claude/agents/researcher.md`:
---
name: researcher
description: 按任务清单读取给定链接,产出带来源和原文摘录的调研结论
tools: Read, Grep, Glob, WebFetch, Write
model: claude-sonnet-5-5
maxTurns: 20
---
你是调研员。只读取任务里给出的链接。每条结论格式:
结论 / 来源链接 / 原文摘录(原样引用)。写入「原始资料」文件夹,不碰其他目录。
`.claude/agents/fact-checker.md`:
---
name: fact-checker
description: 逐条核对结论是否被原文摘录支持,只判定不修改
tools: Read, Grep, Glob
model: claude-haiku-5-5
maxTurns: 8
---
你是核查员。只看结论和原文,不接受任何推理说明。
每条输出「通过」或「打回:理由」。摘录不支持、数字对不上、来源缺失一律打回。
你没有写权限,也不得建议替换措辞以外的任何修改。
Обратите внимание: после первого создания папки .claude/agents/ нужно закрыть и заново открыть сеанс Claude Code. После этого изменения в файлах субагентов будут применяться автоматически за несколько секунд. Субагентам без инструмента Agent нельзя поручать создание других субагентов — так вы избежите неконтролируемого каскада вложенных агентов.
В результате команда /agents покажет researcher и fact-checker, а рядом с каждым будет указана его модель.
Шаг ④: составьте список задач и запустите параллельное исследование одной командой
Создайте в папке Obsidian 任务清单 файл 第一批.md. Для примера возьмём исследование пяти продуктов. Для каждого укажите ссылки, которые нужно изучить. При вызове через сторонний шлюз доступность WebSearch официально не подтверждена, поэтому надёжнее сразу дать субагентам ссылки для чтения через WebFetch.
# 第一批:5 个产品定价与功能
1. 产品 A:定价页 https://example-a.com/pricing ,功能页 https://example-a.com/features
2. 产品 B:https://example-b.com/pricing
3. 产品 C:https://example-c.com/docs/plans
4. 产品 D:https://example-d.com/pricing
5. 产品 E:https://example-e.com/changelog
每条要回答:最低付费档价格、是否有免费版、最近一次功能更新。
Вернитесь в Claude Code и отправьте ему такую команду:
读取 任务清单/第一批.md,把 5 条任务分给 researcher 子代理并行调研,
各自写入「原始资料」。全部完成后告诉我每条的结论数量。
Пять продуктов здесь — только пример. Точно так же можно отслеживать конкурентов, собирать основные тезисы научных статей или новости отрасли: достаточно указать ссылку для каждой задачи и написать, на какие вопросы нужно ответить.
В результате в папке Obsidian 原始资料 постепенно появятся 5 файлов. В каждом будут пункты в формате «вывод / ссылка на источник / цитата из первоисточника».
Шаг ⑤: настройте цикл проверки — не больше 3 повторных попыток
Отправьте основному сеансу следующее сообщение:
对「原始资料」里的每条结论,只把“结论 + 原文摘录 + 来源路径”交给 fact-checker。
通过的,由你写入「调研笔记」,顶部属性填 status: 已核查、来源、核查模型: claude-haiku-5-5、日期。
打回的,把理由交给 researcher 重写后再核查,最多 3 轮;
3 轮仍不过的,写入「打回记录」并附理由,不要放进调研笔记。
Это и есть описанная в официальной документации «цепочка субагентов»: сначала работу выполняет один субагент, затем результат передаётся другому. В этой схеме основной сеанс выступает диспетчером и строго контролирует, что именно увидит проверяющий: только вывод и первоисточник, без хода рассуждений.
В результате в папке 调研笔记 появятся проверенные выводы, а в 打回记录 могут оказаться несколько пунктов с причинами отклонения. Это нормально: значит, проверяющий выполняет свою работу.
Шаг ⑥: проверьте результаты в Obsidian
Откройте любую заметку с результатами исследования. В верхней части должны быть примерно такие свойства:
---
status: 已核查
来源: https://example-a.com/pricing
核查模型: claude-haiku-5-5
日期: 2026-10-21
---
Введите [status:已核查] в строку поиска Obsidian, чтобы отфильтровать заметки, прошедшие проверку. Для приёмки советуем выбрать наугад две-три записи, открыть ссылки на источники и самостоятельно сверить их с оригиналом.
В результате каждый вывод в отфильтрованных заметках можно будет проследить до первоисточника. Сомнительные материалы будут собраны в папке 打回记录 и останутся на ручную проверку.
Роли трёх моделей в исследовательском рое и цены
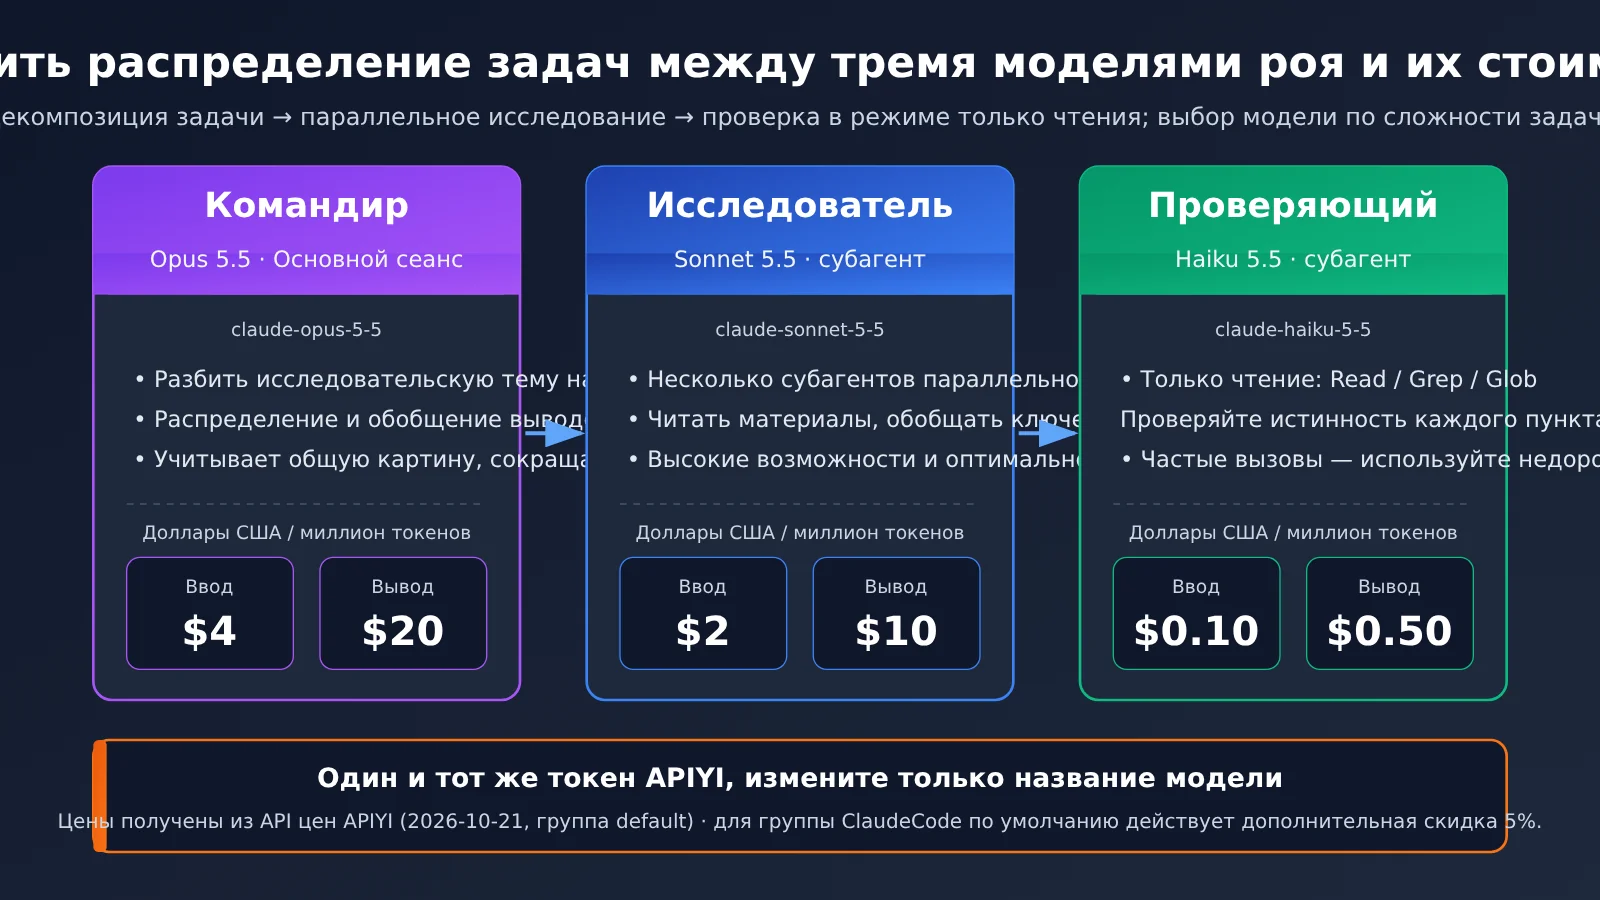
Все три роли используют один и тот же API-ключ APIYI — меняется только название модели. Цены в таблице получены через ценовой API APIYI 2026-10-21 (группа default). В группе ClaudeCode по умолчанию действует скидка 5%.
| Роль | Название модели | Ввод (долларов за миллион токенов) | Вывод (долларов за миллион токенов) | Почему выбрана эта модель |
|---|---|---|---|---|
| Основной сеанс: разбивает задачу и подводит итоги | claude-opus-5-5 |
4 | 20 | Нужно видеть общую картину, а вызовов мало |
| Исследователь: параллельно изучает материалы | claude-sonnet-5-5 |
2 | 10 | Хорошо читает и обобщает, оптимальный баланс цены и возможностей |
| Проверяющий: отдельно проверяет каждый факт | claude-haiku-5-5 |
0.10 | 0.50 | Задачи простые, вызовов много — выгоднее использовать недорогую модель |
По поводу затрат стоит учитывать несколько моментов. Чем больше субагентов, тем длиннее результаты, которые они возвращают, и тем больше места они занимают в контекстном окне основного сеанса. Кроме того, каждый субагент отдельно расходует токены во время работы.
Таблица решений частых проблем с исследовательским роем
| Что происходит | Частая причина | Что делать |
|---|---|---|
| Субагент не вызывается | После первого создания каталога agents не перезапустили сессию; описание слишком расплывчатое |
Закройте Claude Code и запустите снова; при назначении задачи укажите напрямую: «Используй субагента researcher» |
| Проверяющий сам исправляет содержимое | В tools случайно добавили Write / Edit или унаследовали все инструменты |
Откройте fact-checker.md и проверьте, что в tools указаны только Read, Grep, Glob |
Файлы попадают в каталог .obsidian |
CLAUDE.md лежит не в корне хранилища или правила сформулированы недостаточно ясно |
Переместите CLAUDE.md в корень и добавьте правило: «Никогда не читай и не изменяй файлы в .obsidian» |
| Появляется ошибка 401 | Указан неверный токен, выбрана не группа ClaudeCode или используется переменная API_KEY |
Скопируйте токен заново, проверьте группу и замените имя переменной на AUTH_TOKEN |
| Ошибка адреса запроса | В конце адреса лишний /v1 |
Укажите https://api.apiyi.com |
| WebSearch недоступен | Официально не подтверждена поддержка при работе через сторонний шлюз или исчерпан лимит в 200 запросов за сессию | Укажите ссылки прямо в списке задач и используйте WebFetch; чтобы начать новый диалог, выполните /clear |
| В Obsidian не видно новых заметок | Claude Code сохранил файлы в другом каталоге или открыто другое хранилище | Спросите Claude Code: «В какой абсолютный путь ты только что сохранил файл?» — и сравните его с путём к хранилищу |
Если не уверены, какие инструменты доступны в текущей сессии, просто спросите Claude: «Какие инструменты тебе сейчас доступны?» — он перечислит их.
Когда не стоит создавать исследовательский рой на базе Obsidian и Claude Code
У такой схемы есть постоянные накладные расходы, поэтому она подходит не для всех случаев. В ситуациях ниже проще будет просто поговорить с Claude:
- Нужно проверить всего один-два факта: на разбор задачи, распределение и проверку уйдёт больше времени, чем на само исследование.
- Все материалы собраны в одной статье: достаточно попросить Claude прочитать её и подготовить краткое изложение — параллельная работа не нужна.
- Нужны данные в реальном времени: например, котировки акций или текущие валютные курсы. Для этого лучше использовать специализированный API, а не читать веб-страницы, где могут быть устаревшие данные.
- Бюджет сильно ограничен: несколько субагентов могут израсходовать в разы больше токенов. Выгоднее сначала проверить задачу в одной сессии.
Краткая памятка: исследовательский рой в Obsidian и Claude Code
Сохраните эту таблицу и сверяйтесь с ней, когда будете запускать новую серию исследований.
| Пункт | Значение или рекомендация |
|---|---|
| Структура хранилища | Список задач / исходные материалы / заметки по исследованию / записи об отклонённых результатах + файл CLAUDE.md в корневой папке |
| Адрес API | https://api.apiyi.com (без /v1) |
| Токен | Группа ClaudeCode в APIYI — один токен для трёх моделей |
| Роли моделей | Основная сессия — opus-5-5 / исследователи — sonnet-5-5 / проверяющий — haiku-5-5 |
| Инструменты проверяющего | Только Read, Grep и Glob; без Write, Edit и Agent |
| Правила проверки | Сверять только выводы с первоисточниками; выдавать один из двух вердиктов — «принято» или «отклонено»; не более 3 раундов |
| Доступ к сети | Добавляйте ссылки в список задач и используйте WebFetch; лимит WebSearch — 200 запросов на сессию, общий для всех |
| Фильтрация | Поиск в Obsidian по [status:已核查] |
| Контроль расходов | Сначала запустите 3 задачи, затем проверьте расход токена в консоли APIYI |
Частые вопросы
Q1: Что такое «исследовательский рой»?
Исследовательский рой — это подход, при котором несколько ИИ-субагентов параллельно ищут информацию, а другая модель проверяет результаты по каждому пункту. В описанном здесь варианте есть одна основная сессия, 2–3 исследователя и один проверяющий. Масштаб небольшой, но принцип «одни выполняют работу, другие проверяют её достоверность» реализован полностью.
Q2: Правда ли, что в сети Claude Code запустили 300 раз без единой ошибки?
Подтвердить это не удалось. Идентичность разработчика, параллельный запуск 300 экземпляров, время в 100 миллисекунд и отсутствие ошибок — всё это известно только со слов автора поста. В разных пересказах цифры тоже расходятся. Здесь используется лишь сама идея: поручать работу дорогой модели, а проверку — более дешёвой.
Q3: Как включить режим командира `—command-center` из поста?
Никак. В официальной справке по CLI Claude Code такого параметра нет, а REA и JEV не являются официальными функциями. Для параллельной работы используйте официальных субагентов. Если задача должна выполняться долго, в официальной документации рекомендуют перейти на фоновых агентов (`claude agents`).
Q4: Обязательно ли устанавливать плагины Obsidian или MCP?
На начальном этапе — нет. Сторонний автор провёл разовый тест на небольшом хранилище из 560 заметок: Claude Code правильно ответил на все вопросы и без дополнительных инструментов, при этом расход токенов был минимальным. Данных о том, как он поведёт себя на более крупном хранилище, пока нет.
Q5: Нужно ли получать отдельный токен для каждой из трёх моделей?
Нет. Создайте один токен в группе ClaudeCode на APIYI apiyi.com и используйте его для основной сессии и двух субагентов. В конфигурации каждого из них укажите только своё имя модели.
Q6: Как узнать, сколько стоило это исследование?
Войдите в консоль APIYI и посмотрите расход и журнал для этого токена. Советую сначала запустить 3 небольшие задачи и оценить фактические затраты, а уже потом увеличивать объём.
Q7: Гарантирует ли проверка отсутствие ошибок?
Нет. Проверяющий может сопоставить выводы с цитатами, но он не всегда заметит ошибку в самом первоисточнике или предвзятый выбор цитаты. Поэтому на шаге ⑥ рекомендуется вручную проверить несколько результатов, а также регулярно просматривать записи об отклонениях.
Ключевые принципы исследовательского роя
- Идея важнее количества: дорогая модель выполняет работу, дешёвая проверяет результат. Количество агентов не главное.
- База знаний — это папка: Claude Code напрямую читает и записывает Markdown-файлы, поэтому для начала плагины не нужны.
- Проверяющий должен иметь только права на чтение: не выдавайте ему доступ к Write, Edit и Agent — он должен только одобрять результат или возвращать его на доработку.
- Изолируйте процесс рассуждений: проверяющий видит только итог и исходный текст — так исследователь не сможет повлиять на его оценку.
- Для ссылок используйте WebFetch: так вы обойдёте лимиты WebSearch и не будете зависеть от поддержки этой функции шлюзом.
- Если за 3 раунда результат не прошёл проверку — передайте его человеку: зафиксируйте это в журнале возвратов, но не добавляйте материал в базу знаний.
- Сначала проверьте расходы на практике: используйте один API-ключ APIYI и посмотрите фактическое потребление в консоли.
Итоги
Для организации исследовательского роя с Obsidian и Claude Code важны три вещи:
- Понятная структура: 4 папки и файл CLAUDE.md с чёткими правилами о том, кто и куда может записывать данные.
- Разделение ролей: Sonnet проводит исследование, Haiku проверяет результаты, Opus координирует работу. У проверяющего нет прав на запись.
- Замкнутый цикл работы с базой знаний: в исследовательские заметки попадают только одобренные материалы. Если материал не прошёл проверку, его возвращают на доработку; после 3 неудачных раундов подключают человека.
Для начала возьмите 3 небольшие задачи и проверьте весь процесс: куда попадают файлы, насколько хорошо работает проверка и какие получаются расходы. Когда убедитесь, что всё работает как нужно, замените примеры на собственные задачи — например, мониторинг конкурентов, анализ научных статей или отраслевых новостей. Для подключения моделей можно использовать групповой токен ClaudeCode от APIYI на apiyi.com: все три модели работают с одним токеном, поэтому переключаться между ними удобно.
📚 Источники
- Документация по субагентам Claude Code: создание субагентов, разрешения на использование инструментов, поле модели и параллельное исследование
- Ссылка:
code.claude.com/docs/en/sub-agents -
Примечание: основной источник по настройке субагентов в этой статье
-
Справочник по инструментам Claude Code: особенности работы WebSearch и WebFetch, а также ограничения на количество вызовов
- Ссылка:
code.claude.com/docs/en/tools-reference -
Примечание: объясняет, почему в списке задач рекомендуется указывать прямые ссылки
-
Настройка моделей Claude Code: псевдонимы и полные названия моделей
- Ссылка:
code.claude.com/docs/en/model-config -
Примечание: помогает определить, каким версиям соответствуют opus, sonnet и haiku
-
Справка Obsidian: хранилища и способы хранения файлов
- Ссылка:
obsidian.md/help -
Примечание: подтверждает, что хранилище — это обычная папка, а внешние изменения автоматически отображаются в Obsidian
-
Стороннее сравнение ИИ-инструментов для Obsidian (небольшое хранилище из 560 статей, один тестовый запуск)
- Ссылка:
agentskillshub.top/best/obsidian-second-brain/ -
Примечание: источник для рекомендации начать работу без установки плагинов
-
Документация APIYI по подключению Claude Code
- Ссылка:
docs.apiyi.com/scenarios/programming/claude-code - Примечание: содержит сведения о группе ClaudeCode, адресах и переменных окружения
Автор: техническая команда APIYI
Технические вопросы: если при настройке возникнут трудности, оставьте комментарий. Дополнительные инструкции по подключению доступны в центре документации APIYI: docs.apiyi.com