In den letzten Tagen erzielte ein Beitrag auf X sehr viele Aufrufe: Ein „23-jähriger chinesischer Entwickler“ ließ 300 Claude-Code-Instanzen parallel laufen. Jede Ausgabe wurde innerhalb von etwa 100 Millisekunden mit der Quelldatei abgeglichen. So landeten über 100 Unternehmensprofile „fehlerfrei“ in Obsidian.
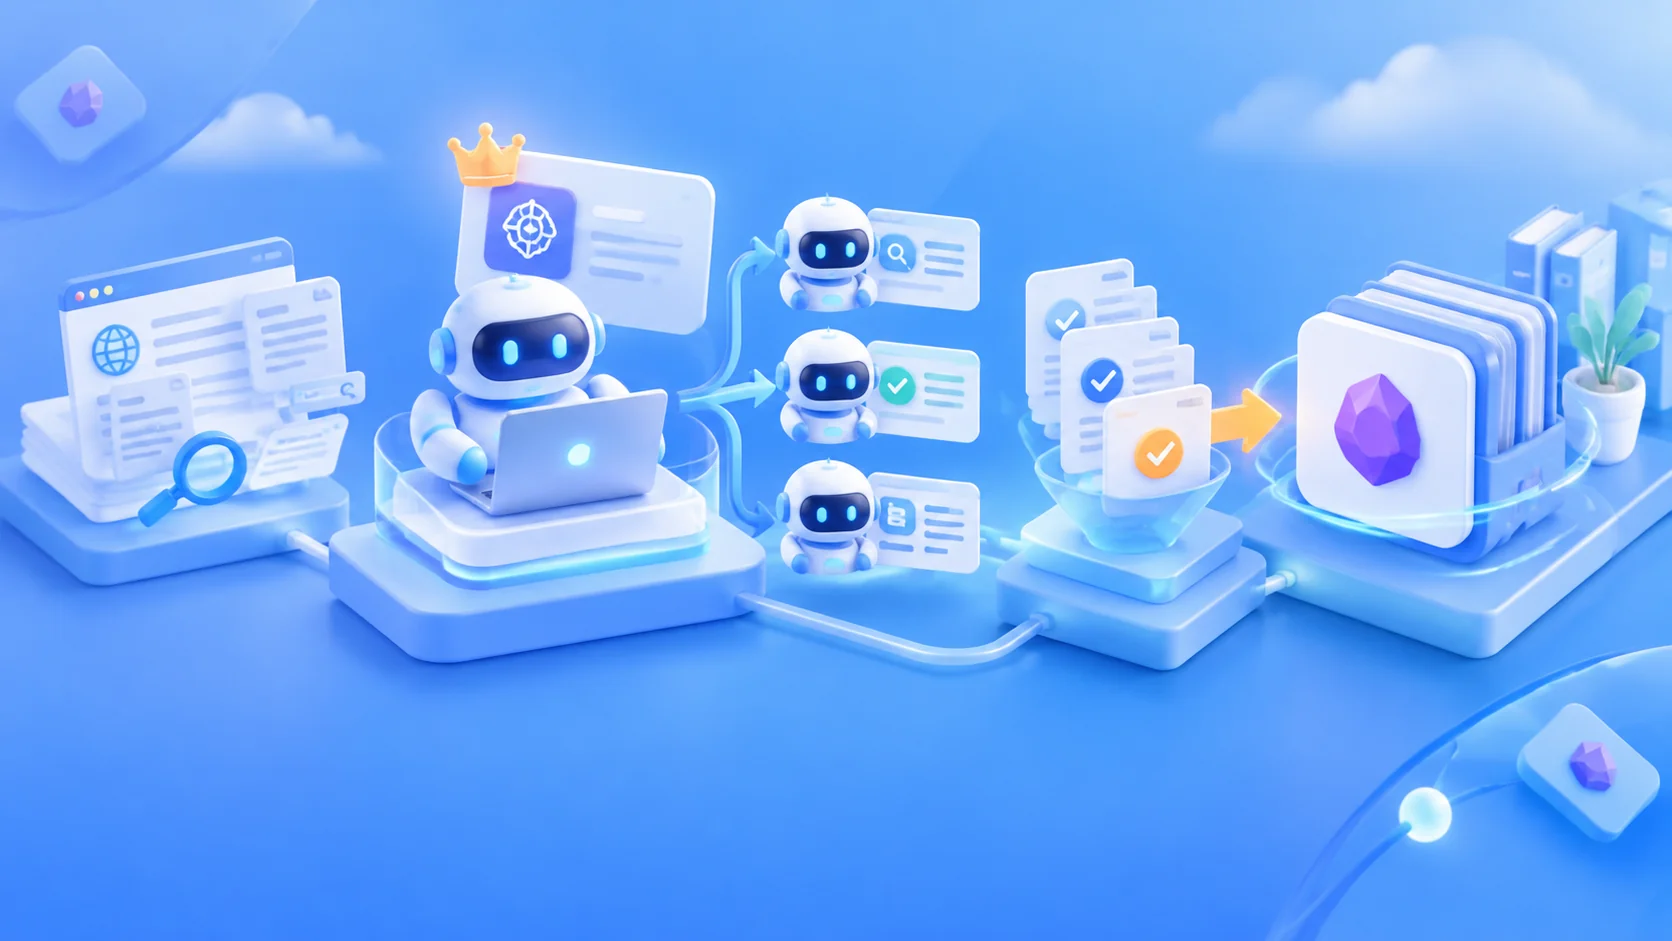
Der wirklich interessante Gedanke dahinter: Ein teures Modell erledigt die Arbeit, ein günstiges prüft die Ergebnisse. Was nicht überzeugt, geht zurück zur Überarbeitung – erst nach bestandener Prüfung wird es gespeichert.
Eine Anleitung, die Sie Schritt für Schritt umsetzen können. Der gesamte Ablauf erfolgt über eine grafische Oberfläche und mit natürlich formulierten Anweisungen an Claude Code. Programmierkenntnisse sind nicht erforderlich.
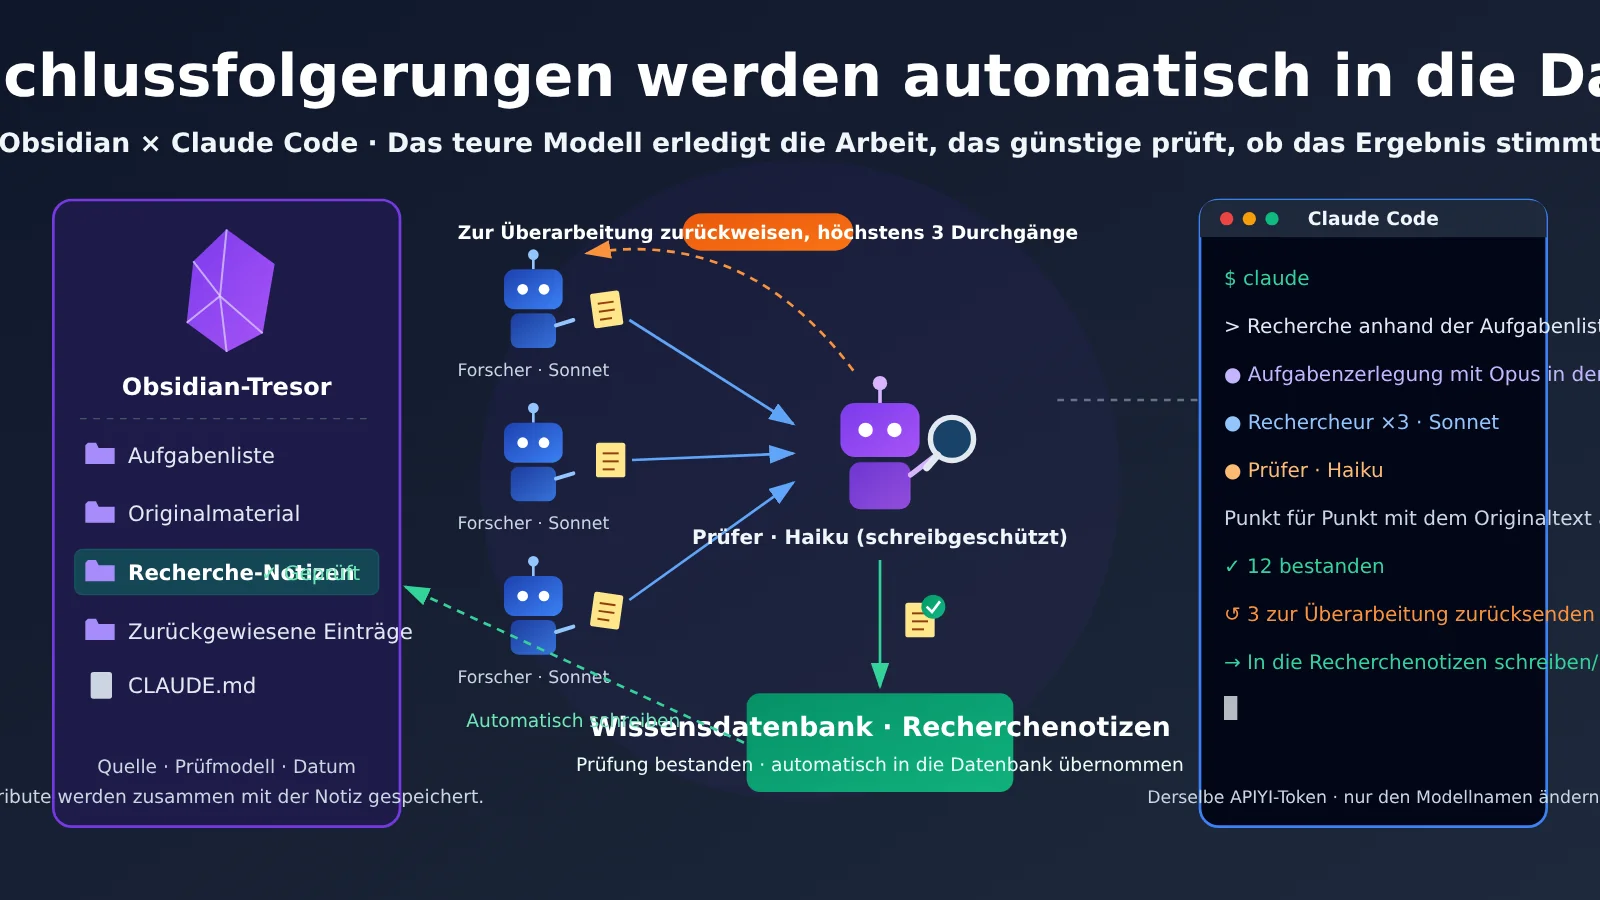
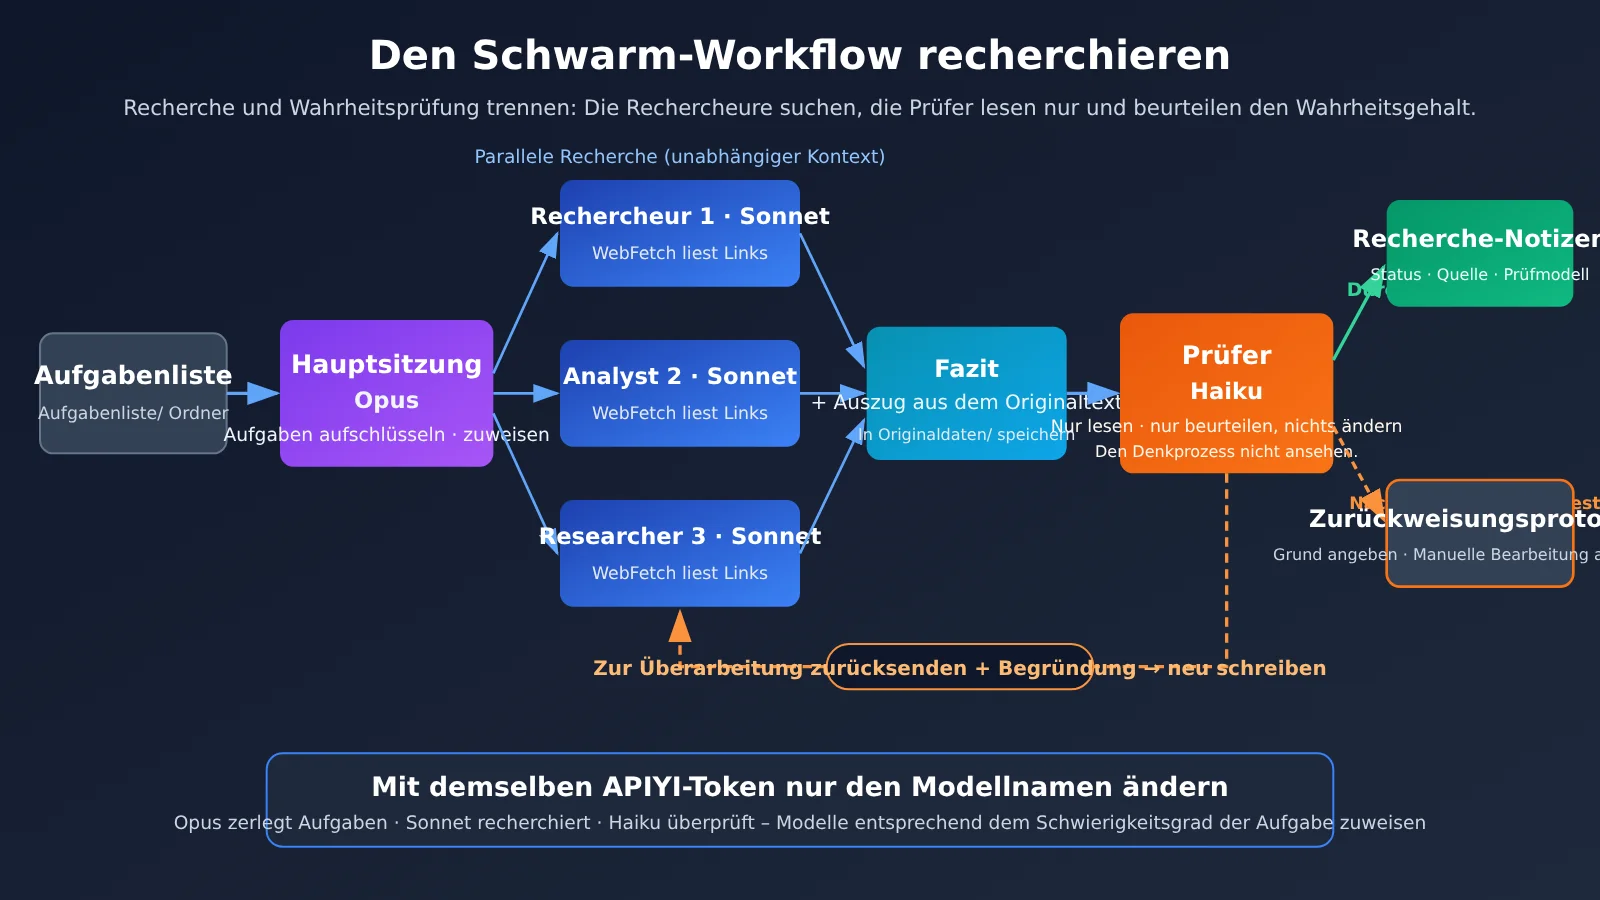
Der zentrale Mehrwert: Nach der Lektüre haben Sie auf Ihrem eigenen Rechner einen kleinen Recherche-Schwarm eingerichtet. Die Hauptsitzung zerlegt die Fragestellung, mehrere Recherche-Subagenten suchen parallel nach Informationen und ein günstiger Prüf-Subagent hinterfragt jede einzelne Aussage. Geprüfte Ergebnisse werden automatisch samt Quellen und Prüfvermerk in Ihrem Obsidian-Wissensspeicher abgelegt.
Obsidian mit Claude Code: Einen Recherche-Schwarm aufbauen
Bevor Sie loslegen, prüfen Sie, ob die folgenden Voraussetzungen erfüllt sind.
- Ziel: Die Hauptsitzung (Opus) zerlegt die Fragestellung und fasst die Ergebnisse zusammen. Zwei bis drei Recherche-Subagenten (Sonnet) recherchieren parallel. Ein Prüf-Subagent (Haiku) überprüft jede Aussage einzeln. Bestätigte Erkenntnisse landen im Obsidian-Ordner „Recherche-Notizen“.
- Zeitaufwand: Planen Sie für die erstmalige Einrichtung einen Nachmittag ein. Für jede weitere Recherche müssen Sie nur noch eine Aufgabenliste erstellen und den Auftrag mit einem Satz erteilen.
- Voraussetzungen: Obsidian Desktop und Claude Code sind installiert, Sie haben ein APIYI-Konto und Ihr Computer kann über das Internet auf die relevanten Quellen zugreifen.
- Schwierigkeitsgrad: Einsteigerfreundlich. Sie müssen während des gesamten Ablaufs keinen Code schreiben. Konfigurationsdateien kommen nur in optionalen ausklappbaren Abschnitten vor.
Die folgende Übersicht zeigt den gesamten Ablauf. Zu jedem Schritt gibt es ein Abnahmekriterium. Schließen Sie einen Schritt ab und prüfen Sie, ob das Kriterium erfüllt ist, bevor Sie weitermachen.
| Schritt | Aufgabe | Abnahmekriterium (daran erkennen Sie, dass der Schritt abgeschlossen ist) |
|---|---|---|
| ① Bibliothek anlegen | Eine Obsidian-Bibliothek mit vier Ordnern und einer CLAUDE.md erstellen | Links in Obsidian erscheinen vier Ordner, im Stammverzeichnis liegt eine CLAUDE.md |
| ② Token einrichten | Das APIYI-Token in Claude Code einrichten | Claude Code lässt sich im Bibliotheksordner öffnen und die Unterhaltung funktioniert |
| ③ Subagenten anlegen | Claude Recherche- und Prüfagenten erstellen lassen | Über /agents sind beide Subagenten zu sehen |
| ④ Aufgaben verteilen | Eine Aufgabenliste schreiben und mit einem Satz parallel verteilen | Im Ordner „Originalquellen“ erscheint zu jeder Aufgabe eine Datei mit Auszügen |
| ⑤ Prüfschleife | Überarbeitungen anfordern, höchstens drei Durchläufe | Bestätigte Erkenntnisse landen in „Recherche-Notizen“, nicht bestätigte im Ordner „Zurückgewiesen“ |
| ⑥ Ergebnisse abnehmen | In Obsidian nach geprüften Notizen filtern | Die Notizen enthalten die Eigenschaften status, Quelle, Prüfmodell und Datum |
Zentrale Erkenntnisse aus der Recherche zum Agenten-Schwarm
| Kategorie | Inhalt | Verwendung in diesem Artikel |
|---|---|---|
| Offizielle Dokumentation (Claude Code / Obsidian) | Unteragenten haben einen eigenen Kontext; Tools und Modelle lassen sich festlegen. Parallele Recherche ist eine offiziell dokumentierte Anwendung. WebSearch ist auf maximal 200 Aufrufe pro Sitzung begrenzt, die sich alle Unteragenten teilen. Ein Obsidian-Vault ist ein gewöhnlicher Ordner mit Markdown-Dateien; externe Änderungen werden automatisch aktualisiert. | Grundlage für den Aufbau |
| Einzelner Praxistest eines Drittanbieters | In einem Test-Vault mit 560 Notizen und 15 Fragen beantwortete sogar Claude Code ohne zusätzliche Plugins alle Fragen korrekt und verbrauchte dabei die wenigsten Tokens. | Als Anhaltspunkt dafür, dass für den Einstieg keine Plugins nötig sind; das sagt nichts über die Leistung bei großen Vaults aus. |
| Gerüchte aus dem Netz | Ein 23-jähriger Entwickler, 300 parallele Prozesse, Prüfungen in 100 Millisekunden und null Fehler; außerdem --command-center, REA und JEV aus einem anderen viel beachteten Post. |
Nur die Grundidee aufgreifen. Letztere Begriffe gibt es in der offiziellen CLI-Referenz nicht – nicht einfach übernehmen. |
Warum der Recherche-Schwarm zwei Rollen braucht: „recherchieren“ und „überprüfen“
Wenn man nur die Zahl der Agenten erhöht, aber keine Prüfung einführt, schleichen sich mit zunehmender Parallelisierung auch mehr Halluzinationen ein. Teilt man Recherche und Überprüfung auf zwei Modelle auf, muss der Prüfer nur eine Frage beantworten: Wird die Aussage durch die Originalquelle belegt? Diese Aufgabe ist deutlich einfacher als die Recherche selbst – dafür reicht das günstigere Haiku-Modell.
In den Kommentaren gab es noch einen praktischen Hinweis: Der Prüfer sollte nicht den Denkprozess des Recherche-Agenten sehen, sondern nur die Aussage und den Originaltext. Sonst lässt er sich leicht von der Darstellung des Recherche-Agenten beeinflussen. Außerdem sollte der Prüfer ausschließlich „bestätigt / zurückgewiesen + Begründung“ ausgeben und keine Änderungen selbst vornehmen. Sobald er Inhalte überarbeitet, vermischen sich seine Aufgaben mit denen des Recherche-Agenten. Die Konfiguration in diesem Artikel folgt genau diesen beiden Grundsätzen.
Warum man für den Einstieg in Obsidian weder Plugins noch MCP braucht
Ein Obsidian-Vault ist im Grunde ein Ordner. Die integrierten Lese- und Schreibwerkzeuge von Claude Code können die darin enthaltenen .md-Dateien direkt bearbeiten, und Obsidian aktualisiert die Anzeige automatisch. Im zuvor erwähnten Praxistest eines Drittanbieters – ein kleiner Vault mit 560 Notizen, jedes Tool wurde nur einmal ausgeführt – verbrauchte die Vergleichsgruppe ohne zusätzliche Tools am wenigsten Tokens. Für den Einstieg sind Plugins also nicht nötig. Wie sich das bei größeren Vaults verhält, ist bislang nicht belegt.
Schnellstart: Recherche-Schwarm mit Obsidian und Claude Code
Schritt ①: Vault in Obsidian erstellen und CLAUDE.md anlegen
Öffne Obsidian und wähle „Neuen Vault erstellen“ (einen neuen, leeren Vault anlegen). Nenne ihn 调研库 und wähle einen leicht auffindbaren Speicherort, zum Beispiel den Ordner „Dokumente“. Lege den Vault nicht in den Ordner eines anderen Vaults: Verschachtelte Vaults können dazu führen, dass interne Links nicht mehr funktionieren.
Klicke in der linken Dateiansicht mit der rechten Maustaste auf „Neuer Ordner“ und erstelle nacheinander diese vier Ordner: 任务清单, 原始资料, 调研笔记 und 打回记录.
Lege anschließend im Stammverzeichnis des Vaults eine Notiz namens CLAUDE.md an und trage dort die Regeln für den Vault ein. Claude Code liest diese Datei jedes Mal, wenn es in diesem Verzeichnis gestartet wird:
# 调研库入库规则
1. 只读写这 4 个文件夹:任务清单、原始资料、调研笔记、打回记录。绝不读写 .obsidian 文件夹。
2. 每条结论必须附来源链接和原文摘录(引号原样摘抄)。
3. 没有通过核查员核查的内容,不得写入「调研笔记」。
4. 打回超过 3 轮仍不通过的,写入「打回记录」并注明理由,等人工处理。
5. 调研笔记顶部写属性:status、来源、核查模型、日期。
So sieht es danach aus: In der linken Seitenleiste von Obsidian findest du vier Ordner und eine Datei namens CLAUDE.md. Im Stammverzeichnis gibt es außerdem den Ordner .obsidian, den Obsidian standardmäßig ausblendet. Darin speichert Obsidian seine eigenen Einstellungen. Kein Agent sollte diesen Ordner verändern.
Schritt ②: APIYI-Token für Claude Code einrichten
Die Konfigurationsdetails werden hier nicht noch einmal erklärt. Richte das APIYI-Token über die grafische Oberfläche ein – folge dazu dieser Anleitung: Claude Code, Codex, Pi und Hermes mit magpie über eine grafische Oberfläche verbinden. Kehre anschließend hierher zurück.
Achte nur auf zwei Punkte:
- Wähle beim Erstellen des Tokens in der APIYI-Konsole die Gruppe ClaudeCode.
- Trage als API-Adresse
https://api.apiyi.comein und hänge kein/v1an.
Öffne nach der Einrichtung im Ordner 调研库 ein Terminal und starte Claude Code mit claude. Stelle eine beliebige Frage. Wenn eine normale Antwort kommt, ist die Verbindung hergestellt.
Optional: settings.json manuell bearbeiten (wenn du keine grafische Oberfläche verwenden möchtest)
Bearbeite `~/.claude/settings.json` und trage die folgenden beiden Einträge in das Feld `env` ein. Beachte: Der Variablenname lautet `ANTHROPIC_AUTH_TOKEN`, nicht `ANTHROPIC_API_KEY`:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.apiyi.com",
    "ANTHROPIC_AUTH_TOKEN": "你的 APIYI 令牌"
  }
}
Wenn beim Start immer wieder die Anmeldung auf der offiziellen Website verlangt wird, kannst du in `~/.claude.json` `“hasCompletedOnboarding“: true` ergänzen.
So sieht es danach aus: Claude Code beantwortet Fragen ganz normal. Gleichzeitig wird in der APIYI-Konsole für dieses Token eine Nutzung angezeigt. Das bestätigt, dass die Anfrage tatsächlich über dieses Token gesendet wurde.
Schritt ③: Claude Code mit einem Satz Recherche- und Prüf-Unteragenten erstellen lassen
Unteragenten sind Markdown-Dateien mit einem YAML-Header. Du musst sie nicht selbst schreiben – lass Claude die Arbeit erledigen. Sende Claude Code diesen Text:
请在当前项目的 .claude/agents/ 下创建两个子代理:
1. researcher(调研员):模型 claude-sonnet-5-5。只用 WebFetch 读任务清单里给的链接,
   每条结论附来源链接和原文摘录,把结果写到「原始资料」文件夹。不给 Agent 工具。
2. fact-checker(核查员):模型 claude-haiku-5-5。只给 Read、Grep、Glob,
   不给 Write、Edit、Agent。它只接收“结论 + 原文摘录 + 来源文件路径”,
   不看调研员的推理过程,只输出「通过」或「打回 + 理由」,不得自己修改任何内容。
Die Hauptsitzung verwendet selbst claude-opus-5-5 und ist für die Aufteilung der Fragen, die Zuweisung der Aufgaben und die Zusammenfassung der Ergebnisse zuständig. Du kannst das Modell nach dem Start mit /model wechseln oder es direkt im Tool aus Schritt ② festlegen.
Optional: So sehen die beiden Unteragenten-Dateien aus
`.claude/agents/researcher.md`:
---
name: researcher
description: 按任务清单读取给定链接,产出带来源和原文摘录的调研结论
tools: Read, Grep, Glob, WebFetch, Write
model: claude-sonnet-5-5
maxTurns: 20
---
你是调研员。只读取任务里给出的链接。每条结论格式:
结论 / 来源链接 / 原文摘录(原样引用)。写入「原始资料」文件夹,不碰其他目录。
`.claude/agents/fact-checker.md`:
---
name: fact-checker
description: 逐条核对结论是否被原文摘录支持,只判定不修改
tools: Read, Grep, Glob
model: claude-haiku-5-5
maxTurns: 8
---
你是核查员。只看结论和原文,不接受任何推理说明。
每条输出「通过」或「打回:理由」。摘录不支持、数字对不上、来源缺失一律打回。
你没有写权限,也不得建议替换措辞以外的任何修改。
Hinweis: Nachdem du den Ordner .claude/agents/ zum ersten Mal erstellt hast, musst du die Claude-Code-Sitzung beenden und neu starten. Änderungen an den Unteragenten-Dateien werden danach innerhalb weniger Sekunden automatisch übernommen. Unteragenten ohne Agent-Tool können keine weiteren Unteragenten beauftragen. So vermeidest du unkontrollierte, ineinander verschachtelte Agentenketten.
So sieht es danach aus: Gib /agents ein. In der Liste erscheinen researcher und fact-checker, jeweils mit dem zugehörigen Modell.
Schritt ④: Aufgabenliste erstellen und parallele Recherche mit einem Satz starten
Lege im Obsidian-Ordner 任务清单 eine neue Datei namens 第一批.md an. Hier ein Beispiel mit fünf Produkten. Für jedes Produkt ist direkt der Link angegeben, den der Agent lesen soll. Der Grund: In der offiziellen Dokumentation ist nicht festgehalten, ob WebSearch bei Aufrufen über Drittanbieter-Gateways verfügbar ist. Am zuverlässigsten ist es daher, dem Unteragenten die Links direkt mitzugeben und sie mit WebFetch lesen zu lassen.
# 第一批:5 个产品定价与功能
1. 产品 A:定价页 https://example-a.com/pricing ,功能页 https://example-a.com/features
2. 产品 B:https://example-b.com/pricing
3. 产品 C:https://example-c.com/docs/plans
4. 产品 D:https://example-d.com/pricing
5. 产品 E:https://example-e.com/changelog
每条要回答:最低付费档价格、是否有免费版、最近一次功能更新。
Wechsle zurück zu Claude Code und sende diese Anweisung:
读取 任务清单/第一批.md,把 5 条任务分给 researcher 子代理并行调研,
各自写入「原始资料」。全部完成后告诉我每条的结论数量。
Die fünf Produkte sind nur ein Beispiel. Das Vorgehen ist dasselbe, wenn du Wettbewerber beobachtest, Kernaussagen aus wissenschaftlichen Arbeiten sammelst oder Branchenmeldungen recherchierst: Gib für jede Aufgabe die Links an und nenne klar die Fragen, die beantwortet werden sollen.
So sieht es danach aus: Im Obsidian-Ordner 原始资料 erscheinen nach und nach fünf Dateien. Jede enthält Einträge im Format „Aussage / Quellenlink / Originalauszug“.
Schritt ⑤: Prüfschleife einrichten und höchstens drei Überarbeitungsrunden zulassen
Sende der Hauptsitzung anschließend diese Anweisung:
对「原始资料」里的每条结论,只把“结论 + 原文摘录 + 来源路径”交给 fact-checker。
通过的,由你写入「调研笔记」,顶部属性填 status: 已核查、来源、核查模型: claude-haiku-5-5、日期。
打回的,把理由交给 researcher 重写后再核查,最多 3 轮;
3 轮仍不过的,写入「打回记录」并附理由,不要放进调研笔记。
Das ist die offiziell beschriebene Vorgehensweise mit „verketteten Unteragenten“: Zuerst erledigt Unteragent A seine Aufgabe, anschließend wird das Ergebnis an Unteragent B weitergegeben. Die Hauptsitzung übernimmt dabei die Koordination und kontrolliert genau, welche Informationen der Prüfer erhält: nur die Aussage und den Originaltext, nicht den Denkprozess.
So sieht es danach aus: Im Ordner 调研笔记 findest du geprüfte Aussagen. Im Ordner 打回记录 können einige Einträge mit Begründungen liegen. Das ist normal und zeigt, dass der Prüfer seine Arbeit macht.
Schritt ⑥: Geprüfte Aussagen in Obsidian abnehmen
Öffne eine beliebige Recherche-Notiz. Die Eigenschaften am Anfang sollten etwa so aussehen:
---
status: 已核查
来源: https://example-a.com/pricing
核查模型: claude-haiku-5-5
日期: 2026-10-21
---
Gib [status:已核查] in das Suchfeld von Obsidian ein, um alle erfolgreich geprüften Notizen zu filtern. Bei der Abnahme empfiehlt es sich, zwei oder drei Einträge stichprobenartig auszuwählen, die Quellenlinks zu öffnen und den Originaltext selbst zu überprüfen.
So sieht es danach aus: Jede Aussage in den Suchergebnissen lässt sich bis zur Originalquelle zurückverfolgen. Verdächtige Inhalte sind im Ordner 打回记录 gesammelt und warten dort auf deine manuelle Prüfung.
Aufgabenverteilung und Preise der drei Modelle im Recherche-Schwarm
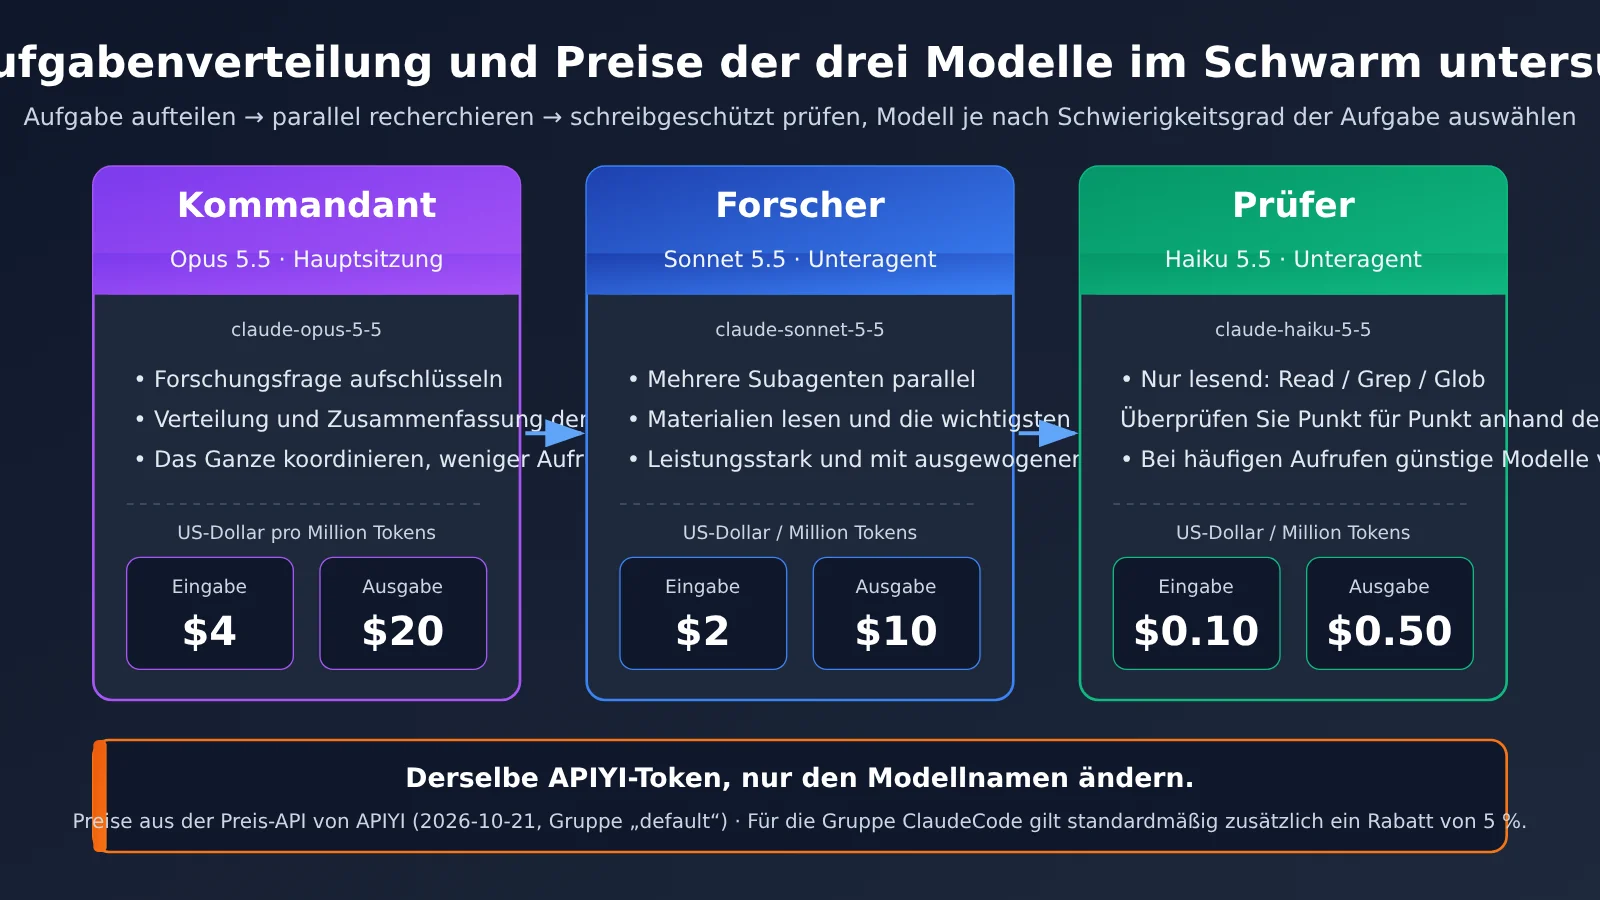
Alle drei Rollen verwenden denselben APIYI-Schlüssel. Der einzige Unterschied ist der Modellname. Die folgende Tabelle zeigt die Preise aus der APIYI-Preisschnittstelle vom 21.10.2026 (Gruppe „default“). In der Gruppe „ClaudeCode“ gibt es standardmäßig zusätzlich 5 % Rabatt.
| Rolle | Modellname | Eingabe (US-Dollar pro Million Tokens) | Ausgabe (US-Dollar pro Million Tokens) | Warum diese Wahl? |
|---|---|---|---|---|
| Hauptsitzung: Aufgaben aufteilen und Ergebnisse zusammenführen | claude-opus-5-5 |
4 | 20 | Muss den Überblick behalten; wird nur selten aufgerufen |
| Rechercheur: Quellen parallel lesen | claude-sonnet-5-5 |
2 | 10 | Stark beim Lesen und Zusammenfassen, ausgewogenes Preis-Leistungs-Verhältnis |
| Prüfer: Aussagen einzeln auf ihren Wahrheitsgehalt prüfen | claude-haiku-5-5 |
0.10 | 0.50 | Einfache Aufgabe mit häufigen Aufrufen – dafür eignet sich ein günstiges Modell |
Bei den Kosten gibt es ein paar wichtige Punkte: Je mehr Subagenten eingesetzt werden, desto länger fallen ihre Ergebnisse aus und desto mehr Kontext belegen sie in der Hauptsitzung. Außerdem verbraucht jeder Subagent während seiner Ausführung separat Tokens.
Fehlerbehebung: Häufige Probleme mit dem Recherche-Schwarm
| Symptom | Häufige Ursache | Lösung |
|---|---|---|
| Unteragenten werden nicht aufgerufen | Nach dem erstmaligen Anlegen des Verzeichnisses agents wurde die Sitzung nicht neu gestartet; die Beschreibung ist zu ungenau |
Claude Code beenden und neu starten; beim Zuweisen ausdrücklich „Nutze den Unteragenten researcher“ angeben |
| Der Prüfer ändert selbst Inhalte | In tools sind Write oder Edit enthalten oder der Prüfer hat alle Tools geerbt |
fact-checker.md öffnen und prüfen, ob unter tools ausschließlich Read, Grep und Glob aufgeführt sind |
Dateien landen im Ordner .obsidian |
CLAUDE.md liegt nicht im Stammverzeichnis des Vaults oder die Regeln sind nicht eindeutig formuliert |
CLAUDE.md ins Stammverzeichnis verschieben und die Regel „.obsidian niemals lesen oder beschreiben“ ergänzen |
| Fehler 401 | Das Token ist falsch, gehört nicht zur Gruppe ClaudeCode oder es wurde die Variable API_KEY verwendet |
Token erneut kopieren, Gruppe überprüfen und den Variablennamen in AUTH_TOKEN ändern |
| Fehler bei der Anfrage-URL | Am Ende der Adresse steht zusätzlich /v1 |
Auf https://api.apiyi.com ändern |
WebSearch ist nicht verfügbar |
Es ist nicht offiziell dokumentiert, ob die Funktion über Drittanbieter-Gateways unterstützt wird; oder das Sitzungslimit von 200 Anfragen ist erreicht | Links direkt in die Aufgabenliste aufnehmen und stattdessen WebFetch verwenden; mit /clear ein neues Gespräch starten |
| Neue Notizen sind in Obsidian nicht sichtbar | Claude Code hat in ein anderes Verzeichnis geschrieben oder es ist ein anderer Vault geöffnet | Claude Code fragen: „In welchen absoluten Pfad hast du gerade geschrieben?“ und den Pfad mit dem Vault-Verzeichnis abgleichen |
Wenn Sie nicht sicher sind, welche Tools in der aktuellen Sitzung verfügbar sind, fragen Sie Claude einfach: „Welche Tools stehen dir gerade zur Verfügung?“ Claude listet sie dann auf.
Wann Sie Obsidian und Claude Code nicht für einen Recherche-Schwarm nutzen sollten
Diese Kombination verursacht einen gewissen Grundaufwand und eignet sich nicht für alle Situationen. In den folgenden Fällen ist ein direktes Gespräch mit Claude einfacher:
- Sie möchten nur ein oder zwei Informationen nachschlagen: Der Aufwand für Aufteilung, Zuweisung und Prüfung ist größer als der Rechercheaufwand selbst.
- Alle Informationen stehen in einem einzigen Artikel: Lassen Sie Claude den Artikel direkt lesen und zusammenfassen. Eine parallele Bearbeitung ist nicht nötig.
- Sie benötigen Echtzeitdaten: Aktienkurse oder aktuelle Wechselkurse lassen sich besser über spezielle Datenschnittstellen abrufen. Beim Lesen von Webseiten besteht die Gefahr, veraltete Informationen zu erhalten.
- Das Budget ist knapp: Mehrere Unteragenten verbrauchen entsprechend mehr Tokens. Es ist günstiger, die Anforderungen zunächst in einer einzelnen Sitzung zu klären.
Obsidian und Claude Code: Kurzreferenz für Recherche-Schwärme
Speichern Sie diese Tabelle und nutzen Sie sie als Orientierung, wenn Sie eine neue Recherche starten.
| Punkt | Wert oder Vorgehen |
|---|---|
| Ordnerstruktur | Aufgabenliste / Rohmaterial / Recherchenotizen / Rückmeldungen zu abgelehnten Ergebnissen + CLAUDE.md im Stammverzeichnis |
| API-Endpunkt | https://api.apiyi.com (ohne /v1) |
| Token | APIYI-ClaudeCode-Gruppe; ein Token für alle drei Modelle |
| Aufgabenverteilung der Modelle | Hauptsitzung opus-5-5 / Recherche sonnet-5-5 / Prüfung haiku-5-5 |
| Werkzeuge der Prüfinstanz | Nur Read, Grep und Glob, kein Write, Edit oder Agent |
| Prüfkriterien | Nur Schlussfolgerung und Originaltext prüfen; ausschließlich „freigegeben“ oder „zur Überarbeitung zurück“ ausgeben; höchstens 3 Runden |
| Internetzugriff | Links in die Aufgabenliste aufnehmen und WebFetch verwenden; WebSearch ist mit 200 Aufrufen pro Sitzung für alle gemeinsam begrenzt |
| Filtern | In Obsidian nach [status:geprüft] suchen |
| Kosten im Blick behalten | Zuerst 3 Aufgaben testweise ausführen, dann den Tokenverbrauch in der APIYI-Konsole prüfen |
Häufige Fragen
F1: Was ist ein „Recherche-Schwarm“?
Ein Recherche-Schwarm ist eine Arbeitsweise, bei der mehrere KI-Subagenten gleichzeitig verschiedene Quellen recherchieren und ein weiteres Modell die Ergebnisse anschließend einzeln überprüft. Die hier beschriebene Variante besteht aus einer Hauptsitzung, 2–3 Rechercheagenten und einer Prüfinstanz. Sie ist zwar klein, setzt aber bereits das vollständige Prinzip um: Recherche und Faktenprüfung werden getrennt.
F2: Stimmt die im Netz kursierende Behauptung von 300 Claude-Code-Aufgaben ohne Fehler?
Das lässt sich nicht überprüfen. Die Angaben zur Identität des Entwicklers, zu 300 parallelen Aufgaben, 100 Millisekunden und null Fehlern stammen ausschließlich aus dem ursprünglichen Beitrag. Auch die Zahlen unterscheiden sich in den verschiedenen Wiedergaben. Dieser Artikel übernimmt lediglich den Ansatz, ein teureres Modell für die Arbeit und ein günstigeres für die Prüfung einzusetzen.
F3: Wie aktiviere ich den im Beitrag erwähnten Kommandantenmodus `–command-center`?
Das geht nicht. In der offiziellen CLI-Referenz von Claude Code gibt es diesen Parameter nicht. Auch REA und JEV sind keine offiziellen Funktionen. Wenn Sie Aufgaben parallel ausführen möchten, verwenden Sie die offiziellen Subagenten. Für längere Ausführungen empfiehlt die offizielle Dokumentation stattdessen Background Agents (`claude agents`).
F4: Muss ich ein Obsidian-Plugin oder MCP installieren?
Für den Einstieg nicht. Ein Drittanbieter hat einen einzelnen Test mit einer kleinen Bibliothek aus 560 Notizen durchgeführt. Claude Code beantwortete dabei auch ohne zusätzliche Installation alle Fragen richtig und verbrauchte am wenigsten Tokens. Wie gut es mit größeren Bibliotheken funktioniert, ist bisher nicht belegt.
F5: Muss ich für die drei Modelle separate Tokens beantragen?
Nein. Erstellen Sie auf APIYI apiyi.com ein Token für die ClaudeCode-Gruppe. Die Hauptsitzung und beide Subagenten verwenden dasselbe Token. In den jeweiligen Konfigurationen müssen Sie lediglich unterschiedliche Modellnamen angeben.
F6: Wie kann ich feststellen, wie viel diese Recherche gekostet hat?
Melden Sie sich in der APIYI-Konsole an und prüfen Sie den Verbrauch und die Protokolle für das betreffende Token. Es empfiehlt sich, zunächst drei kleinere Aufgaben auszuführen und den tatsächlichen Verbrauch zu prüfen, bevor Sie den Umfang erhöhen.
F7: Sind Fehler ausgeschlossen, wenn ich eine Prüfinstanz hinzufüge?
Nein. Die Prüfinstanz kann nur beurteilen, ob die Schlussfolgerung mit den Auszügen übereinstimmt. Fehler im Originaltext oder eine verzerrte Auswahl der Auszüge erkennt sie nicht unbedingt. Deshalb empfiehlt es sich, in Schritt ⑥ einige Ergebnisse stichprobenartig selbst zu prüfen und regelmäßig die Rückmeldungen zu abgelehnten Ergebnissen durchzugehen.
Die wichtigsten Erkenntnisse zum Recherche-Schwarm
- Die Strategie ist wichtiger als die Anzahl: Ein leistungsstarkes Modell übernimmt die Arbeit, ein günstigeres prüft die Ergebnisse. Wie viele Agenten beteiligt sind, ist nicht entscheidend.
- Eine Wissensdatenbank ist einfach ein Ordner: Claude Code kann Markdown-Dateien direkt lesen und bearbeiten. Für den Einstieg sind keine Plugins nötig.
- Prüfer müssen schreibgeschützt arbeiten: Sie erhalten keine Write-, Edit- oder Agent-Berechtigungen und geben nur „bestanden“ oder „zur Überarbeitung“ zurück.
- Denkprozesse voneinander trennen: Der Prüfer sieht nur das Ergebnis und die Originalquelle. So lässt er sich nicht von den Recherche-Agenten beeinflussen.
- Links mit WebFetch abrufen: So umgehen Sie das Limit von WebSearch und müssen sich keine Gedanken darüber machen, ob das Gateway die Funktion unterstützt.
- Nach drei erfolglosen Runden an einen Menschen übergeben: Halten Sie die Rückläufe fest, statt unfertige Ergebnisse in die Wissensdatenbank zu übernehmen.
- Kosten erst nach einem Testlauf bewerten: Prüfen Sie im Dashboard den tatsächlichen Verbrauch desselben APIYI-Tokens.
Zusammenfassung
Für einen Recherche-Schwarm mit Obsidian und Claude Code sind drei Punkte entscheidend:
- Klare Struktur: vier Ordner und eine CLAUDE.md-Datei, in der geregelt ist, wer wo schreiben darf.
- Getrennte Zuständigkeiten: Sonnet recherchiert, Haiku prüft und Opus koordiniert. Der Prüfer hat keine Schreibrechte.
- Geschlossener Freigabeprozess: Nur freigegebene Ergebnisse landen in den Recherchenotizen. Abgelehnte Ergebnisse werden zur Überarbeitung zurückgegeben. Scheitern drei Runden, übernimmt ein Mensch.
Am besten testen Sie zunächst den gesamten Ablauf mit drei kleinen Aufgaben. Prüfen Sie, ob Dateien am richtigen Ort landen, die Ergebnisse zuverlässig kontrolliert werden und die Kosten Ihren Erwartungen entsprechen. Ersetzen Sie anschließend die Beispiele durch Ihre eigenen Themen – etwa Wettbewerbsbeobachtung, Fachartikel oder Branchennews. Für die Anbindung der Modelle können Sie direkt ein Claude-Code-Gruppentoken von APIYI unter apiyi.com verwenden. Alle drei Modelle nutzen dasselbe Token, was den Wechsel erleichtert.
📚 Referenzen
- Dokumentation zu Claude-Code-Subagenten: Erstellung von Subagenten, Tool-Berechtigungen, Modellfelder und parallele Recherche
- Link:
code.claude.com/docs/en/sub-agents -
Hinweis: Die wichtigste Grundlage für die Konfiguration der Subagenten in diesem Artikel
-
Referenz zu Claude-Code-Tools: Funktionsweise und Nutzungslimits von WebSearch und WebFetch
- Link:
code.claude.com/docs/en/tools-reference -
Hinweis: Erklärt, warum es sinnvoll ist, Links direkt in die Aufgabenliste aufzunehmen
-
Claude-Code-Modellkonfiguration: Modell-Aliase und vollständige Modellnamen
- Link:
code.claude.com/docs/en/model-config -
Hinweis: Bestätigt, welche Versionen den Bezeichnungen Opus, Sonnet und Haiku entsprechen
-
Obsidian-Hilfedokumentation: Tresore und Dateispeicherung
- Link:
obsidian.md/help -
Hinweis: Bestätigt, dass ein Tresor ein gewöhnlicher Ordner ist und externe Änderungen automatisch aktualisiert werden
-
Praxistest eines Drittanbieters: Vergleich von Obsidian-KI-Tools (kleiner Tresor mit 560 Artikeln, ein Testlauf)
- Link:
agentskillshub.top/best/obsidian-second-brain/ -
Hinweis: Referenz für den Einstieg ohne Plugins
-
Dokumentation zur Anbindung von Claude Code an APIYI
- Link:
docs.apiyi.com/scenarios/programming/claude-code - Hinweis: Erläuterungen zu Claude-Code-Gruppen, Adressen und Umgebungsvariablen
Autor: Technisches Team von APIYI
Technischer Austausch: Wenn während der Einrichtung Fragen auftauchen, schreiben Sie gerne einen Kommentar. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum von APIYI unterdocs.apiyi.com.