Nota do autor: um modelo parecer “menos inteligente” não significa necessariamente que ele tenha sido substituído. A partir da pesquisa recente da Anthropic sobre provas de inferência com o FlashProve, este artigo organiza os fatores que afetam os resultados das chamadas de API em uma sequência de investigação, do lado do cliente ao servidor.
“A mesma questão é resolvida no site oficial, mas trava quando uso a API”, “o modelo ficou visivelmente menos inteligente este mês”: quase todo desenvolvedor que integra um Modelo de Linguagem Grande via API já ouviu reclamações assim. A primeira reação de muita gente é pensar: será que trocaram o modelo nos bastidores?
Recentemente, a Anthropic lançou o FlashProve, um protótipo de pesquisa de código aberto que tenta usar provas criptográficas para verificar se “esta resposta realmente veio de um conjunto específico de pesos”. Isso abriu caminho para verificar matematicamente se o modelo foi substituído.
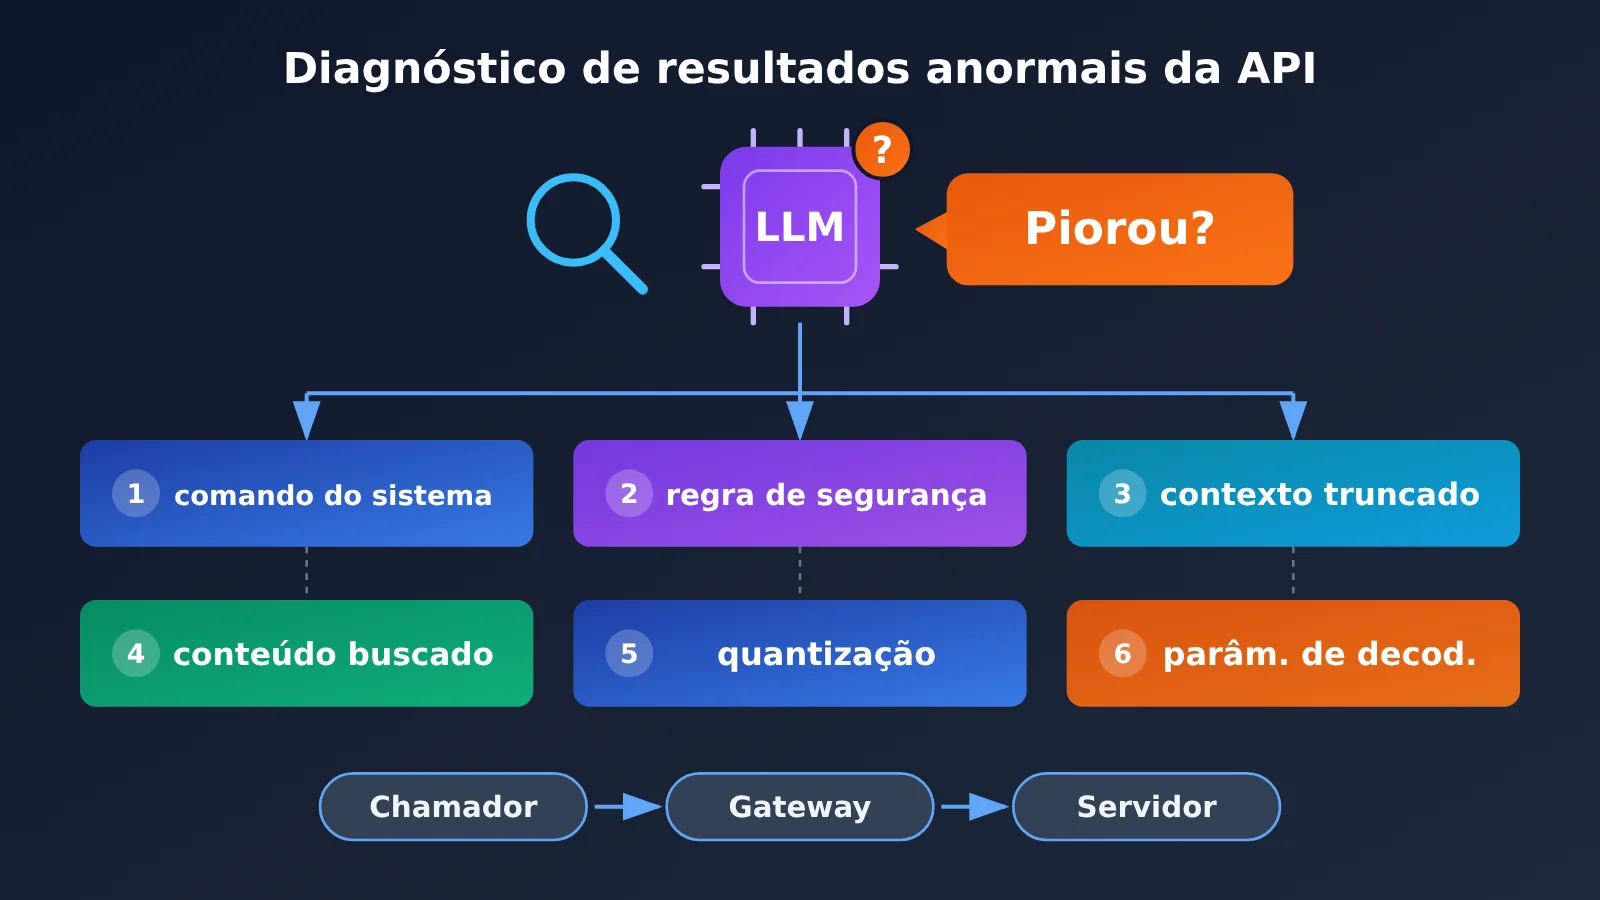
Mas isso não encerra a investigação sobre a queda de desempenho. A própria pesquisa aponta que, mesmo depois de confirmar a identidade dos pesos, os comandos de sistema, as políticas de segurança, o truncamento de contexto, o conteúdo recuperado, o método de quantização e os parâmetros de decodificação ainda podem afetar o resultado. A experiência da equipe do Kimi também mostra que uma parcela considerável das anomalias em benchmarks vem do uso incorreto dos parâmetros de decodificação.
O que você vai encontrar aqui: uma lista de verificação para quando o modelo parecer menos inteligente, com orientações sobre o que você pode investigar por conta própria, o que exige a colaboração do provedor e por que “fazer algumas perguntas para identificar o modelo” não é confiável.
O modelo ficou menos inteligente? Visão geral para investigar
Primeiro, vamos entender o contexto da discussão. Ela começou com uma pesquisa da Anthropic sobre “inferência verificável” e levantou uma pergunta central na comunidade: de quem é a culpa quando um modelo parece ter ficado menos inteligente?
| Item | Detalhes |
|---|---|
| Responsável | Equipe de pesquisa da Anthropic, que também publicou o código, o relatório técnico e as provas formais em Lean |
| Conteúdo principal | FlashProve: gera provas criptográficas da inferência do modelo com base em provas sucintas de conhecimento zero zkSNARK |
| Problema que resolve | Permite verificar se a saída veio dos pesos especificados, sem divulgá-los e sem que o usuário precise executar o modelo novamente |
| Problema que não resolve | Mudanças no produto, como comando de sistema, políticas de segurança, contexto e parâmetros de decodificação |
| Lição para desenvolvedores | É preciso investigar anomalias no desempenho do modelo por camadas, sem focar apenas em uma possível substituição |
Como o FlashProve comprova a identidade do modelo
O FlashProve funciona em duas etapas. Primeiro, o provedor gera um “compromisso” para os pesos do modelo: uma espécie de impressão digital criptográfica que identifica esses pesos sem revelá-los. Em seguida, o provedor gera uma prova para determinada entrada e saída. Com o compromisso, o comando, a resposta e o arquivo de prova em mãos, o usuário pode verificar no próprio computador se aquela saída foi realmente calculada usando os pesos identificados.
O mecanismo de conhecimento zero garante que o verificador não tenha acesso aos pesos nem aos valores intermediários dos cálculos e também não veja quais especialistas foram invocados em cada camada de um modelo MoE. Isso é muito mais confiável do que pedir para o próprio modelo se identificar: o nome na resposta deixa de servir como prova de identidade, e o que se verifica é a relação computacional entre a saída e os pesos.
A Anthropic fez o experimento com o Llama 4 Maverick, cujos pesos de 4 bits são públicos. Trata-se de um modelo de mistura de especialistas com cerca de 400 bilhões de parâmetros, dos quais aproximadamente 17 bilhões são ativados por token. Estes foram os principais resultados divulgados:
| Métrica | Resultado do experimento | Observação |
|---|---|---|
| Taxa de geração de provas | Cerca de 110 tokens/segundo em uma única H100 | É a velocidade de geração da prova, não da resposta no chat |
| Tamanho do arquivo de prova | Cerca de 19 MB por solicitação de 1.024 tokens | Precisa ser enviado junto com a resposta |
| Tempo de verificação | Cerca de 17 segundos em uma CPU de 24 threads | Não exige GPU e pode ser feita em um notebook |
| Geração do compromisso dos pesos | Cerca de 39 minutos | Só precisa ser feita uma vez |
| Custo adicional | Tempo de GPU cerca de 70 a 95 vezes maior que na inferência comum com vLLM | A adoção em larga escala ainda está distante |
Por que o modelo ainda pode parecer menos inteligente mesmo com os pesos confirmados
O FlashProve tem um pré-requisito importante: o usuário precisa saber de antemão qual é o compromisso do “modelo original”. Se o provedor só puder provar que a resposta veio de um modelo escolhido por ele, mas o usuário não puder confirmar que esse é o modelo contratado, a prova não resolve o problema de identidade. O ideal seria que o fabricante do modelo ou uma instituição confiável publicasse o compromisso, permitindo que o usuário verificasse sempre essa mesma impressão digital.
Mais importante: pesos iguais não significam que o serviço permaneceu igual. Uma prova vinculada aos pesos não responde automaticamente se o comando de sistema foi alterado, se o contexto foi truncado ou se os parâmetros de decodificação continuam os mesmos. É por isso que reclamações de que um modelo ficou menos inteligente continuam aparecendo: muitas vezes, elas resultam de mudanças acumuladas em várias etapas.
6 causas comuns para um modelo parecer menos inteligente
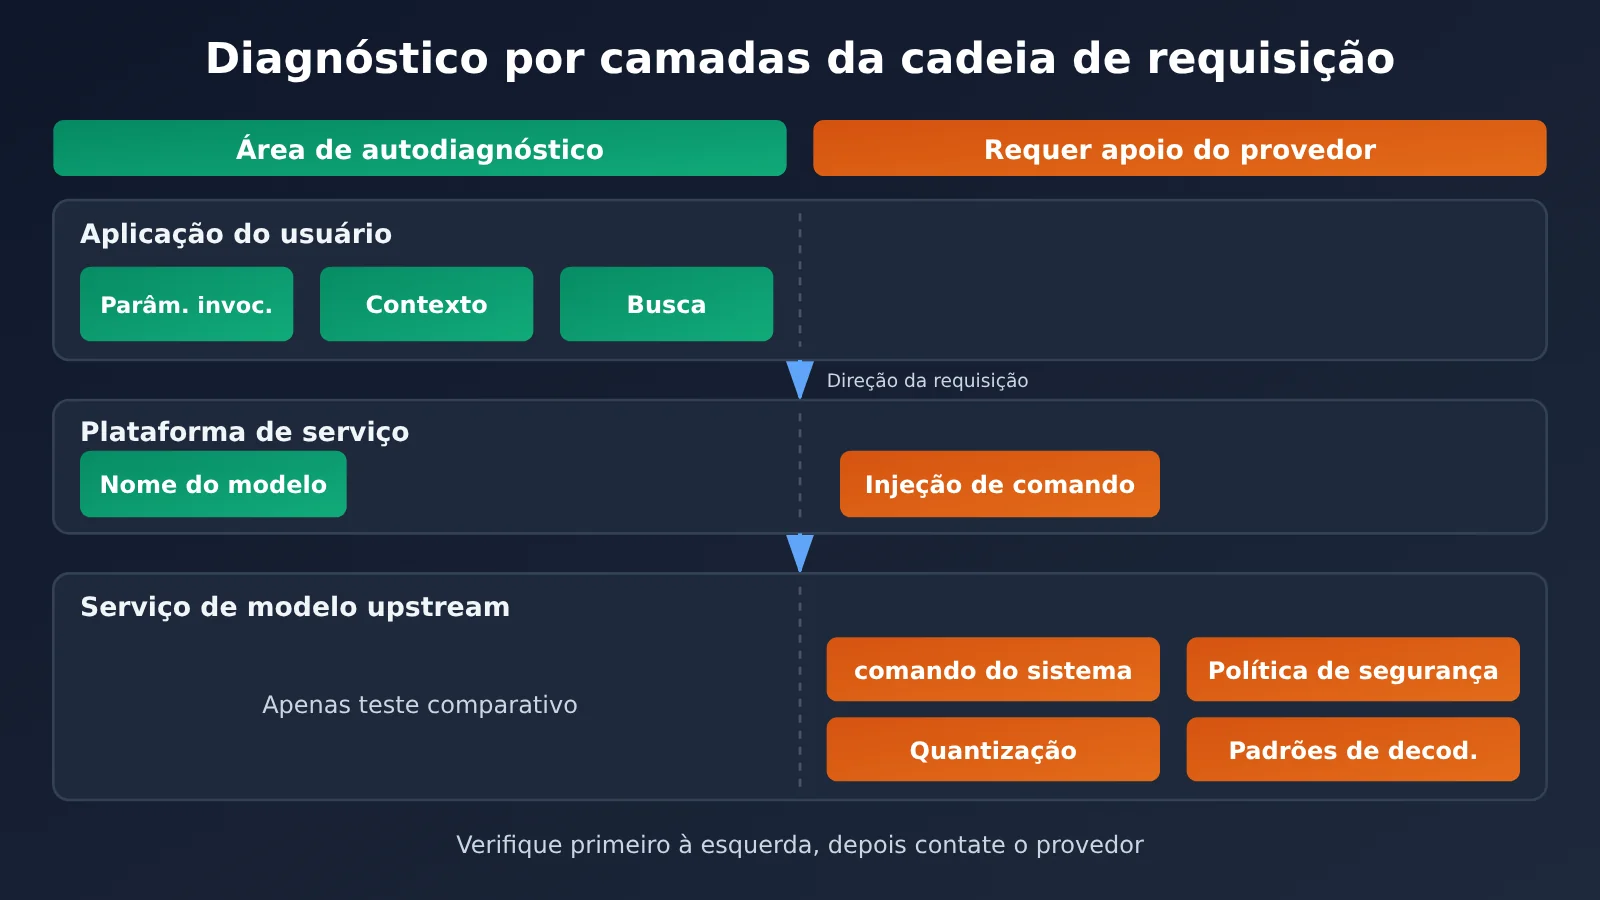
Ao analisar os fatores apontados na pesquisa de referência e classificá-los conforme onde o problema pode estar, fica claro que uma boa parte deles está nas mãos de quem faz a chamada.
| Fator | Sinais típicos | Onde pode ocorrer | O usuário pode verificar? |
|---|---|---|---|
| Parâmetros de decodificação | Saídas dispersas ou repetitivas, pontuação baixa no modo de raciocínio | Principalmente no lado de quem faz a chamada, mas o servidor também pode definir valores padrão | Sim, verificando os parâmetros da requisição |
| Truncamento de contexto | “Esquecimento” do que foi dito antes, respostas incompletas, instruções ignoradas | Tanto no lado de quem faz a chamada quanto no servidor | Em parte, verificando o uso de tokens |
| Comando de sistema | Mudança de estilo, mais recusas, formato incorreto | Inserido por quem faz a chamada ou pelo servidor | É possível verificar o próprio comando, mas não o do servidor |
| Política de segurança | Certos tipos de pergunta passam a ser recusados ou recebem respostas mais conservadoras | Principalmente no servidor | É difícil; o provedor precisa esclarecer |
| Conteúdo recuperado | Oscilação na qualidade das respostas em cenários de RAG | No fluxo de recuperação de quem faz a chamada | Sim, verificando o conteúdo recuperado |
| Método de quantização | Pequena queda geral de capacidade, mais erros em raciocínios longos | Na implantação do servidor | Não, é necessária a colaboração do provedor |
Uso incorreto dos parâmetros de decodificação: uma causa fácil de ignorar
Ao apresentar o Kimi Vendor Verifier, a equipe do Kimi compartilhou uma descoberta bastante ilustrativa: desde o lançamento do K2 Thinking, recebeu vários relatos da comunidade sobre pontuações fora do esperado. Após investigar, confirmou que uma parte considerável vinha do uso incorreto dos parâmetros de decodificação. A equipe então restringiu os parâmetros relevantes no modo Thinking e verificou se o conteúdo do raciocínio estava sendo retornado corretamente.
A lição para desenvolvedores é direta: se parâmetros como temperature, top_p, max_tokens e a ativação do modo de raciocínio não seguirem as recomendações oficiais, o desempenho do modelo pode ficar bem distante do esperado. Isso vale especialmente para modelos de raciocínio: cada fornecedor tem suas próprias exigências para parâmetros de amostragem, orçamento de raciocínio e forma de retornar o conteúdo do raciocínio em conversas com múltiplos turnos. Consulte a documentação oficial de cada modelo para obter os valores adequados, em vez de reutilizar a configuração habitual de modelos de conversa.
Contexto incompleto: quando o modelo parece ter “perdido a memória”
Outro problema frequente está no contexto. Se, em uma conversa com múltiplos turnos, apenas a mensagem mais recente for enviada, naturalmente o modelo não vai “se lembrar” do que veio antes. Em um fluxo de trabalho, se o histórico de mensagens ultrapassar a janela de contexto do modelo, as primeiras instruções de sistema costumam ser truncadas. O resultado é que o modelo, de repente, deixa de seguir o formato solicitado. Além disso, um valor de max_tokens muito baixo pode cortar a resposta no meio, dando a impressão de que ela “parou pela metade”.
Todos esses problemas podem dar a impressão de que o modelo ficou menos inteligente. Mas, ao verificar o corpo da requisição e o motivo de encerramento na resposta, na maioria das vezes é possível identificar a causa na hora.
O modelo ficou menos inteligente? Como investigar em 3 passos
Como as causas podem estar em diferentes pontos da cadeia de chamadas, comece pelos itens mais fáceis de controlar e com menor custo de verificação. Siga esta ordem:
- Verifique primeiro a aplicação que faz a chamada: confira o nome do model, os parâmetros de decodificação, max_tokens, o comando de sistema, a lista completa de mensagens e o conteúdo recuperado pelo RAG.
- Faça um teste comparativo: mantenha os parâmetros e comandos fixos e compare os resultados com os do canal oficial ou com o desempenho descrito na documentação oficial. Execute o teste várias vezes para observar a distribuição dos resultados, em vez de tirar conclusões de uma única execução.
- Por último, avalie o servidor: se a configuração da aplicação estiver correta e a diferença no teste comparativo for consistente e reproduzível, entre em contato com o fornecedor levando os registros das requisições e os resultados dos testes.
Exemplo minimalista: uma chamada reproduzível com parâmetros fixos
O primeiro passo mais prático é definir todos os parâmetros explicitamente, sem depender de valores padrão, e imprimir o motivo da finalização e o consumo de tokens:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Substitua pelo nome do modelo que você quer investigar
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
Se finish_reason for length, a resposta foi cortada por causa de max_tokens. Nesse caso, a resposta incompleta não significa que o modelo ficou menos capaz: o problema está na configuração. O número de tokens de entrada em usage também ajuda a verificar se todo o contexto foi enviado.
Ver o script completo de teste comparativo
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Para trocar de modelo, basta alterar o parâmetro model
)

# Defina todos os parâmetros explicitamente para não depender de valores padrão
PARAMS = {
    "temperature": 0.2,   # Para modelos de raciocínio, use o valor recomendado na documentação oficial
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """Executa o mesmo caso várias vezes e contabiliza a taxa de acerto, os cortes e o consumo de tokens"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # Substitua pelo modelo que será investigado
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
O mais importante nesse script não são as perguntas do teste, mas três pontos: manter todos os parâmetros fixos e incluí-los no relatório; executar o mesmo caso várias vezes para verificar a taxa de acerto; e registrar finish_reason e prompt_tokens para descartar problemas de corte e de contexto. Só depois de descartar essas três possibilidades vale investigar se houve alguma mudança no servidor.
🚀 Dica de diagnóstico: a APIYI apiyi.com usa uma interface compatível com a OpenAI. Para trocar de modelo, basta alterar o parâmetro
model, o que facilita a comparação de vários modelos com o mesmo script de teste. A plataforma oferece logs de chamadas e estatísticas de uso, que permitem consultar o consumo das requisições e de tokens e ajudam a verificar se o contexto foi enviado por completo. Para saber quais campos aparecem nos logs, consulte a página do console da plataforma.
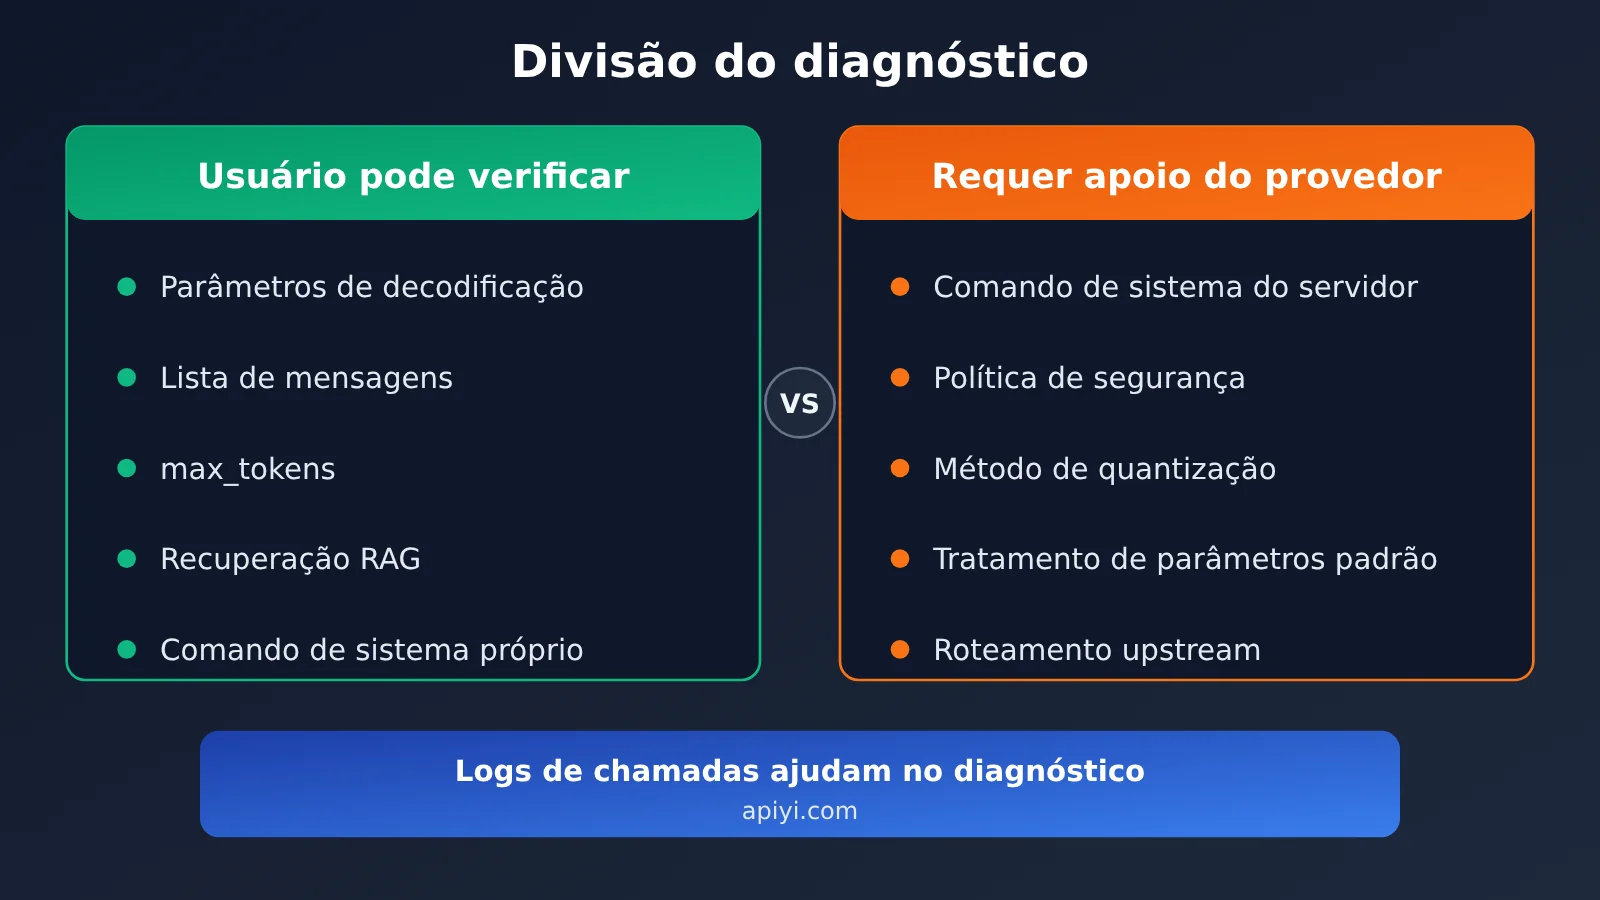
O que você pode verificar e quando precisa do provedor
| Item a verificar | Como verificar por conta própria | Informações necessárias do provedor |
|---|---|---|
| Parâmetros de decodificação | Imprima o corpo completo da requisição e compare com a documentação oficial | Se a plataforma altera parâmetros ou preenche valores padrão |
| Integridade do contexto | Confira a lista de mensagens e o prompt_tokens | Se há truncamento no servidor ou limite de janela de contexto |
| Modo de raciocínio | Confira a ativação do raciocínio e como seu conteúdo é retornado | Se o upstream oferece suporte aos parâmetros correspondentes |
| Quantização e implantação | Não é possível verificar por conta própria | Precisão da implantação e informações sobre o canal upstream |
| Políticas de segurança | Compare o resultado da mesma requisição no canal oficial | Se foram adicionadas regras extras de moderação |
Ao entrar em contato com o provedor, leve uma amostra da requisição com parâmetros fixos, os resultados estatísticos de várias execuções e os dados de comparação. Isso torna a conversa muito mais produtiva. Dizer apenas “o modelo ficou mais burro” dificulta a identificação do problema.
Por que fazer algumas perguntas não é uma forma confiável de identificar se o modelo piorou
Um método popular na comunidade é perguntar ao modelo algo que só a versão mais recente saberia e, se ele não responder, concluir que “trocaram o modelo”. O problema é que cada resposta envolve aleatoriedade: um erro ocasional, parâmetros diferentes, falta de contexto ou diferenças no roteamento interno do fornecedor podem levar à mesma conclusão: “Este não é o modelo que eu pedi”.
O projeto de pesquisa Model Equality Testing, da Universidade Stanford, oferece uma perspectiva mais rigorosa. Os pesquisadores testaram 31 endpoints comerciais de API de quatro modelos Llama em 2024 e descobriram que, em 11 deles, a distribuição das saídas apresentava diferenças estatísticas em relação à distribuição de referência dos pesos publicados pela Meta. O ponto importante é que o método compara a distribuição das saídas, em vez de verificar apenas se uma ou duas respostas estão certas.
Para desenvolvedores, vale adotar essa abordagem estatística: usar parâmetros fixos, vários casos de teste e múltiplas execuções para observar diferenças consistentes. É por isso que o script de comparação apresentado acima usa a “taxa de acerto”, e não o “resultado de uma única execução”.
Análise dos impactos da percepção de que o modelo piorou
Impactos para desenvolvedores
- Comece a investigação mais cedo: diante de resultados inesperados, confira primeiro o corpo da requisição. Erros de parâmetros e falta de contexto são os pontos mais baratos de verificar e com maior chance de explicar o problema.
- Defina os parâmetros explicitamente: em produção, não dependa de valores padrão. Configure especialmente os modelos de raciocínio conforme a documentação oficial e inclua os parâmetros no controle de versão.
- Crie um conjunto de testes de regressão: mantenha casos fixos e execute-os periodicamente. Assim, se o modelo parecer pior, você terá dados em vez de depender apenas da impressão.
- Guarde registros das invocações: parâmetros da requisição, consumo de tokens e motivo de encerramento são evidências importantes na comunicação com o fornecedor.
Impactos para o setor
- Da impressão à comprovação: o FlashProve mostra um caminho para verificar a identidade dos pesos. No futuro, fornecedores de modelos, instituições de avaliação e órgãos reguladores poderão usá-lo para confirmar qual modelo está sendo servido.
- A exigência de transparência vai crescer: além dos pesos, a consistência dos comandos de sistema, das estratégias de decodificação e das configurações de implantação deve ganhar espaço nas discussões.
- A adoção ainda levará tempo: o custo da prova é de dezenas de vezes o de uma inferência comum. Também são necessários suporte a contextos mais longos e um mecanismo confiável de publicação de compromissos, o que dificulta seu uso nas invocações cotidianas no curto prazo.
Perguntas frequentes FAQ
Q1: Se o modelo parece ter ficado menos inteligente, o que devo verificar primeiro?
Comece pela própria requisição: confira se o nome em model está correto, se os parâmetros de decodificação, como temperature, seguem as recomendações oficiais, se max_tokens não está muito baixo e se o histórico completo está sendo enviado nas conversas com várias rodadas. A experiência da equipe Kimi mostra que boa parte dos resultados anormais em testes vem do uso incorreto dos parâmetros de decodificação, então essa verificação costuma trazer resultados rapidamente.
Q2: O FlashProve resolve de vez a discussão sobre modelos que ficaram menos inteligentes?
Não. Ele consegue verificar se a saída veio dos pesos especificados, mas isso pressupõe que exista um compromisso confiável com o modelo para comparação. Comandos de sistema, políticas de segurança, truncamento de contexto, métodos de quantização e parâmetros de decodificação não são automaticamente cobertos por uma prova de pesos.
Q3: Como fazer um teste comparativo confiável?
Mantenha todos os parâmetros e comandos fixos, prepare vários casos com respostas claras e execute cada um várias vezes para calcular a taxa de acerto. Registre também finish_reason e o consumo de tokens. Com a APIYI apiyi.com, você pode usar o mesmo código compatível com OpenAI para comparar vários modelos. Novos usuários recebem créditos gratuitos que podem ser usados nesse tipo de teste.
Q4: Por que um modelo de raciocínio pode ter desempenho pior na API do que na versão web?
Entre as causas comuns estão o modo de pensamento desativado ou um orçamento de pensamento configurado de forma diferente, parâmetros de amostragem que não seguem as recomendações oficiais, o envio incorreto do conteúdo de pensamento nas conversas com várias rodadas e a ausência, na API, dos comandos de sistema e das ferramentas disponíveis na versão web. Vale conferir cada item nas instruções de API da documentação oficial do modelo.
Q5: Depois de conferir tudo, como conversar com o provedor?
Prepare amostras de requisições com parâmetros fixos, resultados estatísticos de várias execuções, dados comparativos dos canais oficiais e os períodos em que ocorreram as anomalias. No console da APIYI apiyi.com, você pode consultar os registros de invocação e as estatísticas de uso. Fornecer esses registros junto com as demais informações pode reduzir bastante o tempo necessário para identificar a causa.
O modelo ficou menos inteligente? Pontos principais
- Uma queda de desempenho não significa necessariamente que o modelo foi substituído: o comando de sistema, o contexto e os parâmetros de decodificação também afetam os resultados.
- Erros de configuração são comuns: a equipe do Kimi confirmou que uma parcela considerável dos resultados anormais em benchmarks veio do uso incorreto de parâmetros de decodificação.
- Investigue por etapas: primeiro, confira a configuração de quem faz a chamada; depois, execute testes comparativos; por fim, avalie possíveis problemas no servidor.
- Um único teste não é confiável: compare a distribuição dos resultados de várias execuções, em vez de se basear em uma ou duas respostas.
- A comprovação dos pesos tem limites: o FlashProve verifica apenas a identidade dos pesos, sem cobrir mudanças na configuração do produto.
- Padronize as ferramentas de teste: use a interface compatível e os logs da APIYI apiyi.com para comparar modelos.
Resumo
Até pouco tempo atrás, as discussões sobre modelos que pareciam menos inteligentes se baseavam principalmente em capturas de tela e impressões pessoais. O FlashProve, da Anthropic, oferece uma forma verificável de investigar se um modelo foi substituído. Mas também nos lembra que, além dos pesos, existe toda uma camada de configurações que influencia os resultados.
- Comece pela sua configuração: parâmetros de decodificação, max_tokens, lista de mensagens e conteúdo recuperado pelo RAG são os pontos de partida mais baratos de verificar.
- Faça testes comparativos: use parâmetros fixos, vários casos de teste e múltiplas execuções para comparar os resultados com o desempenho oficial, trocando impressões por dados.
- Converse com o provedor: depois de confirmar que não há erros na configuração de quem faz a chamada, leve os registros das requisições e os resultados estatísticos ao provedor para investigar possíveis problemas no servidor.
Vale incluir o script comparativo deste artigo nos testes de regressão de rotina. Uma opção é usar a APIYI apiyi.com para verificar rapidamente o desempenho de vários modelos com o mesmo código. A plataforma oferece créditos gratuitos para testes e uma interface unificada compatível com OpenAI.
📚 Referências
- 36氪 / APPSO – Análise da pesquisa da Anthropic sobre inferência verificável: princípios do FlashProve, dados experimentais e discussão sobre as causas da queda de desempenho
- Link:
36kr.com/p/4056019887510401 -
Descrição: principal fonte dos dados apresentados neste artigo, incluindo informações sobre Kimi Vendor Verifier e Model Equality Testing
-
Anthropic Research – Provable Inference: página oficial da pesquisa sobre FlashProve
- Link:
anthropic.com/research/provable-inference - Descrição: contém o relatório técnico, o código aberto e as provas formais
Autor: equipe técnica da APIYI
Contato técnico: se tiver problemas ao investigar resultados inesperados na invocação do modelo, entre em contato conosco pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com.