著者注:モデルが「賢くなくなった」と感じても、モデルがすり替えられたとは限りません。この記事では、Anthropic の最新研究である FlashProve の推論証明を出発点に、API呼び出しの結果に影響する要因を、利用者側からサービス側まで順に調べるための手順にまとめます。
「同じ問題を公式サイトでは解けたのに、APIで呼び出すと行き詰まる」「今月に入ってモデルが明らかに賢くなくなった」――大規模言語モデルをAPI経由で利用する開発者なら、こうした不満を一度は耳にしたことがあるでしょう。多くの人が最初に考えるのは、「裏側でモデルが入れ替えられたのでは?」ということです。
最近、Anthropic はオープンソースの研究プロトタイプ FlashProve を公開しました。暗号技術による証明を使って、「今回の出力が本当に指定された重みに基づくものか」を検証しようとするものです。これにより、「モデルがすり替えられたかどうか」を数学的に検証する道が初めて開かれました。
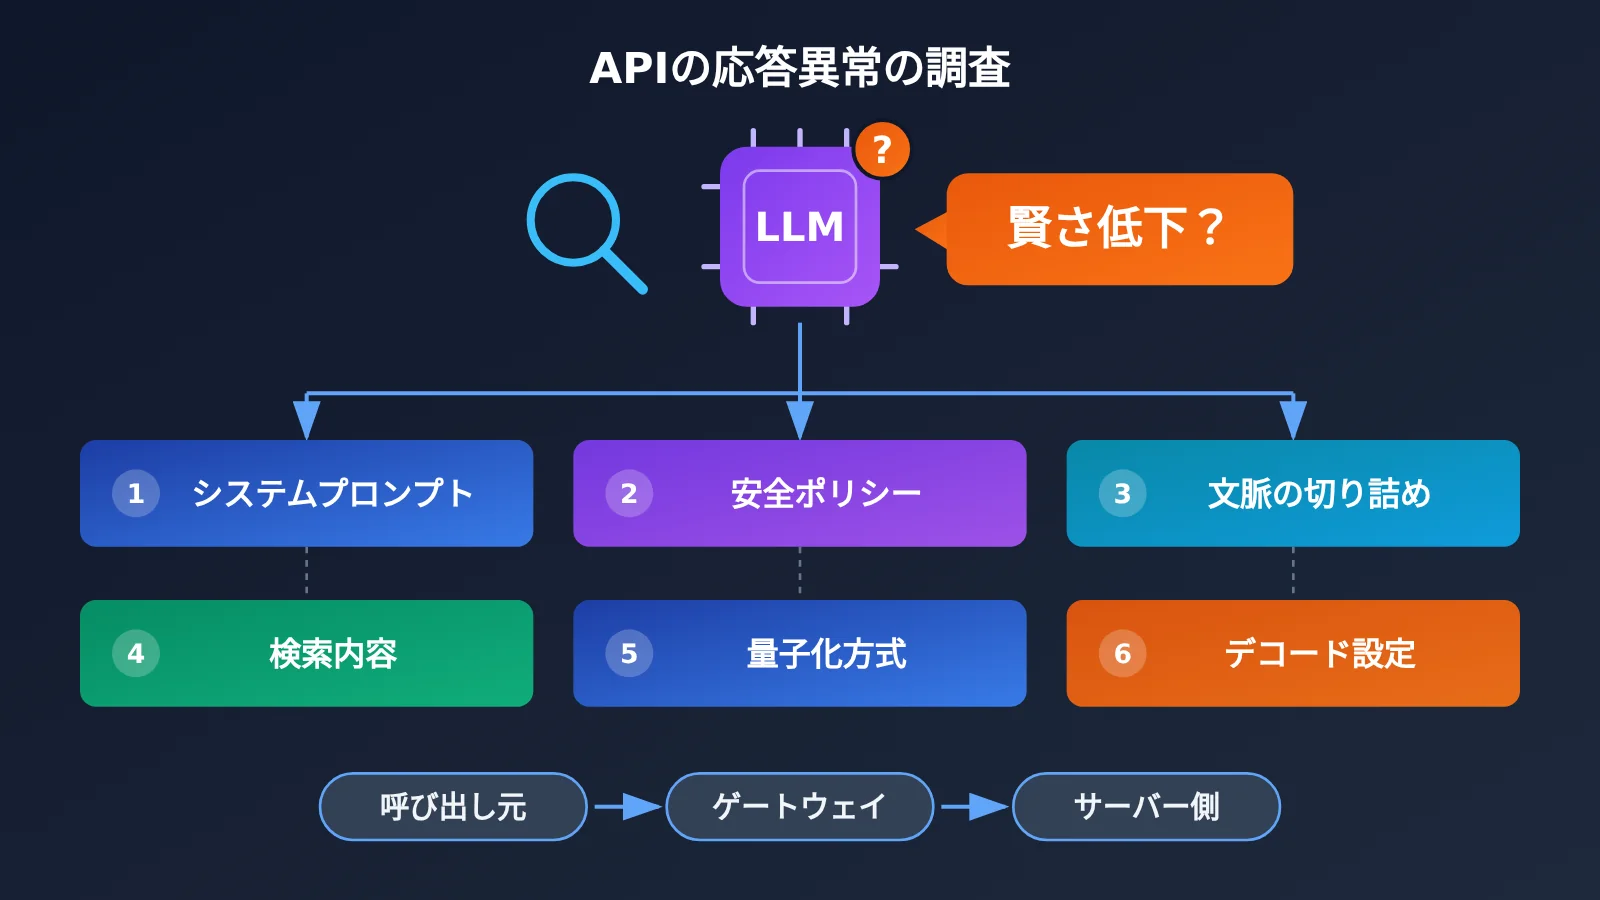
ただし、これで「モデルが賢くなくなった」問題がすべて解決するわけではありません。研究報告でも明確に指摘されているように、重みの同一性を確認できたとしても、システムプロンプト、安全ポリシー、コンテキストの切り詰め、検索結果の内容、量子化方式、デコードパラメータはいずれも最終的な結果に影響します。Kimi チームの調査経験からも、ベンチマークスコアの異常のかなりの割合は、デコードパラメータの誤用に起因することが分かっています。
この記事で得られること:モデルが賢くなくなったと感じたときのチェックリストを通じて、自分で調べられる問題、サービス提供者の協力が必要な問題、そして「いくつか質問してモデルを見分ける」方法がなぜ信頼できないのかが分かります。
モデルが賢くなくなった? 原因調査のポイント
まず、今回の議論の背景を整理しましょう。きっかけは Anthropic の「検証可能な推論」に関する研究です。コミュニティでは、モデルが賢くなくなったと感じる原因はどこにあるのか、という議論につながりました。
| 項目 | 詳細 |
|---|---|
| 発表元 | Anthropic の研究チーム。コード、技術レポート、Lean による形式的証明も公開 |
| 主な内容 | FlashProve:zkSNARK ゼロ知識簡潔証明を用いて、モデルの推論に対する暗号学的な証明を生成 |
| 解決できる問題 | 重みを公開せず、ユーザーがモデルを再実行しなくても、出力が指定された重みによるものかを検証できる |
| 解決できない問題 | システムプロンプト、安全ポリシー、コンテキスト、デコーディングパラメータなど、製品レベルの変更 |
| 開発者への示唆 | モデルの性能に異常を感じたら、「差し替えられたか」だけに注目せず、各層を切り分けて調べる |
FlashProve はどのようにモデルの「本人確認」をするのか
FlashProve の仕組みは、2つのステップに分かれています。まず、サービス提供者がモデルの重みに対する「コミットメント」を生成します。これは、重みそのものを公開せずに、重みを一意に特定できる暗号学的な指紋のようなものです。次に、指定された入力と出力に対する証明を生成します。ユーザーはコミットメント、プロンプト、回答、証明ファイルを受け取り、その出力が確かに特定の重みから計算されたものか、自分のパソコンで検証できます。
ゼロ知識の設計により、検証者に重みや計算途中の値が渡ることはありません。MoE モデルの各層でどのエキスパートが呼び出されたかも見えません。これは「モデルに自分の名前を名乗らせる」よりもはるかに信頼できます。回答に書かれたモデル名を身分証明として扱うのではなく、出力と重みの間にある計算上の関係を検証するからです。
Anthropic は、4-bit 重みが公開されている Llama 4 Maverick を使って実験しました。これは約 4000 億のパラメータを持ち、トークンごとに約 170 億のパラメータを活性化する混合エキスパートモデルです。公開された主なデータは次のとおりです。
| 指標 | 実験データ | 説明 |
|---|---|---|
| 証明生成スループット | H100 1枚で約 110 tokens/秒 | チャットの出力速度ではなく、証明の生成速度 |
| 証明ファイルのサイズ | 1,024-token のリクエストあたり約 19 MB | レスポンスと一緒に渡す必要がある |
| 検証時間 | 24 スレッドの CPU で約 17 秒 | 検証に GPU は不要で、ノートパソコンでも実行可能 |
| 重みのコミットメント生成 | 約 39 分 | 生成は一度だけでよい |
| 追加コスト | GPU 時間は通常の vLLM 推論の約 70~95 倍 | 大規模な普及にはまだ時間がかかる |
重みを確認しても、モデルが賢くなくなったと感じることがあるのはなぜ?
FlashProve には重要な前提があります。ユーザーが「正規モデル」のコミットメントをあらかじめ知っている必要があるのです。サービス提供者が、自分で選んだモデルから回答が生成されたことしか証明できず、ユーザーがそれを購入したモデルと照合できなければ、証明によってモデルの身元を確認することはできません。理想的には、モデルの開発元や信頼できる機関がコミットメントを公開し、ユーザーがその指紋を使って検証します。
さらに重要なのは、重みが変わっていなくても、サービスが変わっていないとは限らないことです。重みにひも付いた証明だけでは、システムプロンプトが調整されたか、コンテキストが途中で切り詰められたか、デコーディングパラメータが同じかといった疑問には答えられません。「モデルが賢くなくなった」という不満が長く続いているのは、こうした複数の要因が重なっていることが多いためです。
モデルが「賢くなくなった」と感じる6つのよくある原因
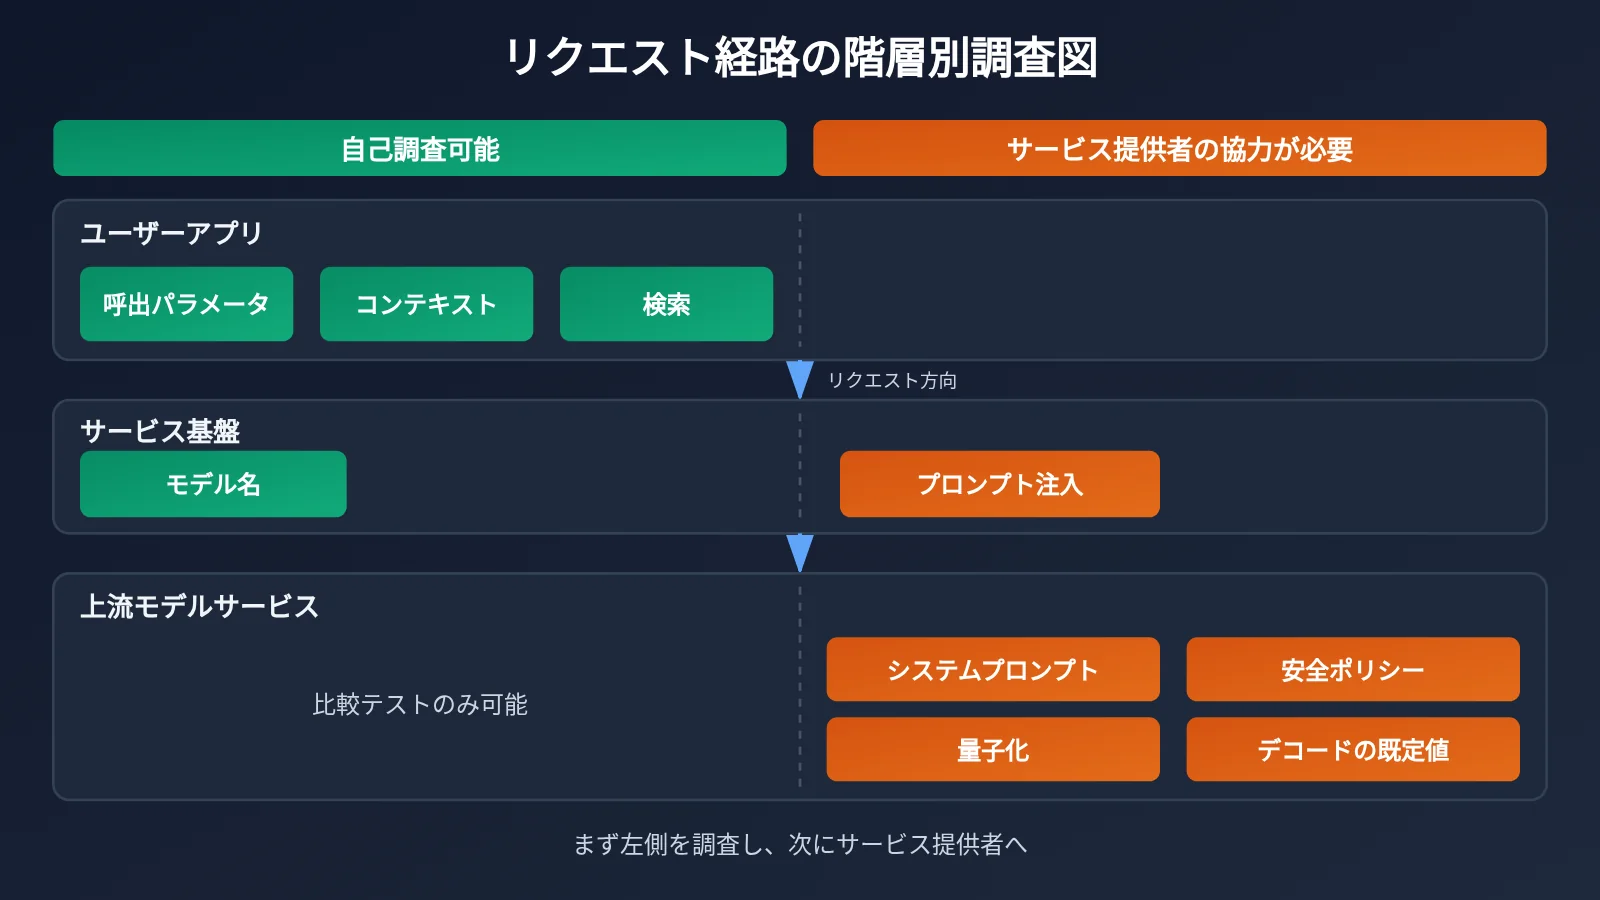
参考研究で挙げられた要因を一つずつ整理し、「どちら側に問題がある可能性があるか」で分類すると、実は呼び出し側で対処できる問題も少なくありません。
| 影響要因 | 典型的な症状 | 問題が起きる可能性のある側 | ユーザーが自分で確認できるか |
|---|---|---|---|
| デコードパラメータ | 出力が発散・反復する、推論モードのベンチマークスコアが低い | 主に呼び出し側。サーバー側でデフォルト値が設定されている場合もある | できる。リクエストパラメータを確認する |
| コンテキストの切り詰め | 前の内容を「忘れる」、回答が不完全になる、指示が無視される | 呼び出し側とサーバー側の両方 | 一部できる。トークン使用量を確認する |
| システムプロンプト | 文体が変わる、回答拒否が増える、形式が違う | 呼び出し側またはサーバー側で挿入 | 自分の設定は確認できるが、サーバー側の設定は確認できない |
| 安全ポリシー | 特定の質問が突然拒否される、回答が慎重になる | 主にサーバー側 | 難しい。サービス提供者の説明が必要 |
| 検索内容 | RAGで回答の品質が安定しない | 呼び出し側の検索処理 | できる。検索で取得した内容を確認する |
| 量子化方式 | 全体的な能力がわずかに低下する、長い推論でエラーが増える | サーバー側のデプロイ環境 | できない。サービス提供者の協力が必要 |
デコードパラメータの誤用:見落としやすい原因
KimiチームはKimi Vendor Verifierの紹介時に、代表的な事例を共有しています。K2 Thinkingの公開後、ベンチマークスコアの異常についてコミュニティから多くの報告が寄せられました。調査の結果、そのかなりの部分がデコードパラメータの誤用に起因すると判明しました。その後、チームはThinkingモードで関連パラメータに制約を設け、思考内容が正しく返されているかを確認しました。
開発者にとって、ここから得られる教訓は明確です。temperature、top_p、max_tokens、推論モードの切り替えなどのパラメータが公式の推奨設定と異なると、モデルの性能が期待から大きく外れることがあります。特に推論モデルでは、サンプリングパラメータや思考バジェット、複数ターンの会話で思考内容を送り返す方法について、各メーカーがそれぞれ要件を定めています。通常の対話モデルで使っていた設定をそのまま流用せず、具体的な値は各モデルの公式ドキュメントを確認してください。
コンテキストが完全に渡されていない:「記憶喪失」に見える原因
もう一つのよくある問題がコンテキストです。複数ターンの会話で最新の一言だけを渡していれば、モデルが前の内容を「覚えていない」のは当然です。ワークフローで会話履歴がモデルのコンテキストウィンドウを超えた場合、最初のシステム指示が切り詰められ、突然指定された形式で出力されなくなることもあります。また、max_tokensの設定が小さすぎると、回答が途中で切れ、「答えの途中で止まった」ように見えます。
これらはいずれもモデルが賢くなくなったように感じられますが、リクエストボディとレスポンスの終了理由を確認すれば、多くの場合、その場で原因を特定できます。
モデルが急に賢くなくなった?3ステップの確認手順
原因は呼び出しチェーンのさまざまな箇所にあり得るため、確認はコストが低く、自分で制御しやすい部分から始めましょう。次の順序で進めるのがおすすめです。
- まず呼び出し側を確認する:model 名、デコードパラメータ、max_tokens、システムプロンプト、メッセージリスト全体、RAGで取得した内容が正しいか確認します。
- 次に比較テストを行う:パラメータとプロンプトを固定し、公式チャネルや公式ドキュメントに記載された挙動と比較します。1回の結果だけで判断せず、複数回実行して結果の分布を観察しましょう。
- 最後にサーバー側を判断する:呼び出し側の設定に問題がなく、比較結果の差を安定して再現できる場合は、リクエスト記録とテスト結果を添えてサービス提供者に問い合わせます。
最小限の例:パラメータを固定して再現可能な呼び出しを行う
まずは、すべてのパラメータを明示してデフォルト値への依存を避け、終了理由とトークン使用量を出力するのが実用的です。
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 調査したいモデル名に変更
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
finish_reason が length の場合、回答が max_tokens によって途中で切られたことを意味します。この場合、「回答が不完全」なのはモデルの能力が落ちたからではなく、パラメータの設定が原因です。また、usage の入力トークン数を確認すれば、コンテキストが本当にすべて渡されたかどうかを判断できます。
比較テスト用スクリプトの全体を見る
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # モデルの切り替えは model パラメータの変更だけでよい
)

# デフォルト値に依存しないよう、すべてのパラメータを明示する
PARAMS = {
    "temperature": 0.2,   # 推論モデルでは公式ドキュメントの推奨値を設定する
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """同じケースを複数回実行し、正答率、出力が途中で切られた回数、トークン使用量を集計する"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # 調査対象のモデルに変更
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
このスクリプトのポイントはテスト問題そのものではなく、次の3点にあります。すべてのパラメータを固定してレポートとともに出力すること、同じケースを複数回実行して正答率を確認すること、finish_reason と prompt_tokens を記録して出力の途中切れやコンテキストの問題を除外することです。この3点を確認してから、初めて「サーバー側に変更があったか」を検討する価値があります。
🚀 調査のヒント:APIYI(apiyi.com)は OpenAI 互換インターフェースを採用しており、model パラメータを変更するだけでモデルを切り替えられます。同じテストスクリプトを使って複数のモデルを横断的に比較するのに便利です。また、プラットフォームの呼び出しログや使用量統計から、リクエストの消費量やトークン使用量を振り返り、コンテキストがすべて渡されたかどうかの判断に役立てられます。ログに表示される具体的な項目は、プラットフォームのコンソール画面で確認してください。
ユーザーによる自己チェックとサービス提供事業者との役割分担
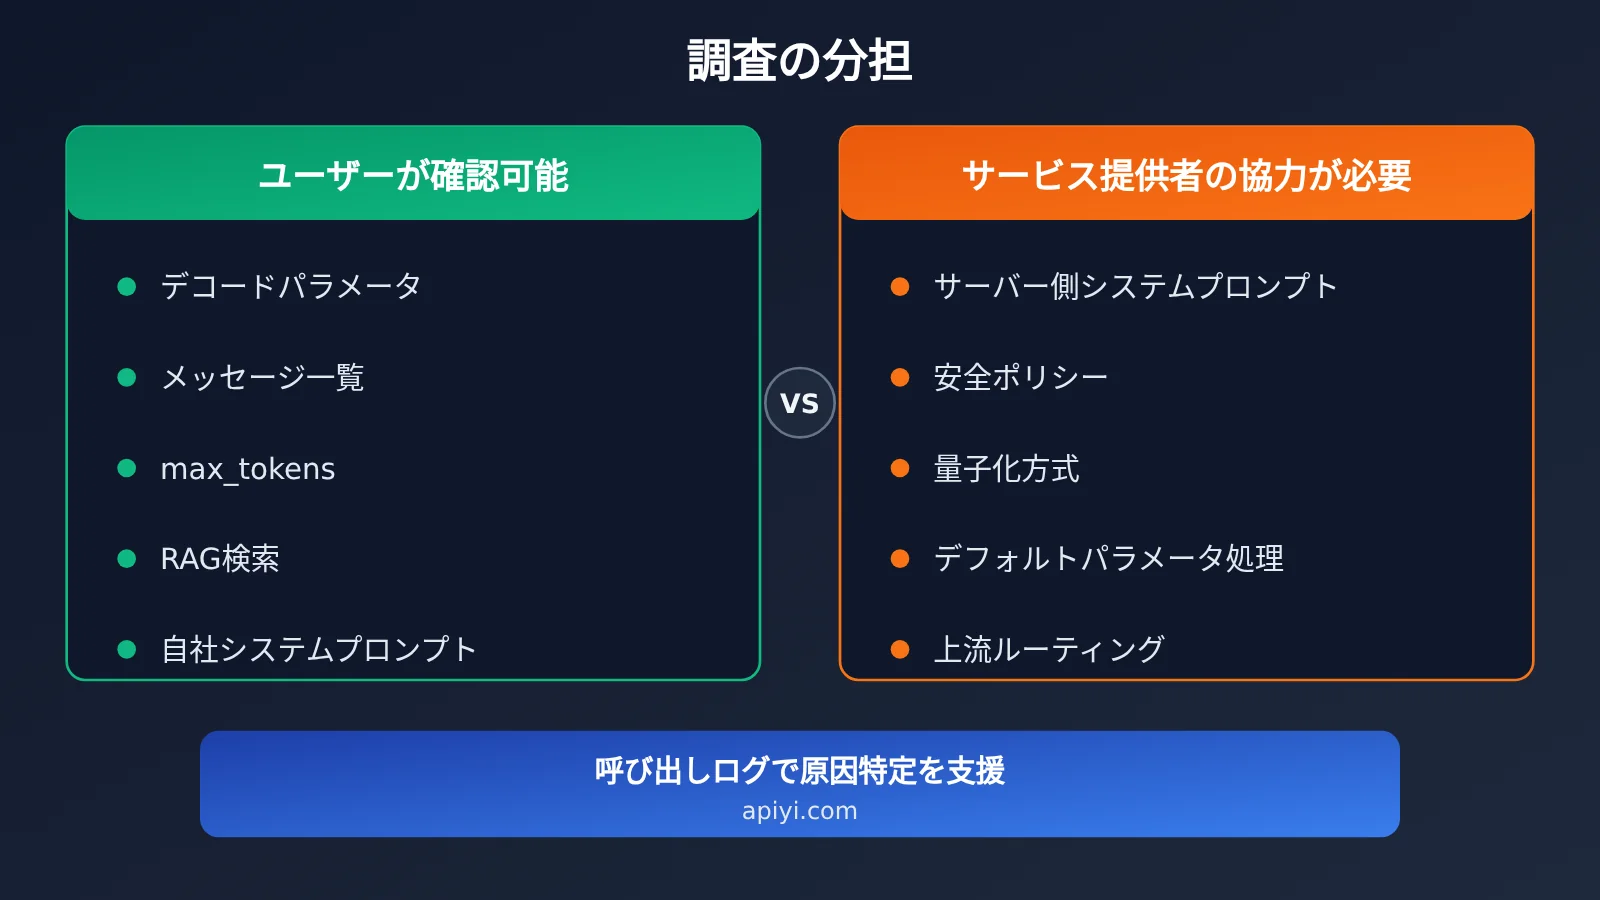
| 調査項目 | ユーザーによるチェック方法 | サービス提供事業者に確認する情報 |
|---|---|---|
| デコードパラメータ | リクエストボディ全体を出力し、公式ドキュメントと照合する | プラットフォームがパラメータを書き換えたり、デフォルト値を補ったりしているか |
| コンテキストの完全性 | メッセージリストと prompt_tokens を確認する | サーバー側での切り詰めやウィンドウの制限があるか |
| 推論モード | 思考モードの設定と、思考内容の返却方法を確認する | 上流が該当するパラメータに対応しているか |
| 量子化とデプロイ | 自己チェックはできない | デプロイ時の精度、上流の提供元に関する説明 |
| 安全ポリシー | 同じリクエストに対する公式経由の応答と比較する | 追加の審査ルールが適用されているか |
サービス提供事業者に問い合わせる際は、パラメータを固定したリクエストのサンプル、複数回実行した統計結果、比較データを用意すると、やり取りがぐっとスムーズになります。「モデルが賢くなくなった」とだけ伝えても、相手は問題を特定しにくいからです。
「いくつか質問してモデルを見分ける」方法が、性能低下の判断に頼れない理由
コミュニティでは、新しいバージョンだけが知っている知識をモデルに質問し、答えられなければ「別のモデルにすり替えられた」と判断する方法が広まっています。しかし、1回の回答にはもともとランダム性があります。たまたま間違えた場合も、パラメータが違う場合も、コンテキストが欠けている場合も、提供事業者の内部ルーティングが異なる場合も、最終的には「使いたいモデルではない」という同じ結論につながってしまいます。
スタンフォード大学の研究プロジェクト Model Equality Testing は、より厳密な視点を示しています。研究者は2024年に4種類のLlamaモデルについて31の商用APIエンドポイントをテストし、そのうち11のエンドポイントで、出力分布がMetaの公開した重みを使った基準分布と統計的に異なることを発見しました。ここで重要なのは、1つや2つの質問の正誤ではなく、出力の「分布」を比較している点です。
開発者が参考にできるのは、この統計的な考え方です。パラメータを固定し、複数のケースを何度も実行して、一貫した差があるかを確認します。これが、上の比較スクリプトで「1回の結果」ではなく「正答率」を採用した理由でもあります。
モデルが「賢くなくなった」現象の影響分析
開発者への影響
- まず自分のリクエストを確認する:出力に異常を感じたら、まずリクエストボディを確認しましょう。パラメータの誤用やコンテキストの不足は、低コストで確認でき、原因が見つかる可能性も高い項目です。
- パラメータを明示する:本番環境ではデフォルト値に依存せず、特に推論モデルは公式ドキュメントに従って設定し、パラメータもバージョン管理しましょう。
- 回帰テストセットを作る:固定のテストケースを定期的に実行すれば、モデルが賢くなくなったと感じたときに、体感ではなくデータを示せます。
- 呼び出し記録を残す:リクエストパラメータ、トークン使用量、終了理由は、サービス提供者とのやり取りにおける重要な証拠になります。
業界への影響
- 体感による判断から証明による検証へ:FlashProve は「重みの同一性を検証できる」という方向性を示しました。今後はモデル提供者、評価機関、規制当局が、実際に提供されているモデルを確認するために活用する可能性があります。
- 透明性への要求が広がる:重みに加え、システムプロンプト、デコード戦略、デプロイ設定が一致しているかどうかも、次の段階の議論の焦点になるでしょう。
- 普及にはまだ時間が必要:証明にかかるコストは通常の推論の数十倍に上ります。さらに長いコンテキストへの対応や、信頼できるコミットメントの公開メカニズムも必要なため、短期的に日常の呼び出しまでカバーするのは難しいでしょう。
よくある質問 FAQ
Q1: モデルの性能が落ちたと感じたら、まず何を確認すべきですか?
まずはリクエストを確認しましょう。model 名が正しいか、temperature などのデコードパラメータが公式の推奨値に沿っているか、max_tokens が小さすぎないか、複数ターンの会話で過去のメッセージをすべて渡しているかをチェックします。Kimi チームの経験によると、ベンチマークスコアの異常のかなりの部分はデコードパラメータの誤用が原因で、この確認によって問題が解決することも少なくありません。
Q2: FlashProve はモデルの性能低下をめぐる議論を完全に解決できますか?
いいえ。FlashProve は出力が指定された重みに由来するかを検証できますが、比較対象となる信頼できるモデルのコミットメントがあることが前提です。システムプロンプト、安全性ポリシー、コンテキストの切り詰め、量子化方式、デコードパラメータといった要素は、重みの証明だけでは自動的にカバーされません。
Q3: 信頼できる比較テストを行うにはどうすればよいですか?
すべてのパラメータとプロンプトを固定し、明確な答えのあるテストケースを複数用意します。各ケースを複数回実行して正答率を集計し、finish_reason とトークン使用量も記録しましょう。APIYI apiyi.com では、同じ OpenAI 互換コードを使って複数のモデルを横断的にテストできます。新規ユーザーは、このような検証に使える無料テスト枠を利用できます。
Q4: 推論モデルが API では Web 版ほどの性能を発揮しないのは、なぜですか?
よくある原因として、思考モードが有効になっていない、または思考バジェットの設定が異なること、サンプリングパラメータが公式の推奨値と一致していないこと、複数ターンの会話で思考内容を返す方法が正しくないことなどが挙げられます。また、Web 版に備わっているシステムプロンプトやツールが API には存在しない場合もあります。そのモデルの公式ドキュメントにある API の説明を、一つずつ確認することをおすすめします。
Q5: 自分で確認しても問題が見つからない場合、サービス提供者にはどう伝えればよいですか?
パラメータを固定したリクエストのサンプル、複数回実行した統計結果、公式チャネルとの比較データ、異常が発生した時間帯を用意しましょう。APIYI apiyi.com のコンソールでは呼び出しログと使用量の統計を確認できます。該当する記録も併せて提供すると、問題の特定にかかる時間を大幅に短縮できます。
モデルが賢くなくなったと感じたときの確認ポイント Key Takeaways
- モデルの性能低下は、すり替えとは限らない:システムプロンプト、コンテキスト、デコードパラメータなども出力結果に影響します。
- パラメータの誤用は珍しくない:Kimi チームは、ベンチマークスコアの異常のかなりの部分がデコードパラメータの誤用に起因すると確認しています。
- 切り分けは段階的に進める:まず呼び出し側を確認し、次に比較テストを行い、最後にサーバー側の問題かどうかを判断します。
- 1問だけでの判定は信頼できない:1~2個の回答を見るのではなく、複数回実行した出力の分布を比較しましょう。
- 重みの証明には限界がある:FlashProve が検証するのは重みの同一性だけで、製品レベルの設定変更は検証できません。
- テストツールは統一する:APIYI apiyi.com の互換インターフェースとログを使えば、横断的な比較ができます。
まとめ
モデルが賢くなくなったと感じる問題は、これまで主にスクリーンショットや体感をもとに議論されてきました。Anthropic の FlashProve は「モデルがすり替えられたかどうか」を検証する手段を示していますが、同時に、重み以外にも出力結果に影響する設定があることを思い出させてくれます。
- まずは自分で確認:デコードパラメータ、max_tokens、メッセージリスト、RAG で取得した内容が、低コストで始められる確認ポイントです。
- 次に比較:パラメータを固定し、複数のケースを複数回実行して公式の結果と比較します。感覚ではなくデータで判断しましょう。
- 最後に相談:呼び出し側に問題がないことを確認したら、リクエスト記録と統計結果を持ってサービス提供者に相談し、サーバー側の問題を特定します。
この記事の比較スクリプトを日常の回帰テストに組み込むことをおすすめします。APIYI apiyi.com を使えば、同じコードで複数のモデルの性能をすばやく検証できます。無料テスト枠と統一された OpenAI 互換インターフェースが提供されています。
📚 参考資料
- 36氪 / APPSO – Anthropic の検証可能な推論に関する研究解説:FlashProve の仕組み、実験データ、および「性能低下」の原因に関する議論
- リンク:
36kr.com/p/4056019887510401 -
説明: 本記事の事実・データの主な出典。Kimi Vendor Verifier と Model Equality Testing に関する紹介を含む
-
Anthropic Research – Provable Inference:FlashProve の公式研究ページ
- リンク:
anthropic.com/research/provable-inference - 説明: 技術レポート、オープンソースコード、形式的証明を参照可能
著者: APIYI 技術チーム
技術交流: モデル呼び出しの結果に異常があり、原因の調査でお困りの場合は、APIYI の apiyi.com トップページからお気軽にお問い合わせください。接続方法の詳細は、docs.apiyi.com のドキュメントセンターをご覧ください