Примечание автора: если модель «поглупела», это не обязательно значит, что её подменили. Отталкиваясь от недавнего исследования Anthropic FlashProve о доказательстве корректности инференса, мы разберём факторы, влияющие на результат вызова API, и составим порядок их проверки — от настроек клиента до серверной части.
«На сайте модель решила задачу, а через API на ней застряла», «В этом месяце модель явно поглупела» — подобные жалобы слышал почти каждый разработчик, который подключает большие языковые модели через API. Первая мысль у многих: не заменили ли модель на сервере?
Недавно Anthropic представила исследовательский прототип с открытым исходным кодом FlashProve. Он использует криптографические доказательства, чтобы проверить, действительно ли ответ получен с помощью заданного набора весов. Так впервые появилась возможность математически проверить, не была ли модель подменена.
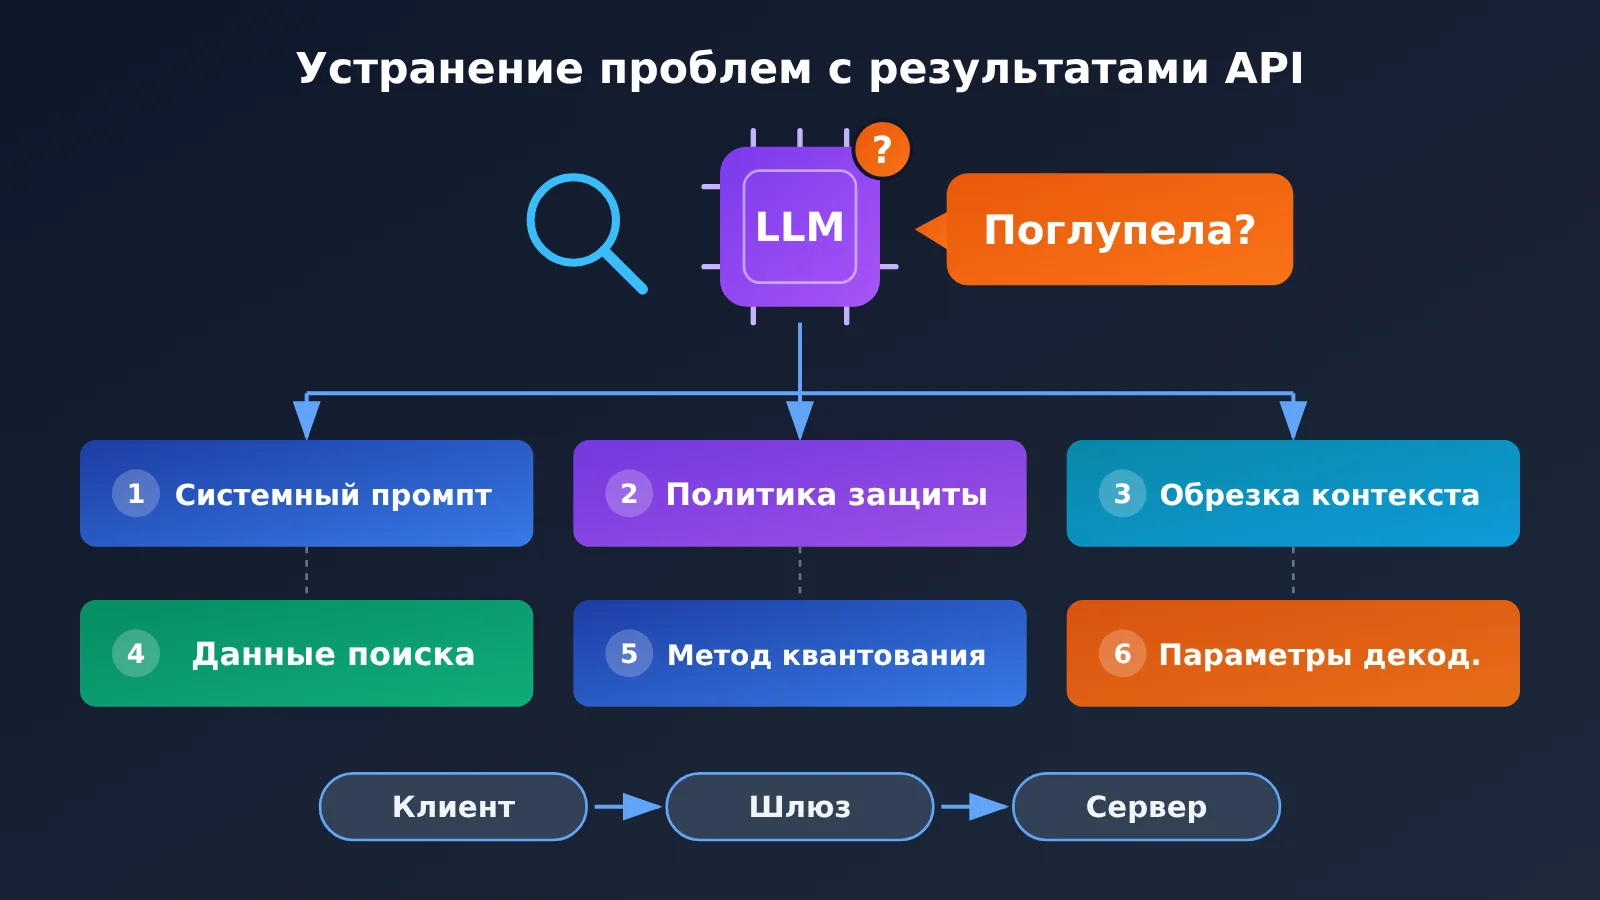
Но на этом проблема «поглупевшей» модели не заканчивается. Как отмечается в исследовании, даже если подлинность весов подтверждена, на результат всё равно влияют системный промпт, политики безопасности, усечение контекста, извлечённые данные, способ квантования и параметры декодирования. Опыт команды Kimi также показывает, что немалая часть аномальных результатов бенчмарков связана с неправильным использованием параметров декодирования.
Что вы узнаете: в конце статьи у вас будет список проверок на случай, если модель начнёт работать хуже. Вы поймёте, что можно проверить самостоятельно, где понадобится помощь провайдера и почему «задать модели несколько вопросов, чтобы определить её» — ненадёжный способ.
Модель стала хуже: краткий обзор
Для начала разберёмся, с чего началось обсуждение. Поводом стало исследование Anthropic о «доказуемом инференсе», а главный вопрос сообщества — кто виноват, когда модель начинает работать хуже.
| Пункт | Подробности |
|---|---|
| Кто опубликовал | Исследовательская команда Anthropic; также открыты код, технический отчёт и формальное доказательство на Lean |
| Суть | FlashProve создаёт криптографическое доказательство инференса модели на основе кратких доказательств с нулевым разглашением zkSNARK |
| Какую проблему решает | Позволяет проверить, получен ли ответ с использованием заданных весов, не раскрывая их и не требуя от пользователя повторного запуска модели |
| Чего не решает | Не выявляет изменения на уровне продукта: системного промпта, политик безопасности, контекста, параметров декодирования и других настроек |
| Что важно для разработчиков | Если качество модели изменилось, нужно проверять разные уровни системы, а не зацикливаться на возможной подмене модели |
Как FlashProve доказывает, что модель — это именно она
FlashProve работает в два этапа. Сначала провайдер создаёт для весов модели криптографическое «обязательство» — своеобразный отпечаток, который однозначно фиксирует веса, не раскрывая их. Затем для заданных входных и выходных данных провайдер формирует доказательство. Получив обязательство, промпт, ответ и файл доказательства, пользователь может на своём компьютере проверить, что ответ действительно вычислен с использованием зафиксированных весов.
Доказательство с нулевым разглашением гарантирует, что проверяющий не получит доступ к весам и промежуточным результатам вычислений и не увидит, какие эксперты вызывались на каждом слое модели MoE. Это гораздо надёжнее, чем просить модель представиться: название модели в ответе больше не служит удостоверением личности — проверяется вычислительная связь между ответом и весами.
Anthropic провела эксперимент с Llama 4 Maverick, чьи 4-битные веса открыты. Это модель со смесью экспертов, в которой около 400 млрд параметров, а при обработке каждого токена активируются около 17 млрд. Вот основные результаты:
| Показатель | Результат эксперимента | Примечание |
|---|---|---|
| Скорость создания доказательства | Около 110 токенов/сек на одной H100 | Это скорость создания доказательства, а не генерации ответа в чате |
| Размер файла доказательства | Около 19 МБ на запрос из 1 024 токенов | Файл нужно передавать вместе с ответом |
| Время проверки | Около 17 секунд на CPU с 24 потоками | GPU не нужен, проверку можно выполнить на ноутбуке |
| Создание обязательства для весов | Около 39 минут | Выполняется только один раз |
| Дополнительные затраты | Время работы GPU примерно в 70–95 раз больше, чем при обычном инференсе с vLLM | До массового применения пока далеко |
Почему модель может «поглупеть», даже если её веса проверены
У FlashProve есть важное предварительное условие: пользователь должен заранее знать, какому коммитменту соответствует «подлинная модель». Если поставщик может лишь доказать, что ответ получен от выбранной им модели, но пользователь не может убедиться, что это именно та модель, за которую он заплатил, доказательство всё равно не решает проблему идентификации. В идеале разработчик модели или доверенная организация должны публично опубликовать коммитмент, а пользователь — проверять его по этому отпечатку.
Но главное — неизменность весов не означает, что сервис тоже не изменился. Доказательство, привязанное к весам, само по себе не отвечает на вопросы, изменился ли системный промпт, не был ли обрезан контекст и остались ли прежними параметры декодирования. Поэтому жалобы на то, что модель «поглупела», возникают снова и снова: часто это результат изменений сразу на нескольких этапах.
6 распространённых причин, почему модель «поглупела»
Если разобрать факторы из исследования и сгруппировать их по тому, на чьей стороне может возникнуть проблема, окажется, что многое зависит от самого пользователя API.
| Фактор | Типичные признаки | На чьей стороне может возникнуть проблема | Можно ли проверить самостоятельно |
|---|---|---|---|
| Параметры декодирования | Ответы становятся бессвязными или повторяются, оценки в режиме рассуждений снижаются | В основном на стороне пользователя API, но сервер тоже может задавать значения по умолчанию | Да, проверить параметры запроса |
| Обрезка контекста | Модель «забывает» предыдущие сообщения, отвечает не полностью, игнорирует инструкции | Как на стороне пользователя API, так и на сервере | Частично, проверить расход токенов |
| Системный промпт | Меняется стиль, учащаются отказы, нарушается формат ответа | Задаётся пользователем API или добавляется на сервере | Свой можно проверить, серверный — нет |
| Политики безопасности | Вопросы определённой категории внезапно отклоняются или ответы становятся осторожнее | В основном на сервере | Сложно, нужны разъяснения поставщика |
| Содержимое поиска | Качество ответов в сценариях RAG колеблется | В цепочке поиска на стороне пользователя API | Да, проверить извлечённые материалы |
| Способ квантования | Общее качество немного снижается, растёт число ошибок в длинных рассуждениях | На стороне серверного развёртывания | Нет, без помощи поставщика не обойтись |
Ошибки в параметрах декодирования: причину того, что модель «поглупела», легко упустить
Команда Kimi поделилась показательным наблюдением, когда рассказывала о Kimi Vendor Verifier. После выхода K2 Thinking разработчики получили немало сообщений от сообщества о странных результатах тестов. Расследование показало, что значительная часть проблем была связана с неправильным использованием параметров декодирования. После этого команда ограничила значения соответствующих параметров в режиме Thinking и проверила, правильно ли возвращается содержимое рассуждений.
Для разработчиков вывод простой: если temperature, top_p, max_tokens или переключатель режима рассуждения не соответствуют рекомендациям производителя, поведение модели может заметно отличаться от ожидаемого. Особенно это касается моделей с рассуждением: у разных производителей свои требования к параметрам сэмплирования, бюджету рассуждений и возврату содержимого рассуждений в многоходовом диалоге. Конкретные значения лучше брать из официальной документации модели, а не переносить привычные настройки обычной диалоговой модели.
Неполный контекст: модель «забывает» и кажется менее умной
Другая частая причина — контекст. Если в многоходовом диалоге передать только последнюю реплику, модель, конечно, не «вспомнит» предыдущие. Если история сообщений в рабочем процессе превышает контекстное окно модели, при обрезке нередко первыми пропадают системные инструкции. В результате модель вдруг перестаёт соблюдать заданный формат. Кроме того, слишком маленькое значение max_tokens обрывает ответ на полуслове — создаётся впечатление, что модель просто остановилась на середине.
Во всех этих случаях может казаться, что модель поглупела. Но чаще всего причину можно найти сразу, проверив тело запроса и причину завершения в ответе.
Модель стала работать хуже: проверка в 3 шага
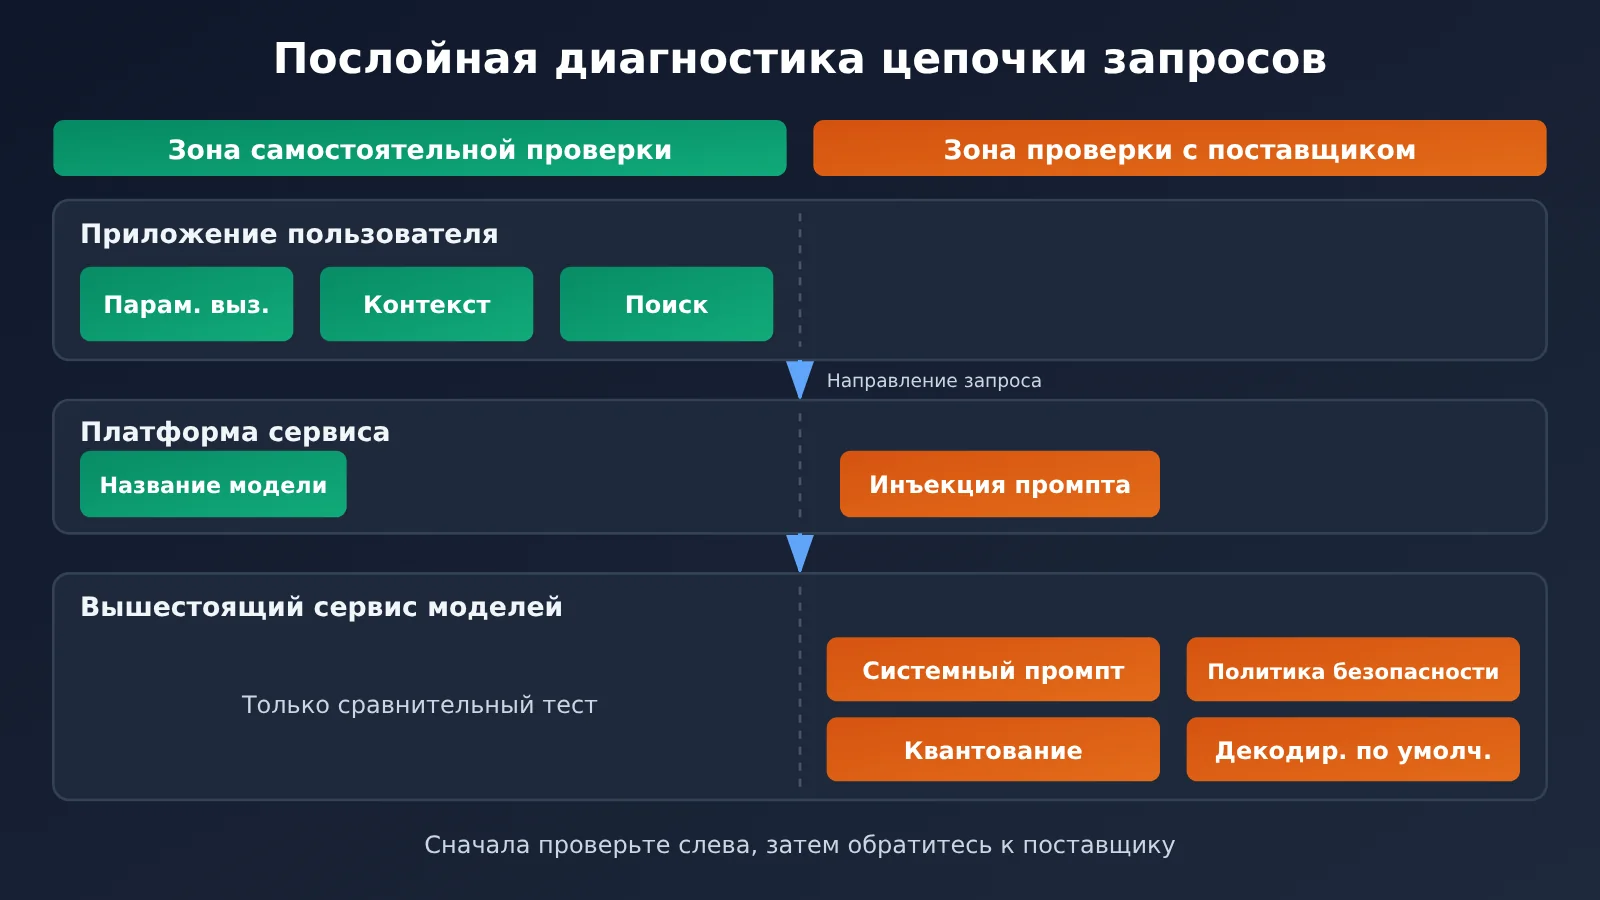
Причины могут скрываться на разных этапах цепочки вызова, поэтому начинать проверку стоит с того, что проще и дешевле всего контролировать. Рекомендуем такой порядок:
- Сначала проверьте настройки на своей стороне: название model, параметры декодирования, max_tokens, системный промпт, полный список сообщений и содержимое, полученное через RAG.
- Затем проведите сравнительный тест: зафиксируйте параметры и промпт, сравните результаты с ответами через официальный канал или описанием в официальной документации. Запустите тест несколько раз, чтобы оценить распределение результатов, а не судить по одному ответу.
- В последнюю очередь проверьте сторону сервиса: если настройки на вашей стороне верны, а различия стабильно воспроизводятся, обратитесь к поставщику сервиса с записями запросов и результатами тестов.
Минимальный пример: воспроизводимый вызов с фиксированными параметрами
Для начала лучше явно указать все параметры, не полагаясь на значения по умолчанию, а также вывести причину завершения и расход токенов:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Укажите модель, которую проверяете
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
Если finish_reason равен length, значит, ответ был обрезан из-за ограничения max_tokens. В этом случае неполный ответ связан не с тем, что модель стала хуже, а с настройкой параметров. Количество входных токенов в usage поможет проверить, действительно ли контекст был передан целиком.
Посмотреть полный скрипт для сравнительного тестирования
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Для смены модели достаточно изменить параметр model
)

# Явно указываем все параметры, не полагаясь на значения по умолчанию
PARAMS = {
    "temperature": 0.2,   # Для рассуждающих моделей используйте значение, рекомендованное в официальной документации
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """Запускает один тест несколько раз и подсчитывает долю успешных ответов, число обрезанных ответов и расход токенов"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # Укажите модель, которую проверяете
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
Суть скрипта не в самих тестовых заданиях, а в трёх вещах: все параметры фиксируются и выводятся в отчёте; каждый тест запускается несколько раз для оценки доли успешных ответов; значения finish_reason и prompt_tokens записываются, чтобы исключить обрезание ответа и проблемы с контекстом. Только после проверки этих трёх пунктов имеет смысл обсуждать, не изменилось ли что-то на стороне сервера.
🚀 Совет по диагностике: APIYI apiyi.com использует интерфейс, совместимый с OpenAI, поэтому для переключения модели достаточно изменить параметр model. Это позволяет сравнивать несколько моделей с помощью одного набора тестовых скриптов. Платформа предоставляет журналы вызовов и статистику использования: по ним можно проверить расход ресурсов и токенов и оценить, был ли контекст передан целиком. Какие именно поля отображаются в журналах, уточняйте в консоли платформы.
Что пользователь может проверить сам, а где нужна помощь провайдера
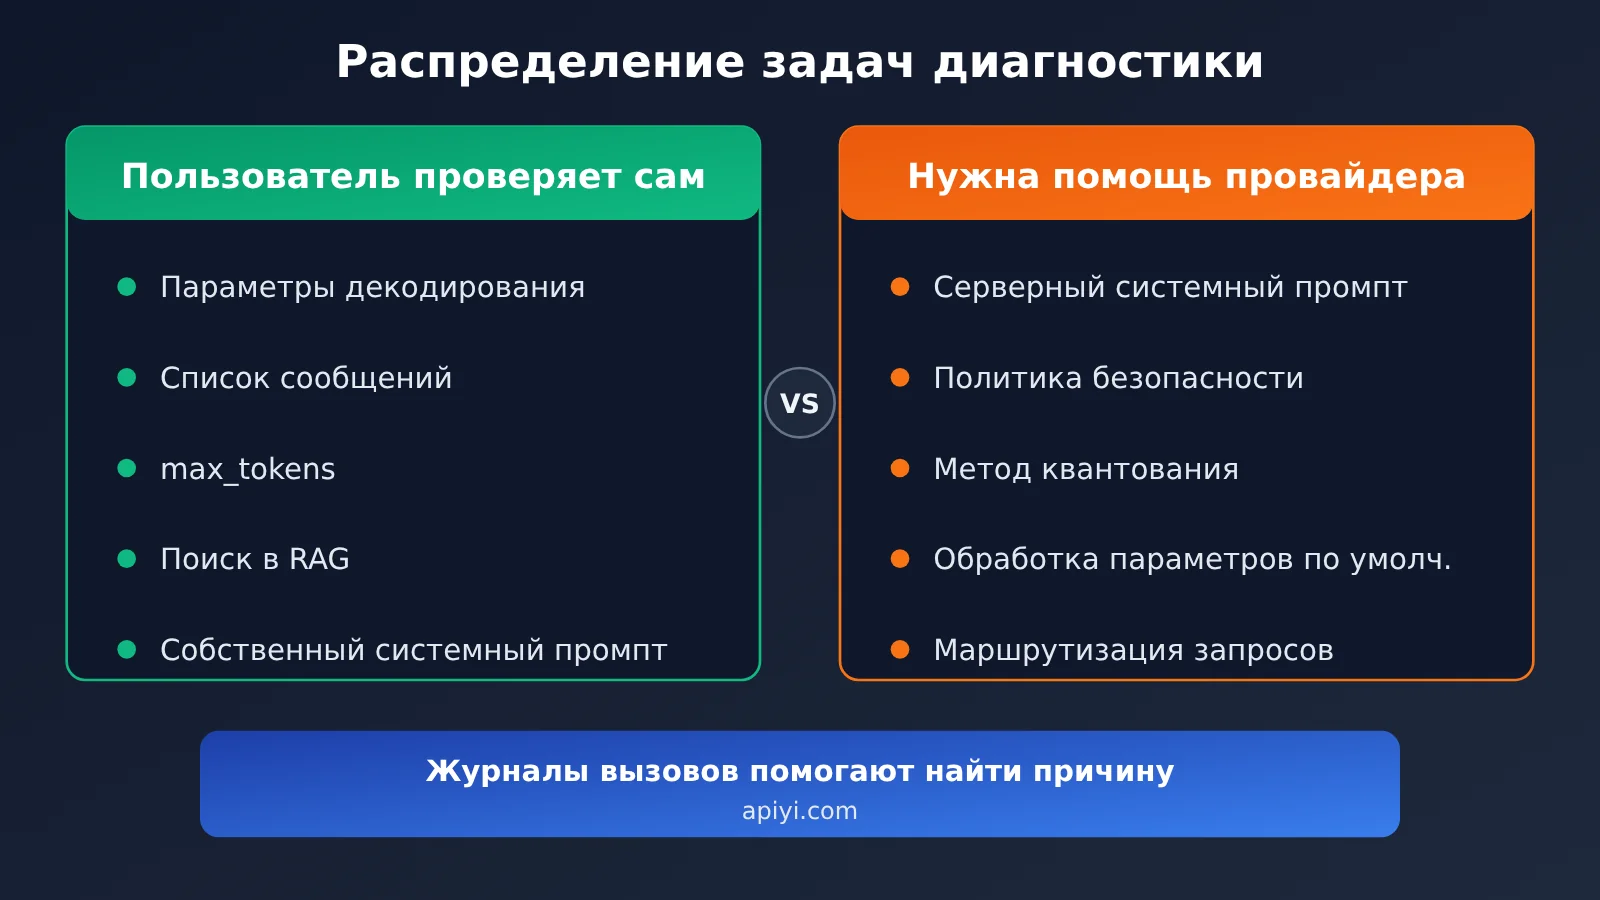
| Что проверить | Как проверить самостоятельно | Какие сведения нужны от провайдера |
|---|---|---|
| Параметры декодирования | Вывести полное тело запроса и сверить с официальной документацией | Изменяет ли платформа параметры или подставляет значения по умолчанию |
| Полнота контекста | Проверить список сообщений и prompt_tokens | Есть ли усечение на сервере или ограничения контекстного окна |
| Режим рассуждения | Проверить переключатель режима рассуждения и способ возврата его содержимого | Поддерживает ли вышестоящий провайдер соответствующие параметры |
| Квантование и развёртывание | Самостоятельно проверить нельзя | Точность развёрнутой модели и сведения о вышестоящем провайдере |
| Политика безопасности | Сравнить результаты одного и того же запроса через официальный канал | Применяются ли дополнительные правила модерации |
При обращении к провайдеру приложите примеры запросов с фиксированными параметрами, статистику нескольких запусков и результаты для сравнения. Так разобраться в проблеме будет гораздо проще. По одной фразе «модель поглупела» найти причину сложно.
Почему нельзя судить об ухудшении модели по ответам на несколько вопросов
В сообществе популярен такой способ проверки: задать модели вопрос, ответ на который известен только новой версии. Если она не справилась, значит, «модель подменили». Проблема в том, что отдельный ответ зависит от случайности. Ошибка может быть случайной, а её причиной также могут стать другие параметры, недостаток контекста или особенности внутренней маршрутизации у провайдера. Но вывод во всех случаях делают один: «Это не та модель, которая мне нужна».
Исследовательский проект Стэнфордского университета Model Equality Testing предлагает более строгий подход. Учёные протестировали 31 коммерческий API-эндпоинт для четырёх моделей Llama 2024 года и обнаружили, что у 11 из них распределение ответов статистически отличалось от эталонного распределения модели с весами, опубликованными Meta. Обратите внимание: исследователи сравнивали именно распределения ответов, а не правильность ответа на один-два вопроса.
Разработчикам стоит взять на вооружение этот статистический подход: искать устойчивые различия с помощью фиксированных параметров, нескольких тестовых случаев и многократных запусков. Именно поэтому скрипт для сравнения выше использует «долю успешных ответов», а не результат одной попытки.
Как влияет ощущение, что модель «поглупела»
Влияние на разработчиков
- Начинайте проверку со своего запроса: если качество ответов ухудшилось, сначала проверьте тело запроса. Неверные параметры и отсутствие контекста — самые простые и частые причины.
- Задавайте параметры явно: в продакшене не полагайтесь на значения по умолчанию. Параметры моделей с рассуждением настраивайте по официальной документации и храните под контролем версий.
- Создайте набор регрессионных тестов: регулярно запускайте фиксированные сценарии. Если модель «поглупеет», у вас будут данные, а не только субъективные ощущения.
- Сохраняйте логи вызовов: параметры запроса, расход токенов и причина завершения помогут при общении с поставщиком сервиса.
Влияние на отрасль
- От субъективных ощущений — к доказательствам: FlashProve показывает, что идентичность весов можно проверять. В будущем производители моделей, организации, занимающиеся оценкой, и регуляторы смогут таким образом подтверждать, какая модель используется в сервисе.
- Требования к прозрачности станут шире: помимо весов, следующим предметом обсуждения может стать соответствие системных промптов, стратегий декодирования и конфигураций развёртывания.
- До широкого применения ещё далеко: получение доказательства обходится примерно в несколько десятков раз дороже обычного инференса. Кроме того, нужны поддержка более длинного контекста и надёжный механизм публикации обязательств. Поэтому в ближайшее время метод вряд ли охватит повседневные вызовы моделей.
Частые вопросы FAQ
Q1: Что проверить в первую очередь, если модель «поглупела»?
Начните с собственного запроса: правильно ли указано имя model, соответствуют ли параметры декодирования, такие как temperature, официальным рекомендациям, не слишком ли мал max_tokens и передаётся ли полная история сообщений в многотуровом диалоге. По опыту команды Kimi, значительная часть аномальных результатов тестов связана с неправильными параметрами декодирования, поэтому эту проверку стоит провести в первую очередь.
Q2: Может ли FlashProve окончательно разрешить споры о том, что модель «поглупела»?
Нет. Он может проверить, получен ли ответ с использованием указанных весов, но для этого нужно доверенное обязательство относительно модели, с которым можно свериться. Доказательство весов автоматически не охватывает такие факторы, как системный промпт, политика безопасности, обрезка контекста, способ квантования и параметры декодирования.
Q3: Как провести надёжное сравнительное тестирование?
Зафиксируйте все параметры и промпты, подготовьте несколько тестовых сценариев с однозначными ответами и запустите каждый из них несколько раз, чтобы подсчитать долю правильных ответов. Также записывайте finish_reason и расход токенов. Через APIYI apiyi.com можно сравнить несколько моделей, используя один и тот же OpenAI-совместимый код. Новым пользователям доступен бесплатный лимит, который можно потратить на такие проверки.
Q4: Почему reasoning-модель может работать через API хуже, чем в веб-версии?
Среди частых причин — выключенный режим размышлений или другой бюджет на размышления, параметры сэмплирования, отличающиеся от официальных рекомендаций, неправильная передача содержимого размышлений в многотуровом диалоге, а также отсутствие в API системного промпта и инструментов, встроенных в веб-версию. Рекомендуем по каждому пункту свериться с разделом об API в официальной документации модели.
Q5: Как общаться с поставщиком сервиса, если самостоятельная проверка не выявила ошибок?
Подготовьте примеры запросов с зафиксированными параметрами, статистику нескольких запусков, данные для сравнения с официальным каналом и укажите период, когда наблюдались отклонения. В консоли APIYI apiyi.com можно посмотреть логи вызовов и статистику использования. Приложите соответствующие записи — это поможет значительно быстрее найти причину.
Модель стала работать хуже: главное о диагностике
- Ухудшение работы модели не обязательно означает её подмену: на результат также влияют системный промпт, контекст, параметры декодирования и другие настройки.
- Ошибки в параметрах встречаются часто: команда Kimi подтвердила, что значительная часть аномальных результатов тестов связана с неправильными параметрами декодирования.
- Проверяйте всё поэтапно: сначала настройки на стороне клиента, затем результаты сравнительных тестов и только после этого — возможные проблемы на стороне сервиса.
- Один вопрос не показателен: нужно сравнивать распределение результатов нескольких запусков, а не судить по одному-двум ответам.
- Проверка весов имеет ограничения: FlashProve подтверждает только идентичность весов и не выявляет изменения настроек на уровне продукта.
- Используйте единые инструменты тестирования: для сравнения можно воспользоваться совместимым интерфейсом и логами APIYI apiyi.com.
Итоги
Раньше споры о том, стала ли модель работать хуже, в основном строились на скриншотах и личных ощущениях. FlashProve от Anthropic предлагает способ проверить, не подменили ли модель. Но при этом инструмент напоминает: помимо весов, на результат влияет целый слой настроек.
- Сначала проверьте свою сторону: параметры декодирования, max_tokens, список сообщений и содержимое, полученное через RAG, — самые простые и недорогие отправные точки.
- Затем проведите сравнение: сопоставьте результаты с официальной версией при фиксированных параметрах, на нескольких сценариях и в нескольких запусках. Опирайтесь на данные, а не на ощущения.
- Наконец, свяжитесь с провайдером: убедившись, что на стороне клиента всё в порядке, передайте ему записи запросов и статистику, чтобы найти проблему на стороне сервиса.
Рекомендуем включить сравнительный скрипт из этой статьи в регулярные регрессионные тесты. Через APIYI apiyi.com можно быстро проверить работу нескольких моделей с помощью одного и того же кода: платформа предоставляет бесплатный лимит для тестирования и единый интерфейс, совместимый с OpenAI.
📚 Источники
- 36氪 / APPSO — разбор исследования Anthropic о проверяемом инференсе: принципы работы FlashProve, данные экспериментов и обсуждение причин «снижения интеллекта» моделей
- Ссылка:
36kr.com/p/4056019887510401 -
Описание: основной источник фактов и данных для статьи, включая сведения о Kimi Vendor Verifier и Model Equality Testing
-
Anthropic Research — Provable Inference: официальная страница исследования FlashProve
- Ссылка:
anthropic.com/research/provable-inference - Описание: здесь можно найти технический отчёт, открытый исходный код и формальные доказательства
Автор: техническая команда APIYI
Технические вопросы: если у вас возникли проблемы при выяснении причин необычных результатов вызова модели, свяжитесь с нами через главную страницу сайта APIYI apiyi.com. Подробнее о подключении — в документации на docs.apiyi.com.