作者注:模型“變笨了”不一定是模型被替換。本文從 Anthropic 最新的 FlashProve 推理證明研究出發,把影響 API 調用效果的因素整理成一套從調用方到服務端的排查順序。
“同一道題,官網能做出來,換成 API 調用就卡住了”,“這個月模型明顯變笨了”,類似的抱怨幾乎每個通過 API 接入大模型的開發者都遇到過。很多人的第一反應是:後臺是不是把模型換了?
近期 Anthropic 發佈了開源研究原型 FlashProve,嘗試用密碼學證明來覈驗“這次輸出是否真的來自某套指定權重”。這讓“模型有沒有被掉包”第一次有了可以數學驗證的方向。
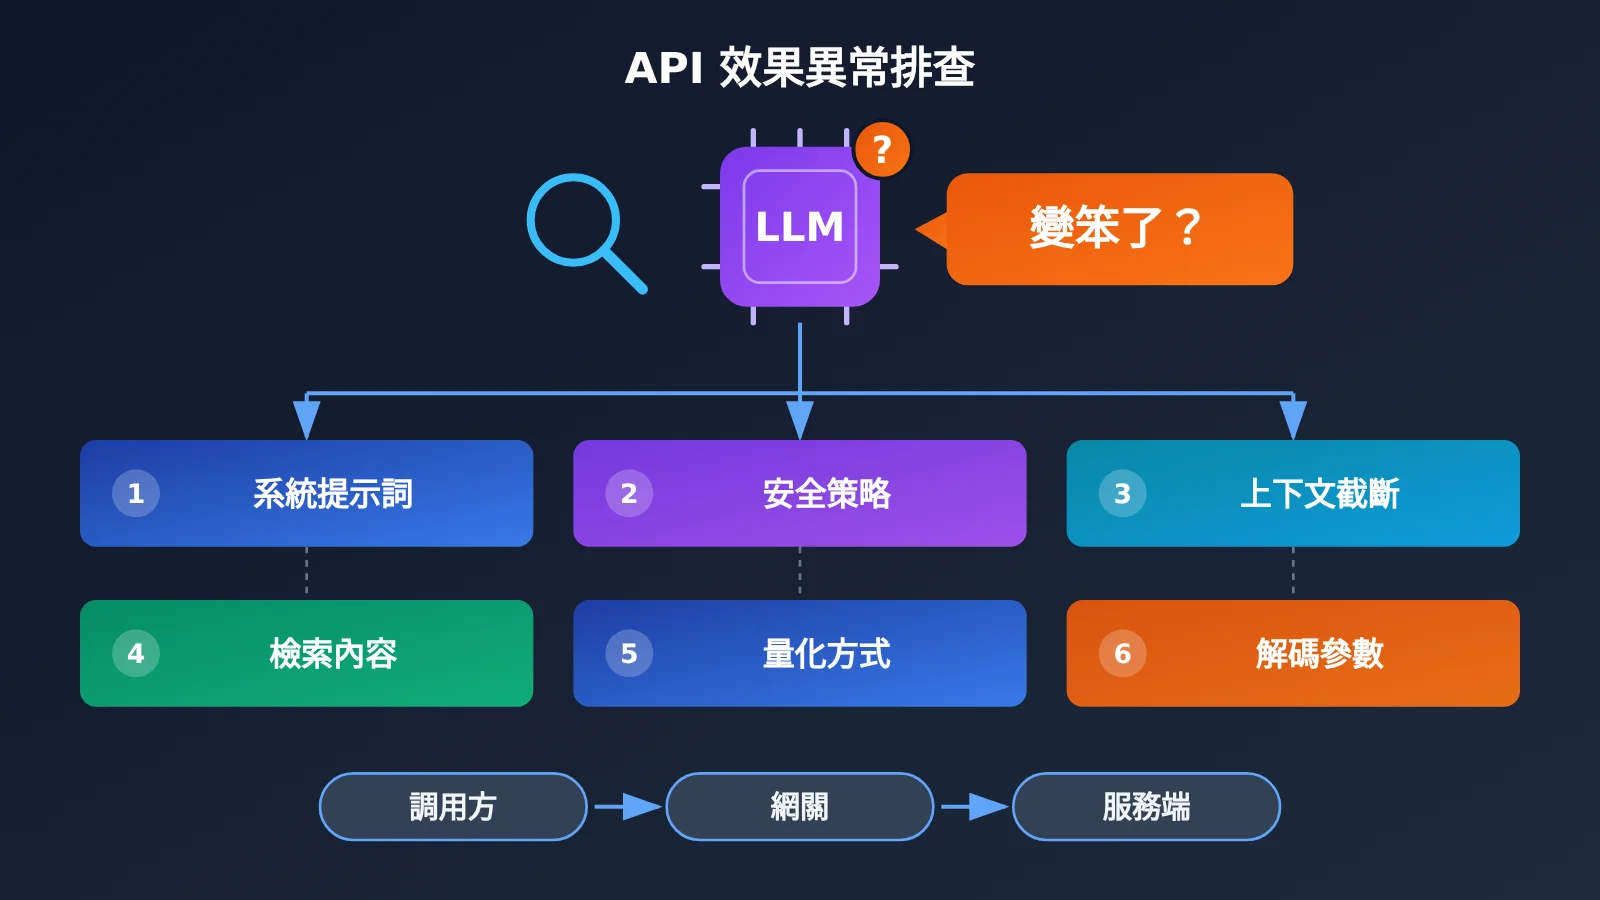
但這不是“降智”問題的終點。研究報道里明確指出:即使權重身份已經確認,系統提示詞、安全策略、上下文截斷、檢索內容、量化方式和解碼參數,依然都會影響最終效果。Kimi 團隊的排查經驗也顯示,相當一部分跑分異常其實來自解碼參數誤用。
核心價值:讀完本文,你會得到一份模型變笨了時的排查清單,知道哪些問題自己就能查,哪些需要服務商配合,以及爲什麼“問幾個問題鑑別模型”並不可靠。
模型變笨了排查:核心信息速覽
先把這次討論的背景信息梳理清楚。引發討論的是 Anthropic 關於“可證明推理”的研究,而它在社區引出的核心問題,正是模型變笨了到底該怪誰。
| 信息項 | 詳情 |
|---|---|
| 發佈方 | Anthropic 研究團隊,同時公開代碼、技術報告和 Lean 形式化證明 |
| 核心內容 | FlashProve:基於 zkSNARK 零知識簡潔證明,爲模型推理生成密碼學證明 |
| 解決的問題 | 不公開權重、不需要用戶重跑模型,也能覈驗輸出是否來自指定權重 |
| 解決不了的問題 | 系統提示詞、安全策略、上下文、解碼參數等產品層面的變化 |
| 對開發者的啓示 | 模型效果異常要分層排查,不能只盯着“是否被替換” |
FlashProve 如何證明“你就是你”
FlashProve 的思路分兩步。首先,服務商爲模型權重生成一個“承諾”,相當於一組能唯一鎖定權重的密碼學指紋,但不會暴露權重本身。隨後,服務商針對給定的輸入和輸出生成一份證明,用戶拿到承諾、提示詞、回答和證明文件,就能在自己電腦上覈驗這段輸出是否確實由被鎖定的權重計算得出。
零知識的設計保證了驗證者不會因此拿到權重、中間計算值,也看不到 MoE 模型每層調用了哪些專家。這比“讓模型自報家門”可靠得多,因爲回答裏寫的模型名字不再充當身份證明,被檢查的是輸出與權重之間的計算關係。
Anthropic 用公開 4-bit 權重的 Llama 4 Maverick 做了實驗,這是一個約 4000 億參數、每個 token 激活約 170 億參數的混合專家模型。公佈的關鍵數據如下:
| 指標 | 實驗數據 | 說明 |
|---|---|---|
| 證明生成吞吐 | 單張 H100 約 110 tokens/秒 | 是證明生成速度,不是聊天輸出速度 |
| 證明文件大小 | 每個 1,024-token 請求約 19 MB | 需要隨響應一起傳遞 |
| 驗證耗時 | 24 線程 CPU 約 17 秒 | 驗證不需要 GPU,筆記本即可完成 |
| 權重承諾生成 | 約 39 分鐘 | 只需生成一次 |
| 額外成本 | GPU 時間約爲普通 vLLM 推理的 70~95 倍 | 距離大規模普及仍有距離 |
爲什麼確認了權重,模型變笨了仍然可能發生
FlashProve 有一個關鍵前提:用戶必須提前知道“正品模型”的承諾是什麼。如果服務方只能證明回答來自它自己選的某個模型,而用戶無法確認這個模型就是自己購買的那個,證明依然解決不了身份問題。理想狀態是由模型廠商或可信機構公開發布承諾,用戶固定覈驗這個指紋。
更重要的是,權重沒變不等於服務沒變。一份綁定權重的證明,並不能自動回答系統提示詞有沒有調整、上下文有沒有被截斷、解碼參數是否一致等問題。這正是模型變笨了這類抱怨長期存在的原因:它往往是多個環節疊加的結果。
模型變笨了的 6 類常見原因
把參考研究中列出的影響因素逐一拆開,再按“問題可能出在哪一側”歸類,會發現相當一部分問題其實在調用方自己手裏。
| 影響因素 | 典型表現 | 可能發生在哪一側 | 用戶能否自查 |
|---|---|---|---|
| 解碼參數 | 輸出發散、重複、推理模式跑分偏低 | 調用方爲主,服務端也可能設默認值 | 能,覈對請求參數 |
| 上下文截斷 | 前文“失憶”、回答不完整、指令被忽略 | 調用方和服務端都可能 | 部分能,覈對 token 用量 |
| 系統提示詞 | 風格變化、拒答增多、格式不對 | 調用方或服務端注入 | 能查自己的,查不到服務端的 |
| 安全策略 | 某類問題突然被拒絕或回答變保守 | 服務端爲主 | 較難,需要服務商說明 |
| 檢索內容 | RAG 場景回答質量波動 | 調用方的檢索鏈路 | 能,檢查召回內容 |
| 量化方式 | 整體能力輕微下降、長推理出錯率上升 | 服務端部署側 | 不能,需要服務商配合 |
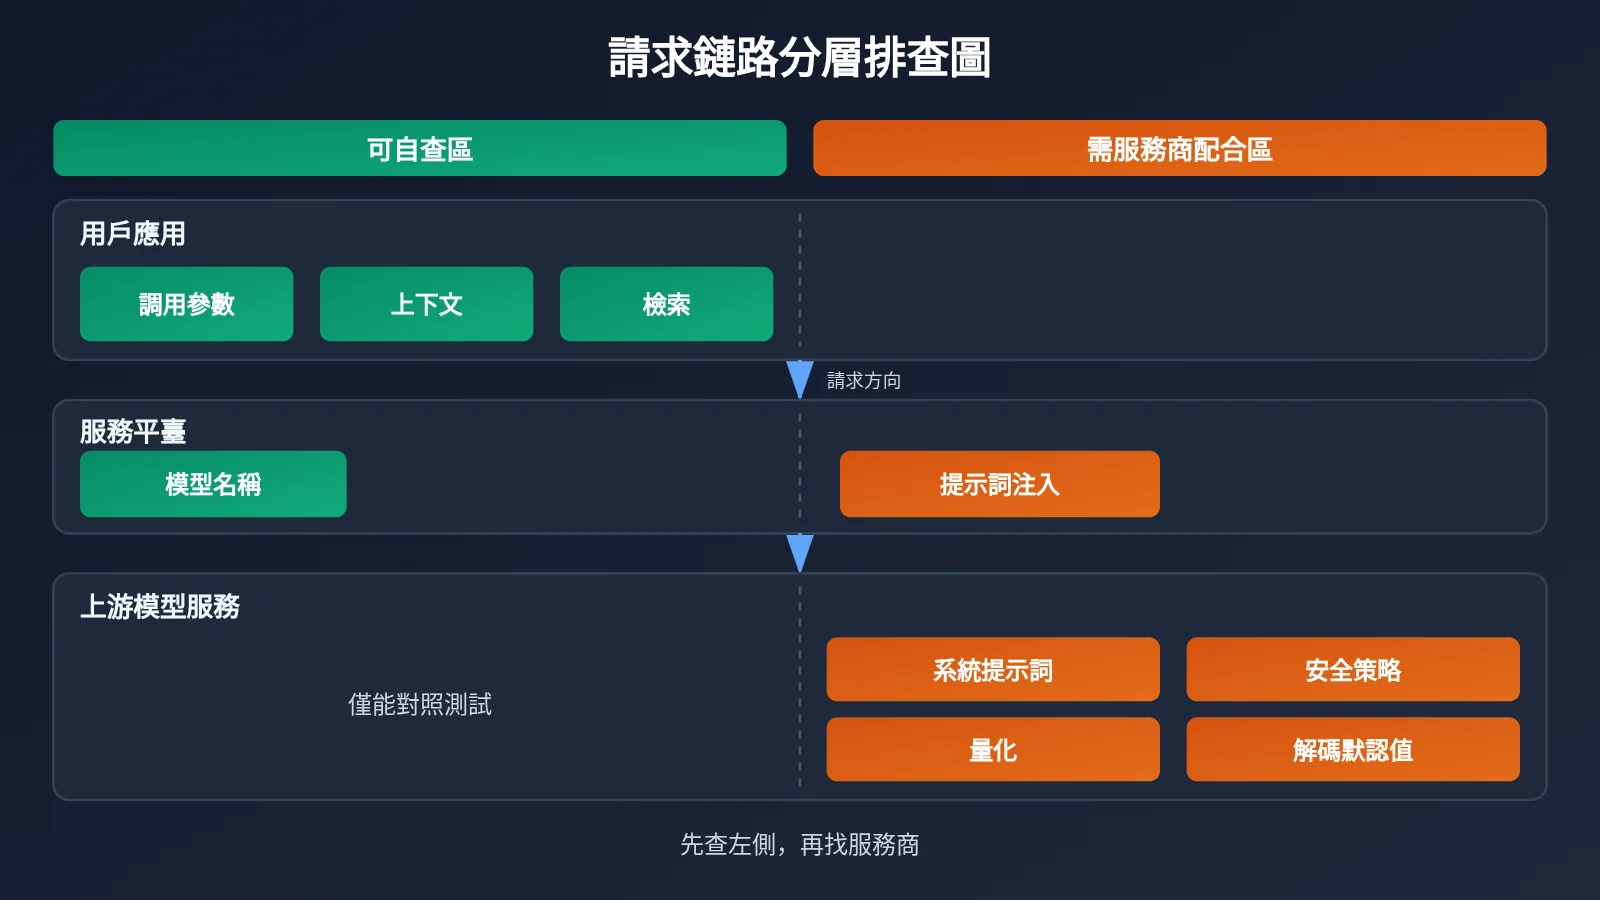
解碼參數誤用:模型變笨了最容易被忽視的原因
Kimi 團隊在介紹 Kimi Vendor Verifier 時分享過一個很有代表性的發現:自 K2 Thinking 發佈後,他們收到不少社區關於跑分異常的反饋,調查後確認其中相當一部分來自解碼參數誤用。團隊隨後在 Thinking 模式下對相關參數做了約束,並檢查思考內容是否被正確傳回。
這對普通開發者的啓示很直接:temperature、top_p、max_tokens、推理模式開關等參數一旦和官方推薦不一致,模型表現就可能明顯偏離預期。尤其是推理類模型,不同廠商對採樣參數、思考預算、多輪對話中思考內容的回傳方式都有各自要求,具體數值請以各模型官方文檔爲準,而不是沿用普通對話模型的習慣配置。
上下文沒傳完整:看起來像“失憶”的模型變笨了
另一類高頻問題是上下文。多輪對話裏如果只傳了最新一句,模型自然“記不住”前文;工作流裏如果歷史消息超過了模型窗口,被截斷的往往是最早的系統指令,結果就是模型突然不按格式輸出。此外,max_tokens 設置過小會讓回答在中途被截斷,表現爲“答一半就停了”。
這些問題都會被體感歸結爲模型變笨了,但只要檢查請求體和響應中的結束原因,大多數時候能當場定位。
模型變笨瞭如何排查:3 步排查順序
既然原因分佈在調用鏈的不同位置,排查就應該從成本最低、最可控的環節開始。建議按下面的順序推進:
- 先查調用方:覈對 model 名稱、解碼參數、max_tokens、系統提示詞、完整消息列表,以及 RAG 召回的內容是否正確。
- 再做對照測試:固定參數和提示詞,與官方渠道或官方文檔描述的表現對比,多次運行觀察分佈而不是單次結果。
- 最後判斷服務端:如果調用方配置無誤且對照差異穩定可復現,再帶着請求記錄和測試結果聯繫服務商。
極簡示例:固定參數做一次可復現調用
第一步最實用的做法,是把參數全部顯式寫出來,避免依賴任何默認值,並打印結束原因和 token 用量:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 換成你要排查的模型名
    messages=[{"role": "user", "content": "用三句話解釋什麼是零知識證明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
如果 finish_reason 是 length,說明回答被 max_tokens 截斷了,這時“答不完整”就不是模型變笨了,而是參數設置問題。usage 中的輸入 token 數則可以幫你確認上下文是否真的完整傳了過去。
查看完整對照測試腳本
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 切換模型只需修改 model 參數
)

# 顯式寫出所有參數,避免依賴默認值
PARAMS = {
    "temperature": 0.2,   # 推理模型請按官方文檔推薦值設置
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一個數加上它的一半等於 45,這個數是多少?只給出數字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 輸出三種水果名稱,鍵名爲 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """同一用例多次運行,統計命中率、截斷次數和 token 用量"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是嚴謹的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # 替換爲待排查模型
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
這個腳本的關鍵不在測試題本身,而在於三點:參數全部固定並隨報告輸出,同一用例多次運行看命中率,記錄 finish_reason 和 prompt_tokens 來排除截斷和上下文問題。只有這三項都排除後,才值得進入“服務端是否有變化”的討論。
🚀 排查建議:API易 apiyi.com 採用 OpenAI 兼容接口,切換模型只需改 model 參數,便於用同一套測試腳本橫向對比多個模型;平臺提供調用日誌和用量統計,可以用來回看請求消耗和 token 用量,輔助判斷上下文是否完整傳入。具體日誌展示哪些字段,建議以平臺控制檯實際頁面爲準。
用戶自查與服務商配合的分工
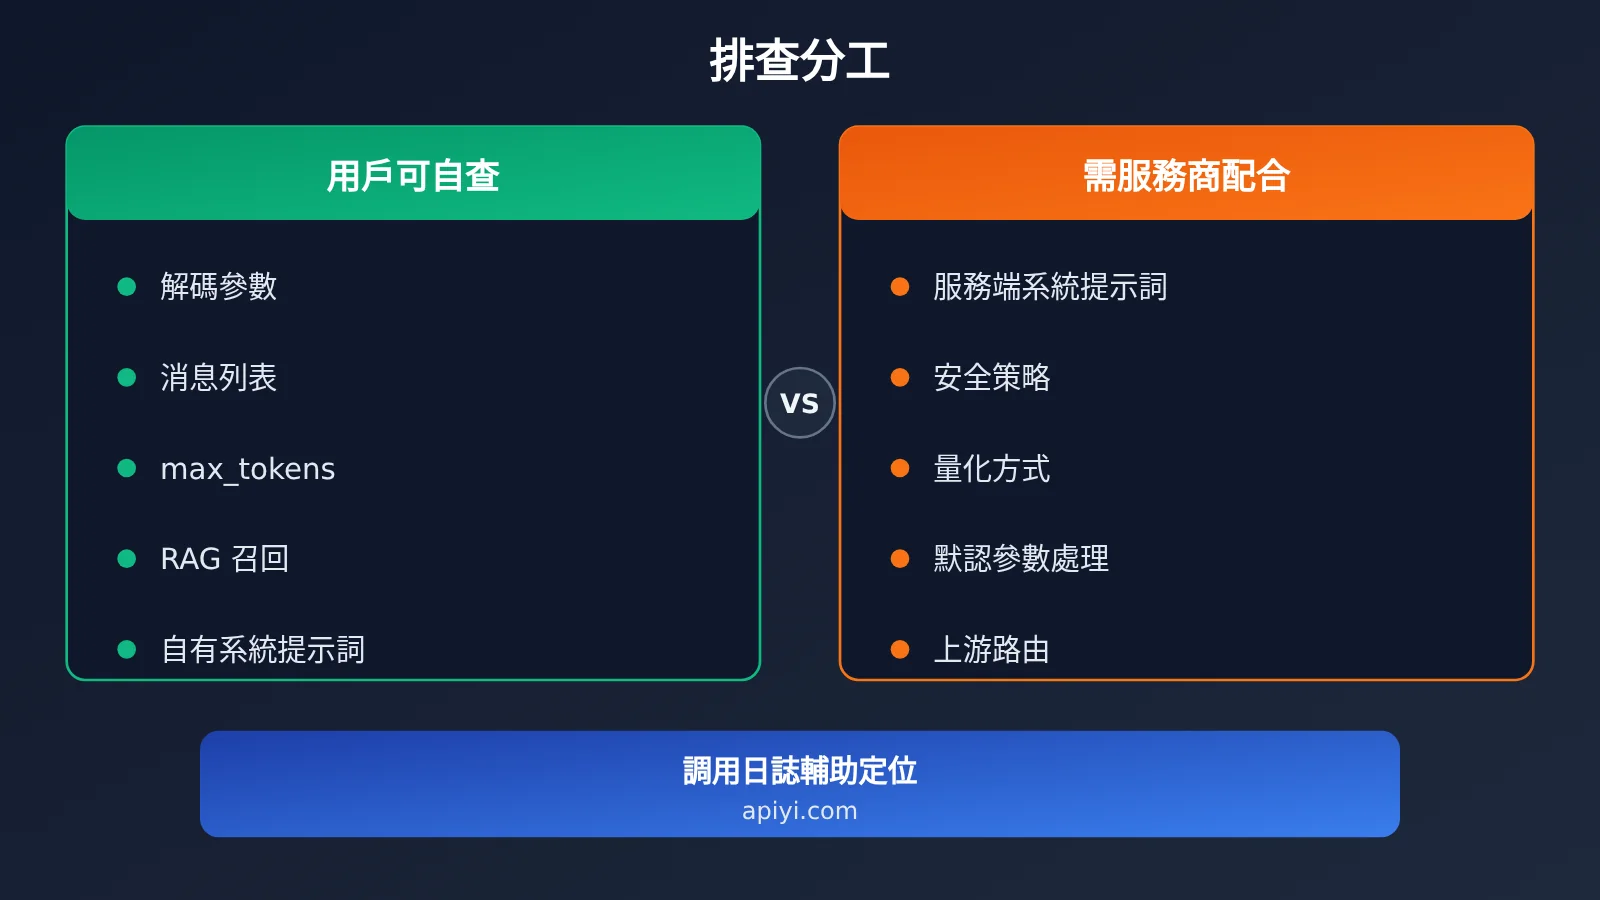
| 排查項 | 用戶自查方法 | 需要服務商提供的信息 |
|---|---|---|
| 解碼參數 | 打印完整請求體,對照官方文檔 | 平臺是否對參數做改寫或補默認值 |
| 上下文完整性 | 檢查消息列表與 prompt_tokens | 是否存在服務端截斷或窗口限制 |
| 推理模式 | 覈對思考開關和思考內容回傳方式 | 上游是否支持對應參數 |
| 量化與部署 | 無法自查 | 部署精度、上游渠道說明 |
| 安全策略 | 對比同一請求在官方渠道的表現 | 是否疊加了額外審覈規則 |
找服務商時,帶上固定參數的請求樣本、多次運行的統計結果和對照數據,溝通效率會高很多。單純一句“模型變笨了”,對方很難定位問題。
爲什麼“問幾個問題鑑別模型”判斷模型變笨了並不可靠
社區裏流行一種鑑別方法:問模型一個只有新版本才知道的知識點,答不上來就判定“被換了”。這種方法的問題在於,單次回答本身帶有隨機性,碰巧答錯、參數不同、上下文缺失、廠商內部路由差異,最後都會表現爲同一句“這不是我要的模型”。
斯坦福大學的研究項目 Model Equality Testing 提供了一個更嚴謹的視角:研究者測試了 2024 年四款 Llama 模型的 31 個商業 API 端點,發現其中 11 個端點的輸出分佈與 Meta 發佈權重的參考分佈存在統計差異。注意這裏的方法是比較輸出“分佈”,而不是看一兩個問題的對錯。
對開發者來說,可借鑑的是統計思路:用固定參數、多個用例、多次運行去觀察穩定差異。這也是上面對照腳本採用“命中率”而不是“單次結果”的原因。
模型變笨了現象的影響分析
對開發者的影響
- 排查習慣要前移:遇到效果異常先檢查自己的請求體,參數誤用和上下文缺失是成本最低、命中率最高的排查方向。
- 參數要顯式化:生產環境中不要依賴任何默認值,推理模型尤其要按官方文檔配置,並把參數納入版本管理。
- 建立迴歸測試集:維護一組固定用例定期跑,模型變笨了時能拿出數據而不是體感。
- 保留調用記錄:請求參數、token 用量、結束原因都是與服務商溝通時的關鍵證據。
對行業的影響
- 驗證從體感走向證明:FlashProve 展示了“權重身份可驗證”的方向,未來模型廠商、評測機構和監管方都可能用它確認實際服務的模型。
- 透明度要求會擴展:權重之外,系統提示詞、解碼策略、部署配置是否一致,會成爲下一階段的討論焦點。
- 普及仍需時間:證明成本約爲普通推理的數十倍,還需要更長上下文支持和可信的承諾發佈機制,短期內難以覆蓋日常調用。
常見問題 FAQ
Q1: 模型變笨了,最先應該檢查什麼?
先檢查自己的請求:model 名稱是否正確、temperature 等解碼參數是否符合官方推薦、max_tokens 是否過小、多輪對話的歷史消息是否完整傳入。Kimi 團隊的經驗表明,相當一部分跑分異常來自解碼參數誤用,這一步往往最先見效。
Q2: FlashProve 能徹底解決模型變笨了的爭議嗎?
不能。它能覈驗輸出是否來自指定權重,但前提是有可信的模型承諾可供對照。系統提示詞、安全策略、上下文截斷、量化方式、解碼參數這些因素,並不在一份權重證明的自動覆蓋範圍內。
Q3: 如何做一次可信的對照測試?
固定全部參數和提示詞,準備多個有明確答案的用例,每個用例運行多次統計命中率,同時記錄 finish_reason 和 token 用量。通過 API易 apiyi.com 可以用同一套 OpenAI 兼容代碼對多個模型做橫向測試,新用戶有免費測試額度可用於這類驗證。
Q4: 推理模型在 API 中表現不如網頁版,可能是什麼原因?
常見原因包括思考模式未開啓或思考預算設置不同、採樣參數與官方推薦不一致、多輪對話中思考內容的回傳方式不對,以及網頁版自帶的系統提示詞和工具在 API 中並不存在。建議逐項對照該模型官方文檔的 API 說明。
Q5: 自查無誤後,怎樣和服務商溝通?
準備好固定參數的請求樣本、多次運行的統計結果、與官方渠道的對照數據,以及出現異常的時間段。在 API易 apiyi.com 控制檯可以查看調用日誌和用量統計,把對應記錄一併提供,能顯著縮短定位時間。
模型變笨了排查覈心要點 Key Takeaways
- 模型變笨了未必是被替換:系統提示詞、上下文、解碼參數等都會改變效果。
- 參數誤用很常見:Kimi 團隊確認相當一部分跑分異常源於解碼參數誤用。
- 排查要分層推進:先查調用方,再做對照測試,最後判斷服務端問題。
- 單題鑑別不可靠:應比較多次運行的輸出分佈,而不是看一兩個答案。
- 權重證明有邊界:FlashProve 只驗證權重身份,覆蓋不了產品層配置變化。
- 測試工具要統一:可藉助 API易 apiyi.com 的兼容接口和日誌做橫向對比。
總結
模型變笨了這類問題,過去主要靠截圖和體感爭論。Anthropic 的 FlashProve 爲“是否被掉包”提供了可驗證的方向,但它同樣提醒我們:權重之外,還有一整層會影響效果的配置。
- 先自查:解碼參數、max_tokens、消息列表和 RAG 召回內容,是成本最低的排查起點。
- 再對照:用固定參數、多用例、多次運行的方式與官方表現對比,用數據代替感覺。
- 最後溝通:確認調用方無誤後,帶着請求記錄和統計結果找服務商定位服務端問題。
建議把本文的對照腳本納入日常回歸測試,推薦通過 API易 apiyi.com 用同一套代碼快速驗證多個模型的表現,平臺提供免費測試額度和統一的 OpenAI 兼容接口。
📚 參考資料
- 36氪 / APPSO – Anthropic 可證明推理研究解讀:FlashProve 原理、實驗數據及“降智”成因討論
- 鏈接:
36kr.com/p/4056019887510401 -
說明: 本文事實數據的主要來源,包含 Kimi Vendor Verifier 與 Model Equality Testing 的相關介紹
-
Anthropic Research – Provable Inference:FlashProve 官方研究頁面
- 鏈接:
anthropic.com/research/provable-inference - 說明: 可查閱技術報告、開源代碼與形式化證明
作者: APIYI 技術團隊
技術交流: 排查調用效果異常遇到問題,歡迎通過 API易 apiyi.com 網站首頁聯繫我們,更多接入說明可訪問 docs.apiyi.com 文檔中心