Nota do autor: fazemos uma análise sistemática de 5 causas comuns de interrupção na conexão com APIs de imagem, abordando configurações de timeout, gateways proxy, conexões internacionais, estratégias de repetição e ambiente de execução. O objetivo é ajudar você a receber os resultados com segurança em cenários de geração de imagens internacionais.
Você envia uma solicitação de geração de imagens, espera dezenas de segundos e, no fim, só recebe um Connection reset ou Read timed out. Esse é um problema comum para quem desenvolve soluções de geração de imagens com conexões internacionais. E o pior: o modelo pode já ter gerado a imagem, mas o resultado não conseguiu chegar ao seu programa. Neste artigo, vamos apresentar 5 causas comuns de interrupção na conexão com APIs de imagem e como resolvê-las, para ajudar você a gerar imagens com estabilidade tanto em ambientes hospedados no exterior quanto no Brasil.
Este não é um guia genérico sobre redes. O conteúdo vem de problemas reais que encontramos repetidamente ao ajudar desenvolvedores a integrar seus sistemas. Por exemplo, uma pessoa com um serviço hospedado em um servidor nos Estados Unidos queria saber principalmente qual endereço de acesso usar, se as chamadas internacionais seriam lentas e como garantir que respostas grandes, como imagens, fossem recebidas por completo.
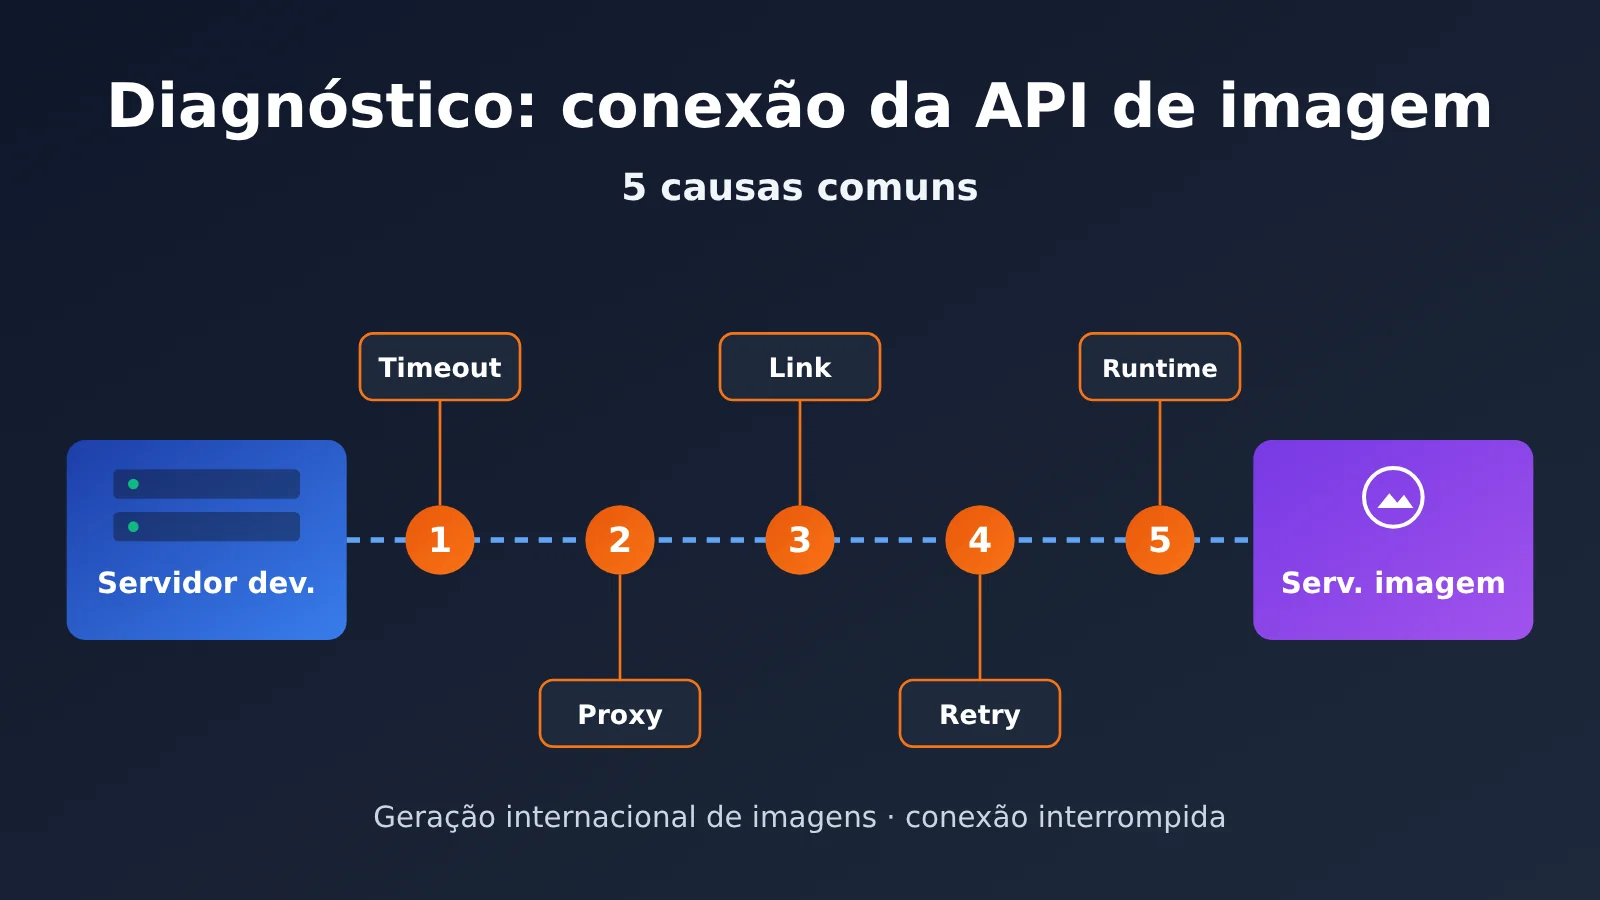
O que você vai aprender: ao terminar este artigo, você saberá diagnosticar problemas de interrupção na conexão com APIs de imagem em cinco camadas — “cliente → gateway → conexão → repetição → ambiente de execução” — e terá um modelo de código para configurar timeouts e novas tentativas, pronto para reutilizar.
Principais pontos para diagnosticar interrupções na conexão com a API de imagens
Vamos direto à conclusão. Quase todas as interrupções na conexão com a API de imagens acontecem em um destes 5 pontos, em ordem de prioridade na investigação:
| Nº | Causa comum | Sinais típicos | Como corrigir |
|---|---|---|---|
| 1 | Tempo limite do cliente muito curto | O erro timeout aparece sempre após o mesmo número de segundos |
Aumente separadamente o tempo limite de leitura |
| 2 | Tempo limite de inatividade no proxy ou gateway | A conexão cai perto de 60 segundos e retorna 502/504 | Ajuste os tempos limite do Nginx e do balanceador de carga |
| 3 | Qualidade da conexão internacional e respostas grandes | Interrupções ocasionais; quanto maior o resultado, maior a chance de falha | Escolha o endereço de acesso adequado e reduza o volume de dados retornado |
| 4 | Estratégia de novas tentativas inadequada | Cobranças duplicadas ou mais falhas a cada nova tentativa nos horários de pico | Desative novas tentativas automáticas sem critério e implemente um intervalo progressivo |
| 5 | Limitações do próprio ambiente de execução | A interrupção sempre ocorre em ambientes serverless ou em conexões diretas do navegador | Use um processo persistente no backend ou uma tarefa assíncrona |
Por que a API de imagens sofre mais interrupções do que a interface de conversa
As interfaces de geração de imagens geralmente funcionam por chamadas síncronas: depois que a solicitação é enviada, a conexão precisa permanecer ativa até o modelo concluir a geração e enviar o resultado. As interfaces de conversa podem transmitir a resposta em fluxo e começam a retornar dados em poucas centenas de milissegundos. Já durante a geração de imagens, muitas vezes não há tráfego de dados por nenhum período — esse “silêncio” pode durar dezenas de segundos ou até mais, o que facilita o acionamento dos tempos limite de inatividade em diferentes camadas.
Outro fator importante é o tamanho da resposta. Quando uma imagem de alta resolução é retornada em formato base64, a resposta pode ter vários MB. Arquivos de vídeo são ainda maiores. Basta uma oscilação na conexão internacional para que uma resposta grande tenha mais chances de ser transmitida de forma incompleta.
O ponto que merece mais atenção é: se a conexão cair, o resultado se perde, mas a geração pode já ter sido concluída e cobrada. O servidor não consegue “reenviar” o resultado para uma conexão que já foi encerrada. Por isso, investigar interrupções de conexão não é apenas uma questão de estabilidade: também afeta diretamente os custos.
Como escolher o endpoint para geração de imagens entre países
Os servidores da APIYI ficam na Costa Oeste dos Estados Unidos. Para operações no exterior, basta usar https://api.apiyi.com/v1: a distância física é menor e a latência, mais baixa. Muitos desenvolvedores se perguntam por que o acesso a partir da China continental também é rápido. Isso acontece porque a plataforma oferece aceleração por rotas otimizadas até a China, especialmente para atender a operações com respostas grandes, como geração de imagens e vídeos.
| Região de implantação | Endpoint recomendado | Características da conexão | Observações |
|---|---|---|---|
| Estados Unidos / América do Norte | Endpoint padrão | Está na mesma região do servidor, com a menor latência | Verifique principalmente o tempo limite do gateway local |
| Europa / Ásia-Pacífico fora da China | Endpoint padrão | Usa a rede pública entre regiões e oferece estabilidade geral | Aumente um pouco o tempo limite de leitura |
| China continental | Endpoint padrão | Conta com aceleração por rotas otimizadas até a China | Evite adicionar outro proxy instável |
| Máquina de desenvolvimento local | Endpoint padrão | É bastante afetada pela rede local | Não use os resultados locais para avaliar o desempenho em produção |
Como você pode ver, no modo compatível com OpenAI, independentemente de onde a aplicação esteja implantada, basta alterar o base_url. Não é necessário manter várias versões do código para regiões diferentes. O que realmente precisa ser ajustado conforme a região são os parâmetros de tempo limite e as configurações dos intermediários da conexão.
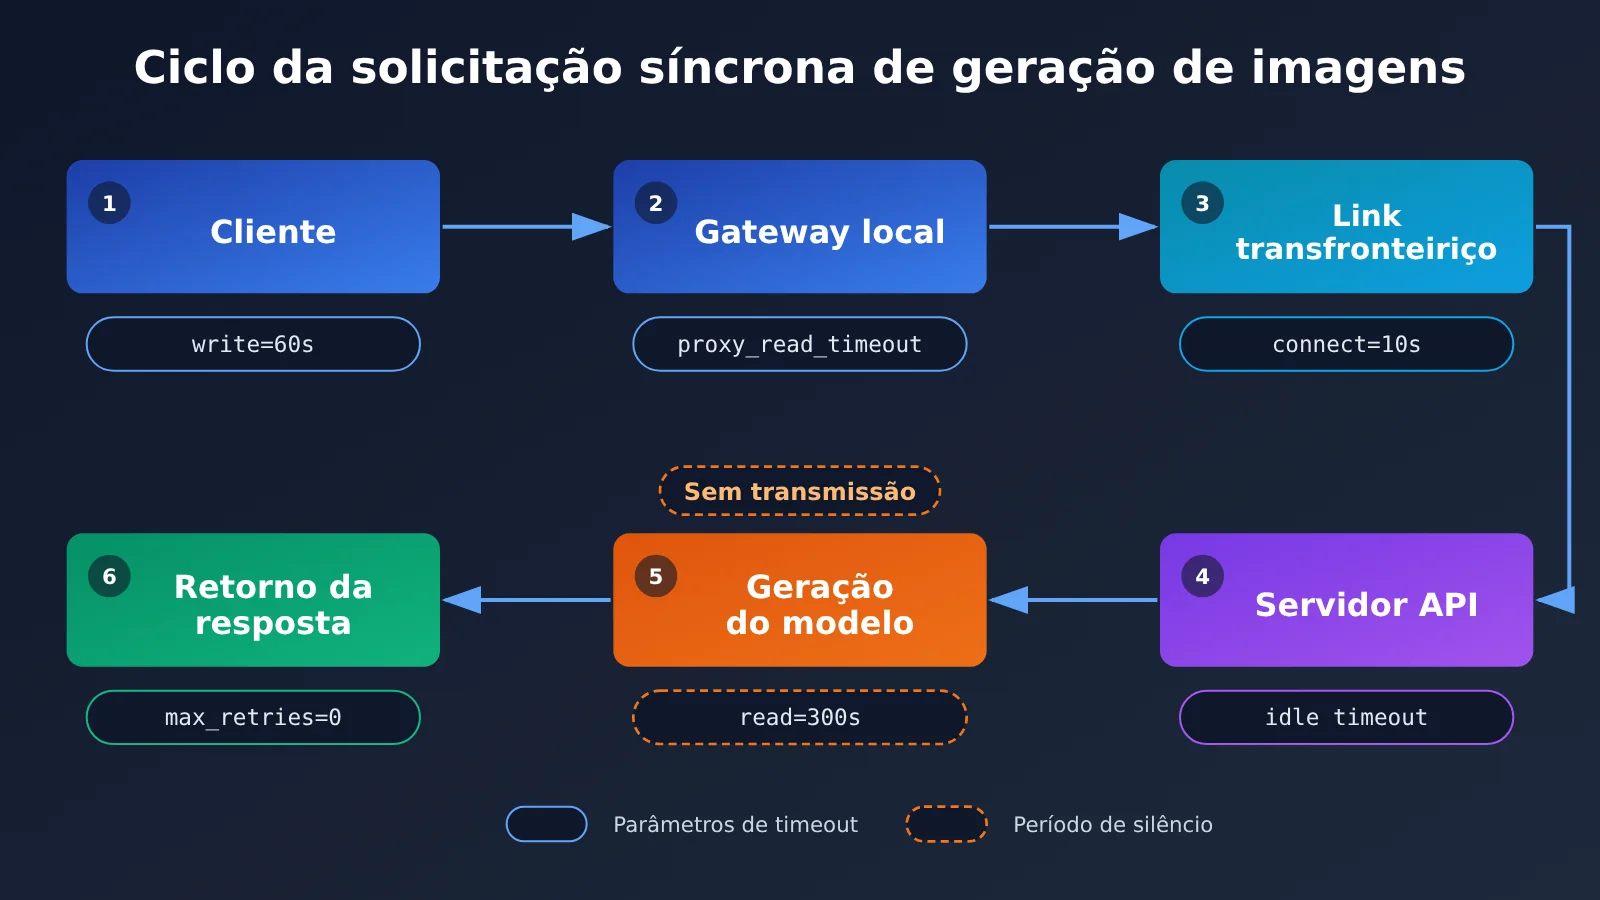
Guia rápido para diagnosticar interrupções de conexão na API de imagens
Exemplo mínimo: configure corretamente o tempo limite e as novas tentativas
Muitos problemas de interrupção de conexão podem ser resolvidos ajustando corretamente o tempo limite e as novas tentativas do SDK. O exemplo abaixo usa o SDK oficial da OpenAI para Python:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Endereço unificado da APIYI, compatível com implantações no exterior e no Brasil
    timeout=300,      # A geração de imagens é uma chamada síncrona; reserve tempo suficiente
    max_retries=0,    # Desative as novas tentativas automáticas do SDK para evitar gerar novamente e cobrar de novo após uma desconexão
)

result = client.images.generate(
    model="gpt-image-1",  # Substitua pelo modelo disponível na lista do painel
    prompt="Um shiba correndo diante de montanhas nevadas, com iluminação cinematográfica",
    size="1024x1024",
)
print("Resultado recebido. Tamanho dos dados:", len(result.data[0].b64_json or ""))
Há dois detalhes que passam despercebidos com facilidade. Primeiro, o SDK oficial da OpenAI para Python faz novas tentativas automáticas em caso de erros de conexão e tempo limite. Isso costuma ser tranquilo para APIs de conversa, mas, na API de imagens, cada nova tentativa pode iniciar uma geração diferente. Segundo, quando timeout recebe um único número, ele se aplica tanto à conexão quanto à leitura. Em produção, é melhor configurar esses tempos separadamente, como no código completo abaixo.
Ver implementação completa (tempos limite separados + novas tentativas limitadas + salvamento do resultado)
import base64
import time
import uuid
import httpx
import openai

# Timeout em camadas: a conexão deve falhar rápido, mas a leitura precisa de mais tempo
TIMEOUT = httpx.Timeout(
    connect=10.0,   # Estabelecimento de conexão TCP/TLS: mais de 10 segundos geralmente indica um problema de rede
    read=300.0,     # Espera pela geração e pelo retorno de uma resposta grande
    write=60.0,     # Necessário para enviar imagens de referência (imagem para imagem/edição)
    pool=10.0,
)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interface compatível com OpenAI da APIYI
    timeout=TIMEOUT,
    max_retries=0,
)

# Tente novamente apenas em erros nos quais é provável que a solicitação não tenha chegado ao servidor
RETRYABLE_BEFORE_SEND = (openai.APIConnectionError,)

def generate_image(prompt: str, out_dir: str = ".", max_attempts: int = 2) -> str:
    task_id = uuid.uuid4().hex[:8]
    for attempt in range(1, max_attempts + 1):
        start = time.time()
        try:
            resp = client.images.generate(
                model="gpt-image-1",
                prompt=prompt,
                size="1024x1024",
            )
            # Salve o resultado imediatamente para evitar perdê-lo caso ocorra um erro na etapa seguinte
            path = f"{out_dir}/img_{task_id}.png"
            with open(path, "wb") as f:
                f.write(base64.b64decode(resp.data[0].b64_json))
            print(f"[{task_id}] Sucesso, levou {time.time() - start:.1f}s")
            return path

        except openai.APITimeoutError:
            # Timeout de leitura: é bem provável que o servidor já esteja gerando a imagem; não é recomendável tentar novamente de imediato
            print(f"[{task_id}] Timeout de leitura após {time.time() - start:.1f}s. Verifique o timeout e a conexão")
            raise

        except RETRYABLE_BEFORE_SEND as e:
            elapsed = time.time() - start
            # Se a falha ocorrer rapidamente durante o estabelecimento da conexão, considere que a solicitação não foi enviada e tente novamente com backoff
            if elapsed < 15 and attempt < max_attempts:
                wait = 2 ** attempt
                print(f"[{task_id}] Falha ao estabelecer conexão. Nova tentativa em {wait}s: {e}")
                time.sleep(wait)
                continue
            print(f"[{task_id}] Conexão interrompida ({elapsed:.1f}s). Não haverá nova tentativa: {e}")
            raise

        except openai.APIStatusError as e:
            # Deixe 429/5xx a cargo da lógica de negócio da camada superior para evitar uma sobrecarga em cascata nos horários de pico
            print(f"[{task_id}] Código de status {e.status_code}: {e.message}")
            raise

if __name__ == "__main__":
    generate_image("Cena urbana noturna em estilo cyberpunk, com luzes de neon refletidas nas ruas após a chuva")
🚀 Sugestão para começar: execute primeiro o exemplo mínimo acima no seu ambiente real de implantação e registre o tempo total. Depois, use esse valor para definir o timeout de leitura. Ao se cadastrar na APIYI, em apiyi.com, você recebe créditos gratuitos para testes — uma boa forma de ajustar timeouts, gateway e parâmetros de novas tentativas antes de entrar em produção.
5 causas comuns de interrupção na conexão com a API de imagens
Causa 1: tempo limite do cliente muito curto
Essa é a causa mais comum e também a mais fácil de corrigir. Muitos clientes HTTP e frameworks de aplicações usam tempos limite padrão de apenas 30 ou 60 segundos. Isso costuma ser suficiente para chamadas a APIs de conversa, mas a geração de imagens em alta resolução, com comandos complexos ou durante horários de pico, pode facilmente levar mais tempo.
É fácil identificar o problema: se todas as falhas acontecem praticamente no mesmo segundo, quase certamente o tempo limite de alguma camada está sendo atingido. Nesse caso, diferencie o tempo limite de conexão do tempo limite de leitura. Mantenha o tempo limite de conexão curto para detectar problemas de rede rapidamente; já o tempo limite de leitura deve cobrir o pior cenário, considerando o tempo de geração e o de envio da resposta.
Motivo 2: tempo limite de inatividade do proxy ou gateway
Mesmo que o tempo limite do cliente esteja configurado corretamente, o Nginx, o balanceador de carga na nuvem e o gateway de API no caminho da solicitação também têm seus próprios limites. O proxy_read_timeout do Nginx é de 60 segundos por padrão, e o tempo limite de inatividade de muitos balanceadores de carga na nuvem fica nessa mesma faixa. Se o período sem resposta durante a geração de imagens ultrapassar esse limite, o gateway encerrará a conexão. O cliente verá um erro 502 ou 504, ou uma conexão redefinida.
Se o seu serviço usa uma estrutura de encaminhamento como “frontend → seu backend → API de imagens”, verifique tanto o gateway de entrada do seu backend quanto o proxy de saída:
location /api/image/ {
    proxy_pass http://backend;
    proxy_connect_timeout 10s;
    proxy_send_timeout    120s;
    proxy_read_timeout    300s;   # 覆盖图片生成的静默期
    client_max_body_size  20m;    # 图生图、图片编辑需要上传参考图
    proxy_buffering       on;
}
| Camada | Parâmetro principal | Valores padrão comuns | Recomendação |
|---|---|---|---|
| SDK / cliente HTTP | read timeout | Varia bastante entre frameworks | Cubra o pior tempo de geração e deixe uma margem |
| Nginx próprio | proxy_read_timeout | 60 segundos por padrão | Alinhe com o tempo limite de leitura do cliente |
| Balanceador de carga na nuvem | idle timeout | Geralmente inferior a alguns minutos | Aumente explicitamente o valor no painel de controle |
| Navegador / frontend | O fetch não tem tempo limite integrado, mas está sujeito às limitações dos serviços anteriores |
Depende do gateway | Passe a consultar periodicamente o status da tarefa no backend |
| Plataforma serverless | Tempo máximo de execução | Varia conforme a plataforma | Escolha um plano compatível com execuções longas ou altere a arquitetura |
Uma regra prática: quanto mais externa for a camada, maior ou igual deve ser o tempo limite em relação às camadas internas. Se o tempo limite do gateway for menor que o do cliente, configurar o tempo limite do cliente não adianta.
Motivo 3: qualidade da conexão internacional e retorno de respostas grandes
Uma característica das conexões internacionais é que a “latência média pode ser aceitável, mas a instabilidade e a perda de pacotes são imprevisíveis”. Se uma pequena solicitação à interface de conversa sofre com instabilidade, alguns pacotes são retransmitidos e o problema passa. Já quando a interface de imagens retorna resultados de vários MB, a transmissão leva mais tempo e fica mais sujeita a essas oscilações.
Há três formas de otimizar essa etapa:
- Escolha o endereço de acesso adequado: se a implantação for no exterior, use o endereço padrão para se comunicar com o servidor da costa oeste dos EUA. Se for no Brasil, também use o endereço padrão: a rota acelerada da plataforma até a China cuida da parte internacional. Evite adicionar um proxy próprio cuja estabilidade seja incerta.
- Controle o tamanho da resposta: escolha dimensões e quantidades adequadas às necessidades da aplicação. Gerar várias imagens em uma única solicitação aumenta proporcionalmente o volume de dados transferidos.
- Salve assim que receber: grave o resultado imediatamente no armazenamento local ou em um armazenamento de objetos. Não espere concluir uma sequência de pós-processamentos em memória para só então salvá-lo.
💡 Sugestão para testar a conexão: se você quiser comparar o desempenho de geração de imagens da mesma aplicação em servidores no exterior e no Brasil, implante o script de teste acima nos dois locais e faça os testes usando a APIYI apiyi.com. Compare o tempo de resposta e a taxa de sucesso. Como só o local da implantação muda, e o código permanece igual, fica mais fácil chegar a uma conclusão confiável.
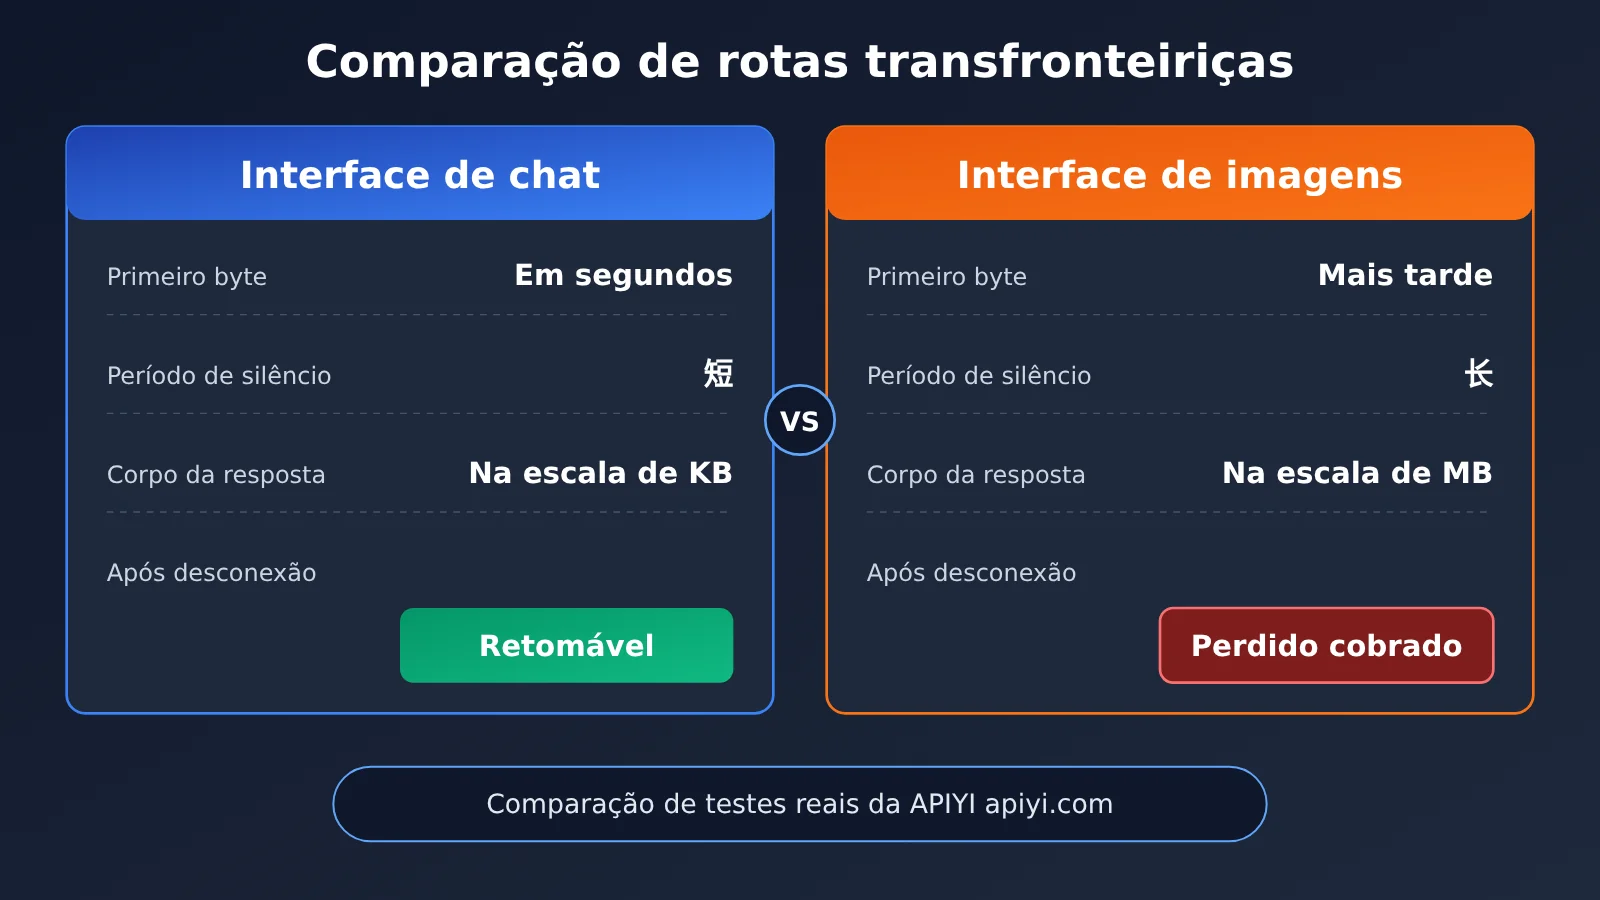
Motivo 4: estratégia de novas tentativas inadequada
Tentar novamente não é o problema. O problema é “tratar todos os erros da mesma forma e repetir a solicitação”. Quando a conexão com a API de imagens cai durante a leitura, é provável que o servidor já tenha iniciado ou até concluído a geração. Nesse caso, tentar novamente imediatamente equivale a fazer um novo pedido. Pior ainda: nos horários de pico, muitas tentativas rápidas de vários clientes ao mesmo tempo podem aumentar a fila e causar mais timeouts, criando um ciclo vicioso.
| Cenário de falha | A solicitação chegou ao servidor? | É recomendável tentar novamente? | Como proceder |
|---|---|---|---|
| Falha na resolução de DNS ou timeout ao estabelecer conexão | Provavelmente não | Sim | Use backoff exponencial e limite o número de tentativas |
| Falha no handshake TLS | Provavelmente não | Sim | Primeiro, verifique o proxy local e os certificados |
| Timeout de leitura | Provavelmente sim | Com cautela | Aumente o timeout e depois confirme manualmente |
| Conexão redefinida durante o envio da resposta | Sim, e o processamento pode ter sido concluído | Não tente novamente automaticamente | Registre o erro e investigue a conexão |
| Limitação de taxa 429 | A solicitação chegou, mas foi recusada | Sim | Aumente o intervalo de backoff e controle a concorrência |
| Erro 5xx no servidor | Sim | Depende do caso | Faça poucas tentativas com backoff e emita um alerta |
A ideia principal está naquela verificação do código completo: tente novamente automaticamente apenas quando for provável que a solicitação não tenha chegado ao servidor. Nos demais casos, deixe a decisão para a camada de negócio. Quando o usuário solicita a geração de uma imagem, em vez de tentar novamente em silêncio no backend, é melhor informar claramente: “Falha na geração. Você pode enviar a solicitação novamente.”
Causa 5: limitações do próprio ambiente de execução
Algumas interrupções de conexão não têm relação com a rede: o ambiente de execução simplesmente não consegue esperar. Há três casos comuns: funções serverless têm um tempo máximo de execução e são encerradas pela plataforma quando esse limite é atingido; chamadas diretas à API de imagens pelo navegador são interrompidas quando o usuário troca de página ou muda de rede móvel; e algumas plataformas de contêineres encerram instâncias que ficam ociosas.
Para evitar esse tipo de problema, recomendamos executar a geração de imagens em um processo de back-end persistente ou em uma fila de tarefas. O front-end envia a tarefa e recebe um ID; depois, obtém o resultado por meio de consultas periódicas ou notificações push. Assim, o processo de geração não depende da conexão do usuário, e o resultado não se perde mesmo que ele atualize a página. Como os arquivos de vídeo são maiores, é ainda mais importante usar essa abordagem desacoplada para retornar os resultados.
Checklist prático para investigar interrupções de conexão na API de imagens
Quando ocorrer uma interrupção de conexão em produção, siga estas etapas para identificar a camada envolvida — geralmente em menos de meia hora:
- Analise a distribuição do tempo de resposta: meça a duração das solicitações com falha. Se elas se concentrarem em um valor fixo, provavelmente há um problema na configuração do tempo limite; se variarem de forma aleatória, é mais provável que o problema esteja no caminho da conexão.
- Verifique o tipo de erro: diferencie falha ao estabelecer a conexão, tempo limite de leitura, conexão redefinida e código de status HTTP. Cada caso aponta para uma camada diferente.
- Teste uma conexão direta, sem passar pelas camadas intermediárias: no mesmo servidor, use um script para chamar a API diretamente. Se funcionar, o problema está no seu próprio gateway ou proxy.
- Repita o teste em outro horário: se a taxa de falhas aumentar significativamente nos horários de pico, verifique primeiro a concorrência e a estratégia de novas tentativas.
- Confira as cobranças e os logs: para solicitações cuja conexão foi interrompida durante a leitura, verifique se houve cobrança. Isso ajuda a avaliar as perdas e otimizar a estratégia.
🎯 Recomendação técnica: durante a investigação, registre nos logs o horário de início e de término de cada solicitação, o tipo de erro e o identificador da solicitação. Se o histórico de chamadas no console da APIYI apiyi.com mostrar que a solicitação foi concluída com sucesso, mas o seu programa retornar um erro, é bem provável que o problema esteja na conexão ou no tempo limite durante o retorno dos dados.
Perguntas frequentes (FAQ)
P1: O que é uma interrupção de conexão com a API de imagens?
É quando a conexão entre o cliente e o servidor é encerrada antes de uma solicitação de geração de imagens ser concluída. Os erros mais comuns são tempo limite de leitura, conexão redefinida, 502 e 504. Como a API de imagens é chamada de forma síncrona, depois que a conexão cai, não é possível enviar o resultado gerado ao cliente.
P2: Preciso configurar um `base_url` diferente para chamadas de servidores no exterior e na China?
Não. O servidor está hospedado no oeste dos Estados Unidos. Para operações no exterior, basta usar o endereço de acesso padrão. Já o acesso da China é acelerado pela rota de retorno oferecida pela plataforma. As duas configurações usam o mesmo `base_url`; a diferença está apenas nos parâmetros de tempo limite e na configuração do gateway intermediário.
P3: Se a conexão cair, ainda haverá cobrança pela solicitação?
É possível. Se a conexão cair durante o envio do resultado, depois que o modelo já tiver concluído a geração, o processamento em si já terá sido concluído e normalmente será cobrado, embora o resultado não chegue ao destino. Por isso, é importante configurar os tempos limite com cuidado e definir a política de novas tentativas com cautela.
P4: Qual é um tempo limite de leitura adequado?
Não existe um valor padrão que sirva para todos os casos. Recomendamos fazer testes no ambiente real de implantação: envie uma série de solicitações com os tamanhos de imagem desejados e comandos típicos, observe as de maior duração e acrescente uma margem confortável. Verifique também se os tempos limite do gateway e do balanceador de carga são iguais ou maiores que esse valor.
P5: Como posso verificar rapidamente se minhas configurações de tempo limite e novas tentativas são adequadas?
Siga estas etapas:
1. Cadastre-se na APIYI, em apiyi.com, e obtenha uma chave API e uma cota gratuita para testes.
2. Mantenha o `base_url` do código completo deste artigo como `https://api.apiyi.com/v1` e implante-o em um servidor de produção na mesma região.
3. Execute várias solicitações consecutivas, registre a distribuição dos tempos de resposta e os tipos de falha e, com base nos resultados, ajuste os parâmetros.
P6: O mesmo problema também pode ocorrer com APIs de geração de vídeo?
Sim. Além disso, os arquivos de vídeo são maiores e mais sensíveis à instabilidade no envio de dados entre países. A abordagem é semelhante: aumentar o tempo limite de leitura, salvar o resultado em disco assim que ele chegar, desacoplar o processo de geração da conexão com o usuário e evitar novas tentativas indiscriminadas quando houver falha no envio do resultado.
P7: Essas medidas eliminam completamente as interrupções de conexão?
Não. Não é possível evitar por completo as oscilações ocasionais da rede internacional. As medidas deste artigo ajudam a reduzir a taxa de falhas a um nível aceitável e a garantir que cada falha possa ser localizada e rastreada. Para operações críticas, recomendamos também configurar alertas e um processo de revisão manual.
Principais pontos para diagnosticar interrupções de conexão na API de imagens
- A chamada síncrona é a causa principal: durante a geração de imagens pela API, não há transferência de dados, o que facilita o acionamento de timeouts de inatividade em diferentes camadas.
- Se a conexão cair, o resultado pode ser perdido: a geração pode já ter sido concluída e cobrada quando a conexão cair durante o envio da resposta. Por isso, a estabilidade afeta diretamente os custos.
- Alinhe os timeouts por camada: o timeout de conexão deve ser curto, e o de leitura, longo. O timeout do gateway externo não deve ser menor que o da camada interna.
- Considere a etapa antes de tentar novamente: faça novas tentativas automáticas apenas para erros de conexão em que a solicitação não chegou ao destino, usando também o recuo exponencial.
- Padronize o endereço de acesso: tanto em implantações internacionais quanto no mercado interno, use o mesmo
base_url. Para padronizar o acesso, basta usar APIYI, em apiyi.com. - Desacople tarefas longas: em cenários com Serverless ou conexão direta pelo navegador, use tarefas no backend com consulta periódica do status.
Resumo
Principais pontos para diagnosticar interrupções de conexão na API de imagens:
- Identifique primeiro a camada: verifique uma a uma as cinco camadas — cliente, gateway, rede, novas tentativas e ambiente de execução — observando a distribuição do tempo e os tipos de erro.
- Ajuste os parâmetros em seguida: configure os timeouts por camada, desative as novas tentativas automáticas indiscriminadas do SDK e alinhe o timeout do gateway ao do cliente.
- Por fim, ajuste a arquitetura: grave em disco os corpos de resposta grandes assim que forem recebidos e desacople as tarefas demoradas da conexão com o usuário.
A geração de imagens entre regiões não é instável por natureza. A maioria das interrupções de conexão vem de problemas de configuração e arquitetura, que podem ser resolvidos de forma sistemática. Antes de entrar em produção, recomendamos executar os scripts de teste deste artigo no ambiente real. Você pode validar os resultados rapidamente pela APIYI, em apiyi.com: com uma única chave API, dá para comparar o tempo de geração e a estabilidade de vários modelos de imagem.
📚 Referências
- APIYI: guia de início rápido e manual da API: endereço de acesso e instruções para integração em três etapas
- Link:
docs.apiyi.com -
Descrição: inclui a configuração de
base_urlno modo compatível com OpenAI e observações sobre chamadas às interfaces de imagem -
OpenAI Python SDK: biblioteca cliente oficial
- Link:
github.com/openai/openai-python -
Descrição: consulte a documentação completa dos parâmetros
timeout,max_retriese outros -
Documentação dos módulos de proxy do Nginx: explicação de parâmetros como
proxy_read_timeout - Link:
nginx.org/en/docs/http/ngx_http_proxy_module.html - Descrição: referência para ajustar as configurações de timeout em um gateway próprio
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site da APIYI. Para consultar mais materiais de integração, acesse a central de documentação.