Anmerkung des Autors: Wenn ein Modell „dümmer geworden“ ist, muss es nicht ausgetauscht worden sein. Ausgehend von Anthropics aktueller Forschung zu kryptografischen Nachweisen mit FlashProve ordnet dieser Artikel die Faktoren, die das Ergebnis von API-Aufrufen beeinflussen – und zeigt eine sinnvolle Reihenfolge für die Fehlersuche, von der Anwendung bis zum Server.
„Auf der offiziellen Website löst das Modell dieselbe Aufgabe, aber beim API-Aufruf bleibt es stecken.“ Oder: „Diesen Monat ist das Modell deutlich dümmer geworden.“ Solche Beschwerden kennt fast jeder, der ein Großes Sprachmodell über eine API einbindet. Die erste Vermutung lautet oft: Wurde das Modell im Hintergrund ausgetauscht?
Anthropic hat kürzlich den quelloffenen Forschungsprototyp FlashProve veröffentlicht. Er soll mithilfe kryptografischer Beweise prüfen, ob eine Ausgabe tatsächlich von einem bestimmten Satz Modellgewichte stammt. Damit gibt es erstmals einen Ansatz, um mathematisch zu überprüfen, ob ein Modell ausgetauscht wurde.
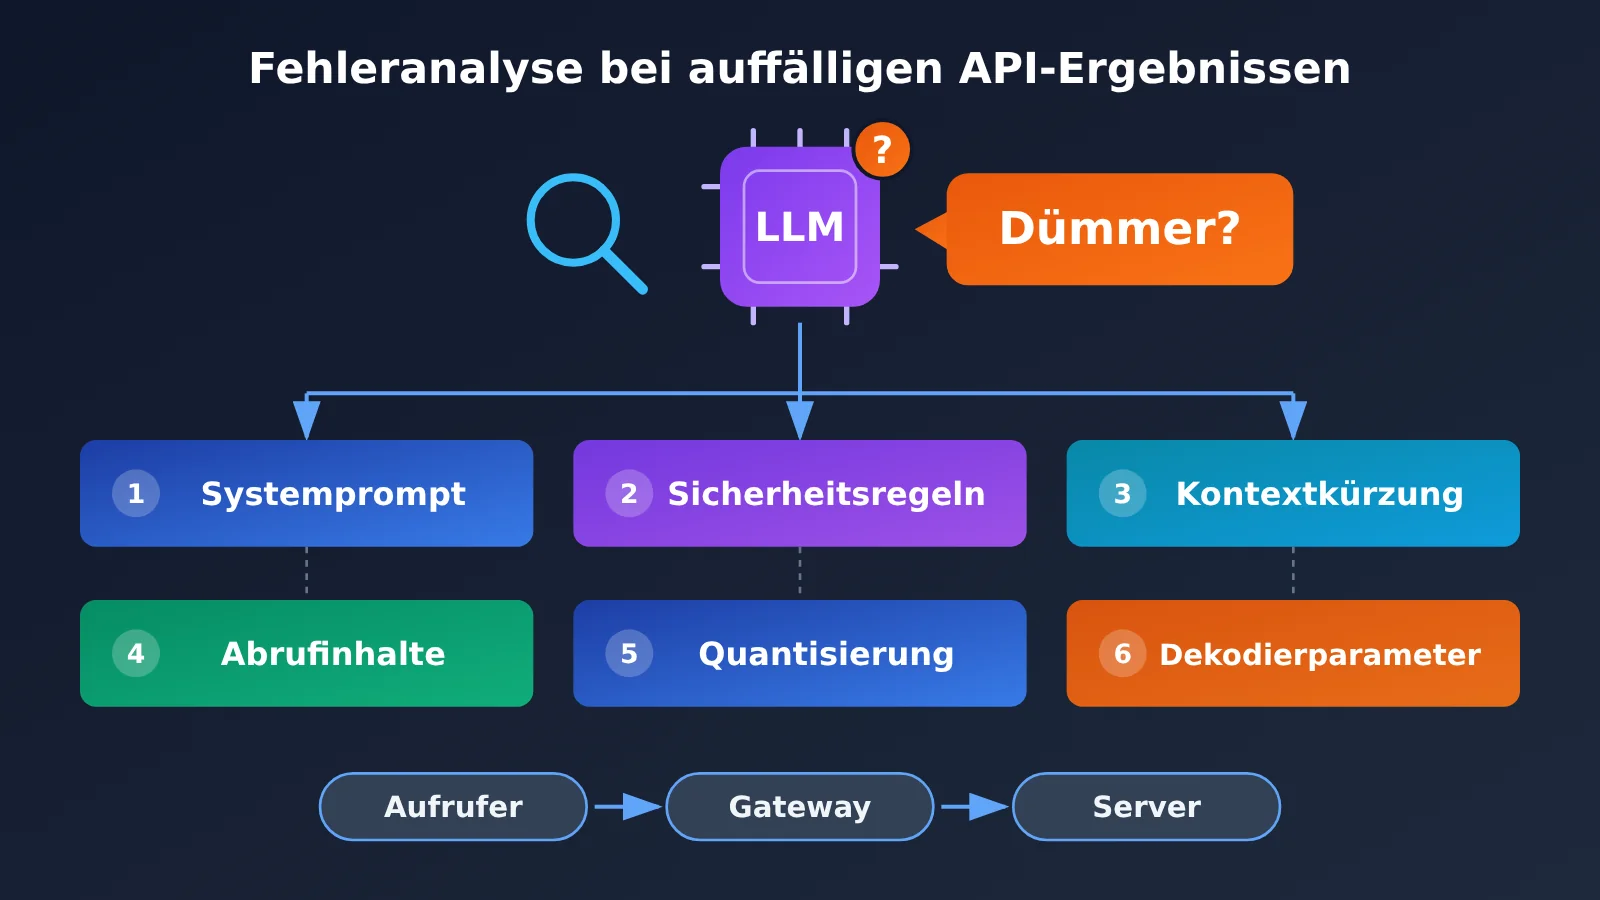
Doch damit ist die Frage nach dem vermeintlichen Leistungsverlust noch nicht geklärt. Der Forschungsbericht weist ausdrücklich darauf hin: Selbst wenn die Identität der Gewichte bestätigt ist, beeinflussen System-Eingabeaufforderung, Sicherheitsrichtlinien, Kontextkürzung, abgerufene Inhalte, Quantisierung und Decodierungsparameter weiterhin das Ergebnis. Auch die Erfahrungen des Kimi-Teams bei der Fehlersuche zeigen, dass ein erheblicher Teil auffälliger Benchmark-Ergebnisse auf falsch verwendete Decodierungsparameter zurückgeht.
Was Sie mitnehmen: Nach der Lektüre haben Sie eine Checkliste für die Fehlersuche, wenn ein Modell scheinbar dümmer geworden ist. Sie wissen, was Sie selbst prüfen können, wann Sie die Unterstützung des Dienstanbieters brauchen und warum es nicht zuverlässig ist, ein Modell anhand einiger Testfragen zu identifizieren.
Fehlersuche bei schlechterer Modellleistung: Das Wichtigste im Überblick
Zunächst zum Hintergrund: Auslöser der Diskussion ist eine Studie von Anthropic über „beweisbare Inferenz“. In der Community wirft sie vor allem eine Frage auf: Wer ist verantwortlich, wenn ein Modell schlechter wird?
| Information | Details |
|---|---|
| Herausgeber | Anthropic-Forschungsteam; Code, technischer Bericht und formaler Lean-Beweis wurden ebenfalls veröffentlicht |
| Kerninhalt | FlashProve erzeugt kryptografische Beweise für die Modellinferenz auf Basis von zkSNARK, einem kompakten Zero-Knowledge-Beweisverfahren |
| Was es löst | Die Herkunft einer Ausgabe aus bestimmten Gewichten lässt sich prüfen, ohne die Gewichte offenzulegen oder das Modell erneut auszuführen |
| Was es nicht löst | Änderungen auf Produktebene, etwa an System-Eingabeaufforderungen, Sicherheitsrichtlinien, Kontext oder Dekodierungsparametern |
| Erkenntnis für Entwickler | Bei auffälliger Modellleistung lohnt sich eine schrittweise Fehlersuche auf allen Ebenen – statt nur zu fragen, ob das Modell ausgetauscht wurde |
Wie FlashProve die Identität eines Modells beweist
FlashProve geht in zwei Schritten vor. Zunächst erzeugt der Anbieter ein sogenanntes Commitment für die Modellgewichte. Es funktioniert wie ein kryptografischer Fingerabdruck, der die Gewichte eindeutig festlegt, ohne sie offenzulegen. Anschließend erstellt der Anbieter für eine gegebene Eingabe und Ausgabe einen Beweis. Mit Commitment, Eingabeaufforderung, Antwort und Beweisdatei können Nutzer auf ihrem eigenen Computer prüfen, ob die Ausgabe tatsächlich mit den festgelegten Gewichten berechnet wurde.
Das Zero-Knowledge-Verfahren stellt sicher, dass Prüfende dabei weder die Gewichte noch Zwischenwerte der Berechnung erhalten. Auch welche Experten ein MoE-Modell in den einzelnen Schichten aufgerufen hat, bleibt verborgen. Das ist deutlich zuverlässiger, als ein Modell nach seiner Identität zu fragen: Der in der Antwort genannte Modellname dient nicht mehr als Identitätsnachweis. Stattdessen wird die rechnerische Beziehung zwischen Ausgabe und Gewichten geprüft.
Anthropic hat das Verfahren mit den öffentlich verfügbaren 4-Bit-Gewichten von Llama 4 Maverick getestet. Dabei handelt es sich um ein Mixture-of-Experts-Modell mit rund 400 Milliarden Parametern, von denen pro Token etwa 17 Milliarden aktiviert werden. Die wichtigsten veröffentlichten Daten:
| Kennzahl | Experimentdaten | Erläuterung |
|---|---|---|
| Durchsatz bei der Beweiserzeugung | Etwa 110 Tokens/Sekunde auf einer einzelnen H100 | Geschwindigkeit der Beweiserzeugung, nicht der Chat-Ausgabe |
| Größe der Beweisdatei | Etwa 19 MB pro Anfrage mit 1.024 Tokens | Muss zusammen mit der Antwort übertragen werden |
| Prüfzeit | Etwa 17 Sekunden auf einer CPU mit 24 Threads | Für die Prüfung ist keine GPU nötig; ein Laptop reicht aus |
| Erzeugung des Gewichts-Commitments | Etwa 39 Minuten | Muss nur einmal erzeugt werden |
| Zusätzliche Kosten | Etwa 70- bis 95-mal so viel GPU-Zeit wie bei gewöhnlicher vLLM-Inferenz | Von einer breiten Anwendung ist das Verfahren noch entfernt |
Warum ein Modell trotz bestätigter Gewichte schlechter werden kann
FlashProve hat eine wichtige Voraussetzung: Nutzer müssen im Voraus wissen, welcher Commitment-Wert zum Originalmodell gehört. Kann der Anbieter nur nachweisen, dass eine Antwort von einem selbst gewählten Modell stammt, können Nutzer aber nicht prüfen, ob es das gekaufte Modell ist, bleibt die Identitätsfrage ungelöst. Idealerweise veröffentlicht der Modellhersteller oder eine vertrauenswürdige Stelle den Commitment-Wert, sodass Nutzer diesen Fingerabdruck bei jeder Prüfung abgleichen können.
Noch wichtiger: Unveränderte Gewichte bedeuten nicht, dass der Dienst unverändert geblieben ist. Ein an die Gewichte gebundener Nachweis beantwortet nicht automatisch, ob die Systemanweisung angepasst wurde, ob der Kontext abgeschnitten wurde oder ob die Decoding-Parameter gleich geblieben sind. Genau deshalb hört man immer wieder Beschwerden, dass ein Modell schlechter geworden sei: Oft kommen mehrere Faktoren zusammen.
6 häufige Gründe, warum ein Modell weniger leistungsfähig wirkt
Wenn man die Einflussfaktoren aus der zugrunde liegenden Untersuchung einzeln betrachtet und danach ordnet, auf welcher Seite das Problem entstehen kann, zeigt sich: Ein großer Teil liegt tatsächlich in der Hand derjenigen, die das Modell aufrufen.
| Einflussfaktor | Typische Anzeichen | Wo kann das Problem entstehen? | Lässt es sich selbst prüfen? |
|---|---|---|---|
| Dekodierungsparameter | Ausgaben schweifen ab oder wiederholen sich, niedrige Benchmark-Ergebnisse im Reasoning-Modus | Vor allem beim Aufrufer, aber auch durch serverseitige Standardwerte | Ja, durch Prüfung der Anfrageparameter |
| Kontextabschneidung | Das Modell „vergisst“ vorherige Inhalte, antwortet unvollständig oder ignoriert Anweisungen | Sowohl beim Aufrufer als auch auf dem Server | Teilweise, durch Prüfung des Token-Verbrauchs |
| System-Eingabeaufforderung | Veränderter Stil, mehr Ablehnungen, falsches Format | Vom Aufrufer oder serverseitig eingefügt | Die eigene ja, die serverseitige nicht |
| Sicherheitsrichtlinien | Bestimmte Fragen werden plötzlich abgelehnt oder vorsichtiger beantwortet | Vor allem auf dem Server | Schwierig, erfordert eine Auskunft des Anbieters |
| Abgerufene Inhalte | Schwankende Antwortqualität in RAG-Szenarien | In der Retrieval-Pipeline des Aufrufers | Ja, durch Prüfung der abgerufenen Inhalte |
| Quantisierungsmethode | Leichter allgemeiner Leistungsabfall, mehr Fehler bei langen Schlussfolgerungen | Bei der serverseitigen Bereitstellung | Nein, erfordert die Mitwirkung des Anbieters |
Falsch verwendete Dekodierungsparameter: eine leicht übersehene Ursache
Das Kimi-Team berichtete bei der Vorstellung von Kimi Vendor Verifier von einer aufschlussreichen Entdeckung: Seit der Veröffentlichung von K2 Thinking hatte es aus der Community zahlreiche Rückmeldungen zu auffälligen Benchmark-Ergebnissen erhalten. Die Untersuchung ergab, dass ein beträchtlicher Teil davon auf falsch verwendete Dekodierungsparameter zurückging. Daraufhin schränkte das Team die entsprechenden Parameter im Thinking-Modus ein und prüfte, ob die Denkinhalte korrekt zurückgegeben wurden.
Für Entwickler ist die Lehre daraus klar: Weichen Parameter wie temperature, top_p, max_tokens oder die Einstellung für den Reasoning-Modus von den offiziellen Empfehlungen ab, kann die Modellleistung deutlich hinter den Erwartungen zurückbleiben. Gerade bei Reasoning-Modellen haben verschiedene Anbieter eigene Anforderungen an Sampling-Parameter, Denkbudget und die Rückgabe von Denkinhalten in mehrstufigen Dialogen. Die konkreten Werte sollten daher aus der offiziellen Dokumentation des jeweiligen Modells stammen – statt einfach die gewohnte Konfiguration für normale Dialogmodelle zu übernehmen.
Unvollständig übertragener Kontext: Wenn das Modell scheinbar „vergisst“
Ein weiteres häufiges Problem ist der Kontext. Wird bei einem mehrstufigen Dialog nur die letzte Nachricht übermittelt, kann sich das Modell natürlich nicht an frühere Inhalte „erinnern“. Überschreiten die bisherigen Nachrichten in einem Workflow das Kontextfenster des Modells, werden oft die frühesten Systemanweisungen abgeschnitten. Das Ergebnis: Das Modell hält sich plötzlich nicht mehr an das gewünschte Ausgabeformat. Ist max_tokens zu niedrig eingestellt, wird außerdem die Antwort mittendrin abgeschnitten – das Modell scheint einfach nach der Hälfte aufzuhören.
All das kann den Eindruck erwecken, das Modell sei weniger leistungsfähig geworden. Ein Blick auf den Anfrage-Body und den Beendigungsgrund in der Antwort reicht aber meistens, um die Ursache direkt zu finden.
Wenn das Modell schlechter wird: Fehlersuche in 3 Schritten
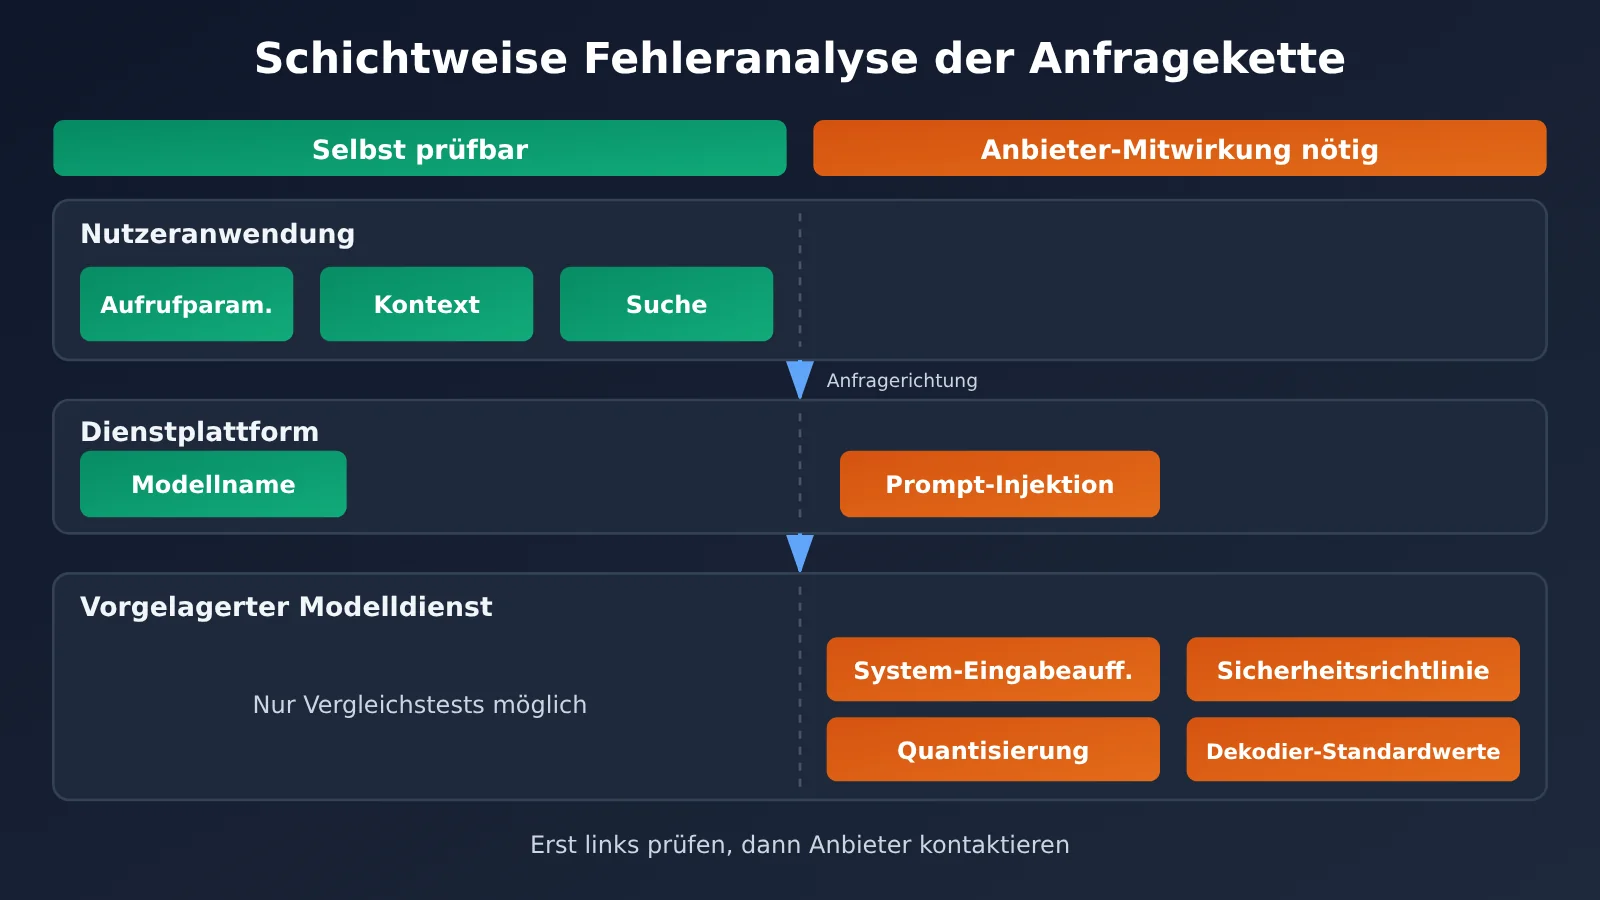
Da die Ursachen an verschiedenen Stellen der Aufrufkette liegen können, beginnt die Fehlersuche am besten dort, wo sie am wenigsten Aufwand verursacht und Sie die meiste Kontrolle haben. Gehen Sie in dieser Reihenfolge vor:
- Zuerst die aufrufende Anwendung prüfen: Kontrollieren Sie den Modellnamen, die Dekodierungsparameter, max_tokens, die System-Eingabeaufforderung, die vollständige Nachrichtenliste und die von RAG abgerufenen Inhalte.
- Dann Vergleichstests durchführen: Halten Sie Parameter und Eingabeaufforderung konstant und vergleichen Sie die Ergebnisse mit einem offiziellen Zugang oder dem in der offiziellen Dokumentation beschriebenen Verhalten. Führen Sie den Test mehrfach aus und betrachten Sie die Verteilung statt eines einzelnen Ergebnisses.
- Zuletzt die Serverseite prüfen: Wenn die Konfiguration der aufrufenden Anwendung korrekt ist und sich die Unterschiede im Vergleichstest zuverlässig reproduzieren lassen, kontaktieren Sie den Dienstanbieter mit den Anfrageprotokollen und Testergebnissen.
Minimales Beispiel: Ein reproduzierbarer Aufruf mit festen Parametern
Am besten schreiben Sie zunächst alle Parameter explizit aus, statt sich auf Standardwerte zu verlassen. Geben Sie ausserdem den Beendigungsgrund und den Tokenverbrauch aus:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Durch den Namen des zu prüfenden Modells ersetzen
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
Ist finish_reason gleich length, wurde die Antwort durch max_tokens abgeschnitten. Die unvollständige Antwort liegt dann nicht daran, dass das Modell schlechter geworden ist, sondern an der Parametereinstellung. Anhand der Zahl der Eingabe-Token in usage können Sie prüfen, ob der Kontext tatsächlich vollständig übertragen wurde.
Vollständiges Vergleichsskript anzeigen
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Zum Modellwechsel muss nur der Parameter model geändert werden
)

# Alle Parameter explizit angeben, statt sich auf Standardwerte zu verlassen
PARAMS = {
    "temperature": 0.2,   # Für Reasoning-Modelle den in der offiziellen Dokumentation empfohlenen Wert verwenden
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """Denselben Testfall mehrfach ausführen und Trefferquote, Kürzungen und Tokenverbrauch erfassen"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # Durch das zu prüfende Modell ersetzen
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
Entscheidend an diesem Skript sind nicht die Testfragen selbst, sondern drei Punkte: Alle Parameter sind festgelegt und werden im Bericht ausgegeben, jeder Testfall wird zur Ermittlung der Trefferquote mehrfach ausgeführt, und finish_reason sowie prompt_tokens werden erfasst, um Kürzungen und Kontextprobleme auszuschliessen. Erst wenn diese drei Punkte geklärt sind, lohnt sich die Frage, ob sich auf Serverseite etwas geändert hat.
🚀 Tipp zur Fehlersuche: APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle. Zum Modellwechsel müssen Sie nur den Parameter
modeländern und können so mehrere Modelle mit demselben Testskript vergleichen. Die Plattform bietet Aufrufprotokolle und Nutzungsstatistiken, mit denen Sie den Verbrauch und die Tokenzahlen früherer Anfragen prüfen können. Das hilft bei der Einschätzung, ob der Kontext vollständig übertragen wurde. Welche Felder die Protokolle konkret anzeigen, sehen Sie in der Plattformkonsole.
Was Nutzer selbst prüfen können und wo der Dienstanbieter mithelfen muss
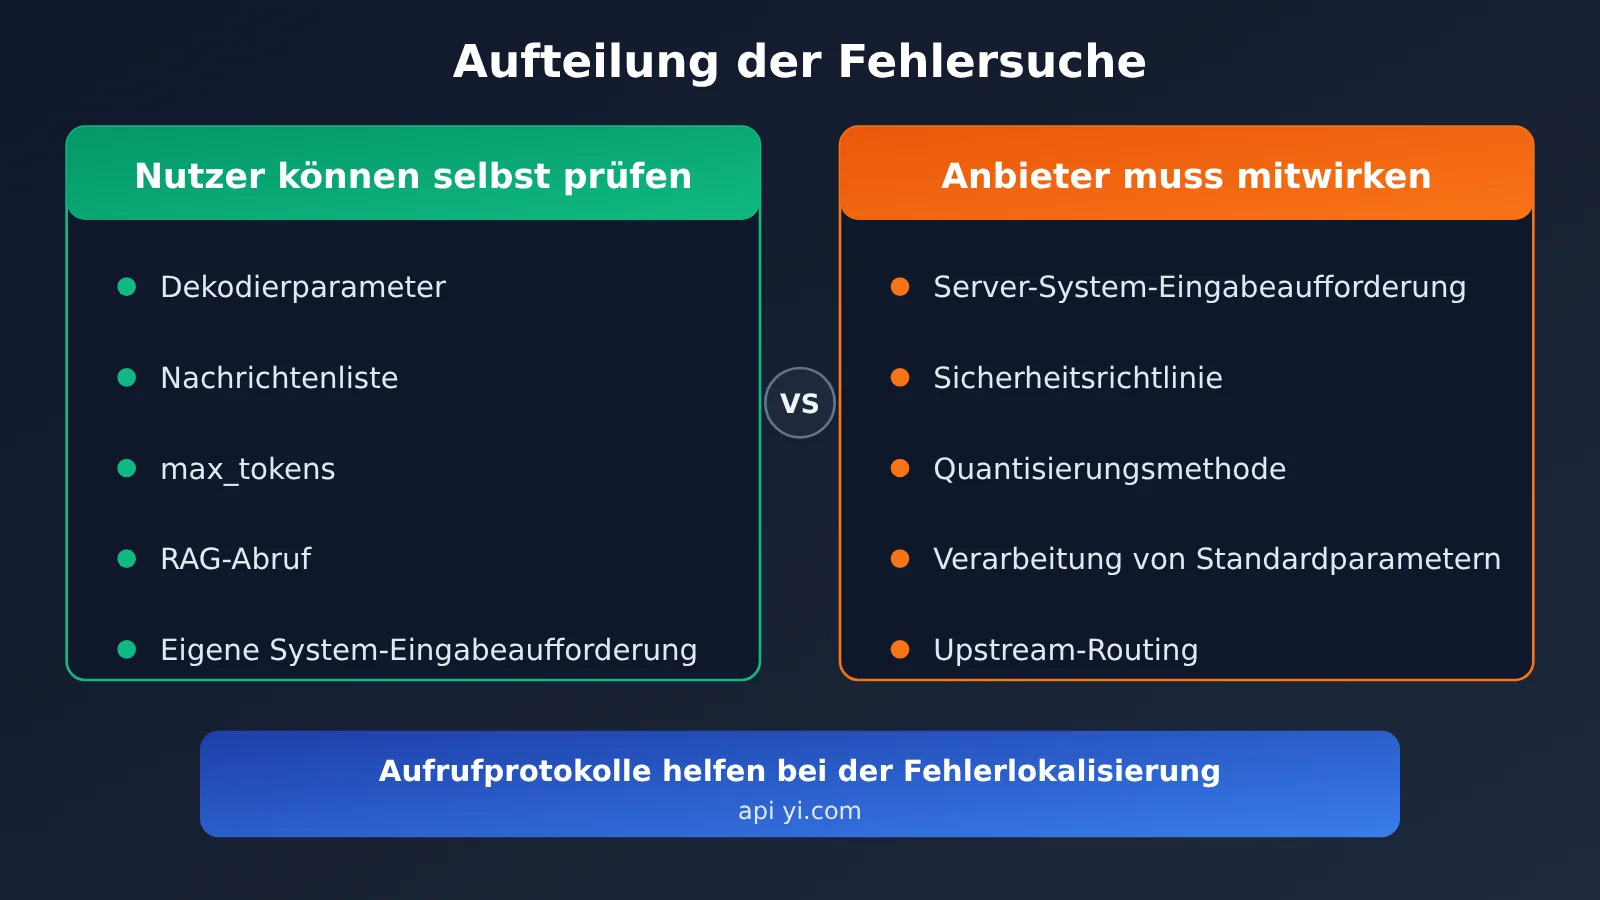
| Prüfpunkt | Selbstprüfung durch den Nutzer | Benötigte Informationen vom Dienstanbieter |
|---|---|---|
| Dekodierungsparameter | Den vollständigen Request-Body ausgeben und mit der offiziellen Dokumentation vergleichen | Ob die Plattform Parameter verändert oder Standardwerte ergänzt |
| Vollständigkeit des Kontexts | Nachrichtenliste und prompt_tokens prüfen | Ob serverseitig eine Kürzung oder eine Begrenzung des Kontextfensters erfolgt |
| Reasoning-Modus | Einstellungen zum Denken und Art der Rückgabe der Denkinhalte prüfen | Ob der Upstream die entsprechenden Parameter unterstützt |
| Quantisierung und Deployment | Nicht selbst prüfbar | Deployment-Präzision und Informationen zum Upstream-Anbieter |
| Sicherheitsrichtlinien | Verhalten derselben Anfrage über den offiziellen Kanal vergleichen | Ob zusätzliche Prüfregeln angewendet werden |
Wenn Sie sich an den Dienstanbieter wenden, halten Sie eine Beispielanfrage mit festen Parametern, statistische Ergebnisse mehrerer Durchläufe und Vergleichsdaten bereit. Das erleichtert die Klärung erheblich. Mit der Aussage „Das Modell ist dümmer geworden“ allein lässt sich das Problem kaum eingrenzen.
Warum ein paar Testfragen nicht zuverlässig zeigen, ob ein Modell schlechter geworden ist
In der Community ist eine Methode verbreitet, um ein Modell zu identifizieren: Man fragt nach einem Sachverhalt, den nur die neue Version kennen dürfte. Kann das Modell nicht antworten, gilt es als „ausgetauscht“. Das Problem: Jede einzelne Antwort enthält ein Zufallselement. Eine zufällig falsche Antwort, andere Parameter, fehlender Kontext oder Unterschiede beim internen Routing des Anbieters können alle zum selben Schluss führen: „Das ist nicht das Modell, das ich wollte.“
Das Forschungsprojekt Model Equality Testing der Stanford University bietet eine fundiertere Perspektive: Die Forschenden untersuchten 31 kommerzielle API-Endpunkte für vier Llama-Modelle aus dem Jahr 2024. Bei 11 Endpunkten fanden sie statistische Unterschiede zwischen der Verteilung der Ausgaben und der Referenzverteilung der von Meta veröffentlichten Gewichte. Entscheidend ist dabei: Verglichen wurden die Verteilungen der Ausgaben, nicht die Antworten auf ein oder zwei Fragen.
Für Entwickler ist vor allem der statistische Ansatz übertragbar: Mit festen Parametern, mehreren Testfällen und wiederholten Durchläufen lassen sich dauerhafte Unterschiede beobachten. Deshalb verwendet auch das Vergleichsskript weiter oben eine „Trefferquote“ statt eines „Einzelergebnisses“.
Welche Folgen hat es, wenn Modelle schlechter werden?
Auswirkungen für Entwickler
- Früher mit der Fehlersuche beginnen: Bei ungewöhnlichen Ergebnissen zuerst den eigenen Request-Body prüfen. Falsch verwendete Parameter und fehlender Kontext lassen sich mit geringem Aufwand prüfen und sind häufige Ursachen.
- Parameter explizit setzen: In der Produktionsumgebung nicht auf Standardwerte verlassen. Insbesondere Reasoning-Modelle sollten anhand der offiziellen Dokumentation konfiguriert und die Parameter versioniert werden.
- Eine Regressionstestsammlung aufbauen: Eine feste Gruppe von Testfällen regelmässig ausführen. So liegen Daten vor, wenn ein Modell schlechter wird – statt nur eines Bauchgefühls.
- Aufrufprotokolle aufbewahren: Anfrageparameter, Token-Verbrauch und der Grund für die Beendigung sind wichtige Nachweise für die Kommunikation mit dem Anbieter.
Auswirkungen auf die Branche
- Vom Bauchgefühl zum Nachweis: FlashProve zeigt einen Weg, die Identität von Gewichten überprüfbar zu machen. Künftig könnten Modellanbieter, Evaluierungsstellen und Aufsichtsbehörden damit prüfen, welches Modell tatsächlich bereitgestellt wird.
- Mehr Transparenz gefordert: Über die Gewichte hinaus dürfte die Frage in den Mittelpunkt rücken, ob auch System-Eingabeaufforderungen, Dekodierungsstrategien und Deployment-Konfigurationen übereinstimmen.
- Breite Nutzung braucht Zeit: Die Erstellung eines Nachweises kostet etwa ein Vielfaches im zweistelligen Bereich gegenüber gewöhnlicher Inferenz. Ausserdem braucht es Unterstützung für längere Kontexte und einen vertrauenswürdigen Mechanismus zur Veröffentlichung von Commitments. Für alltägliche Aufrufe ist das Verfahren daher kurzfristig kaum flächendeckend einsetzbar.
Häufige Fragen (FAQ)
Q1: Was sollte ich zuerst prüfen, wenn ein Modell schlechtere Ergebnisse liefert?
Prüfen Sie zuerst Ihre Anfrage: Ist der Modellname korrekt? Entsprechen Dekodierungsparameter wie temperature den offiziellen Empfehlungen? Ist max_tokens zu niedrig angesetzt? Wird bei mehrstufigen Gesprächen der vollständige Nachrichtenverlauf übergeben? Die Erfahrung des Kimi-Teams zeigt, dass ein erheblicher Teil auffälliger Benchmark-Ergebnisse auf falsch verwendete Dekodierungsparameter zurückgeht. Diese Prüfung bringt daher oft am schnellsten Klarheit.
Q2: Kann FlashProve die Diskussion über nachlassende Modellleistung endgültig klären?
Nein. Es kann überprüfen, ob eine Ausgabe von bestimmten Gewichten stammt. Dafür muss allerdings eine vertrauenswürdige Modellzusage als Vergleichsgrundlage vorliegen. Faktoren wie System-Eingabeaufforderungen, Sicherheitsrichtlinien, Kontextkürzung, Quantisierung und Dekodierungsparameter werden von einem Gewichtsnachweis nicht automatisch abgedeckt.
Q3: Wie führe ich einen zuverlässigen Vergleichstest durch?
Halten Sie alle Parameter und Eingabeaufforderungen konstant und bereiten Sie mehrere Testfälle mit eindeutigen Antworten vor. Führen Sie jeden Testfall mehrfach aus, ermitteln Sie die Trefferquote und protokollieren Sie finish_reason sowie den Token-Verbrauch. Über APIYI apiyi.com können Sie mehrere Modelle mit demselben OpenAI-kompatiblen Code vergleichen. Neue Nutzer erhalten ein kostenloses Testguthaben, das sie für solche Prüfungen verwenden können.
Q4: Warum liefert ein Reasoning-Modell über die API möglicherweise schlechtere Ergebnisse als in der Webversion?
Häufige Ursachen sind ein nicht aktivierter Denkmodus oder ein anders eingestelltes Denkbudget, Sampling-Parameter, die von den offiziellen Empfehlungen abweichen, eine falsche Rückübermittlung der Denkinhalte bei mehrstufigen Gesprächen sowie System-Eingabeaufforderungen und Tools, die in der Webversion vorhanden sind, aber nicht in der API. Vergleichen Sie diese Punkte einzeln mit den API-Angaben in der offiziellen Dokumentation des Modells.
Q5: Wie spreche ich den Anbieter an, wenn meine eigene Prüfung keinen Fehler ergeben hat?
Stellen Sie Anfragebeispiele mit fest eingestellten Parametern, statistische Ergebnisse mehrerer Durchläufe, Vergleichsdaten aus offiziellen Quellen und den Zeitraum zusammen, in dem die Auffälligkeiten aufgetreten sind. In der Konsole von APIYI apiyi.com können Sie Aufrufprotokolle und Nutzungsstatistiken einsehen. Wenn Sie die passenden Einträge ebenfalls bereitstellen, lässt sich die Ursache meist deutlich schneller finden.
Die wichtigsten Punkte zur Fehlersuche bei nachlassender Modellleistung
- Ein Leistungsabfall bedeutet nicht zwangsläufig, dass das Modell ausgetauscht wurde: Auch System-Eingabeaufforderungen, Kontext und Dekodierungsparameter beeinflussen die Ergebnisse.
- Falsch gesetzte Parameter sind häufig: Das Kimi-Team bestätigte, dass ein erheblicher Teil der auffälligen Benchmark-Ergebnisse auf falsch verwendete Dekodierungsparameter zurückging.
- Schrittweise vorgehen: Zuerst den Aufruf prüfen, dann Vergleichstests durchführen und zuletzt mögliche serverseitige Probleme untersuchen.
- Einzelne Fragen sind kein verlässlicher Test: Vergleichen Sie die Verteilung der Ausgaben über mehrere Durchläufe hinweg, statt nur ein oder zwei Antworten zu betrachten.
- Der Nachweis der Gewichte hat Grenzen: FlashProve überprüft nur die Identität der Gewichte und erfasst keine Konfigurationsänderungen auf Produktebene.
- Einheitliche Testwerkzeuge verwenden: Die kompatiblen Schnittstellen und Logs von APIYI apiyi.com ermöglichen den direkten Vergleich.
Fazit
Wenn Modelle scheinbar schlechter wurden, stützten sich Diskussionen bisher vor allem auf Screenshots und subjektive Eindrücke. Anthropic zeigt mit FlashProve einen überprüfbaren Weg auf, um festzustellen, ob ein Modell ausgetauscht wurde. Gleichzeitig macht das Verfahren deutlich: Neben den Gewichten beeinflusst eine ganze Konfigurationsebene die Ergebnisse.
- Zuerst selbst prüfen: Dekodierungsparameter, max_tokens, Nachrichtenliste und die von RAG abgerufenen Inhalte sind der einfachste und günstigste Ausgangspunkt.
- Dann vergleichen: Vergleichen Sie die Ergebnisse anhand fester Parameter, mehrerer Testfälle und wiederholter Durchläufe mit den offiziellen Ergebnissen. So ersetzen Sie Eindrücke durch Daten.
- Zuletzt den Anbieter kontaktieren: Wenn der Aufruf nachweislich korrekt ist, helfen Anfrageprotokolle und statistische Ergebnisse dem Anbieter, serverseitige Probleme einzugrenzen.
Nehmen Sie das Vergleichsskript aus diesem Artikel am besten in Ihre regelmäßigen Regressionstests auf. Über APIYI apiyi.com können Sie mit demselben Code schnell die Leistung mehrerer Modelle prüfen. Die Plattform bietet ein kostenloses Testguthaben und eine einheitliche OpenAI-kompatible Schnittstelle.
📚 Quellen
- 36氪 / APPSO – Analyse der Anthropic-Forschung zu Provable Inference: Funktionsweise von FlashProve, Versuchsdaten und Diskussion möglicher Ursachen für nachlassende Modellleistung
- Link:
36kr.com/p/4056019887510401 -
Hinweis: Die wichtigste Quelle für die Fakten und Daten dieses Artikels; enthält auch Erläuterungen zu Kimi Vendor Verifier und Model Equality Testing
-
Anthropic Research – Provable Inference: Offizielle Forschungsseite zu FlashProve
- Link:
anthropic.com/research/provable-inference - Hinweis: Hier finden Sie den technischen Bericht, den Open-Source-Code und die formalen Beweise
Autor: APIYI-Technikteam
Technischer Austausch: Wenn Sie bei der Untersuchung ungewöhnlicher Ergebnisse von Modellaufrufen auf Probleme stoßen, kontaktieren Sie uns über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.