ملاحظة الكاتب: «تراجع ذكاء النموذج» لا يعني بالضرورة أنه استُبدل. انطلاقًا من أحدث أبحاث Anthropic حول إثبات الاستدلال باستخدام FlashProve، يجمع هذا المقال العوامل التي تؤثر في نتائج استدعاءات API ضمن تسلسل للفحص يبدأ من جهة المستخدم وينتهي بالخادم.
«يستطيع حل المسألة نفسها على الموقع الرسمي، لكنه يتعثر عند استدعائه عبر API»، و«أصبح النموذج أقل ذكاءً بوضوح هذا الشهر»؛ شكاوى يكاد كل مطور يستخدم نماذج اللغة الكبيرة عبر API يسمعها. وأول ما يتبادر إلى ذهن كثيرين: هل استُبدل النموذج في الخلفية؟
أصدرت Anthropic مؤخرًا نموذجًا بحثيًا مفتوح المصدر باسم FlashProve، يحاول استخدام إثباتات التشفير للتحقق مما إذا كان «هذا الناتج قد صدر فعلًا عن مجموعة أوزان محددة». ويتيح ذلك لأول مرة مسارًا للتحقق رياضيًا مما إذا كان النموذج قد استُبدل.
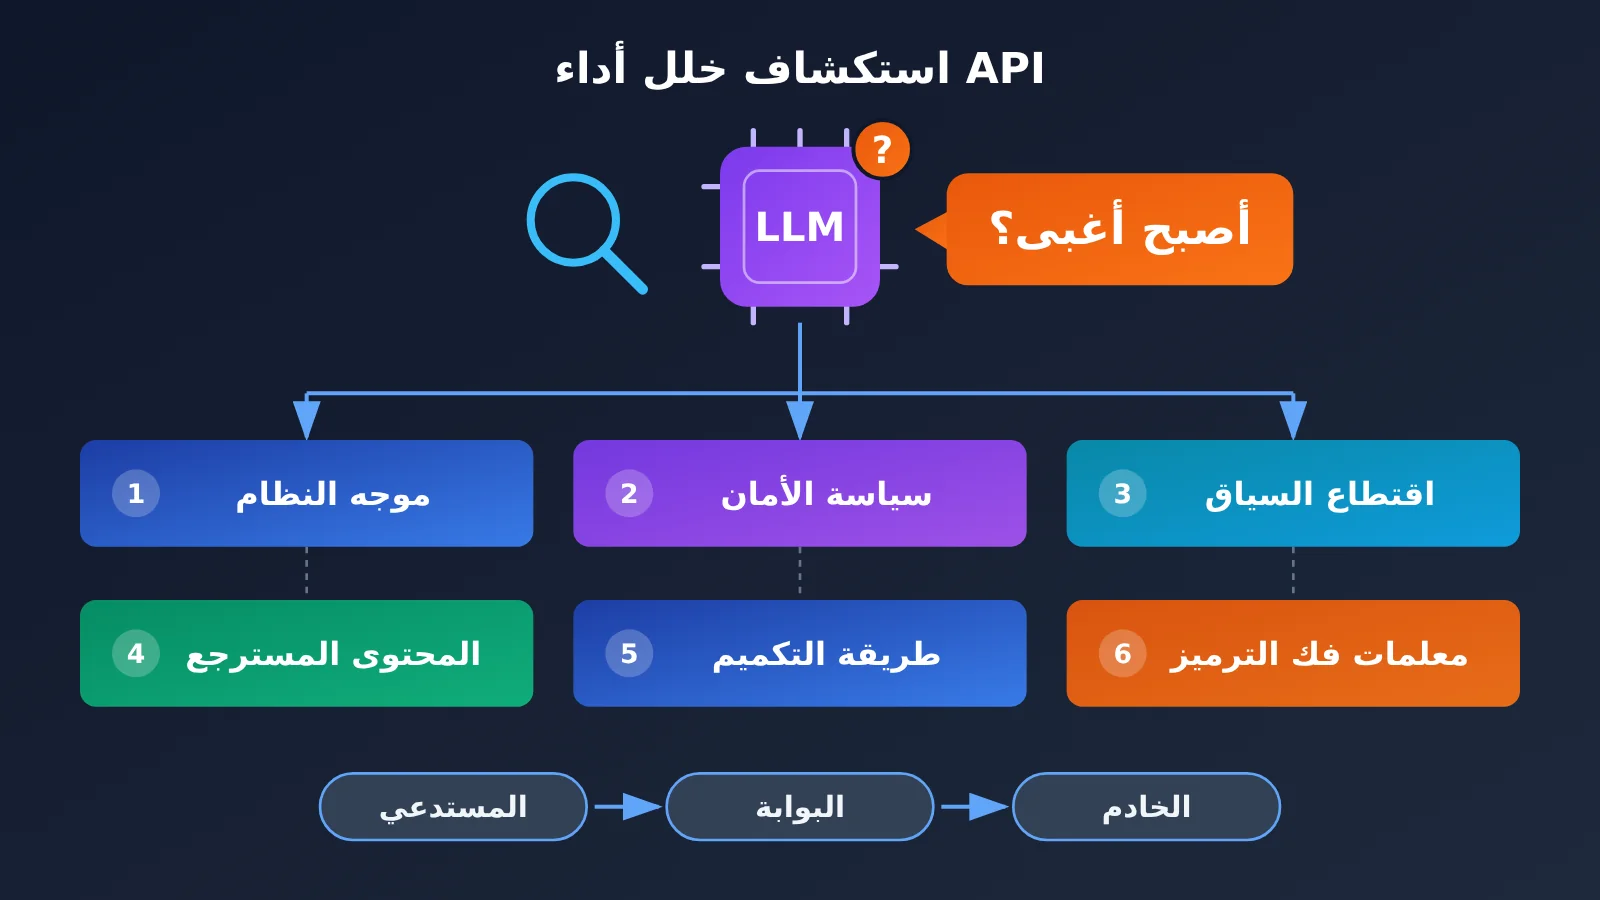
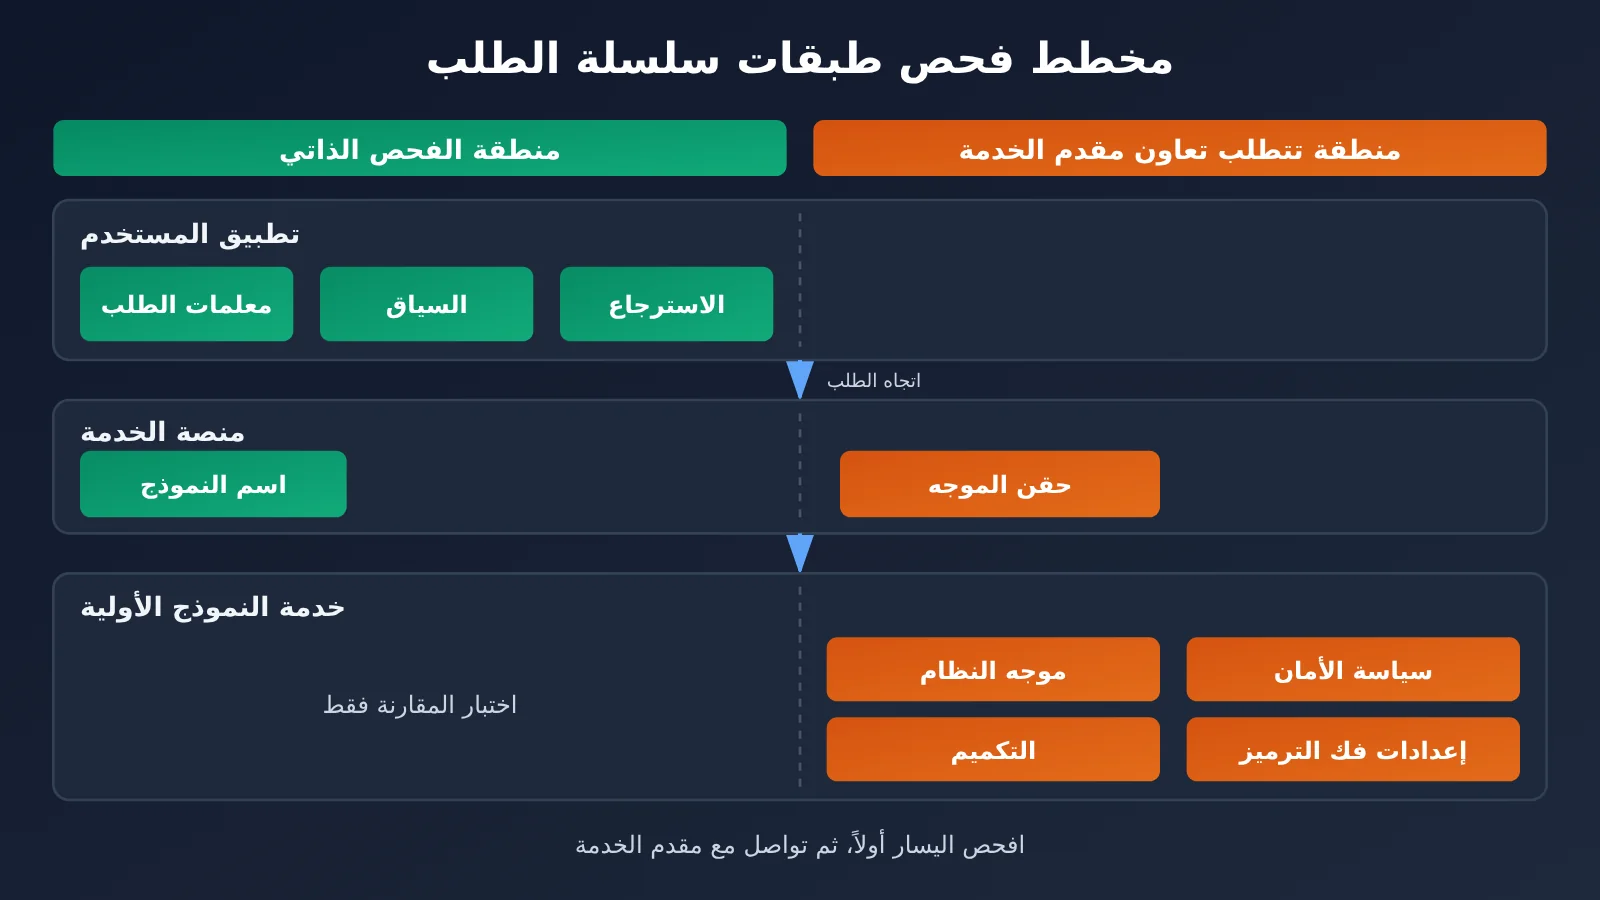
لكن هذا لا يحسم مشكلة «تراجع الذكاء». تشير التغطية البحثية بوضوح إلى أنه حتى بعد التأكد من هوية الأوزان، تظل موجهات النظام وسياسات الأمان واقتطاع السياق والمحتوى المسترجع وطريقة التكميم ومعلمات فك الترميز عوامل تؤثر في النتيجة النهائية. وتُظهر تجربة فريق Kimi في استقصاء المشكلات أيضًا أن جزءًا كبيرًا من النتائج غير الطبيعية في الاختبارات يعود في الواقع إلى الاستخدام الخاطئ لمعلمات فك الترميز.
ما الذي ستستفيده؟ بعد قراءة المقال، ستحصل على قائمة فحص تستخدمها عندما يبدو النموذج أقل ذكاءً، وستعرف ما يمكنك التحقق منه بنفسك، وما يتطلب تعاون مزود الخدمة، ولماذا لا يُعد «طرح بضعة أسئلة للتعرف على النموذج» طريقة موثوقة.
تشخيص تراجع أداء النموذج: أهم المعلومات
لنبدأ بتوضيح خلفية النقاش. فقد انطلق من بحث Anthropic حول «الاستدلال القابل للإثبات»، وأثار سؤالًا أساسيًا في المجتمع: من المسؤول عندما يبدو أن النموذج أصبح أقل ذكاءً؟
| العنصر | التفاصيل |
|---|---|
| الجهة الناشرة | فريق أبحاث Anthropic، الذي نشر أيضًا الشيفرة والتقرير التقني والبرهان الصوري باستخدام Lean |
| الفكرة الأساسية | FlashProve: يُنشئ إثباتًا تشفيريًا لاستدلال النموذج باستخدام براهين المعرفة الصفرية الموجزة zkSNARK |
| المشكلة التي يحلها | التحقق من أن المخرجات صدرت عن الأوزان المحددة، دون كشفها أو مطالبة المستخدم بإعادة تشغيل النموذج |
| ما لا يستطيع حله | التغييرات على مستوى المنتج، مثل موجه النظام وسياسات الأمان والسياق ومعلمات فك الترميز |
| الخلاصة للمطورين | يجب تشخيص الأداء غير المتوقع للنموذج على مستويات متعددة، بدل التركيز فقط على احتمال استبداله |
كيف يثبت FlashProve أن النموذج هو نفسه؟
تقوم فكرة FlashProve على خطوتين. أولًا، يُنشئ مزود الخدمة «التزامًا» بأوزان النموذج، أشبه ببصمة تشفيرية تحدد الأوزان بشكل فريد دون كشفها. بعد ذلك، يُنشئ المزود إثباتًا لمدخل ومخرج محددين. وباستخدام الالتزام والموجه والإجابة وملف الإثبات، يستطيع المستخدم التحقق على جهازه من أن المخرجات حُسبت فعلًا باستخدام الأوزان المحددة.
ويضمن تصميم المعرفة الصفرية ألا يحصل المدقق على الأوزان أو قيم الحسابات الوسيطة، وألا يرى الخبراء الذين استدعاهم نموذج MoE في كل طبقة. وهذه طريقة أكثر موثوقية من «مطالبة النموذج بالتعريف عن نفسه»؛ فاسم النموذج الوارد في الإجابة لم يعد دليلًا على هويته، بل ما يُتحقق منه هو العلاقة الحسابية بين المخرجات والأوزان.
أجرت Anthropic تجربتها باستخدام Llama 4 Maverick، الذي أُتيحت أوزانه بدقة 4-bit. وهو نموذج خليط خبراء يضم نحو 400 مليار معلمة، ويُفعّل نحو 17 مليار معلمة لكل token. وفيما يلي أبرز النتائج المنشورة:
| المؤشر | نتيجة التجربة | التوضيح |
|---|---|---|
| معدل توليد الإثبات | نحو 110 tokens/ثانية على بطاقة H100 واحدة | هذه سرعة توليد الإثبات، وليست سرعة إخراج المحادثة |
| حجم ملف الإثبات | نحو 19 MB لكل طلب من 1,024 token | يجب إرساله مع الاستجابة |
| وقت التحقق | نحو 17 ثانية على وحدة CPU بـ 24 خيط معالجة | لا يتطلب التحقق وحدة GPU، ويمكن إجراؤه على حاسوب محمول |
| إنشاء الالتزام بالأوزان | نحو 39 دقيقة | يكفي إنشاؤه مرة واحدة |
| التكلفة الإضافية | وقت GPU يعادل نحو 70~95 ضعف الاستدلال العادي باستخدام vLLM | لا يزال الاعتماد على نطاق واسع بعيدًا |
لماذا قد يبدو النموذج أقل ذكاءً حتى بعد التحقق من أوزانه؟
يعتمد FlashProve على شرط أساسي: يجب أن يعرف المستخدم مسبقًا الالتزام الخاص بـ«النموذج الأصلي». فإذا كان مزوّد الخدمة لا يستطيع سوى إثبات أن الإجابة صدرت عن نموذج اختاره بنفسه، بينما لا يستطيع المستخدم التأكد من أنه النموذج الذي اشتراه، فلن يحلّ هذا الإثبات مشكلة التحقق من الهوية. والحل المثالي هو أن تنشر الجهة المطوّرة للنموذج أو مؤسسة موثوقة الالتزام علنًا، ليتحقق المستخدم دائمًا من هذه البصمة.
والأهم أن ثبات الأوزان لا يعني ثبات الخدمة. فالإثبات المرتبط بالأوزان لا يجيب تلقائيًا عن أسئلة مثل: هل تغيّر موجه النظام؟ هل اقتُطع جزء من السياق؟ وهل بقيت معاملات فك الترميز متسقة؟ وهذا يفسر استمرار شكاوى أن النموذج أصبح أقل ذكاءً: فالأمر غالبًا نتيجة تداخل عدة عوامل.
6 أسباب شائعة تجعل النموذج يبدو أقل ذكاءً
عند تفصيل العوامل المذكورة في الدراسة المرجعية وتصنيفها بحسب الجهة التي قد تنشأ فيها المشكلة، يتضح أن جزءًا كبيرًا منها يقع ضمن نطاق تحكم الجهة المستدعية.
| العامل المؤثر | الأعراض المعتادة | الجهة التي قد تنشأ فيها المشكلة | هل يستطيع المستخدم التحقق بنفسه؟ |
|---|---|---|---|
| معاملات فك الترميز | مخرجات مشتتة أو متكررة، ونتائج أقل في اختبارات وضع الاستدلال | الجهة المستدعية غالبًا، وقد يحدد الخادم قيمًا افتراضية أيضًا | نعم، بمراجعة معاملات الطلب |
| اقتطاع السياق | «نسيان» ما سبق، أو إجابات غير مكتملة، أو تجاهل التعليمات | الجهة المستدعية أو الخادم | جزئيًا، بمراجعة استهلاك الرموز المميزة (tokens) |
| موجه النظام | تغير الأسلوب، أو زيادة حالات رفض الإجابة، أو عدم الالتزام بالتنسيق | الجهة المستدعية أو الخادم عند إضافة الموجه | يستطيع مراجعة موجهه الخاص، لكن ليس موجه الخادم |
| سياسات السلامة | رفض مفاجئ لفئة معينة من الأسئلة أو إجابات أكثر تحفظًا | الخادم غالبًا | صعب نسبيًا، ويتطلب توضيحًا من مزوّد الخدمة |
| محتوى الاسترجاع | تفاوت جودة الإجابات في سيناريوهات RAG | سلسلة الاسترجاع لدى الجهة المستدعية | نعم، بفحص المحتوى المسترجع |
| طريقة التكميم | تراجع طفيف في القدرات عمومًا، وارتفاع معدل الأخطاء في الاستدلال الطويل | جهة نشر النموذج على الخادم | لا، ويتطلب الأمر تعاون مزوّد الخدمة |
إساءة استخدام معلمات فك الترميز: سبب يسهل إغفاله وراء تراجع أداء النموذج
شارك فريق Kimi ملاحظة لافتة عند تقديم Kimi Vendor Verifier: بعد إطلاق K2 Thinking، تلقّى الفريق العديد من البلاغات من المجتمع عن نتائج غير متوقعة في الاختبارات المعيارية. وبعد التحقيق، تبيّن أن عددًا كبيرًا منها يعود إلى إساءة استخدام معلمات فك الترميز. لذلك فرض الفريق قيودًا على المعلمات ذات الصلة في وضع Thinking، وتحقق من إعادة تمرير محتوى التفكير بشكل صحيح.
والدرس للمطورين واضح: إذا اختلفت إعدادات مثل temperature وtop_p وmax_tokens ومفتاح وضع الاستدلال عن التوصيات الرسمية، فقد ينحرف أداء النموذج بوضوح عن المتوقع. وينطبق ذلك خصوصًا على نماذج الاستدلال، إذ تختلف متطلبات الشركات بشأن معلمات أخذ العينات وميزانية التفكير وطريقة إعادة تمرير محتوى التفكير في المحادثات متعددة الجولات. لذا، ارجع إلى الوثائق الرسمية لكل نموذج لتحديد القيم المناسبة، بدلًا من استخدام الإعدادات المعتادة لنماذج المحادثة العادية.
عدم تمرير السياق كاملًا: حين يبدو النموذج وكأنه «فقد ذاكرته»
السياق مصدر آخر للمشكلات المتكررة. ففي المحادثات متعددة الجولات، إذا مرّرت الرسالة الأخيرة فقط، فمن الطبيعي ألا «يتذكر» النموذج ما سبقها. وفي سير العمل، إذا تجاوزت الرسائل السابقة نافذة سياق النموذج، فغالبًا ما تُحذف تعليمات النظام الأولى، فيتوقف النموذج فجأة عن الالتزام بتنسيق الإخراج المطلوب. كذلك، قد يؤدي ضبط max_tokens على قيمة صغيرة جدًا إلى قطع الإجابة في منتصفها، فيبدو أن النموذج «توقف قبل إكمالها».
قد توحي كل هذه المشكلات بأن النموذج أصبح أقل قدرة، لكن فحص متن الطلب وسبب انتهاء الاستجابة يساعد في معظم الأحيان على تحديد المشكلة فورًا.
كيف تتحقق عندما يبدو النموذج أقل ذكاءً: 3 خطوات بالترتيب
بما أن الأسباب قد تقع في مواضع مختلفة من سلسلة الاستدعاء، فمن الأفضل البدء بالجانب الأقل تكلفة والأسهل تحكمًا. اتبع هذا الترتيب:
- تحقق أولًا من جهة الاستدعاء: راجع اسم model، ومعلمات فك الترميز، وmax_tokens، وموجه النظام، وقائمة الرسائل الكاملة، والمحتوى الذي استرجعه نظام RAG.
- أجرِ اختبارًا مقارنًا: ثبّت المعلمات والموجه، ثم قارن الأداء بالقناة الرسمية أو بما تصفه الوثائق الرسمية. كرر الاختبار لملاحظة توزيع النتائج بدلًا من الاعتماد على نتيجة واحدة.
- قيّم جانب الخدمة أخيرًا: إذا كانت إعدادات جهة الاستدعاء صحيحة، وكان الفرق في المقارنة ثابتًا ويمكن إعادة إنتاجه، فتواصل مع مزود الخدمة وأرفق سجلات الطلبات ونتائج الاختبار.
مثال مبسط: تثبيت المعلمات لإجراء استدعاء قابل للتكرار
الخطوة الأولى الأكثر عملية هي تحديد جميع المعلمات صراحةً، دون الاعتماد على القيم الافتراضية، وطباعة سبب انتهاء الاستجابة واستهلاك الرموز:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # استبدله باسم النموذج الذي تريد تشخيصه
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
إذا كانت قيمة finish_reason هي length، فهذا يعني أن الإجابة قُطعت بسبب max_tokens. عندها لا يكون نقص الإجابة دليلًا على تراجع أداء النموذج، بل على مشكلة في إعداد المعلمات. ويمكن أن يساعدك عدد رموز الإدخال في usage على التأكد من إرسال السياق كاملًا.
عرض سكربت الاختبار المقارن كاملًا
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # لتغيير النموذج، يكفي تعديل المعلمة model
)

# حدد جميع المعلمات صراحةً لتجنب الاعتماد على القيم الافتراضية
PARAMS = {
    "temperature": 0.2,   # لنماذج الاستدلال، استخدم القيمة الموصى بها في الوثائق الرسمية
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """شغّل حالة الاختبار نفسها عدة مرات واحسب معدل النجاح وعدد حالات القطع واستهلاك الرموز"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # استبدله بالنموذج المراد تشخيصه
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
تكمن أهمية هذا السكربت في ثلاث نقاط، لا في أسئلة الاختبار نفسها: تثبيت جميع المعلمات وإظهارها في التقرير، وتشغيل حالة الاختبار نفسها عدة مرات لقياس معدل النجاح، وتسجيل finish_reason وprompt_tokens لاستبعاد مشكلات قطع الإجابة والسياق. بعد استبعاد هذه الاحتمالات الثلاثة، يصبح من المجدي البحث في احتمال حدوث تغيير على جانب الخادم.
🚀 نصيحة لتشخيص المشكلة: تستخدم APIYI على apiyi.com واجهة متوافقة مع OpenAI، لذا يكفي تغيير المعامل model للتبديل بين النماذج ومقارنتها باستخدام نصوص الاختبار نفسها. وتوفر المنصة سجلات الاستدعاء وإحصاءات الاستخدام، لمراجعة استهلاك الطلبات وعدد الرموز المستخدمة، والاستعانة بها لتحديد ما إذا كان السياق قد أُرسل كاملًا. للاطلاع على الحقول المتاحة في السجلات، يُرجى الرجوع إلى صفحة لوحة تحكم المنصة.
توزيع مهام التشخيص بين المستخدم ومزود الخدمة
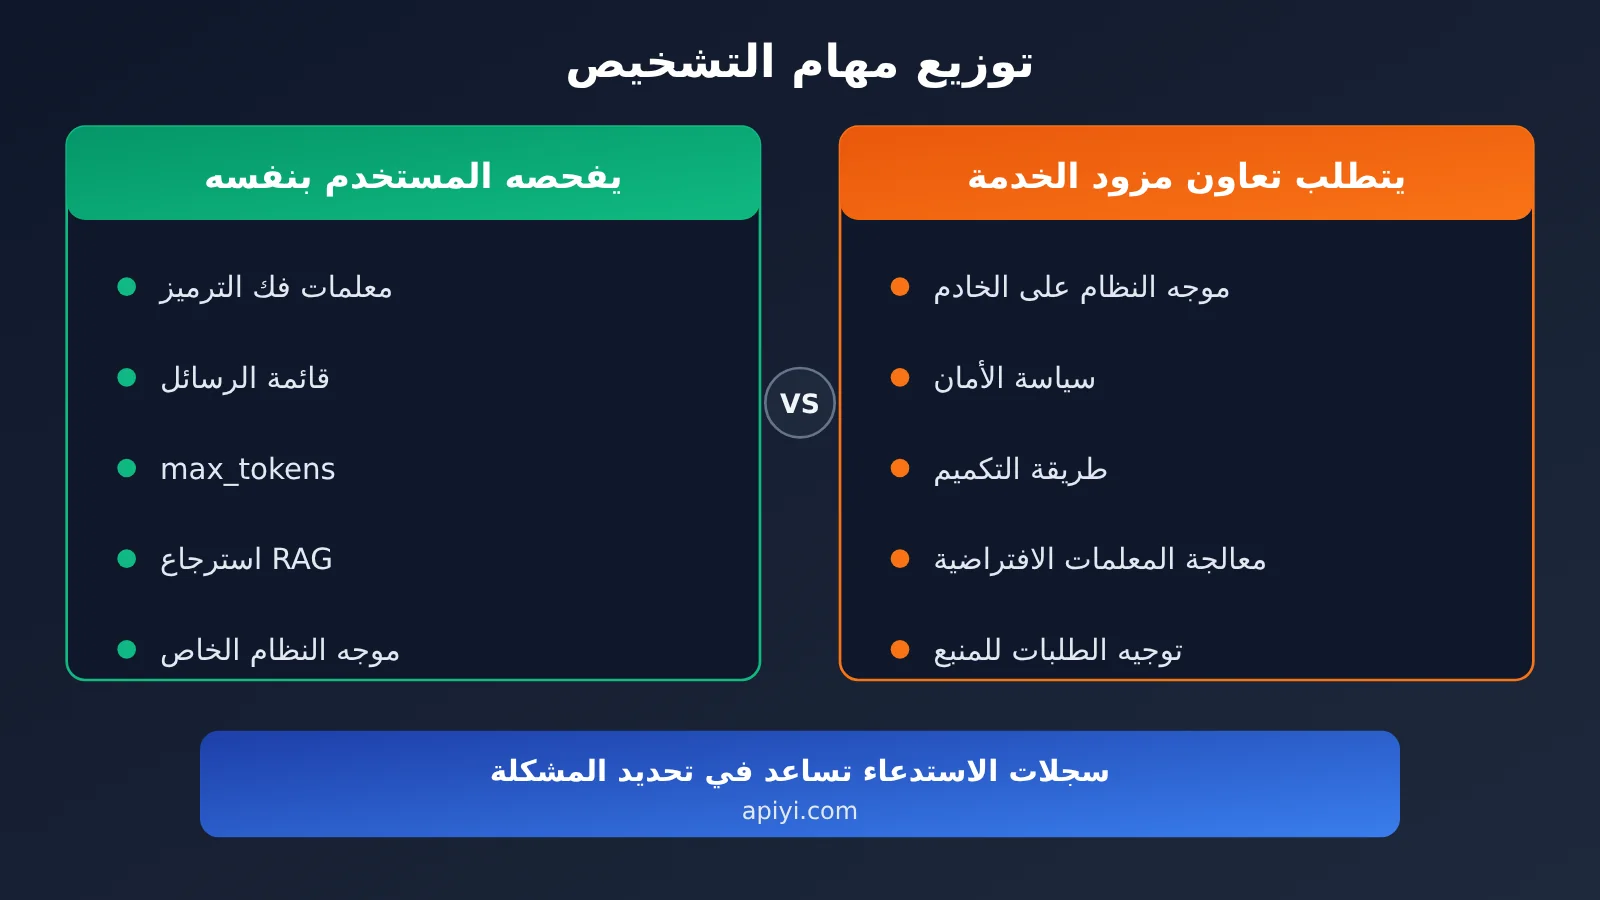
| عنصر التشخيص | طريقة فحص المستخدم | المعلومات المطلوبة من مزود الخدمة |
|---|---|---|
| معاملات فك الترميز | طباعة نص الطلب كاملًا ومقارنته بالوثائق الرسمية | هل تعيد المنصة كتابة المعاملات أو تضيف قيمًا افتراضية؟ |
| اكتمال السياق | فحص قائمة الرسائل وprompt_tokens | هل يوجد اقتطاع على الخادم أو حد لنافذة السياق؟ |
| نمط الاستدلال | التحقق من مفتاح التفكير وطريقة إرجاع محتوى التفكير | هل تدعم الخدمة المصدرية المعاملات المعنية؟ |
| التكميم والنشر | لا يمكن فحصهما ذاتيًا | دقة النشر وتفاصيل القناة المصدرية |
| سياسة الأمان | مقارنة أداء الطلب نفسه عبر القناة الرسمية | هل أُضيفت قواعد مراجعة إضافية؟ |
عند التواصل مع مزود الخدمة، أرفق عينة طلب بمعاملات ثابتة، ونتائج إحصائية لعدة تشغيلات، وبيانات المقارنة؛ فهذا يجعل التواصل أكثر كفاءة. أما الاكتفاء بقول «أصبح النموذج أقل ذكاءً»، فيصعّب على الطرف الآخر تحديد المشكلة.
لماذا لا يمكن الاعتماد على «طرح بضعة أسئلة لتمييز النموذج» للحكم على تراجع أدائه؟
تنتشر في المجتمع طريقة للتحقق من النموذج: يُطرح عليه سؤال عن معلومة لا يعرفها سوى الإصدار الجديد، وإذا عجز عن الإجابة يُستنتج أن النموذج «استُبدل». لكن المشكلة أن الإجابة الواحدة تنطوي على قدر من العشوائية؛ فقد يخطئ النموذج بالمصادفة، أو تختلف المعاملات، أو يغيب جزء من السياق، أو تختلف آلية التوجيه الداخلية لدى المزوّد. وكل هذه الاحتمالات قد تؤدي إلى الاستنتاج نفسه: «هذا ليس النموذج الذي طلبته».
يقدم مشروع Model Equality Testing البحثي في جامعة ستانفورد منظورًا أكثر دقة. فقد اختبر الباحثون 31 نقطة وصول تجارية عبر API لأربعة نماذج Llama في عام 2024، ووجدوا أن توزيع المخرجات في 11 منها يختلف إحصائيًا عن التوزيع المرجعي المستند إلى أوزان النموذج التي نشرتها Meta. لاحظ أن المنهج هنا يقارن «توزيع» المخرجات، بدلًا من الحكم على صحة إجابة سؤال أو سؤالين.
ما يمكن للمطورين الاستفادة منه هو النهج الإحصائي: استخدام معاملات ثابتة، وحالات اختبار متعددة، وتشغيل الاختبارات عدة مرات لرصد الفروق المستقرة. ولهذا يعتمد نص المقارنة البرمجي أعلاه على «معدل النجاح» بدلًا من «نتيجة واحدة».
تحليل آثار ظاهرة تراجع أداء النموذج
التأثير على المطورين
- ابدأ التشخيص مبكرًا: عند ملاحظة أداء غير معتاد، افحص متن الطلب أولًا. فالأخطاء في استخدام المعلمات ونقص السياق من أقل الأسباب تكلفةً في الفحص وأكثرها احتمالًا.
- اضبط المعلمات صراحةً: لا تعتمد على القيم الافتراضية في بيئة الإنتاج. اضبط نماذج الاستدلال وفق الوثائق الرسمية، وأدر المعلمات ضمن نظام التحكم في الإصدارات.
- أنشئ مجموعة اختبارات انحدار: احتفظ بمجموعة ثابتة من حالات الاختبار وشغّلها دوريًا، حتى تستند إلى بيانات عند تراجع أداء النموذج بدلًا من الاعتماد على الانطباع الشخصي.
- احتفظ بسجلات الاستدعاء: تُعد معلمات الطلب واستهلاك الرموز وسبب انتهاء الاستجابة أدلة مهمة عند التواصل مع مزود الخدمة.
التأثير على القطاع
- الانتقال من الانطباع إلى الإثبات: يوضح FlashProve إمكانية التحقق من هوية أوزان النموذج. وقد يستخدمه مستقبلًا مزودو النماذج وجهات التقييم والجهات التنظيمية للتأكد من النموذج الذي تُقدَّم به الخدمة فعليًا.
- اتساع نطاق مطالب الشفافية: إلى جانب الأوزان، قد يصبح التحقق من اتساق موجه النظام واستراتيجية فك الترميز وإعدادات النشر محور النقاش في المرحلة المقبلة.
- الانتشار ما زال يحتاج إلى وقت: تبلغ تكلفة الإثبات عشرات أضعاف تكلفة الاستدلال العادي، ولا يزال الأمر يتطلب دعم سياقات أطول وآلية موثوقة لنشر الالتزامات. لذلك يصعب تطبيقه على الاستدعاءات اليومية في المدى القريب.
الأسئلة الشائعة FAQ
س1: إذا بدا أن أداء النموذج تراجع، فما أول ما ينبغي التحقق منه؟
ابدأ بمراجعة طلبك: هل اسم model صحيح؟ هل تتوافق معلمات فك الترميز، مثل temperature، مع التوصيات الرسمية؟ هل قيمة max_tokens صغيرة جدًا؟ وهل أُرسل سجل الرسائل كاملًا في المحادثة متعددة الجولات؟ تشير تجربة فريق Kimi إلى أن عددًا كبيرًا من نتائج الاختبارات غير الطبيعية يعود إلى الاستخدام الخاطئ لمعلمات فك الترميز، لذا غالبًا ما تكون هذه الخطوة الأسرع في إظهار النتائج.
س2: هل يستطيع FlashProve حسم الجدل حول تراجع أداء النموذج تمامًا؟
لا. يمكنه التحقق مما إذا كان المخرَج صادرًا عن أوزان محددة، لكن ذلك يفترض وجود التزام موثوق بأوزان النموذج للمقارنة معه. أما عوامل مثل موجه النظام، وسياسات الأمان، واقتطاع السياق، وطريقة التكميم، ومعلمات فك الترميز، فلا يغطيها إثبات الأوزان تلقائيًا.
س3: كيف أجري اختبارًا مقارنًا موثوقًا؟
ثبّت جميع المعلمات والموجهات، وأعدّ عدة حالات اختبار ذات إجابات واضحة، ثم شغّل كل حالة عدة مرات لحساب نسبة الإجابات الصحيحة، مع تسجيل finish_reason واستهلاك الرموز. عبر APIYI apiyi.com، يمكنك استخدام الشفرة نفسها المتوافقة مع OpenAI لإجراء اختبارات مقارنة بين عدة نماذج. كما يحصل المستخدمون الجدد على رصيد اختبار مجاني يمكن استخدامه في هذا النوع من التحقق.
س4: لماذا قد يكون أداء نموذج الاستدلال عبر API أضعف منه في نسخة الويب؟
من الأسباب الشائعة عدم تفعيل وضع التفكير أو اختلاف إعدادات ميزانيته، وعدم توافق معلمات أخذ العينات مع التوصيات الرسمية، وطريقة إعادة تمرير محتوى التفكير في المحادثات متعددة الجولات، فضلًا عن أن موجه النظام والأدوات المتاحة في نسخة الويب قد لا تكون موجودة عند استخدام API. يُنصح بمراجعة تعليمات API في الوثائق الرسمية للنموذج ومقارنتها بإعداداتك بندًا بندًا.
س5: بعد التأكد من صحة إعداداتي، كيف أتواصل مع مزوّد الخدمة؟
جهّز عينات من الطلبات ذات المعلمات الثابتة، والنتائج الإحصائية لعمليات التشغيل المتكررة، وبيانات المقارنة مع القنوات الرسمية، والفترة الزمنية التي ظهر فيها الخلل. يمكنك الاطلاع على سجلات الاستدعاء وإحصاءات الاستخدام في لوحة تحكم APIYI apiyi.com. أرفق السجلات المعنية عند التواصل، فهذا يساعد كثيرًا على تسريع تحديد سبب المشكلة.
أهم النقاط لتقصّي أسباب تراجع أداء النموذج
- تراجع أداء النموذج لا يعني بالضرورة استبداله: فقد يتغير الأداء بسبب موجه النظام أو السياق أو معاملات فك الترميز وغيرها.
- سوء استخدام المعاملات شائع: أكّد فريق Kimi أن نسبة ملحوظة من نتائج الاختبارات غير الطبيعية ترجع إلى سوء استخدام معاملات فك الترميز.
- استقصِ المشكلة على مراحل: ابدأ بفحص جهة الاستدعاء، ثم أجرِ اختبارات مقارنة، وأخيرًا تحقّق من وجود مشكلة في الخادم.
- لا يكفي اختبار واحد للحكم: قارن توزيع المخرجات عبر تشغيلات متعددة، بدلًا من الاعتماد على إجابة أو إجابتين.
- التحقق من الأوزان له حدود: يتحقق FlashProve من هوية الأوزان فقط، ولا يكشف التغييرات في إعدادات المنتج.
- وحّد أدوات الاختبار: يمكن استخدام الواجهة المتوافقة والسجلات لدى APIYI apiyi.com للمقارنة بين النماذج.
الخلاصة
كانت النقاشات حول تراجع أداء النموذج تعتمد في السابق غالبًا على لقطات الشاشة والانطباعات الشخصية. ويقدم FlashProve من Anthropic طريقة قابلة للتحقق لمعرفة ما إذا كان النموذج قد استُبدل، لكنه يذكّرنا أيضًا بأن هناك إعدادات أخرى، بخلاف الأوزان، تؤثر في الأداء.
- ابدأ بفحص إعداداتك: معاملات فك الترميز و
max_tokensوقائمة الرسائل والمحتوى المسترجع بواسطة RAG هي أقل نقاط البداية تكلفة. - ثم أجرِ المقارنة: قارن الأداء بالنتائج الرسمية باستخدام معاملات ثابتة وحالات اختبار متعددة وتشغيلات متكررة، واستند إلى البيانات بدلًا من الانطباعات.
- تواصل مع مزود الخدمة أخيرًا: بعد التأكد من سلامة إعدادات جهة الاستدعاء، شارك سجلات الطلبات والنتائج الإحصائية مع مزود الخدمة لتحديد المشكلة على الخادم.
يُنصح بإضافة سكربت المقارنة الوارد في هذا المقال إلى اختبارات الانحدار الدورية، واستخدام APIYI apiyi.com للتحقق سريعًا من أداء عدة نماذج بالشفرة نفسها. وتوفر المنصة رصيدًا مجانيًا للاختبار وواجهة موحدة متوافقة مع OpenAI.
📚 المراجع
- 36氪 / APPSO – تحليل بحث Anthropic حول الاستدلال القابل للإثبات: شرح مبادئ FlashProve وبيانات التجارب ومناقشة أسباب «تراجع أداء النموذج»
- الرابط:
36kr.com/p/4056019887510401 -
ملاحظات: المصدر الرئيسي للحقائق والبيانات في هذا المقال، ويتضمن معلومات عن Kimi Vendor Verifier وModel Equality Testing
-
Anthropic Research – Provable Inference: صفحة البحث الرسمية لـ FlashProve
- الرابط:
anthropic.com/research/provable-inference - ملاحظات: تتيح الاطلاع على التقرير التقني والشفرة مفتوحة المصدر والبراهين الصورية
الكاتب: الفريق التقني في APIYI
للتواصل التقني: إذا واجهت مشكلة أثناء التحقيق في نتائج غير متوقعة لاستدعاء النموذج، يمكنك التواصل معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com. ولمزيد من إرشادات التكامل، تفضل بزيارة مركز التوثيق على docs.apiyi.com