Nota do autor: separamos em blocos distintos a pontuação agregada de terceiros, os preços oficiais, a leitura de cache e as comparações item a item entre GPT-6.2 Sol e Claude Fable 5.2, explicando quais números podem ser comparados diretamente e quais não podem ser resumidos num único “quem é mais forte”.
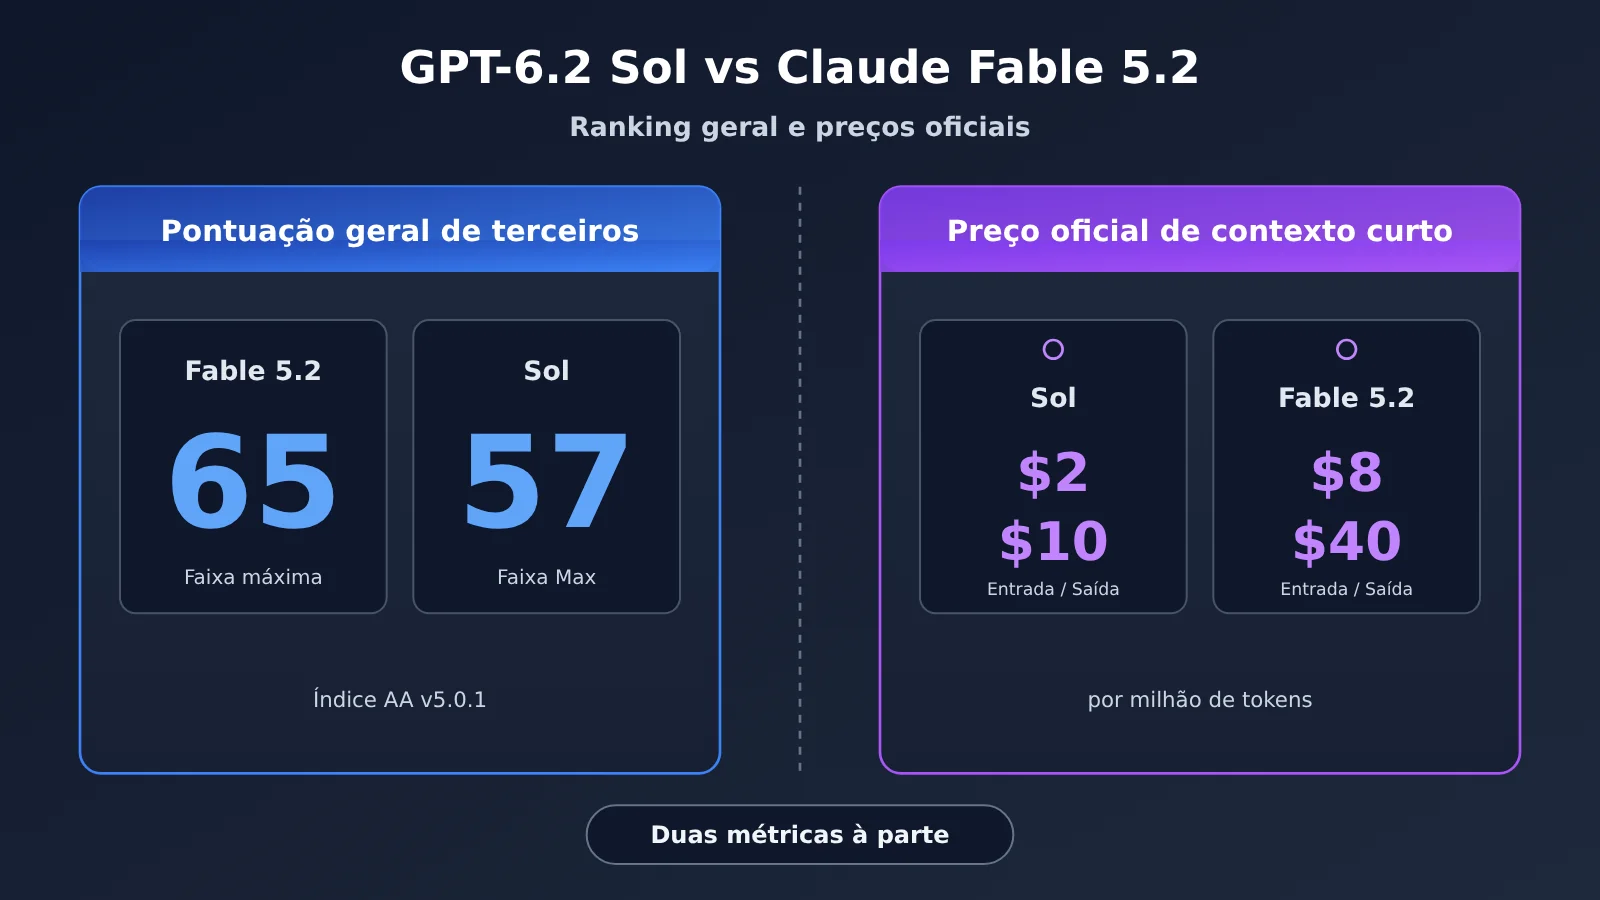
Ao colocar GPT-6.2 Sol e Claude Fable 5.2 lado a lado, o erro mais fácil de cometer é deixar que um único “quem é mais forte” cubra todos os números. Em 17 de novembro de 2026, a OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol, e a agência independente Artificial Analysis atualizou seu ranking agregado no mesmo dia: Claude Fable 5.2 marca 65 pontos no nível máximo de raciocínio, enquanto o GPT-6.2 Sol marca 57 pontos no nível Max. Por outro lado, pelos preços oficiais de tabela para contexto curto das duas empresas, tanto o preço de entrada quanto o de saída do Sol equivalem a um quarto dos preços do Fable.
A diferença de pontos é grande, a diferença de preço também, as duas coisas são verdadeiras, mas uma não cancela a outra e elas não podem ser condensadas numa única conclusão. Este não é um artigo que escolhe um lado por você. Autoavaliação oficial, rankings de terceiros e tabelas de preços dos fabricantes pertencem a três conjuntos distintos de critérios; este artigo os desconstrói camada por camada e lista em separado quais itens, na verdade, não têm comparação oficial direta entre Sol e Fable.
Valor central: ao terminar a leitura, você terá três conjuntos de números verificáveis — pontuação agregada, preços oficiais e leitura de cache —, saberá quais itens não servem para comparar Sol com Fable e poderá decidir, conforme a sua tarefa, qual lado consultar primeiro.
Pontos essenciais do GPT-6.2 Sol e do Claude Fable 5.2
A tabela abaixo traz de início os números no nível de conclusão, com o critério de medição anotado em cada linha. As seções seguintes detalham cada uma delas em sequência.
| Ponto essencial | Número | Critério e interpretação |
|---|---|---|
| Pontuação geral | Fable 5.2 com 65, Sol (Max) com 57 | Índice de terceiros Artificial Analysis Intelligence Index v5.0.1, no nível máximo de raciocínio de cada um |
| Preço de tabela de entrada/saída com contexto curto | Sol $2 / $10, Fable $8 / $40 (por 1 milhão de tokens) | Preços de tabela oficiais das duas empresas; Sol custa um quarto do preço da Fable, limitado apenas a estes dois itens |
| Preço de tabela de leitura de cache | Sol $0.10, Fable $0.20 | Preço de tabela oficial; Sol custa metade do preço da Fable, não um quarto |
| Comparação direta nos materiais oficiais | Elo da avaliação humana às cegas AA-3D: Sol 1259, Fable 1271 | Repasse oficial; os demais itens individuais oficiais são, na maioria, Astra vs. Fable, ou Sol vs. modelos antigos da própria casa |
| Disponibilidade na APIYI | claude-fable-5-2 já disponível; gpt-6.2-sol ainda indisponível |
Vale o que consta na lista de modelos da plataforma |
Sobre o preço do GPT-6.2 Sol indicado na tabela: os valores acima são os preços oficiais da OpenAI; o modelo ainda não está disponível e o publicaremos o quanto antes. Quanto ao modelo e aos preços, vale o que consta na lista de modelos da plataforma.
Por que a comparação entre GPT-6.2 Sol e Claude Fable 5.2 precisa ser feita em camadas
O índice geral comprime dezenas de tarefas em uma única pontuação — serve para responder “em qual faixa o nível geral se encontra”, mas não responde “quem é mais adequado para a minha tarefa”. O preço de tabela responde quanto se paga por milhão de tokens, o que não equivale a quanto custa concluir uma tarefa, porque o nível de raciocínio, o volume de tokens de pensamento e a taxa de acerto do cache de cada lado alteram a fatura real.
As tarefas individuais formam uma terceira camada. No texto de lançamento, a OpenAI menciona resultados individuais da Fable, mas o alvo da comparação é, na maioria das vezes, o GPT-6.2 Astra, e não o Sol. Atribuir ao Sol as notas do Astra é o equívoco mais comum nesse tipo de comparação — e este artigo se dedica justamente a separar os dois.
GPT-6.2 Sol vs Claude Fable 5.2: principais diferenças
Pontuação agregada de terceiros: GPT-6.2 Sol vs Claude Fable 5.2
A Artificial Analysis é uma agência independente de avaliações — os números abaixo não são autodeclarados pela OpenAI nem pela Anthropic. No Intelligence Index v5.0.1, ela dá uma nota a cada modelo separadamente por nível de raciocínio, então, na hora de comparar, é essencial deixar claro qual nível você está usando.
| Modelo | Nível de raciocínio | Intelligence Index v5.0.1 | Custo por tarefa no índice agregado (página de cada modelo) |
|---|---|---|---|
| Claude Fable 5.2 | Nível máximo de raciocínio | 65 (1º lugar do ranking) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | Nível máximo | 60 | — |
| Claude Opus 5.5 | Nível máximo | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
Segundo a Artificial Analysis, o Sol fica 2 pontos acima do GPT-6.1 Sol, chegando a 57, empata com o GPT-6 Astra e tem um custo por tarefa de cerca de 15% do valor deste último. O “custo por tarefa” da tabela é o gasto quando a agência roda esse índice — ele reflete a combinação de nível de raciocínio, extensão do pensamento e preço de tabela, e não o preço de lista da API.
Vale a pena notar: a OpenAI disse oficialmente que o Astra tem um custo de aproximadamente 5% do Fable no Agents’ Last Exam — mas esse é outro conjunto de tarefas. Não dá para converter entre $26.54 e os “5%” oficiais, nem aplicar essa conta ao Sol.
Preços oficiais e cache do GPT-6.2 Sol e do Claude Fable 5.2
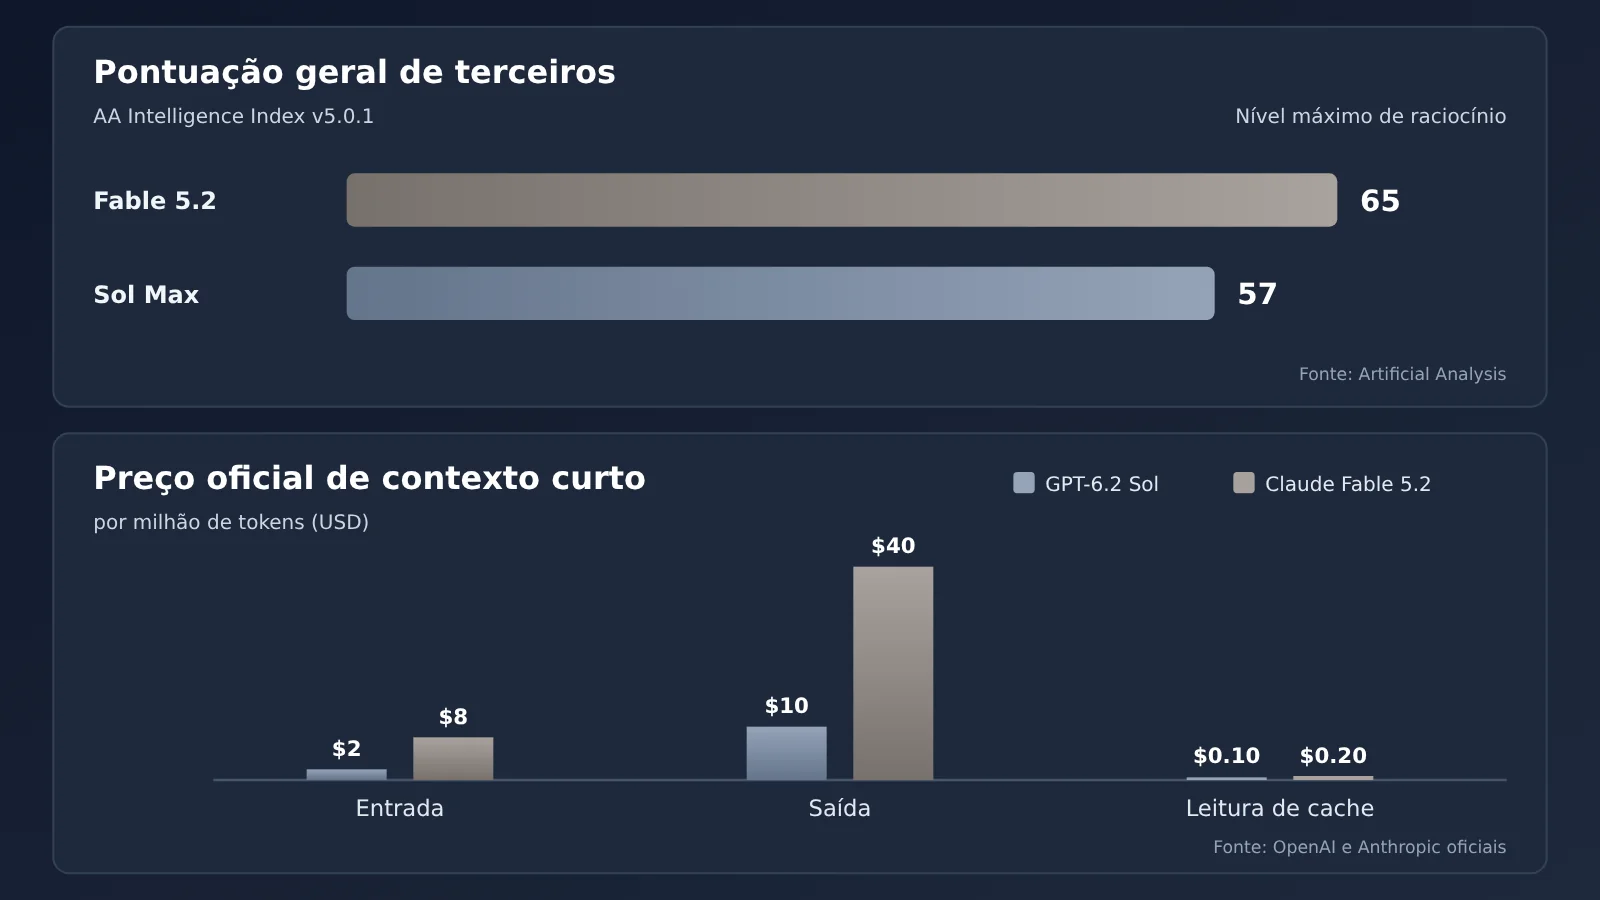
Vamos começar pelo GPT-6.2 Sol. Na página de modelos da OpenAI, a faixa padrão com contexto curto está precificada assim: entrada de $2, leitura de cache de $0.10, escrita de cache (com retenção de 30 minutos) de $2.50, escrita de cache de 12 horas por $5 e saída de $10. O modelo ainda não está disponível na plataforma, mas vamos publicá-lo o quanto antes; nomes de modelos e preços devem ser confirmados na lista de modelos da plataforma. Segundo a nota de lançamento, o Sol mantém os mesmos preços de token da API do GPT-6.1 Sol.
Na documentação da Anthropic, o Claude Fable 5.2 está precificado em: entrada de $8, saída de $40, escrita de cache de 5 minutos por $10, escrita de cache de 1 hora por $16 e leitura de cache de $0.20. Na tabela geral de modelos da APIYI (apiyi.com), claude-fable-5-2 e claude-fable-5-2-thinking listam entrada, saída e leitura de cache como $8 / $40 / $0.2, em linha com os valores oficiais; as páginas de detalhes dos dois modelos retornam 404 no momento, então use a tabela geral como referência de preços.
| Item de cobrança (por 1 milhão de tokens) | GPT-6.2 Sol (oficial da OpenAI) | Claude Fable 5.2 (oficial da Anthropic) | Relação entre os dois |
|---|---|---|---|
| Entrada (contexto curto) | $2 | $8 | Um quarto |
| Saída (contexto curto) | $10 | $40 | Um quarto |
| Leitura de cache | $0.10 | $0.20 | Metade |
| Escrita de cache | 30 minutos $2.50; 12 horas $5 | 5 minutos $10; 1 hora $16 | Durações de retenção diferentes; não dá para dividir diretamente |
| Batch | 50% do preço padrão | Entrada e saída pela metade do preço | Regras parecidas |
| Faixa acelerada | Fast: 2x o preço padrão; Ultrafast: 3x até 2027-02-28 e 6x a partir de 2027-03-01 | Fast mode: entrada $16, saída $80, até cerca de 2,5x mais rápido | Mecanismos diferentes |
Os valores do GPT-6.2 Sol na tabela são os preços oficiais da OpenAI. O modelo ainda não está disponível na plataforma, mas vamos publicá-lo o quanto antes; nomes de modelos e preços devem ser confirmados na lista de modelos da plataforma.
A ideia de que “o Sol custa um quarto do Fable” só se sustenta na entrada e na saída com contexto curto. A página de modelos da OpenAI traz ainda uma regra: quando a entrada de uma única requisição passa de 272K tokens, o preço unitário da entrada e do cache dobra, a saída é cobrada a 1,5x do valor de contexto curto — e tudo é calculado sobre a requisição inteira. Nesse cenário, o preço unitário de saída do Sol deixa de ser $10, e qualquer estimativa usando o fator de um quarto vai dar errado. Já para a cobrança de contexto longo do lado do Fable, siga a documentação da Anthropic.
Especificações e interfaces do GPT-6.2 Sol e do Claude Fable 5.2
Os dois modelos têm janela de contexto na casa do milhão, com saída máxima de 128K nos dois casos. As diferenças estão nas modalidades de entrada, nos controles de raciocínio e nas interfaces — pontos que afetam diretamente a forma de integração.
| Item | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| Janela de contexto / saída máxima | 1.050.000 (entrada máxima de 922.000) / 128.000 | 1M / 128K |
| Entrada / saída | Texto, imagem / texto | Conforme a documentação oficial da Anthropic |
| Data de corte do conhecimento | 2026-06-01 | 2026-06 |
| Configurações de raciocínio | A API não permite definir o reasoning effort como none | O effort padrão é high, com o pensamento ativado e sem opção de desligar |
| Endpoints oficiais | Chat Completions, Responses, Batch | API da Anthropic |
| APIYI | Não disponível no catálogo | claude-fable-5-2, claude-fable-5-2-thinking, endpoints chat e messages |
Para fazer a invocação do modelo Fable, que já está disponível na APIYI, o base URL no modo compatível com OpenAI é https://api.apiyi.com/v1, preenchendo o campo do modelo com claude-fable-5-2; se o projeto já segue o protocolo Anthropic Messages, também dá para usar o endpoint messages da plataforma. Quanto aos grupos, a tabela geral lista ClaudeCode, Claude_Reverse, Claude_Enterprise, Default e SVIP.
GPT-6.2 Sol e Claude Fable 5.2: analisando cada tarefa separadamente
Esta é a seção mais importante do artigo. O texto de lançamento da OpenAI apresenta uma série de resultados por tarefa individual, mas comparações diretas “Sol vs Fable” são raras. A tabela abaixo lista cada item, organizado por fonte e pelos pares comparados.
| Item | Fonte | Pares comparados e resultados | É comparação direta Sol vs Fable? |
|---|---|---|---|
| Intelligence Index v5.0.1 | Terceira parte (AA), nível máximo de raciocínio | Fable 65, Sol (Max) 57 | Sim (pontuação composta de terceira parte) |
| AA-3D Elo de avaliação cega por humanos | Transcrição oficial | Sol 1259, Fable 1271 | Sim (único item dos materiais oficiais) |
| AA-Robotics v0.1 | Terceira parte (AA), prévia de pesquisa | Sol 78, Fable 75 | Sim (prévia de terceira parte; níveis de raciocínio conforme a página da AA) |
| Agents’ Last Exam | Auto-relato oficial | Astra supera o Fable em 5,5 pontos, custo de cerca de 5% | Não, é Astra vs Fable |
| Harvey LAB-AA v1.1 | Auto-relato oficial | Taxa de aprovação da Astra mais que o dobro da do Fable, custo de cerca de um sexto | Não, é Astra vs Fable |
| FrontierCode 2.0 | Auto-relato oficial | Sol e Astra diferem por menos de 0,5 ponto, custo de cerca de um quinto, ambos no nível Max | Não, é Sol vs Astra |
| LifeVal | Auto-relato oficial | Sol acima do GPT-6 Astra, custo de cerca de um sétimo | Não |
| GDPval v2 | Auto-relato oficial | Sol 5,3 pontos acima do GPT-6.1 Sol | Não |
| Coding Agent Index | Terceira parte (AA), nível max | Sol 3 pontos abaixo do GPT-6.1 Sol | Não |
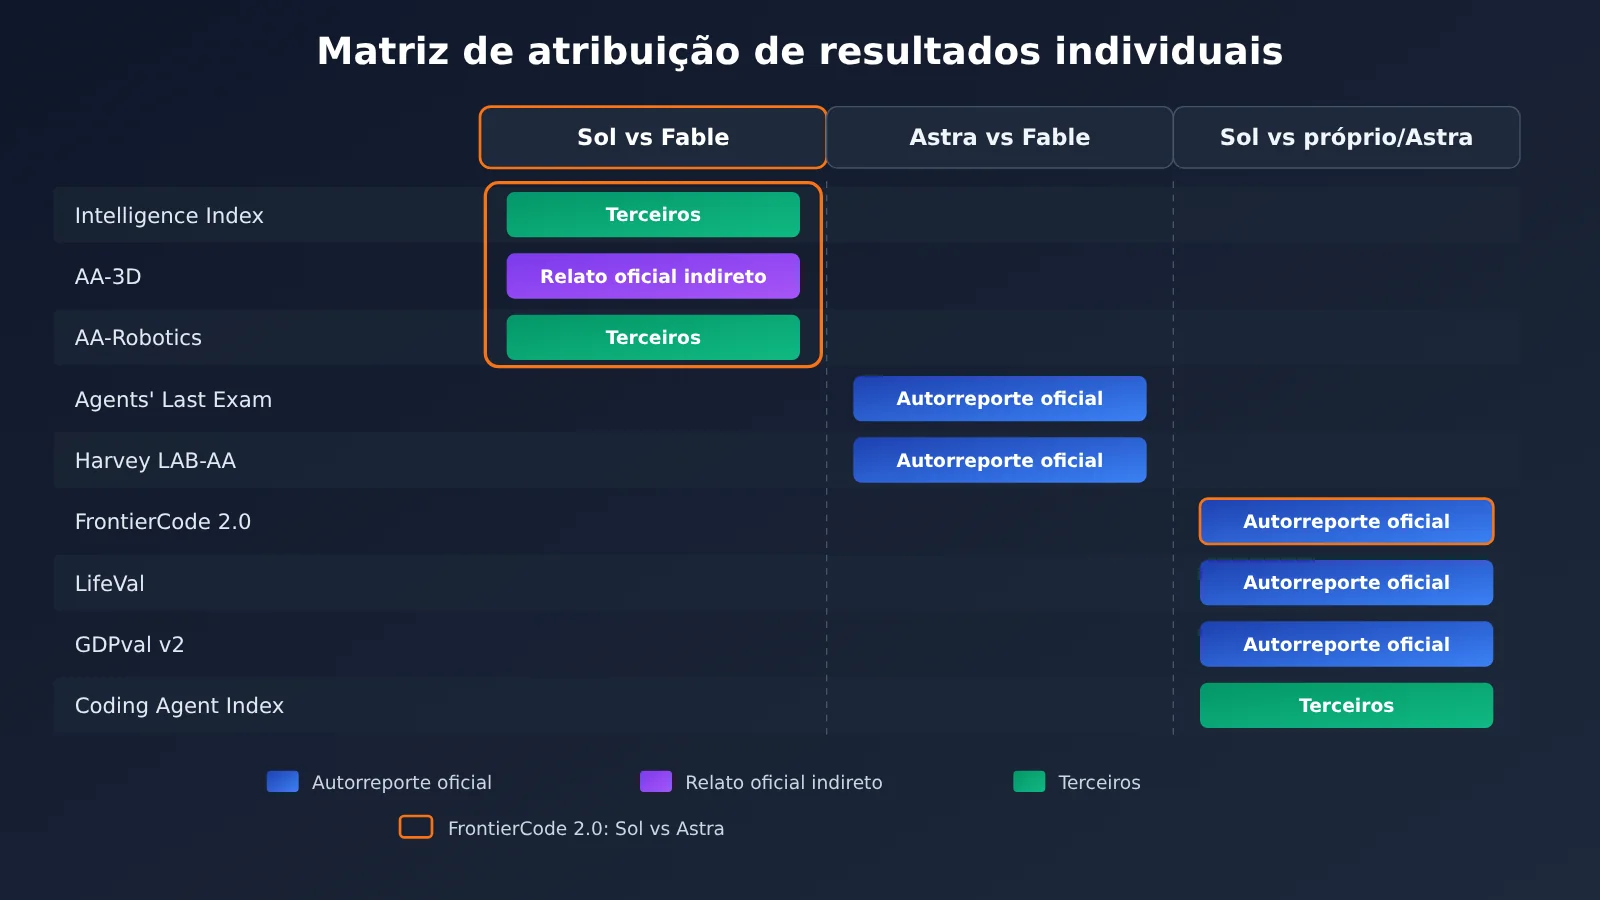
O resultado do GPT-6.2 Sol no FrontierCode 2.0 não pode ser reaproveitado numa comparação com o Fable
O FrontierCode 2.0 foi criado pela Cognition e avalia se as alterações em repositórios de código reais conseguem ser mescladas (merge) pelos mantenedores. O resultado auto-reportado oficialmente mostra que Sol e Astra diferem por menos de 0,5 ponto, com custo de cerca de um quinto do da Astra — ambos no nível Max. O Fable não participou dessa comparação, então não se pode dizer que “Sol fica a menos de 0,5 ponto do Fable no FrontierCode”.
Pela mesma lógica, no Agents’ Last Exam e no Harvey LAB-AA quem lidera sobre o Fable é a Astra. Como o Sol se compara ao Fable nesses dois itens, o texto de lançamento não informa — e não cabe especular.
Os itens de ciência e código do GPT-6.2 Sol e do Claude Fable 5.2
Cuidado também com o Terminal-Bench-Science 0.1. O auto-relato oficial indica que a Astra ficou 9 pontos percentuais acima do GPT-6 Astra; na nota de rodapé, o Fable 5.2 aparece com dois números: um vem do teste da Artificial Analysis usando o mini-swe-agent, e o outro é o 74,6% reportado pela Anthropic com Claude Code em intensidade de raciocínio Max. Esses dois números do Fable vêm de testes diferentes — não dá para tratá-los como uma única comparação, e nenhum deles é resultado do Sol.
No que diz respeito a terceiras partes, a Artificial Analysis menciona que o Sol ficou 3 pontos abaixo do GPT-6.1 Sol no Coding Agent Index (com o harness do Codex, nível max), principalmente porque no SWE-Atlas-QnA-AA caiu 14 pontos, ficando mais propenso a deixar passar fatos-chave. A taxa de alucinação do AA-Omniscience medida para o Sol (Max) foi de 55%. Esses números não têm valores correspondentes do Fable — servem apenas para entender as fraquezas do próprio Sol.
Recomendações de cenário para GPT-6.2 Sol e Claude Fable 5.2
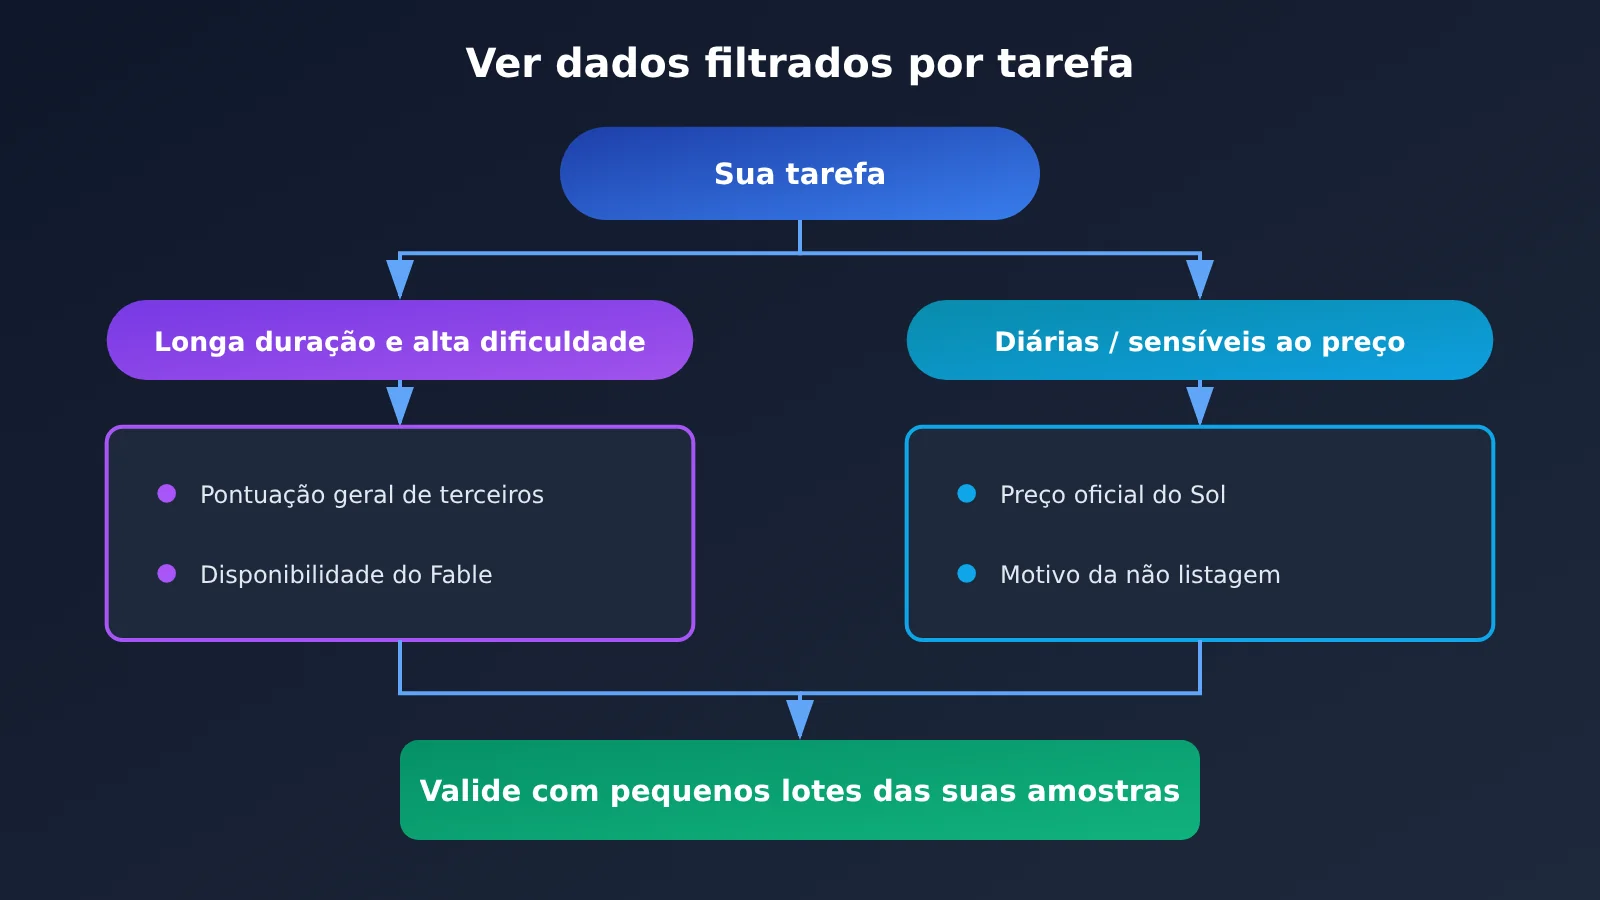
Esta seção não vai decidir por você qual modelo usar — ela apenas mostra quais dados consultar primeiro de acordo com o tipo de tarefa.
Tarefas em que vale consultar primeiro os dados do Claude Fable 5.2
- Tarefas abrangentes, de longo prazo, alta dificuldade e múltiplas etapas: comece pela pontuação composta de terceiros. A Fable alcançou 65 no nível máximo de raciocínio do Intelligence Index v5.0.1, ficando no topo da lista — esse é, no momento, o dado composto diretamente comparável com a Sol.
- Projetos que precisam de integração imediata: o
claude-fable-5-2já está disponível na APIYI, então você pode testar agora mesmo com suas próprias amostras. - Projetos em que o custo de raciocínio importa: o raciocínio da Fable vem ativado por padrão e não pode ser desativado, com o effort padrão definido como high — na hora de fechar o orçamento, não se esqueça de incluir os tokens de raciocínio na conta.
Tarefas em que vale consultar primeiro os dados do GPT-6.2 Sol
- Tarefas do dia a dia e tarefas em lote sensíveis a preço: confira primeiro os preços de tabela oficiais para contexto curto e as regras do Batch; depois, veja os resultados em tarefas cotidianas auto-reportados oficialmente, como LifeVal e GDPval v2.
- Requisições que ficam dentro de 272K: é nessa faixa que aparece principalmente a diferença de preço de um quarto nas entradas e saídas da Sol.
- Equipes que já usam o ChatGPT Work ou o Codex: segundo o anúncio oficial, Plus, Pro, Enterprise e Edu estão disponíveis a partir de hoje, e o Pro 200 recebe pela primeira vez o Ultrafast, oferecido a partir da Sol.
GPT-6.2 Sol e Claude Fable 5.2: guia de início rápido
Esta seção organiza a ordem das operações por tipo de tarefa. Não há código no texto — os nomes dos modelos e os endereços aparecem escritos diretamente nas frases.
Tarefas longas e de alta dificuldade: comece pela pontuação geral do Fable e pela disponibilidade na plataforma. Crie uma chave API no console da APIYI, altere a base URL do SDK compatível com OpenAI para https://api.apiyi.com/v1 e defina o model como claude-fable-5-2; se preferir que o nome do modelo indique explicitamente o modo de pensamento, também é possível usar claude-fable-5-2-thinking. A tabela geral registra os preços de $8 para entrada, $40 para saída e $0.2 para leitura de cache, em linha com os valores oficiais da Anthropic. Recomendamos primeiro rodar de 20 a 50 das suas tarefas reais para registrar a taxa de conclusão e o consumo de tokens e, só então, avaliar se a nota de 65 pontos se manifesta no seu cenário.
Tarefas do dia a dia sensíveis ao preço de tabela: confira depois o preço oficial do Sol e o aviso de indisponibilidade. O preço oficial da OpenAI para o GPT-6.2 Sol é de $2 para entrada, $0.10 para leitura de cache e $10 para saída. Ele ainda não está disponível na plataforma — faremos o lançamento o mais rápido possível; o nome do modelo e os preços devem ser confirmados na lista de modelos da plataforma. Antes do lançamento, verifique periodicamente a lista de modelos em apiyi.com e não use os modelos gpt-6.1-sol ou gpt-6-sol da plataforma como substitutos nos testes: eles não são a versão 6.2, e o preço de leitura de cache do gpt-6-sol também é diferente.
Depois que o Sol entrar no catálogo, três pontos merecem atenção: o reasoning effort não pode ser definido como none; quando a entrada ultrapassa 272K, o acréscimo é aplicado ao pedido inteiro; e o endpoint oficial oferece suporte a Chat Completions e Responses — os endpoints da plataforma devem ser confirmados na lista de modelos.
🚀 Início rápido: uma mesma chave API permite invocar vários modelos da plataforma. Recomendamos primeiro colocar o Fable para rodar de ponta a ponta na APIYI (apiyi.com) usando o crédito gratuito de teste, deixar os scripts de avaliação e as amostras prontos e, quando o Sol for disponibilizado, basta trocar o nome do modelo para refazer a comparação com as mesmas amostras.
Recomendações de decisão entre GPT-6.2 Sol e Claude Fable 5.2
Abaixo está um checklist para ajudar você a contextualizar esses números nas suas próprias tarefas.
- Confirme primeiro a origem dos dados: o que está sendo citado é uma pontuação agregada de terceiros, um resultado individual autodeclarado oficialmente ou o preço oficial? Não some os três nem tente converter um no outro.
- Verifique o nível de raciocínio: os 57 pontos do Sol são na faixa Max; na faixa High são 55, e na Low apenas 41. Consulte a pontuação da faixa que você realmente vai usar.
- Faça as contas pelo tamanho da requisição: até 272K, é possível estimar entrada e saída na proporção de um quarto; acima de 272K, é preciso recalcular segundo a regra de cobrança do pedido inteiro da OpenAI.
- Calcule o cache separadamente: a leitura em cache custa $0.10 contra $0.20 — uma diferença do dobro; os tempos de retenção da gravação em cache também variam, então estime cada um conforme a sua própria estratégia de cache.
- Confirme se existe a comparação individual desejada: se a métrica que você se importa só tem dados de Astra versus Fable ou de Sol versus Astra, não dá para tratá-la como uma conclusão entre Sol e Fable.
- Considere as políticas de segurança: oficialmente, ambos os modelos 6.2 atingem o nível “crítico” de cibersegurança do Preparedness Framework; a proteção é mais rigorosa, e parte das solicitações legítimas de pesquisa de vulnerabilidades será recusada.
💡 Recomendação de escolha: qual modelo usar depende do comprimento da tarefa, do nível de raciocínio e da taxa de acerto do cache. Você pode chamar os dois na plataforma APIYI com o mesmo lote de amostras e deixar as faturas e a taxa de conclusão falarem por si — sem precisar depender de um único ranking.
Perguntas Frequentes (FAQ)
Q1: O que são o GPT-6.2 Sol e o Claude Fable 5.2?
O GPT-6.2 Sol é o modelo lançado pela OpenAI em 17/11/2026 junto com o GPT-6.2 Astra, com ID de modelo `gpt-6.2-sol`. Ele aceita texto e imagens como entrada e gera texto como saída, com janela de contexto de 1.050.000. O Claude Fable 5.2 é o modelo lançado pela Anthropic em 09/11/2026, com janela de contexto de 1M e saída máxima de 128K; o raciocínio vem ativado por padrão e não pode ser desativado.
Q2: O placar de 65 contra 57 no ranking geral prova que o Claude Fable 5.2 supera o GPT-6.2 Sol em tudo?
Não. O 65 contra 57 é o resultado no índice de terceiros Artificial Analysis Intelligence Index v5.0.1, em que o Fable usou o nível máximo de raciocínio e o Sol, o nível Max. Esse número reflete o desempenho geral do índice e não significa que a mesma diferença apareça em cada teste individual. No Elo da avaliação às cegas por humanos do AA-3D, citado nos materiais oficiais, o Sol marcou 1259 e o Fable 1271 — uma diferença bem menor; na prévia de pesquisa do AA-Robotics v0.1, de terceiros, o Sol marcou 78 e o Fable 75.
Q3: O preço do GPT-6.2 Sol é mesmo um quarto do preço do Claude Fable 5.2?
Isso vale apenas para entrada e saída com contexto curto. Pelos preços oficiais, o Sol custa $2 na entrada e $10 na saída, enquanto o Fable custa $8 na entrada e $40 na saída. O modelo ainda não está disponível — vamos publicá-lo o mais rápido possível; o modelo e os preços devem ser confirmados na lista de modelos da plataforma. A leitura de cache sai por $0,10 contra $0,20, ou seja, metade do preço; acima de 272K de entrada, o Sol recebe um acréscimo sobre o pedido inteiro e a saída passa a custar 1,5 vez o valor de contexto curto — nesse cenário, já não dá para estimar pela regra do um quarto.
Q4: Qual é a diferença entre o GPT-6.2 Sol e o Claude Fable 5.2 no FrontierCode 2.0?
Os materiais oficiais não trazem essa comparação. O “menos de 0,5 ponto de diferença” no FrontierCode 2.0 compara o GPT-6.2 Sol com o GPT-6.2 Astra, ambos no nível Max, com o Sol custando cerca de um quinto. O Fable não participou dessa comparação.
Q5: Como invocar o GPT-6.2 Sol e o Claude Fable 5.2 via API?
Siga os passos abaixo:
1. Crie sua conta no APIYI (apiyi.com) e obtenha sua chave API e créditos de teste gratuitos.
2. Defina a base URL do SDK compatível com OpenAI para o endereço da plataforma e preencha o model com `claude-fable-5-2` — assim você já consegue invocar o Fable.
3. O `gpt-6.2-sol` ainda não está disponível; quando for lançado, confirme o modelo e os preços na lista de modelos da plataforma e teste com o mesmo lote de amostras.
Q6: Quais são as limitações conhecidas do GPT-6.2 Sol e do Claude Fable 5.2?
No caso do Sol: nos testes de terceiros da AA, a taxa de alucinação no nível Max foi de 55%, e o Coding Agent Index ficou 3 pontos abaixo do GPT-6.1 Sol, principalmente por omitir fatos essenciais com mais facilidade; o reasoning effort não pode ser definido como none; a proteção de segurança cibernética é mais rigorosa, e parte das pesquisas legítimas de vulnerabilidades será recusada. No caso do Fable: o modo de raciocínio não pode ser desativado, o effort padrão é high e os tokens de raciocínio entram na conta do custo; o Fast mode tem preço de $16 na entrada e $80 na saída.
Q7: Segundo os dados oficiais, o custo do Astra é de apenas 5% do custo do Fable. Dá para fazer essa conta cruzando com os $26,54 apurados por terceiros?
Não. Os “cerca de 5%” são o custo autoinformado oficialmente no Agents’ Last Exam, usado para comparar Astra e Fable; já os $26.54 são o custo por tarefa do Fable quando a Artificial Analysis rodou o índice geral. São tarefas e fontes diferentes — não dá para dividir um pelo outro, nem usar esses números para estimar o custo do Sol. Se você só quer uma noção da ordem de grandeza, registrar a fatura real com suas próprias amostras na plataforma APIYI acaba sendo mais confiável.
GPT-6.2 Sol e Claude Fable 5.2: principais conclusões (Key Takeaways)
- Pontuação geral: no índice de terceiros da AA, Fable atinge 65 na faixa mais alta de raciocínio, enquanto Sol registra 57 na faixa Max — uma comparação direta no mesmo ranking.
- Preço tabelado: para entrada e saída com contexto curto, Sol custa um quarto do preço de Fable ($2 contra $8, $10 contra $40).
- Leitura de cache: $0.10 contra $0.20 — a diferença é de apenas metade; não dá para aplicar a regra de um quarto.
- Contexto longo: quando a entrada do Sol passa de 272K, a sobretaxa passa a valer para o pedido inteiro, e a proporção original não serve mais.
- Poucas comparações diretas: nos materiais oficiais, Sol contra Fable aparece apenas no item AA-3D, com 1259 contra 1271.
- Não recicle resultados: FrontierCode 2.0 mede Sol contra Astra, enquanto ALE e Harvey comparam Astra contra Fable.
- Disponibilidade: Fable pode ser invocado diretamente na APIYI (apiyi.com); Sol ainda não está listado — confirme na lista de modelos.
Resumo
Comparar o GPT-6.2 Sol com o Claude Fable 5.2 exige separar as três camadas de números:
- Pontuação agregada de terceiros: Fable 65, Sol (Max) 57, usada para avaliar a faixa geral em que cada modelo se encontra.
- Preços oficiais: em entradas e saídas com contexto curto, a diferença é de um quarto; na leitura de cache, de metade; o contexto longo é calculado à parte, segundo as regras de cada um.
- Tarefas individuais: a maioria dos resultados individuais oficiais não é uma comparação direta entre Sol e Fable; antes de citar, confirme quem estão sendo comparados.
A diferença de pontuação e a diferença de preço não podem ser resumidas numa única frase do tipo “qual vale mais a pena”. A abordagem mais segura é usar suas próprias amostras, fixar o nível de raciocínio e registrar separadamente a taxa de conclusão e a fatura. O Fable já pode ser testado na APIYI, em apiyi.com; o GPT-6.2 Sol ainda não está disponível, mas vamos publicar esse modelo o mais rápido possível. Os modelos e preços vigentes prevalecem conforme a lista de modelos da plataforma.
📚 Referências
-
Anúncio de lançamento da OpenAI: notas de lançamento do GPT-6.2 Astra e Sol e resultados individuais auto-relatados
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: resumo dos resultados individuais auto-relatados oficialmente, disponibilidade e preços oficiais
- Link:
-
Página de modelo da OpenAI – GPT-6.2 Sol: especificações, preços oficiais e regras de cobrança do 272K
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Descrição: preços de gravação de cache, acréscimo por contexto longo e multiplicadores da camada acelerada conforme esta fonte
- Link:
-
Cartão de sistema da OpenAI: avaliações de segurança do GPT-6.2 Astra e Sol
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descrição: classificação da estrutura de prontidão e avaliações de alinhamento
- Link:
-
Artigo e página de modelo da Artificial Analysis: Intelligence Index v5.0.1 de terceiros
- Link:
artificialanalysis.ai/models/claude-fable-5-2 - Descrição: pontuações agregadas por faixa, custo por tarefa individual e Coding Agent Index
- Link:
-
Documentação da Anthropic – Claude Fable 5.2: preços oficiais e especificações
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: gravação de cache, leitura de cache, Fast mode e configurações de effort
- Link:
-
Tabela geral de modelos da APIYI: modelos e preços disponíveis na plataforma
- Link:
docs.apiyi.com/models.md - Descrição: dados de 2026-11-17 15:54 (UTC+8); os modelos e preços vigentes prevalecem conforme a lista de modelos da plataforma
- Link:
Autor: equipe técnica da APIYI
Intercâmbio técnico: entre em contato conosco pela página inicial do site da APIYI; para mais modelos e informações sobre as APIs, consulte o centro de documentação em docs.apiyi.com