Autorennotiz: Die externe Gesamtwertung, die offiziellen Preise, die Cache-Lesekosten und die Einzelvergleiche von GPT-6.2 Sol und Claude Fable 5.2 werden hier getrennt aufbereitet – mit Erklärung, welche Zahlen sich direkt vergleichen lassen und welche sich nicht mit einem einzigen „Wer ist stärker?“ zusammenfassen lassen.
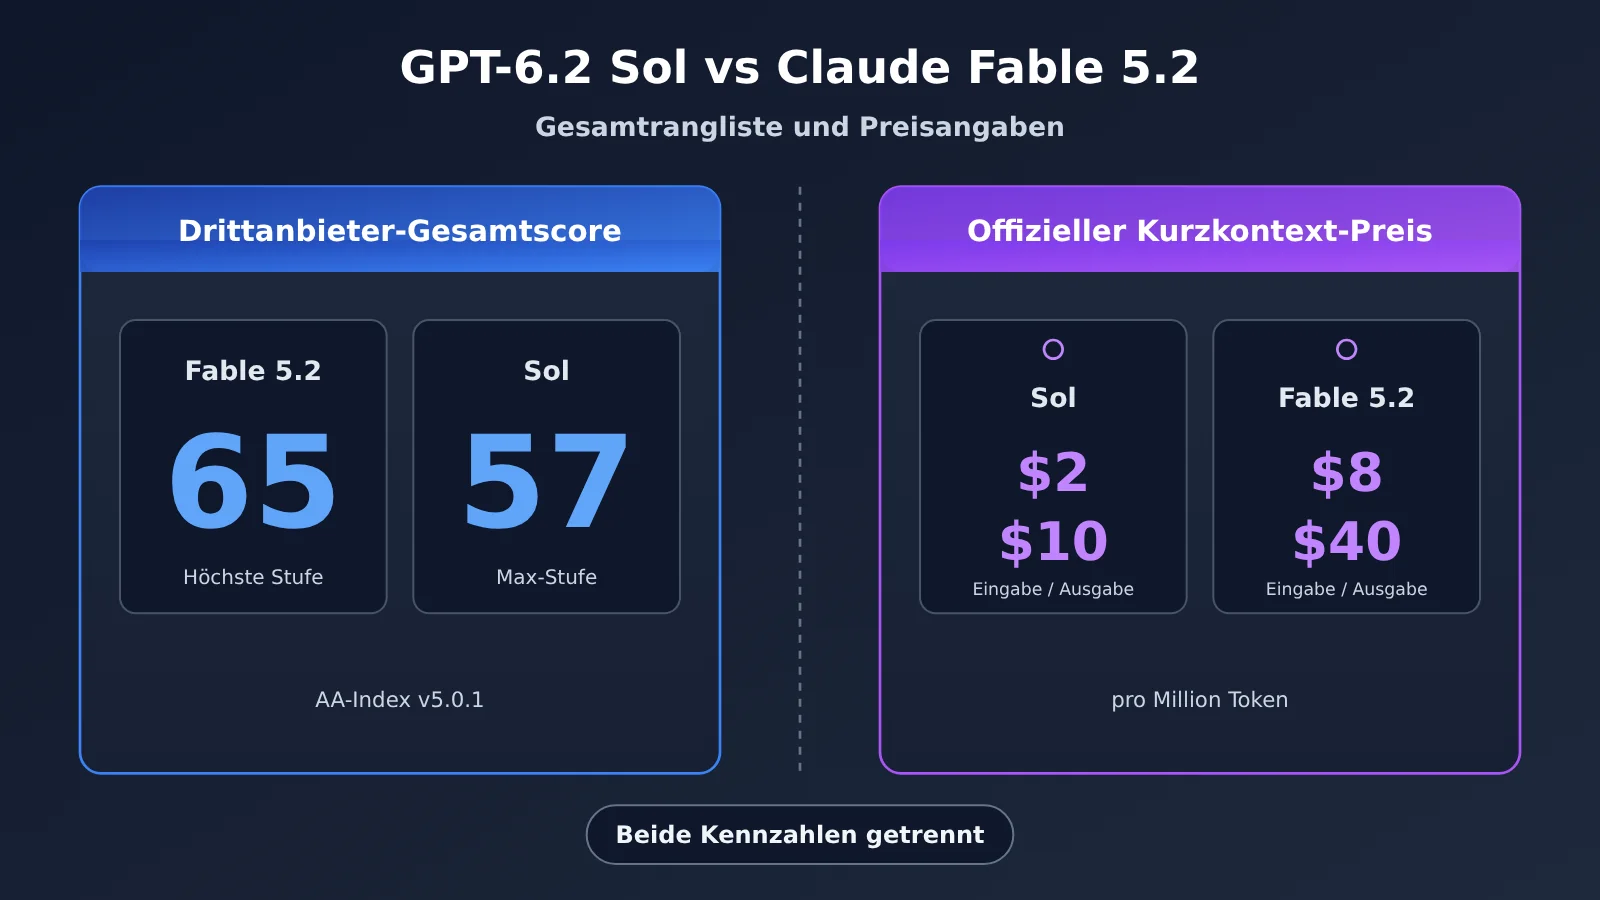
Wer GPT-6.2 Sol und Claude Fable 5.2 direkt vergleicht, macht am ehesten einen Fehler: alle Zahlen hinter einem einzigen „Wer ist stärker?“ verschwinden zu lassen. Am 17. November 2026 veröffentlichte OpenAI GPT-6.2 Astra und GPT-6.2 Sol, und das unabhängige Analyse-Institut Artificial Analysis aktualisierte noch am selben Tag seine Gesamtwertung: Claude Fable 5.2 erreicht auf der höchsten Reasoning-Stufe 65 Punkte, GPT-6.2 Sol kommt auf der Max-Stufe auf 57 Punkte. Andererseits liegt Sol nach den offiziellen Preisen beider Anbieter für kurze Kontexte sowohl beim Einheitspreis für Eingabe als auch für Ausgabe bei einem Viertel dessen, was Fable kostet.
Der Punkteabstand ist groß, der Preisabstand ebenso – beides stimmt, doch die beiden Fakten heben sich nicht gegenseitig auf und lassen sich auch nicht zu einer einzigen Schlussfolgerung verschmelzen. Dieser Artikel ist kein Ratgeber, der die Seitenwahl für dich übernimmt. Selbstangaben der Hersteller, externe Ranglisten und offizielle Preislisten sind drei verschiedene Maßstäbe; dieser Artikel zerlegt sie Schicht für Schicht und listet separat auf, welche Einzelwerte schlicht keine direkte offizielle Gegenüberstellung von Sol und Fable besitzen.
Kernaussage: Nach der Lektüre dieses Artikels hast du drei überprüfbare Zahlengruppen in der Hand – Gesamtwertung, Preisliste und Cache-Lesekosten –, weißt, welche Einzelwerte sich nicht für einen Sol-versus-Fable-Vergleich eignen, und kannst anhand deiner eigenen Aufgabe entscheiden, welche Daten du zuerst prüfst.
GPT-6.2 Sol und Claude Fable 5.2: Die wichtigsten Punkte im Überblick
Die folgende Tabelle liefert vorab die Zahlen auf Ergebnisebene – bei jeder Zeile ist die zugrunde liegende Erhebungsmethode vermerkt. In den nachfolgenden Abschnitten gehen wir alles Zeile für Zeile durch.
| Punkt | Zahl | Grundlage und Interpretation |
|---|---|---|
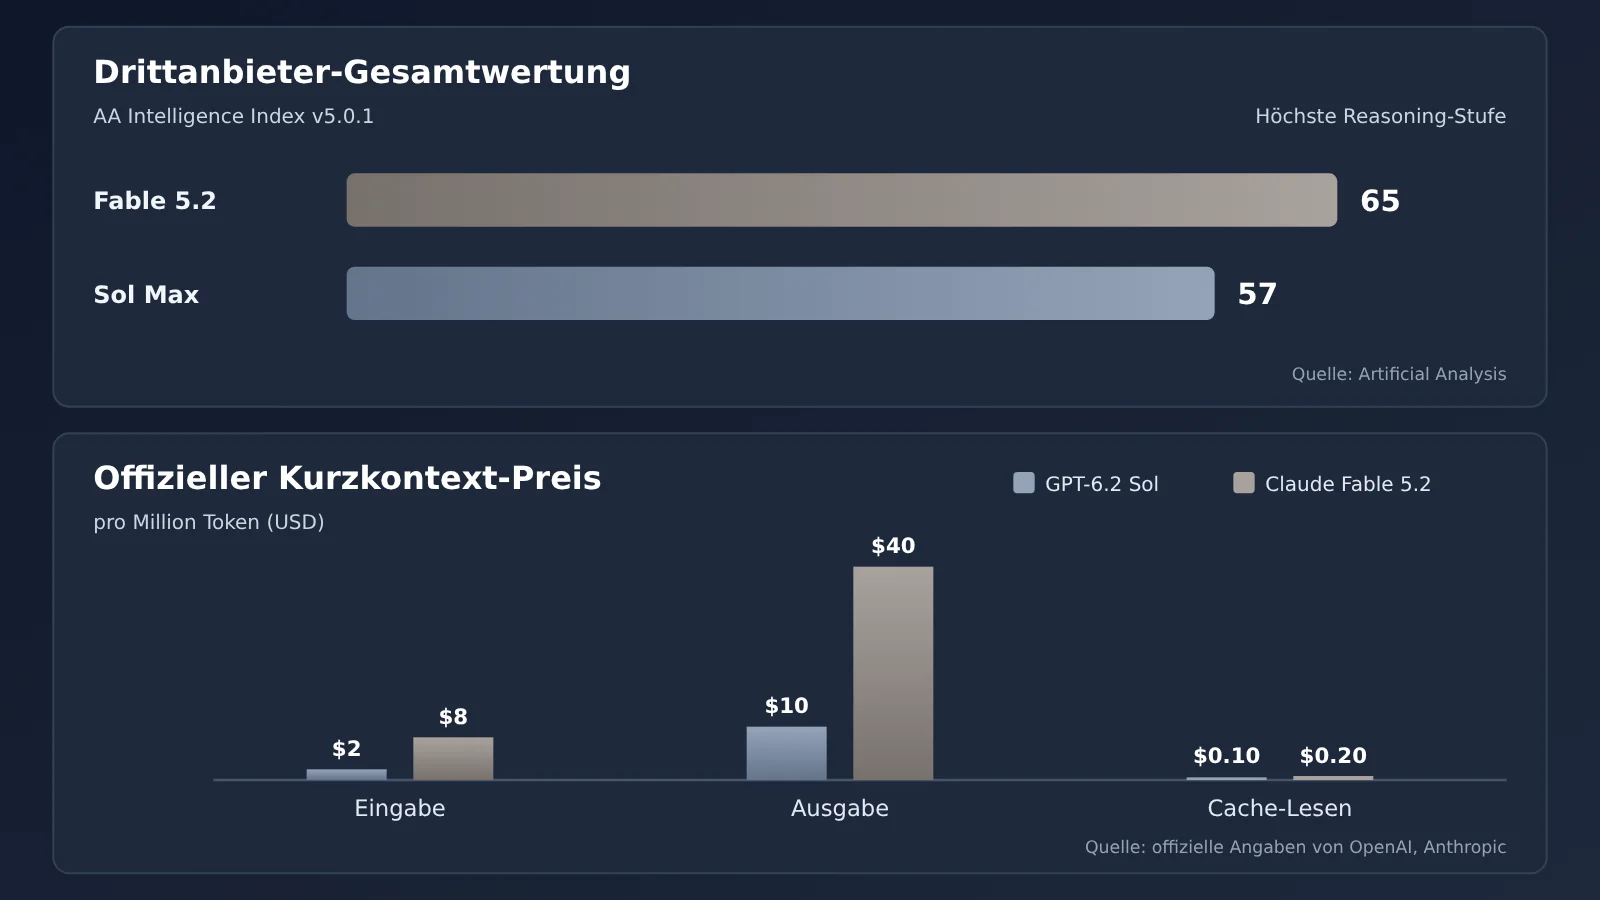
| Gesamtscore | Fable 5.2 mit 65, Sol (Max) mit 57 | Unabhängiger Artificial Analysis Intelligence Index v5.0.1, jeweils höchste Reasoning-Stufe |
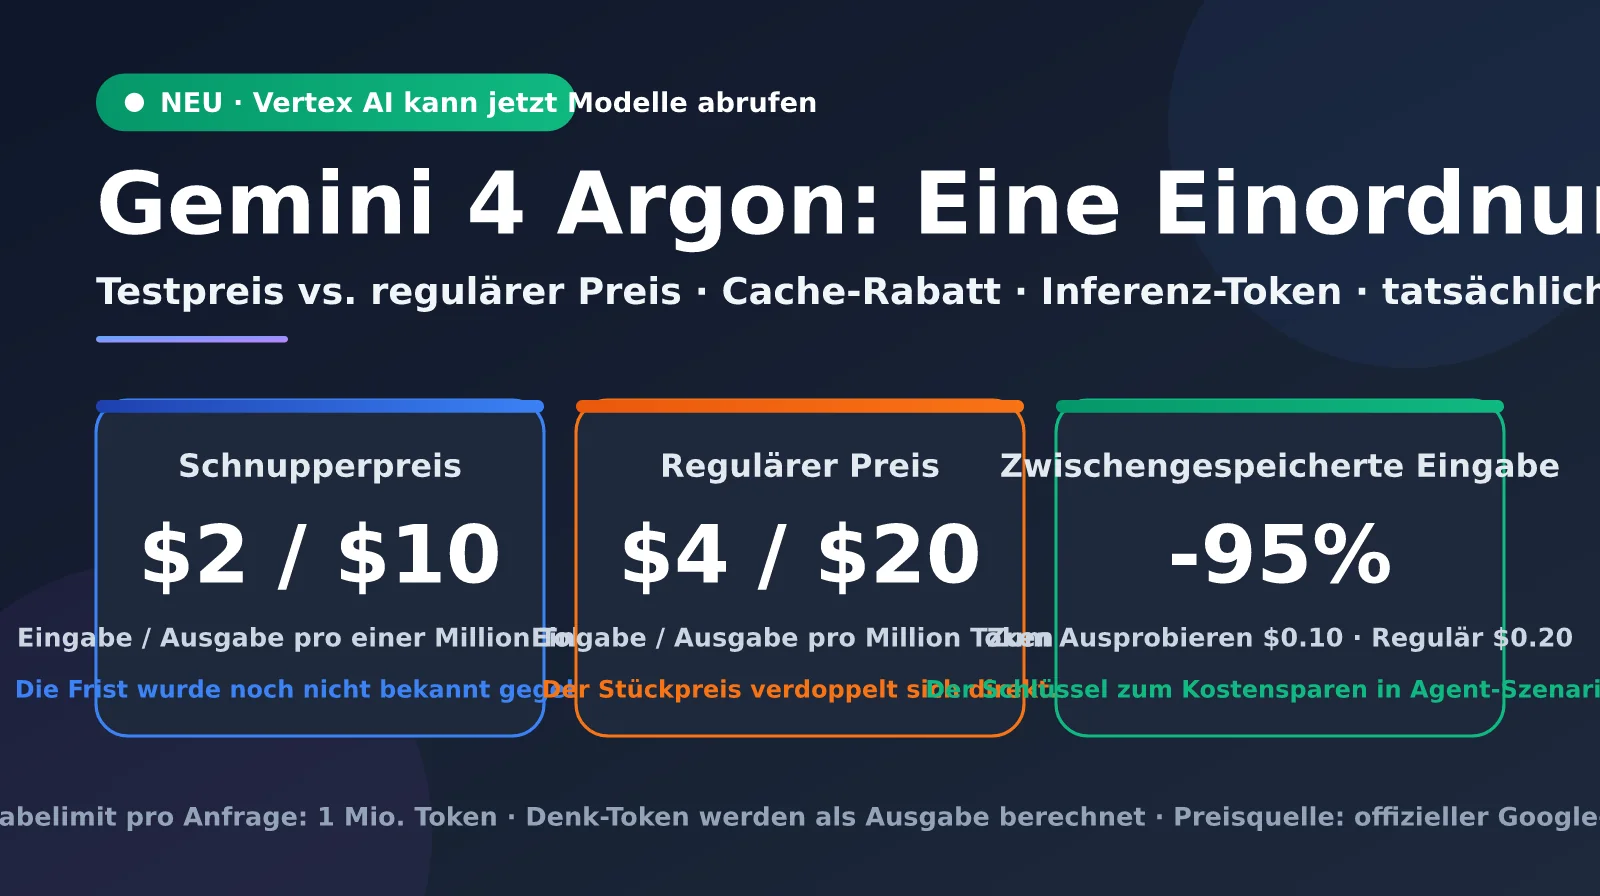
| Listenpreis Ein-/Ausgabe (kurzer Kontext) | Sol $2 / $10, Fable $8 / $40 (pro 1 Million Token) | Offizielle Listenpreise beider Anbieter; Sol liegt bei einem Viertel von Fable – gilt nur für diese beiden Posten |
| Listenpreis für Cache-Lesezugriffe | Sol $0.10, Fable $0.20 | Offizielle Listenpreise; Sol liegt bei der Hälfte von Fable, nicht bei einem Viertel |
| Direktvergleich in offiziellen Materialien | AA-3D-Elo aus menschlichen Blindbewertungen: Sol 1259, Fable 1271 | Aus offiziellen Angaben übernommen; die übrigen offiziellen Einzelwerte vergleichen meist Astra mit Fable oder Sol mit älteren eigenen Modellen |
| Verfügbarkeit bei APIYI | claude-fable-5-2 bereits gelistet; gpt-6.2-sol noch nicht gelistet |
Maßgeblich ist die Modellliste der Plattform |
Zu den Listenpreisen von GPT-6.2 Sol in der Tabelle: Die angegebenen Preise sind die offiziellen OpenAI-Preise. Das Modell ist derzeit noch nicht gelistet; wir werden es so bald wie möglich anbieten. Maßgeblich für Modellnamen und Preise ist die Modellliste der Plattform.
Warum wir den Vergleich zwischen GPT-6.2 Sol und Claude Fable 5.2 auf mehreren Ebenen betrachten
Ein Gesamtindex presst Dutzende Aufgaben in eine einzige Zahl. Damit lässt sich gut beantworten, „auf welchem Niveau sich ein Modell insgesamt bewegt“ – aber nicht, „welches Modell für meine konkrete Aufgabe besser passt“. Der Listenpreis sagt aus, was eine Million Token kosten – nicht, was eine Aufgabe am Ende kostet, denn Reasoning-Stufe, Anzahl der Denk-Token und Cache-Trefferquote verändern auf beiden Seiten die tatsächliche Abrechnung.
Einzelne Aufgaben bilden wiederum eine dritte Ebene. In OpenAIs Veröffentlichung werden die Einzelergebnisse von Fable meist gegen GPT-6.2 Astra gemessen – nicht gegen Sol. Astras Ergebnisse kurzerhand Sol zuzuschreiben, ist der häufigste Fehlschluss bei dieser Art von Vergleich; in diesem Artikel trennen wir beide Modelle gezielt auseinander.
GPT-6.2 Sol im Vergleich mit Claude Fable 5.2: Die zentralen Unterschiede
Die unabhängige Gesamtwertung von GPT-6.2 Sol und Claude Fable 5.2
Artificial Analysis ist ein unabhängiges Bewertungsunternehmen — die folgenden Zahlen stammen also nicht aus Eigenangaben von OpenAI oder Anthropic. Im Intelligence Index v5.0.1 vergibt es für jedes Modell je nach Reasoning-Stufe eine eigene Punktzahl; wer vergleicht, sollte deshalb immer klar angeben, welche Stufe gemeint ist.
| Modell | Reasoning-Stufe | Intelligence Index v5.0.1 | Kosten pro Einzelaufgabe im Gesamtindex (jeweilige Modellseite) |
|---|---|---|---|
| Claude Fable 5.2 | Höchste Reasoning-Stufe | 65 (Platz 1 der Rangliste) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | Höchste Stufe | 60 | — |
| Claude Opus 5.5 | Höchste Stufe | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
Laut Artificial Analysis liegt Sol damit 2 Punkte über GPT-6.1 Sol und erreicht 57 Punkte — auf Augenhöhe mit GPT-6 Astra, bei nur etwa 15 % von dessen Kosten pro Einzelaufgabe. Die „Kosten pro Einzelaufgabe“ in der Tabelle sind die Ausgaben, die beim unabhängigen Durchlauf dieses Index anfallen; sie fassen Reasoning-Stufe, Denklänge und Listenpreis zusammen und sind nicht mit dem API-Listenpreis identisch.
Zu beachten ist: OpenAI gibt offiziell an, dass Astra beim Agents‘ Last Exam nur etwa 5 % der Kosten von Fable verursacht — dabei handelt es sich jedoch um eine andere Aufgabensammlung. Man kann $26.54 also nicht mit den offiziellen „5 %“ gegeneinander umrechnen, und auf Sol lässt sich diese Relation erst recht nicht übertragen.
Offizielle Preise und Caching von GPT-6.2 Sol und Claude Fable 5.2
Beginnen wir mit GPT-6.2 Sol. Auf der OpenAI-Modellseite sind die Preise der Standardstufe für kurze Kontexte wie folgt angegeben: Eingabe $2, Cache-Lesen $0.10, Cache-Schreiben (30 Minuten Aufbewahrung) $2.50, 12-Stunden-Cache-Schreiben $5, Ausgabe $10. Das Modell ist bei uns noch nicht gelistet, wir werden es aber so bald wie möglich anbieten; Modellname und Preise richten sich nach der Modellliste der Plattform. In der Release-Ankündigung heißt es, dass Sol die API-Token-Preise von GPT-6.1 Sol beibehält.
In der Anthropic-Dokumentation sind für Claude Fable 5.2 folgende Preise angegeben: Eingabe $8, Ausgabe $40, 5-Minuten-Cache-Schreiben $10, 1-Stunden-Cache-Schreiben $16, Cache-Lesen $0.20. In der Gesamtmodellliste von APIYI (apiyi.com) sind für claude-fable-5-2 und claude-fable-5-2-thinking Eingabe, Ausgabe und Cache-Lesen mit $8 / $40 / $0.2 gelistet – identisch mit den offiziellen Angaben; die Beschreibungsseiten der beiden Modelle liefern derzeit einen 404-Fehler, maßgeblich sind die Preise der Gesamtliste.
| Preisposition (pro 1 Million Token) | GPT-6.2 Sol (OpenAI offiziell) | Claude Fable 5.2 (Anthropic offiziell) | Verhältnis |
|---|---|---|---|
| Eingabe (kurzer Kontext) | $2 | $8 | ein Viertel |
| Ausgabe (kurzer Kontext) | $10 | $40 | ein Viertel |
| Cache-Lesen | $0.10 | $0.20 | die Hälfte |
| Cache-Schreiben | 30 Minuten $2.50; 12 Stunden $5 | 5 Minuten $10; 1 Stunde $16 | unterschiedliche Aufbewahrungsdauern, nicht direkt vergleichbar |
| Batch | 50 % des Standardpreises | Eingabe und Ausgabe zum halben Preis | ähnliche Regeln |
| Beschleunigungsstufe | Fast: das Doppelte des Standardpreises; Ultrafast: bis 2027-02-28 das Dreifache, ab 2027-03-01 das Sechsfache | Fast mode: Eingabe $16, Ausgabe $80, bis zu rund 2,5-fache Geschwindigkeit | unterschiedliche Mechanismen |
Die GPT-6.2-Sol-Werte in der Tabelle entsprechen den offiziellen OpenAI-Preisen. Das Modell ist bei uns noch nicht gelistet, wir werden es aber so bald wie möglich anbieten; Modellname und Preise richten sich nach der Modellliste der Plattform.
„Sol ist ein Viertel von Fable“ – das stimmt nur für die Eingabe und Ausgabe bei kurzen Kontexten. Auf der OpenAI-Modellseite gibt es zudem eine weitere Regel: Überschreitet die Eingabe einer einzelnen Anfrage 272K Token, verdoppeln sich die Einzelpreise für Eingabe und Cache, und die Ausgabe wird mit dem 1,5-Fachen des Kurzkontext-Preises berechnet – gerechnet auf die gesamte Anfrage. In diesem Fall liegt der Ausgabepreis von Sol nicht mehr bei $10, und eine Schätzung mit dem Faktor „ein Viertel“ geht daneben; wie Fable bei langen Kontexten abrechnet, entnehmen Sie bitte der Anthropic-Dokumentation.
Spezifikationen und Schnittstellen von GPT-6.2 Sol und Claude Fable 5.2
Beide Modelle bieten ein Kontextfenster im Millionenbereich, und die maximale Ausgabe liegt jeweils bei 128K. Die Unterschiede stecken in den Eingabemodalitäten, den Reasoning-Einstellungen und den Schnittstellen – und genau diese Punkte beeinflussen, wie Sie die Modelle in Ihre Projekte integrieren.
| Merkmal | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| Kontextfenster / maximale Ausgabe | 1,050,000 (maximale Eingabe 922,000) / 128,000 | 1M / 128K |
| Eingabe / Ausgabe | Text, Bilder / Text | gemäß Anthropic-Dokumentation |
| Wissensstand | 2026-06-01 | 2026-06 |
| Reasoning-Einstellungen | Die API lässt reasoning effort nicht auf none setzen | Standardwert für effort ist high; das Thinking ist aktiviert und lässt sich nicht deaktivieren |
| Offizielle Endpunkte | Chat Completions, Responses, Batch | Anthropic API |
| APIYI | noch nicht gelistet | claude-fable-5-2, claude-fable-5-2-thinking, Endpunkte chat und messages |
Beim Aufruf des bereits gelisteten Fable über APIYI lautet die Base URL im OpenAI-kompatiblen Modus https://api.apiyi.com/v1, und als Modellname trägt man claude-fable-5-2 ein. Setzt Ihr Projekt ohnehin auf das Anthropic-Messages-Protokoll, können Sie alternativ den messages-Endpunkt der Plattform nutzen. Bei den Gruppen verzeichnet die Gesamtübersicht ClaudeCode, Claude_Reverse, Claude_Enterprise, Default und SVIP.
GPT-6.2 Sol und Claude Fable 5.2: Einzelaufgaben getrennt betrachtet
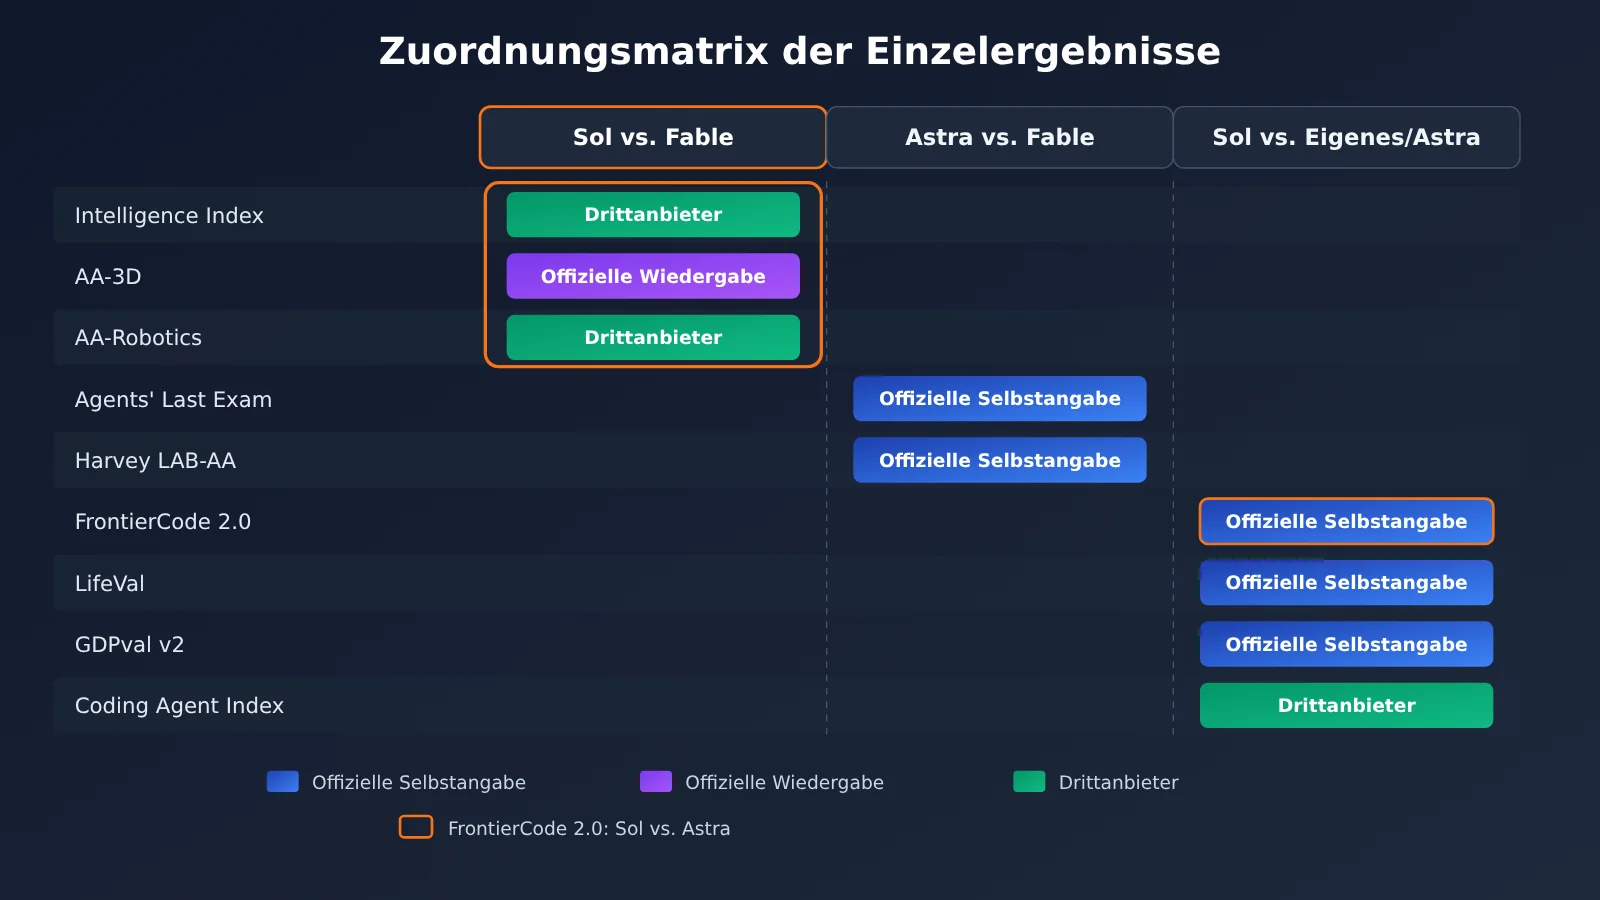
Dieser Abschnitt ist der wichtigste im gesamten Artikel. Im offiziellen OpenAI-Beitrag finden sich durchaus einige Einzelergebnisse, direkte Vergleiche zwischen „Sol und Fable“ sind darunter aber selten. Die folgende Tabelle schlüsselt alles einzeln auf – nach Quelle und nach den jeweils verglichenen Modellen.
| Einzeldisziplin | Quelle | Verglichene Modelle und Ergebnis | Direktvergleich Sol vs. Fable? |
|---|---|---|---|
| Intelligence Index v5.0.1 | Drittanbieter AA, höchste Reasoning-Stufe | Fable 65, Sol (Max) 57 | Ja (externer Gesamtscore) |
| AA-3D, Elo aus Blindbewertung durch Menschen | Offizielle Wiedergabe | Sol 1259, Fable 1271 | Ja (einzige Angabe in den offiziellen Materialien) |
| AA-Robotics v0.1 | Drittanbieter AA, Research Preview | Sol 78, Fable 75 | Ja (Drittanbieter-Preview, Reasoning-Stufe laut AA-Seite) |
| Agents‘ Last Exam | Offizielle Selbstangabe | Astra liegt 5,5 Punkte über Fable, Kosten ca. 5 % | Nein, Astra vs. Fable |
| Harvey LAB-AA v1.1 | Offizielle Selbstangabe | Bestehensquote von Astra mehr als doppelt so hoch wie bei Fable, Kosten ca. ein Sechstel | Nein, Astra vs. Fable |
| FrontierCode 2.0 | Offizielle Selbstangabe | Sol und Astra liegen weniger als 0,5 Punkte auseinander, Kosten ca. ein Fünftel, beide auf Stufe Max | Nein, Sol vs. Astra |
| LifeVal | Offizielle Selbstangabe | Sol über GPT-6 Astra, Kosten ca. ein Siebtel | Nein |
| GDPval v2 | Offizielle Selbstangabe | Sol liegt 5,3 Punkte über GPT-6.1 Sol | Nein |
| Coding Agent Index | Drittanbieter AA, Max-Stufe | Sol liegt 3 Punkte unter GPT-6.1 Sol | Nein |
GPT-6.2 Sols FrontierCode-2.0-Ergebnis lässt sich nicht auf Fable übertragen
FrontierCode 2.0 wurde von Cognition entworfen und untersucht, ob Änderungen an echten Codebasen von den Maintainern gemergt werden. Laut offiziellen Selbstangaben liegen Sol und Astra weniger als 0,5 Punkte auseinander – bei etwa einem Fünftel der Kosten von Astra; beide treten in der Stufe Max an. Fable ist hier nicht im Spiel, man darf daraus also nicht machen: „Sol und Fable liegen bei FrontierCode weniger als 0,5 Punkte auseinander“.
Ebenso ist es bei Agents‘ Last Exam und Harvey LAB-AA Astra, das vor Fable liegt. Wie Sol in diesen beiden Disziplinen im Vergleich zu Fable abschneidet, gibt der Release-Text nicht an – das darf man nicht folgern.
GPT-6.2 Sol und Claude Fable 5.2 bei Wissenschaft und Code
Auch bei Terminal-Bench-Science 0.1 ist Vorsicht geboten. Offiziell wird angegeben, dass Astra 9 Prozentpunkte über GPT-6 Astra liegt; in den Fußnoten tauchen für Fable 5.2 zwei Zahlen auf: Eine stammt aus dem Test von Artificial Analysis mit mini-swe-agent, die andere ist der von Anthropic gemeldete Wert von 74,6 % mit Claude Code bei Reasoning-Intensität Max. Diese beiden Fable-Zahlen entstammen unterschiedlichen Tests und dürfen nicht als ein und derselbe Vergleich gelesen werden – und keine von beiden ist Sols Ergebnis.
Zu den Drittanbieter-Daten: Artificial Analysis führt an, dass Sol im Coding Agent Index (Codex harness, max) 3 Punkte niedriger liegt als GPT-6.1 Sol – hauptsächlich, weil SWE-Atlas-QnA-AA um 14 Punkte niedriger ausfällt und Schlüsselfakten Sol dadurch leichter entgehen. Die von Artificial Analysis gemessene AA-Omniscience-Halluzinationsrate (Max) liegt für Sol bei 55 %. Für diese Zahlen gibt es keine Fable-Gegenwerte; sie taugen nur dazu, Sols eigene Schwachstellen besser zu verstehen.
Einsatzempfehlungen für GPT-6.2 Sol und Claude Fable 5.2
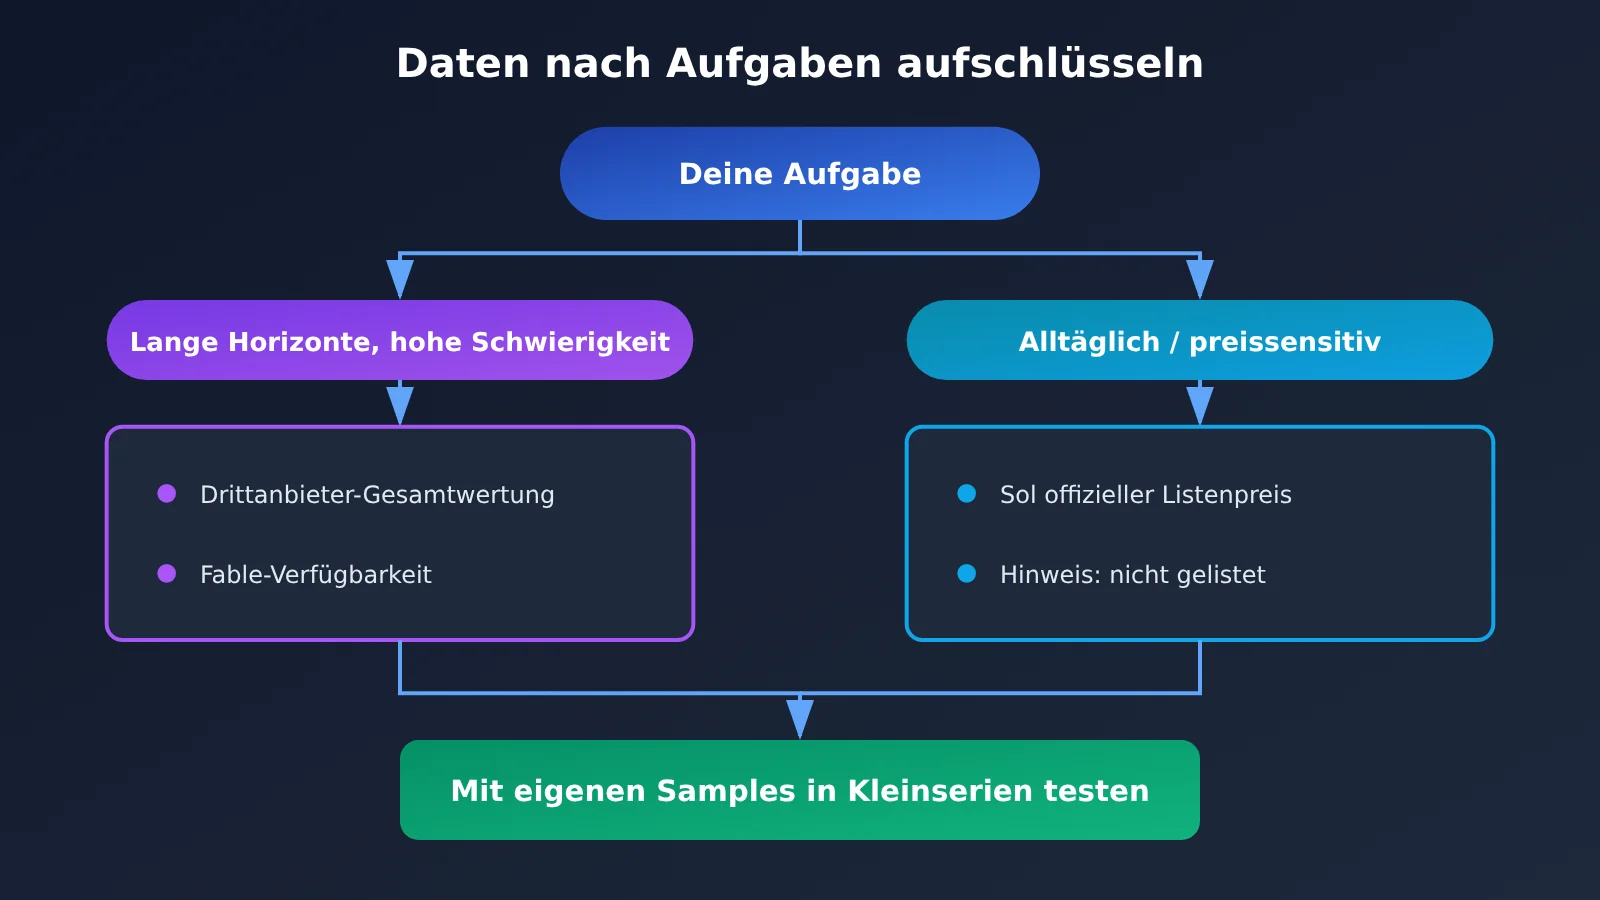
Dieser Abschnitt entscheidet nicht für dich, welches Modell du nehmen sollst – er zeigt nur, welche Daten du bei welcher Art von Aufgabe zuerst prüfen solltest.
Aufgaben, bei denen du zuerst die Daten von Claude Fable 5.2 prüfen solltest
- Lange, anspruchsvolle, mehrstufige Aufgaben: Wirf zuerst einen Blick auf die unabhängigen Gesamtwertungen. Fable erreicht im Intelligence Index v5.0.1 in der höchsten Reasoning-Stufe 65 Punkte und liegt damit an der Spitze – das ist derzeit die einzige Gesamtwertung, die sich direkt mit Sol vergleichen lässt.
- Projekte, die sofort angebunden werden müssen:
claude-fable-5-2ist bei APIYI bereits verfügbar, du kannst also sofort mit eigenen Samples testen. - Projekte, bei denen du den Thinking-Overhead einkalkulieren musst: Fables Thinking ist standardmäßig aktiviert und lässt sich nicht abschalten; der Standardwert für effort ist high. Rechne die Thinking-Tokens daher bei der Budgetplanung mit ein.
Aufgaben, bei denen du zuerst die Daten von GPT-6.2 Sol prüfen solltest
- Alltagsaufgaben und preissensible Batch-Aufgaben: Sieh dir zuerst die offiziellen Listenpreise für kurze Kontexte und die Batch-Regeln an, danach die Ergebnisse bei Alltagsaufgaben wie LifeVal oder GDPval v2 – offizielle Eigenangaben.
- Anfragen, die überwiegend innerhalb von 272K bleiben: Die Preisdifferenz von einem Viertel zwischen Sol-Input und -Output zeigt sich vor allem in diesem Bereich.
- Teams, die bereits ChatGPT Work oder Codex nutzen: Laut offiziellen Angaben sind Plus, Pro, Enterprise und Edu ab sofort verfügbar; Pro 200 erhält erstmals Ultrafast, das ab Sol angeboten wird.
Schnellstart mit GPT-6.2 Sol und Claude Fable 5.2
Dieser Abschnitt ordnet die Schritte nach Aufgabentyp. Im gesamten Text finden Sie keinen Code – Modellnamen und Adressen stehen direkt in den Sätzen.
Lange, besonders anspruchsvolle Aufgaben: Schauen Sie zuerst auf Fables Gesamtwertung und Verfügbarkeit. Erstellen Sie in der APIYI-Konsole einen API-Schlüssel, ändern Sie die Base-URL Ihres OpenAI-kompatiblen SDKs auf https://api.apiyi.com/v1 und tragen Sie als model claude-fable-5-2 ein; wenn der Modellname ausdrücklich das Thinking kennzeichnen soll, geht auch claude-fable-5-2-thinking. Die Übersichtstabelle nennt $8 für Eingabe, $40 für Ausgabe und $0.2 für Cache-Lesen – deckungsgleich mit den offiziellen Preisen von Anthropic. Am besten ermitteln Sie zunächst mit 20 bis 50 eigenen, echten Aufgaben Abschlussrate und Token-Verbrauch, bevor Sie bewerten, ob sich die 65 Punkte in Ihrem Szenario wirklich bemerkbar machen.
Alltägliche, preisempfindliche Aufgaben: Werfen Sie danach einen Blick auf Sols offizielle Preise und den Hinweis zur Nichtverfügbarkeit. Die offiziellen OpenAI-Preise für GPT-6.2 Sol liegen bei $2 für Eingabe, $0.10 für Cache-Lesen und $10 für Ausgabe. Das Modell ist noch nicht gelistet – wir nehmen es so schnell wie möglich ins Angebot auf; für Modellname und Preis gilt die Modellliste der Plattform. Prüfen Sie bis zur Listung regelmäßig die Modellliste auf apiyi.com und ersetzen Sie Ihre Tests nicht durch gpt-6.1-sol oder gpt-6-sol von der Plattform: Das sind keine 6.2-Modelle, und bei gpt-6-sol unterscheidet sich auch der Cache-Lese-Preis.
Nach der Listung von Sol sind drei Punkte zu beachten: Der reasoning-effort-Parameter darf nicht auf none gesetzt werden; bei Eingaben über 272K wird auf den gesamten Auftrag ein Aufpreis erhoben; der offizielle Endpunkt unterstützt Chat Completions und Responses, und welcher Endpunkt auf der Plattform gilt, richtet sich nach der Modellliste.
🚀 Schnellstart: Mit demselben API-Schlüssel können Sie Modelle mehrerer Anbieter auf der Plattform aufrufen. Am besten bringen Sie Fable zuerst mit dem kostenlosen Testguthaben auf APIYI (apiyi.com) zum Laufen und bereiten Evaluierungsskripte und Testdaten vor – sobald Sol gelistet ist, tauschen Sie einfach den Modellnamen aus und führen denselben Vergleich mit denselben Testdaten durch.
GPT-6.2 Sol und Claude Fable 5.2: Entscheidungshilfe
Die folgende Checkliste hilft dir, die Zahlen in den Kontext deiner eigenen Aufgaben einzuordnen.
- Zuerst die Bezugsbasis klären: Wird ein Gesamtwert von Drittanbietern, ein offiziell selbst gemeldeter Einzelwert oder der offizielle Listenpreis zitiert? Diese drei Werte nicht addieren und nicht ineinander umrechnen.
- Die Reasoning-Stufe prüfen: Sols 57 Punkte beziehen sich auf die Max-Stufe; die High-Stufe erreicht 55, die Low-Stufe nur 41. Maßgeblich ist die Stufe, die du tatsächlich nutzt – und deren Punktzahl.
- Nach der Anfragelänge kalkulieren: Innerhalb von 272K lassen sich Eingabe und Ausgabe jeweils mit einem Viertel abschätzen; jenseits von 272K muss nach OpenAIs Regel zur Gesamtabrechnung neu gerechnet werden.
- Cache separat berechnen: Cache-Reads kosten $0.10 gegenüber $0.20 – ein Unterschied um den Faktor zwei; bei Cache-Writes unterscheiden sich die Aufbewahrungsdauern, daher beide entsprechend der eigenen Cache-Strategie getrennt abschätzen.
- Existenz direkter Gegenüberstellungen prüfen: Liegen für den Einzelwert, der dich interessiert, nur Daten für Astra gegen Fable oder Sol gegen Astra vor, darfst du sie nicht als Aussage über Sol gegen Fable werten.
- Sicherheitsrichtlinien einbeziehen: Laut offiziellen Angaben erreichen beide 6.2-Modelle im Preparedness-Framework die Stufe „kritisch“ für Cybersicherheit; die Schutzmechanismen sind strenger, sodass ein Teil legitimer Anfragen zur Schwachstellenforschung abgelehnt wird.
💡 Auswahlempfehlung: Welches Modell infrage kommt, hängt von Aufgabenlänge, Reasoning-Stufe und Cache-Trefferquote ab. Du kannst dieselben Beispieldaten auf der APIYI-Plattform jeweils separat aufrufen und die Rechnung sowie die Abschlussquote sprechen lassen – ganz ohne Abhängigkeit von einer einzigen Rangliste.
Häufige Fragen (FAQ)
Q1: Was sind GPT-6.2 Sol und Claude Fable 5.2?
GPT-6.2 Sol ist ein Modell, das OpenAI am 17. November 2026 gemeinsam mit GPT-6.2 Astra veröffentlicht hat. Die Modell-ID lautet `gpt-6.2-sol`, es nimmt Text und Bilder als Eingabe entgegen und gibt Text aus – bei einem Kontextfenster von 1.050.000. Claude Fable 5.2 ist ein Modell, das Anthropic am 9. November 2026 veröffentlicht hat, mit einem Kontextfenster von 1M und einer maximalen Ausgabe von 128K. Das Thinking ist standardmäßig aktiviert und lässt sich nicht deaktivieren.
Q2: Bedeutet 65 gegen 57 in der Gesamtwertung, dass Claude Fable 5.2 GPT-6.2 Sol in allen Punkten überlegen ist?
Nein. 65 gegen 57 ist das Ergebnis des unabhängigen Artificial Analysis Intelligence Index v5.0.1, wobei Fable mit der höchsten Reasoning-Stufe und Sol mit der Max-Stufe gemessen wurde. Dieser Wert spiegelt das Gesamtniveau des Index wider und bedeutet nicht, dass jede Einzelkategorie denselben Abstand aufweist. Bei den offiziell zitierten Elo-Werten der AA-3D-Blindbewertung durch Menschen liegt Sol bei 1259 und Fable bei 1271 – der Abstand fällt deutlich geringer aus; in der unabhängigen Research Preview AA-Robotics v0.1 liegt Sol bei 78 und Fable bei 75.
Q3: Ist GPT-6.2 Sol wirklich nur ein Viertel so teuer wie Claude Fable 5.2?
Das gilt nur für Eingabe und Ausgabe bei kurzen Kontexten. Nach der offiziellen Preisliste kostet Sol $2 für die Eingabe und $10 für die Ausgabe, Fable $8 bzw. $40. Das Modell ist derzeit noch nicht gelistet – wir werden es so bald wie möglich anbieten; Modellname und Preis richten sich nach der Modellliste der Plattform. Das Lesen aus dem Cache kostet $0.10 gegenüber $0.20, also die Hälfte. Bei Eingaben von mehr als 272K Tokens erhebt Sol jedoch einen Aufschlag auf die gesamte Anfrage, und der Ausgabepreis steigt auf das 1,5-Fache des Kurzkontextpreises – eine Schätzung mit einem Viertel greift dann nicht mehr.
Q4: Wie groß ist der Unterschied zwischen GPT-6.2 Sol und Claude Fable 5.2 in FrontierCode 2.0?
In den offiziellen Unterlagen gibt es diesen Direktvergleich nicht. Die Aussage „weniger als 0,5 Punkte Unterschied“ in FrontierCode 2.0 bezieht sich auf den Vergleich zwischen GPT-6.2 Sol und GPT-6.2 Astra – beide mit der Max-Stufe, wobei die Kosten von Sol etwa ein Fünftel betragen. Fable war an diesem Vergleich nicht beteiligt.
Q5: Wie ruft man GPT-6.2 Sol und Claude Fable 5.2 über die API auf?
So gehen Sie vor:
1. Registrieren Sie sich auf APIYI apiyi.com und holen Sie sich einen API-Schlüssel sowie kostenloses Testguthaben.
2. Setzen Sie die Base URL Ihres OpenAI-kompatiblen SDKs auf die Adresse der Plattform und geben Sie bei `model` den Wert `claude-fable-5-2` ein – schon können Sie Fable aufrufen.
3. `gpt-6.2-sol` ist derzeit noch nicht gelistet. Sobald es verfügbar ist, gelten Modellname und Preis gemäß der Modellliste der Plattform – testen Sie dann mit denselben Beispieldaten.
Q6: Welche bekannten Einschränkungen haben GPT-6.2 Sol und Claude Fable 5.2?
Bei Sol: Laut unabhängigen AA-Messungen beträgt die Halluzinationsrate auf der Max-Stufe 55 %, und im Coding Agent Index liegt das Modell 3 Punkte unter GPT-6.1 Sol – vor allem, weil wichtige Fakten leichter übersehen werden. Der Parameter reasoning effort lässt sich nicht auf none setzen. Die Schutzmechanismen im Bereich Cybersicherheit sind strenger, sodass ein Teil legitimer Schwachstellenforschung abgelehnt wird. Bei Fable: Das Thinking lässt sich nicht deaktivieren, effort steht standardmäßig auf high, und die Thinking-Tokens werden kostenpflichtig verrechnet. Im Fast mode liegen die Einzelpreise bei $16 für die Eingabe und $80 für die Ausgabe.
Q7: Der offiziellen Angabe zufolge kostet Astra nur 5 % von Fable – lässt sich das mit den $26.54 eines Drittanbieters rechnerisch vergleichen?
Nein. Die „rund 5 %“ sind die von den Entwicklern selbst gemeldeten Kosten für Agents‘ Last Exam, verglichen wurde dabei Astra mit Fable; die $26.54 hingegen sind Fables Kosten pro Einzelaufgabe, wenn Artificial Analysis seinen Gesamtindex berechnet. Beide Werte stammen aus unterschiedlichen Aufgaben und Quellen – man kann sie weder durcheinander teilen noch daraus die Kosten von Sol ableiten. Wer nur die grobe Größenordnung wissen möchte, fährt damit besser, auf der APIYI-Plattform mit eigenen Stichproben die tatsächlichen Abrechnungsbeträge zu erfassen – das liefert verlässlichere Werte.
GPT-6.2 Sol und Claude Fable 5.2: Die wichtigsten Punkte (Key Takeaways)
- Gesamtwertung: Im AA-Index eines Drittanbieters erreicht Fable in der höchsten Reasoning-Stufe 65 Punkte, Sol in der Max-Stufe 57 – ein direkter Vergleich aus derselben Rangliste.
- Listenpreise: Bei kurzen Kontexten kosten Eingabe und Ausgabe bei Sol ein Viertel von Fable ($2 gegenüber $8, $10 gegenüber $40).
- Cache-Lesezugriffe: $0.10 gegenüber $0.20 – nur halb so teuer, das Viertel-Verhältnis lässt sich hier also nicht übertragen.
- Lange Kontexte: Überschreitet die Eingabe bei Sol 272K, wird der gesamte Auftrag mit Aufpreis abgerechnet – das bisherige Preisverhältnis gilt dann nicht mehr.
- Wenige direkte Gegenüberstellungen: Im offiziellen Material gibt es für Sol vs. Fable nur den AA-3D-Wert: 1259 gegenüber 1271.
- Ergebnisse nicht übertragen: FrontierCode 2.0 vergleicht Sol mit Astra, während ALE und Harvey Astra mit Fable vergleichen.
- Verfügbarkeit: Fable ist über APIYI (apiyi.com) für den direkten Modellaufruf verfügbar, Sol ist dort noch nicht gelistet – maßgeblich ist die Modellliste.
Zusammenfassung
Vergleicht man GPT-6.2 Sol mit Claude Fable 5.2, kommt es entscheidend darauf an, die drei Zahlenebenen getrennt zu betrachten:
- Gesamtscore von Drittanbietern: Fable 65, Sol (Max) 57 – er dient dazu, die insgesamt erreichte Leistungsklasse einzuordnen.
- Offizielle Listenpreise: Bei kurzen Kontextfenstern liegen Ein- und Ausgabepreis um ein Viertel auseinander, der Cache-Lesepreis um die Hälfte; lange Kontexte werden nach den jeweils eigenen Regeln separat abgerechnet.
- Einzelaufgaben: Die meisten offiziellen Einzelergebnisse sind kein direkter Vergleich zwischen Sol und Fable – vor dem Zitieren sollte man genau prüfen, welche beiden Modelle eigentlich verglichen werden.
Der Punktabstand und der Preisabstand lassen sich nicht zu einem einzigen Satz vom Typ „wer lohnt sich mehr“ zusammenfassen. Verlässlicher ist es, mit eigenen Testfällen und einer festen Reasoning-Stufe jeweils Erfolgsquote und Abrechnung separat zu dokumentieren. Fable lässt sich bereits jetzt auf APIYI unter apiyi.com testen; GPT-6.2 Sol ist noch nicht gelistet – wir werden dieses Modell schnellstmöglich anbieten. Maßgeblich sind Modellname und Preis laut der Modellliste der Plattform.
📚 Referenzen
-
OpenAI-Release-Ankündigung: Release Notes zu GPT-6.2 Astra und Sol sowie offiziell selbst gemeldete Einzelergebnisse
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Hinweis: offiziell selbst gemeldete Einzelergebnisse, Verfügbarkeitsumfang und Überblick über die Listenpreise
- Link:
-
OpenAI-Modellseite – GPT-6.2 Sol: Spezifikationen, Listenpreise und 272K-Abrechnungsregeln
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Hinweis: maßgeblich für Cache-Schreibpreise, Aufpreise bei langen Kontexten und die Multiplikatoren der beschleunigten Stufe
- Link:
-
OpenAI-Systemkarte: Sicherheitsbewertung von GPT-6.2 Astra und Sol
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Hinweis: Einstufung nach dem Preparedness Framework und Alignment-Bewertungen
- Link:
-
Artificial Analysis – Artikel und Modellseite: Intelligence Index v5.0.1 von Drittanbietern
- Link:
artificialanalysis.ai/models/claude-fable-5-2 - Hinweis: Gesamtscores nach Stufen, Kosten pro Einzelaufgabe und Coding Agent Index
- Link:
-
Anthropic-Dokumentation – Claude Fable 5.2: Offizielle Listenpreise und Spezifikationen
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Cache-Schreiben, Cache-Lesen, Fast Mode und Effort-Einstellungen
- Link:
-
APIYI-Modellübersicht: Modelle und Preise im Angebot der Plattform
- Link:
docs.apiyi.com/models.md - Hinweis: Datenstand 2026-11-17 15:54 (UTC+8); maßgeblich sind Modellname und Preis laut der Modellliste der Plattform
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Modelle und Schnittstellenbeschreibungen finden Sie im Dokumentationszentrum unter docs.apiyi.com