“o gpt-4o-mini está prestes a ser descontinuado?” é uma pergunta que tem aparecido repetidamente nas comunidades de tecnologia. O gatilho direto dessa dúvida foram os anúncios de aposentadoria de modelos publicados gradualmente pelo Azure OpenAI Service, somados à queda contínua do gpt-4o-mini nos rankings de benchmark, levando muitas equipes a reavaliar suas escolhas de modelos.
Com base na documentação oficial da OpenAI, nos anúncios de aposentadoria do Microsoft Learn e nos dados de benchmark do Artificial Analysis, este artigo primeiro esclarece a confusão em torno dos rumores de descontinuação do gpt-4o-mini. Em seguida, compara, sob as perspectivas de preço e desempenho, 5 modelos alternativos com preços semelhantes — GPT-5 mini, GPT-5 nano, Gemini 2.5 Flash-Lite, DeepSeek V4 Flash e Claude Haiku 4.5 — para ajudar você a decidir se é necessário migrar e qual modelo pode oferecer o maior ganho.
Valor principal: ao terminar este artigo, você saberá com clareza se o gpt-4o-mini está sendo “descontinuado parcialmente” ou se o assunto foi interpretado de forma exagerada. Também descobrirá qual modelo alternativo pode proporcionar uma melhoria mais significativa sem alterar muito o orçamento.
Esse tipo de confusão se espalhou principalmente porque os anúncios de aposentadoria do Azure, a remoção de modelos da versão web do ChatGPT e as afirmações genéricas da comunidade de que “a OpenAI vai descontinuar os modelos antigos” passaram a ser discutidos como se fossem a mesma coisa. Faltava uma visão clara, separada por plataforma e tipo de implantação. A seguir, vamos separar essas três linhas do tempo para evitar tanto uma migração precipitada por causa de um rumor que ainda não entrou em vigor quanto a negligência de uma data de aposentadoria realmente urgente no Azure.
Situação atual do gpt-4o-mini: apenas 7 pontos no benchmark — o rumor de descontinuação é verdadeiro?
Vamos direto ao ponto: os rumores sobre a descontinuação do gpt-4o-mini misturam informações diferentes. Azure e a API oficial da OpenAI seguem cronogramas completamente distintos. Portanto, não é correto afirmar de forma geral que “o gpt-4o-mini será descontinuado”.
Preço e desempenho atuais do gpt-4o-mini
| Métrica | Valor | Descrição |
|---|---|---|
| Preço de entrada | US$ 0,15 / 1 milhão de tokens | Preço da API oficial da OpenAI |
| Preço de entrada em cache | US$ 0,075 / 1 milhão de tokens | O preço cai pela metade quando o cache é utilizado |
| Preço de saída | US$ 0,60 / 1 milhão de tokens | Preço da API oficial da OpenAI |
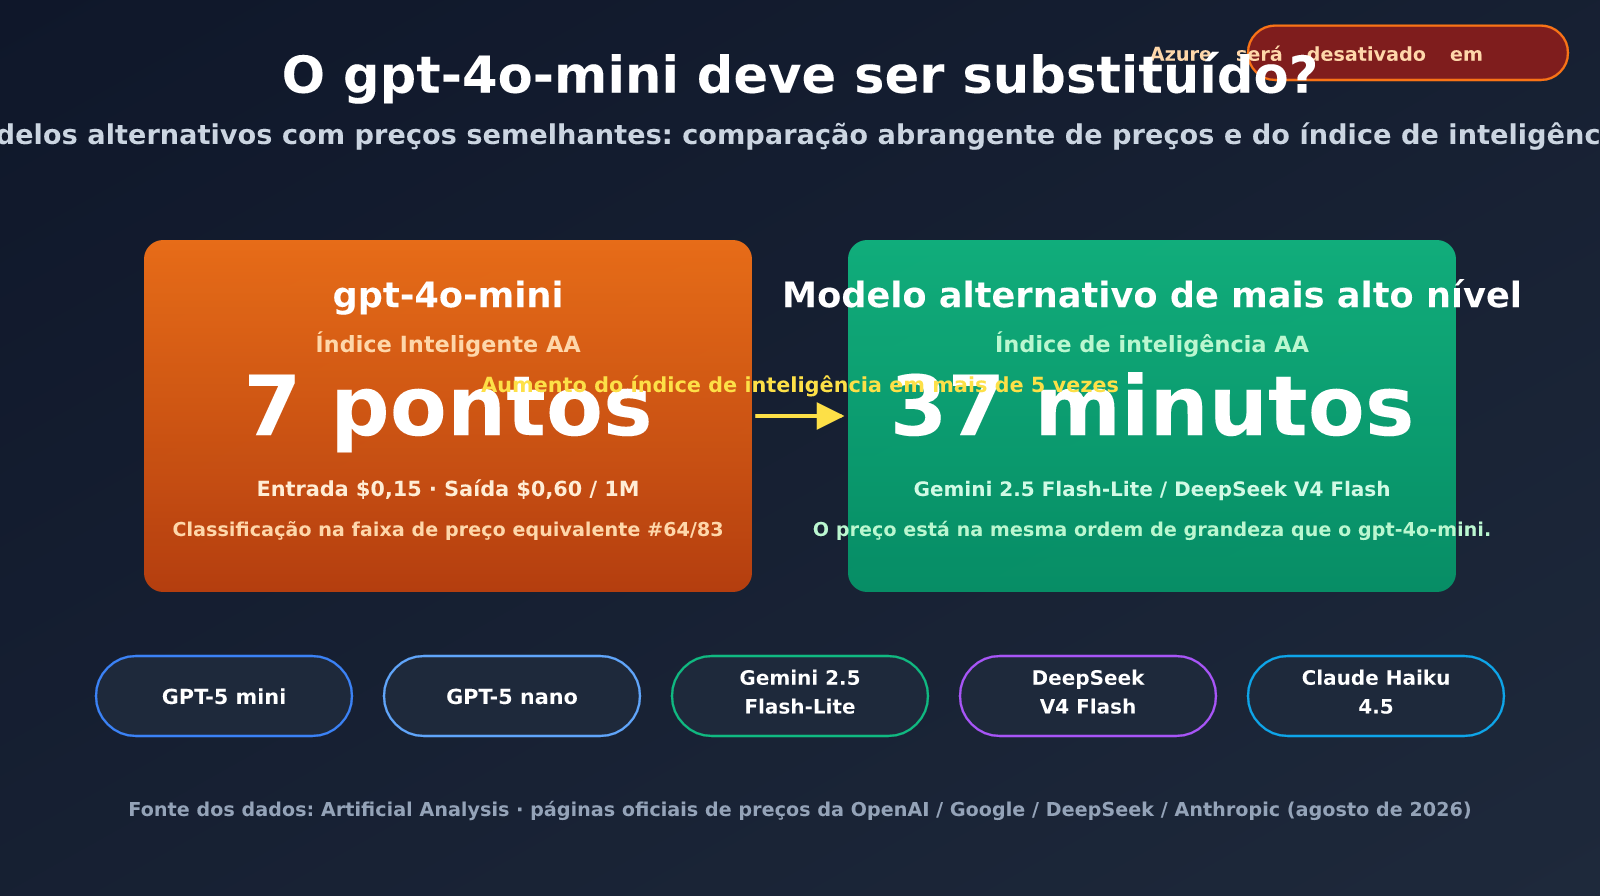
| Índice de inteligência da AA | 7 pontos | Avaliação do Artificial Analysis; posição #64/83 na faixa de preço |
| Velocidade de saída | 100,9 tokens/s | Abaixo da média de 102,1 tokens/s dos modelos similares |
O principal motivo pelo qual o gpt-4o-mini vem sendo questionado com frequência em 2026 não é uma mudança de preço, mas o fato de seu índice de inteligência no Artificial Analysis ser de apenas 7 pontos. Entre 83 modelos da mesma faixa de preço, ele ocupa a 64ª posição, ficando claramente abaixo da mediana do segmento. Em outras palavras, o gpt-4o-mini continua barato, mas “barato” já não significa necessariamente “bom custo-benefício”: hoje, o mesmo orçamento permite comprar modelos muito mais capazes.
Vale explicar melhor o valor de referência do índice de inteligência da AA. Ele é calculado pelo Artificial Analysis a partir de uma média ponderada de diversos benchmarks públicos, cobrindo dimensões como raciocínio, programação e matemática. A vantagem é que ele abrange muitos modelos e é atualizado com frequência, permitindo comparar modelos de diferentes fornecedores usando a mesma régua. A limitação é que ele representa o nível médio de capacidade geral e não substitui completamente os testes com os dados da sua própria operação. O mais seguro é usá-lo como primeiro filtro para selecionar candidatos, e não como critério final de escolha.
Cronograma de descontinuação do gpt-4o-mini: Azure e API da OpenAI são completamente diferentes
| Plataforma / tipo de implantação | Status | Data de aposentadoria |
|---|---|---|
| API oficial da OpenAI (gpt-4o-mini original) | Nenhuma data de aposentadoria definida | Ainda não definida |
| Versão ajustada da OpenAI ft-gpt-4o-mini | Plano anunciado | Treinamento até, no mínimo, 01/04/2027; implantação até 01/10/2027 |
| Implantação Standard do Azure OpenAI | Já aposentada | 31/03/2026 |
| Provisioned / Global Standard / Data Zone Standard do Azure OpenAI | Em processo de aposentadoria | 01/10/2026 |
É importante esclarecer que, em 13 de fevereiro de 2026, a OpenAI realmente removeu GPT-4o, GPT-4.1, GPT-4.1 mini e o4-mini da interface do produto ChatGPT. No entanto, essa foi uma alteração no seletor de modelos da versão web do ChatGPT. O anúncio oficial deixou claro que a API não sofreu mudanças, e o próprio gpt-4o-mini nem sequer fazia parte dessa lista de modelos removidos. O que realmente exige atenção é o cronograma do Azure: a implantação Standard do gpt-4o-mini no Azure OpenAI já foi aposentada em 31 de março de 2026, enquanto as implantações Provisioned, Global Standard e Data Zone Standard também deixarão de ser atendidas em 1º de outubro de 2026. Faltam menos de dois meses para essa data e, a partir daí, as chamadas retornarão diretamente o erro 410 Gone. Se sua operação roda no Azure, esse cronograma deve ter prioridade sobre a discussão genérica de “a OpenAI vai descontinuar o modelo?”.
Outro detalhe fácil de ignorar é que, mesmo com o mesmo nome “gpt-4o-mini”, as diferentes formas de implantação no Azure — Standard, Provisioned, Global Standard e Data Zone Standard — não têm a mesma data de aposentadoria. Equipes que utilizam mais de um tipo de implantação podem facilmente interpretar errado o cronograma geral depois de consultar o anúncio de apenas uma modalidade. Antes de investigar o assunto, confirme no portal do Azure qual tipo de implantação você está usando e compare-o individualmente com a tabela acima. Assim, você evita a diferença entre “ouvi dizer que foi descontinuado” e “por quanto tempo ele ainda estará disponível na prática”.
gpt-4o-mini vs. 5 modelos alternativos: comparação completa de preços e benchmarks
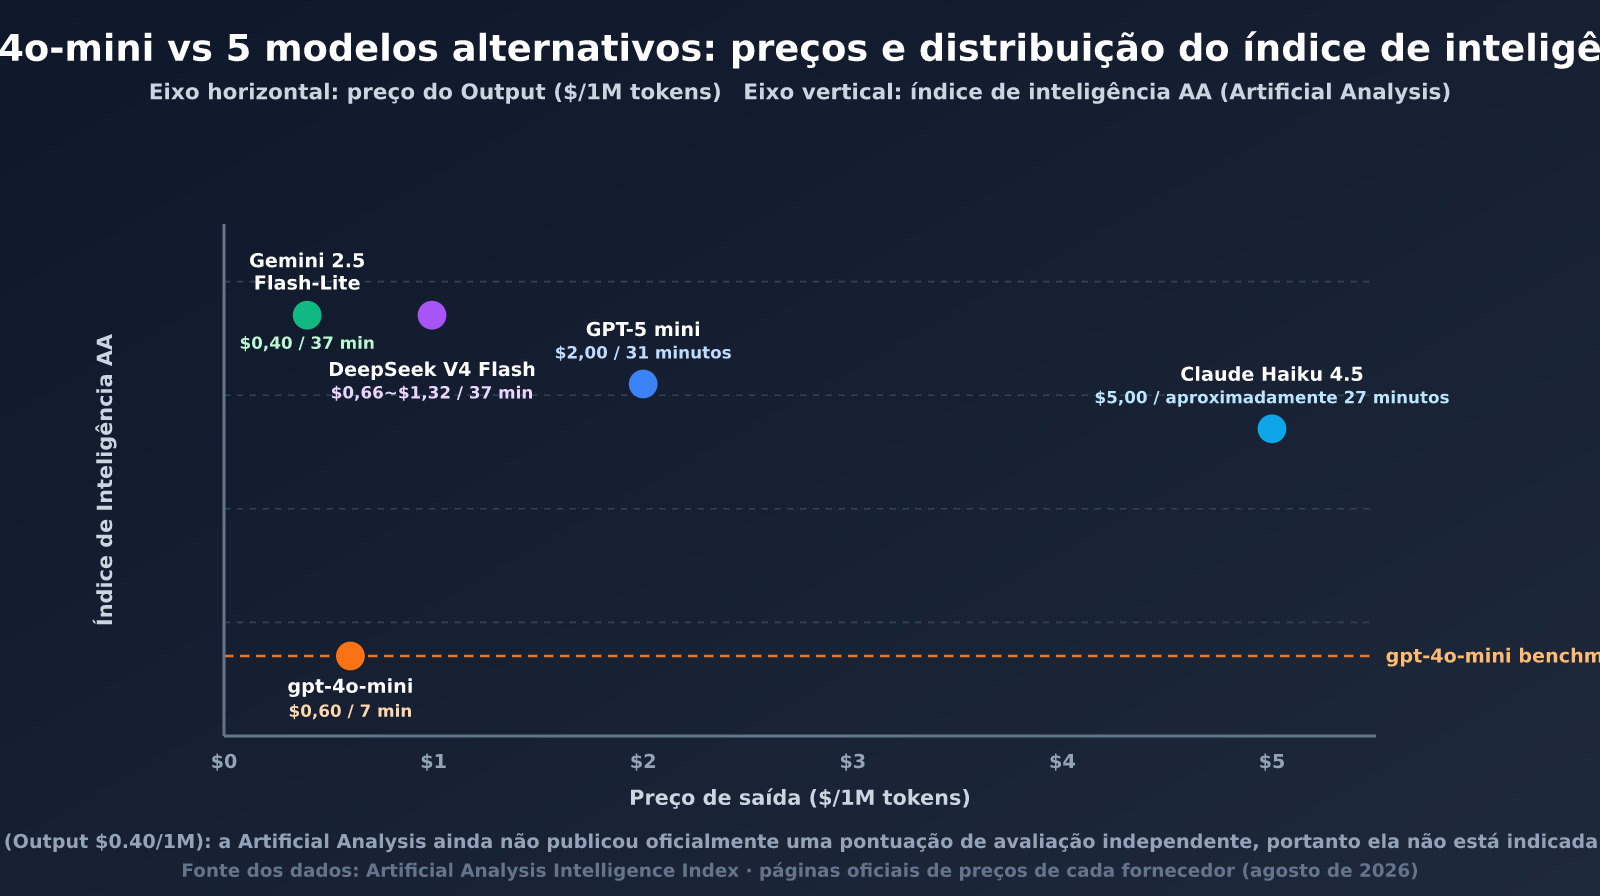
Se você está avaliando uma estratégia de migração, a tabela abaixo reúne 5 modelos com preços próximos aos do gpt-4o-mini e dados oficiais ou de fontes terceiras confiáveis. Assim, fica mais fácil filtrar rapidamente as opções conforme o orçamento e as necessidades de desempenho.
| Modelo | Input / Output (US$ / 1M) | Índice de inteligência AA | Principal vantagem |
|---|---|---|---|
| gpt-4o-mini (referência) | US$ 0,15 / US$ 0,60 | 7 pontos (#64/83) | Ecossistema maduro e boa compatibilidade |
| GPT-5 nano | US$ 0,05 / US$ 0,40 | Benchmark oficial não divulgado separadamente | Opção de menor custo da mesma família |
| GPT-5 mini | US$ 0,25 / US$ 2,00 | 31 pontos (nível de raciocínio medium) | Substituto oficial mais direto dentro do ecossistema OpenAI |
| Gemini 2.5 Flash-Lite | US$ 0,10 / US$ 0,40 | 37 pontos | Preço próximo ao do gpt-4o-mini, com aumento significativo no índice de inteligência |
| DeepSeek V4 Flash | US$ 0,22~US$ 0,44 / US$ 0,66~US$ 1,32 (preços de pico e fora de pico) | 37 pontos (alta intensidade de raciocínio) | Preços variáveis por horário; com cache, o custo mínimo pode chegar a US$ 0,007/1M |
| Claude Haiku 4.5 | US$ 1,00 / US$ 5,00 | Cerca de 24~30 pontos (conforme o nível de raciocínio) | Mais destaque para contexto longo e uso de ferramentas |
🎯 Sugestão técnica: na seleção prática, recomendamos testar individualmente esses modelos por meio da plataforma APIYI apiyi.com. A plataforma oferece uma API unificada com suporte simultâneo ao gpt-4o-mini, à série GPT-5, ao Gemini, ao DeepSeek e ao Claude, facilitando a troca rápida de modelos e a comparação de resultados dentro da mesma base de código.
Além dos 5 modelos acima, o Qwen3.5 Flash, da Alibaba Cloud, também é uma opção em uma faixa de preço próxima. Canais de comparação de preços de terceiros indicam valores em torno de US$ 0,10 / US$ 0,40. No entanto, como esses números não foram confirmados diretamente na página oficial de preços do DashScope, recomendamos consultar os valores no console oficial antes da migração definitiva, evitando divergências causadas por região ou câmbio. Da mesma forma, não encontramos um benchmark independente do GPT-5 nano divulgado oficialmente ou pela Artificial Analysis. Por isso, indicamos honestamente “não divulgado”, em vez de apresentar um número inventado.
De modo geral, o Gemini 2.5 Flash-Lite é a opção que mais merece ser testada primeiro: seu preço é apenas um pouco superior ao do gpt-4o-mini, mas o índice de inteligência AA salta de 7 para 37 pontos. Dentro dessa faixa de preço, é o modelo que apresenta o ganho mais evidente de custo-benefício. Se a prioridade for a compatibilidade com o ecossistema OpenAI, o GPT-5 mini custa mais que o dobro do gpt-4o-mini, mas também oferece um aumento expressivo de desempenho. Já em cenários extremamente sensíveis a custos, vale considerar o GPT-5 nano e os preços fora do horário de pico do DeepSeek V4 Flash.
O mecanismo de preços do DeepSeek V4 Flash merece uma explicação à parte. O modelo adota duas faixas: fora do horário de pico, o Input/Output custa apenas US$ 0,22/US$ 0,66; nos horários de pico, o valor sobe para US$ 0,44/US$ 1,32. Quando há acerto de cache, o custo pode cair ainda mais, chegando a US$ 0,007~US$ 0,014 por milhão de tokens. Para tarefas offline que podem ser executadas fora do pico, como resumos em lote durante a noite e análise de logs, esse modelo de preços costuma ser mais vantajoso do que modelos com tarifa fixa. Porém, se o sistema processa solicitações em tempo real durante o pico do dia, é necessário recalcular o custo usando a tarifa de pico. O Claude Haiku 4.5 segue uma abordagem diferente: seu preço unitário é significativamente maior que o do gpt-4o-mini, mas oferece maior estabilidade com janelas de contexto longas e recursos mais fortes de uso de ferramentas. Ele é mais adequado para processar documentos extensos e orquestrar ferramentas em várias etapas do que para simplesmente substituir um modelo de perguntas e respostas curtas.
Recomendação por cenário: qual modelo escolher para cada necessidade
| Cenário de aplicação | Modelo recomendado | Motivo |
|---|---|---|
| Atendimento ao cliente com alta concorrência / robô de FAQ | Gemini 2.5 Flash-Lite | Preço equivalente ao gpt-4o-mini, com índice de inteligência mais de 5 vezes superior |
| Raciocínio complexo / tarefas de Agent com várias etapas | GPT-5 mini | Melhor compatibilidade com o ecossistema da OpenAI e capacidade de raciocínio significativamente superior à do gpt-4o-mini |
| Processamento em lote com custo ultrabaixo (classificação de conteúdo, resumos) | GPT-5 nano / DeepSeek V4 Flash fora do horário de pico | O preço unitário pode chegar a cerca de um terço do gpt-4o-mini |
| Análise de documentos longos / contextos extensos | Claude Haiku 4.5 | Maior estabilidade em contextos longos e capacidade mais destacada de invocação de ferramentas |
| Validação de protótipos com orçamento extremamente limitado | DeepSeek V4 Flash em cenários com acerto de cache | Com o acerto de cache, o preço pode cair para um nível extremamente baixo |
💡 Sugestão de escolha: o modelo ideal depende principalmente do seu cenário de aplicação e dos requisitos de qualidade. Recomendamos fazer testes práticos pela plataforma APIYI apiyi.com, comparando, dentro do mesmo orçamento, o desempenho dos diferentes modelos nos dados reais do seu negócio, em vez de tomar uma decisão apenas com base em benchmarks públicos.
Vale lembrar que a tabela acima apresenta recomendações “padrão”. Na prática, a escolha também deve considerar o tamanho do contexto, o volume de requisições simultâneas e os requisitos de latência. Por exemplo, no mesmo cenário de atendimento ao cliente, se o histórico da conversa for muito longo e houver necessidade de consultar o contexto anterior com frequência, parte da vantagem de custo-benefício do Gemini 2.5 Flash-Lite pode ser consumida por comandos mais longos. Nesse caso, vale incluir o Claude Haiku 4.5 em um teste lado a lado. Da mesma forma, se a latência for um fator crítico em tarefas complexas de Agent, é importante medir o tempo total de resposta do GPT-5 mini na sua cadeia de ferramentas específica, em vez de observar apenas a pontuação de inteligência divulgada oficialmente.
Migração rápida: trocar o gpt-4o-mini por um modelo alternativo em apenas duas etapas
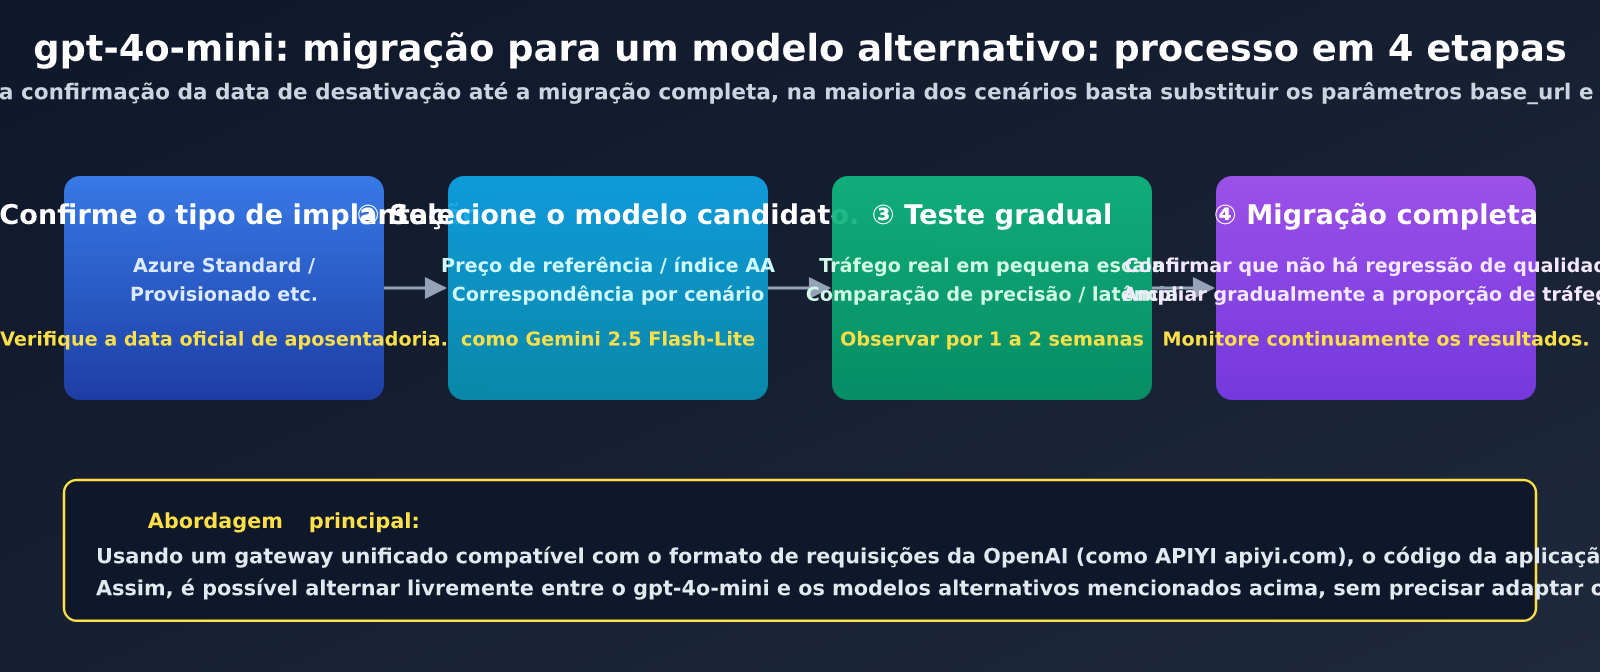
A maior parte do trabalho de migração exige apenas alterar os parâmetros base_url e model. Se você já usa o OpenAI SDK ou um cliente compatível com esse formato, não é necessário reescrever nenhuma lógica de negócio.
A parte realmente trabalhosa normalmente não está no código, mas nas diferenças entre as interfaces nativas de cada fornecedor: formato das mensagens, campos de invocação de ferramentas e estratégias de limitação de taxa. Ao mudar diretamente para o SDK nativo do Gemini ou do Claude, muitas vezes é necessário reescrever a lógica de montagem das requisições e de análise das respostas. Um gateway unificado compatível com o formato de requisições da OpenAI consegue ocultar essas diferenças, permitindo que o código de negócio mantenha uma única forma de invocação. É por isso que, no exemplo abaixo, model é um parâmetro configurável, em vez de haver um cliente separado para cada fornecedor.
Exemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI统一接口,一次接入可切换多家模型
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # 从 gpt-4o-mini 切换到替代模型
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
Ver o código completo da migração (incluindo alternância de modelos e novas tentativas em caso de erro)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # APIYI统一接口,兼容 OpenAI SDK 调用格式
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("总结一下 gpt-4o-mini 的下线时间表", profile="gemini"))
🚀 Comece rapidamente: recomendamos usar a plataforma APIYI apiyi.com para realizar testes comparativos antes da migração. A plataforma oferece cobrança unificada para vários modelos, sem exigir a solicitação de uma chave API e de uma conta separadas para cada novo modelo. Em poucos minutos, você consegue testar todos os modelos candidatos apresentados na tabela acima.
Perguntas frequentes
Q1: Estou usando o gpt-4o-mini no Azure OpenAI. Por quanto tempo ainda poderei usá-lo?
Isso depende do tipo específico de implantação. Se for uma implantação Standard, ela foi desativada em 31 de março de 2026 e, neste momento, provavelmente já não é possível fazer invocações do modelo. Se for uma implantação Provisioned, Global Standard ou Data Zone Standard, a data de desativação é 1º de outubro de 2026 — faltam menos de dois meses. Recomendamos concluir quanto antes os testes de migração por meio de plataformas com suporte à troca entre vários modelos, como a APIYI apiyi.com, para evitar interrupções no negócio após o prazo.
Q2: Uso a API oficial da OpenAI. Também preciso migrar imediatamente?
Não necessariamente. De acordo com a página oficial de descontinuações da OpenAI, o gpt-4o-mini em si não está atualmente na lista de modelos descontinuados. Apenas sua versão ajustada, ft-gpt-4o-mini, tem um cronograma diferente e posterior. Se a prioridade for reduzir custos, você pode continuar acompanhando a situação. No entanto, considerando que o índice de inteligência AA do gpt-4o-mini é de apenas 7 pontos, comparar o desempenho com modelos da mesma faixa de preço por meio da plataforma APIYI apiyi.com normalmente permite obter uma melhoria perceptível de qualidade sem aumentar o orçamento.
Q3: Depois de migrar para um novo modelo, como confirmar que o desempenho não piorou?
Não tome essa decisão apenas com base em uma percepção subjetiva. Recomendamos primeiro fixar um conjunto representativo de amostras reais do negócio, em vez de usar apenas alguns casos de teste escritos às pressas. Em seguida, execute o gpt-4o-mini e os modelos candidatos com as mesmas entradas e compare os resultados em três dimensões: taxa de acerto, conformidade com o formato e tempo médio de resposta. Durante a implementação gradual, o novo modelo pode receber apenas uma pequena parte do tráfego real. Observe o desempenho em produção por uma ou duas semanas e, depois de confirmar que não houve regressão significativa de qualidade ou latência, aumente gradualmente a proporção de tráfego até atingir 100%.
Resumo e recomendações para a decisão
| Item de verificação | Descrição |
|---|---|
| Confirmar o tipo de implantação | Azure Standard, Provisioned, Global Standard e Data Zone Standard têm datas de desativação diferentes |
| Verificar os preços oficiais | Os preços podem variar conforme a região e os horários de pico e fora de pico; consulte a página oficial |
| Comparar o índice de inteligência AA | Dê preferência a rankings públicos de terceiros, como o Artificial Analysis, evitando analisar apenas a divulgação dos fornecedores |
| Implementar gradualmente | Valide primeiro o desempenho em fluxos não essenciais e, depois, aumente gradualmente a proporção de tráfego |
| Unificar as invocações pela interface | Use uma plataforma de serviço proxy de API compatível com o formato do SDK da OpenAI para reduzir o custo da troca entre modelos |
Em resumo, o gpt-4o-mini não foi totalmente descontinuado na API oficial da OpenAI, mas o cronograma de desativação no Azure já está muito próximo. Além disso, seu desempenho inferior nos benchmarks é um fato objetivo. Para a maioria dos cenários, Gemini 2.5 Flash-Lite e GPT-5 mini são duas opções prioritárias com preços próximos e melhorias significativas de desempenho. Em situações extremamente sensíveis a custos, também vale acompanhar os preços de pico e fora de pico do GPT-5 nano e do DeepSeek V4 Flash.
Também vale fazer um alerta: não recomendamos trocar de modelo às pressas apenas porque ele é “mais barato” ou porque você “ouviu dizer que será descontinuado”. Preço e resultados de benchmark são apenas o primeiro passo para filtrar os candidatos. O que realmente deve determinar se a migração será feita e para qual modelo é o desempenho medido nos seus próprios dados de negócio. Estender o período de avaliação para uma ou duas semanas e cobrir uma quantidade suficiente de cenários reais é mais confiável do que acompanhar as oscilações das pontuações nos rankings. Como etapa final, recomendamos realizar um teste comparativo com dados reais do negócio por meio da plataforma APIYI apiyi.com antes de decidir para qual modelo migrar.
Se você encontrar problemas específicos durante a migração, entre em contato pelo canal de suporte técnico da APIYI apiyi.com. Continuaremos acompanhando as mudanças nos preços oficiais do gpt-4o-mini e dos modelos alternativos, além de atualizar os dados deste artigo.