“gpt-4o-mini 是不是快要被淘汰了”,是最近技术社区里反复出现的问题。这个疑问的直接触发点是 Azure OpenAI Service 陆续发布的模型退役公告,再加上 gpt-4o-mini 在各类跑分榜单上的排名持续走低,让不少团队开始重新评估自己的模型选型。
本文基于 OpenAI 官方文档、Microsoft Learn 退役公告和 Artificial Analysis 权威跑分数据,先澄清 gpt-4o-mini 下线传闻中的信息混淆,再从定价和性能两个维度,对比 GPT-5 mini、GPT-5 nano、Gemini 2.5 Flash-Lite、DeepSeek V4 Flash、Claude Haiku 4.5 等 5 款价格接近的替代模型,帮助你判断是否需要迁移,以及迁移到哪个模型收益最大。
核心价值:读完本文,你将清楚知道 gpt-4o-mini 到底是“部分下线”还是被过度解读,以及在预算基本不变的前提下,哪款替代模型能带来更明显的效果提升。
这类误解之所以传播很广,很大程度上是因为 Azure 侧的退役公告、ChatGPT 网页端的模型下架,以及社区里“OpenAI 要淘汰旧模型”的笼统说法被混在一起讨论,缺少一个按平台、按部署类型拆开的清晰版本。下文会把这几条时间线分开说明,避免你为了一个还没真正生效的传闻仓促迁移,也避免真正紧迫的 Azure 退役日期被忽略。
gpt-4o-mini 现状:跑分仅7分,下线传闻是否属实
先说结论:gpt-4o-mini 的下线传闻存在明显的信息混淆,Azure 和 OpenAI 官方 API 是两套完全不同的时间表,不能一概而论地说“gpt-4o-mini 要下线了”。
gpt-4o-mini 当前定价与性能
| 指标 | 数值 | 说明 |
|---|---|---|
| Input 定价 | $0.15 / 1M tokens | OpenAI 官方 API 价格 |
| Cached Input 定价 | $0.075 / 1M tokens | 命中缓存时价格减半 |
| Output 定价 | $0.60 / 1M tokens | OpenAI 官方 API 价格 |
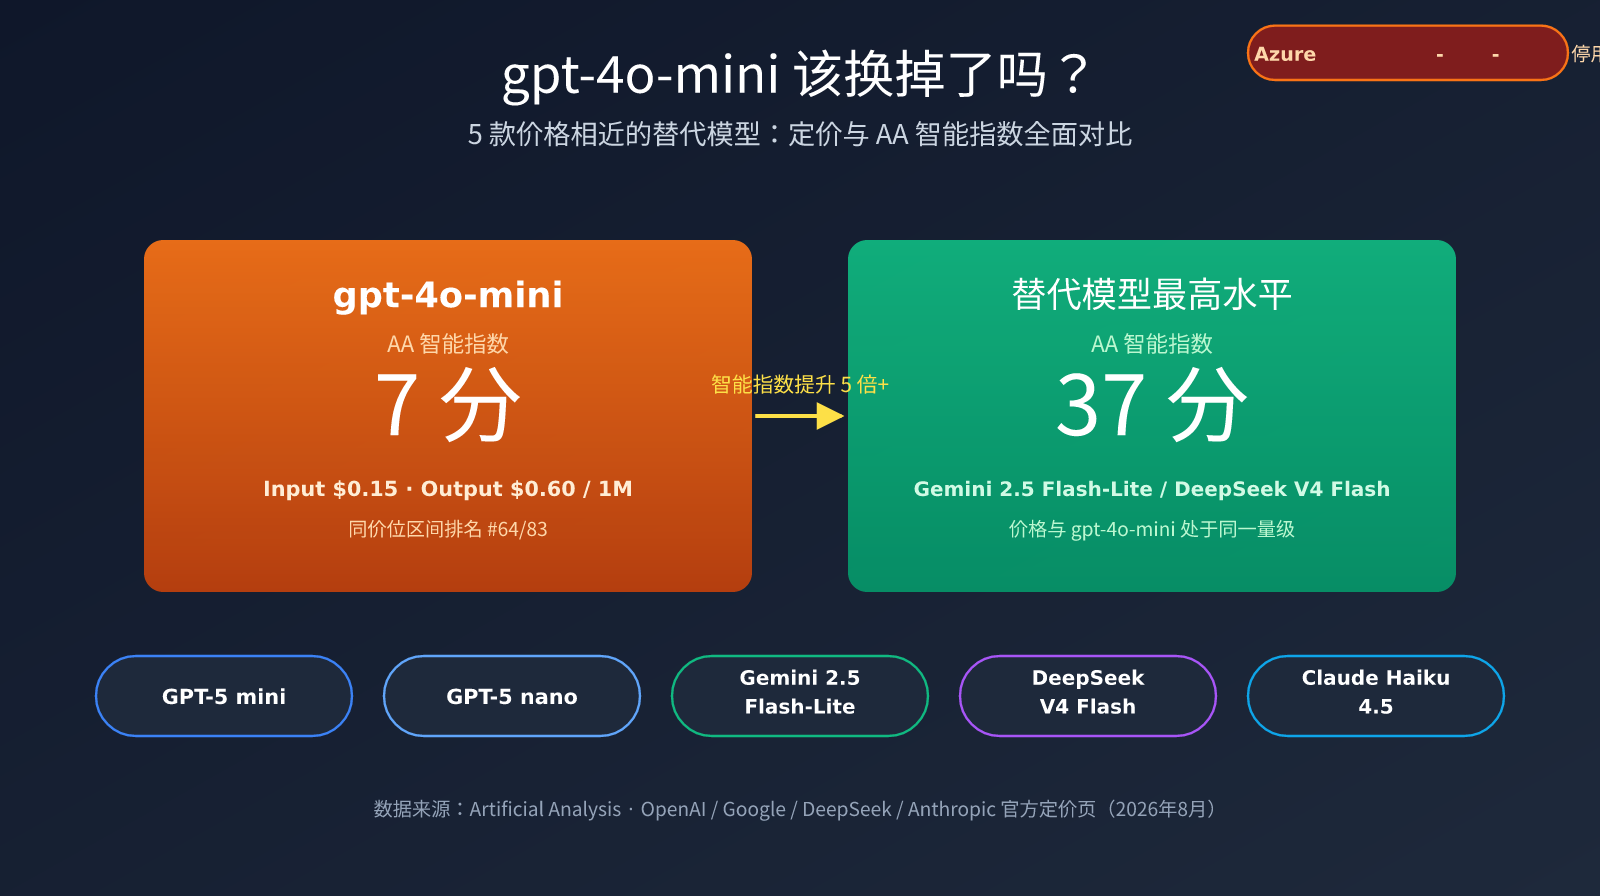
| AA 智能指数 | 7 分 | Artificial Analysis 评测,同价位区间排名 #64/83 |
| 输出速度 | 100.9 tokens/s | 低于同类模型均值 102.1 tokens/s |
gpt-4o-mini 之所以在 2026 年被频繁质疑,核心原因并不是价格变了,而是它的 Artificial Analysis 智能指数只有 7 分,在同价位区间的 83 款模型里排名第 64,明显低于该价位段的中位数水平。换句话说,gpt-4o-mini 依旧便宜,但“便宜”已经不再等于“高性价比”——同样的预算,现在能买到聪明得多的模型。
这里补充说明一下 AA 智能指数的参考价值:它由 Artificial Analysis 综合多项公开评测(涵盖推理、代码、数学等能力维度)加权计算得出,好处是覆盖模型广、更新频率高,可以在同一把尺子下横向比较不同厂商的模型;局限是它反映的是通用能力的平均水平,不能完全替代你在自己业务数据上的实测结果。把它当作筛选候选模型的第一道过滤器,而不是最终的选型依据,会更稳妥。
gpt-4o-mini 下线时间表:Azure 和 OpenAI API 完全不同
| 平台 / 部署方式 | 状态 | 退役日期 |
|---|---|---|
| OpenAI 官方 API(gpt-4o-mini 本体) | 未设定退役日期 | 暂无 |
| OpenAI 微调版 ft-gpt-4o-mini | 已公布计划 | 训练截止不早于 2027-04-01,部署截止 2027-10-01 |
| Azure OpenAI Standard 部署 | 已退役 | 2026-03-31 |
| Azure Provisioned / Global Standard / Data Zone Standard | 即将退役 | 2026-10-01 |
需要特别澄清的是,2026 年 2 月 13 日 OpenAI 确实从 ChatGPT 产品界面下线了 GPT-4o、GPT-4.1、GPT-4.1 mini 和 o4-mini,但这是 ChatGPT 网页端模型选择器的调整,官方公告明确说明 API 端没有变化,而且 gpt-4o-mini 本身也不在这份下线名单里。真正需要认真对待的是 Azure 侧的时间表:Azure OpenAI 的 gpt-4o-mini Standard 部署已经在 2026 年 3 月 31 日退役,Provisioned、Global Standard 和 Data Zone Standard 部署也将在 2026 年 10 月 1 日统一停止服务,距现在只剩不到两个月,届时调用会直接返回 410 Gone 错误。如果你的业务跑在 Azure 上,这份时间表比“OpenAI 是否下线”更值得优先关注。
另一个容易被忽略的细节是:即便是同一个“gpt-4o-mini”名字,Azure 上不同的部署方式(Standard、Provisioned、Global Standard、Data Zone Standard)退役时间并不统一,混用团队很容易因为只查了其中一种部署的公告,就误判整体的下线节奏。建议在排查这件事之前,先在 Azure 门户里确认自己具体用的是哪一种部署,再对照上表逐一核实退役日期,避免“听说下线了”和“实际还能用多久”出现偏差。
gpt-4o-mini vs 5 款替代模型:价格与跑分全对比
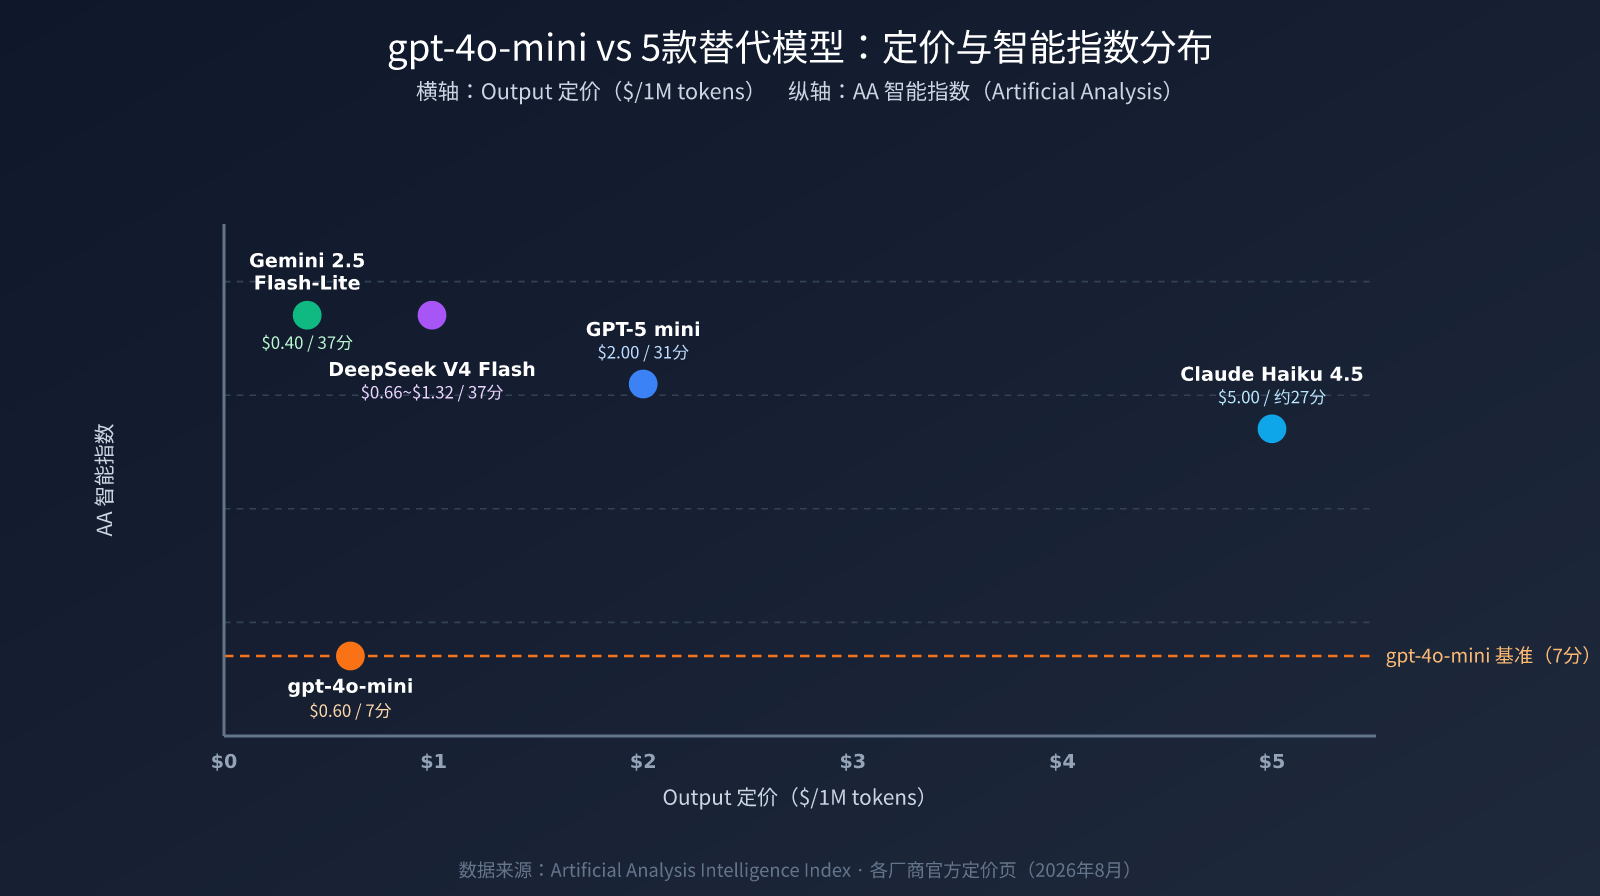
如果你正在评估迁移方案,下面这张对比表汇总了 5 款定价接近 gpt-4o-mini、且有官方或权威三方数据支撑的替代模型,方便你按预算和性能需求快速筛选。
| 模型 | Input / Output($/1M) | AA 智能指数 | 核心优势 |
|---|---|---|---|
| gpt-4o-mini(基准) | $0.15 / $0.60 | 7 分(#64/83) | 生态成熟,兼容性好 |
| GPT-5 nano | $0.05 / $0.40 | 官方未单独公布跑分 | 同系列里成本最低的选项 |
| GPT-5 mini | $0.25 / $2.00 | 31 分(medium 推理档位) | OpenAI 生态内最直接的官方平替 |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 分 | 价格与 gpt-4o-mini 接近,智能指数提升明显 |
| DeepSeek V4 Flash | $0.22~$0.44 / $0.66~$1.32(峰谷定价) | 37 分(高推理强度) | 分时段定价,缓存命中最低可到 $0.007/1M |
| Claude Haiku 4.5 | $1.00 / $5.00 | 约 24~30 分(视推理档位) | 长上下文与工具调用能力更突出 |
🎯 技术建议:在实际选型时,我们建议通过 API易 apiyi.com 平台对上述模型逐一进行接口测试,该平台以统一的 API 接口同时支持 gpt-4o-mini、GPT-5 系列、Gemini、DeepSeek 和 Claude 等主流模型调用,便于在同一套代码里快速切换和对比效果。
以上 5 款之外,阿里云 Qwen3.5 Flash 也是一个价格区间接近的选项,第三方比价渠道给出的价格在 $0.10 / $0.40 附近,但由于并非从 DashScope 官方定价页直接确认,建议在正式迁移前以官方控制台价格为准,避免因区域或汇率差异产生误差。同样,GPT-5 nano 目前没有查到官方或 Artificial Analysis 公布的独立跑分,这里如实标注为“未公布”,而不是给出一个编造的数字。
整体来看,Gemini 2.5 Flash-Lite 是最值得优先测试的选项:价格只比 gpt-4o-mini 略高一点,AA 智能指数却从 7 分跳到 37 分,是同价位区间里性价比提升最明显的一款。如果你更看重和 OpenAI 生态的兼容性,GPT-5 mini 虽然价格是 gpt-4o-mini 的一倍多,但换来的性能提升同样显著;预算极度敏感的场景则可以看看 GPT-5 nano 和 DeepSeek V4 Flash 的非高峰时段定价。
DeepSeek V4 Flash 的定价机制值得单独说明一下:它采用峰谷两套价格,非高峰时段的 Input/Output 只要 $0.22/$0.66,高峰时段则涨到 $0.44/$1.32,如果命中缓存还能进一步降到 $0.007~$0.014 每百万 token。对于可以错峰跑批的离线任务(比如夜间批量摘要、日志分析),这套定价往往比固定单价的模型更划算,但如果业务是白天高峰期的实时请求,就需要按高峰价重新核算成本。Claude Haiku 4.5 则走的是另一条路线:单价明显高于 gpt-4o-mini,但换来了更强的长上下文稳定性和工具调用能力,更适合需要处理长文档、多轮工具编排的场景,而不是单纯的短问答替换。
场景推荐:不同需求该选哪个模型
| 应用场景 | 推荐模型 | 理由 |
|---|---|---|
| 高并发客服 / FAQ 机器人 | Gemini 2.5 Flash-Lite | 价格与 gpt-4o-mini 持平,智能指数提升 5 倍以上 |
| 复杂推理 / 多步骤 Agent 任务 | GPT-5 mini | 与 OpenAI 生态兼容性最好,推理能力明显优于 gpt-4o-mini |
| 超低成本批量处理(内容打标、摘要) | GPT-5 nano / DeepSeek V4 Flash 非高峰时段 | 单价可低至 gpt-4o-mini 的三分之一左右 |
| 长文档 / 长上下文分析 | Claude Haiku 4.5 | 长上下文稳定性和工具调用能力更突出 |
| 预算极度敏感的原型验证 | DeepSeek V4 Flash 缓存命中场景 | 缓存命中价格可压到极低水平 |
💡 选择建议:选择哪个模型主要取决于你的具体应用场景和质量要求。我们建议通过 API易 apiyi.com 平台进行实际测试,在同一套预算下对比不同模型在你真实业务数据上的表现差异,而不是只参考公开跑分做决策。
需要注意的是,上表给出的是“默认推荐”,实际选型还要结合上下文长度、并发量和延迟要求做调整。例如同样是客服场景,如果对话历史很长、需要频繁引用之前的上下文,Gemini 2.5 Flash-Lite 的性价比优势可能会被更长的 prompt 消耗掉一部分,这时候不妨把 Claude Haiku 4.5 也拉进来做一次并排测试;而复杂 Agent 任务如果对响应延迟要求很高,也要实测 GPT-5 mini 在你具体工具链下的端到端耗时,而不是只看官方公布的智能指数分数。
快速迁移:从 gpt-4o-mini 切换到替代模型只需两步
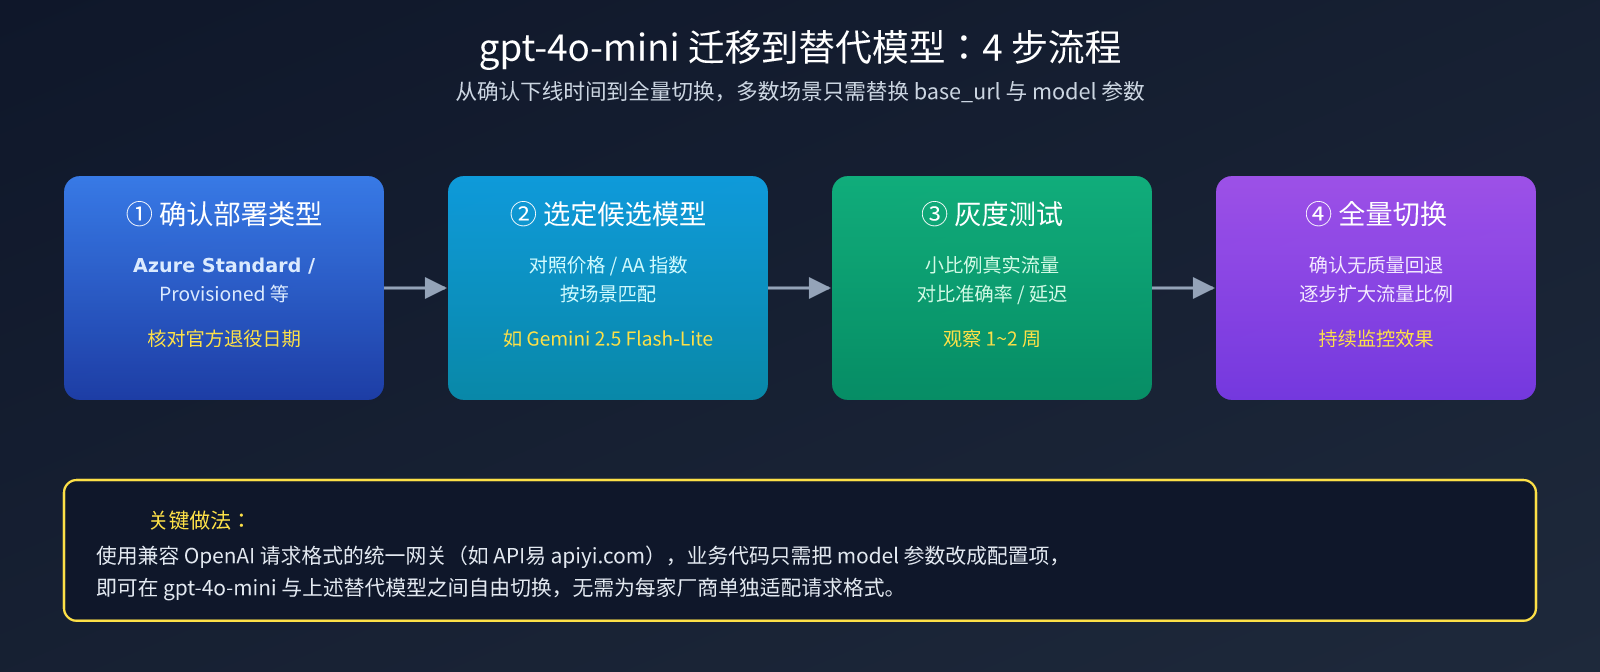
多数迁移工作只需要修改 base_url 和 model 两个参数。如果你原本使用的是 OpenAI SDK 或兼容格式的客户端,不需要重写任何业务逻辑。
真正麻烦的地方通常不在代码层面,而在于不同厂商的原生接口在消息格式、工具调用字段、速率限制策略上并不完全一致:直接切换到 Gemini 或 Claude 的原生 SDK,往往需要重写请求体和响应解析逻辑。使用兼容 OpenAI 请求格式的统一网关,可以把这部分差异屏蔽掉,让业务代码只维护一套调用方式,这也是下面示例里把 model 做成可配置参数、而不是为每家单独写一套客户端的原因。
极简示例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易统一接口,一次接入可切换多家模型
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # 从 gpt-4o-mini 切换到替代模型
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
查看完整迁移代码(含模型切换开关和错误重试)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # API易统一接口,兼容 OpenAI SDK 调用格式
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("总结一下 gpt-4o-mini 的下线时间表", profile="gemini"))
🚀 快速开始:推荐使用 API易 apiyi.com 平台完成迁移前的对比测试,平台内置多模型统一计费,不需要为每个新模型单独申请密钥和账户,几分钟内就能跑通上表中的全部候选模型。
常见问题
Q1:我现在用的是 Azure OpenAI 上的 gpt-4o-mini,还能继续用多久?
要看具体部署类型。如果是 Standard 部署,已经在 2026 年 3 月 31 日退役,目前应该已经无法调用;如果是 Provisioned、Global Standard 或 Data Zone Standard 部署,退役日期是 2026 年 10 月 1 日,距现在只剩不到两个月。建议尽快通过 API易 apiyi.com 之类支持多模型切换的平台完成迁移测试,避免到期后业务中断。
Q2:我用的是 OpenAI 官方 API,是不是也必须马上迁移?
不是必须的。根据 OpenAI 官方 Deprecations 页面,gpt-4o-mini 本体目前没有被列入退役名单,只有它的微调版本 ft-gpt-4o-mini 有更晚的时间表。如果你更看重成本,可以继续观望;但考虑到 gpt-4o-mini 的 AA 智能指数只有 7 分,通过 API易 apiyi.com 平台做一次同价位模型的效果对比,通常能在不增加预算的前提下换来明显的质量提升。
Q3:迁移到新模型之后,怎么确认效果没有变差?
不要只凭主观感觉判断,建议先固定一批有代表性的真实业务样本(而不是随手写的几条测试用例),让 gpt-4o-mini 和候选模型跑同一批输入,再从准确率、格式合规率、平均响应时长三个维度对比结果。灰度切换阶段可以让新模型只承接一小部分真实流量,观察一到两周的线上表现,确认没有明显的质量或延迟回退后,再逐步把流量比例提高到全量。
总结与决策建议
| 检查项 | 说明 |
|---|---|
| 确认部署类型 | Azure Standard / Provisioned / Global Standard / Data Zone Standard 退役时间不同 |
| 核实官方定价 | 定价可能随区域、峰谷时段浮动,以官方页面为准 |
| 对比 AA 智能指数 | 优先参考 Artificial Analysis 等第三方公开榜单,避免只看厂商宣传 |
| 灰度切换 | 先在非核心链路验证效果,再逐步扩大流量比例 |
| 统一接口调用 | 使用兼容 OpenAI SDK 格式的中转平台,降低多模型切换成本 |
综合来看,gpt-4o-mini 并没有被 OpenAI 官方 API 整体下线,但 Azure 侧的退役时间表已经非常紧迫,而它在跑分上的落后也是客观事实。对大多数场景而言,Gemini 2.5 Flash-Lite 和 GPT-5 mini 是价格接近、性能提升明显的两个优先选项;预算极度敏感的场景可以再看看 GPT-5 nano 和 DeepSeek V4 Flash 的峰谷定价。
也要提醒一句:不建议只因为“便宜”或者“听说要下线”就仓促切换模型,价格和跑分只是筛选候选池的第一步,真正决定要不要迁移、迁移到哪一款,还是要看它在你自己业务数据上的实测表现。把评估周期拉长到一到两周、覆盖足够多的真实场景,比追逐榜单上的分数变化更可靠。最终推荐通过 API易 apiyi.com 平台完成一次真实业务数据下的横向测试,再决定迁移到哪个模型。
如果你在迁移过程中遇到具体问题,欢迎通过 API易 apiyi.com 技术支持通道交流,我们会持续跟踪 gpt-4o-mini 和各替代模型的官方定价变化,并同步更新本文数据。