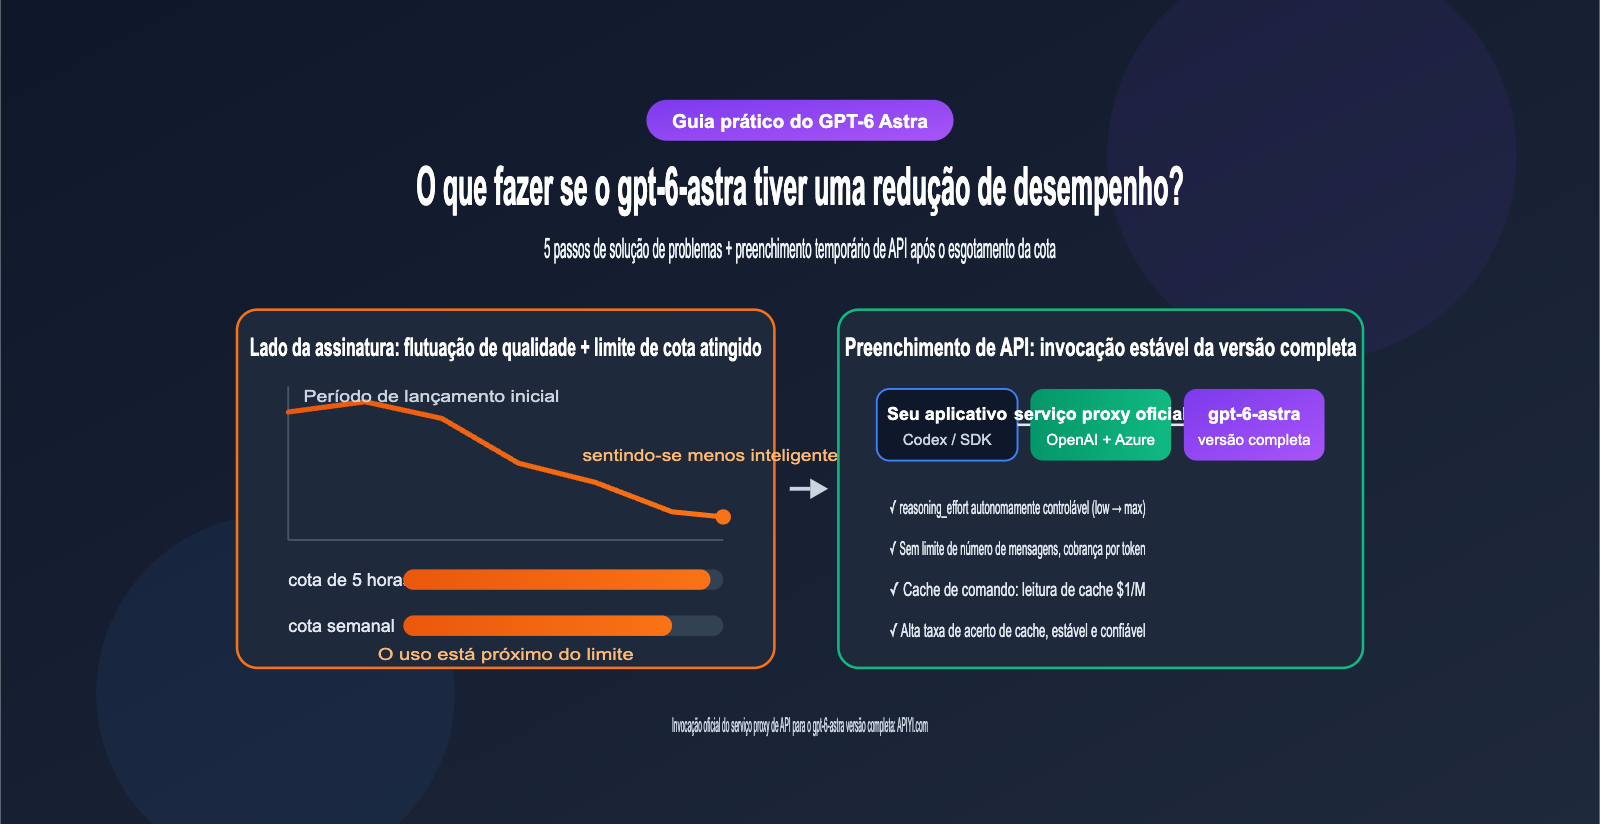
O gpt-6-astra foi lançado em 3 de setembro de 2026 e disponibilizado para todos no dia seguinte. Apenas uma semana após o lançamento, as redes sociais foram inundadas com reclamações de que o "gpt-6-astra ficou mais burro": o mesmo comando gerava resultados de qualidade inferior aos dos primeiros dias, e o nível de raciocínio Extra high estava mais rápido, porém com resultados mais grosseiros. Ao mesmo tempo, as cotas do Astra no ChatGPT e no Codex ficaram visivelmente mais restritas em comparação com a geração anterior, o GPT-5.6 Sol, deixando muitos desenvolvedores travados por limites de uso no meio do trabalho. Este artigo apresenta um método de verificação em 5 etapas para determinar se o gpt-6-astra realmente perdeu capacidade, além de uma solução de contorno usando o serviço proxy de API oficial para manter seu fluxo de trabalho estável.
Valor central: Ao terminar de ler, você será capaz de distinguir entre uma "perda real de capacidade" e "viés de percepção", entender os limites reais das cotas de assinatura e aprender a usar estratégias de intensidade de raciocínio e cache para invocar o gpt-6-astra em sua capacidade máxima com um custo razoável.
Pontos principais da controvérsia sobre a "perda de capacidade" do gpt-6-astra
Antes de começar a investigar, vamos colocar os fatos conhecidos na mesa. De acordo com o levantamento de mídias estrangeiras como o Decrypt, as reclamações começaram a se concentrar uma semana após o lançamento do Astra. Alguns desenvolvedores (incluindo a equipe da opencode) voltaram para o GPT-5.6 Sol devido ao custo dobrado e à qualidade abaixo do esperado. No entanto, até o momento desta publicação, a OpenAI não divulgou uma declaração oficial sobre o Astra, e muitos usuários experientes acreditam que o modelo em si não mudou, apenas que, após o "período de lua de mel", as pessoas começaram a notar mais suas falhas.
| Ponto | Fato conhecido | Significado para você |
|---|---|---|
| Data de lançamento | 03/09/2026 para usuários aprovados, 04/09 disponível para todos | O modelo ainda está em fase inicial, as políticas do servidor podem mudar frequentemente |
| Reclamações | Usuários relatam piora na saída com o mesmo comando e tempo de raciocínio reduzido | É necessário verificar de forma reprodutível, não apenas por intuição |
| Resposta oficial | Nenhuma declaração oficial sobre o Astra até o momento | Impossível confirmar se a intensidade de raciocínio padrão foi ajustada |
| Precedentes | Em julho de 2026, o Sol sofreu críticas semelhantes; a OpenAI negou enfraquecimento, mas admitiu testar configurações de "intensidade de raciocínio" | O orçamento de raciocínio no ChatGPT não é totalmente controlado por você |
| Restrição de cotas | No Plus, o limite no Work/Codex é de cerca de 5-45 mensagens/5 horas, metade do período do Sol | Usuários intensivos atingirão o limite facilmente em horários de pico |
Por que o gpt-6-astra "parece mais burro"?
A possibilidade de os pesos do modelo terem sido substituídos secretamente é, na verdade, muito baixa; a causa mais comum reside no "orçamento de raciocínio". O gpt-6-astra suporta cinco níveis de intensidade de raciocínio na API: low, medium, high, xhigh e max. Quanto maior o nível, mais etapas de pensamento o modelo realiza antes de responder, aumentando a qualidade e o tempo de processamento. Em produtos de assinatura como o ChatGPT e o Codex, o orçamento de raciocínio é gerenciado centralmente pela plataforma. Assim que a plataforma reduz o orçamento real para lidar com a pressão computacional, o que o usuário vê são resultados "mais rápidos, porém mais grosseiros", o que coincide perfeitamente com as reclamações.
Por outro lado, desenvolvedores como Theo apontaram que a variância de saída do próprio Astra é bastante alta: para a mesma tarefa, ele pode fornecer resultados surpreendentes ou cometer erros básicos. No lançamento, é fácil lembrar dos casos impressionantes, mas com o uso prolongado, os casos de falha são amplificados, e essa discrepância psicológica também é interpretada como "perda de capacidade". Portanto, a chave para a investigação é separar as três variáveis: "agendamento da plataforma", "variância do modelo" e "uso pessoal".
Método de diagnóstico de 5 passos para a degradação do gpt-6-astra
Este fluxo é ideal para quando você suspeita que o gpt-6-astra está sofrendo uma degradação de desempenho. Siga a ordem para eliminar causas uma a uma e evitar trocar de modelo sem necessidade.
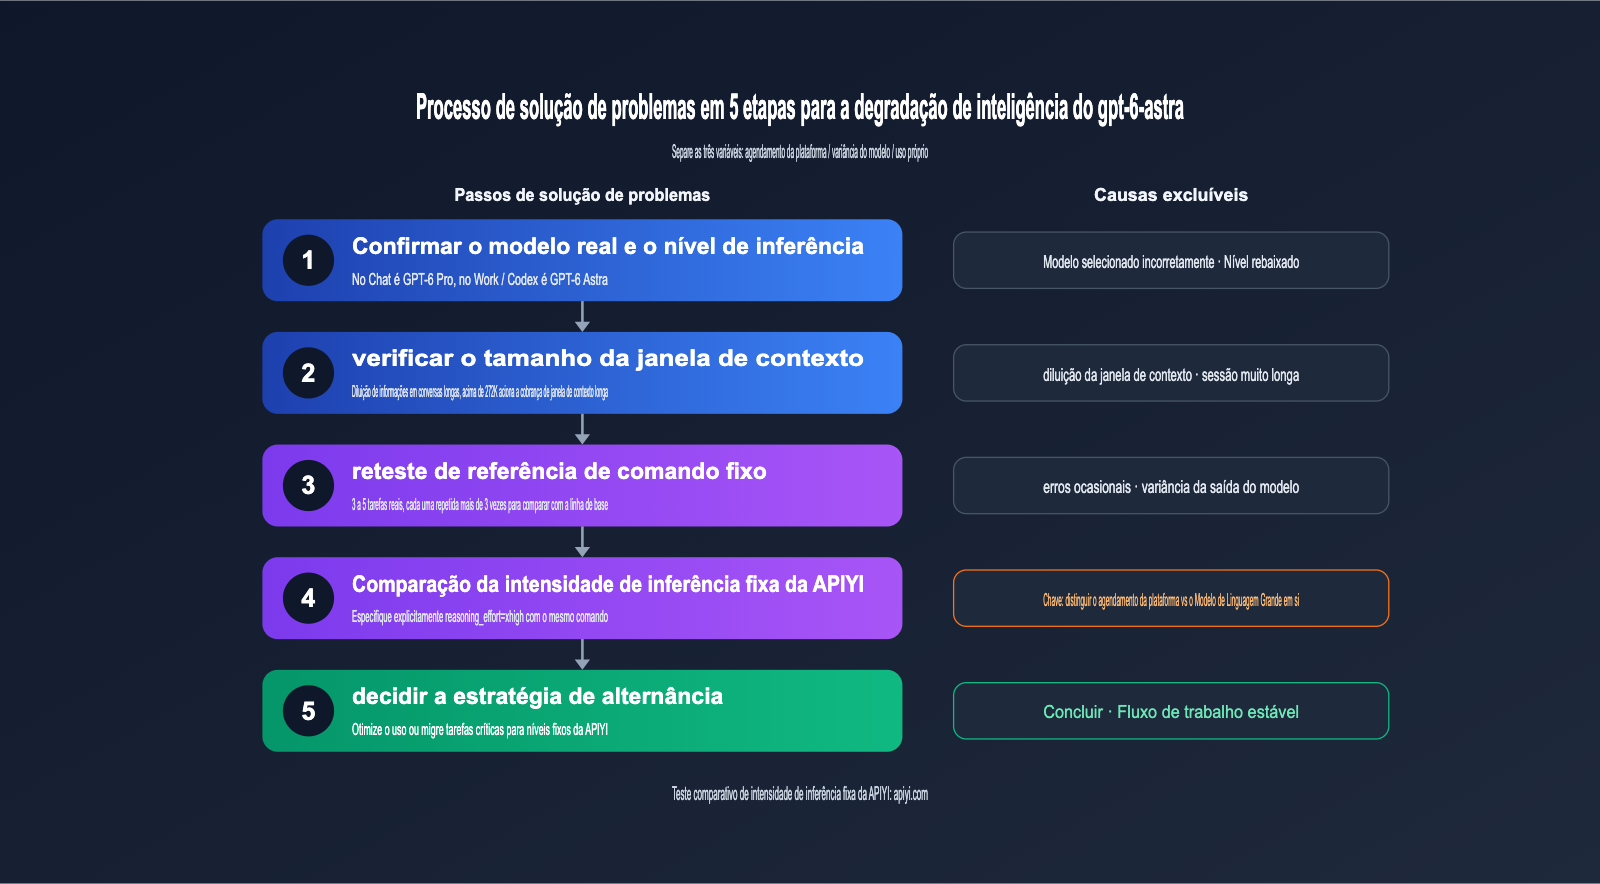
- Confirme o modelo e o nível de intensidade: No ChatGPT, o Astra aparece como GPT-6 Pro no Chat, enquanto no Work e no Codex ele é o GPT-6 Astra; os sistemas de cota são diferentes. Verifique qual modelo está rodando, qual nível de intensidade de raciocínio foi selecionado e se a interface já sinalizou alguma redução de nível por falta de cota.
- Verifique se o contexto está muito longo: A janela de contexto do Astra é de 1.050.000 tokens, mas a diluição de informações antigas em conversas longas é um problema comum em todos os Modelos de Linguagem Grandes. Se uma sessão do Codex já dura horas, inicie uma nova e simplifique o material de referência antes de testar.
- Faça um teste de referência com comandos fixos: Escolha de 3 a 5 tarefas reais que você conhece bem, salve a saída do período inicial como base e repita o mesmo comando pelo menos 3 vezes para ver se o desempenho cai constantemente ou se são falhas aleatórias. Uma única comparação não tem valor estatístico.
- Use a API com intensidade de raciocínio fixa como controle: Especifique explicitamente o
reasoning_effortvia API e compare a saída com a do ChatGPT usando o mesmo comando. Se o resultadoxhighda API for visivelmente superior ao da assinatura, o problema provavelmente está no orçamento de inferência da plataforma, não no modelo em si. - Decida a estratégia com base na conclusão: Se for um problema de uso, otimize seus comandos e o gerenciamento da sessão; se for um problema de agendamento ou cota da plataforma, migre as tarefas críticas para chamadas de API controladas.
| Fenômeno | Causa mais provável | Método de verificação | Ação sugerida |
|---|---|---|---|
| Resposta rápida, mas raciocínio superficial | Orçamento de inferência reduzido | Comparar com xhigh na API |
Mover tarefas críticas para a API com nível fixo |
| Erros frequentes em conversas longas | Diluição de contexto ou excedeu 272K | Testar em nova sessão | Dividir tarefas, simplificar contexto |
| Desempenho instável na mesma tarefa | Alta variância na saída do modelo | Rodar 3-5 vezes com o mesmo comando | Adicionar etapas de verificação ou amostragem |
| Aviso repentino de uso excedido | Cota de 5h ou semanal atingida | Verificar painel de uso | Aguardar reset ou usar API como backup |
| Queda na qualidade do código | Nível alterado ou desvio de comando | Comparar com base inicial | Fixar o comando do sistema e o nível |
🎯 Dica de diagnóstico: O passo 4 é fundamental para distinguir entre "problemas da plataforma" e "problemas do modelo". Recomendamos usar a APIYI (apiyi.com) com o mesmo conjunto de comandos para rodar os níveis
highexhigh. A plataforma oferece o gpt-6-astra via proxy direto oficial, mantendo os parâmetros de chamada idênticos à interface nativa da OpenAI, o que torna a comparação muito mais confiável.
O que fazer quando a cota do gpt-6-astra acaba?
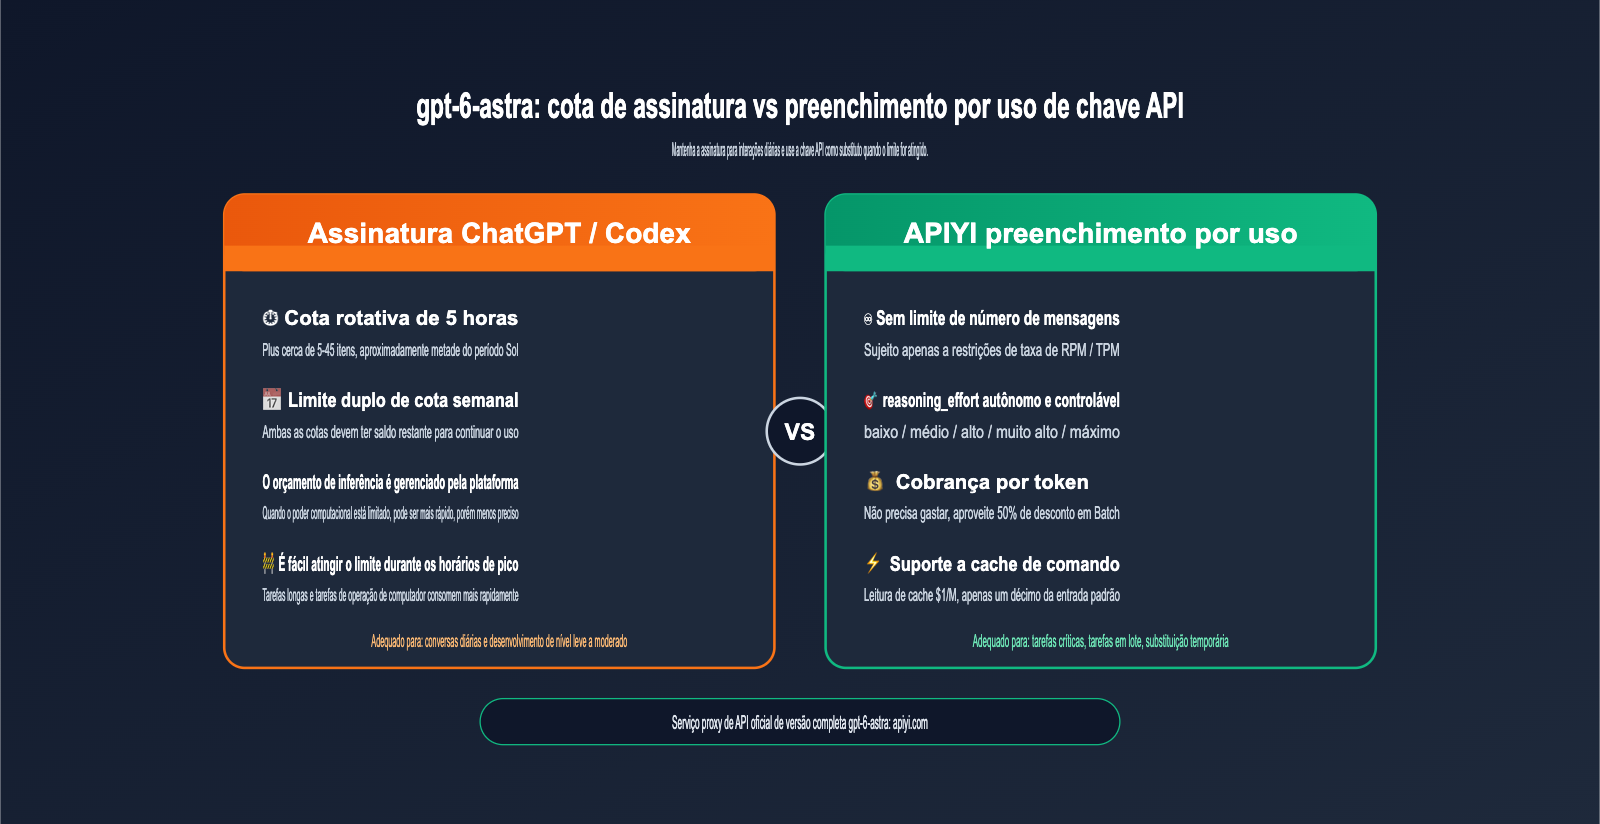
Mesmo que o modelo não esteja sofrendo com a "redução de inteligência" (o famoso downgrade), problemas de cota são suficientes para interromper o ritmo de trabalho. De acordo com informações de comunidades e mídias internacionais, o Astra no ChatGPT Work e no Codex utiliza uma restrição dupla de "cota rotativa de 5 horas + cota semanal", sendo necessário ter saldo em ambas para continuar usando. Além disso, há relatos de que, após o reset geral de cotas em 5 de setembro, o limite para alguns usuários intensivos foi ainda mais reduzido. A tabela abaixo apresenta estimativas compiladas pela comunidade; os valores reais devem ser consultados no painel de uso oficial da OpenAI.
| Plano de Assinatura | Cota estimada do Astra no Work/Codex | GPT-6 Pro no Chat | Perfil de usuário |
|---|---|---|---|
| Plus | Aprox. 5-45 mensagens / 5h | Não disponível | Uso leve, tarefas complexas ocasionais |
| Pro $100 | Aprox. 25-225 mensagens / 5h | Aprox. 50 mensagens / semana | Desenvolvimento diário |
| Pro $200 | Aprox. 100-900 mensagens / 5h | Aprox. 200 mensagens / semana | Uso intensivo em tempo integral |
| API (pague pelo uso) | Sem limite de mensagens, sujeito a RPM/TPM | Não aplicável | Tarefas em lote, críticas ou backup |
A grande variação nos intervalos ocorre porque o consumo de cota por mensagem depende da complexidade da tarefa, do nível de raciocínio e do tamanho da janela de contexto. Uma tarefa de automação de computador que leva 40 minutos consome muito mais do que uma pergunta simples. Para a maioria dos desenvolvedores, não vale a pena assinar o plano de $200 apenas para picos ocasionais de demanda. Uma estratégia mais econômica é manter a assinatura atual e usar a API como complemento quando a cota esgotar.
Três vantagens de usar a API do gpt-6-astra como backup
Usar a API como complemento temporário não é apenas "ganhar mais cota", mas sim retomar o controle. Primeiro, a intensidade do raciocínio é definida explicitamente por você, sem ajustes silenciosos da plataforma, o que neutraliza a incerteza da "redução de inteligência". Segundo, a API é cobrada por token, ou seja, você não gasta quando não usa, sendo ideal para demandas intermitentes. Terceiro, a API suporta recursos de otimização de custo, como Batch e cache de comando, tornando o uso a longo prazo previsível.
Ao escolher um provedor, verifique se é um serviço proxy de API oficial. Alguns canais de terceiros podem usar interfaces reversas ou rotear solicitações para outros modelos, o que agrava o problema da "redução de inteligência". O gpt-6-astra oferecido pela APIYI (apiyi.com) é a versão completa, com conexão direta oficial via OpenAI e Azure, mantendo os parâmetros de interface idênticos aos oficiais, sendo um complemento estável além da sua assinatura.
Primeiros passos com a API do gpt-6-astra
O gpt-6-astra suporta os endpoints Chat Completions, Responses e Batch, aceitando texto e imagens como entrada e gerando texto como saída. O exemplo minimalista abaixo utiliza o SDK oficial da OpenAI; basta substituir a base_url e a chave API para começar.
Exemplo minimalista de invocação do gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "Você é um engenheiro backend sênior, responda fornecendo código executável."},
        {"role": "user", "content": "Implemente um cache LRU com tempo de expiração em Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # Fique atento a prompt_tokens_details.cached_tokens
Ver código completo: encapsulamento com chaves de cache, retentativas e estatísticas de uso
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# O comando de sistema longo e fixo é colocado no início para facilitar o cache de comando
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """Invoca o gpt-6-astra, fixando a intensidade de raciocínio e reutilizando a chave de cache"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"Entrada {usage.prompt_tokens} | Cache {cached} "
                  f"| Taxa de acerto {hit_rate:.1%} | Saída {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"Limite de taxa atingido, tentando novamente em {wait} segundos")
            time.sleep(wait)
        except APIError as e:
            print(f"Erro de interface: {e}")
            time.sleep(1)
    raise RuntimeError("Falha após múltiplas tentativas")


if __name__ == "__main__":
    tasks = [
        "Analise o uso de índices neste SQL: SELECT ...",
        "Projete um esquema de retentativa idempotente para o serviço de pedidos",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 Dica de uso: Na primeira chamada, recomendo usar o nível
mediumpara validar o fluxo e, em seguida, ajustar conforme a dificuldade da tarefa. Você pode se registrar na APIYI (apiyi.com) para obter uma cota de teste e confirmar se a qualidade da saída atende às suas expectativas antes de migrar tarefas críticas.
Usando a API do gpt-6-astra no Codex
Se você usa o Astra principalmente via Codex CLI, não precisa interromper o trabalho quando a cota acabar. Você pode configurar um provedor de modelo personalizado no arquivo ~/.codex/config.toml e usar sua chave API:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Após configurar, execute export APIYI_API_KEY=sua_chave e inicie o Codex. Quando sua cota de assinatura for resetada, basta comentar a linha model_provider para voltar ao modo original. Você pode alternar entre os dois modos conforme necessário.
Como escolher a intensidade de raciocínio do gpt-6-astra?
A intensidade de raciocínio determina diretamente a qualidade, o tempo de processamento e o custo. Recomendo categorizar por tipo de tarefa, em vez de usar sempre o nível máximo.
| Intensidade | Cenário típico | Qualidade | Tempo e Custo |
|---|---|---|---|
| low | Conversão de formato, perguntas simples, extração de dados | Atende necessidades básicas | Mínimo |
| medium | Autocompletar código, escrita de documentos | Equilibrado | Baixo |
| high | Refatoração complexa, design de arquitetura, análise de dados | Estável e confiável | Médio |
| xhigh | Depuração de bugs difíceis, tarefas de agentes de longa cadeia | Próximo à experiência inicial | Alto |
| max | Provas matemáticas, auditoria de segurança, decisões de alto valor | Qualidade máxima | Máximo, controle a frequência |
🎯 Dica de seleção: Se você suspeita que o lado da assinatura está "menos inteligente", pode fixar as tarefas críticas que rodava no ChatGPT no nível
xhighvia API. Ao usar a APIYI (apiyi.com), a intensidade de raciocínio é totalmente determinada pelos parâmetros da solicitação, facilitando o controle da qualidade dentro de limites previsíveis.
Controle de custos e otimização da taxa de acerto de cache do gpt-6-astra
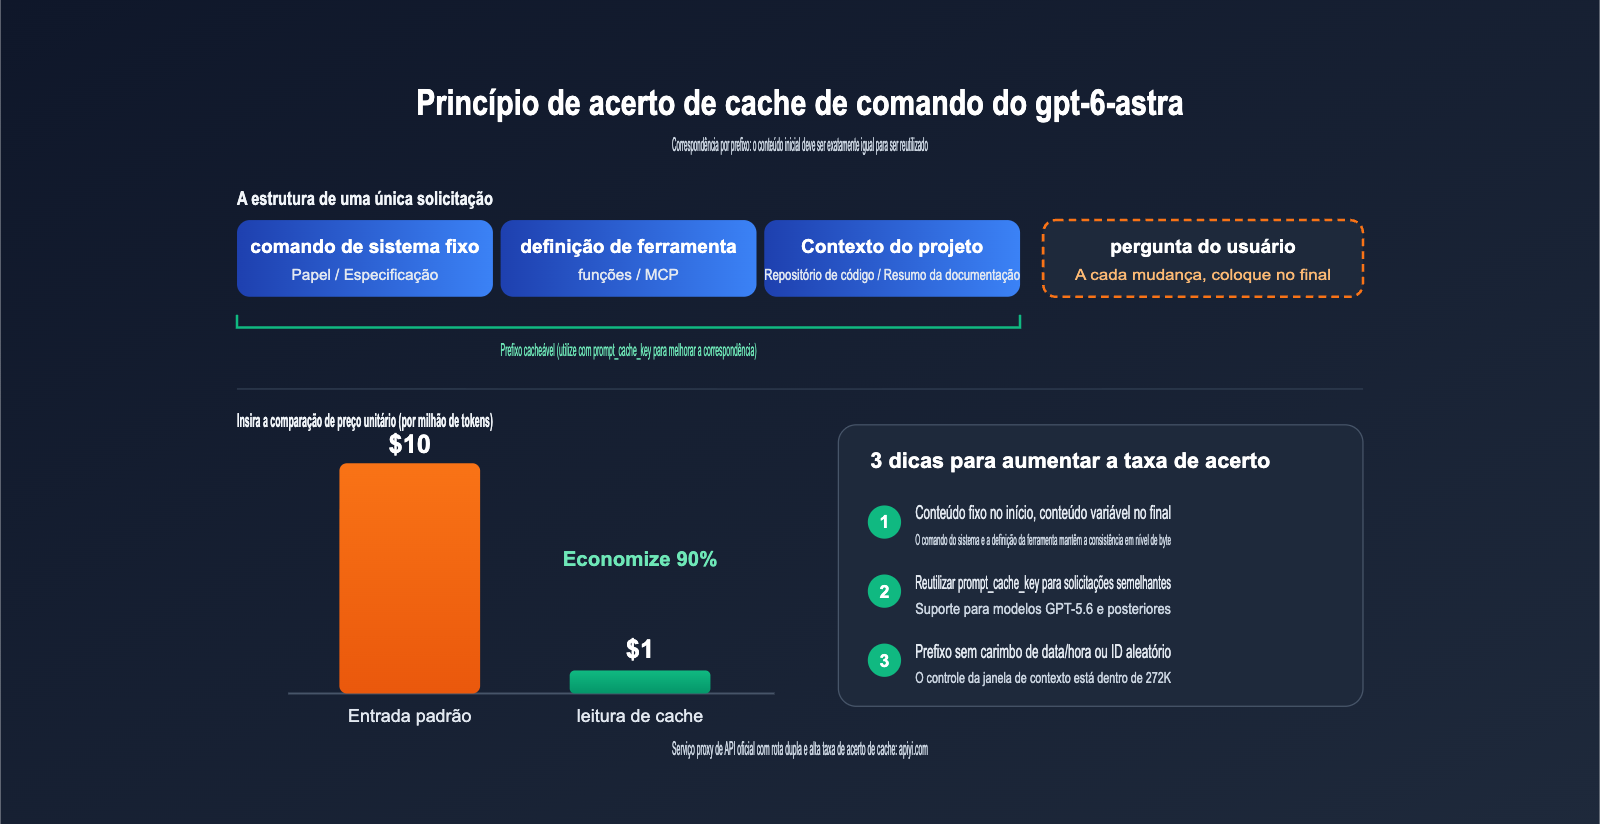
O preço oficial do gpt-6-astra é de US$ 10 para entrada e US$ 50 para saída (por milhão de tokens), sendo várias vezes superior ao preço de lançamento do GPT-5.6 Sol. Por isso, o controle de custos deve ser uma prioridade ao usar a API para suprir demandas. A boa notícia é que o preço de entrada do cache do Astra é de apenas US$ 1, o que equivale a 10% do preço de entrada padrão; a taxa de acerto do cache impactará diretamente o valor da sua fatura.
| Item de cobrança | Preço oficial (por milhão de tokens) | Observação |
|---|---|---|
| Entrada padrão | US$ 10 | Aplicável quando a entrada não excede 272K tokens |
| Leitura de cache | US$ 1 | Parte que atinge o cache do comando, economiza 90% |
| Escrita de cache | US$ 12,5 | Prefixo recém-escrito no cache, ligeiramente superior à entrada padrão |
| Saída padrão | US$ 50 | Inclui tokens de inferência |
| Contexto longo | 2x entrada/cache, 1,5x saída | Acionado quando a entrada excede 272K tokens |
| Batch / Flex | 50% do preço padrão | Ideal para tarefas que não exigem retorno em tempo real |
4 dicas para aumentar a taxa de acerto de cache do gpt-6-astra
O cache de comando é correspondido por "prefixo"; desde que o conteúdo inicial da solicitação seja exatamente o mesmo, os resultados de cálculo anteriores podem ser reutilizados. Com base nesse mecanismo, você pode otimizar seguindo estes pontos:
- Coloque o conteúdo fixo no início: Mantenha o comando do sistema, definições de ferramentas, normas do projeto e outros conteúdos imutáveis no início da mensagem, deixando perguntas do usuário, carimbos de data/hora e conteúdos variáveis para o final.
- Use
prompt_cache_key: Modelos a partir do GPT-5.6 suportam esse parâmetro. Usar a mesma chave de cache para solicitações que compartilham prefixos longos pode aumentar significativamente a probabilidade de correspondência. - Evite inserir valores dinâmicos no prefixo: Incluir a hora atual ou IDs aleatórios no comando do sistema fará com que o prefixo de cada solicitação seja diferente, invalidando o cache imediatamente.
- Mantenha o contexto dentro de 272K: Ultrapassar esse limite acionará a cobrança de contexto longo e o preço de leitura do cache dobrará. Para documentos longos, recomenda-se realizar uma busca antes de enviar ao modelo.
A taxa de acerto do cache também está relacionada à estabilidade da infraestrutura subjacente. Se a solicitação oscilar frequentemente entre diferentes backends, o cache dificilmente será mantido. A APIYI (apiyi.com) utiliza rotas diretas oficiais da OpenAI e Azure, com otimizações de cache específicas para o gpt-6-astra. Em cenários com prefixos fixos, é possível obter uma alta taxa de acerto, e você pode verificar o desempenho diretamente através do campo cached_tokens na resposta.
Perguntas frequentes sobre o gpt-6-astra
Q1: O gpt-6-astra foi realmente “desinteligenciado” (nerfed) pela OpenAI?
Atualmente, não há evidências oficiais de que os pesos do modelo tenham sido substituídos, e a OpenAI ainda não se pronunciou formalmente. Uma explicação mais provável é a mudança no agendamento do orçamento de inferência do lado da assinatura, somada à variância de saída do próprio modelo. Sugerimos usar o método de verificação de 5 etapas deste artigo, fazendo uma comparação com um nível fixo via API antes de tirar conclusões.
Q2: O gpt-6-astra chamado via API é o mesmo modelo do ChatGPT?
Sim, é o mesmo modelo. A diferença é que a API permite especificar explicitamente a intensidade da inferência, enquanto o orçamento de inferência dos produtos por assinatura é gerenciado pela plataforma. A APIYI (apiyi.com) oferece a versão completa do gpt-6-astra com redirecionamento oficial, onde a intensidade da inferência é executada exatamente conforme os parâmetros que você envia.
Q3: Posso usar a cota de assinatura e a API ao mesmo tempo?
Sim, ambas são independentes. Uma prática recomendada é continuar usando a cota de assinatura para interações diárias e alternar para a API quando a cota acabar ou quando precisar de processamento em lote; no Codex, você pode alternar rapidamente através do arquivo de configuração.
Q4: Usar a API para suprir demandas sai caro?
Depende do uso. Controlar o nível de inferência, aumentar a taxa de acerto de cache e colocar tarefas não urgentes em Batch pode reduzir o custo pela metade ou mais. Sugerimos testar o custo por tarefa com casos reais na APIYI (apiyi.com) antes de decidir a escala de uso.
Q5: Como combinar o gpt-6-astra e o GPT-5.6 Sol?
O Sol tem um preço muito mais baixo, sendo ideal para codificação convencional e tarefas em lote; o Astra tem vantagens claras em operações de computador, raciocínio complexo e tarefas de agentes de longa cadeia. Você pode usar o Sol como modelo padrão e atualizar para o Astra apenas em tarefas difíceis, garantindo qualidade e controlando custos.
Resumo: Transformando a incerteza do gpt-6-astra em variáveis controláveis
O gpt-6-astra é atualmente o Modelo de Linguagem Grande carro-chefe mais capaz da OpenAI, mas as controvérsias sobre a "redução de inteligência" e o aperto nos limites de uso logo após o lançamento expuseram uma característica essencial dos produtos por assinatura: o orçamento de inferência e os limites de uso são determinados pela plataforma, e o usuário só pode aceitá-los passivamente. Diante disso, em vez de ficar especulando se o modelo ficou "mais burro", é melhor estabelecer sua própria linha de base de qualidade usando comandos fixos e níveis de inferência definidos.
Na prática, você pode seguir três passos: primeiro, use o método de verificação de 5 etapas para distinguir o agendamento da plataforma, a variância do modelo e o seu próprio uso; em seguida, quando a cota esgotar, use a API para complementar, fixando as tarefas críticas nos níveis high ou xhigh; por fim, reduza os custos usando prefixos fixos, prompt_cache_key e processamento em lote (Batch). Assim, independentemente de como a assinatura seja ajustada, seu fluxo de trabalho principal permanecerá estável.
Se você precisa de um canal de suporte estável, recomendamos a invocação da versão completa do gpt-6-astra através da APIYI (apiyi.com). A plataforma oferece redirecionamento oficial direto da OpenAI e Azure, com interfaces totalmente compatíveis com as oficiais e alta taxa de acerto de cache, sendo uma alternativa confiável além das assinaturas do ChatGPT e Codex.
Referências:
- Documentação do modelo OpenAI (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- Central de Ajuda da OpenAI sobre o uso do Astra: help.openai.com
- Relatório do Decrypt sobre a controvérsia de redução de inteligência do Astra: decrypt.co
- Documentação de cache de comandos do Microsoft Foundry: learn.microsoft.com
- Documentação do modelo APIYI: docs.apiyi.com
Sobre o autor: Equipe técnica da APIYI, focada em integração de API de Modelo de Linguagem Grande e práticas de engenharia. Convidamos você a trocar experiências sobre otimização de invocação e controle de custos do gpt-6-astra através da APIYI (apiyi.com).